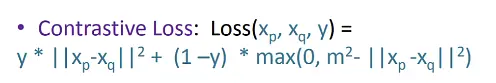
이성준
[데일리AI] Constrastive Learning 이란
Contrastive learning이란? (Feat. Contrastive loss) | 코어닷투데이
안녕하세요. 이번 글에서는 contrastive learning에 대해서 설명하도록 하겠습니다. Contrast라는 용어를 정의하면 아래와 같습니다. "A contrast is a
https://core.today/contents/57RV5yX12ze1
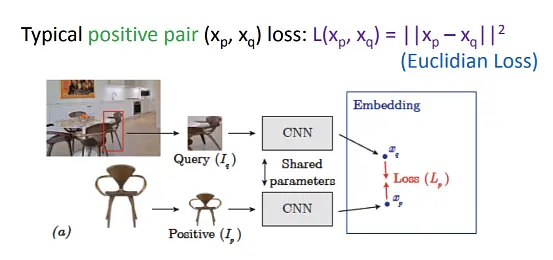
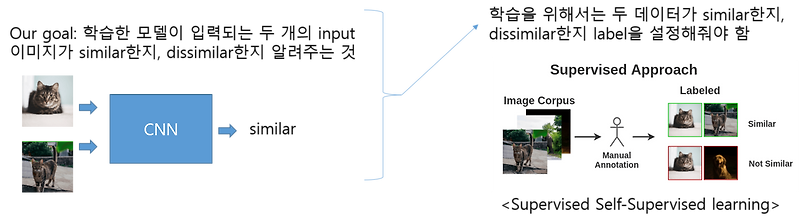
인공신경망을 이용한 딥러닝은 결국 데이터를 특정 기준에 따라 잘 표현(representation)하도록 학습시키는 것일텐데, 여기서 '어느어느 데이터는 서로 비슷해' 라고 라벨을 주면서 학습시키는 것은 similarity learning 이고, 여기에 더해서 '어느어느 데이터는 서로 달라' 라는 "차이"를 추가로 주어서 학습시키는 것이 바로 constrastive learning (대조학습) 이라고 합니다.
사람이 무언가 개념을 배울 때에도 요거랑 이거랑 비슷한거야 라고만 배우는 것보다 이거는 요거랑은 비슷하지만 저거랑은 다른거야 라고 차이를 같이 알려주면 그 개념의 바운더리를 확실히 배울 수 있는 그런 원리인 것 같네요.
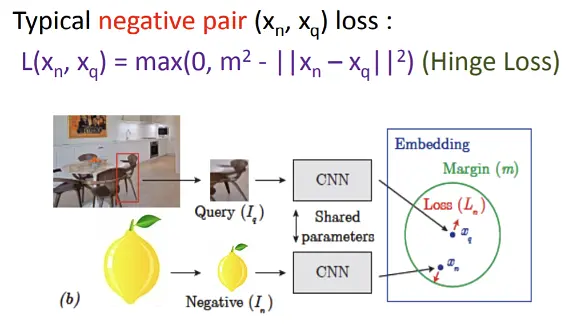
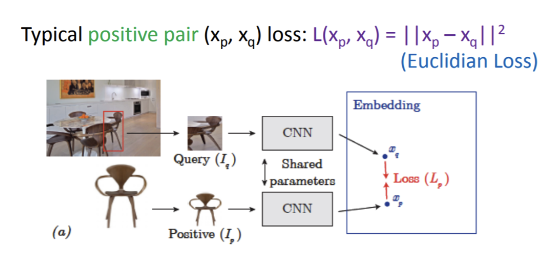
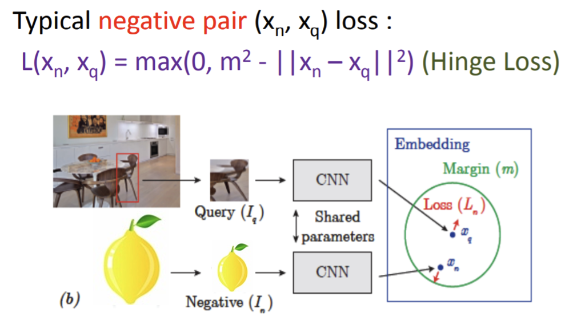
표현학습에서 유사도와 차이는 결국 표현된 공간에서의 (인공신경망에 의해 차원감소 후 매핑된 공간) 데이터 간의 거리로 표현할 수 있고, 유사 샘플 사이의 거리는 가깝게, 다른 샘플 사이의 거리는 되도록 멀어지게끔 학습하게 됩니다.
합치면:
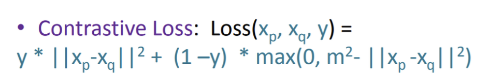
뒤에 max 텀은 max( 0, m2 - || x_n - x_q ||2 ) 인데 오타가 있네요.
여기서 x_q는 비교의 기준 (query), x_p는 positive pair, x_n은 negative pair를 의미하고, m은 마진값입니다. negative pair는 m보다 멀어졌으면 하면서 학습시키는 거죠.
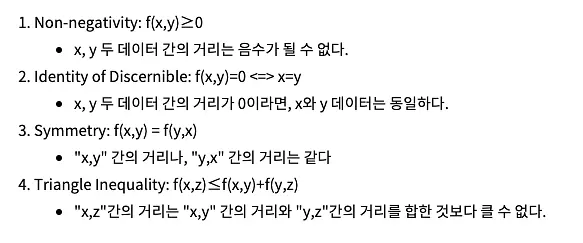
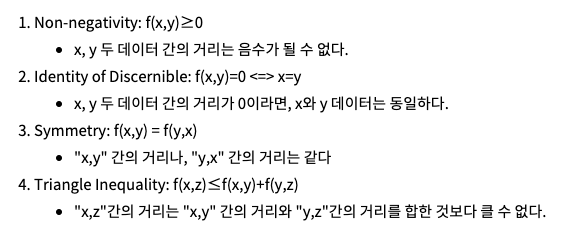
그리고 이 거리라는 것은 아래와 같이 기하학적인 특성이 그대로 적용된다는 것이 신기했습니다. 특히 4번째 특성.
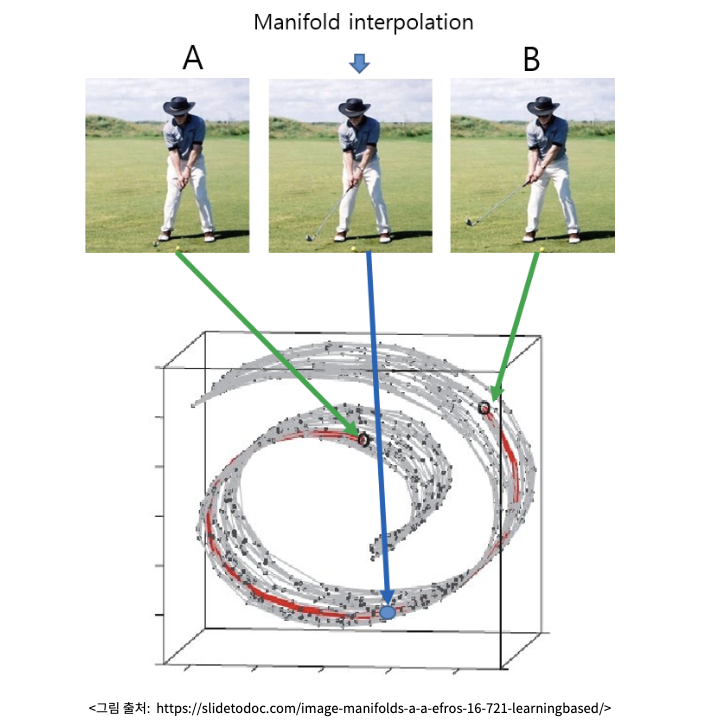
그리고 고차원에서는 데이터 간의 거리를 구하는 것이 어렵고, 표현학습을 통해 저차원 공간으로 잘 매핑(표현)되어야 한다는 것을 아래 그림으로 직관적으로 설명하고 있는 것이 인상적입니다. (Word to Vector도 결국 이런 개념인 것 같네요.)
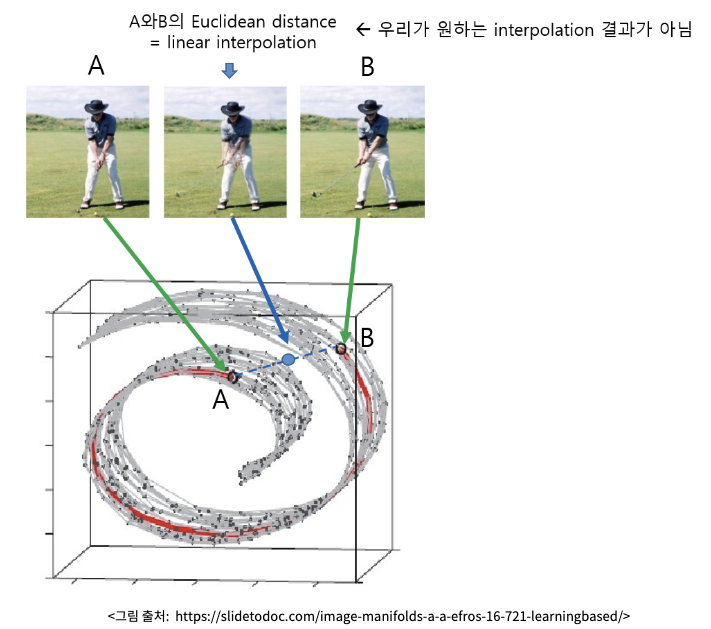
고차원 공간에서의 interpolation은 의미가 없을 수 있고, 매핑된 저차원 공간 (그림에서는 회색 평면)에서 일어나야 한다는 것이죠.
근데 이걸 언제 쓰느냐..
대표적인 사례로, 라벨링 된 데이터가 적을 때에 라벨링 되지 않은 다량의 데이터를 가지고 자가지도학습(self-supervised learning)을 통해 성능을 높일 수 있다고 합니다.
이미지를 증강하여 positive sample로 놓고, 다른 이미지는 negative sample로 놓고 학습시키는 것이지요.
사람이 데이터 라벨링을 해주지 않아도 되니까 대형 모델 사전학습 시키기에 아주 좋은 방법이 될 것 같네요.
요즘 특히 멀티모달 학습에도 널리 쓰이는 것 같은데 여기에 대해서는 다음 기회에 또 정리해 보겠습니다.