왜 한국엔 OpenAI가 없는가
기술이 끊임없이 발전하는 요즘, 가장 주목 받는 키워드가 무엇이냐 묻는다면 단언컨대 생성형 AI, 우리가 아는 OpenAI의 ChatGPT라고 말할 수 있겠다.
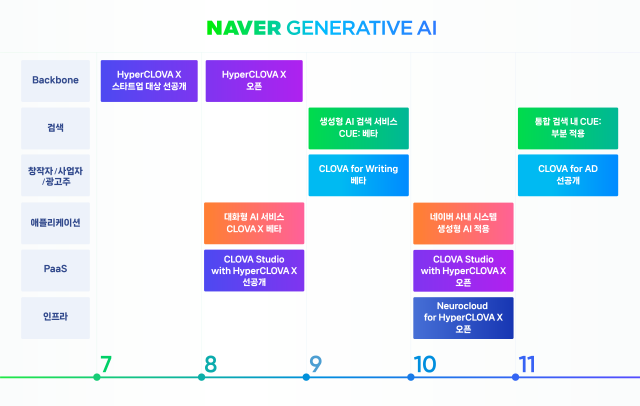
-그림1. 하이퍼블로바X 개발 일정(출처: 네이버,서울경제)
지난 21일, 네이버는 기술 채널 '채널 테크'를 통해서 대화형 에이전트 '클로바X(CLOVA X)'와 생성형 AI 기반 검색 서비스 '큐(Cue:)'의 베타 서비스 공개 일정을 밝혔다. 작년 11월 최초 베타 버전이 공개된 ChatGPT 서비스나 New Bing에 비해 다소 느린 시작이라 볼 수 있다.
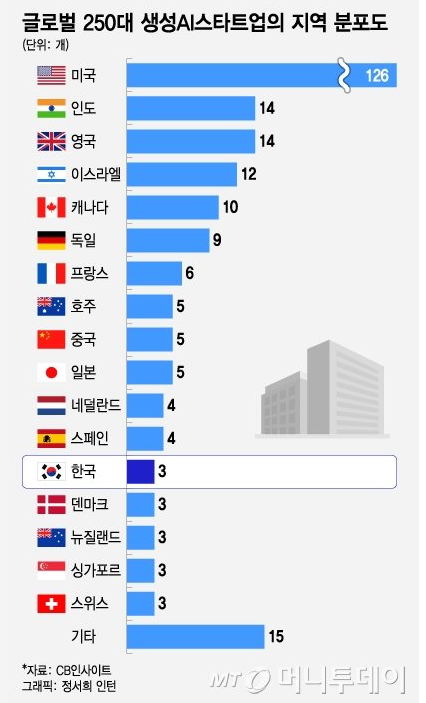
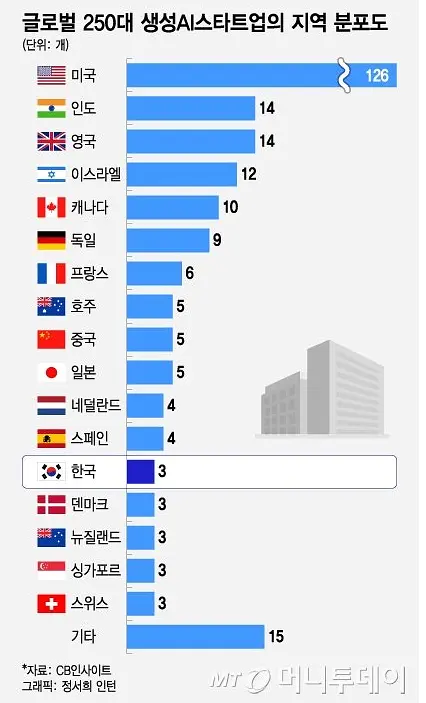
그림2. 글로벌 250대 생성 AI 스타트업 기업 그래프(출처: 머니투데이, 고석영 기자/정서희 인턴)
또 올해 초 CB인사이트에서 발표한 '글로벌 250대 생성AI 스타트업 기업'에 따르면 국내 소속 기업은 단 3곳으로, 126개를 차지하는 미국과 대비해 현저히 낮은 수치를 보였다. 단순히 기술이나 자원의 격차 만으로는 설명하기 힘든 차이를 보인 것이다. 충격적인 차이를 보고 나는 깊은 고민에 빠졌다.
왜 우리는 OpenAI와 같은 First Mover가 될 수 없었는가? 이 질문에 대해 나를 포함한 많은 이들은 데이터의 양과 질에 초점을 맞췄다.
LG AI 연구원 최정규씨는 "우리도 한국어에 집중하다가 영어를 포함한 바이링구얼(2개 이상 언어 구사)을 지향하게 됐다. 한국어 데이터는 전세계 인터넷 데이터 중 0.6%에 불과한 반면 영어는 60%를 차지하더라" 라며 AI 연구에서 한국어 데이터의 고충을 설명했다.
그와 동시에 영미권 책과 달리 한국은 저작권이 있는 자료의 경우 라이선스를 얻으려면 개개인 생산자에게 컨택을 해야한다며 데이터 차이가 발생하는 이유도 설명했다.
'데이터의 부족'이라는 문제는 단순히 생성형 AI 개발에 국한되는 문제가 아니다. 데이터의 수집과 학습은 AI를 포함한 딥 테크 분야에서 필수 불가결한 과정이다. 따라서 데이터 수집 과정이 어렵다면 결국 우리는 영미권 데이터에 의존하는 Fast Follower 중 하나가 될 수 밖에 없다. 딥 테크 산업은 차세대 산업 분야로 계속해 성장하고 있고 이 분야에서 주도권을 잡지 못한다는 것은 큰 문제이다. 이것이 정부와 기업인들 모두 AI 발전 속도를 따라잡기 위한 해결 방안을 고민하고 있는 이유이다.
이를 해결하는 것은 단순하다. 앞서 언급된 인터넷 상에 존재하는 데이터의 원 소유자와 수요자 사이 컨택 과정이 효율적으로 처리되면 해결된다.
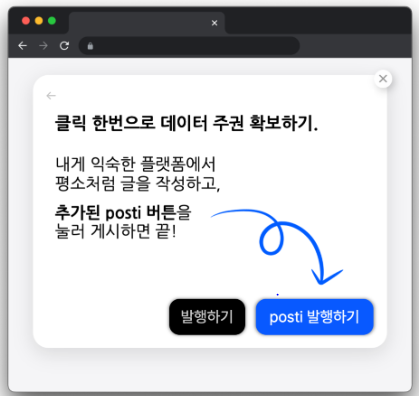
누군가 데이터를 생산하는 개개인에게 생산 직전 AI 학습을 위한 데이터 공유를 허가 받아 모아둔다면 데이터 수요자는 저작권적 고민 없는 고품질의 데이터를, 공급자는 자신의 데이터 가치에 맞는 보상을 받을 수 있지 않을까.
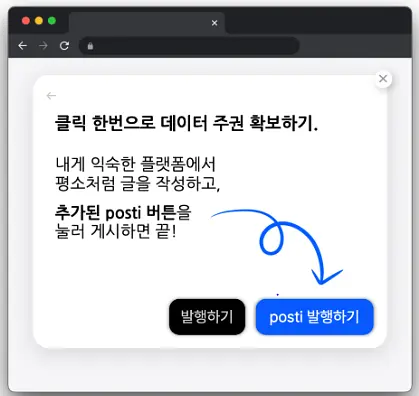
LLM 분야를 넘어 미래의 새로운 Innovative Deep tech 분야에서 주도권을 쟁취하기 위한 합리적 데이터 생산, posti가 이끌어 가보려 한다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.