AI 자막 번역을 만들면서 알게 된 것들
처음 TTRBench를 만들 때는 비교적 단순하게 생각했습니다.
좋은 AI 모델을 쓰고, 자막 파일을 잘 나눠서 번역하고, 결과를 다시 합치면 꽤 괜찮은
자막 번역기가 될 거라고 생각했습니다.
그런데 실제로 긴 자막 파일을 계속 테스트해보니, 번역 품질만 좋아서는 부족했습니다.
같은 인물 이름이 앞에서는 다르게 번역되고, 뒤에서는 또 다른 표현으로 바뀌기도 했습니다.
전문용어도 문장마다 조금씩 달라졌고, 짧은 자막은 앞뒤 문맥이 부족해 의도와 다른 번역이 나오기도
했습니다.
긴 파일에서는 또 다른 문제가 생겼습니다.
중간 구간에서 번역이 실패하거나, 일부 자막이 누락되거나, 한 번에 너무 많은 내용을 처리하면서
앞부분의 맥락이 뒤까지 제대로 이어지지 않는 경우도 있었습니다.
이 과정에서 생각이 조금 바뀌었습니다.
자막 번역에서 중요한 건 단순히
“이 문장을 얼마나 잘 번역했는가”가 아니라,
“영상 전체에서 번역을 얼마나 일관되게 유지할 수 있는가”
“실패가 생겼을 때 작업을 얼마나 안정적으로 이어갈 수 있는가”
“사람이 최종 결과를 얼마나 빠르게 검수하고 수정할 수 있는가”
에 더 가깝다는 생각이 들었습니다.
그래서 TTRBench도 처음 생각했던 단순한 AI 번역기보다는 조금씩 자막 작업용
워크스페이스에 가까운 형태로 바뀌고 있습니다.
현재는 영상에서 자막을 추출하고, SRT/VTT/TXT 파일을 번역한 뒤, 프로젝트별 용어집을 적용하고,
고유명사와 반복 표현의 일관성을 확인하고, 번역 결과를 직접 검수하고 수정할 수 있도록 만들고 있습니다.
또 긴 파일 처리 중 일부 구간이 실패하더라도 처음부터 다시 시작하지 않고, 완료된 구간을 유지한 채 이어서
처리하는 구조도 계속 다듬고 있습니다.
만들면서 또 하나 느낀 점은, AI 번역 서비스에서 모델 선택 자체보다 작업 흐름을 어떻게 설계하느냐가
생각보다 훨씬 중요하다는 점입니다.
좋은 모델을 사용하는 것만으로는 실제 작업 도구가 되기 어렵고, 번역 전후의 문맥 관리, 용어 통일,
실패 복구, 검수 과정까지 같이 설계해야 비로소 사람이 쓸 수 있는 결과가 나오는 것 같습니다.
아직 TTRBench도 이 문제들을 완전히 해결했다고 생각하지는 않습니다.
그래서 요즘은 “번역이 잘 됐나?”보다
“실제로 자막 작업을 하던 사람이 이걸 쓰면 시간이 줄어들까?”
를 더 많이 보고 있습니다.
자막 번역이나 영상 작업을 해보신 분이 있다면 궁금합니다.
AI 번역을 실제 작업에 써보면서 가장 많이 손이 갔던 부분은 무엇이었나요?
번역 품질, 용어 통일, 타임코드, 문맥, 검수, 파일 처리 등 어떤 부분이 가장 불편했는지도 듣고 싶습니다.
TTRBench를 만들면서 생기는 시행착오와 테스트 결과도 앞으로 조금씩 공유해보려고 합니다.
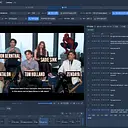
AI로 자막을 번역하고 용어·고유명사·문맥 일관성까지 검토하는 자막 번역 작업도구
댓글
로그인 후 댓글을 남길 수 있습니다.
완료한 구간을 남기고 이어서 처리하는 구조가 특히 실용적으로 보입니다. 다만 검수 중 용어집을 고치면 이미 번역한 구간에도 같은 표기를 적용해야 할 텐데요. 바뀐 용어가 들어간 구간만 다시 검토할 수 있도록 표시하는 방식도 고려하고 계신가요?
생각하지 못한 방향의 시선이네요. 댓글 감사합니다. 꼭 확인해 보도록 하겠습니다!
긴 파일에서 실패한 구간만 다시 처리하고, 프로젝트 용어집으로 고유명사를 맞추는 흐름이 실무에 특히 중요해 보입니다. 검수 화면에서 용어가 이전 구간과 다르게 번역된 곳을 한눈에 표시해 주면 수정 시간이 더 줄 것 같습니다.