1.1B 한국어 LLM 밑바닥부터 구현해 봤는데... 이제 어떻게 고도화하면 좋을까요?
🇰🇷 직접 만드는 한국어 AI | 데이터부터 모델 학습과 추론까지 직접 구현하는 LLM 프로젝트
1
0 팔로워
소개
안녕하세요, 커뮤니티 여러분. 이번에 방구석에서 낭만 하나로 밑바닥부터 나만의 한국어 AI를 직접 만들어보고 있는 @seoan1210입니다.요즘 허깅페이스에서 기존 모델을 불러와 쓰거나 상용 API를 호출하는 건 몇 줄이면 되지만, "최근 AI 기업들이 무료 한도를 째째하게 차단하고 결제 유도하는 게 킹받아서" 데이터 전처리부터 모델 아키텍처, 학습 프레임워크까지 아예 통째로 독자 구현해 보기로 결심했습니다.
현재까지 구현한 스펙 (수작업 빌드)
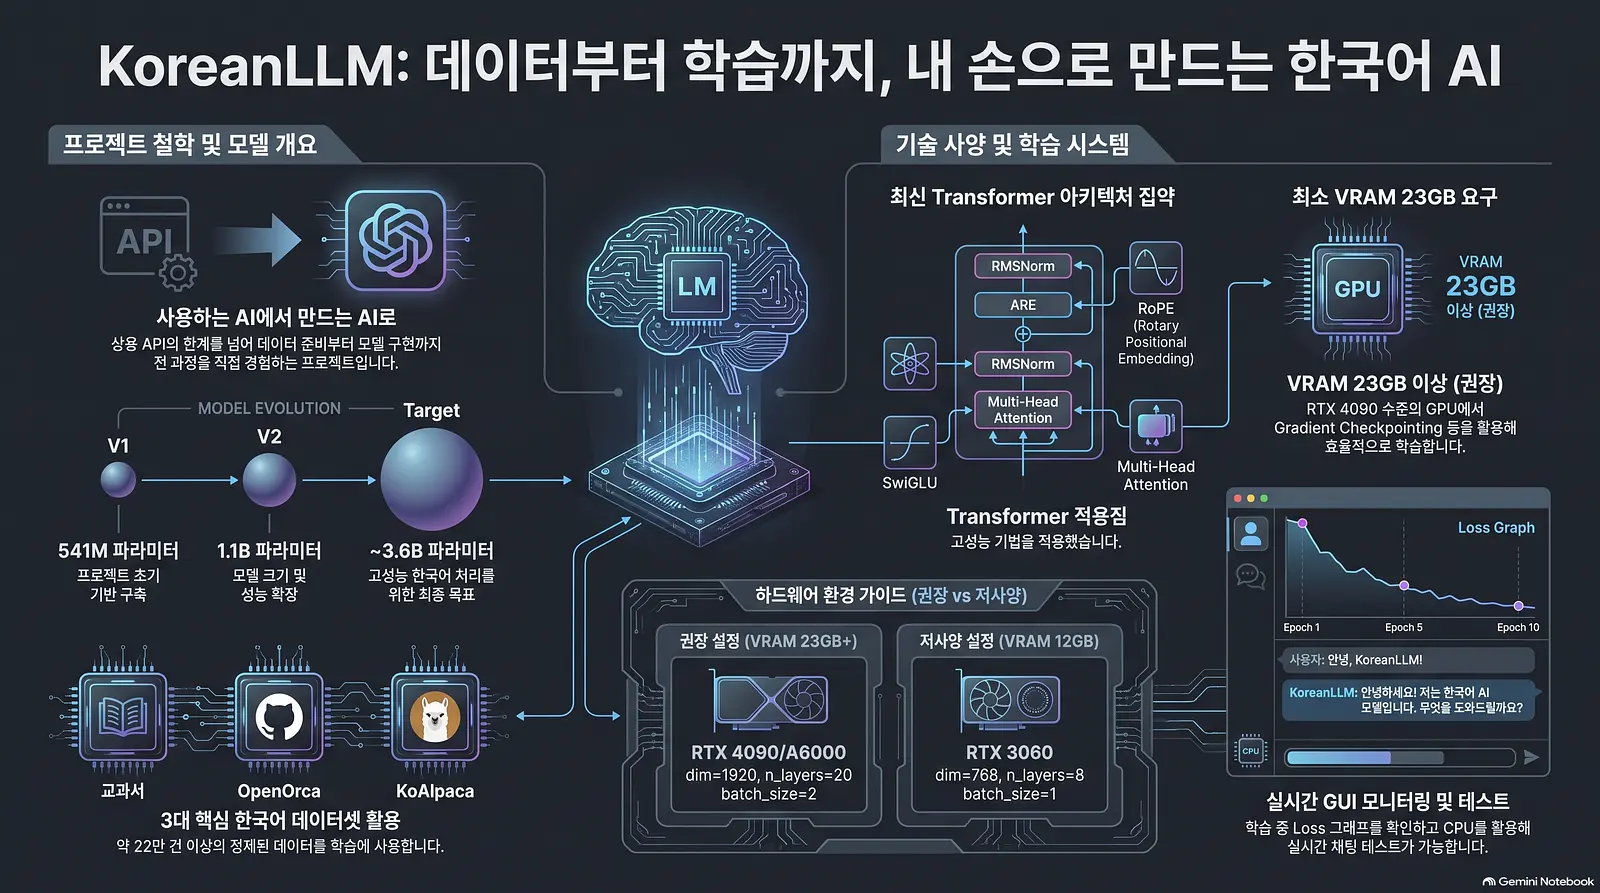
상용 패키지 없이 오직 행렬 곱과 파이토치 기본 연산으로 Llama 3 규격을 통째로 생(Raw) 코딩했습니다.
- Llama 3 기반 아키텍처 정밀 역설계: 대형 패키지 없이 기본 텐서 연산만으로 RMSNorm, SwiGLU, RoPE(회전 위치 임베딩), 추론용 KV-Cache 누적 메커니즘을 직접 수식으로 짰습니다.
- 비용 0원의 무료 AI 릴레이 조합: 무료 에이전트 툴 없이 Claude 4.5 Haiku(수학 연산), Google Gemini(대용량 맥락 검수), xAI Grok(생략 없는 통짜 소스 출력)의 무료 웹 채팅창을 게릴라식 세션 분할 기법으로 쥐어짜 부품을 수확하고, 제가 직접 변수명 및 데이터 흐름을 하나로 조립했습니다. (코파일럿은 오직 커밋 메시지 요약용으로만 썼습니다.)
- 전처리: beomi/Llama-3-Open-Ko-8B 토크나이저와 허깅페이스 국산 데이터셋(korean_textbooks, OpenOrca-gugugo-ko, KoAlpaca)을 수혈했습니다.
현재 진행 상황: 3,000 스텝 실측 로깅 (방금 전 결과)
1,000스텝마다 자동 생성되는 방금 전 3,000 스텝 중간 생성 결과인데, 아직 헛소리 단계를 못 벗어났습니다.
2026-08-09 16:50:44,650 - INFO - Generating samples...
Q: 한국의 수도는 -> A: 정답은 "국가"입니다.Q: 인공지능이란 -> A: "인구는 인공지능을 갖춘다"라는 문구를 보면... 긍정적이고 합리적인 것으로 간주될 수 있습니다.
Q: 안녕? -> A: 안녕하세요! 안녕하세요? 안녕하세요. 제 이름은 "저입니다."라고 말합니다... 오늘 저는 정말 열심히 일하고 싶어요.
이제아직 상식 지식이 부족해 엉뚱한 답변을 내놓지만, 소름 돋는 점은 '긍정적', '합리적', '간주될 수 있습니다' 같은 고난도 어휘와 조사 처리 등 한국어의 어순과 문법적 레이아웃을 내부 수제 트랜스포머 블록들이 완벽하게 인지하여 매끄러운 뼈대로 출력하기 시작했다는 것입니다. 수식이 하드웨어 레벨에서 단 1의 오차도 없이 무결점으로 연산되고 있다는 신호로 보입니다.
선배 엔지니어분들께 드리는 질문 (이제 어떻게 하면 좋을까요?)
현재 최종 목표는 5만 스텝을 완주한 뒤, 메모리 최적화 프롬프트 스펙을 극한으로 깎아내 최종 3.6B(36억 파라미터) 규모의 Transformer 모델로 체급을 확장하는 것입니다. 여기서 선배 개발자분들께 조언을 구하고 싶습니다.
1. 3.6B 스케일업 시 VRAM 절약 팁: 현재 1.1B에서도 VRAM 23GB를 꽉 채워 쓰고 있습니다. 노트북 단일 GPU(24GB VRAM) 환경을 유지하면서 3.6B까지 체급을 키우려면, Gradient Checkpointing 외에 순수 파이토치 레벨에서 추가로 적용할 만한 극단적인 메모리 최적화 기법(예: 고도화된 텐서 슬라이싱이나 경량화 팁)이 무엇이 있을까요?
2. 데이터셋 밸런싱 노하우: 3,000스텝에서 문법 구조는 잡혔는데 정보의 팩트가 자꾸 틀립니다. 5만 스텝까지 가면서 지식이 자연스럽게 차오를까요, 아니면 지금이라도 특정 데이터셋의 비율을 수동으로 더 조율해야 할까요?
3. 코드 리뷰 및 피드백: 깃허브 레포에 가볍게 들러보시고, 아키텍처나 인프라 상에서 개선할 만한 부분이 있다면 어떤 의견이든 달게 받겠습니다!
혼자 Loss 그래프만 보다가, 더 넓은 세상의 집단지성을 빌려보고 싶어 글을 올립니다.
많은 조언과 피드백, 그리고 깃허브 스타와 추천 부탁드립니다!
GitHub Repository: https://github.com/seoan1210/korean-llm-v2.git
포스트
아직 포스트가 없습니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.