honyaku
번역서 없는 일본어 책·논문을, 세로쓰기 스캔 원서까지 통째로 한국어로 읽게 해주는 번역 워크플로
0
0 팔로워
소개
일본 자료를 읽어야 하는데 번역서가 없어서 막혀본 적이 있다면, 이 도구를 왜 만들었는지 바로 아실 겁니다.
논문 한 편은 DeepL에 넣으면 됩니다. 문제는 그다음입니다. 무료는 월 1파일, 유료도 월 3파일에서 막히고, 같은 전문용어가 파일마다 다르게 번역됩니다(介護가 어떤 날은 '개호', 어떤 날은 '요양'으로 나오는 식). 그리고 번역서 없는 일본 책 한 권을 통째로 읽으려는 순간, 사실상 방법이 없습니다. 세로쓰기 스캔 원서를 DeepL·구글에 넣으면 세로 컬럼을 뒤섞거나 한 페이지를 통째로 건너뜁니다. 그렇다고 전문 번역가에게 책 한 권을 맡기면 수백만 원이고, 몇 주가 걸립니다.
honyaku는 '한 편 번역'이 아니라 '책 한 권을 끝까지 읽게 하는 워크플로'로 만들었습니다.
- 용어 일관성: 한 번 정한 용어를 300쪽 내내, 다음 문서에서까지 그대로 지킵니다(용어집 + 번역 메모리).
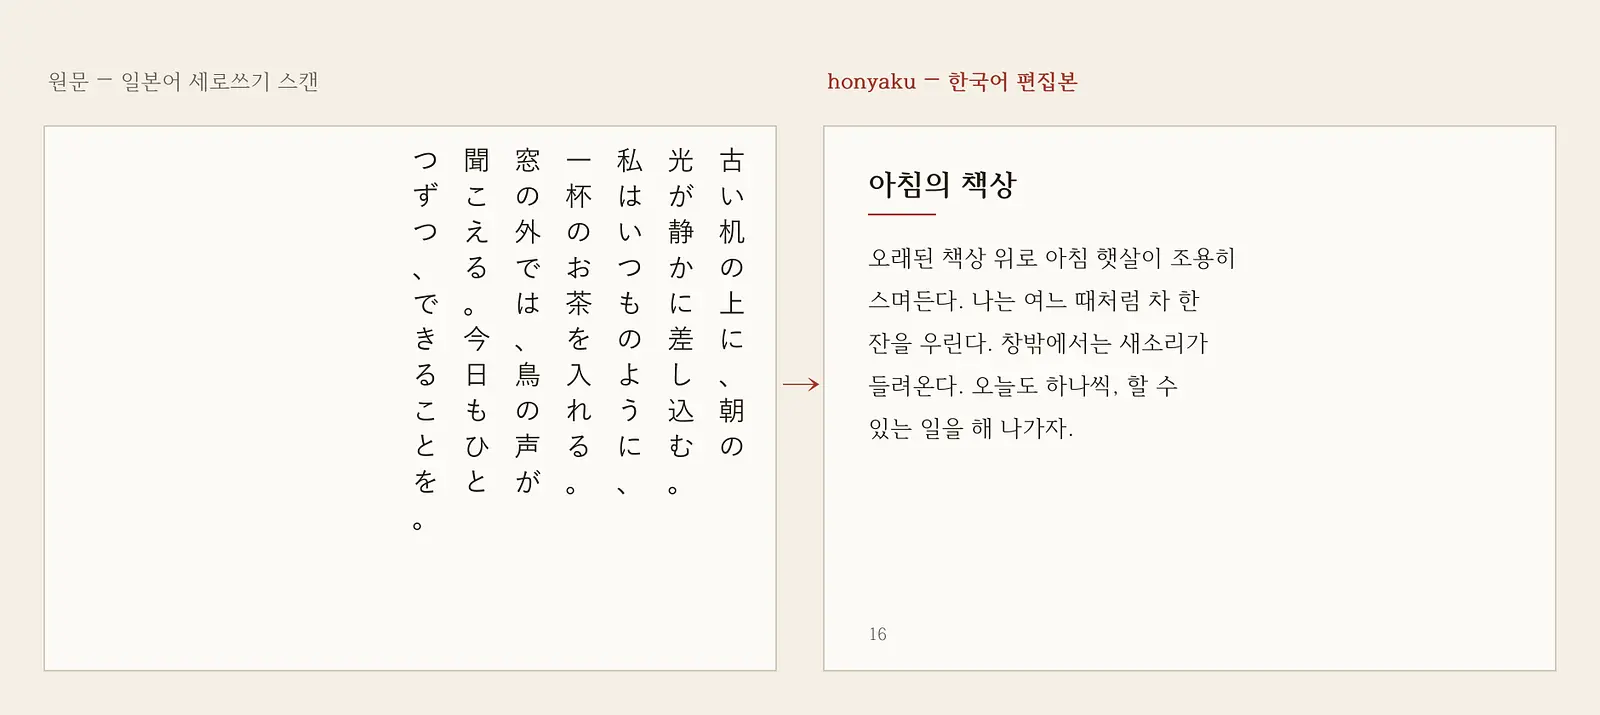
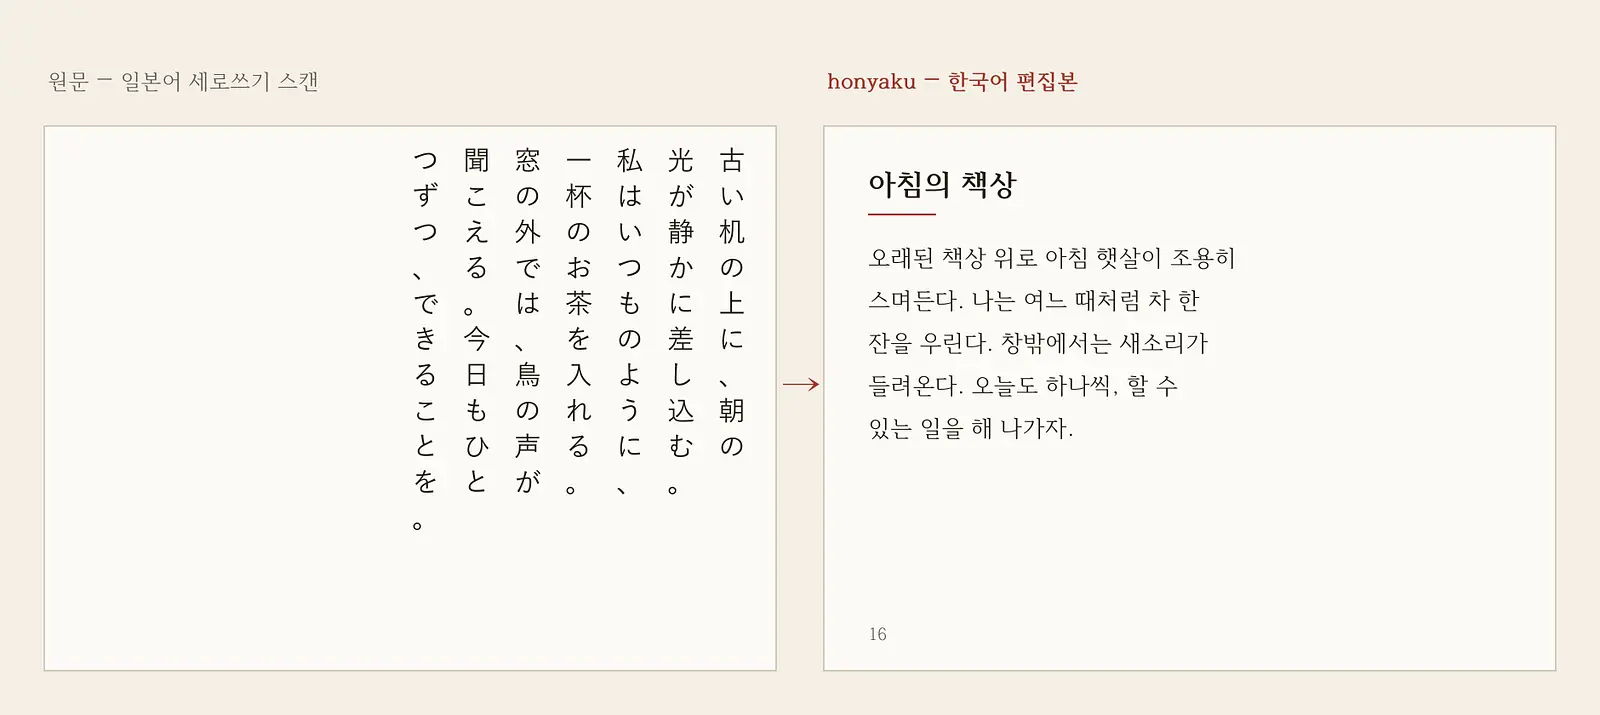
- 원문·번역 대조 PDF: 원문과 번역을 한 화면에 나란히. 인용 검증하거나 지도교수님께 검토받을 때 씁니다.
- 그림 속 일본어 제자리 교체: 도판 라벨·캡션까지 그림 안에서 한국어로 바꿉니다(DeepL·구글·파파고는 손대지 않는 부분).
- 품질·일관성 리포트: 용어 적용률·숫자 보존을 자동 검증한 결과를 증거로 함께 냅니다.
세로쓰기 스캔 원서는 텍스트 모드로 번역합니다. 본문은 읽기 좋은 한국어로, 사진 페이지는 원본 그대로, 캡션은 번역해 함께 싣고, 원문·번역 대조본까지 나옵니다. '정밀 인식'을 켜면 장 표지·소제목·본문을 구분해 판형·러닝헤더·명조 조판까지 갖춘 한국어 번역판처럼 만들어 줍니다.
정직하게 적겠습니다. 번역 문장 자체의 품질은 DeepL과 비슷합니다(블라인드로 비교해봤습니다). 차이는 문장 하나가 아니라 '책 한 권을 끝까지 다루는 워크플로'에 있습니다. 용어를 끝까지 통일하고, 대조본을 뽑고, 그림 속 글자를 바꾸고, 결과를 검증해 내주는 것 — 여기에 걸었습니다.
그래서 가격이 이렇게 됩니다. 전문 번역가에게 200쪽짜리 책 한 권을 맡기면 수백만 원, DeepL은 세로쓰기 스캔 원서를 애초에 제대로 못 읽습니다. honyaku는 원서 한 권을 십수만 원에, 오늘 오후 안에 읽을 수 있는 한국어로 바꿔줍니다.
기술적으로는 BabelDOC 레이아웃 보존 위에 Claude 번역을 얹고, 사용자별 용어집·번역 메모리를 프록시 레이어에서 주입하는 구조입니다. 1인 개발, 맥미니 한 대로 운영하고 있습니다.
가입하면 5페이지를 무료로 써볼 수 있고, 가입 없이 실제 결과물(번역본·대조본·Word)을 열어보는 데모도 있습니다.
https://honyaku.kr
포스트
아직 포스트가 없습니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.