Inferaft
코딩 에이전트용 오픈웨이트 추론 API — 262K 컨텍스트, 측정해서 공개하는 요금제
0
0 팔로워
소개
Qwen3.8-27B를 직접 서빙해서 OpenAI·Anthropic 호환 API로 제공합니다. Claude Code, Codex, OpenCode에 base URL과 API 키만 바꿔 끼우면 붙습니다.
왜 만들었나
코딩 에이전트를 계속 돌리다 보면 토큰값이 먼저 무너집니다. 그렇다고 로컬에 27B를 띄우자니 장비값과 운영이 따로 듭니다. 그 사이를 메우려고 만들었습니다.
무제한 요금제를 만들었다가 지웠습니다
처음엔 $50 무제한 + 100석 좌석제였습니다. 상한 없는 요금제를 안전하게 팔려면 인원을 좌석으로 묶어야 하는데, 두 가지가 무너졌습니다.
첫째, 좌석 100은 빌린 H200 측정치로 뽑았는데 실제 서빙은 3090 두 장이었습니다. 하드웨어가 못 지키는 약속이었습니다.
둘째, 좌석은 결제 시작부터 정산까지 잡아둬야 초과판매가 안 납니다. 그래서 버려진 체크아웃이 좌석을 영구 점유했고, 한 건도 안 팔렸는데 남은 좌석이 99로 표시됐습니다.
전부 계량 요금제로 바꿨습니다. 5시간·7일·30일 롤링 한도이고, 한도가 곧 콘솔에서 보이는 숫자입니다.
포함 사용량 6배가 사실 손익분기점입니다
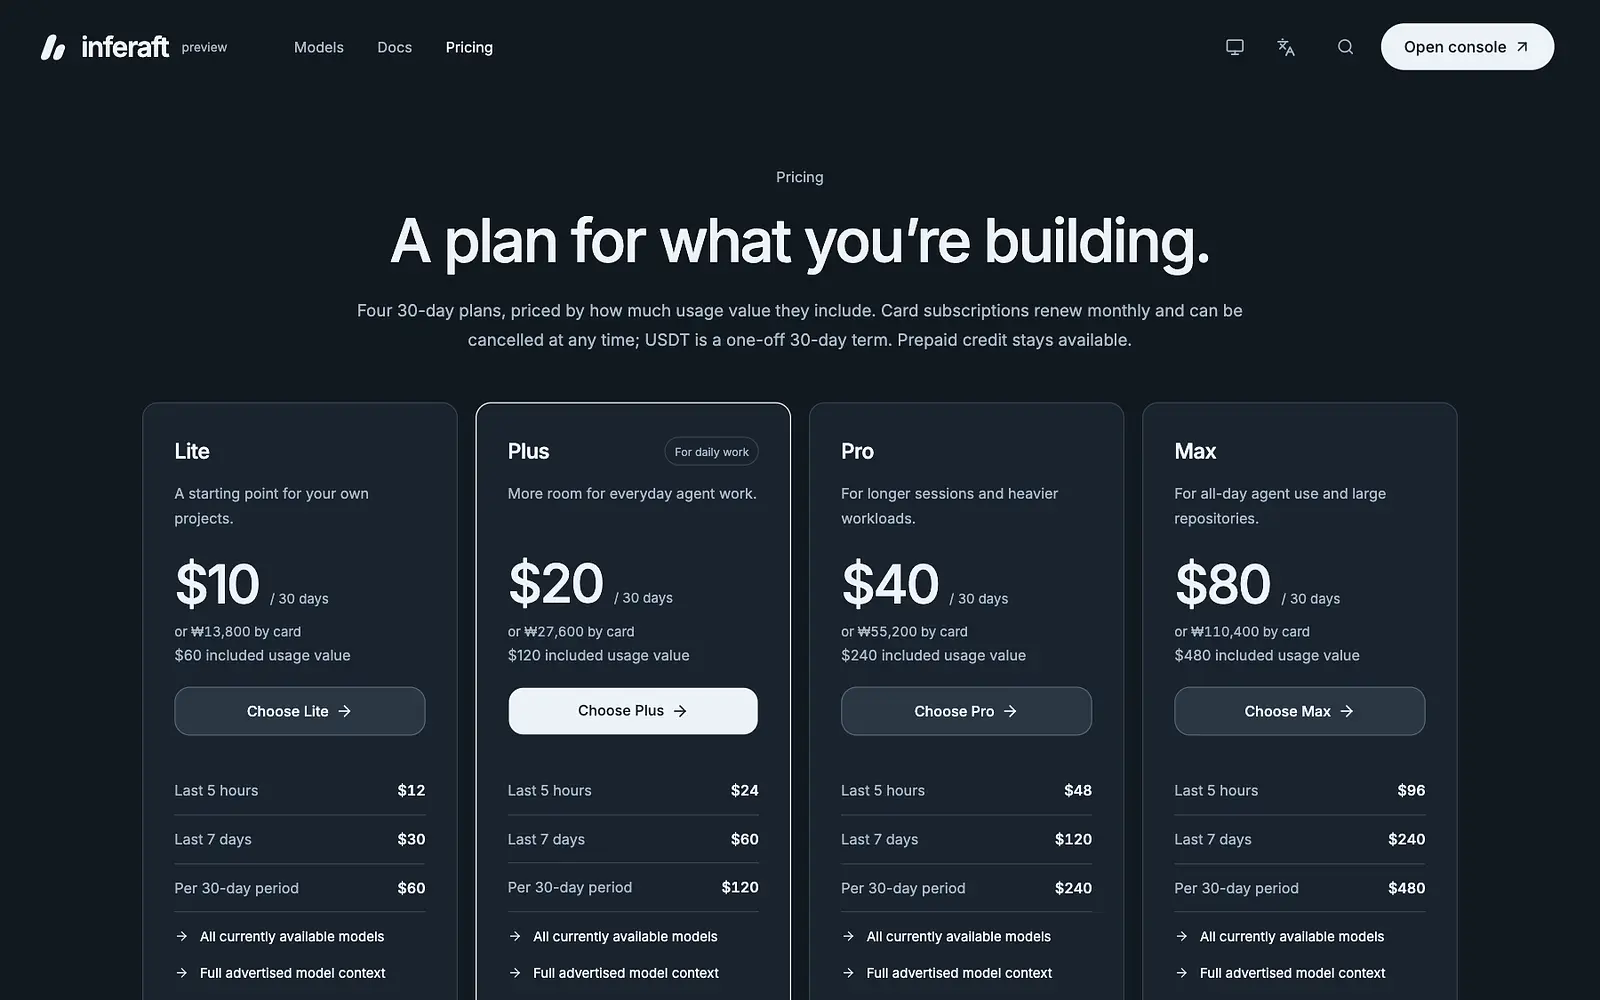
요금제는 가격의 6배에 해당하는 사용량을 포함합니다($10 → $60). 마케팅 숫자 같지만 계산하면 정확히 본전입니다. H200 포화 기준으로 요청당 GPU 원가 $0.000600, 공시 단가 환산 $0.003648, 비율 6.08배입니다. 즉 100% 소진하면 마진 0이고, 마진은 안 쓴 한도에서 나옵니다. 그래서 윈도우가 장식이 아니라 사업 모델입니다.
가입자 수는 용량 단위가 아니었습니다
"100명 받으면 터지나"를 H100 80GB를 17.7분 빌려($0.65) 측정했습니다. 고정 동시성 스윕 대신 포아송 도착 과정으로 돌렸습니다. 가입자가 동시에 요청하지 않으니까요. 활성 사용자당 시간 10요청 기준입니다.
- 100명 → 피크 동시 3건, 전체 p95 1,965ms
- 300명 → 피크 동시 7건, p95 3,047ms
- 600명 → 피크 동시 20건, p95 10,851ms (실패 0)
100명일 때 평균 in-flight가 0.41건입니다. 구속 조건은 가입자 수가 아니라 도착률 × 서비스 시간이었습니다.
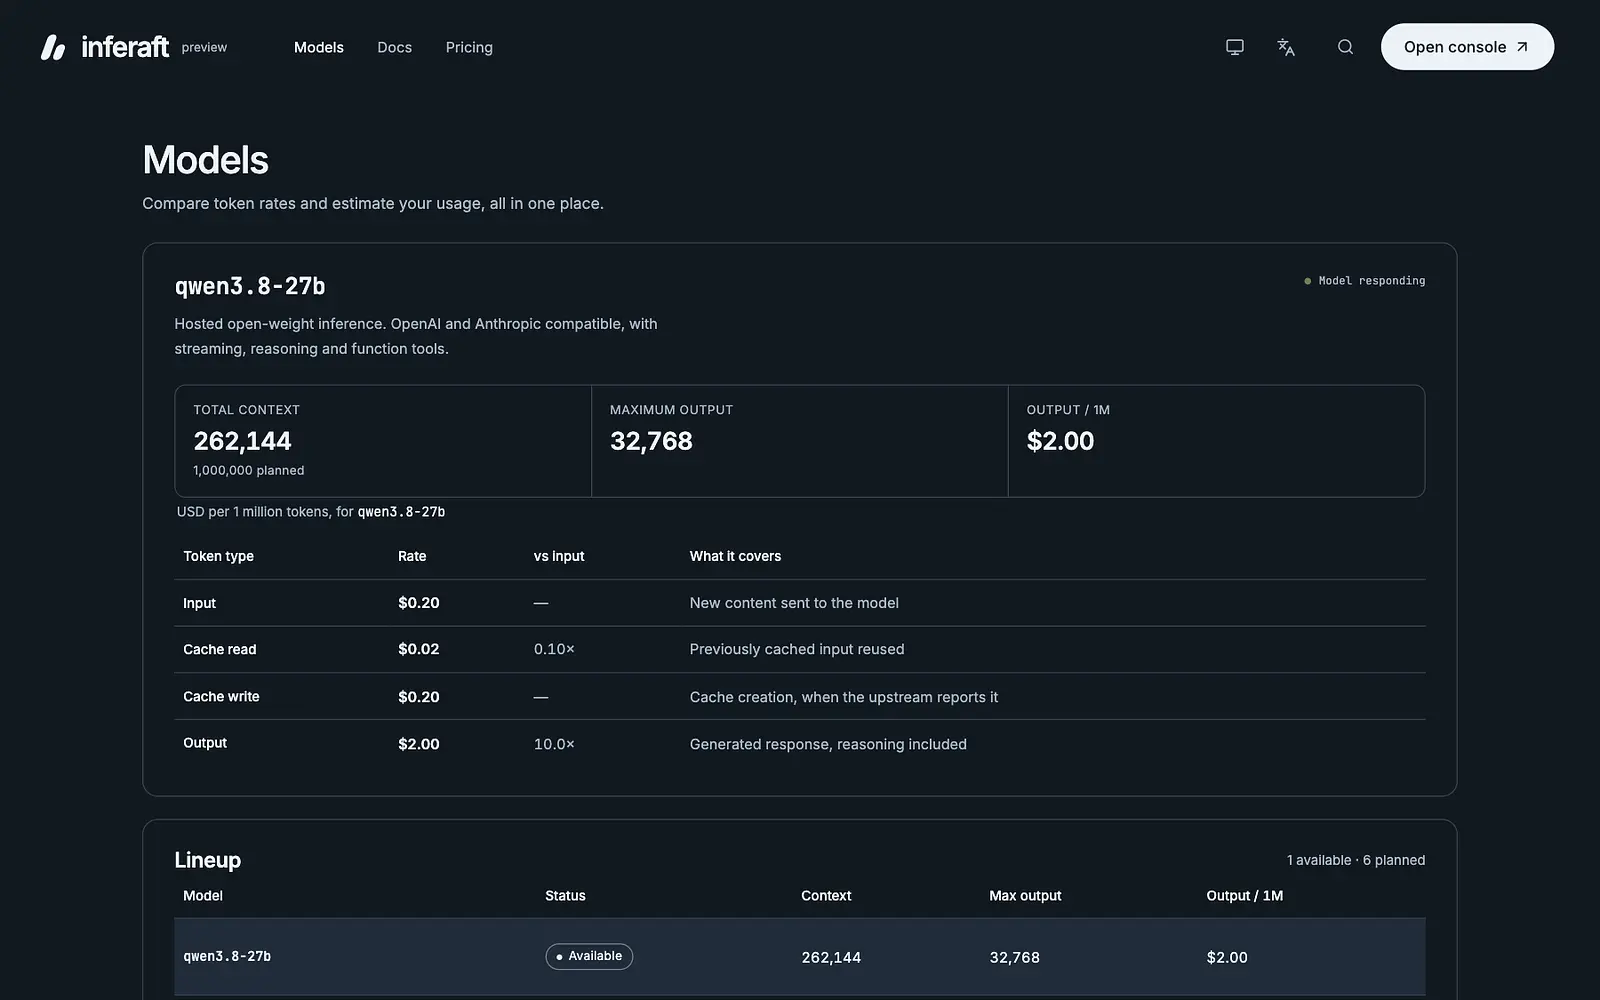
컨텍스트도 실측했습니다. 255,271토큰 입력 한가운데 심은 needle을 정확히 찾아냈고, 262,145토큰 요청은 모델 상한 262,144에 1토큰 차로 거부됐습니다. 광고하는 창이 실제 창입니다.
요금
Lite $10 / Plus $20 / Pro $40 / Max $80, 각 30일에 가격의 6배 사용량. 토큰 단가는 입력 $0.20, 캐시 읽기 $0.02, 출력 $2.00 / 1M입니다. 한도가 떨어지면 $5 사용량 초기화권으로 세 윈도우에 각각 $15를 더합니다. 국내는 카드(원화), 해외는 USDT.
솔직한 한계
위 측정은 빌린 H100이고 현재 프로덕션은 3090 두 장, 전역 동시 2건입니다. 트래픽이 몰리면 대기가 생깁니다. 숨길 게 아니라 적어둡니다. 측정 시 thinking은 껐고, 도착 테스트는 요청 형태 한 가지만 썼습니다.
피드백이 궁금한 지점
1. 6배 배수가 본전인 구조에서 배수를 낮추고 가격을 내릴지, 이대로 갈지
2. 초기화권($5 → $15)이 상위 요금제로 올라가게 만드는 유인으로 충분한지
3. 전역 동시 2건인 채로 여는 게 맞는지, GPU부터 올릴지
포스트
아직 포스트가 없습니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.