하자혜
아이디어나 정보를 빠르게 도식화하고 싶던 적 있나요?
전 노션을 쓰면서, 별도 툴을 찾아 쓰지 않고도 간편하게 플로우를 그리고 싶던 적이 종종 있었는데요.
노션에서 머메이드(Mermaid)를 사용하면 플로우, 사용자 여정, 마인드맵 등 여러 다이어그램과 차트를 단순한 코드로 만들 수 있습니다. 에디터에서 샘플 코드도 재공돼, 뚝딱뚝딱 만드는 재미도 있었어요!
👇링크드인에서 전문 보기
하자혜
아이디어나 정보를 빠르게 도식화하고 싶던 적 있나요?
전 노션을 쓰면서, 별도 툴을 찾아 쓰지 않고도 간편하게 플로우를 그리고 싶던 적이 종종 있었는데요.
노션에서 머메이드(Mermaid)를 사용하면 플로우, 사용자 여정, 마인드맵 등 여러 다이어그램과 차트를 단순한 코드로 만들 수 있습니다. 에디터에서 샘플 코드도 재공돼, 뚝딱뚝딱 만드는 재미도 있었어요!
👇링크드인에서 전문 보기
하자혜
[모두레터] 오픈AI, 고난이도 추론을 위한 새로운 모델 발표
오픈AI가 어려운 추론 문제를 해결하기 위한 언어 모델 'o1'을 공개했습니다. 답변을 하기 전에 더 많이 생각하여 여러 가지 전략을 시도하거나 오류들을 수정하도록 설계되어 있다고 하네요. 아직 이미지 처리와 같은 다양한 기능은 없지만 물리학, 화학, 생물학 분야의 벤치마크 테스트에서는 박사 과정 학생들과 비슷한 수준의 점수를 받았고요. 국제 수학 올림피아드 문제는 83%를 해결하여 GPT-4o의 13%보다 훨씬 높은 점수를 기록했습니다.
챗GPT 플러스, 팀 사용자들은 챗GPT에서 'o1-preview' 모델과 더 가벼운 'o1-mini'를 사용해 볼 수 있습니다. 'o1-preview' 모델은 일주일에 메시지 30개, 'o1-mini'의 경우 50개를 처리할 수 있는데요. 오픈AI는 사용량 제한을 늘리고 프롬프트에 따라 적절한 모델이 자동으로 선택되게 업데이트를 할 예정이라고 합니다.
👇9월 16일, 모두레터 전문 보기
하자혜
[모두레터] 텍스트 프롬프트로 60초 만에 3D 모델이 뚝딱!
메타가 텍스트 프롬프트로 60초 만에 고품질 3D 에셋(assets)을 생성하는 파이프라인 '3D 젠(3D Gen)'을 공개했습니다. 3D 젠의 핵심 기술 '에셋젠(AssetGen)'과 '텍스처젠(TextureGen)'의 논문도 각각 발표했습니다. 3D 젠 파이프라인은 크게 2단계로 이뤄져 있는데요. 첫 번째 단계(AssetGen)에서 3D 메시(mesh)를 생성하고, 두 번째 단계(TextureGen)에서 적절한 텍스처를 입히게 됩니다.
두 단계 모두 디퓨전(Diffusion) 기법이 사용되었는데요. 기존의 3D 생성 모델보다 더 정교하고 프롬프트도 잘 반영된다는 것을 확인할 수 있습니다. 하나의 3D 모델로도 텍스처에 따라서 다양한 사물과 분위기를 표현할 수 있는 것을 보니, 텍스처젠으로 텍스처를 다시 입히는 과정이 핵심적인 아이디어인 것 같네요!
하자혜
[설문 이벤트] 스타트업/개발자/PM 분들, 스마트하게 일하고 계신가요?
안녕하세요, 커뮤니티 기반 SW/AI 교육 스타트업 모두의연구소입니다.
ㅤ
현재 저희가 사수 없이 어려움을 겪는 DX 새내기를 위한 교육 서비스를 만들고 있는데요.
실제 현업에 계신 분들이 어떤 필요를 갖고 있는지 더 잘 이해하고,
가장 적합한 서비스를 제공하고자 설문조사를 진행하고 있습니다💎.
디스콰이엇 분들의 적극적인 참여와 관심 부탁드립니다, 감사합니다!
ㅤ
• 설문 기간: 2024년 7월 4일 ~ 7월 10일 (1주일)
• 설문 시간: 약 5분
• 설문 내용: 현업에서 주로 사용 중인 솔루션 및 고충점 관련 질문
• 참가 혜택: 스타벅스 1만원 기프티콘 (총 10명 추첨)
ㅤ
👉지금 설문 참여하기: https://bit.ly/4coUMqL
하자혜
미스트랄 AI, 첫 코드 생성 모델 '코드스트랄' 공개
Mixture-of-Experts(MoE) 기법을 적용한 언어 모델 믹스트랄(Mixtral)로 잘 알려져 있는 인공지능 스타트업 미스트랄 AI(Mistral AI)에서 코드 생성 모델 '코드스트랄(Codestral)'을 출시했습니다. 미스트랄 AI에서 처음으로 출시된 코드 생성 모델인데요. 파이썬이나 자바와 같이 널리 쓰이고 있는 언어부터 스위프트(Swift), 포트란(Fortran) 등 80가지 이상의 프로그래밍 언어로 학습됐다고 해요.
코드스트랄의 모델 크기는 22B(파라미터 220억 개)지만, 코드라마 70B(CodeLlama 70B), 딥식 코더 33B(DeepSeek Coder 33B) 등 규모가 더 큰 모델과 비교해도 뛰어난 성능을 보였다고 하네요. 코드스트랄 모델은 미스트랄에서 제공하는 API를 통해서 사용할 수 있고요. 챗봇 서비스 '르 챗(Le Chat)'에서도 모델과 대화해 볼 수 있으니 참고해 주세요!
👇6월 10일, 모두레터 전문 보러가기👇
하자혜
구글이 구글 워크스페이스(Google Workspace)의 제미나이(Gemini)에서 활용할 수 있는 프롬프트 팁을 45페이지 분량의 가이드북으로 만들어 공유했습니다. 이 책에서는 프롬프트를 페르소나(persona), 할 일(task), 문맥(context), 형식(format)으로 나누고요. 이후에 등장하는 예제들에서도 프롬프트를 4개의 영역으로 구분하고 있습니다. 본문에 들어가기 전에도 간단한 팁을 주고 있는데요. 사람에게 이야기하는 것처럼 완전한 문장을 사용하는 것, 모델이 해야 할 일과 문맥을 간결하지만 구체적으로 입력하는 것, 여러 개의 프롬프트를 이용해 모델과 대화를 하는 것이 있습니다.
다른 프롬프트 엔지니어링 자료들과는 다르게, 이 가이드북은 업무에서 사용할 수 있는 프롬프트를 경영・HR・마케팅 등 다양한 직무별로 구분하여 구성했습니다. 업무용 프롬프트 스킬을 향상시키고 싶다면 아래 링크에서 가이드북을 확인해 보세요!
👇5월 27일, 모두레터 전문 보러가기👇
하자혜
언어 모델 클로드(Claude)를 개발한 앤트로픽(Anthropic)에서 흥미로운 연구 결과를 발표했습니다. 언어 모델은 나날이 발전 중이지만, 크고 복잡하다는 특성 때문에 작동 원리를 파악하기 어려웠죠. 앤트로픽의 연구팀은 클로드 소넷(Claude Sonnet) 모델과 딕셔너리 러닝(dictionary learning)이라는 기법을 사용해, 특정한 개념에 반응하는 피처(feature, 뉴런들의 활성화 패턴)가 존재한다는 사실을 밝혔습니다.
피처들을 활성시키는 개념에는 도시, 인물 등의 개체부터 코드 에러, 차별적 표현 등 더욱 추상적인 것들도 있었다고 해요. 피처들 사이의 '거리'를 측정하는 것도 가능했는데요. '내적 갈등' 피처 근처에는 '어려운 상황', '딜레마' 등과 관련된 피처들이 있네요. 더 나아가서, 이런 피처들을 조정해 언어 모델의 답변에도 영향을 줄 수 있었다고 합니다.
👇5월 27일, 모두레터 전문 보러가기👇
하자혜
구글의 개발자 컨퍼런스 '구글 I/O'의 개최를 앞둔 시점에 오픈AI가 올해 봄 새로운 업데이트 내용들을 발표했습니다. 가장 뜨거운 소식은 역시 신규 모델 'GPT-4o'의 공개인데요. 모델명의 "o"는 "omni(모든)"의 줄임말로, 텍스트・오디오・이미지・비디오 등 다양한 형태의 데이터를 이해할 수 있다는 점(멀티모달)을 강조한 것 같죠. 인간 대화에 버금가는 실시간 음성 대화, 다양한 언어 지원에 빠른 응답 속도까지 엄청난 진보에 큰 놀라움을 주고 있습니다.
오픈AI는 그동안 언어 모델 GPT뿐만 아니라 이미지 생성 모델, 음성 합성 모델 등을 꾸준히 개발해 왔는데요. 그 간의 연구 내용을 바탕으로, 여러 모달리티(Modality)를 통합하고 인간-컴퓨터 상호작용(Human-Computer Interaction, HCI) 측면을 강화한 결과가 이번 모델이지 않을까 싶습니다. 차기작 GPT-5도 올여름 출시 예정이라는 소문이 있죠. 'GPT-4o'의 멀티모달 성능에 GPT-5가 결합되면 얼마나 더 강력해질까요?
👇5월 20일, 모두레터 전문 보러가기👇
하자혜
비디오 생성 모델 비두(Vidu)가 오픈AI 소라(Sora)의 경쟁 상대로 떠올랐습니다. 비두는 중국의 칭화 대학과 성수 테크놀로지(Shengshu Technology)가 개발한 인공지능 모델인데요. 최대 16초 길이와 1080p 해상도의 영상을 생성할 수 있다고 합니다.
기술적인 부분이 자세히 공개되지는 않았지만, 디퓨전(Diffusion)과 트랜스포머(Transformer)를 결합한 U-ViT(Universal Vision Transformer)라는 아키텍쳐를 사용했다고 하네요. 오픈AI 소라는 디퓨전 트랜스포머(DiT)를 사용했다고 알려져 있는데요. 이 부분은 아이디어가 비슷한 것 같습니다. 아직 소라에 비해서는 조금 부족하지만 결과물의 퀄리티가 꽤 괜찮은 모델이라는 평가를 받고 있어요. 새로운 경쟁자 비두가 앞으로 어떻게 발전해 나갈지 기대가 되네요!
👇5월 6일, 모두레터 전문 보러가기👇
하자혜
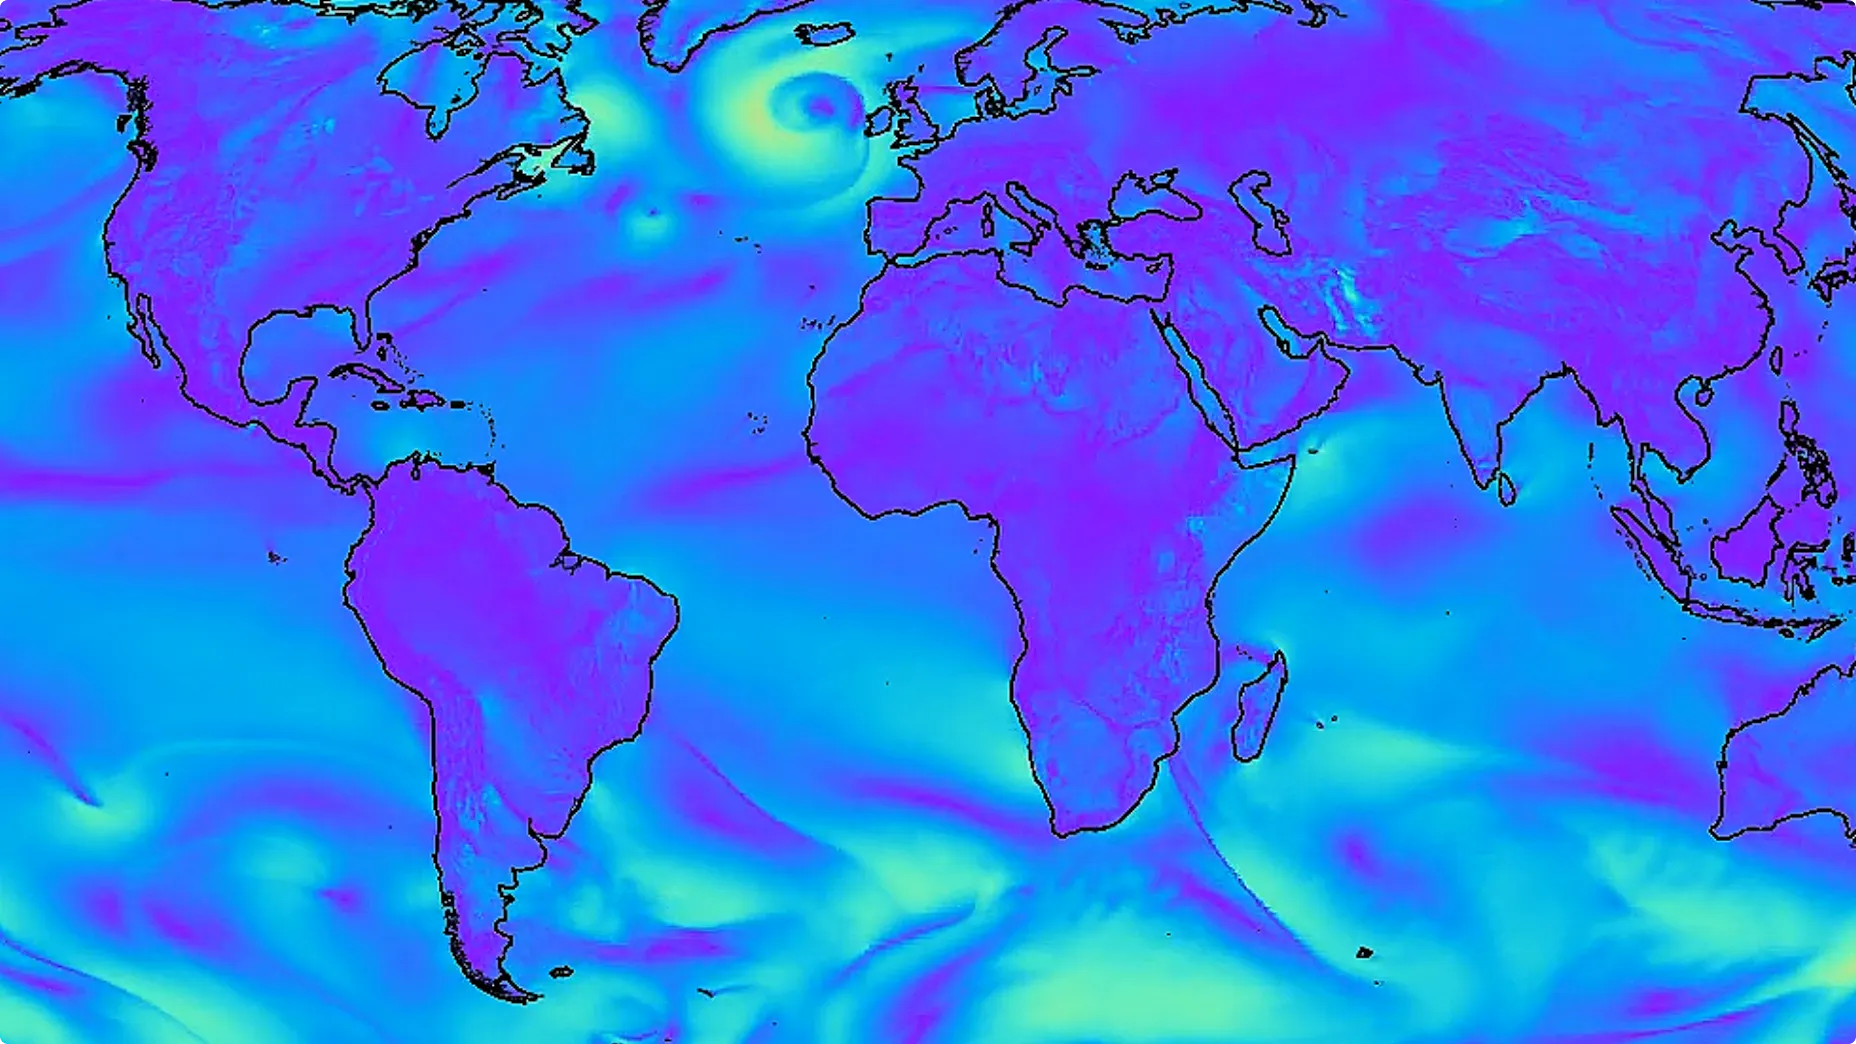
구글 딥마인드의 날씨 예측 AI 모델 그래프캐스트(GraphCast) 논문이 사이언스(Science)지를 통해 발표되었습니다. 원래 날씨 예측은 물리학적인 수식들을 슈퍼컴퓨터(supercomputer)로 계산하는 방식이었는데요. 이 방식은 전문적인 지식뿐만 아니라, 계산을 위한 컴퓨팅 자원이 많이 소요된다는 단점이 있었어요. 그래프캐스트는 수식 대신 데이터를 택했습니다. 지구 표면 전체는 위도/경도 0.25도씩의 작은 영역으로 나누어지고, 각 영역의 상태는 기온, 풍속, 기압 등을 나타내는 총 227개의 변수로 표현되는데요. 그래프캐스트는 현재와 6시간 전의 상태를 입력받아서, GNN(Graph Neural Network)을 이용해 6시간 이후의 변수들을 예측한다네요. 10일 동안의 날씨를 예측하는 데 1분 이하의 시간이 걸렸고, 정확도 측면에서도 뛰어난 성능을 보였다고 해요!
▶︎ 자세히 보기: https://bit.ly/47jEMnm
하자혜
마이크로소프트가 초보자를 위한 생성형(Generative) AI 강의를 공개했습니다. LLM(Large Language Model), 프롬프트 엔지니어링의 개념부터 오픈AI API를 이용한 채팅 앱, 달리를 이용한 이미지 생성 앱, 코파일럿(Copilot)을 이용한 로코드(Low-code) AI 앱 구현까지, 생성형 AI와 관련된 다채로운 내용을 다루고 있어요. 심지어 생성형 AI 앱을 위한 사용자 경험(UX) 디자인 팁까지 설명하고 있네요. 마이크로소프트는 생성형 AI 이외에도 초보자를 위한 인공지능, 데이터 사이언스, 웹 개발, IoT(Internet of Things), XR(Extended Reality) 강의도 제공하고 있으니, 관심이 있다면 아래 홈페이지를 방문해 보세요.
하자혜
오늘날 기업이 사용하는 데이터의 약 60%가 클라우드 서버에 저장돼 있다고 해요. 특히 아마존의 S3 서비스는 여러 주요 기업들이 데이터 저장을 위해 사용하고 있는데요. S3 서버에는 그만큼 민감한 정보가 많이 저장되어 있기 때문에, 랜섬웨어와 같은 공격의 표적이 되기 쉬워요. 이 기사에서는 S3 저장소를 대상으로 하는 랜섬웨어 공격을 예방하는 몇 가지 방법을 추천하고 있습니다. 우선 클라우드에 누가 어떻게 접근하는지 기록하기 위해, 여유가 된다면 'CloudTrail'과 같은 서비스를 이용하는 것이 좋다고 하고요. 이외에도 랜섬웨어 공격 시나리오를 이해하는 것, 사용자 권한을 적절하게 관리하는 것, 데이터 잠금(Lock) 기능으로 데이터가 삭제되지 못 하게 보호하는 것, 별도의 백업 저장소를 구축하는 것 등을 소개하고 있습니다.
▶︎자세히 보기: https://bit.ly/3sizIAl
하자혜
사람의 뇌파를 통해 생각을 읽어내는 것🧠. 왠지 SF 소설에나 나올 것 같은 이야기죠? 하지만 실제로도 연구가 되고 있는 주제 중 하나예요. 메타(Meta)가 사람에게 사진을 보여줬을 때의 뇌 신호를 측정해서 이미지를 재구성하는 내용의 논문을 발표했습니다. 사람의 뇌 활동을 측정하는 방법 중 하나인 'fMRI(기능적 자기 공명 영상)' 데이터는 해상도가 낮기 때문에, 그동안의 연구는 성능이 그리 좋지 않았는데요. 하지만 생성 모델이 발전하면서 fMRI 데이터로도 선명한 이미지를 얻을 수 있게 됐어요. 이번 논문에서는 fMRI보다 더 짧은 시간 동안의 뇌 활동을 측정할 수 있는 MEG(Magnetoencephalography) 데이터가 사용됐습니다. 모델을 학습시킬 때 이미지 임베딩(Embedding)에 MEG 신호 임베딩을 일치시키는 작업이 진행되고, 생성 단계에서는 잠재 확산(Latent diffusion) 모델을 통해 이미지가 생성된다고 해요.
하자혜
개발자 분들이 참고하면 좋을 블로그 글을 소개할게요. 이 글의 저자는 FAANG(Facebook, Apple, Amazon, Netflix, Google)와 같은 대기업과 스타트업에서 뛰어난 엔지니어들과 함께 일하면서, 그들이 작성한 코드에서 7가지의 공통된 습관을 발견했다고 해요. '컴퓨터가 아니라 사람(동료 엔지니어 및 사용자)을 위한 코드 작성하기', '코드 자체에서 벗어나기', '일관성 있는 형식의 코드 작성하기', '간결하고 깔끔한 코드 작성하기', '테스트를 통해 예상치 못한 결과가 나오지 않도록 하기' 등의 일곱 가지 습관들을 각각 소개하고 있고요. 소프트웨어 개발에는 다양한 예외 상황이 존재하기 때문에 이 규칙들은 유연하게 적용돼야 하며, 그 경우 기록으로 남겨두는 것이 필요하다고 강조했습니다.