대규모 언어모델에 지식을 주입한다면? -cokeBERT 논문 리뷰를 중심으로 (2)
저번시간에 cokeBERT와 같은 지식을 주입한 대규모 언어모델의 중요성에 대하여 알아봤습니다.
이번시간에는 cokeBERT의 구조와 방법론에 대하여 알아봅시다.
과연 cokeBERT는 어떤 구조를 가지고 있을까요?
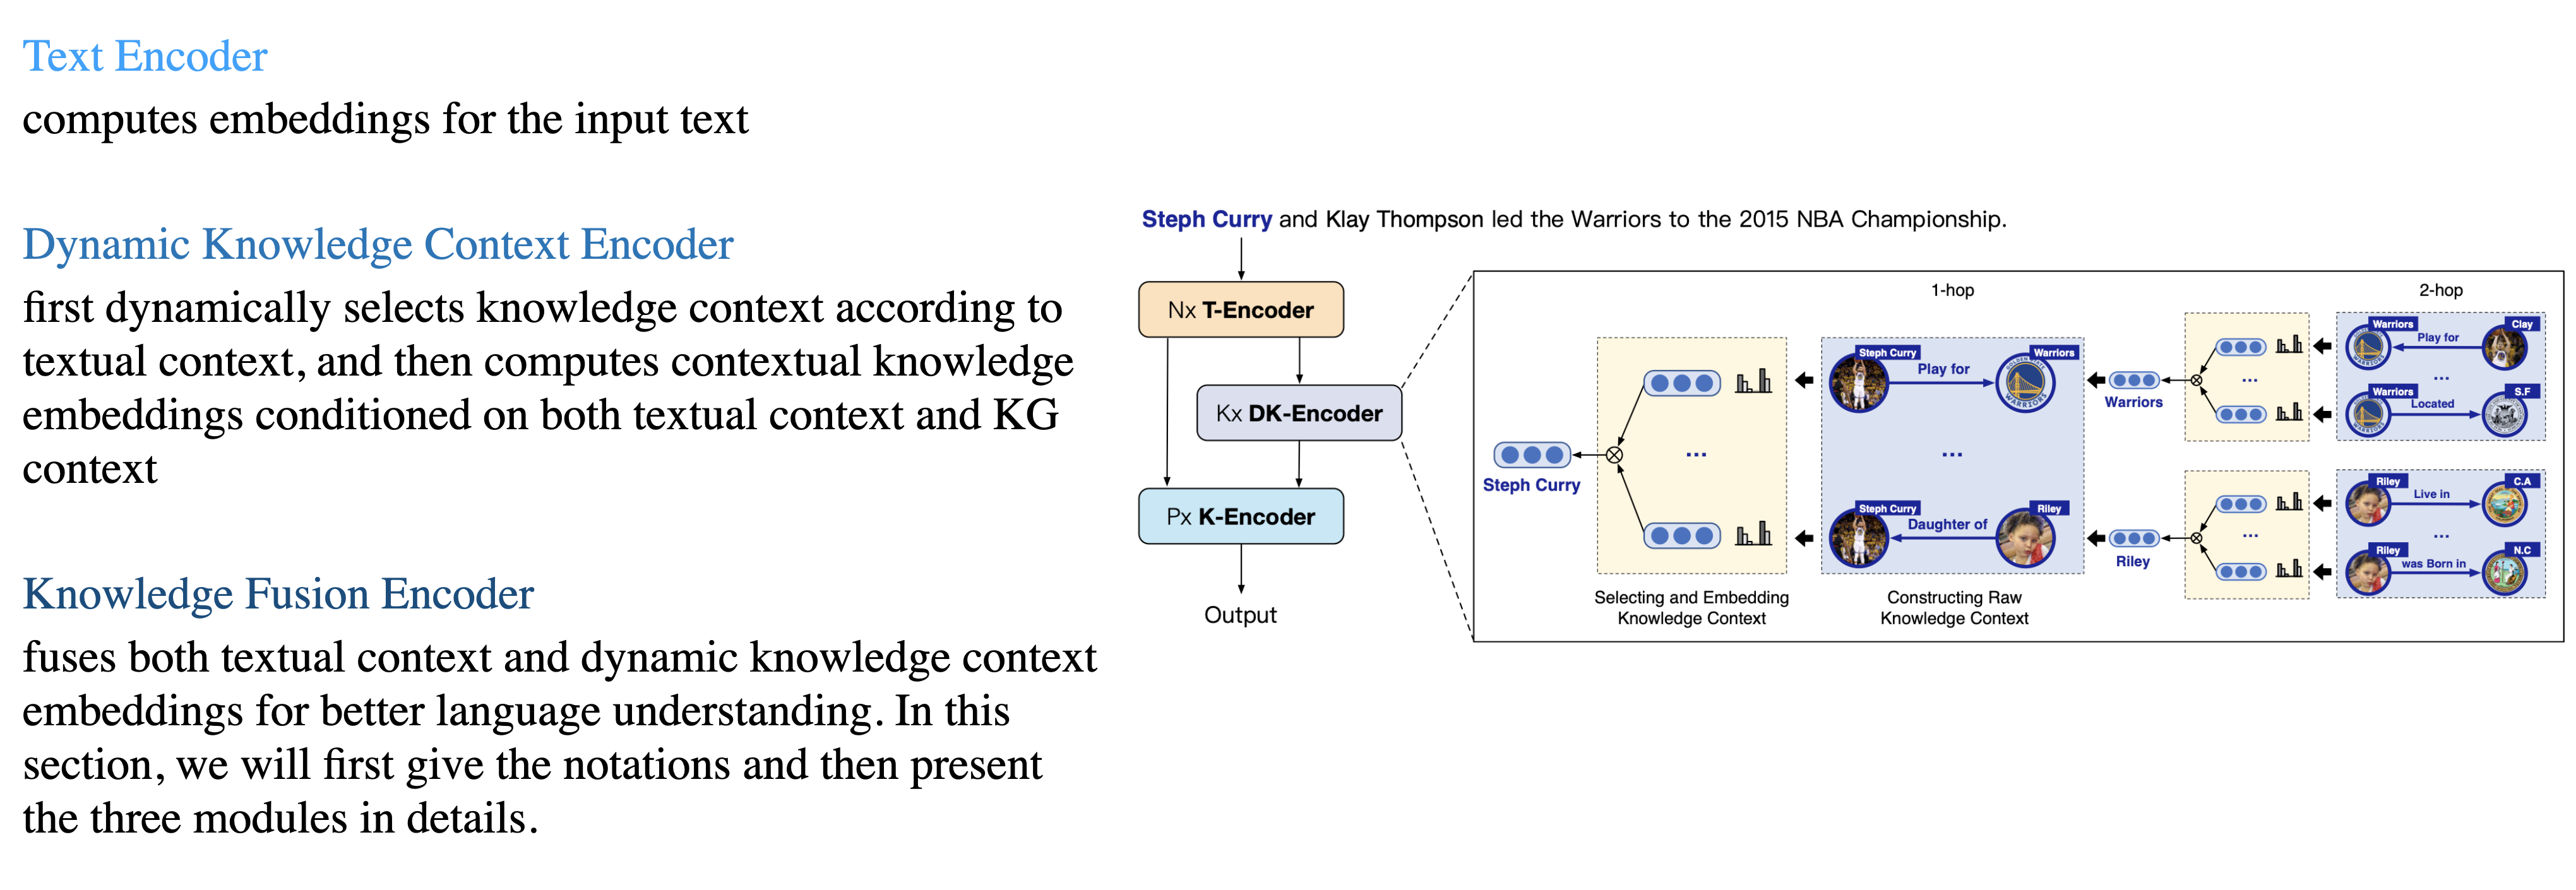
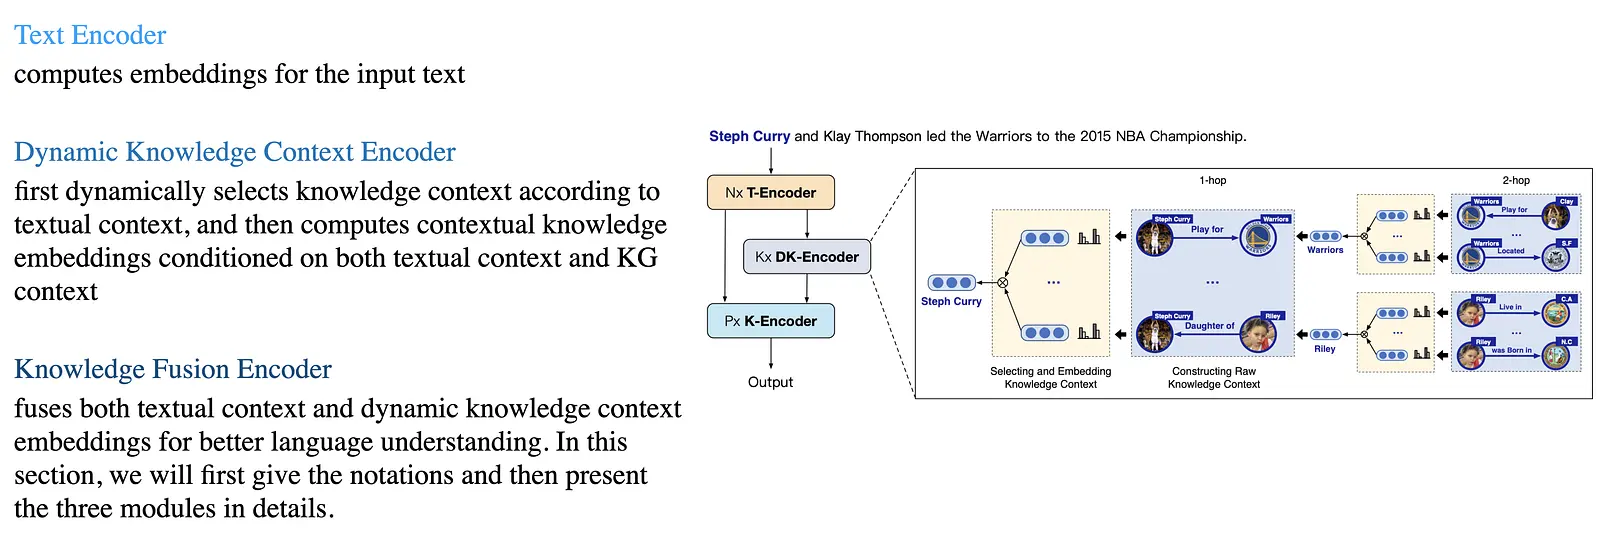
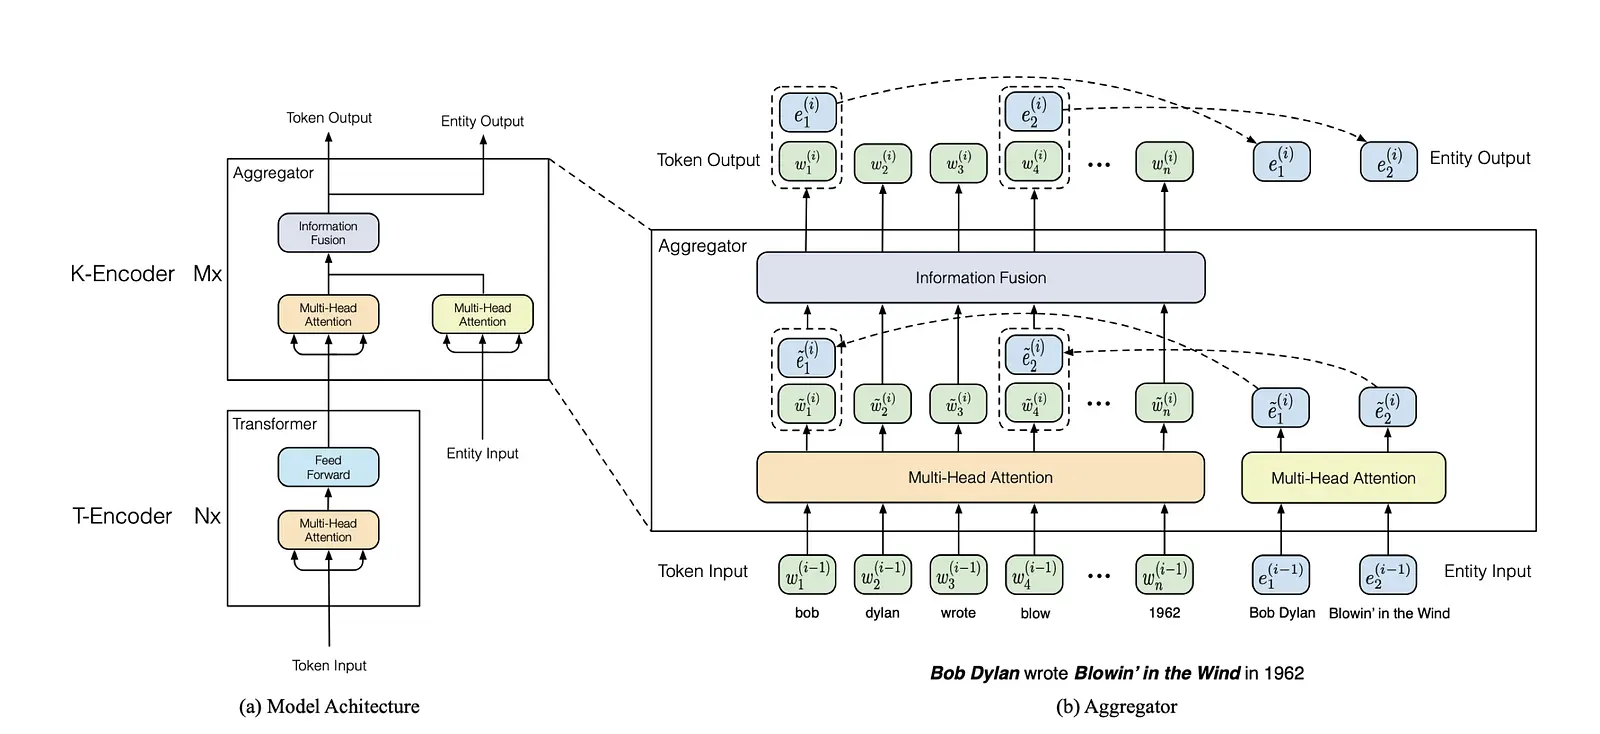
cokeBERT는 T-Encoder, DK-Encoder, K-Encode로 총 3가지의 Encoder를 가지고 있습니다.
T-Encoder는 Text-Encoder로 어떤 Text가 주어졌을 때, 문맥 정보를 뽑아내는 역할을 진행합니다. 문맥 정보라는 것이 어색하게 들릴 수 있는데, 쉽게 생각하면 컴퓨터가 알아보기 쉽게 문장을 숫자로 된 공간 벡터로 표현한 것을 의미합니다. 문장을 컴퓨터 차원으로 해석하는 것이죠!
DK-Encoder는 Dynamic Knowledge Context Encoder입니다.
쉽게 말하자면, Knowledge-Graph로부터 우리가 주목하는 Entity와 연관된 Sub-graph를 가져오고 어느 Node를 주목할 지 동적으로 가중치를 부여하고 이 부여된 가중치를 이용해서 재구성한 Graph 데이터를 컴퓨터가 알아듣기 쉽게 숫자로 임베딩을 하는 과정입니다. 즉, 주제와 연관성이 높은 Node를 선택하고 임베딩하는 과정이라고 생각하면 쉽습니다.
K-Encoder는 Knowledge Fusion Encoder로 DK-Encoder로 부터 나온 그래프 임베딩 벡터와 T-Encoder로 부터 나온 Token 차원 임베딩 벡터를 적절히 조화해서 컴퓨터가 문장을 해석하는 단계입니다. 즉, cokeBERT에서 결과를 도출하는 마지막 단계입니다.
각 단계를 자세하게 알아볼까요?
알아보기 전에 논문을 읽기 위한 필수 Notation에 대해서 먼저 알아봅시다. 수식이 등장할건데 이해하면 아주 쉬우니까 따라와봅시다!
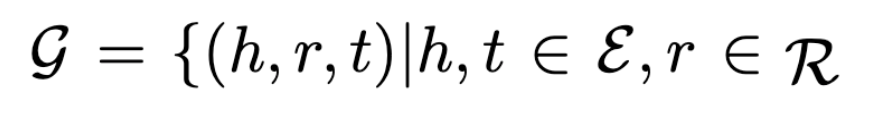
그래프에서 표현하는 'G'입니다.
KG는 앞서 말했듯이 Entity들을 Relation으로 엮어주는 그래프입니다.
h는 head, t는 tail을 의미하며 그래프에서 특정한 Edge, 즉 간선이 Head entity (h)에서 Tail entity (t)로 relation (r)을 가지고 있으면 (h,r,t)로 표현을 합니다.
그래프에서 모든 Entity 집합인 E와 relation 집합인 R이 만족하는 모든 (h,r,t) Edge 정보를 담은 set이 'G'입니다.
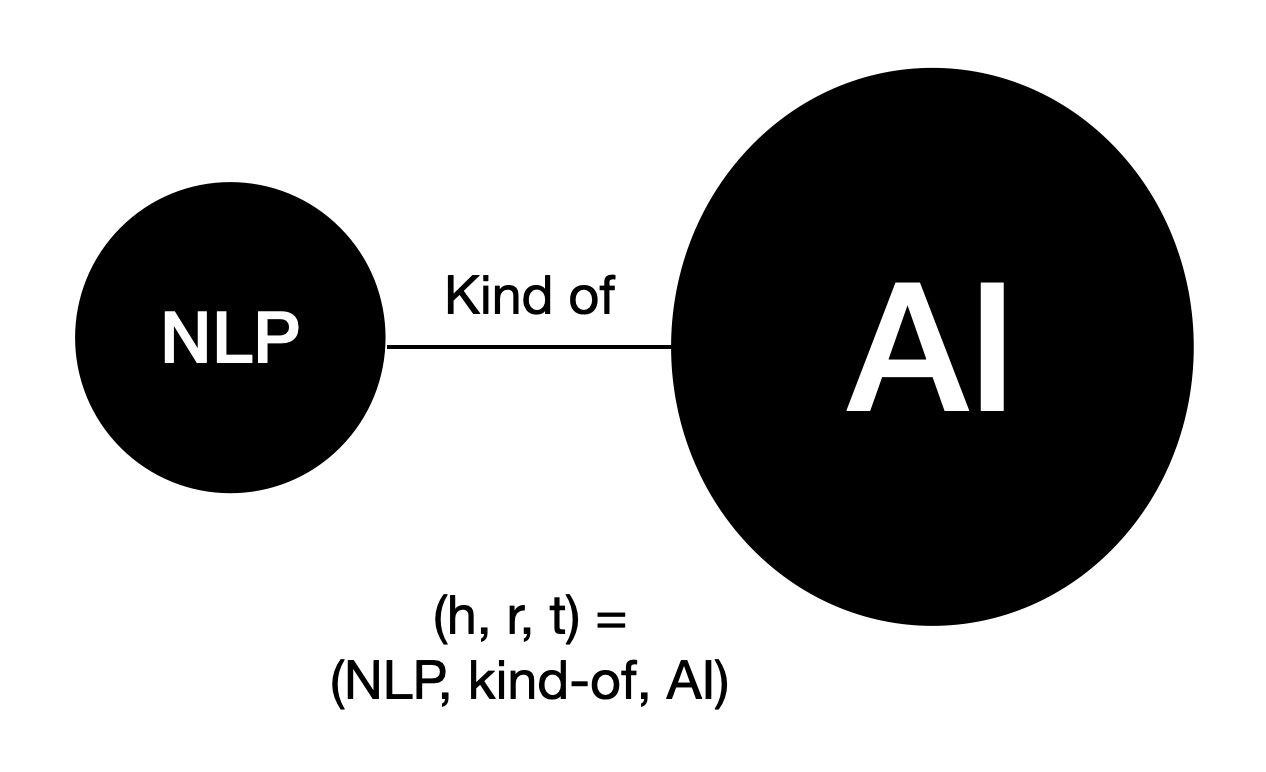
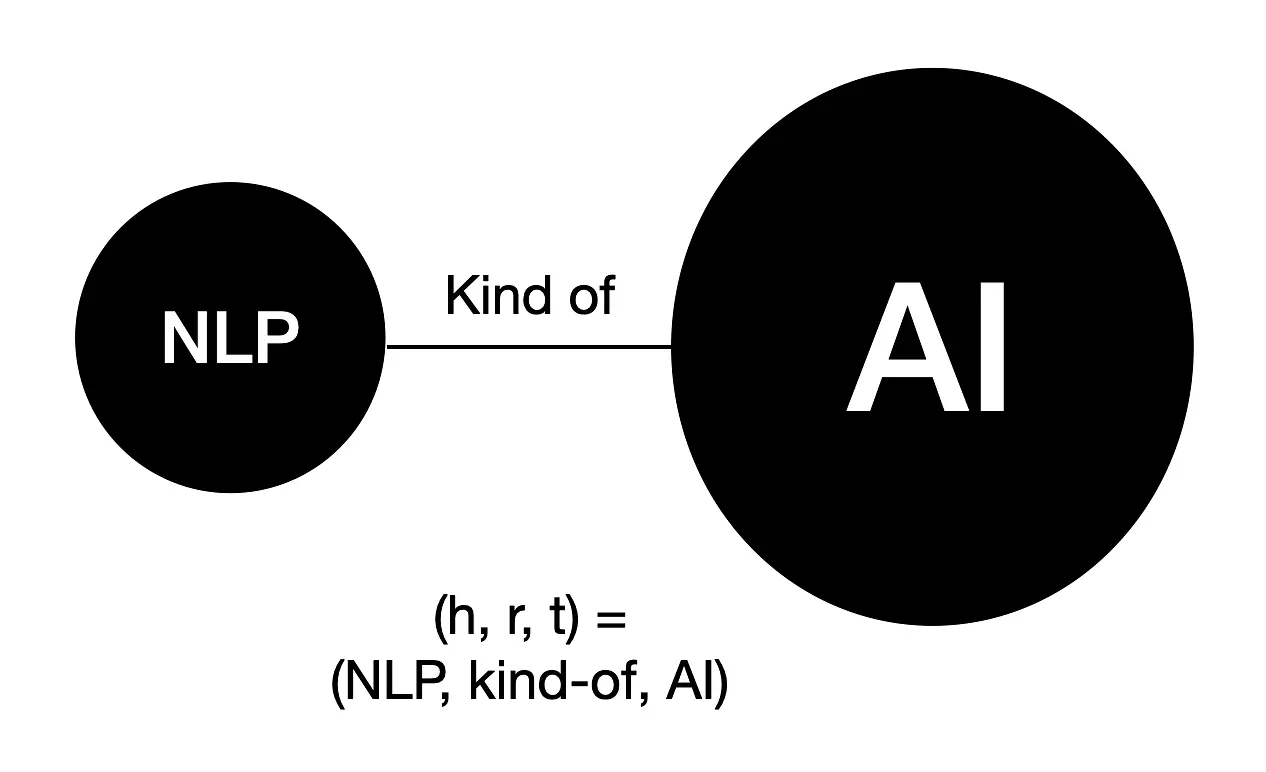
위 그림과 같은 KG가 있다면 NLP와 AI를 연결하는 Edge의 정보에서 head는 NLP, relation은 'kind-of', tail은 AI가 됩니다.
별로 어렵지가 않죠?
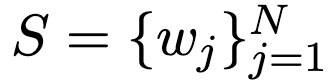
위와 같은 표현도 등장하는데, 아주 간단합니다.
컴퓨터는 String 타입을 해석할 수 없으니 문장을 Token들로 잘라서 BERT나 Roberta에 넣어줍니다. 그래서 S를 토큰들의 집합, w는 토큰, j는 인덱스 N은 전체 토큰의 수라고 생각하면됩니다.
이때 토큰과 Entity는 다를 수 있다는 것이 중요합니다.
여기서 정의한 Entity는 문장에서 골지, 즉 본체가 되는 단어를 의미하기 때문에 모든 토큰이 Entity가 될 수 없습니다.
이제 Notation을 모두 공부해보았으니, Encoder를 분석해봅시다!
우선 첫번째 T-Encoder부터 알아봅시다
T-Encoder
이 논문에서 활용한 T-Encoder는 BERT와 Roberta 두 모델을 활용했습니다.
cokeBERT의 저자는 우선 문장에서 문맥을 파악하기위한 Feature Extraction을 위한 모델로 이미 다양한 분야에서 SOTA를 달성한 BERT와 Roberta를 사용했습니다.
BERT와 Roberta는 두 모델 전부 Transformer-Encoder를 활용한다는 점에서 공통점이 있으며 Making 기법, 즉 MLM 등에서 차이점이 있으나 Roberta는 단순하게 BERT를 조금 더 업그레이드한 버전이라고 생각하면 됩니다.
이제 이 논문의 하이라이트인 DK-Encoder를 분석해보겠습니다.
DK-Encoder
DK-Encoder는 총 2가지 단계로 나뉘어 있습니다.
- Constructing Raw Knowledge Context
- Selecting and Embedding Knowledge Context
우선 첫번째, Constructing Raw Knowledge Context에 대해 알아봅시다.
KGs는 데이터의 크기가 엄청나게 거대합니다. 우리가 가진 전체 지식처럼요. 이 거대한 KGs을 모두 PLM에 결합을 한다면 메모리 효율성이 낮을 수 밖에 없습니다. 문장과 관련이 있는 몇 개의 토막 지식들만 가지고 문맥을 해석하는 편이 훨씬 좋겠군요!
그래서 KGs 전체를 사용하는 것이 아닌 텍스트에서 주어진 Entity와 연관이 있는 몇 개의 sub-graph를 가져옵니다.
이 논문에서는 K 개의 Edge 거리를 가진 Node까지 Sub-Graph를 가져오는 K-hop를 이용합니다.
그 알고리즘은 다음과 같습니다.
왼쪽에 있는 E는 m을 중심으로하는 i-hop의 집합입니다.
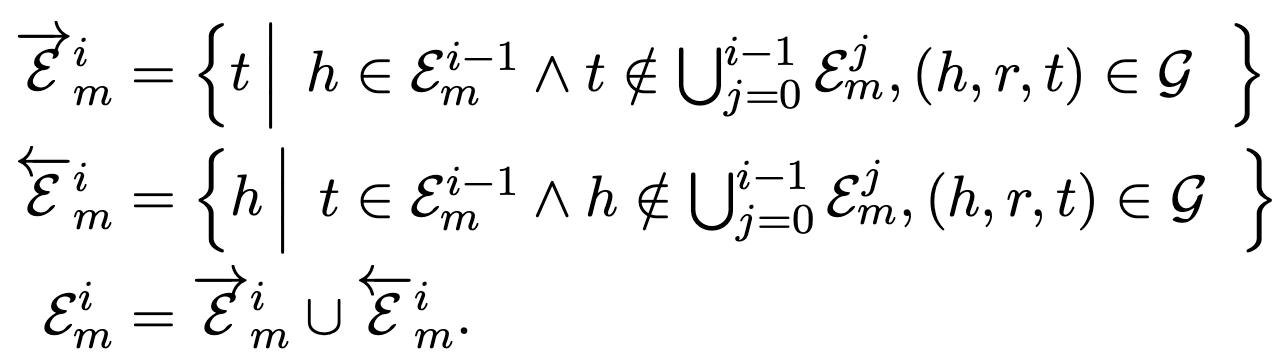
쉽게 설명하면 다음과 같습니다. head 노드는 (i-1)-hop에 속하면서 tail 노드는 0에서 (i-1)-hop에 속하지 않습니다. 이 head와 tail이 relation r을 가진다면 tail은 i-hop를 가질 수 밖에 없습니다!
반대인 경우도 마찬가지이구요.
두 경우의 합집합이 i-hop 전체 집합이 되겠군요!
자 이제 Sub-graph는 다음과 같이 정의할 수 있습니다.
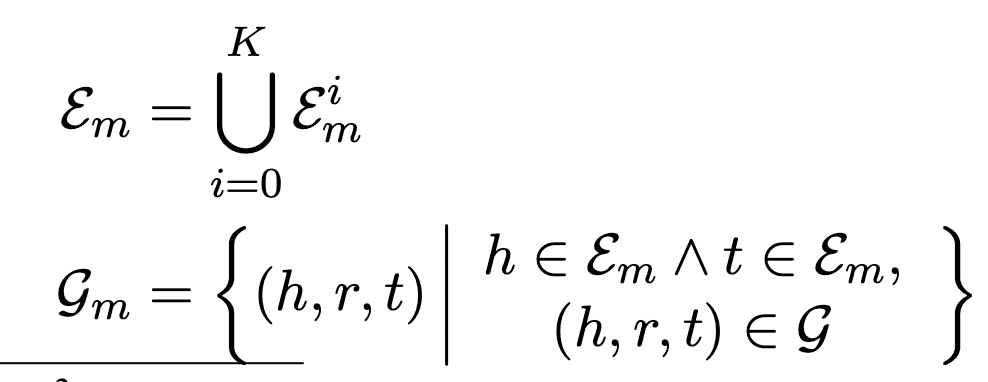
Sub-Graph 데이터는 0-hop부터 K-hop까지의 엔티티의 집합이라고 생각할 수 있겠군요! (K 값은 실험 환경에 따라 변경했습니다.)
Entity m을 중심으로하는 G또한 head와 tail이 모두 Sub-graph에 속하면서 relation을 가지는 (h,r,t)집합으로 정의합니다.
자 이렇게 Graph로부터 Entity 집합과 Sub-graph Gm을 모두 추출했습니다.
이제 제일 중요한 단계인, 가중치 부여가 남았습니다.
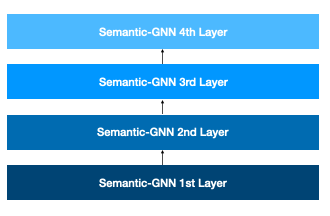
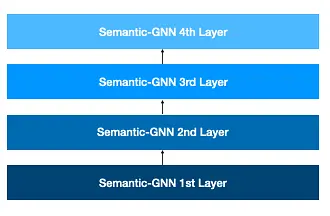
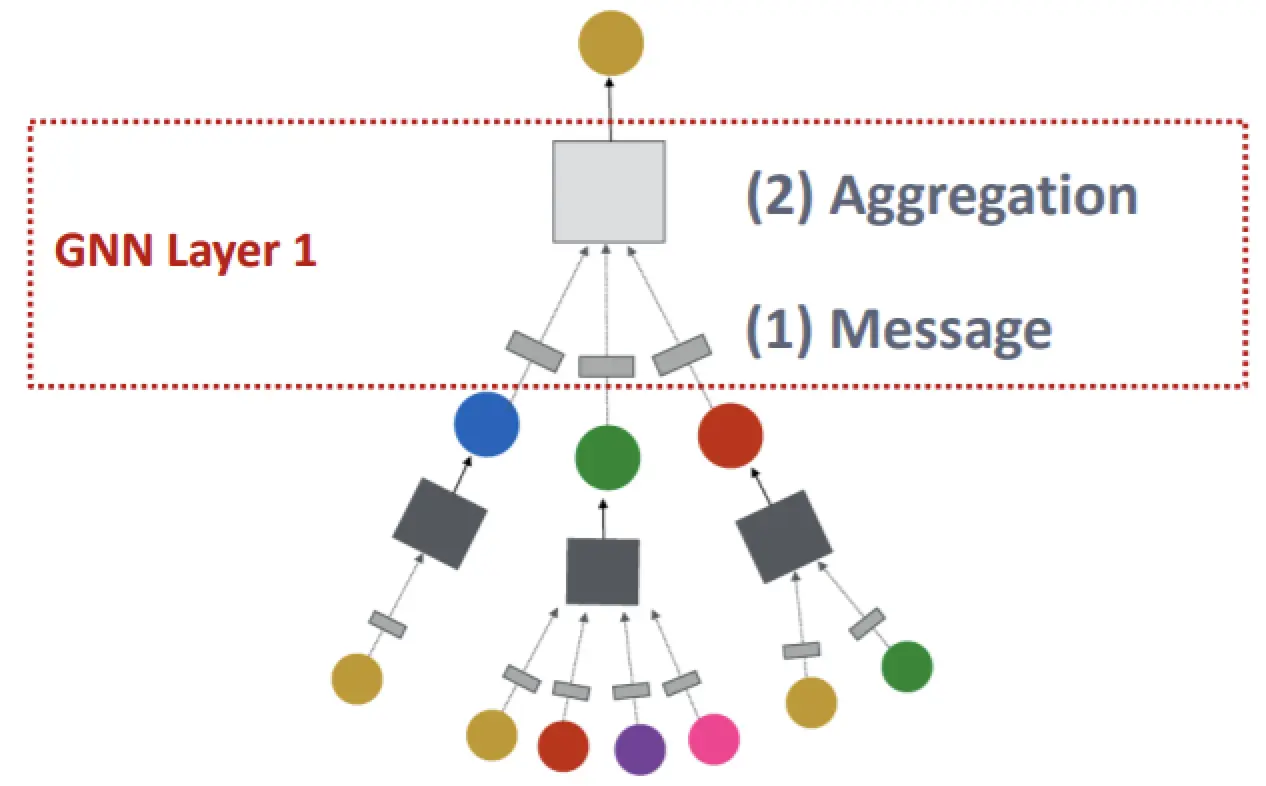
cokeBERT에서는 여러 층의 Semantic-GNN을 사용해서 임베딩하고 가중치를 부여합니다. 이제 GNN 각 층에서 이루어지는 계산에 대해 알아봅시다.
그전에, (h,r,t)를 벡터화 시키는 방법론에 대하여 알아볼까요?
어떤 벡터표현이 (h,r,t)를 잘 임베딩했다고 생각될 수 있을까요?
예를 하나 들어보겠습니다.
대한민국 + 수도 = 서울
미국 + 수도 = 워싱턴D.C.
오스트리아 + 수도 = Wien
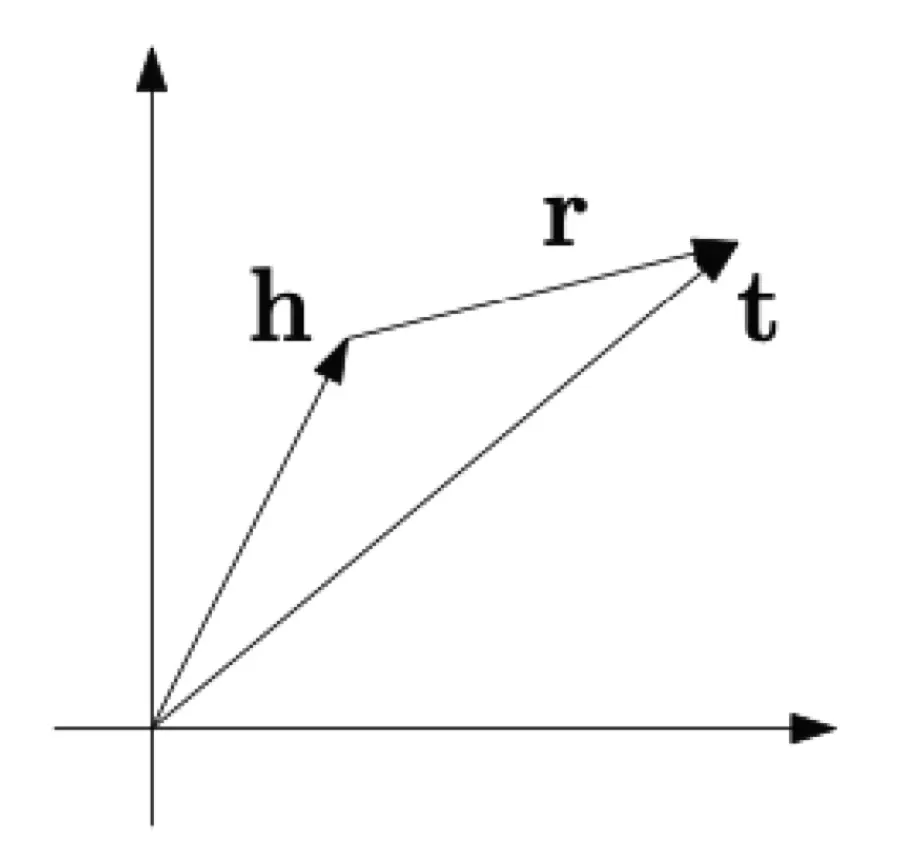
등과 같이 head(국가명)에 Relation(수도)을 더하면 tail(수도명)에 향하도록 벡터화 시키면 어떨까요? 다음 그림을 보면 이해가 편할거에요.
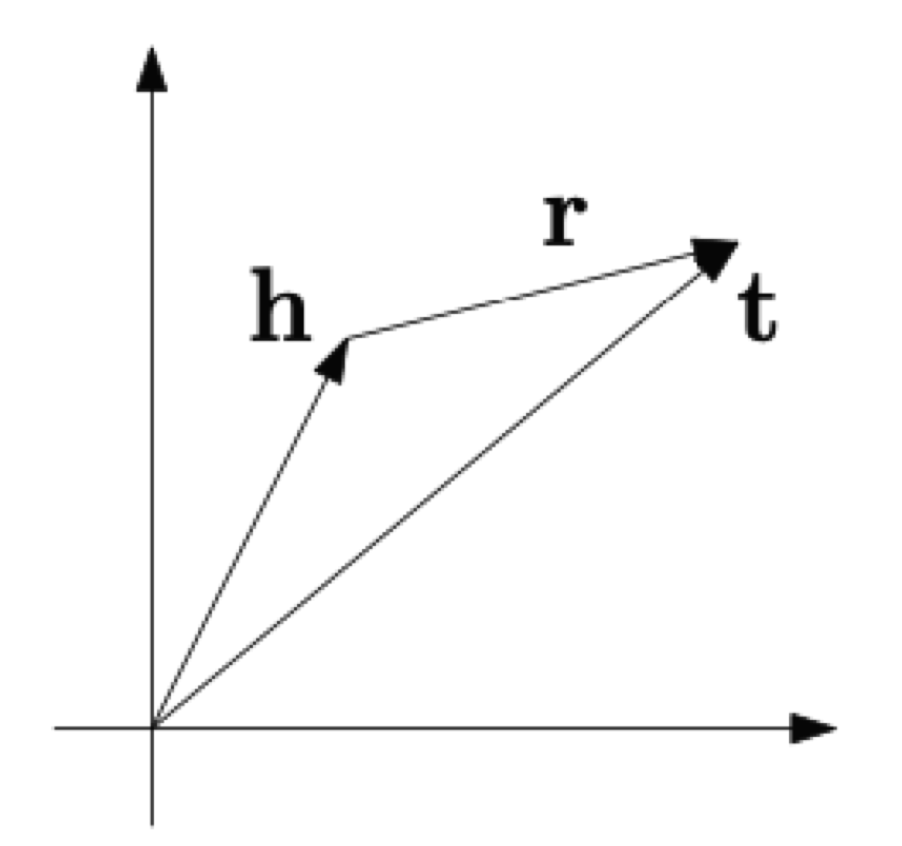
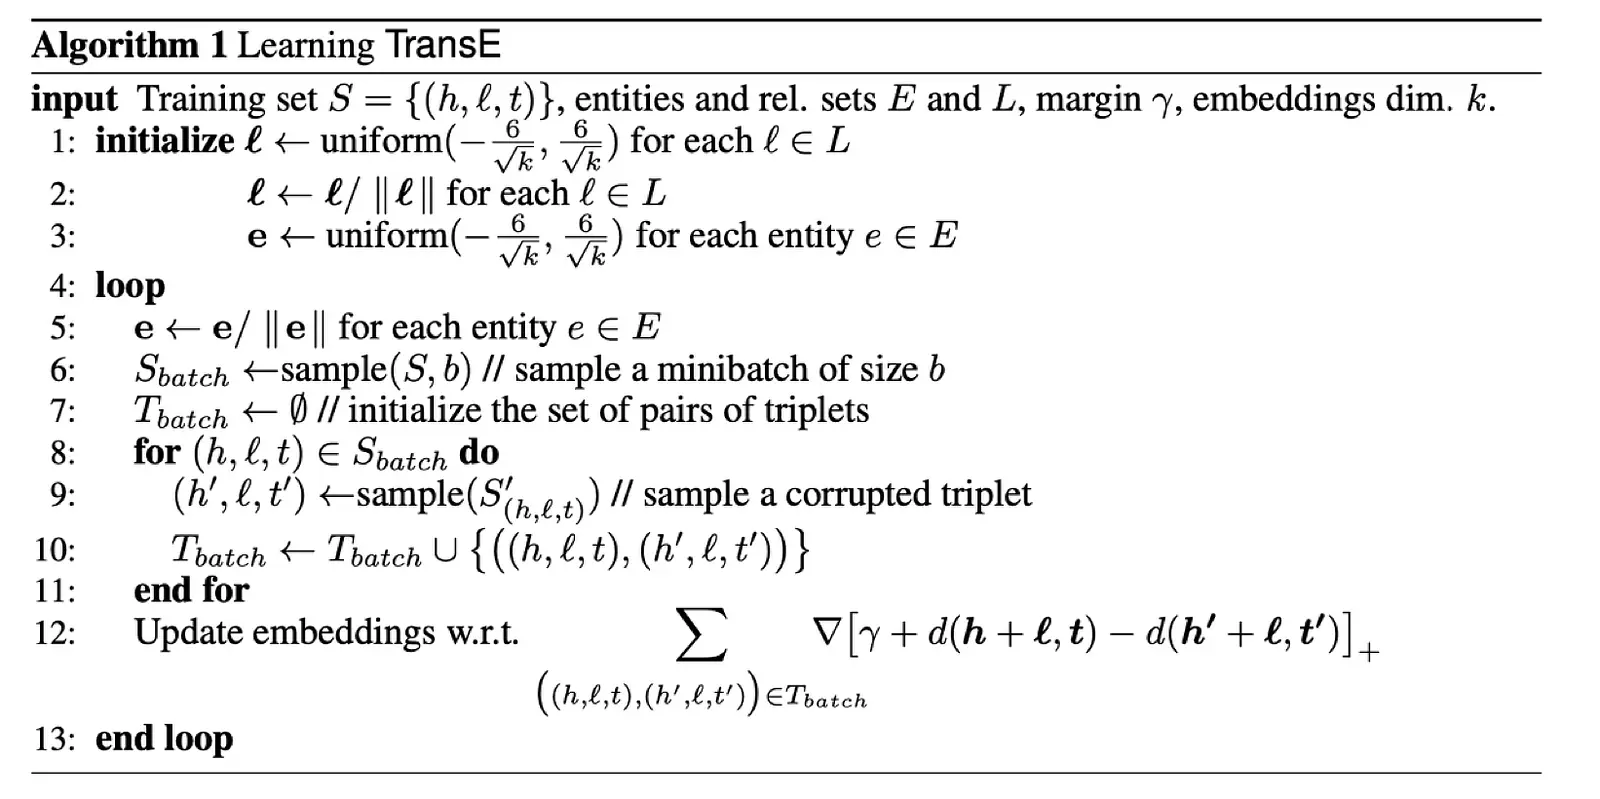
위 벡터 임베딩을 활용하는 대표적인 방법으로는 이 논문에서 인용한 TransE라는 방법이 있습니다.
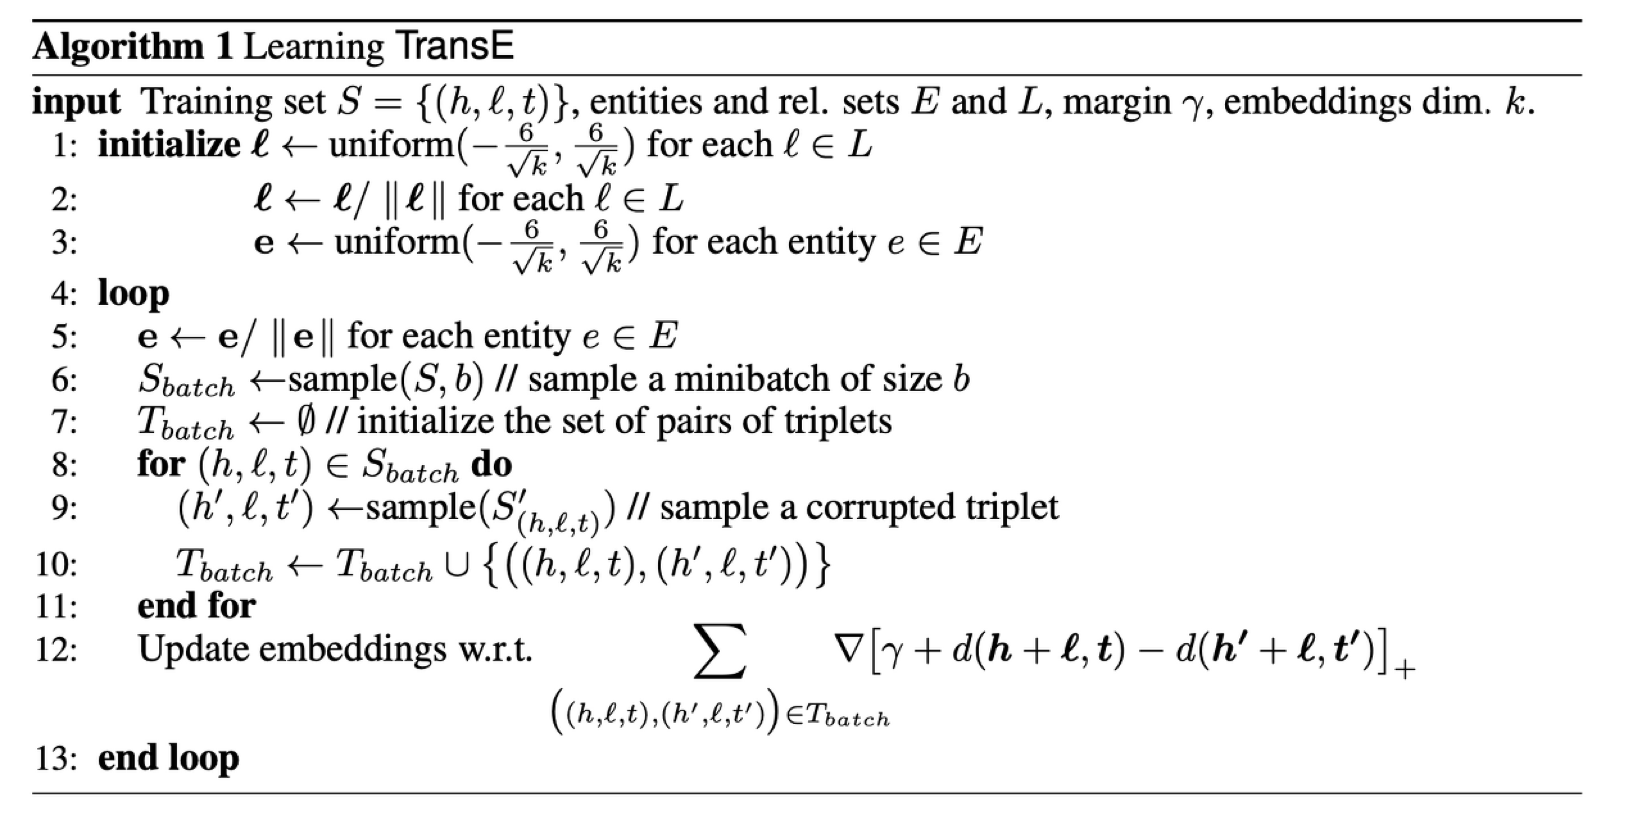
알고리즘이 길지만 간단하게 분석해보면 총 3가지 단계로 이루어져 있습니다.
첫번째 h,r,t를 각각에 대해 정규화합니다.
두번째, head 와 tail을 Corrupt 시켜줍니다.
세번째, Loss가 감소하는 방향으로 임베딩을 업데이트합니다.
여기서 의문점이 생겼습니다! 왜 Entity를 Corrupt 시킬까요?
만약에 위 예에서 대한민국이 아니라 모니터가 들어온다고 생각해봅시다.
이 경우에는 모니터에서 수도를 더한 벡터는 최대한 서울과 멀어져야 할 것입니다. 모니터는 서울을 수도로 가질 수 없으니까요! 이처럼 head가 Corrupt 즉 변형되었을 때, relation을 더한 벡터가 최대한 Corrupt된 tail과 멀어지게 Loss 함수를 선택했습니다.
그리고 Corrupt 되지않은, 즉 원래 상태의 head와 relation을 더하면 tail에 가까워지도록 다음과 같은 Loss 함수를 설정해주면 완성입니다.
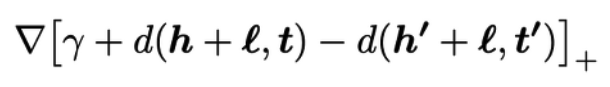
(Gamma는 Loss값이 -가 되는 것을 방지해주는 margin 값입니다.)
CokeBERT에서는 TransE 방법을 통해 Entity, Relation을 임베딩했습니다.
이 임베딩한 Entity와 Relation을 가지고 GNN층을 이해해봅시다.
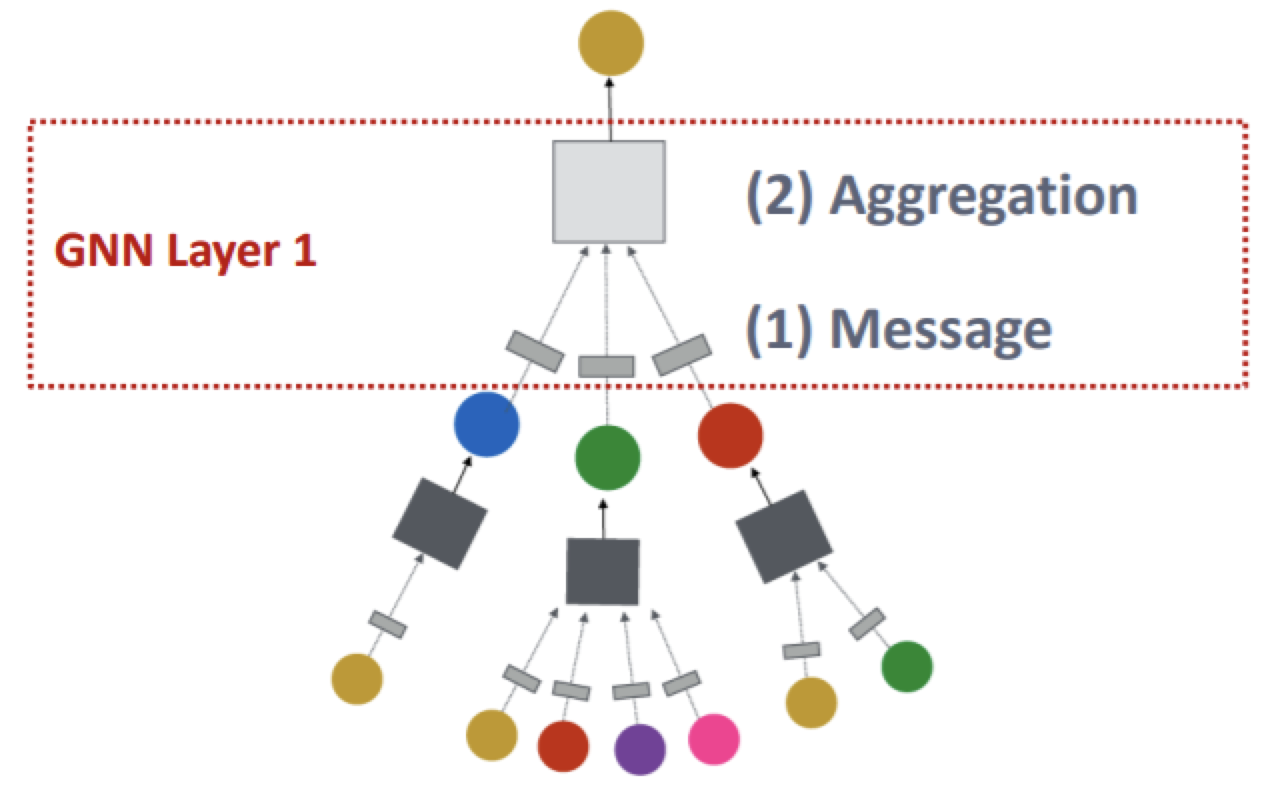
GNN각 층에서의 Hidden Layer의 수식은 다음과 같이 정의됩니다.
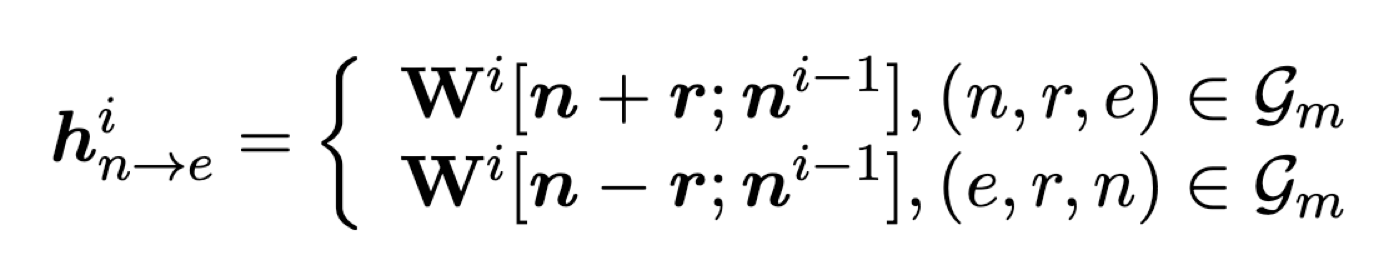
(i-1이 지수로 올라와있지 않은 n과 r은 TransE로부터 계산된 임베딩 벡터값입니다.)
i번째 Hidden Layer중 entity n에서 entity e로 향하는 값은 n과 r의 벡터합과 i-1번째 Layer에서 (후술할 어텐션 메커니즘을 통해)가중치를 부여해서 계산된 n벡터의 concatenation을 한 후 학습가능한 가중치 벡터 W에 곱한 값입니다.
n+r 벡터는 e벡터로 향할 것이고, 이전 Layer에서 가중치 값, 즉 문장에서 중요도를 파악한 n벡터와 같이 W에 곱해주어서 n벡터의 오차를 보정하고 더 정확하게 e벡터로 향할 수 있게해줍니다.
이제 e의 모든 Neighborhood에 대하여 가중치를 부여하는 f함수를 적용시키면 i번째 Layer에서의 e 벡터가 완성이됩니다!
그럼 도대체 f함수가 어떻게 가중치를 부여할까요?
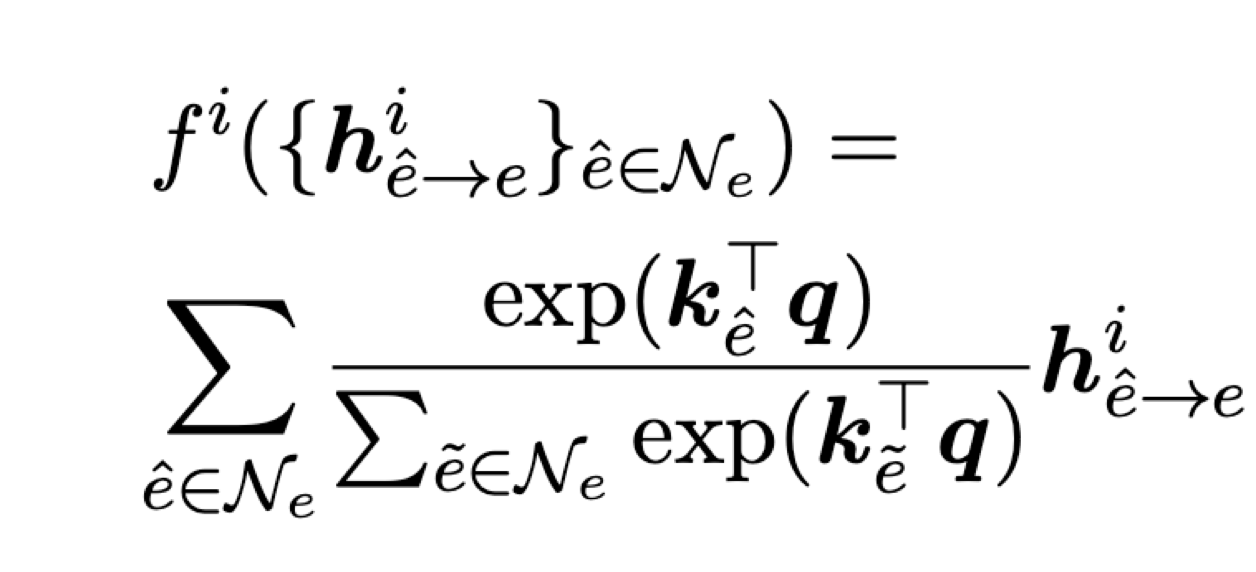
f-함수는 위와 같이 정의됩니다. 많이 사용해왔던 어텐션 메커니즘과 동일합니다. Query와 Key를 통해 가중치를 정하고 이 가중치를 Value 값에 곱해주어서 어텐션 값을 부여합니다. (어텐션을 모르신다면 여기를 클릭해주세요!)
Query는
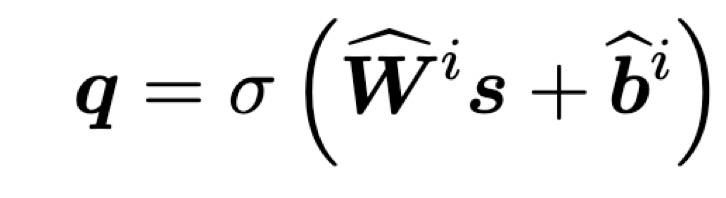
Key는
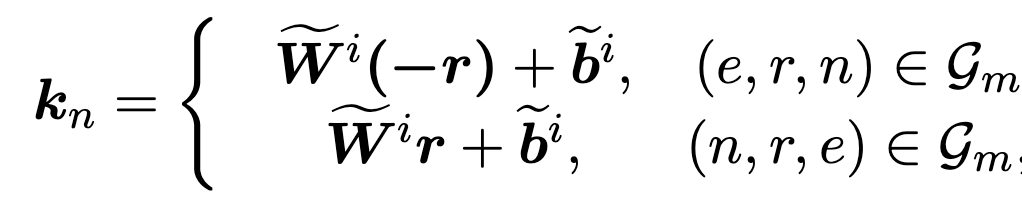
와 같이 정의가 되는데, 여기서 되게 재미있습니다.
보통의 self-attention과 달리 여기서 Query는 T-Encoder 즉 BERT로 부터 생성된 pooler output, 문맥 벡터(s)를 사용합니다. 또한, key는 relation을 사용합니다. 종합하자면 어떤 문장에서 문맥과 Entity들 사이에서 relation을 분석하여 가중치를 부여합니다.
이게 왜 중요할까요?
다음 문장을 살펴봅시다.
"스테판 커리와 클레이 톰슨이 주먹다짐을 하고있다."
해당 문장을 해석하기 위해선, warriors라는 소속팀도 중요하겠지만, 그보다 더 중요한 사전지식은 둘이 어떤 앙숙관계(relation)가 있는지가 더 중요하겠죠. 이처럼 문맥과 relation을 비교해서 더 적절하게 Entity들에 대해서 어텐션 값을 부여해줄 수 있습니다.
모든 Neighborhood에 대해서 어텐션 메커니즘을 진행해주고 더하면 비로소 가중치를 부여한 임베딩 벡터가 완성됩니다.
K-Encoder
사전지식과 문맥을 결합하는 Knowledge Fusion Encoder에서는 ERNIE라는 논문에서 사용하는 방법과 동일한 방법을 사용했습니다.
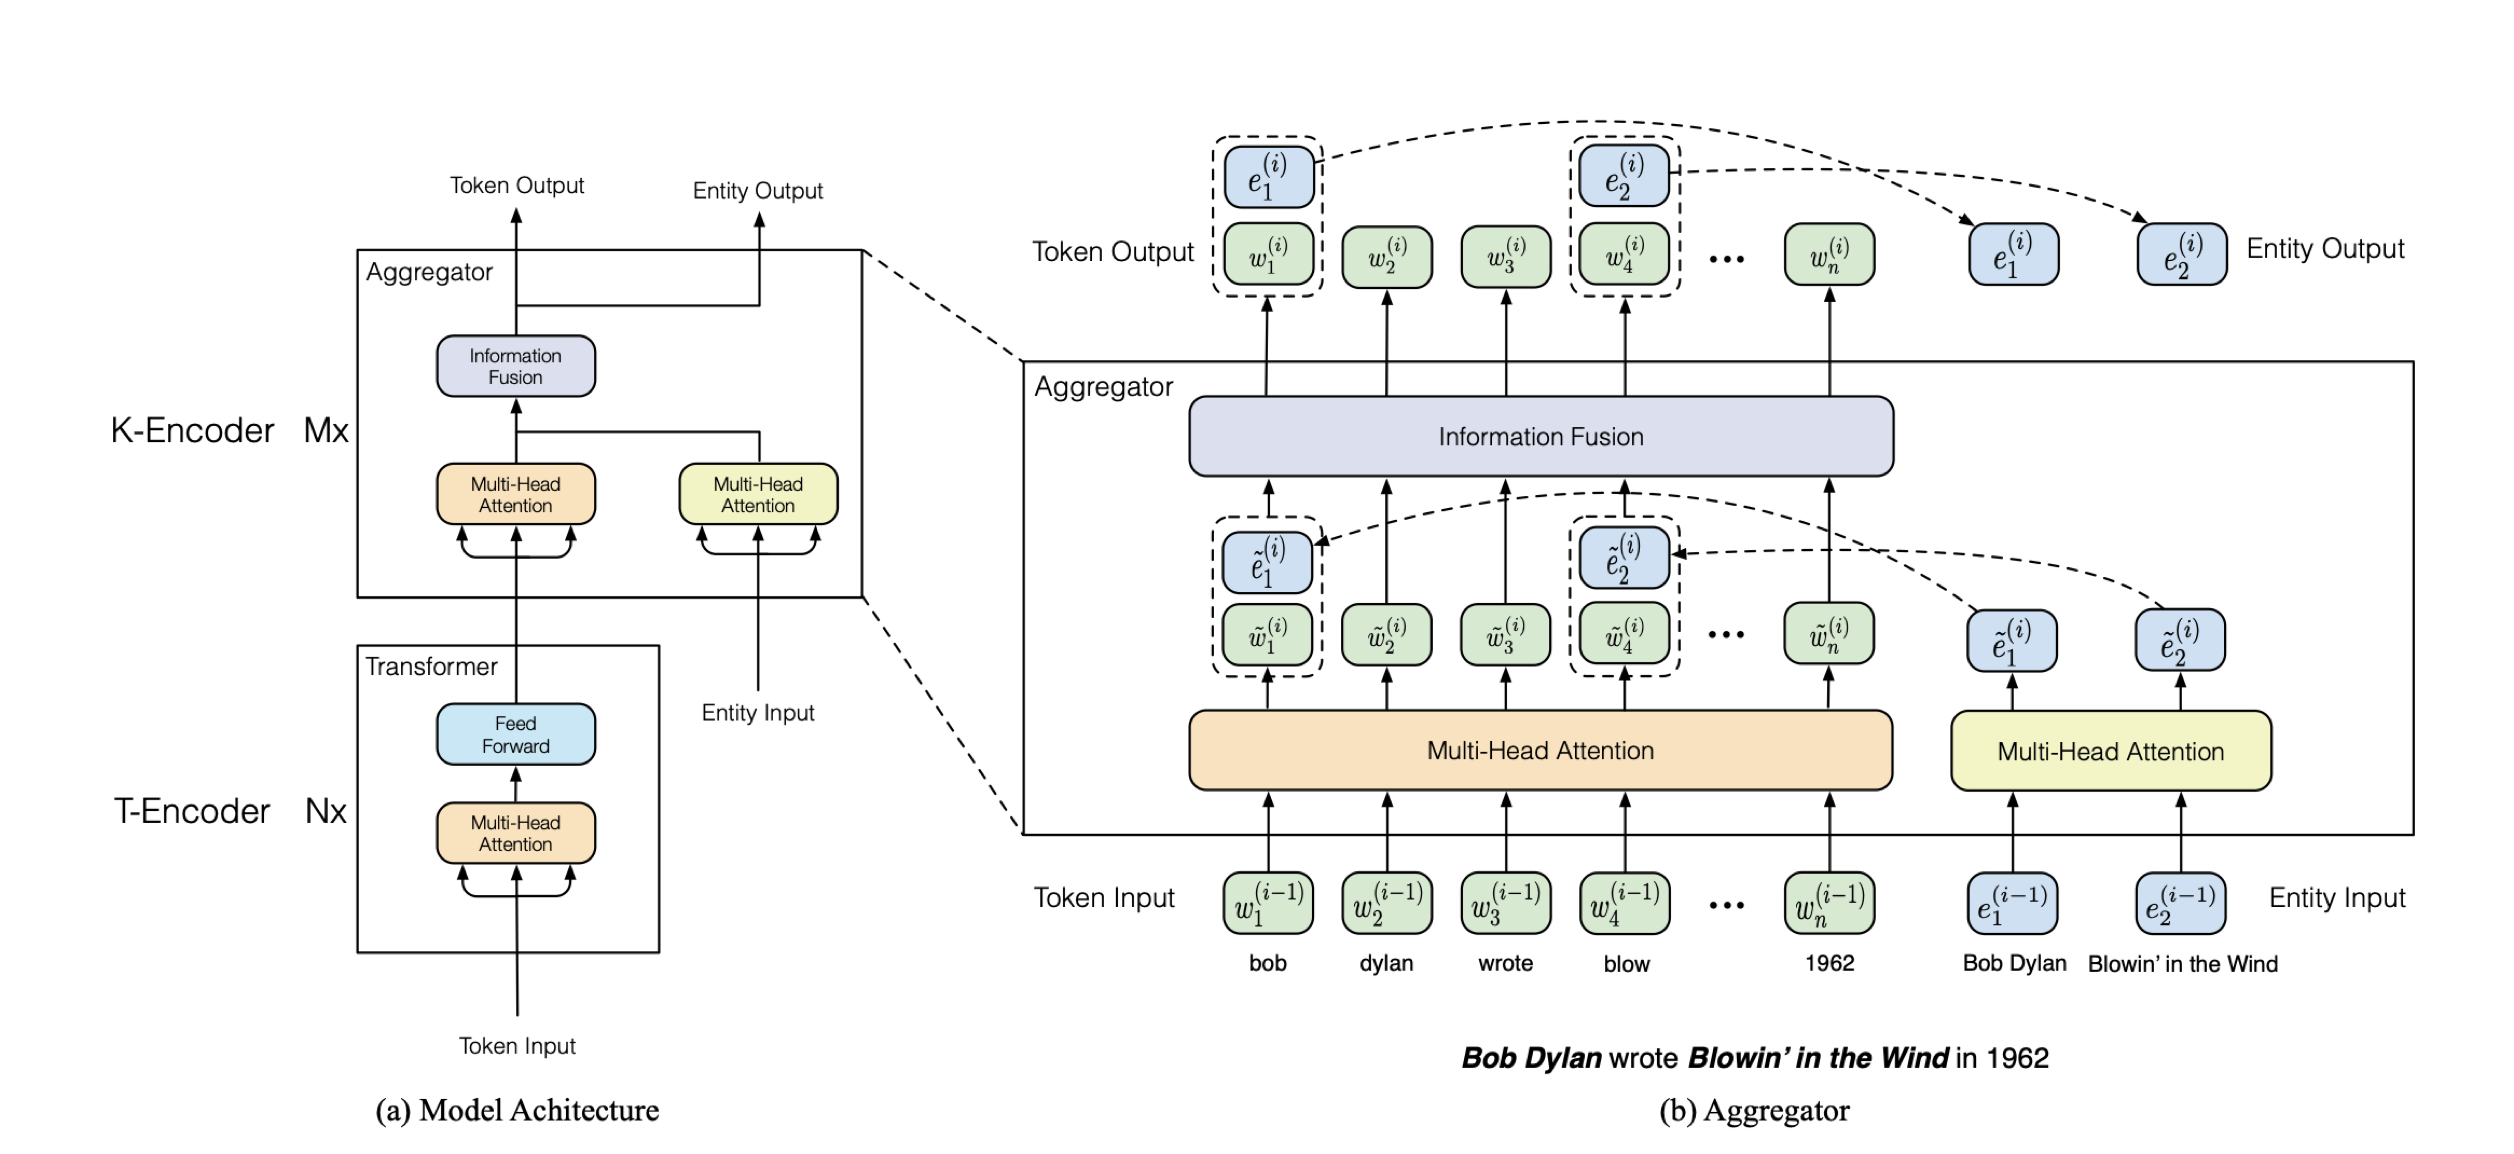
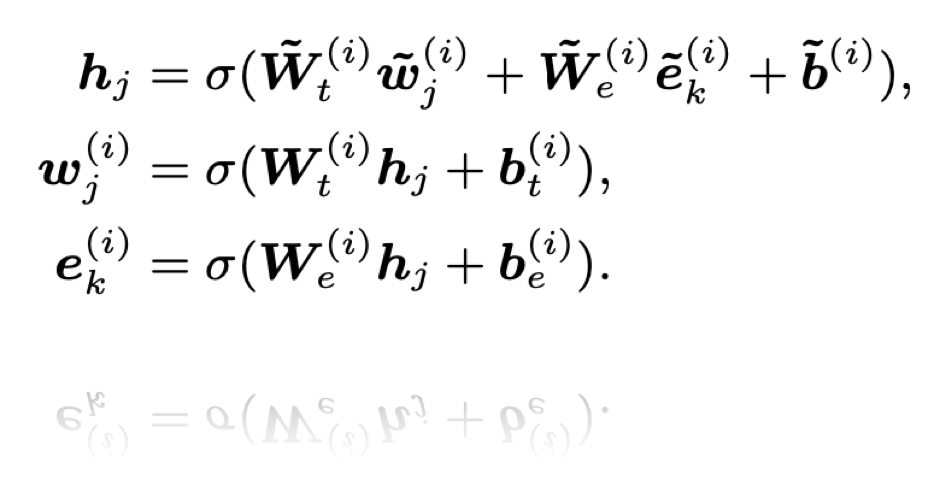
DK-Encoder로 나온 Entity 벡터와 BERT에서 구한 Token 임베딩 벡터를 위 수식으로 결합합니다.
단순히 말하면 Entity벡터와 Token 벡터를 적절히 섞은 h라는 벡터를 만들고, 그 mixture로 부터 Token 벡터와 entity벡터를 추출해서 다음 층에 넣어줍니다.
(h,w,e 벡터를 생성하는 과정은 모두 학습가능한 가중치 벡터를 사용해서 Loss에 따라서 업데이트가 가능합니다.)
이렇게 여러층의 K-Encoder층을 통과해서 비로소 모델이 완성됩니다.
이제 결과를 확인해볼까요?
RESULT
KGs
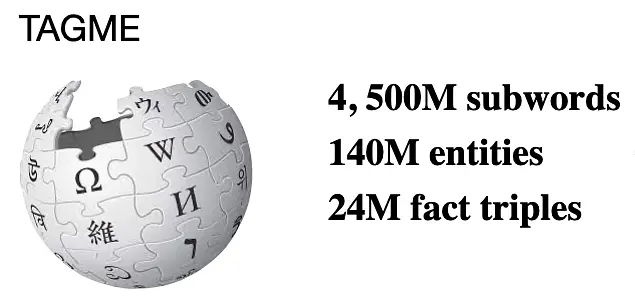
위키백과에서 h, r, t를 TAGME로 추출해서 KGs를 구성했습니다.
Task
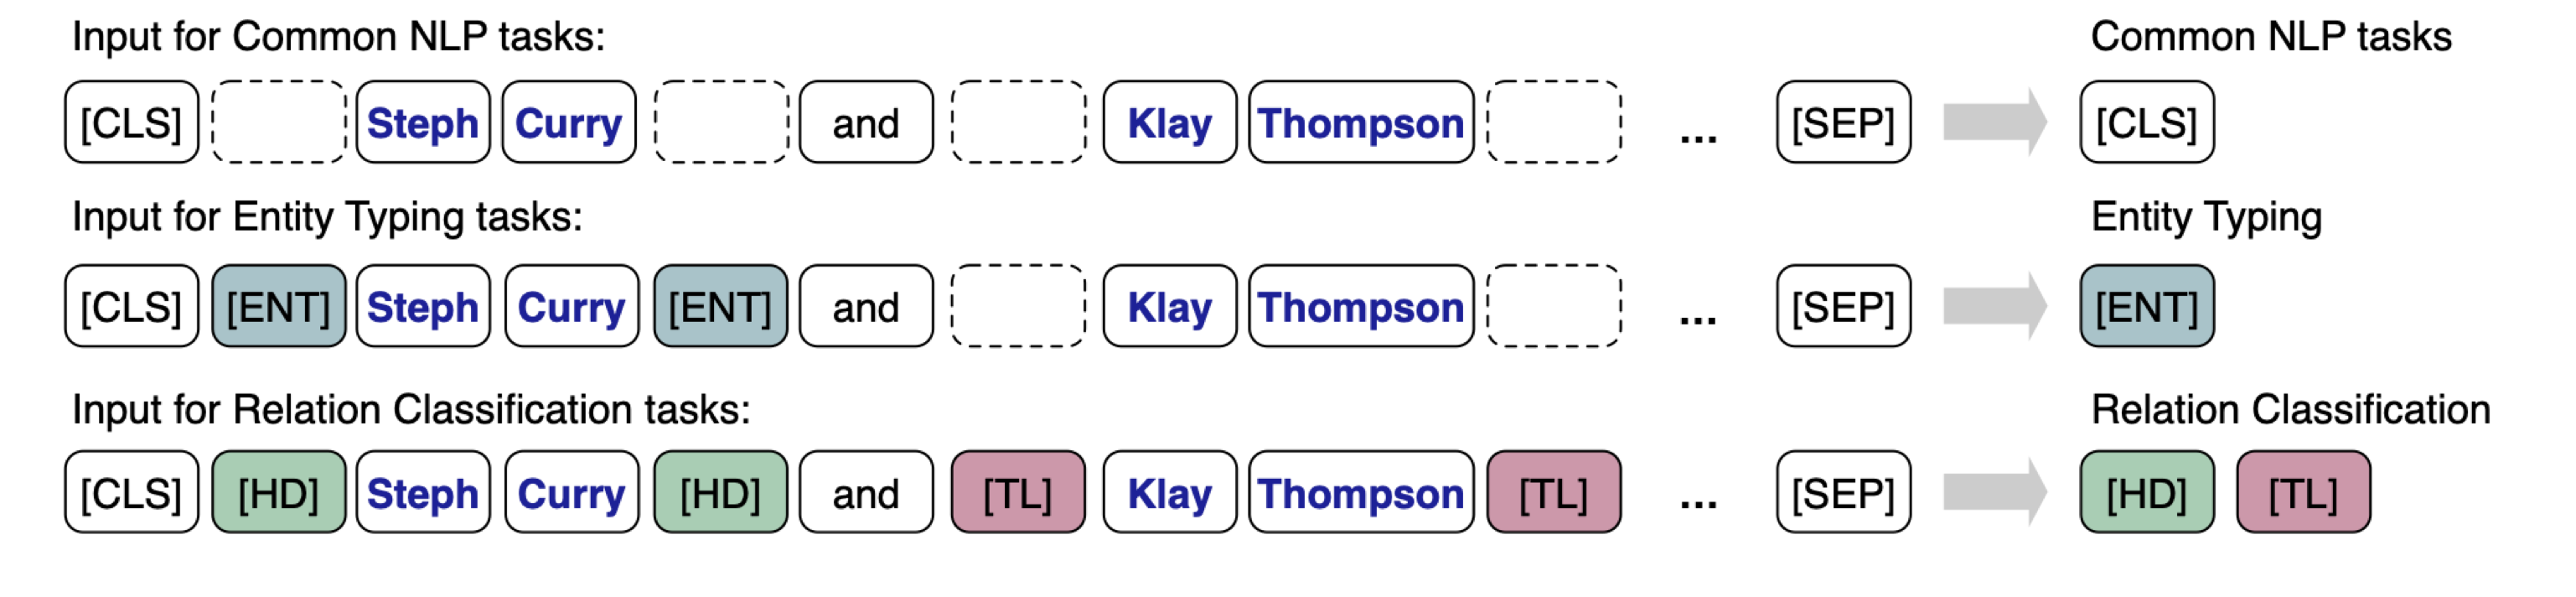
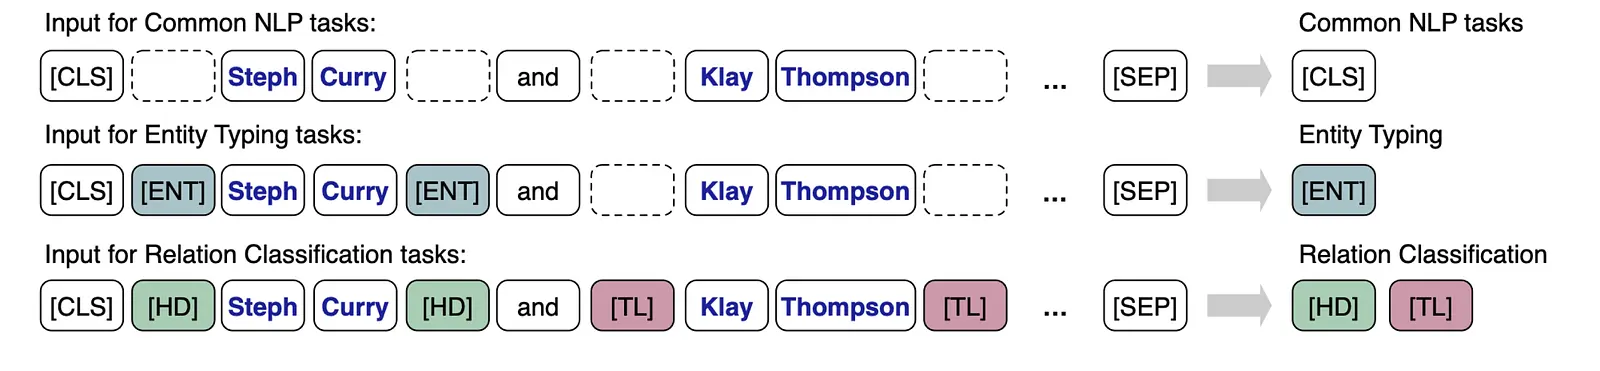
Task는 총 3가지 부여했는데, 첫번째는 BERT와 같이 CLS 토큰에서 문맥벡터를 추출하는 Task, 두번째는 Entity를 분류하는 Entity Typing, 세번째는 두 Entity들간의 Relation을 파악하는 Relation Classification이 있습니다.
자 이제 결과를 보시죠!
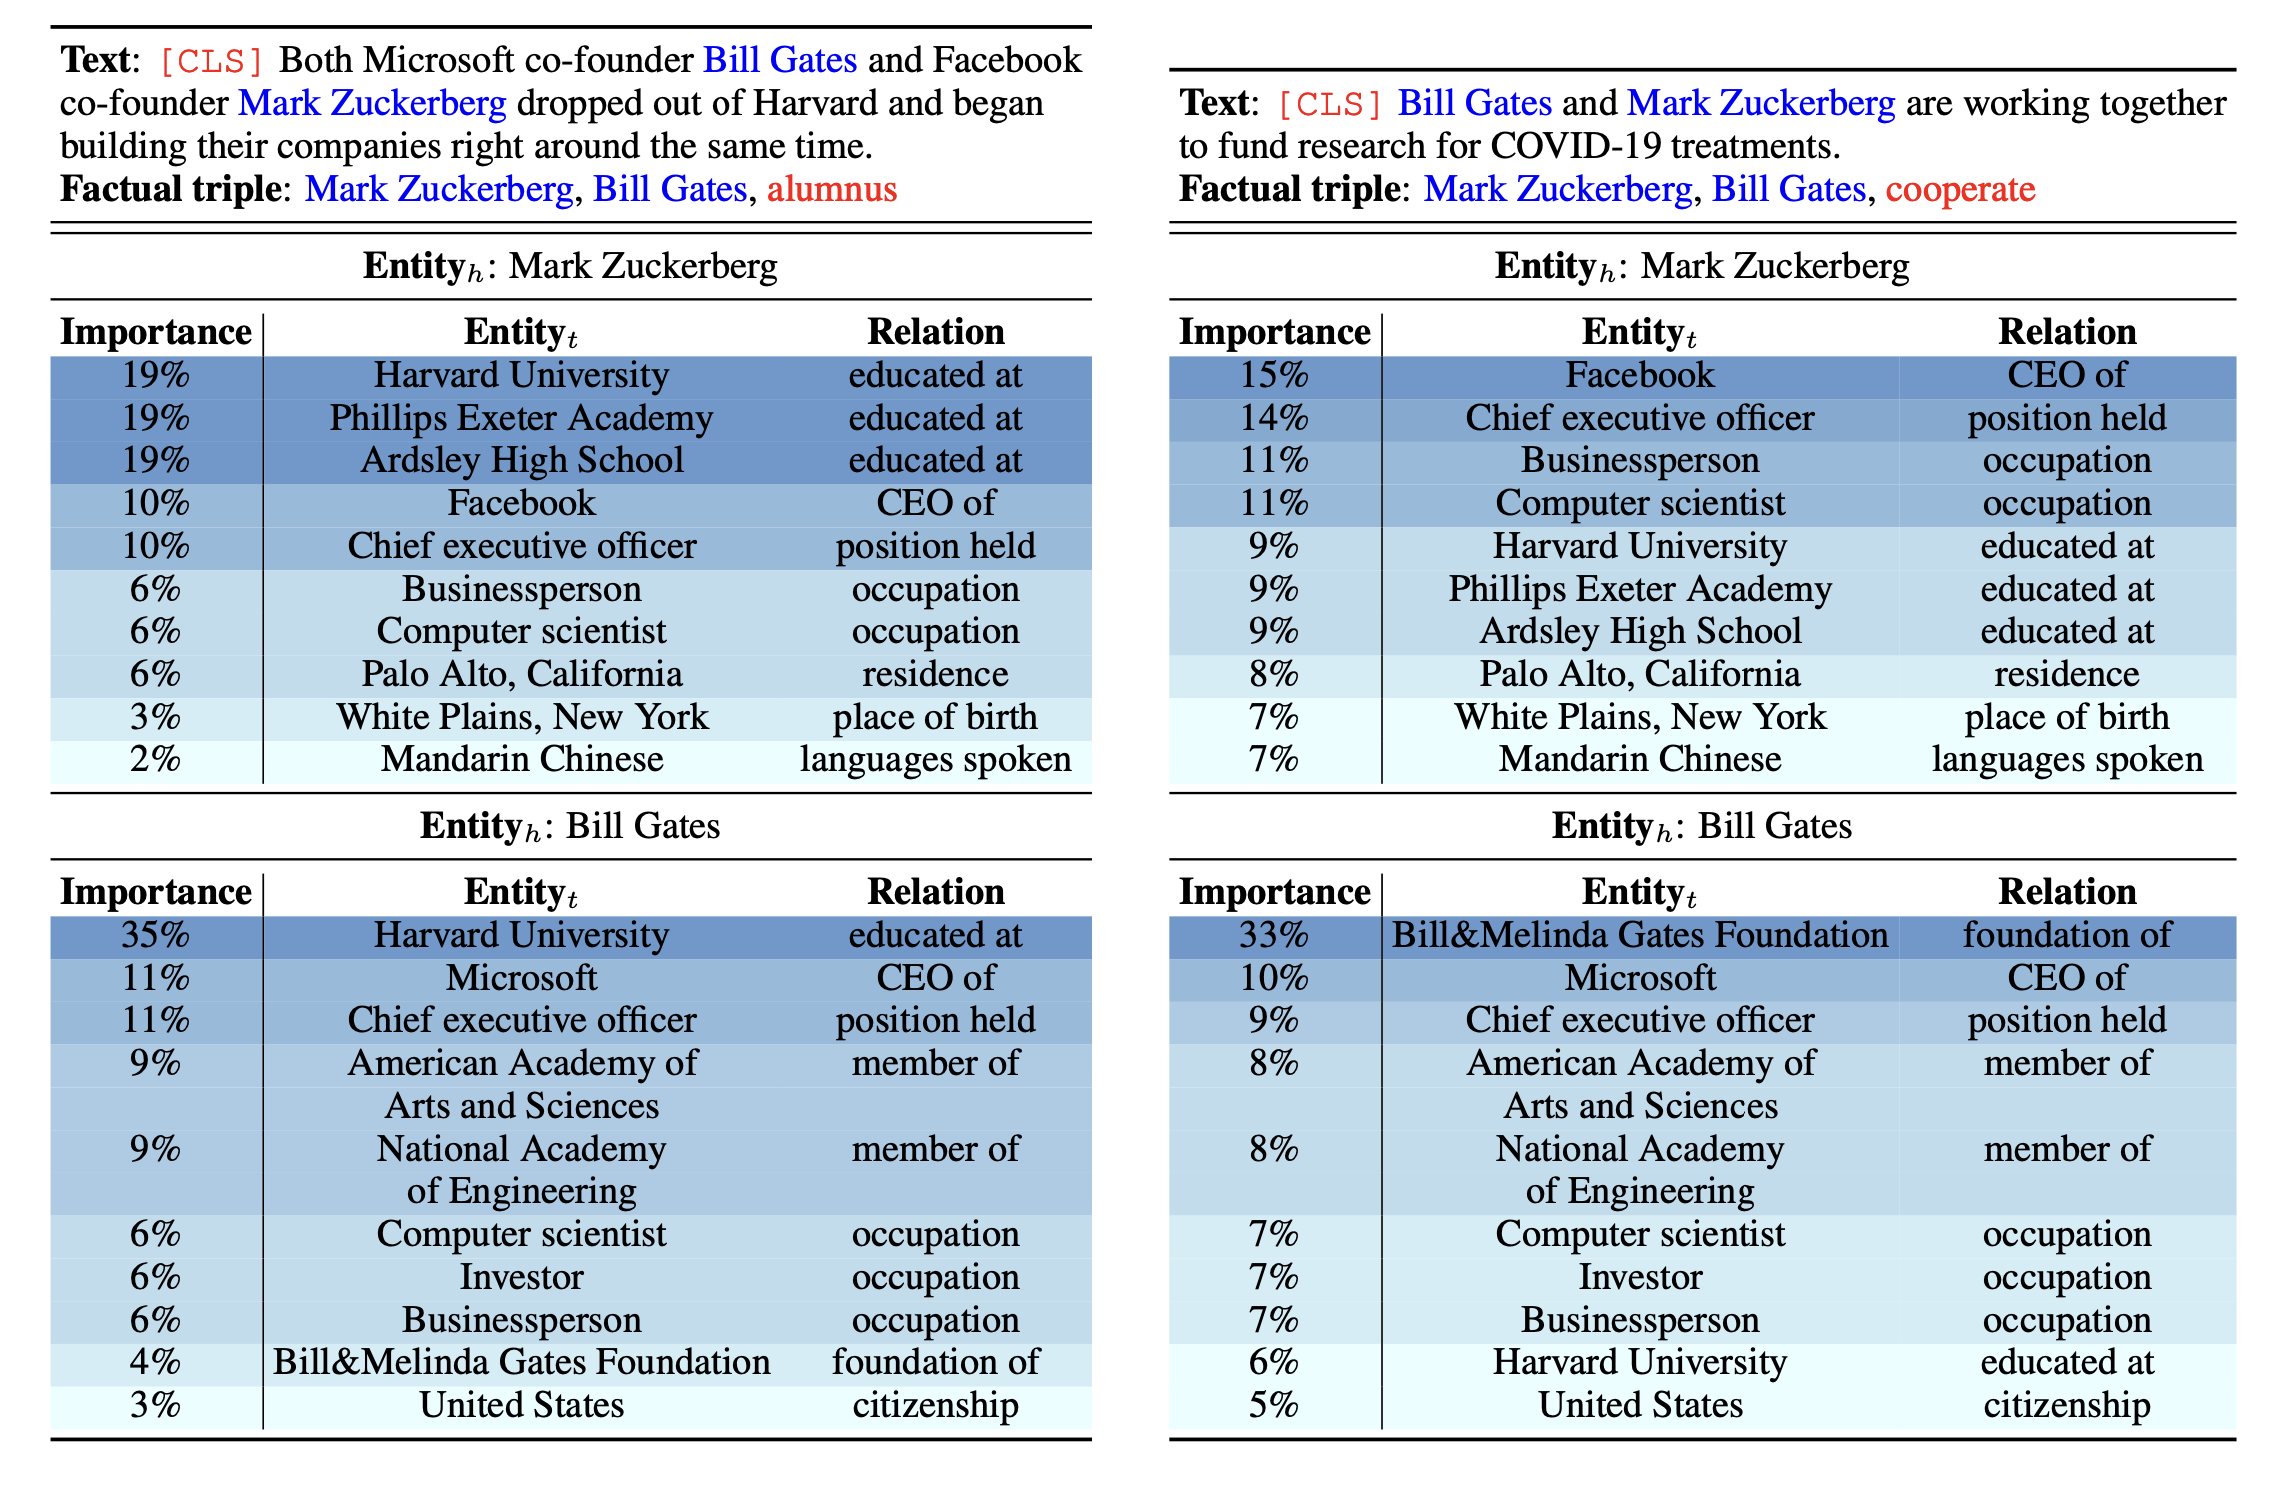
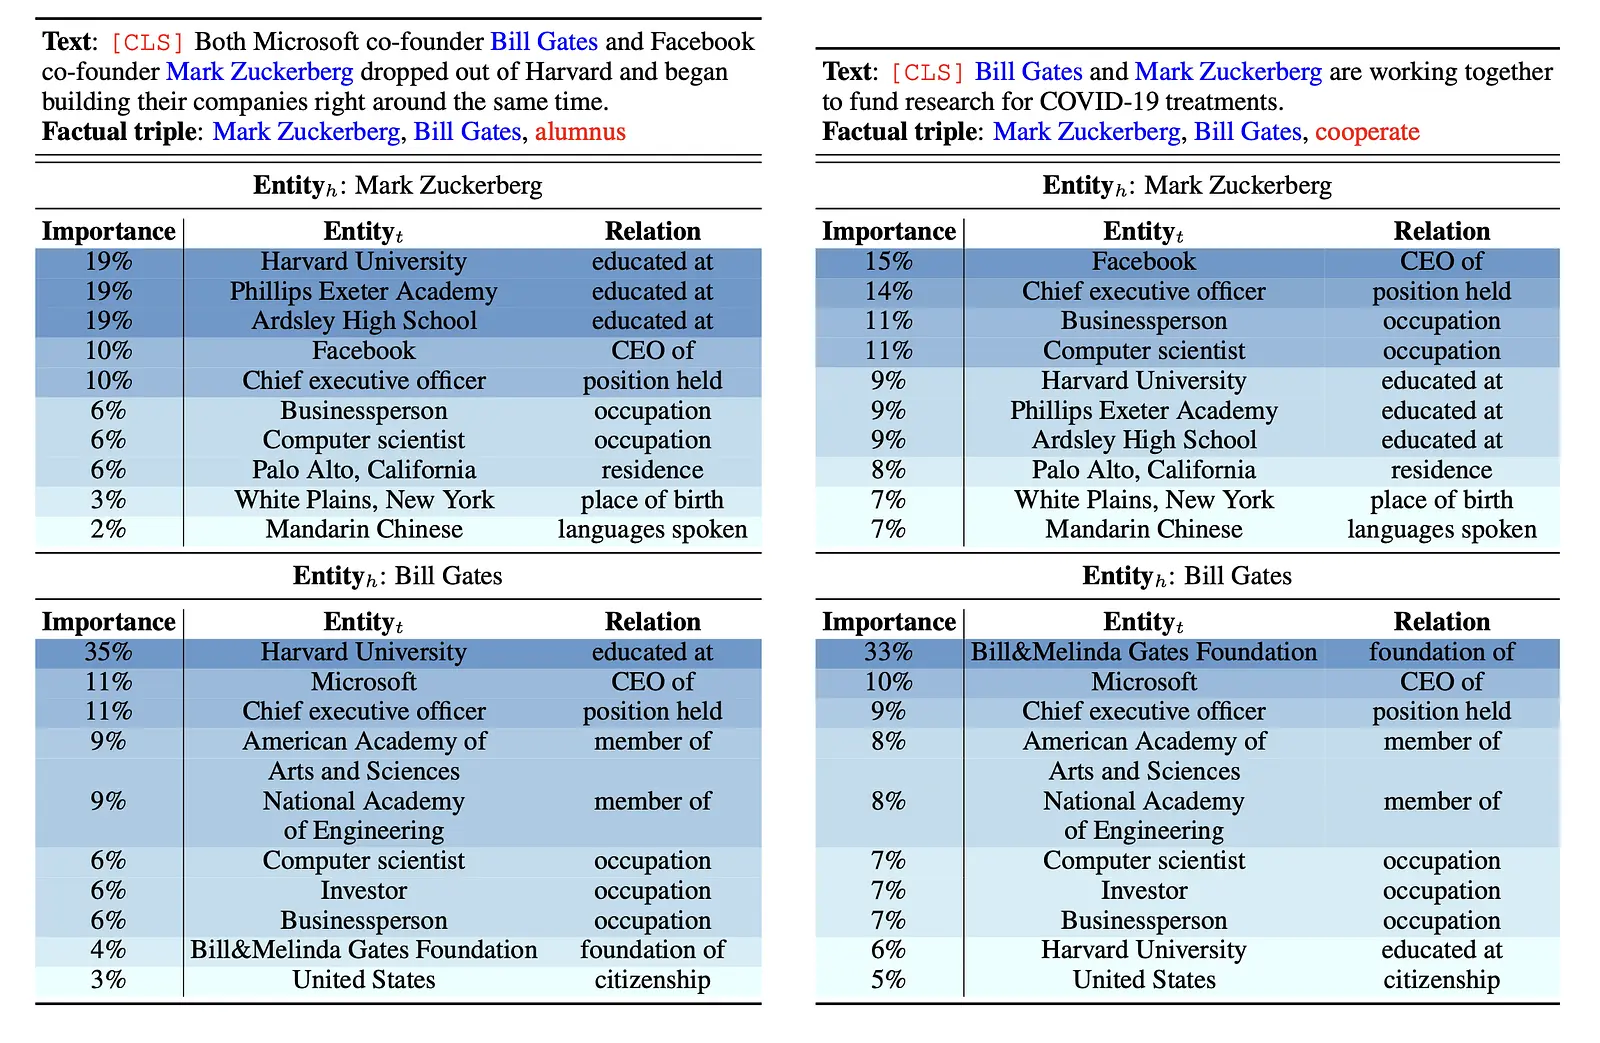
왼쪽과 오른쪽 문장은 둘 다 저커버그랑 빌게이츠가 Entity로 등장한 문장이지만, 왼쪽 문장은 둘 다 하버드대학 자퇴를 한 것을 다룬 문장이고 오른쪽은 둘 다 코로나 치료를 위해 협조한 내용을 다룬 문장입니다.
왼쪽 문장에서 cokeBERT가 가중치를 부여한 것은 두 사람이 공부했던 학교들을 높은 가중치로 계산했고, 오른쪽 문장에서는 foundation과 CEO를 담당하고 있는 회사이름이 높은 가중치로 계산되었습니다.
해당 결과에서도 볼 수 있듯이, 같은 Entity이지만, 문맥에 맞게 Relation을 선택하고 가중치를 부여하는 것을 볼 수 있습니다! 실제로도 두 문장을 해석하기 위해서는, 공부했던 학교와 창업한 기업과 제단이 사전지식으로 중요한데, 잘 선택되었네요.
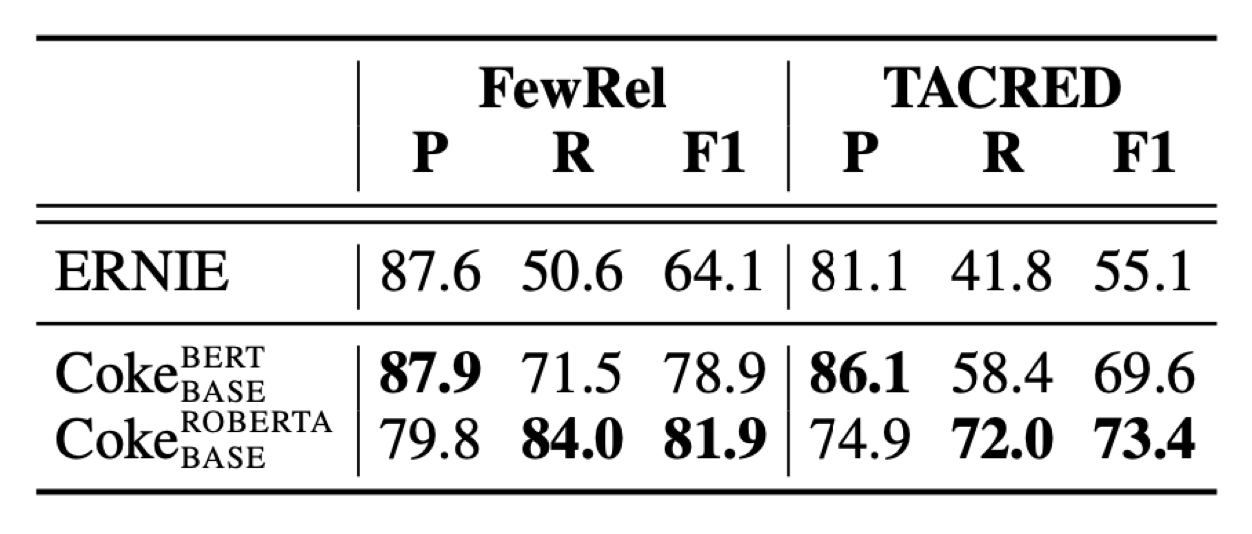
이전 모델인 ERNIE와 비교해도 중요한 Entity를 잘 선택한 것을 볼 수 있습니다. 이제 필요한 지식을 잘 선택한 것은 확인되었습니다.
이제 Task를 잘 수행하는 지 확인해봅시다.
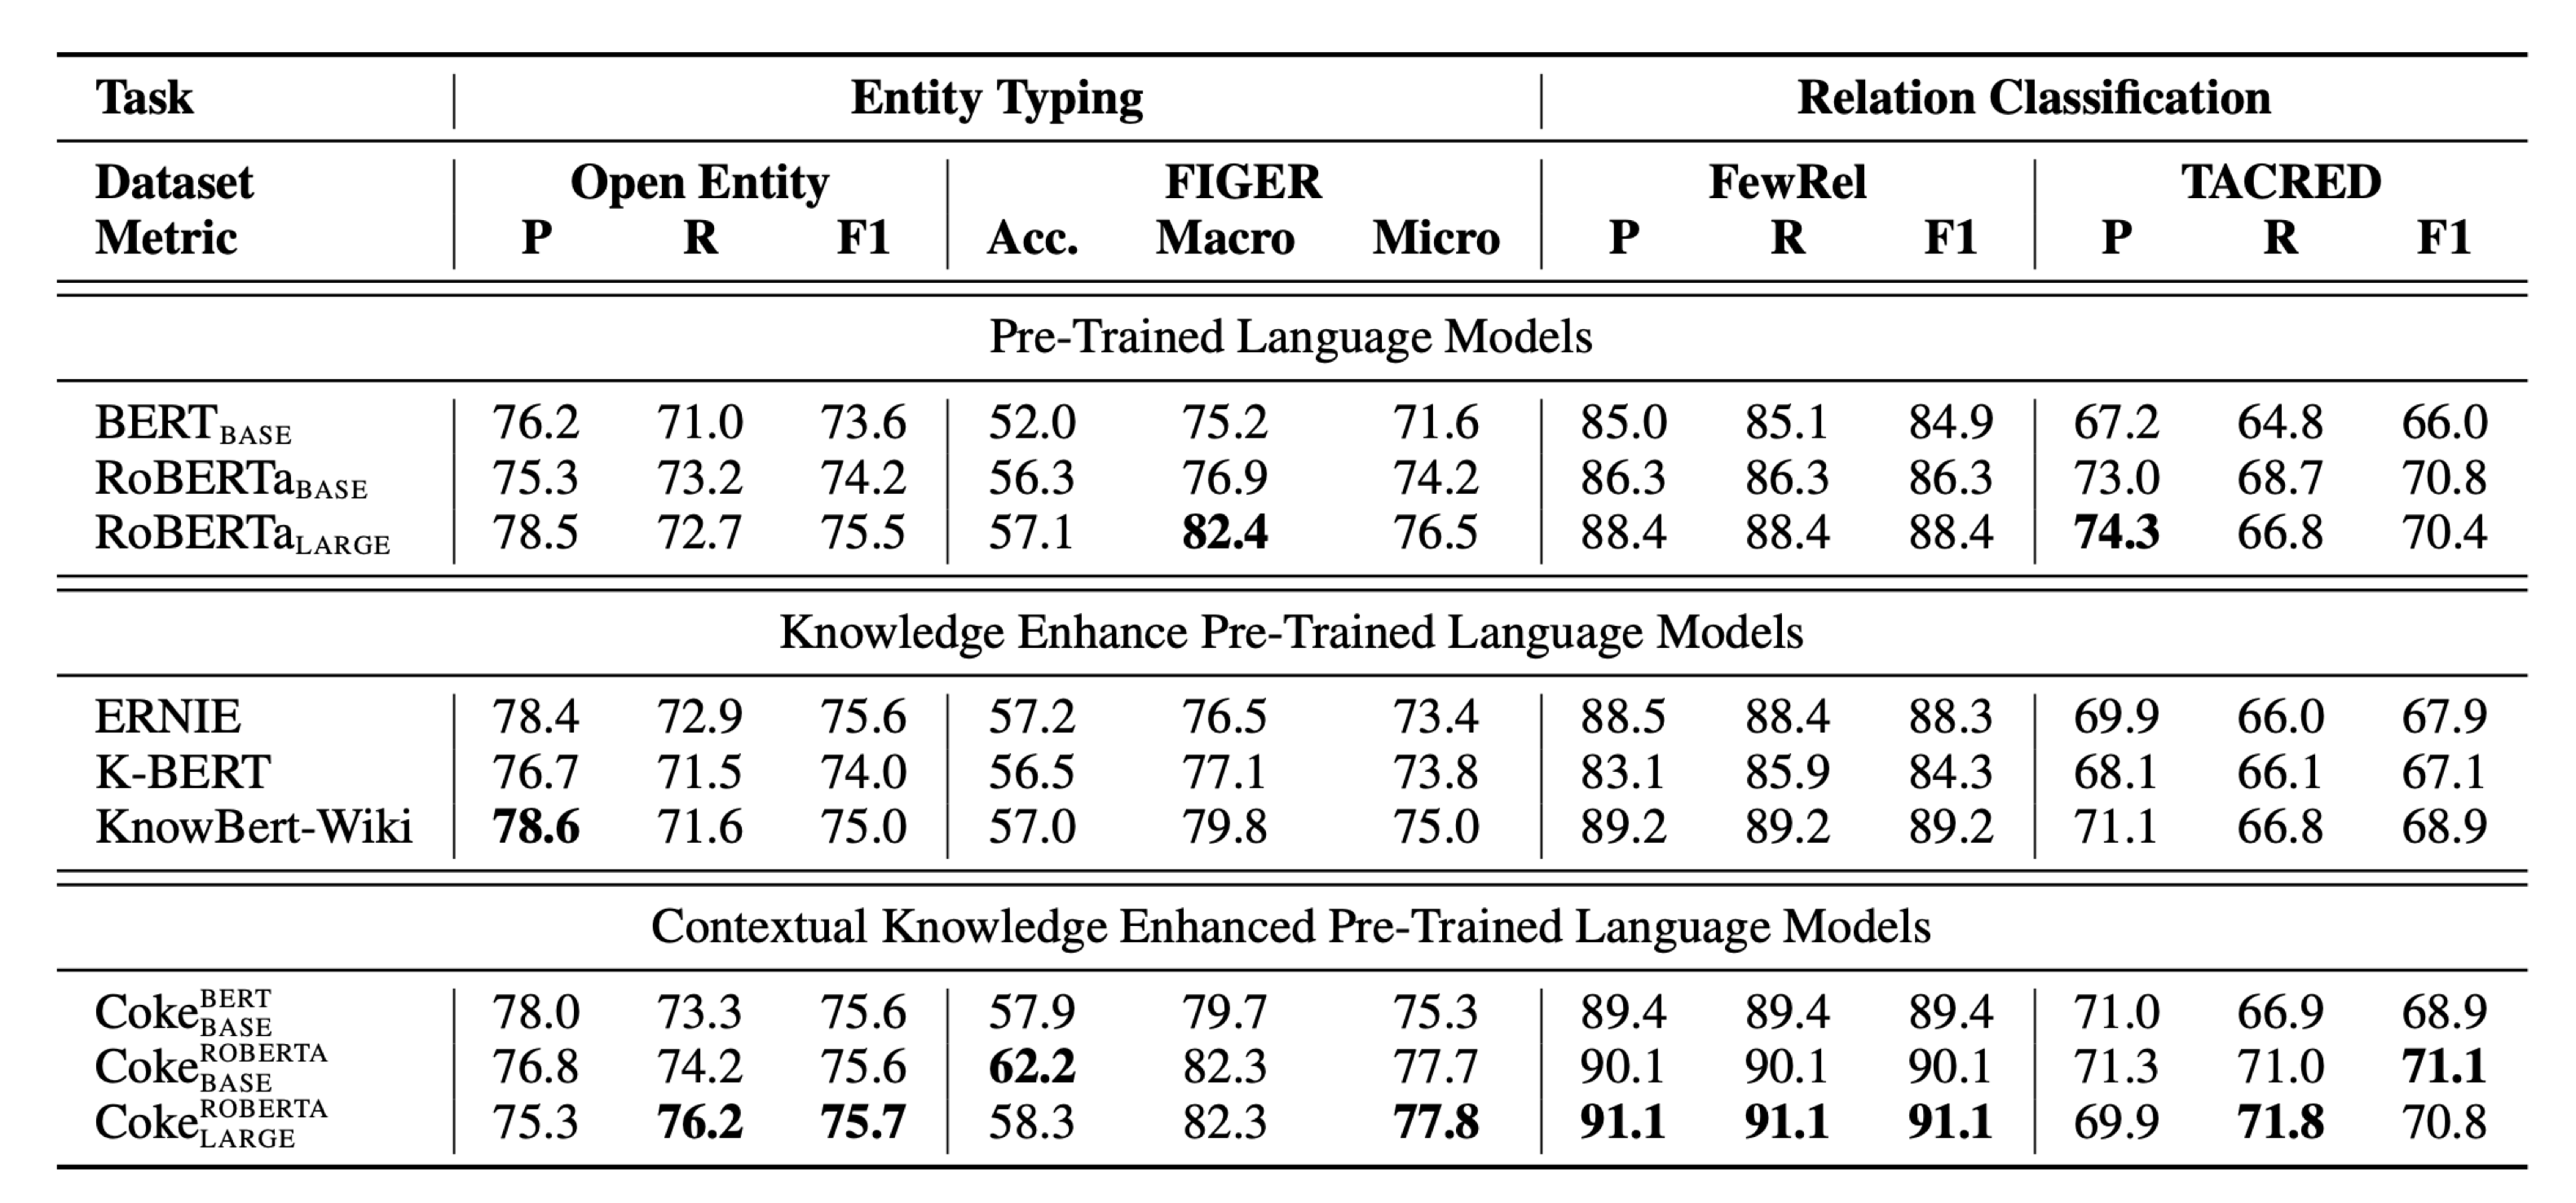
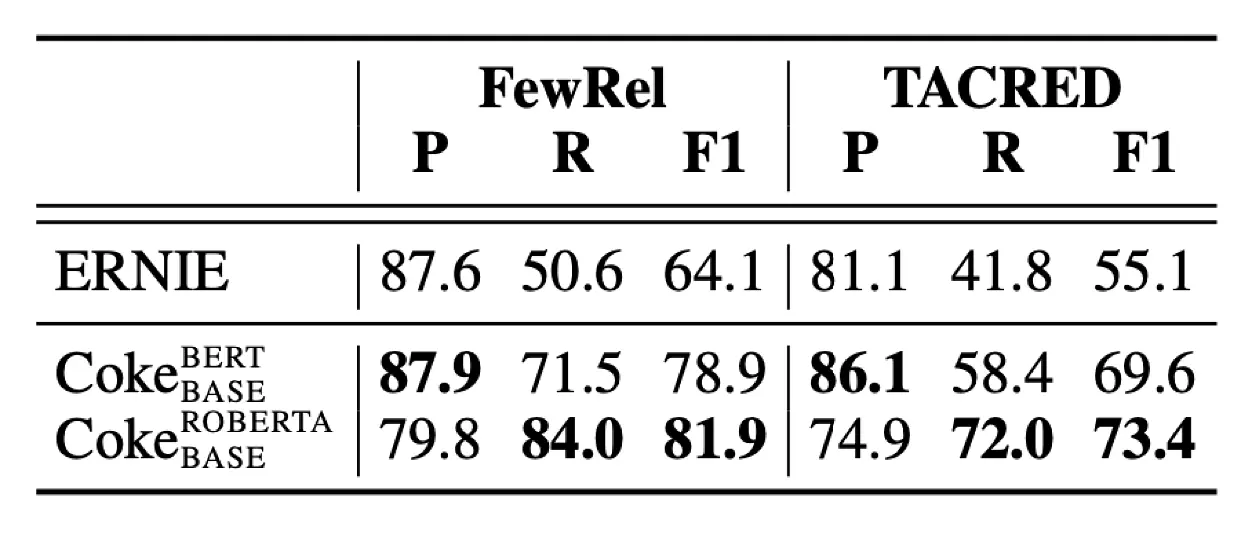
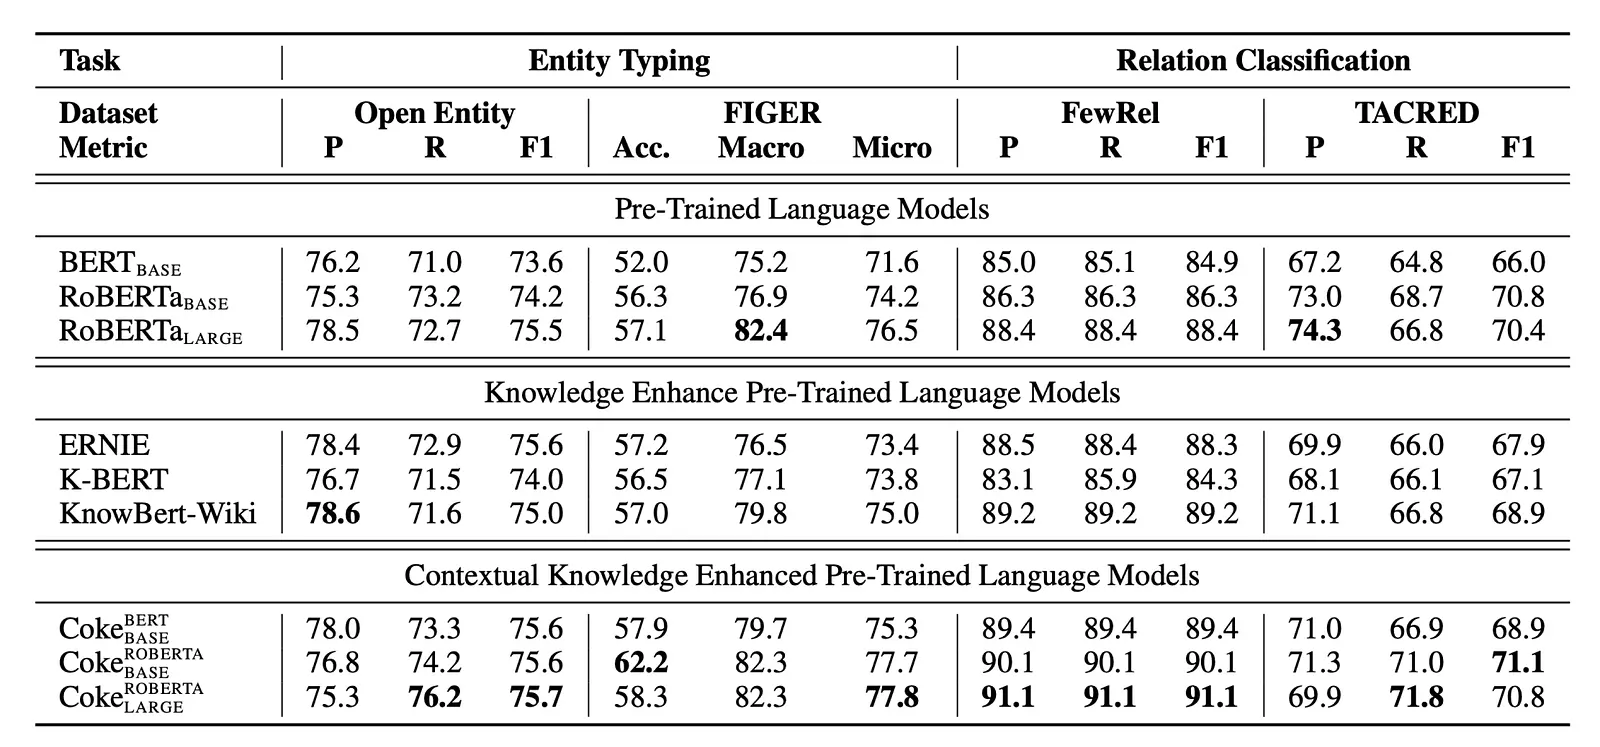
앞서 말한 Entity Typing과 Relation Classification Task에 대한 F1, P, R Score입니다.
Entity Typing의 경우에는 Roberta Large를 T-Encoder로 사용한 Coke모델이 가장 성능이 좋았고, 기존 모델들 보다 1~4%정도로 우세했습니다.
Relation Classification의 경우에는 거의 모든 score에서 3~4%차이로 SOTA를 달성한 것을 볼 수 있습니다.
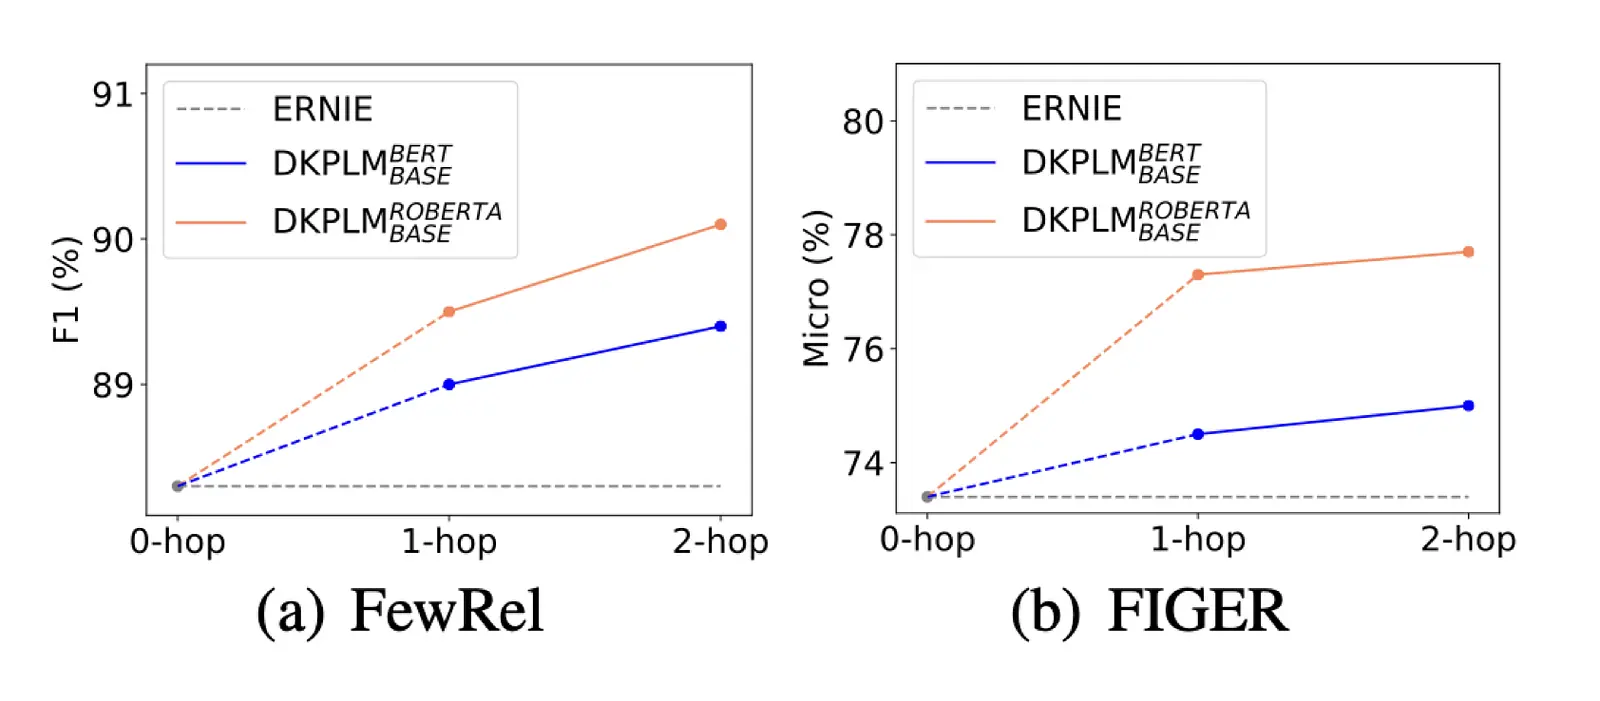
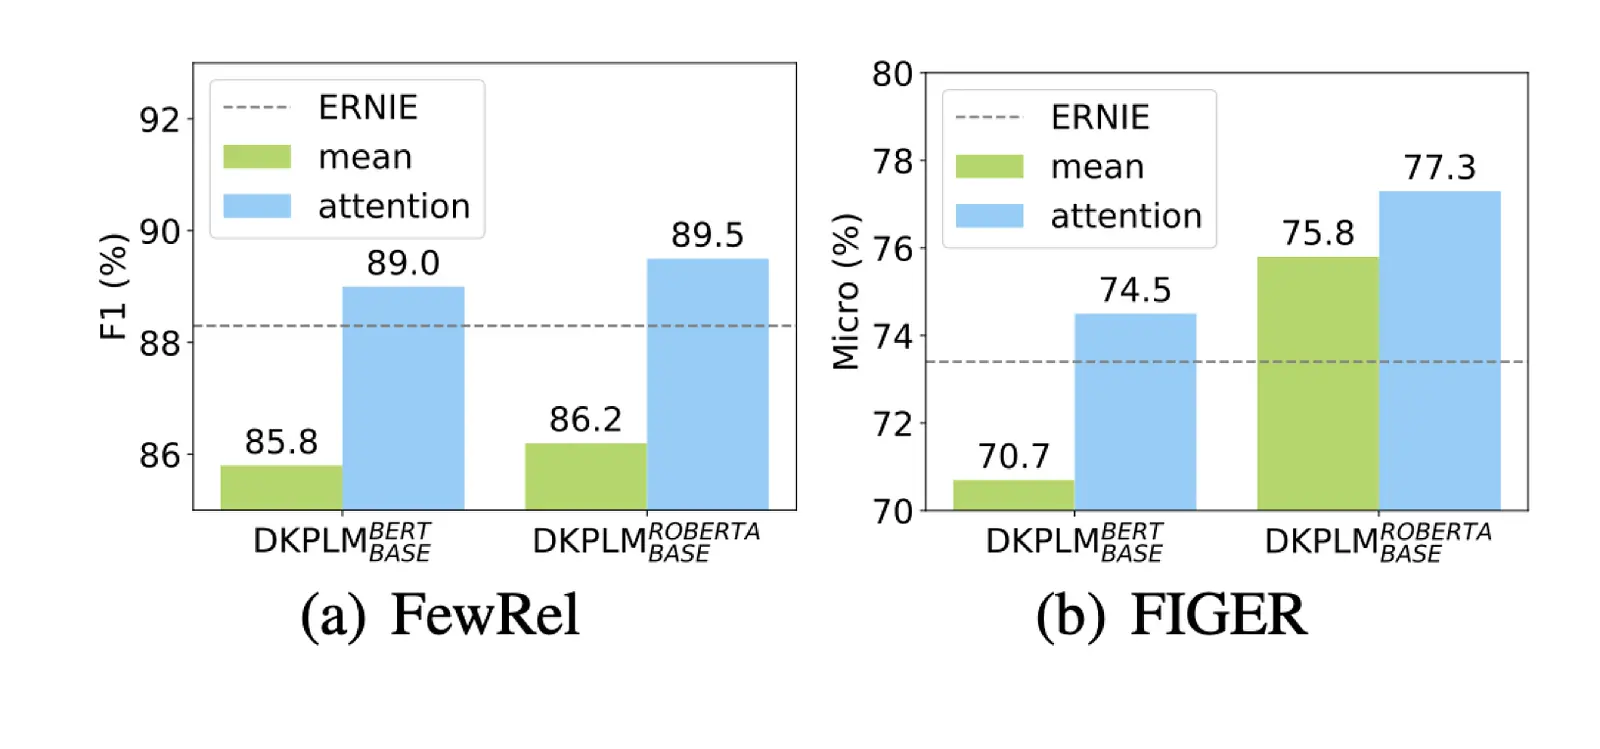
추가적으로 K-hop에서 K의 크기에 따른 정확도와 DK-Encoder에서 Attention 유무에 따른 정확도를 비교해보았습니다.
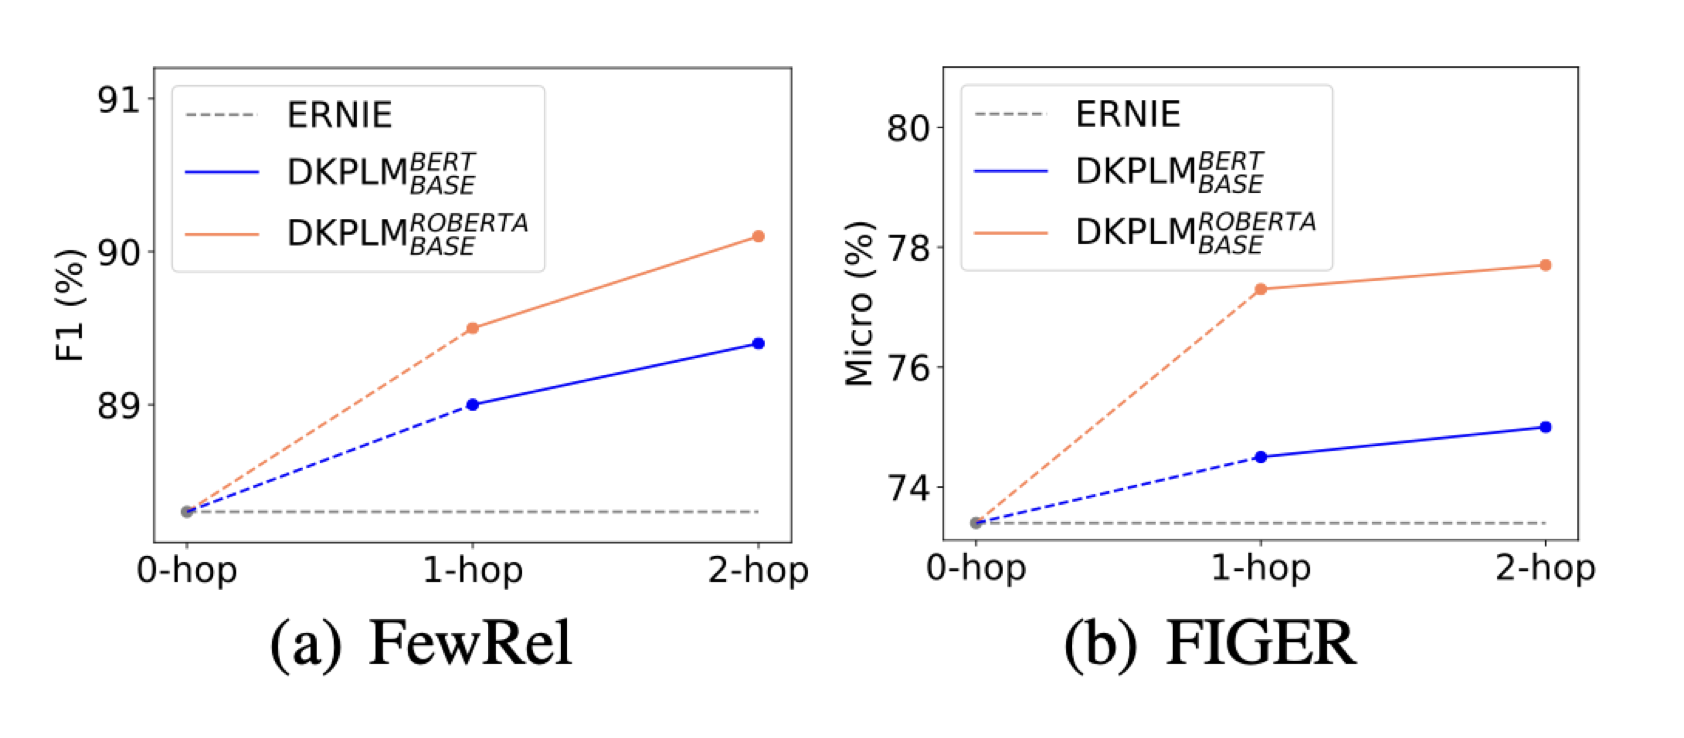
위 그래프에서 나타나듯이 K가 커짐에 따라서 F1, Micro 점수가 모두 향상되는 것을 볼 수 있습니다. 당연히 지식이 커질수록 정확도는 증가하겠지만 K 값을 많이 키우는 것은 메모리 연산 효율성 부분에서 권장되지는 않을 것 같습니다.
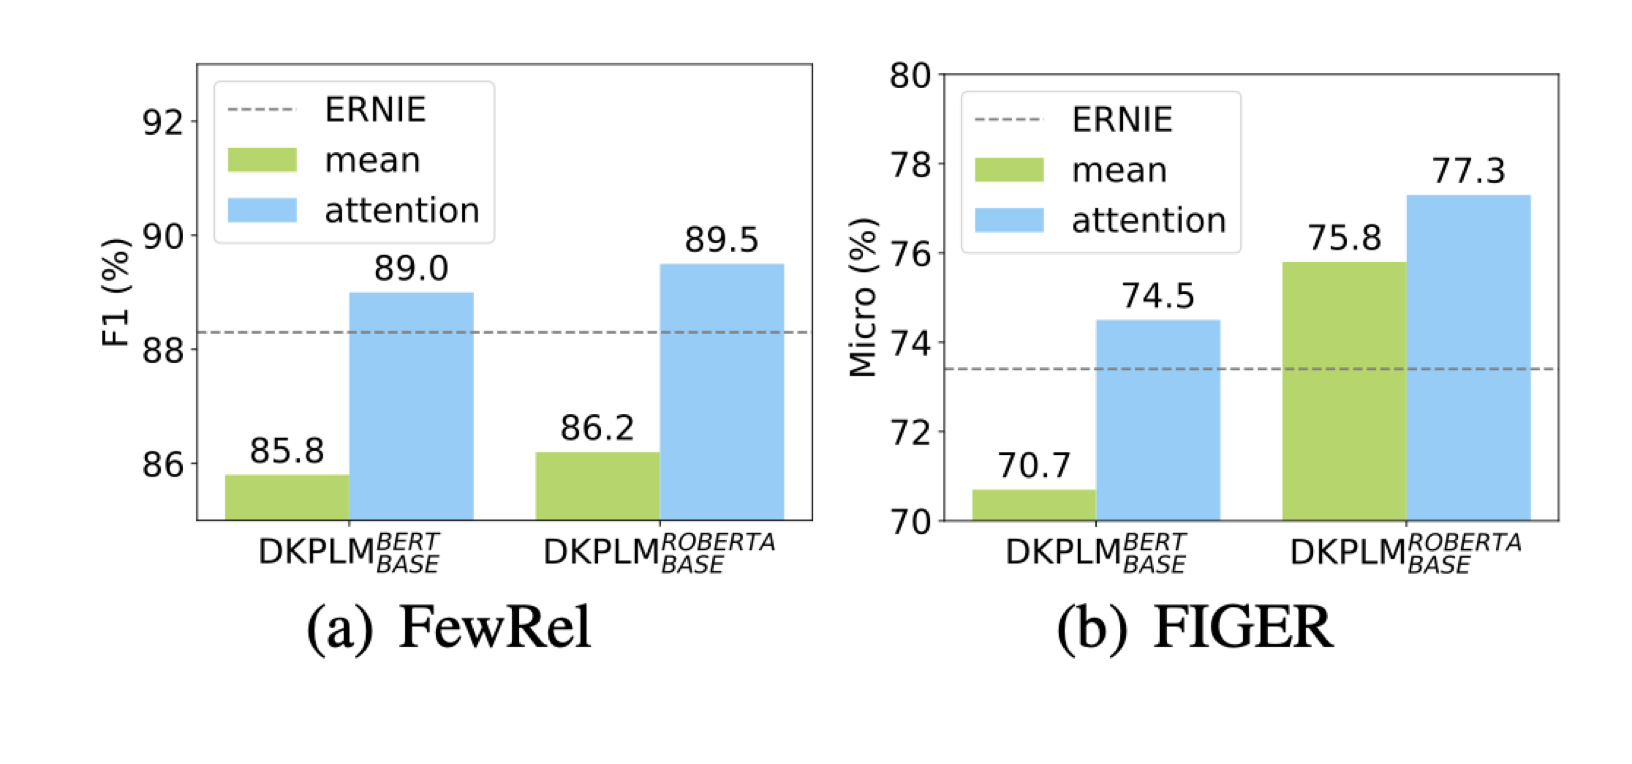
Attention 유무에 따른 정확도 비교 그래프인데, attention을 통해서 가중치를 부여한 모델이 가중치를 average로 설정한 모델보다 2~4% 증가한 것을 볼 수 있습니다.
위 두 분석을 통해서 cokeBERT가 다른 Knowledge Enhanced PLM보다 우세함을 알 수 있었습니다.
Conclusion
텍스트상에 등장하지 않은 Entity까지 Knowledge를 Dynamic하게 선택해서 PLM의 정확도를 증가시킨 점에서 주목할만한 논문입니다.
제 개인적인 생각으로는 정말 컴퓨터가 사람처럼 효율적이고 정확하게 글을 읽으려면, BERT의 Transformer Encoder층에서 Attention mechanism을 적용할 때, real-time으로 KGs를 이용하는 방법이 등장해야할 것 같습니다.
우리 인간은 문장을 다 읽고 문맥을 파악해서 사전지식을 적용시키는 것이 아니라, 문장을 읽으면서 사용될 사전지식을 떠올리기 때문에 이와 유사하게 모델을 구성하기 위해서는 DK-Encoder와 K-encoder처럼 새로운 Encoder Layer를 BERT 위에 추가하는 것이 아니라 BERT와 같은 PLM들의 구조를 변형시켜서 Transformer Encoder 대신 이전 Layer의 문맥 벡터 Query를 참조하는 DK-Encoder로 구성된 모델을 학습시켜보는 것이 좋을 것 같습니다.
References
BERT
Jacob Devlin, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. 2019. Bert: Pre-training of deep bidirectional transformers for language understand- ing. In Proceedings of NAACL, pages 4171–4186.
TransE
Antoine Bordes, Nicolas Usunier, Alberto Garcia- Duran, Jason Weston, and Oksana Yakhnenko. 2013. Translating embeddings for modeling multi- relational data. In Proceedings of NeurIPS, pages 2787–2795.
ERNIE
Zhengyan Zhang, Xu Han, Zhiyuan Liu, Xin Jiang, Maosong Sun, and Qun Liu. 2019. Ernie: Enhanced language representation with informative entities. In Proceedings of ACL, page 1441–1451.
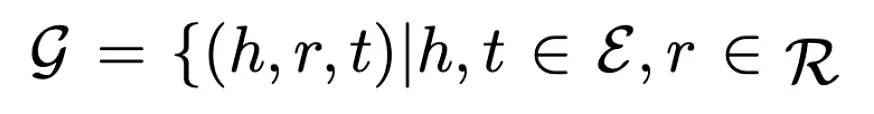
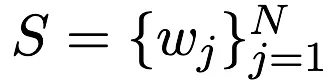
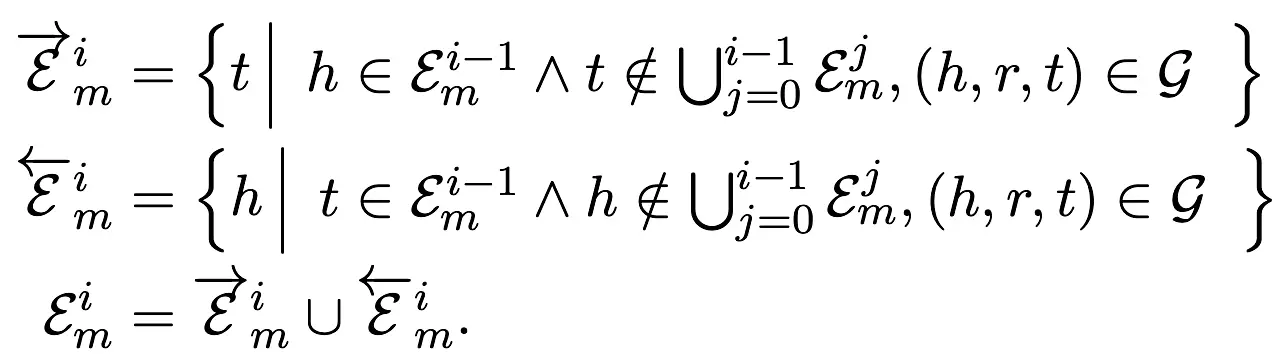
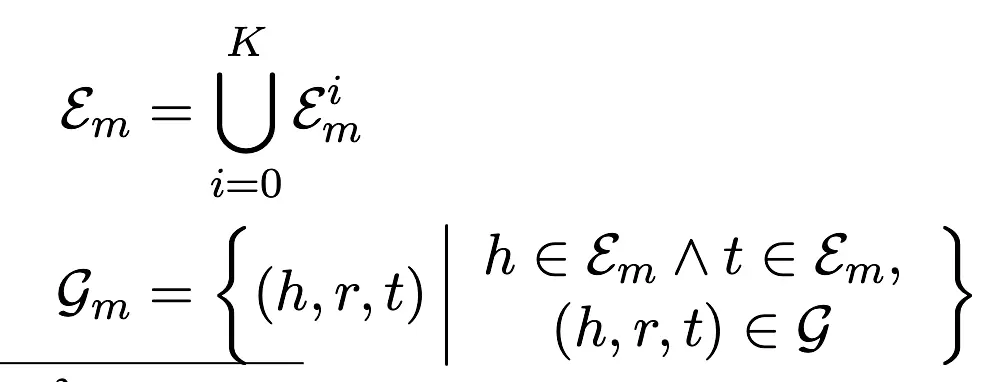
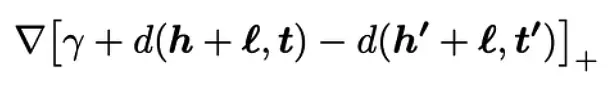
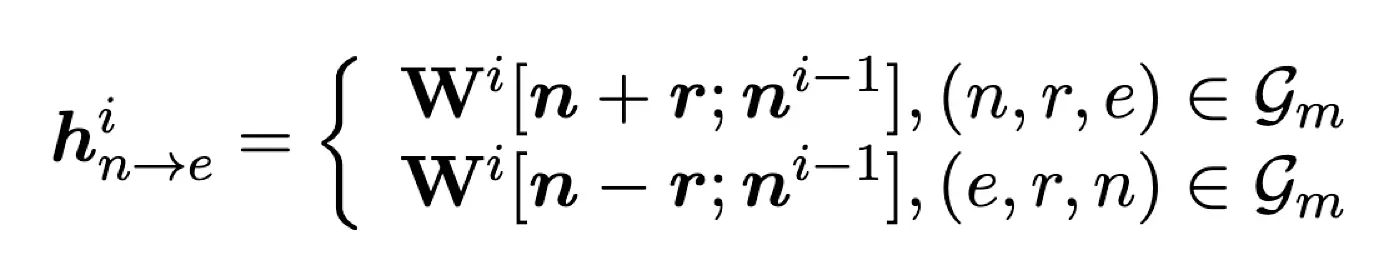
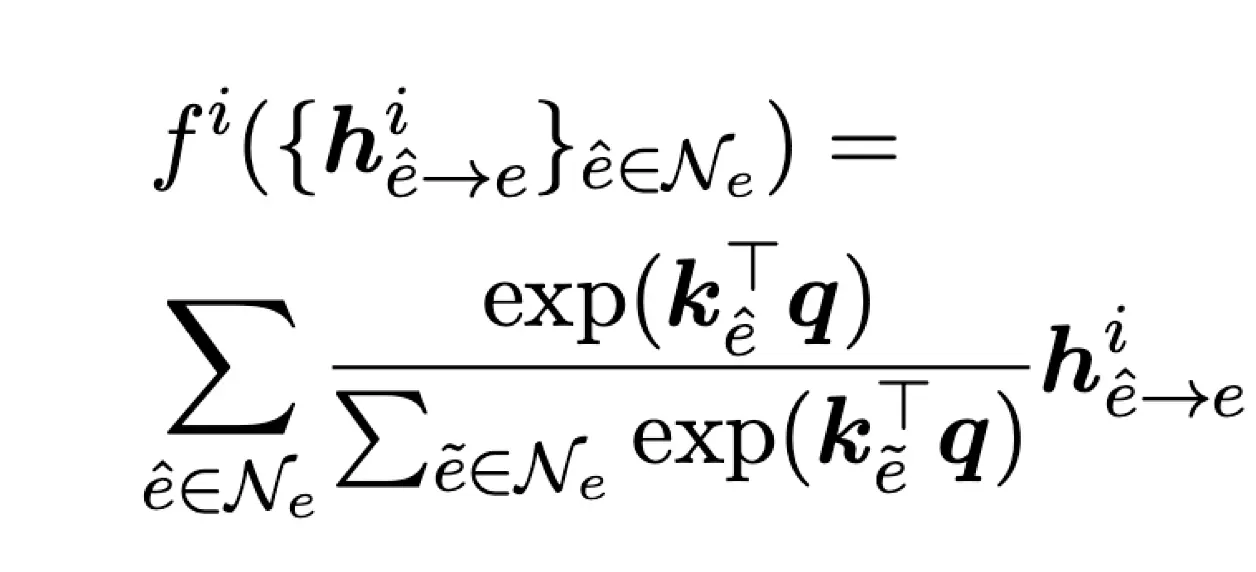
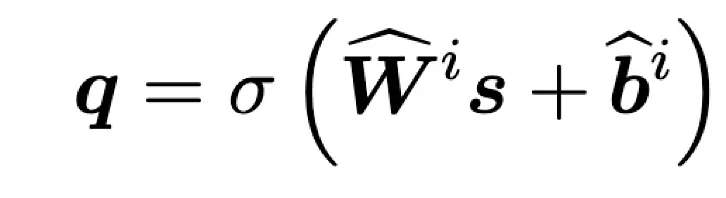
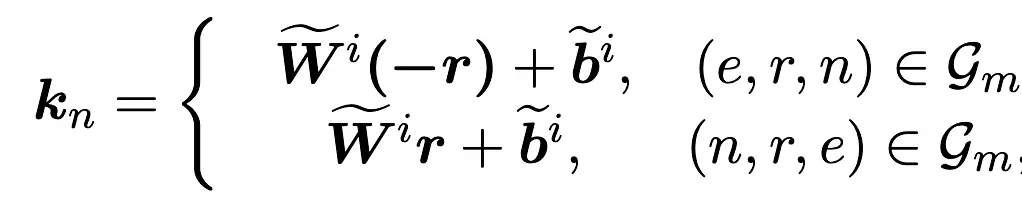
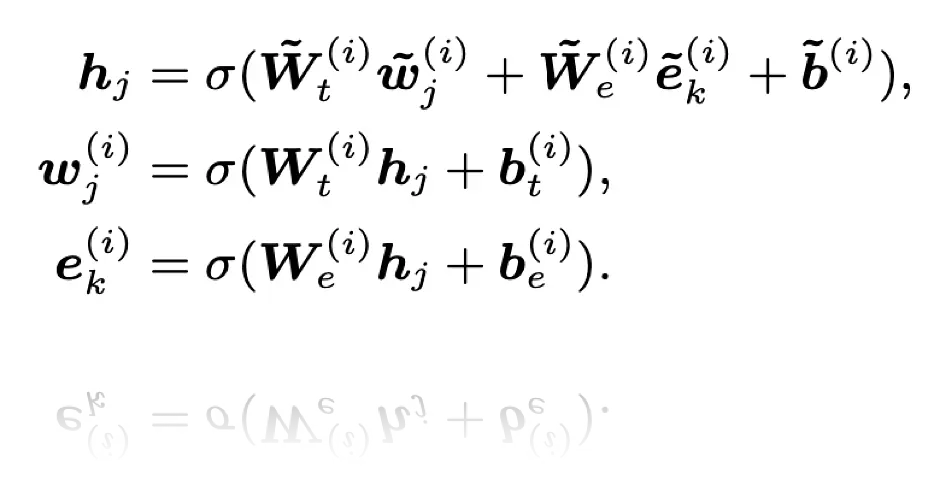
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.