NLP : 키워드를 추출하자!
1.Overview & Motivation
코어닷투데이는 유저들이 AI관련 용어, 최신 기술들을 쉽고 빠르게 접근할 수 있는 환경을 제공하는 회사입니다.
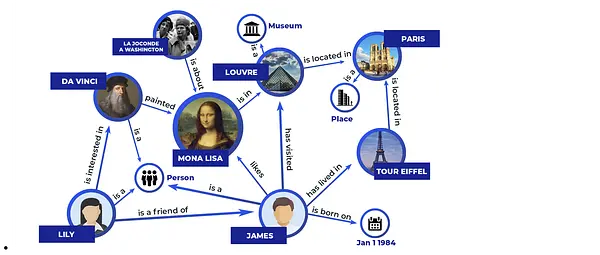
유저가 관심있어하는 article을 입력했을 때, 그 article에서의 키워드를 제공하고 그 키워드를 포함하는 다른 문서를 참조하며 유저들이 마인드맵처럼 자신의 생각을 확장할 수 있다면 유저가 만족하는 서비스를 제공할 수 있으리라 생각했습니다. Twitter나 Instagram처럼요!
또, 논문의 Abstract에서 제공하는 키워드처럼, 사람들은 키워드를 숙지한 후 문서를 읽으면 체계적이고 효율적으로 문서의 내용을 습득할 수 있답니다.
하지만 유저가 직접 입력해야하는 키워드 태깅 방식은 타겟 키워드에서 여러 변형된 형태(오타를 포함하여)로 태깅 될 수도 있고(Ex: AI, 인공 지능, 인공지능, Artificial Intelligence, artificiall intellligeence), 무엇보다도 유저가 서비스를 이용하는데에 피로감을 느낄 수 있다고 생각했어요.
“유저가 원하는 키워드를 자동으로 추출하자!”가 이 모델의 출발점이었습니다.
2. Success metrics
“좋은 키워드가 무엇일까?” “유저가 어떤 키워드를 원할까?”를 고민하는 것이 가장 어려웠습니다..
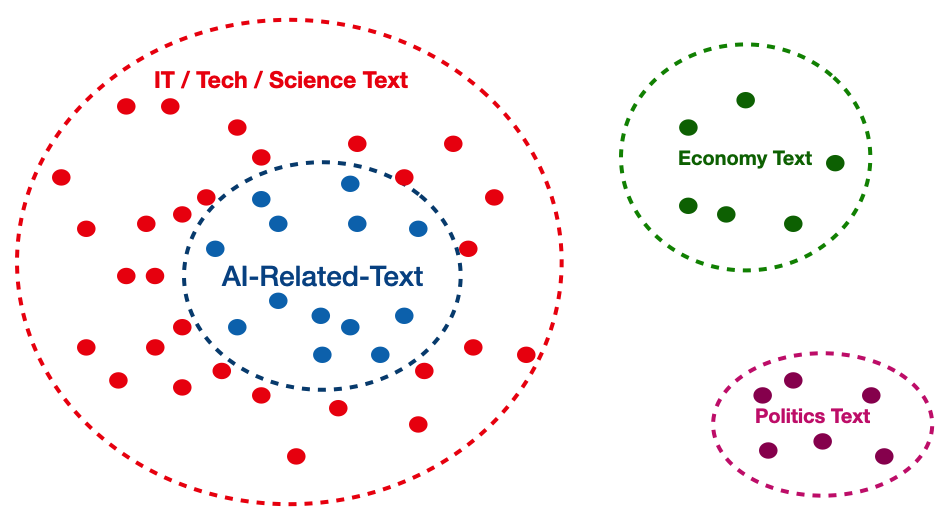
AI관련 용어와 최신기술의 접근성을 높이는 것이 목표니, AI관련 용어가 키워드가 되어야할지 아니면 정말 말그대로 문장을 대표하는 용어들을 키워드로 설정할 지 생각이 많았답니다.
저는 “유저가 원하는 키워드는 비단 AI관련 용어일 뿐 아니라, 보내주신 article에서의 핵심 용어도 포함한다.”라고 생각하고 프로젝트를 진행해보았습니다.
3. Requirements & Constraints
- Pre-trained model
- Bert model / KoBert model
- XLM-Roberta NER model
- Requirements
- transformers == 4.26.0
- sentencepiece >= 0.1.97
- torch >= 1.7.0, <=1.10.1
- trafilatura (optional, 자동 URL-text fetch를 위해 필요합니다.)
- Dataset
- CNN/DM summarization
- AIhub 한국어 요약
- Environment
- Colab (10000개 이상의 데이터셋에서는 Colab-PRO나 40Gb이상의 GPU가 필요합니다.)
4. Methodology
4.1. Model conception
물론 키워드를 문서에서 바로 뽑을 수 있다면, 더할나위 없이 좋겠죠. 빈도나 Co-occurence같은 지표를 통해서 말이에요.
📃 [(49996, '서비스'), (41834, '기업'), (33440, '데이터'), (32562, '디지털'), (28158, '사업'), (26960, '활용'), (26876, '제공'), (25780, '플랫폼'), (24436, '분야')]
위 데이터는 한국어 AI 뉴스 10000건 중 ‘AI’의 (# of Co-Occurence, word) 데이터인데, 보시는 바와 같이 키워드라기보다 연관어라는 느낌이 강합니다.
우리가 사용하는 언어는 복잡한 의미관계를 내포하고 있어서, 해당 방법으로는 정말 그 문서를 대표하는 키워드를 뽑아내기에는 부족해요.
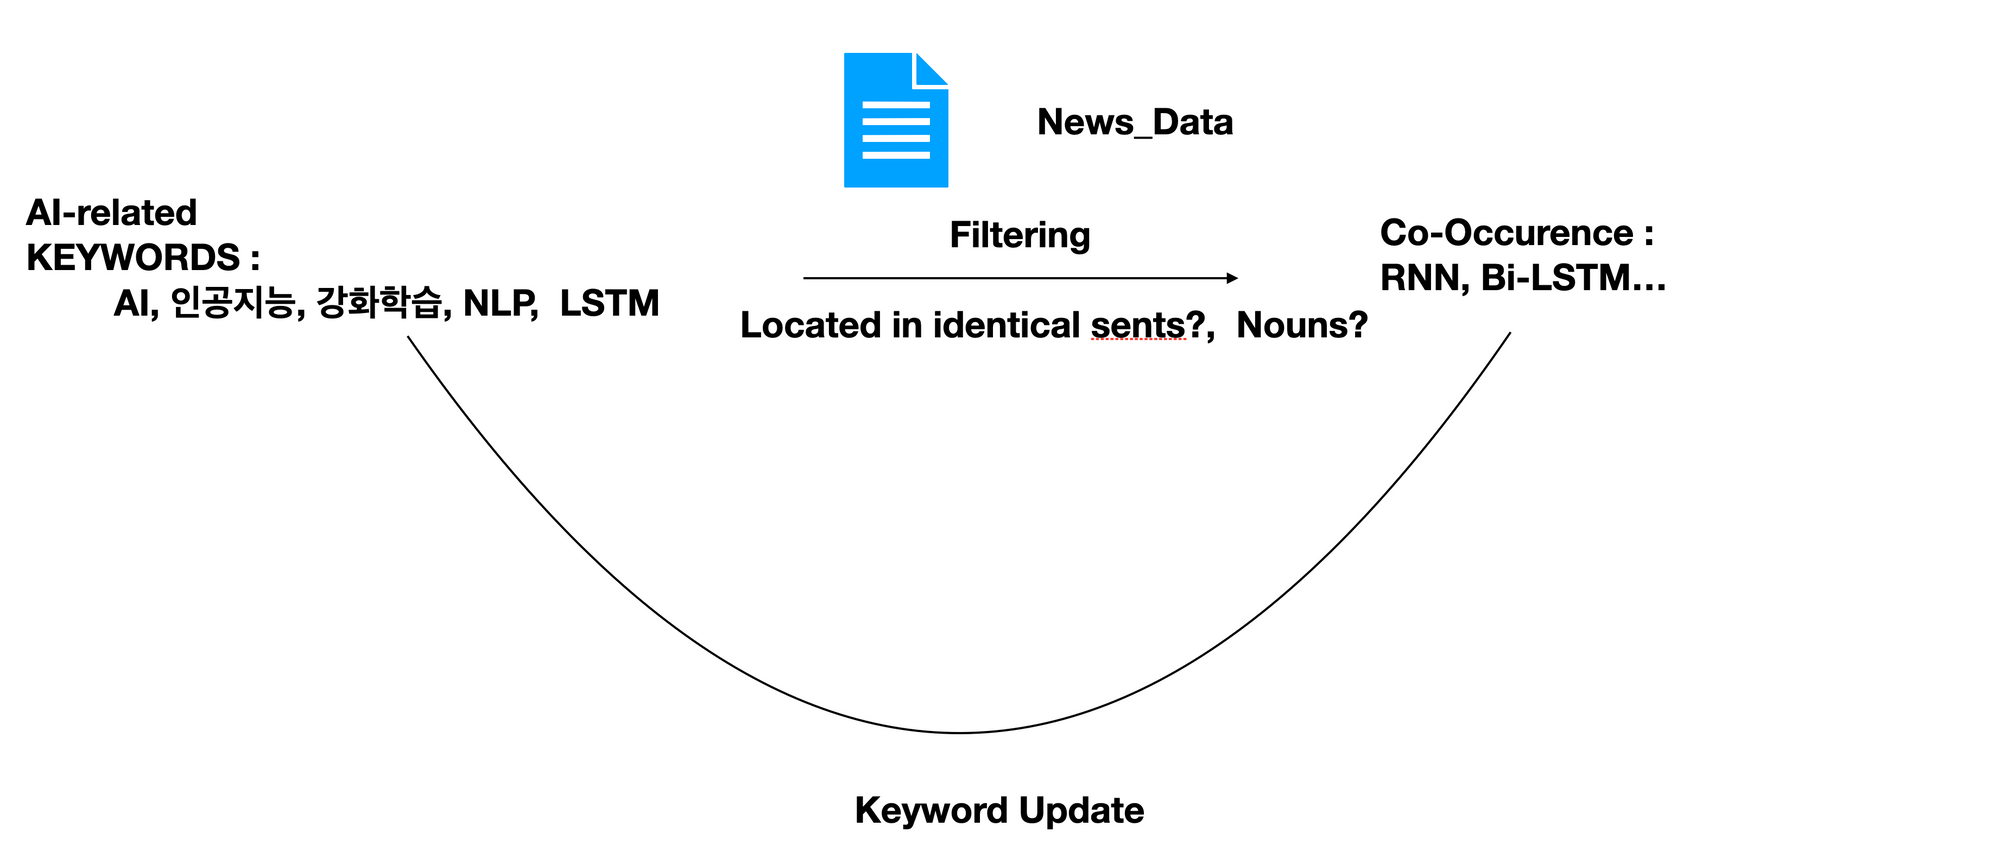
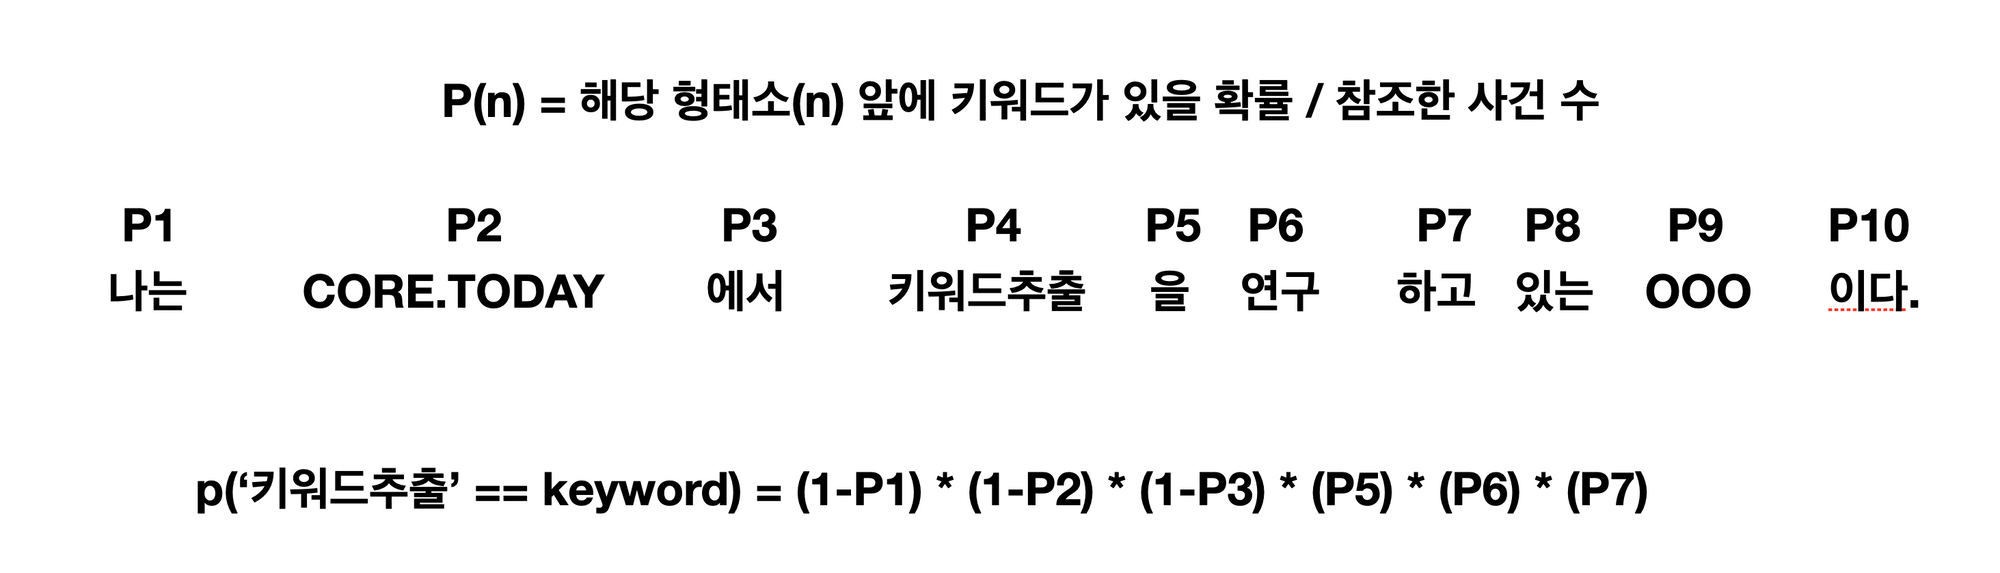
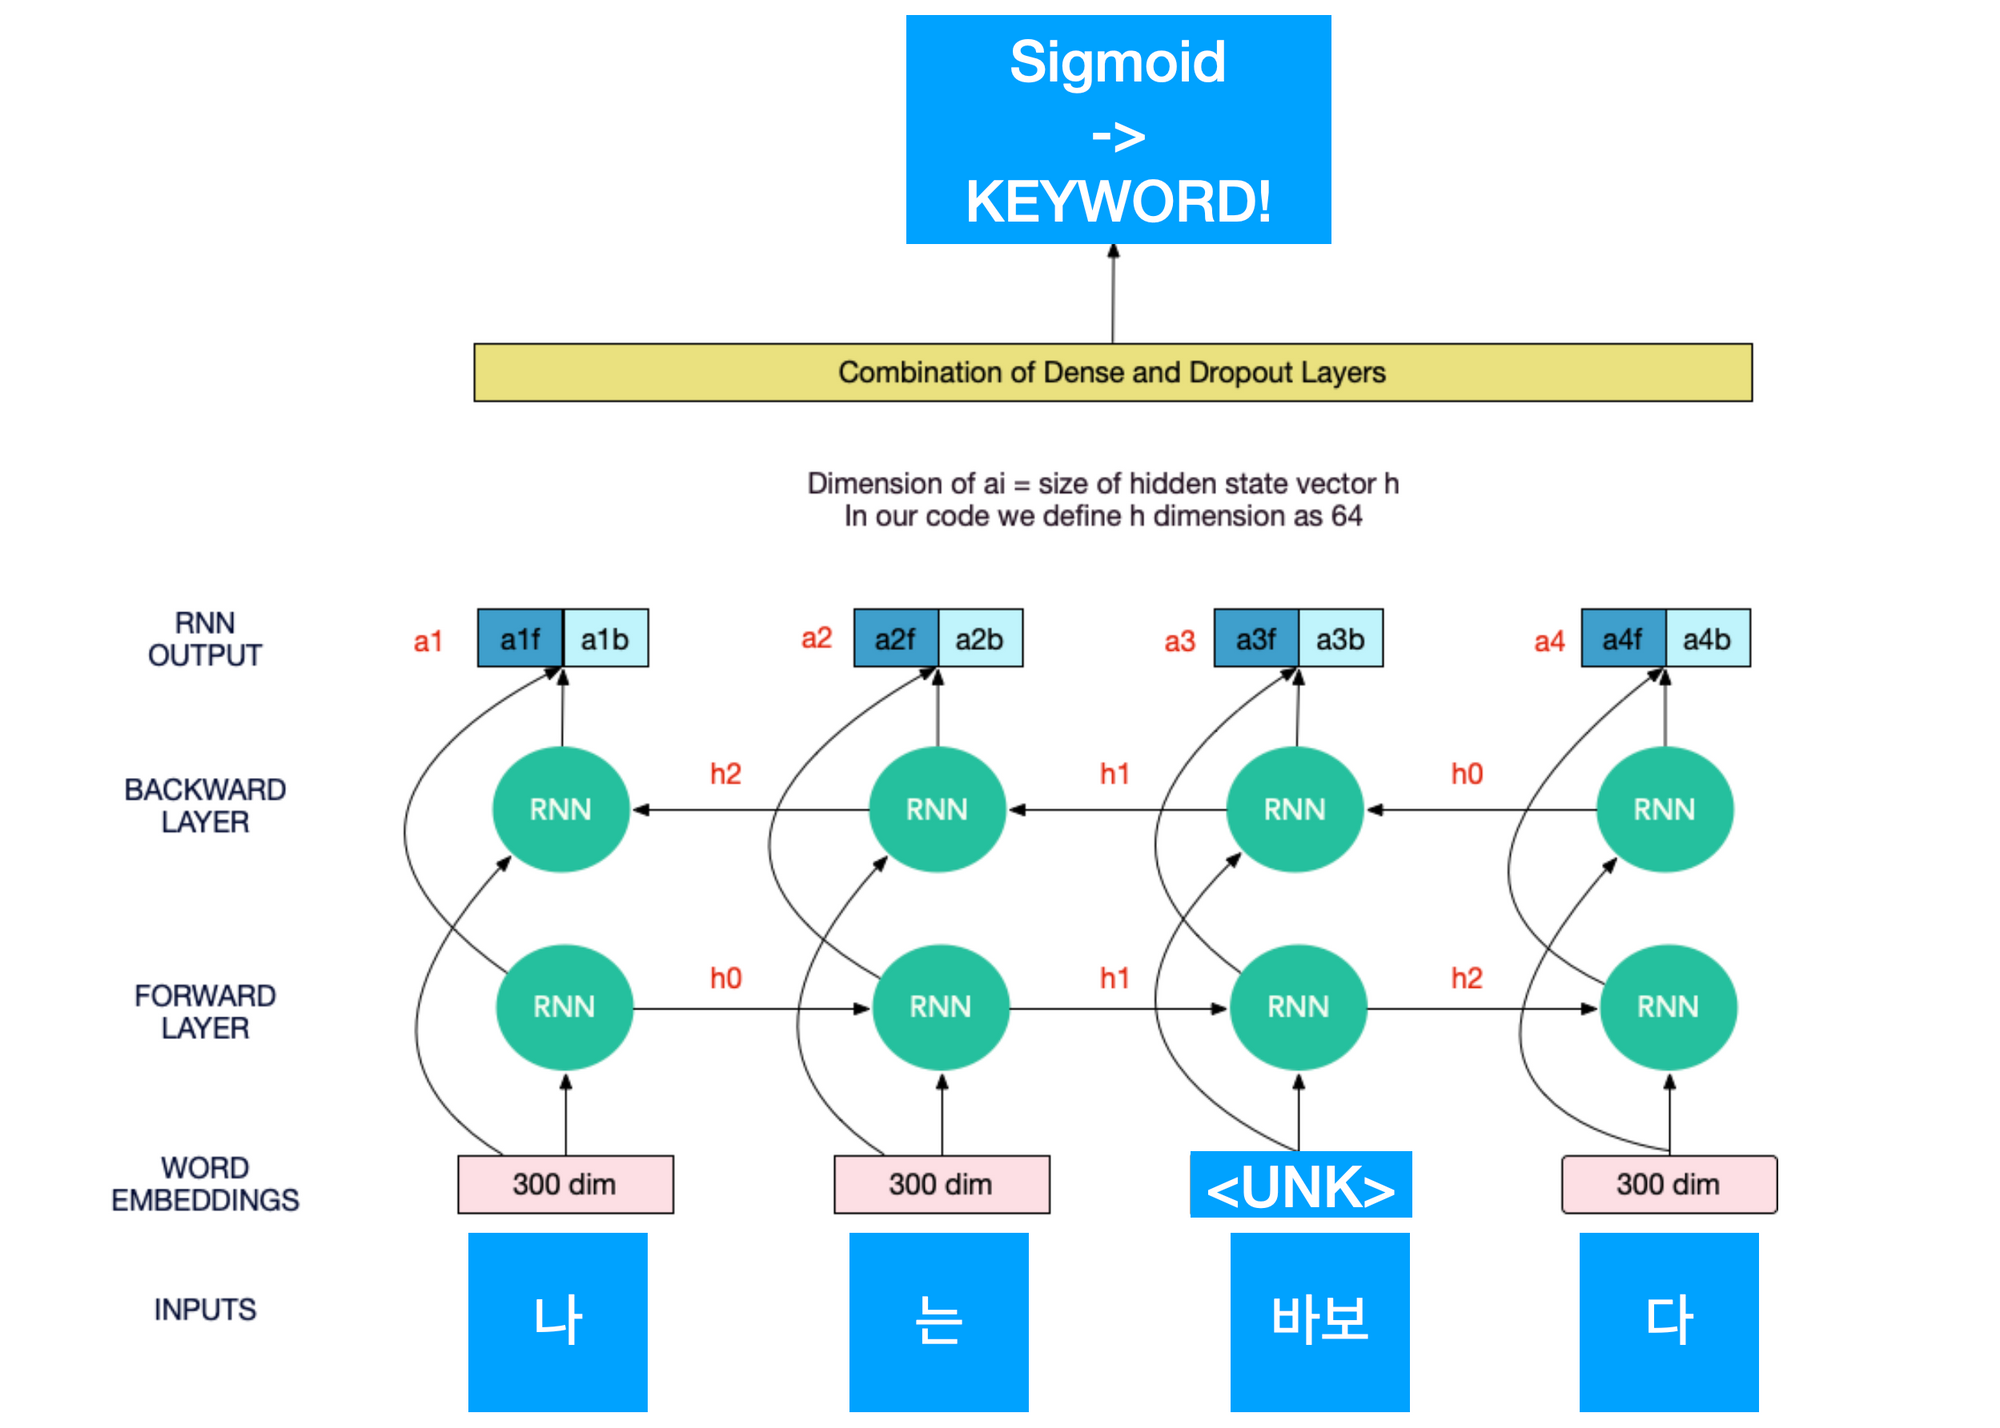
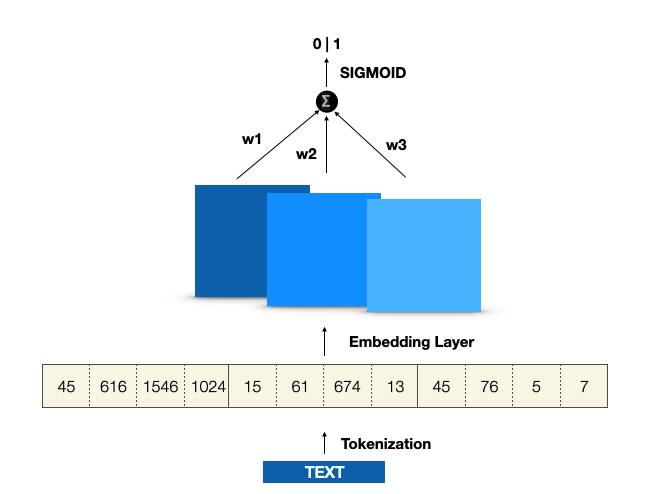
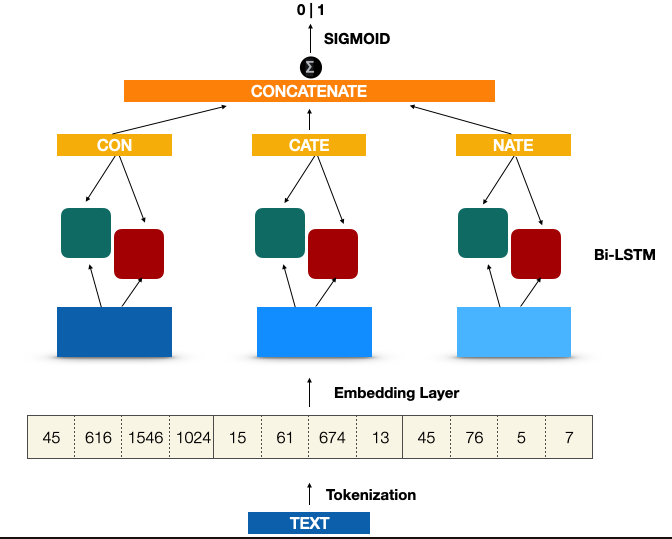
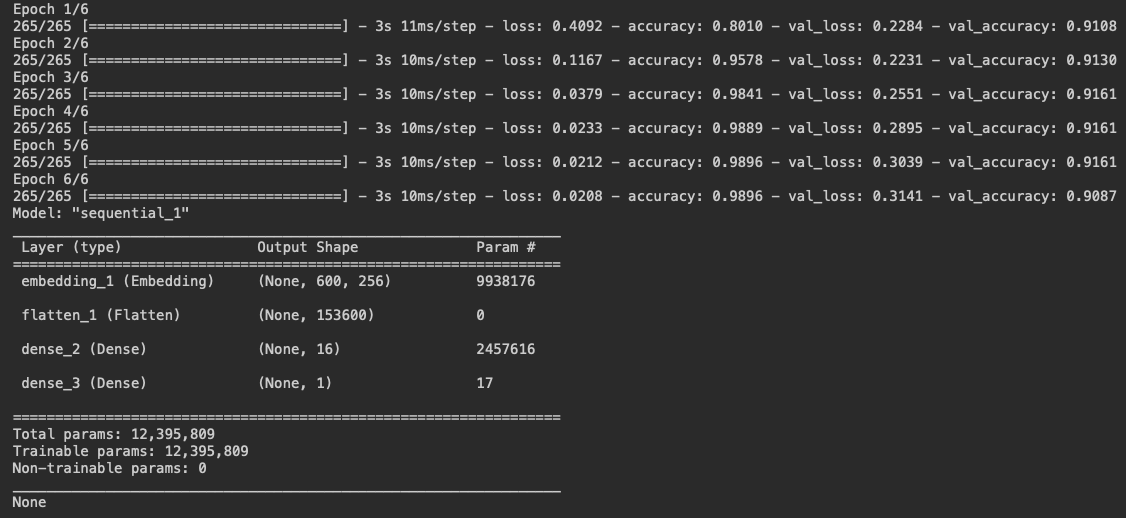
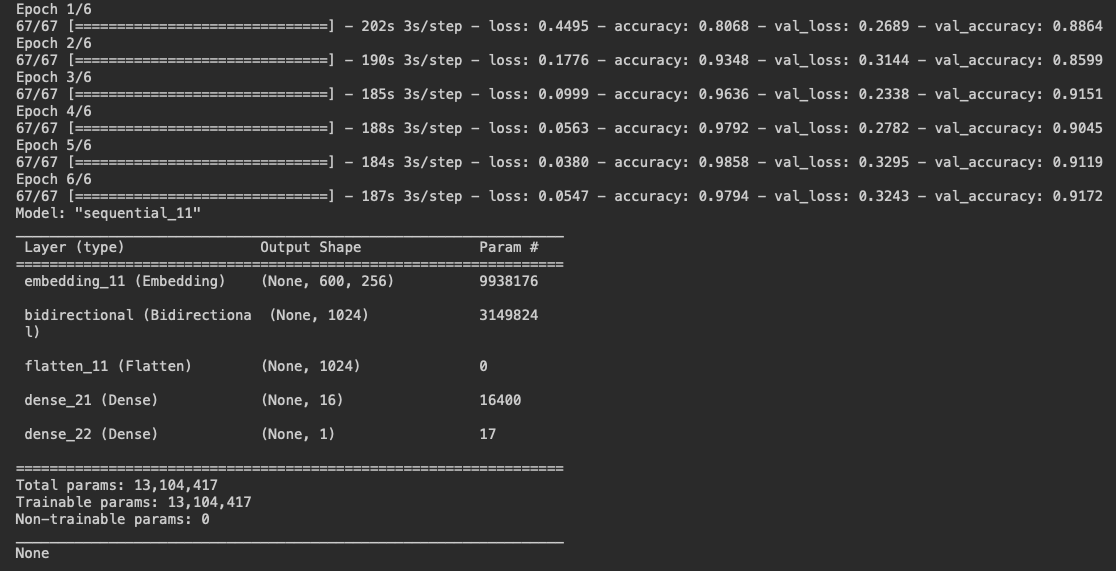
확률 기반, Co-occurence, LSTM, Bi-LSTM등 여러 시행착오를 거쳤지만 결과는 만족스럽지 못했어요.
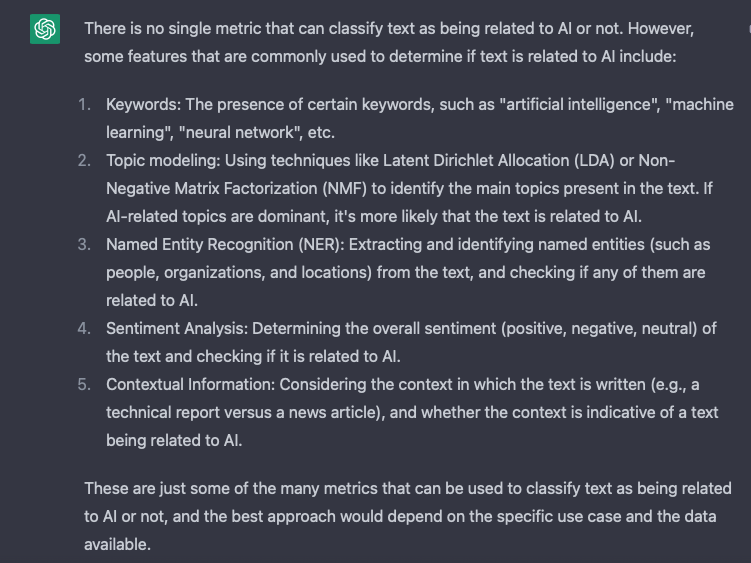
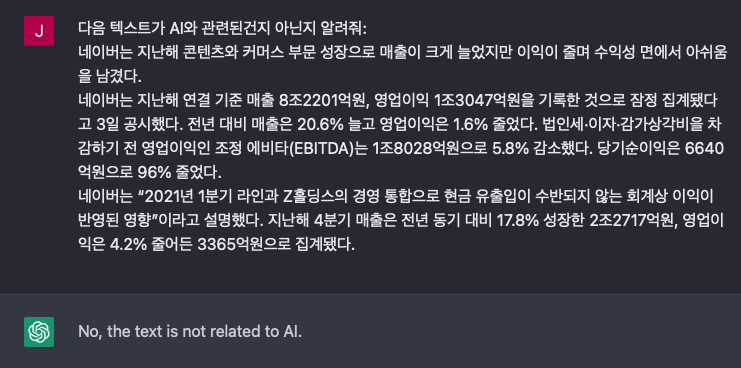
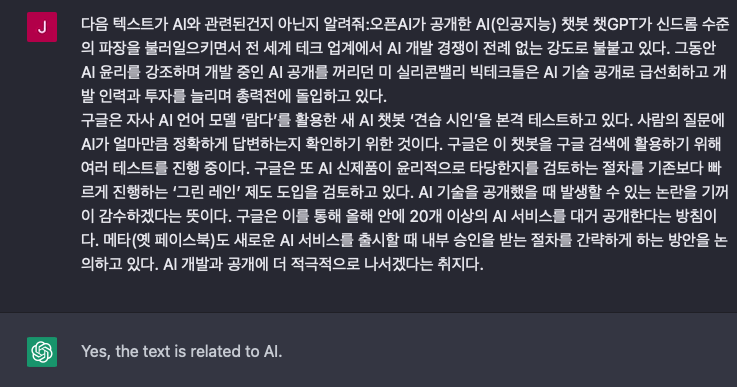
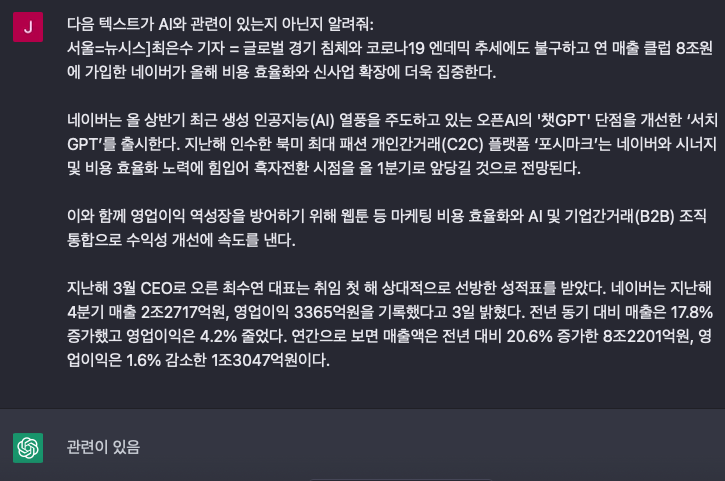
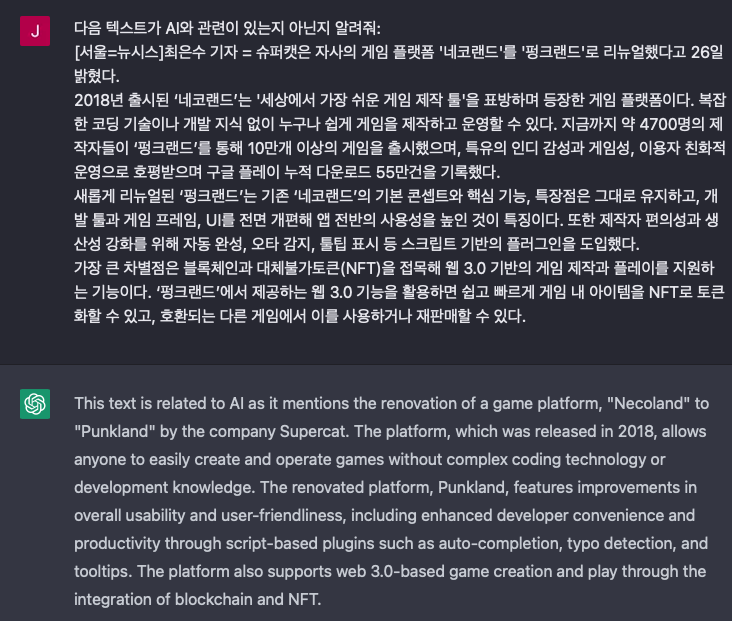
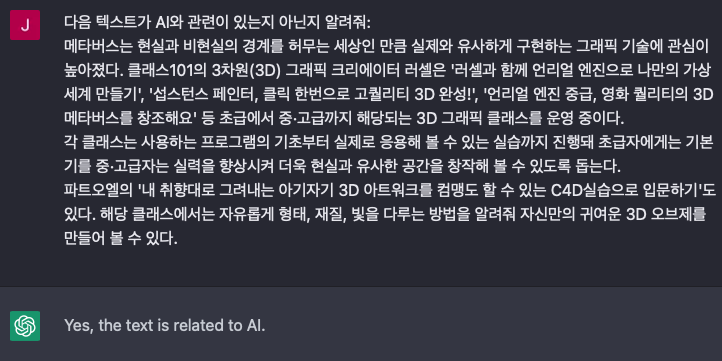
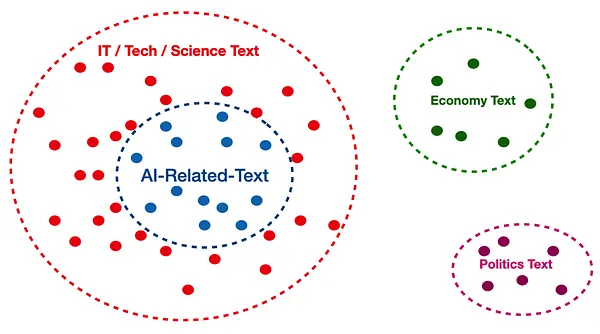
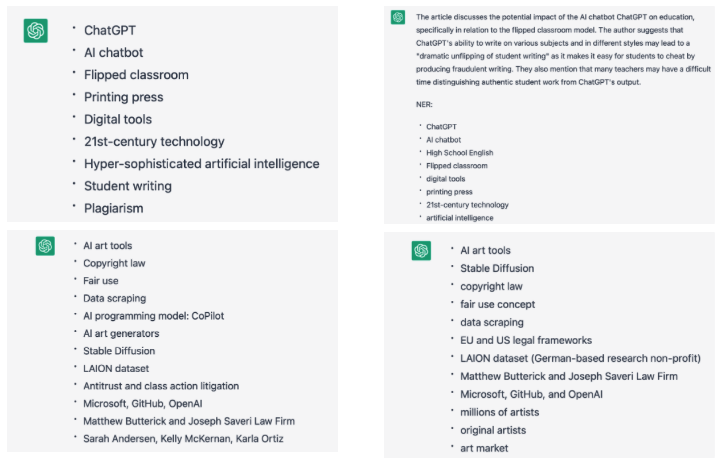
그렇다면, 요약문으로부터 Named entity를 추출하면 어떨까 생각했어요. 제가 여러 요약문을 보았을 때, 거의 Named-entity들은 키워드가 되기에 충분했어요. 아래의 예제는 ChatGPT에게 Article을 주고 각각 키워드 추출, 요약으로부터 Named-entity를 추출하게한 결과에요. 중요한 단어들은 거의 다 포함하고 있답니다.
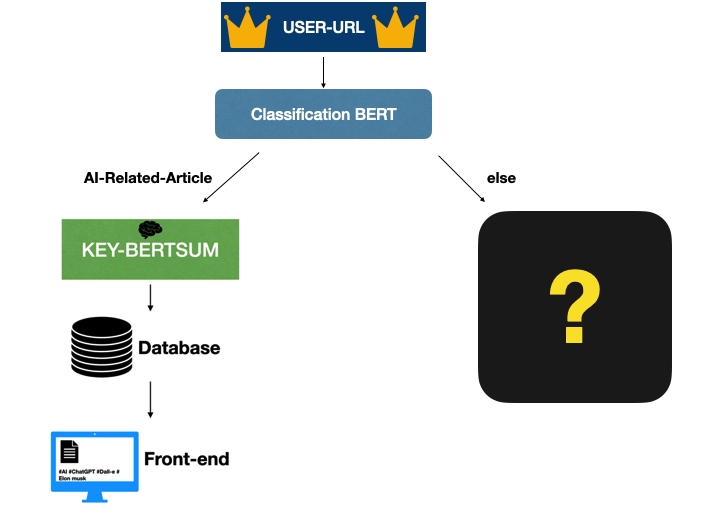
흠,, 이제 요약문을 추출해야하는데 가장 대표적인 방법으로 pre-trained LM인 BERT를 사용하는 BERTSUM이 있었습니다. BERTSUM을 학습시키고 NER 층을 통과시켜서 키워드를 추출해서 키워드 데이터셋이 필요없는 모델을 만드는 것이 전체적인 구상이었습니다.
4.2. Data
cnn_dailymail · Datasets at Hugging Face
데이터셋 구조:
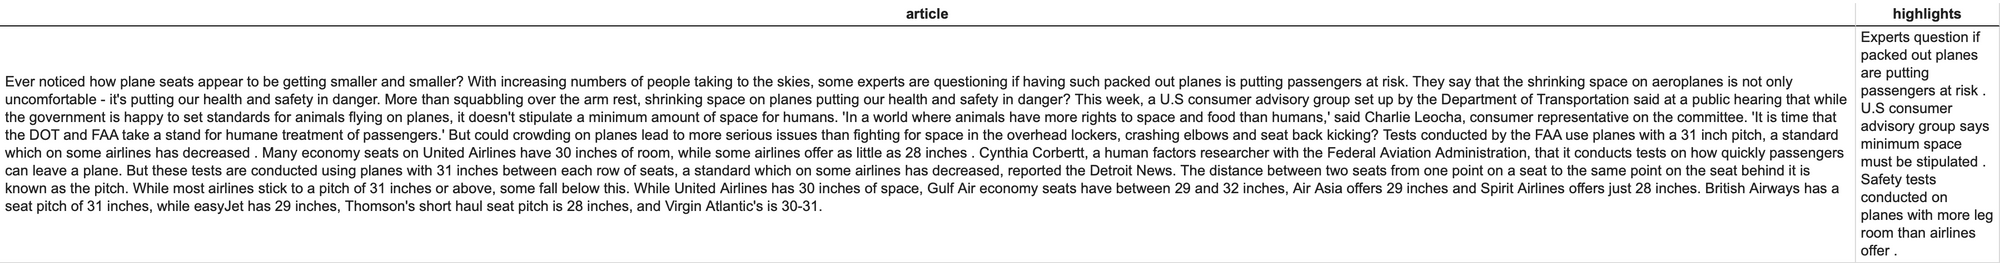
CNN/DM 데이터셋은 Article, Highlights 구조로 되어있습니다. Article은 본문 Highlights는 요약문을 나타내는데, 이 Highlights가 사람이 분석한 Gold-Summary이기 때문에, Article 문장과 대조하여 ROUGE-2 점수를 기준으로 해당 문장이 Summary에 해당하는지 아닌지 Binary 형태의 리스트로 변환시킬 필요가 있습니다.
AI-Hub
데이터셋 구조:

AIhub 뉴스 요약데이터는 index-n : n번째 문장 데이터와 Extractive에 추출적 요약을 위한 gold-summary 문장 인덱스가 있습니다. 따라서 해당 데이터셋은 ROUGE-2 score를 구하는 가공이 필요가 없습니다.
다만, 가끔씩 index에 문장이 없는 경우가 있어서 이런 예외 케이스들을 2차 가공으로 걸러주어야합니다.
AIhub 데이터는 요청이 필요합니다!
4.3. Techniques
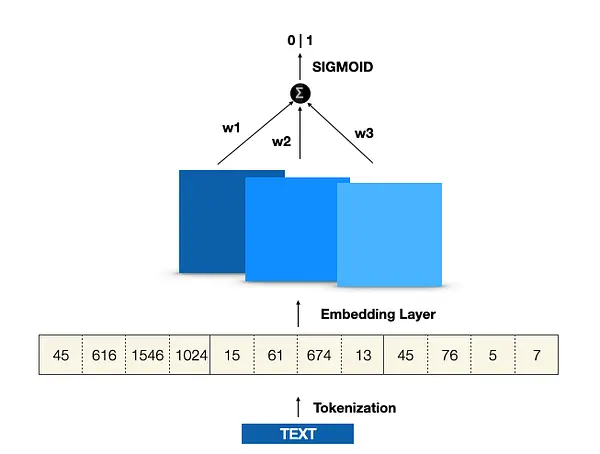
대략적인 모델은 다음과 같습니다.
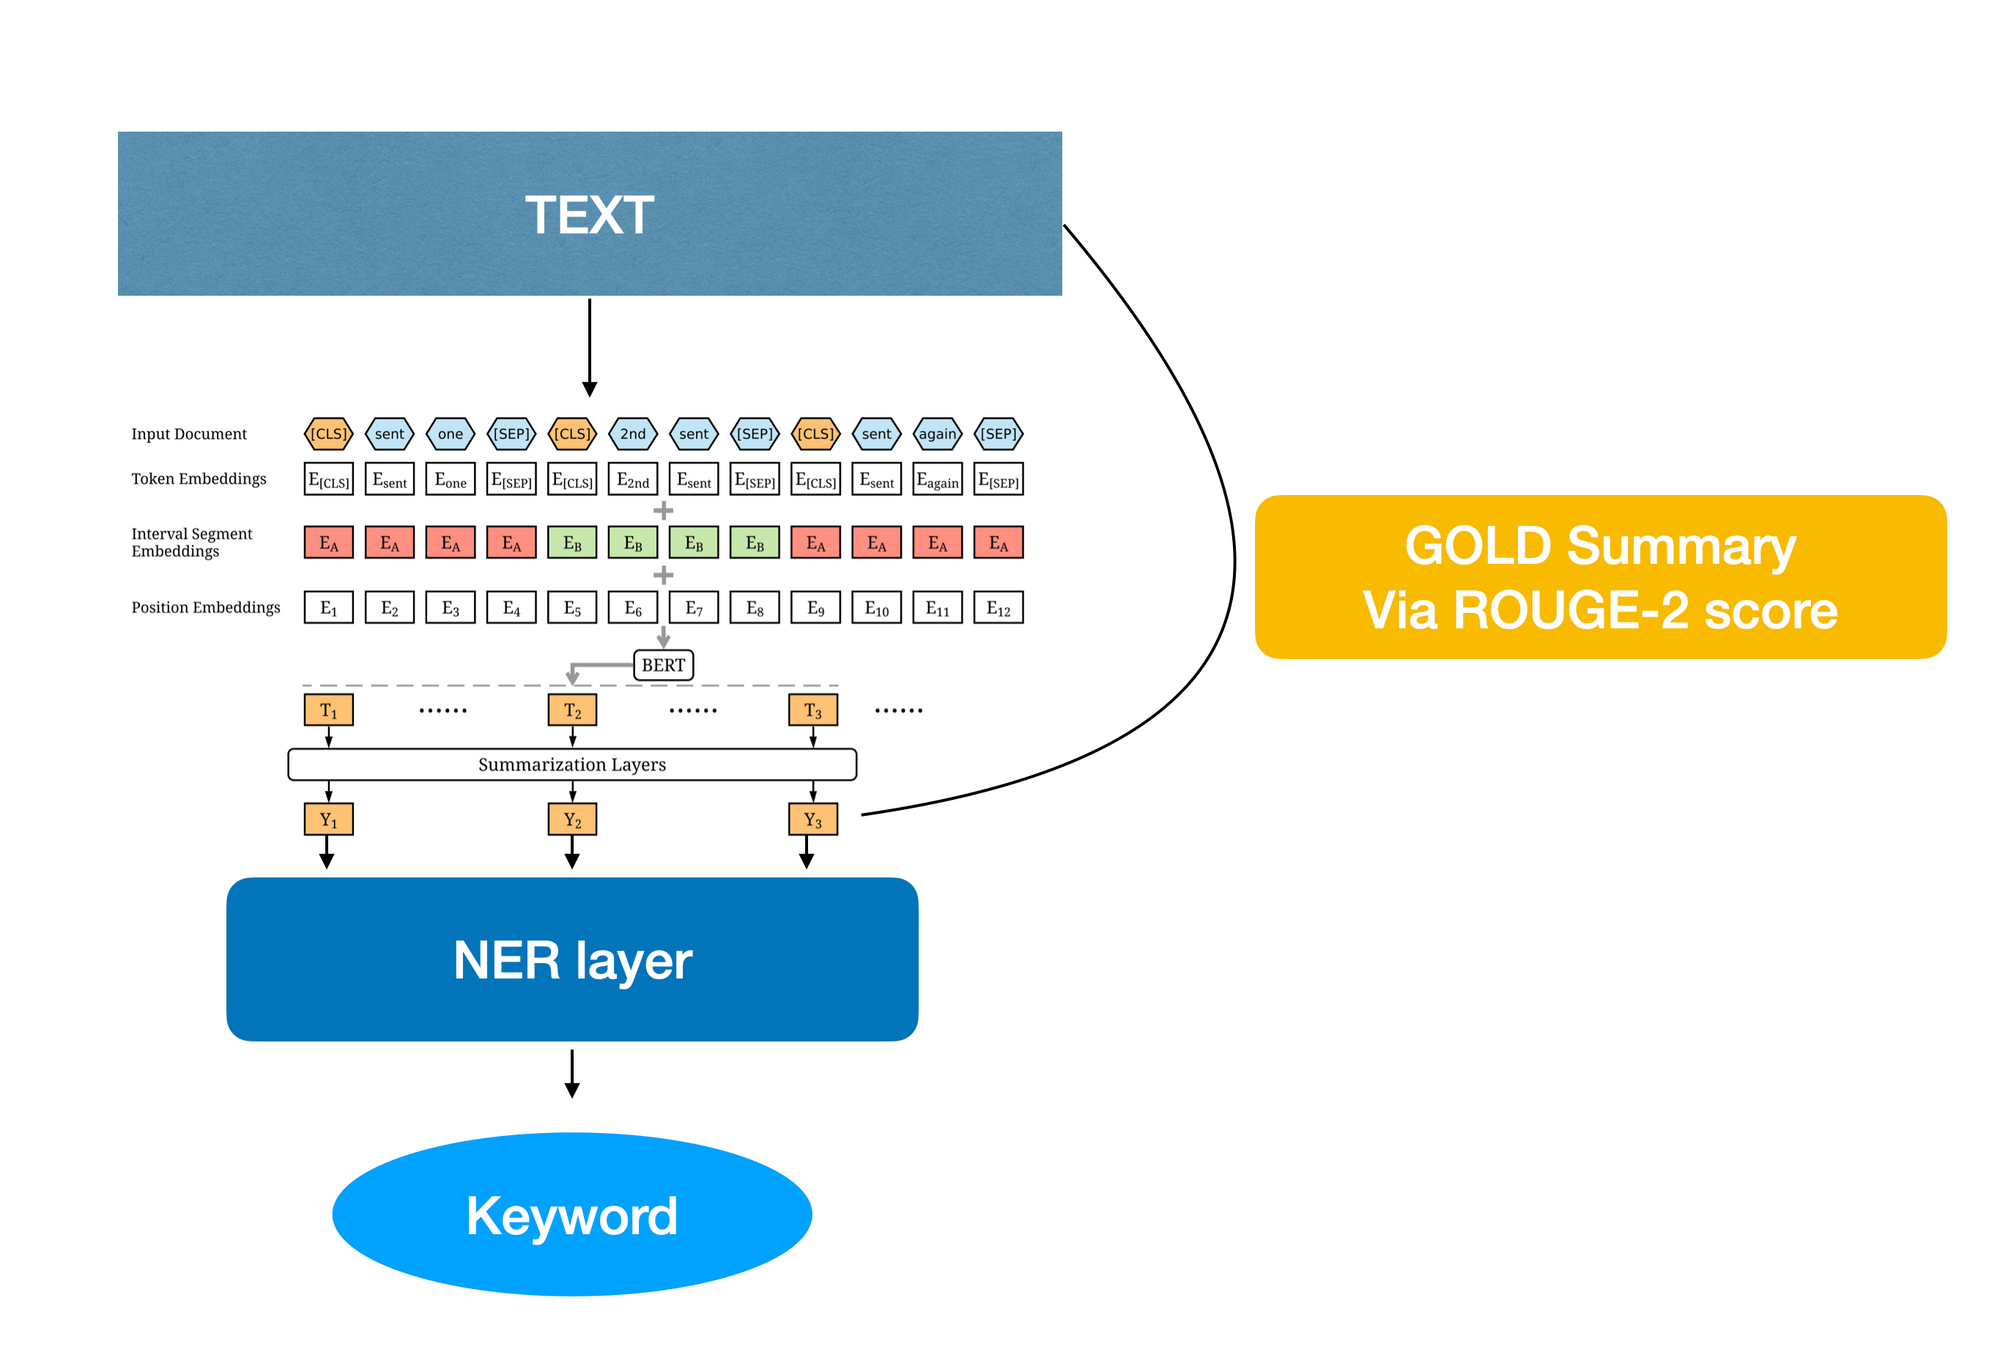
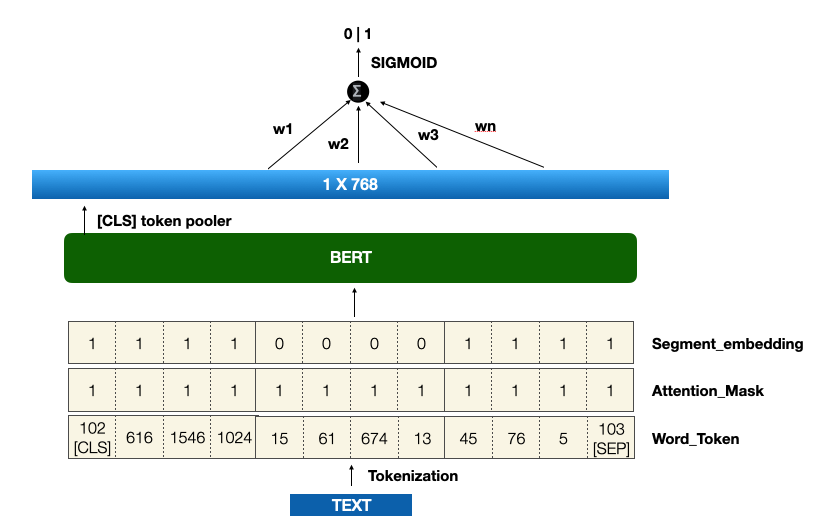
입력받은 텍스트로부터 Tokenization을 진행합니다. Bert 구조에 맞게 포지션 인코딩, Segment 인코딩, 어텐션데이터를 추출해줍니다. 하지만 BERTSUM 구조에서는 [CLS] 토큰을 매 문장 앞에 넣는 것을 잊지마세요!
문장 Feature 데이터가 [CLS] 위치에 저장이 될테니 [CLS] 토큰 위치도 저장해주고요.
그 다음, pre-trained LM인 BERT에 집어넣어줍니다. 알아서 특징을 뽑아내어 줄거에요.
우리는 해당 CLS토큰에 가서 잘 나온 Feature vector들로 다시 이중 Transformer Encoder Layer로 통과시켜줍니다. 그렇다면 앞뒤 문맥을 파악하여 어느 문장이 대표가 될 지 확실하게 알 수 있을거에요. (문장들도 단어와 마찬가지로 위치정보가 중요하니, 포지션 인코딩 잊지말고요!) 이제 Sigmoid 함수로 과연 요약문이 될 수 있을지 아닐지 Binary-Classification을 해주면 BERTSUM 구현은 끝이 난답니다.
이제 결과를 비교하고 Back-propagation을 해야하는데, 어라?! CNN/DM 데이터셋에서는 GOLD-SUMMARY만 제공을 하네요.. 논문에서 나온 것처럼 python-rouge 모듈을 import하여 ROUGE-2 F1 score로 해당 문장이 요약문인지 아닌지 표현하는 binary list로 바꿔줍시다.
다행히 AIhub는 Extractive-summary index를 제공한답니다.
자 이렇게 BERTSUM 학습을 시키면 끝이납니다.
이제 BERTSUM에서 구해진 핵심 문장들을 가지고와서 NER 모델을 통해 Named-entity를 추출하면 키워드 추출이 끝이납니다.
4.4. Result
NEWS : https://tech.hindustantimes.com/tech/news/dalle-2-to-stable-diffusion-generate-photos-freely-with-these-ai-tools-71674561212855.html
🔥 등록하신 Article은 english입니다. 5-sentence summarization :
DALL-E 2 to Stable Diffusion, generate photos freely with these AI tools One of the most rapidly growing fields that has the potential to revolutionize the way we live and work is Artificial Intelligence (AI) It was revealed by OpenAI on January 21 and uses a modified version of GPT3 to generate realistic-looking images There's an AI which can help you make realistic AI photos in just seconds! Called DALL-E, it is a deep-learning model developed by OpenAI to generate digital images with language descriptions And it's not just DALL-E that can help users create digital art pieces using AI
Keyword from 5-sentence :
{'OpenAI', 'DALL-E 2', 'GPT3', 'Stable Diffusion', 'Intelligence', 'AI', 'DALL-E'}
NEWS : https://www.artificialintelligence-news.com/2023/01/20/google-speed-up-ai-releases-in-response-chatgpt/
🔥 등록하신 Article은 english입니다.
5-sentence summarization :
The New York Times claims ChatGPT set off alarm bells at Google Google is reportedly set to speed up its release of AI solutions in response to the launch of ChatGPT In 2020, leading AI ethics researcher Timnit Gebru was fired by Google At the invite of Google CEO Sundar Pichai, the company’s founders – Larry Page and Sergey Brin – returned for a series of meetings to review Google’s AI product strategy Gebru claims she was fired over an unpublished paper and sending an email critical of the company’s practices
Keyword from 5-sentence :
{'ChatGPT', 'Larry Page', 'Timnit Gebru', 'AI', 'Gebru', 'Google', 'Sundar Pichai', 'The New York Times', 'Sergey Brin'}
NEWS : https://www.artificialintelligence-news.com/2023/01/19/openai-ceo-people-begging-disappointed-about-gpt-4/
🔥 등록하신 Article은 english입니다.
5-sentence summarization :
An improved version, GPT-3.5, powers the ChatGPT chatbot GPT-3 arrived in 2020 OpenAI CEO Sam Altman believes there is too much hype around the next major version of GPT The ability to generate mass amounts of content could exacerbate issues like misinformation and propaganda OpenAI has never rushed the release of its models due to concerns about the societal impact
Keyword from 5-sentence :
{'OpenAI', 'Sam Altman', 'GPT-3', 'ChatGPT', 'GPT-3.5', 'GPT'}
NEWS : https://www.aitimes.kr/news/articleView.html?idxno=27195
🔥 등록하신 Article은 korean입니다.
5-sentence summarization :
SK텔레콤(대표 유영상)이 2월 중 성장형 AI 서비스 ‘에이닷’에 오래된 정보를 기억해 대화에 활용할 수 있는 ‘장기기억’ 기술과 사진, 텍스트 등 복합적인 정보를 함께 이해할 수 있는 멀티모달(Multi-modal) 서비스를 장착해 본격적인 서비스 고도화에 나선다고 24일 밝혔다 또한, 세계 최초로 한국어 GPT-3 상용화 서비스를 시작한 앞선 기술력을 바탕으로 챗GPT(ChatGPT)와 같은 생성AI (Generative AI) 모델을 접목하는 등 지속적인 R&D 투자를 통해 국내 초거대 AI 서비스 시장을 선도해 나갈 방침이다 해당 정보들은 이용자가 좋아하는 것, 싫어하는 것, 직업, 취미, MBTI 유형, 애완동물까지 다양한 정보가 포함된다 먼저, 오는 2월 중 이용자가 에이닷과 오래 전에 대화했던 내용 중 중요한 정보를 별도의 메모리에 저장해두고, 사람이 마치 뇌 속에서 오래된 기억을 끄집어 내 듯이 대화 중에 활용할 수 있는 ‘장기기억’ 기술을 에이닷에 적용할 계획이다 예를 들어, 에이닷에게 “오랜만에 지하철 탔는데 환승하기 귀찮아”라고 말하면 “너 원래 택시타는 거 좋아했자나”라며 이용자가 과거에 에이닷과 대화했던 내용을 기억해 답변해주는 식이다
Keyword from 5-sentence :
{'챗GPT', '유영상', '에이닷', 'ChatGPT', 'MBTI', 'AI', 'SK텔레콤', '한국어 GPT-3'}
NEWS : https://www.aitimes.com/news/articleView.html?idxno=148979
🔥 등록하신 Article은 korean입니다.
5-sentence summarization :
구글이 '달리(DALL-E)'나 '이마젠(Imagen)'보다 훨씬 빠른 속도로 고품질 이미지를 생성할 수 있는 새로운 텍스트 이미지 인공지능(AI) 모델 ‘뮤즈(Muse)’를 공개했다고 벤처비트가 13일(현지시간) 보도했다 구글이 이번에 공개한 '뮤즈'는 256x256 이미지를 0.5초 만에 생성할 수 있는 것이 특징이다 이마젠이 9.1초 걸리는 것과 비교하면 이미지 생성 속도가 무려 20배 가까이 향상됐다 생성한 이미지의 품질도 훨씬 우수하다 생성 AI로 생성한 이미지의 품질과 정확성을 측정하는 두가지 메트릭인 CLIP 및 FID에서 다른 모델들보다 높은 점수를 기록했다
Keyword from 5-sentence :
{'Muse', '구글', '벤처비트', '뮤즈', 'AI', 'Imagen', '달리(DALL-E)', '이마젠'}
원하는 요약문과 키워드가 깔끔하게 추출되었습니다.
4.4. Conclusion
위 결과에서도 나왔듯이 Tag를 필요로 하는 명사들이 깔끔한 형태로 잘 추출되었습니다. Appendix→Alternatives에서도 언급하겠지만, 기존 모델보다 조사와 punctuation등으로 오염된 데이터가 아니라 깔끔한 명사가 추출이 되었습니다. 만약 오염된 키워드가 뽑힌다면 그 키워드를 기준으로 다른 Article들로 퍼져나가지 못할 수 있습니다. 즉, 딕셔너리 Key-error가 일어날 수 있기 때문에 그 관점에서 정말 만족할만한 결과가 나왔습니다. 물론 문장을 대표할 수 있는 키워드기도 하고요!
앞으로 유저가 만족할 때까지 해당 모델을 기반으로 발전해나가기로 결정했습니다!
5. Implementation
5.1. High-level design
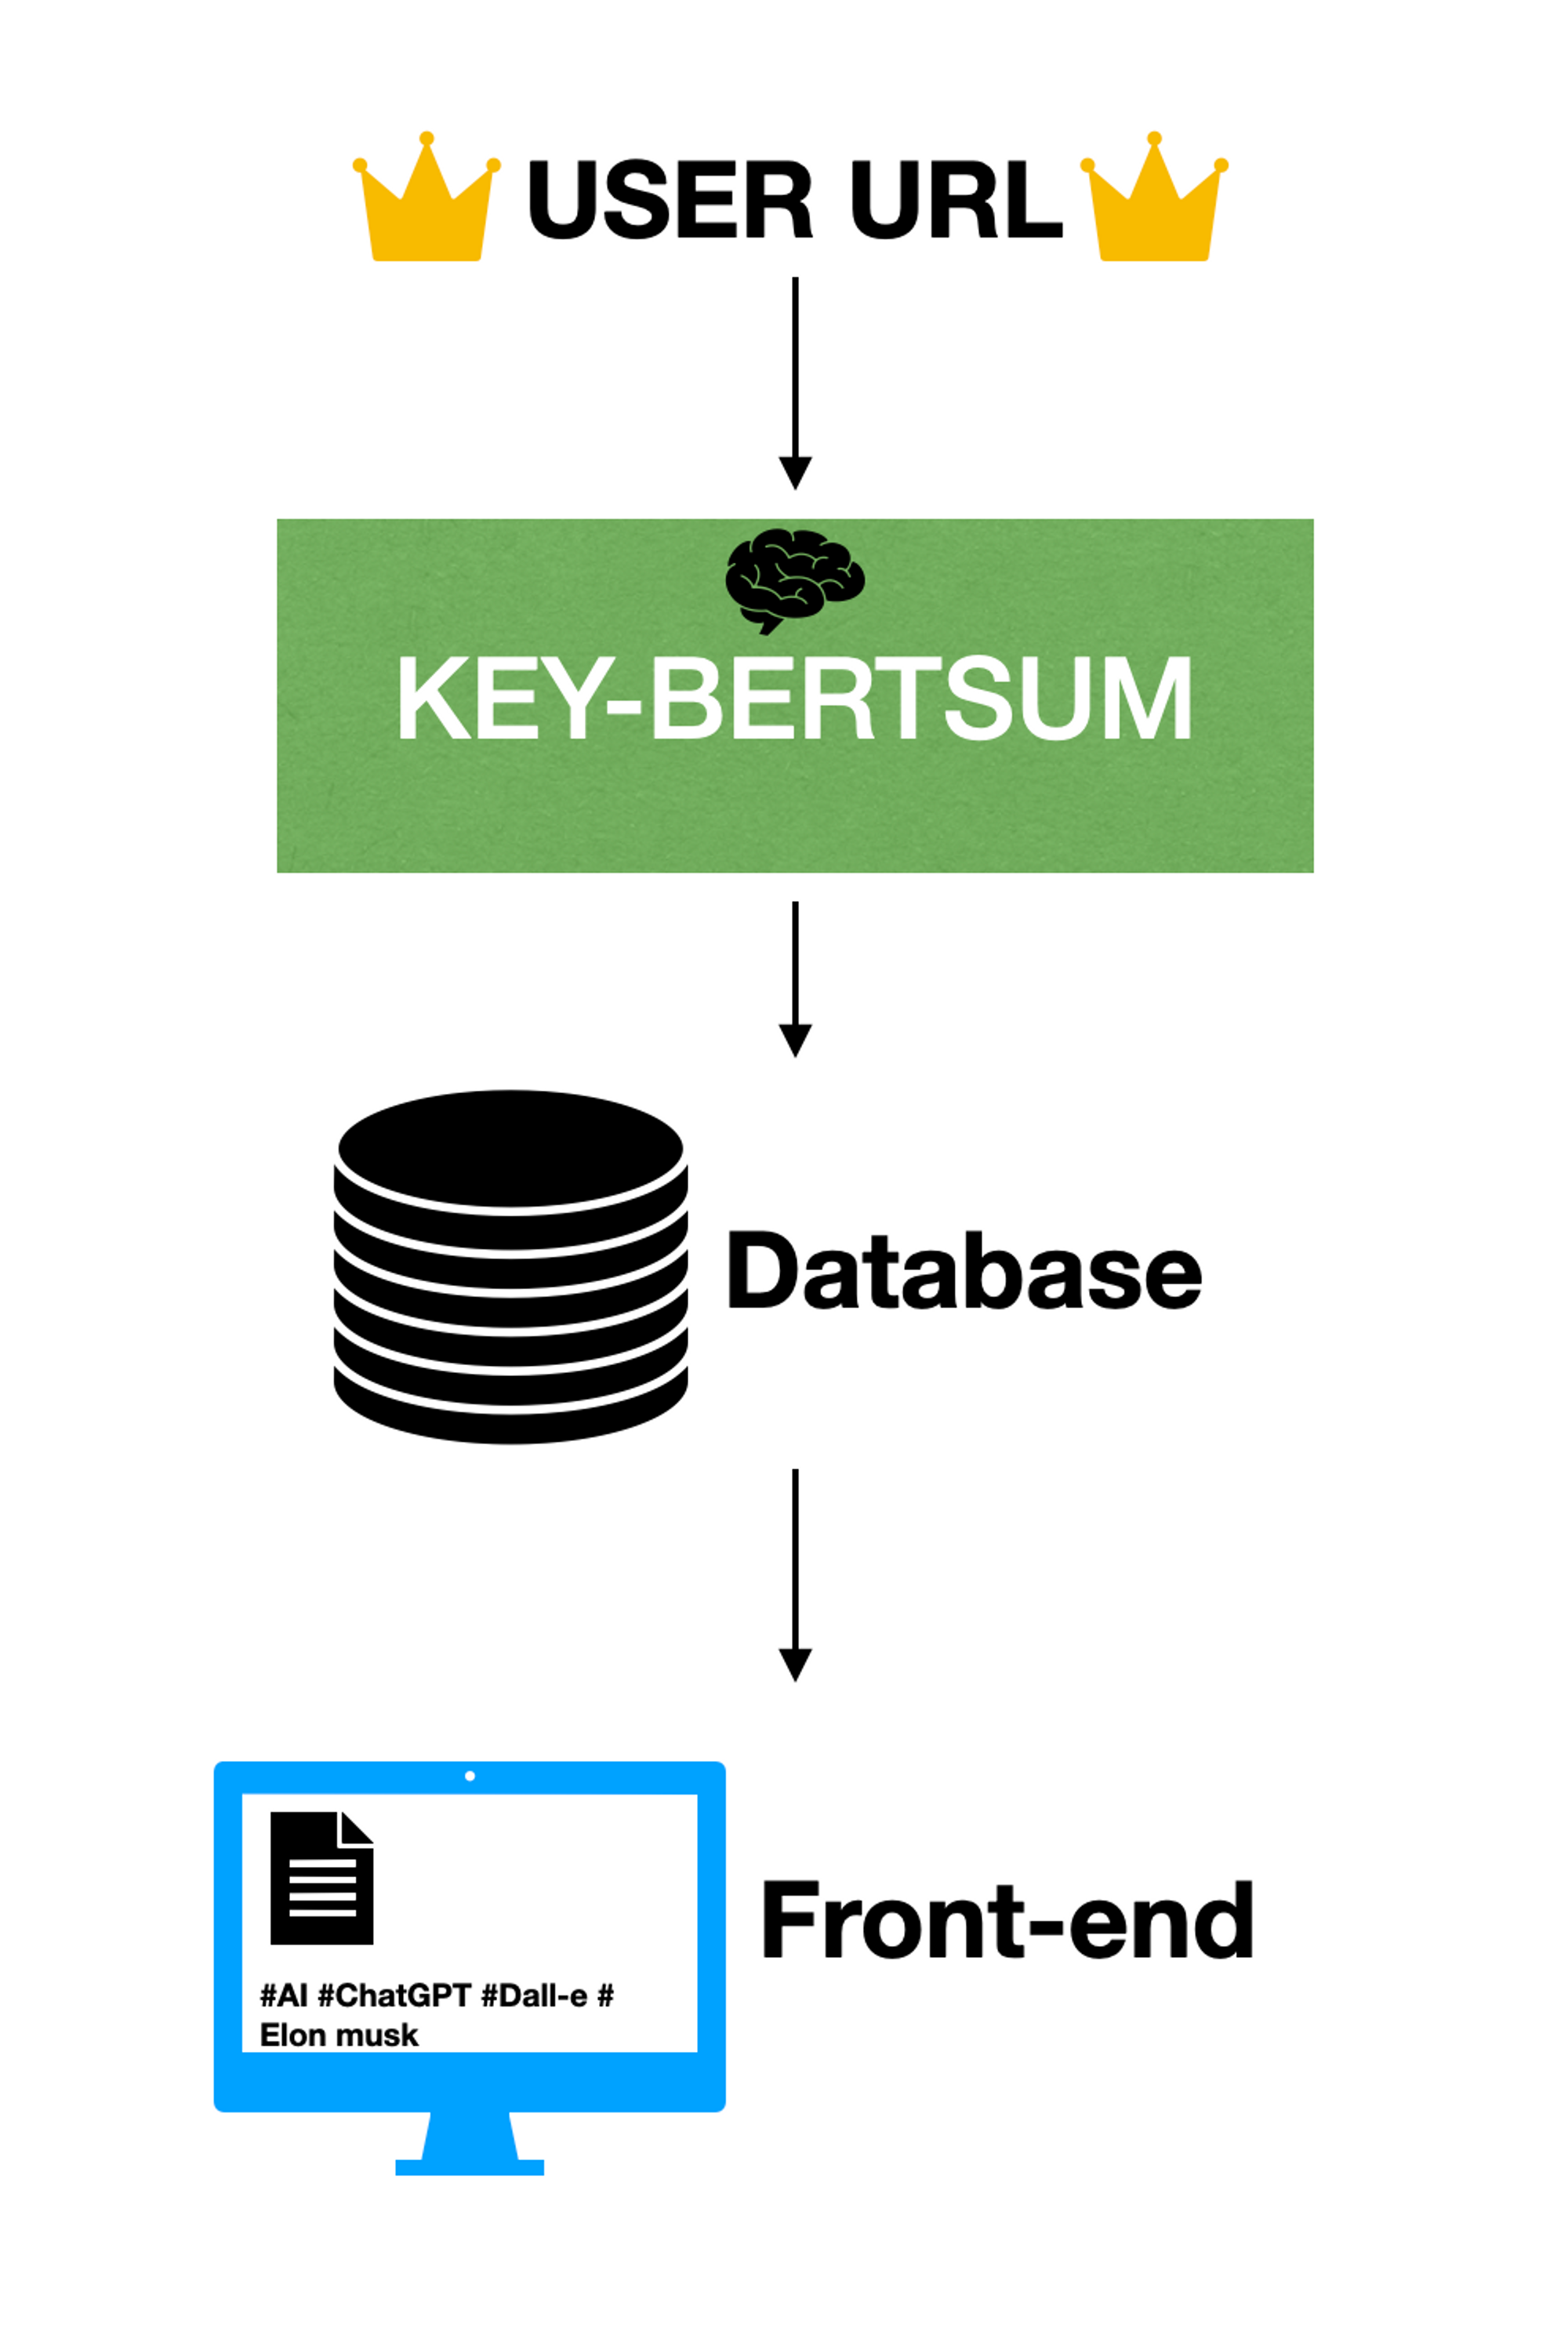
유저가 URL을 사이트에 넣으면, 우리는 그 URL에서 텍스트를 추출하여 KEY-BERTSUM으로 문장 요약문과 키워드 데이터를 데이터 베이스에 저장하고, 앞에 #을 붙이고 하이퍼링크 등을 첨부하여 잘 가공된 형태로 유저 Interface에 제공합니다.
5.2. Performance (Throughput, Latency)
문서의 길이에 따라서 다르지만 평균적으로 Colab 무료 환경에서 문서당 요약문, 키워드 추출까지 약 2~3초가 소요됩니다.
6. Appendix
6.1. Previous models
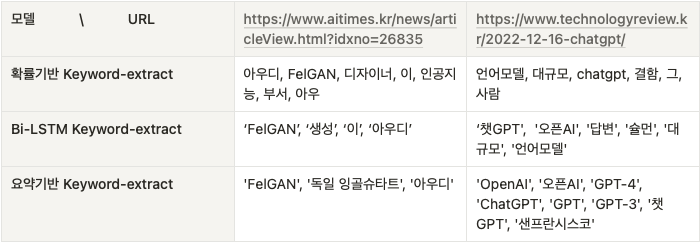
6.2. Alternatives
Keyword 추출하는 알고리즘은 여러가지가 있는데, 영어에서 Yake, Keybert, chatgpt 한국어에서 Yake, KR-wordrank로 비교해보겠습니다. (Chatgpt 한국어 키워드 추출에서는 계속 에러가 발생하네요,,,)
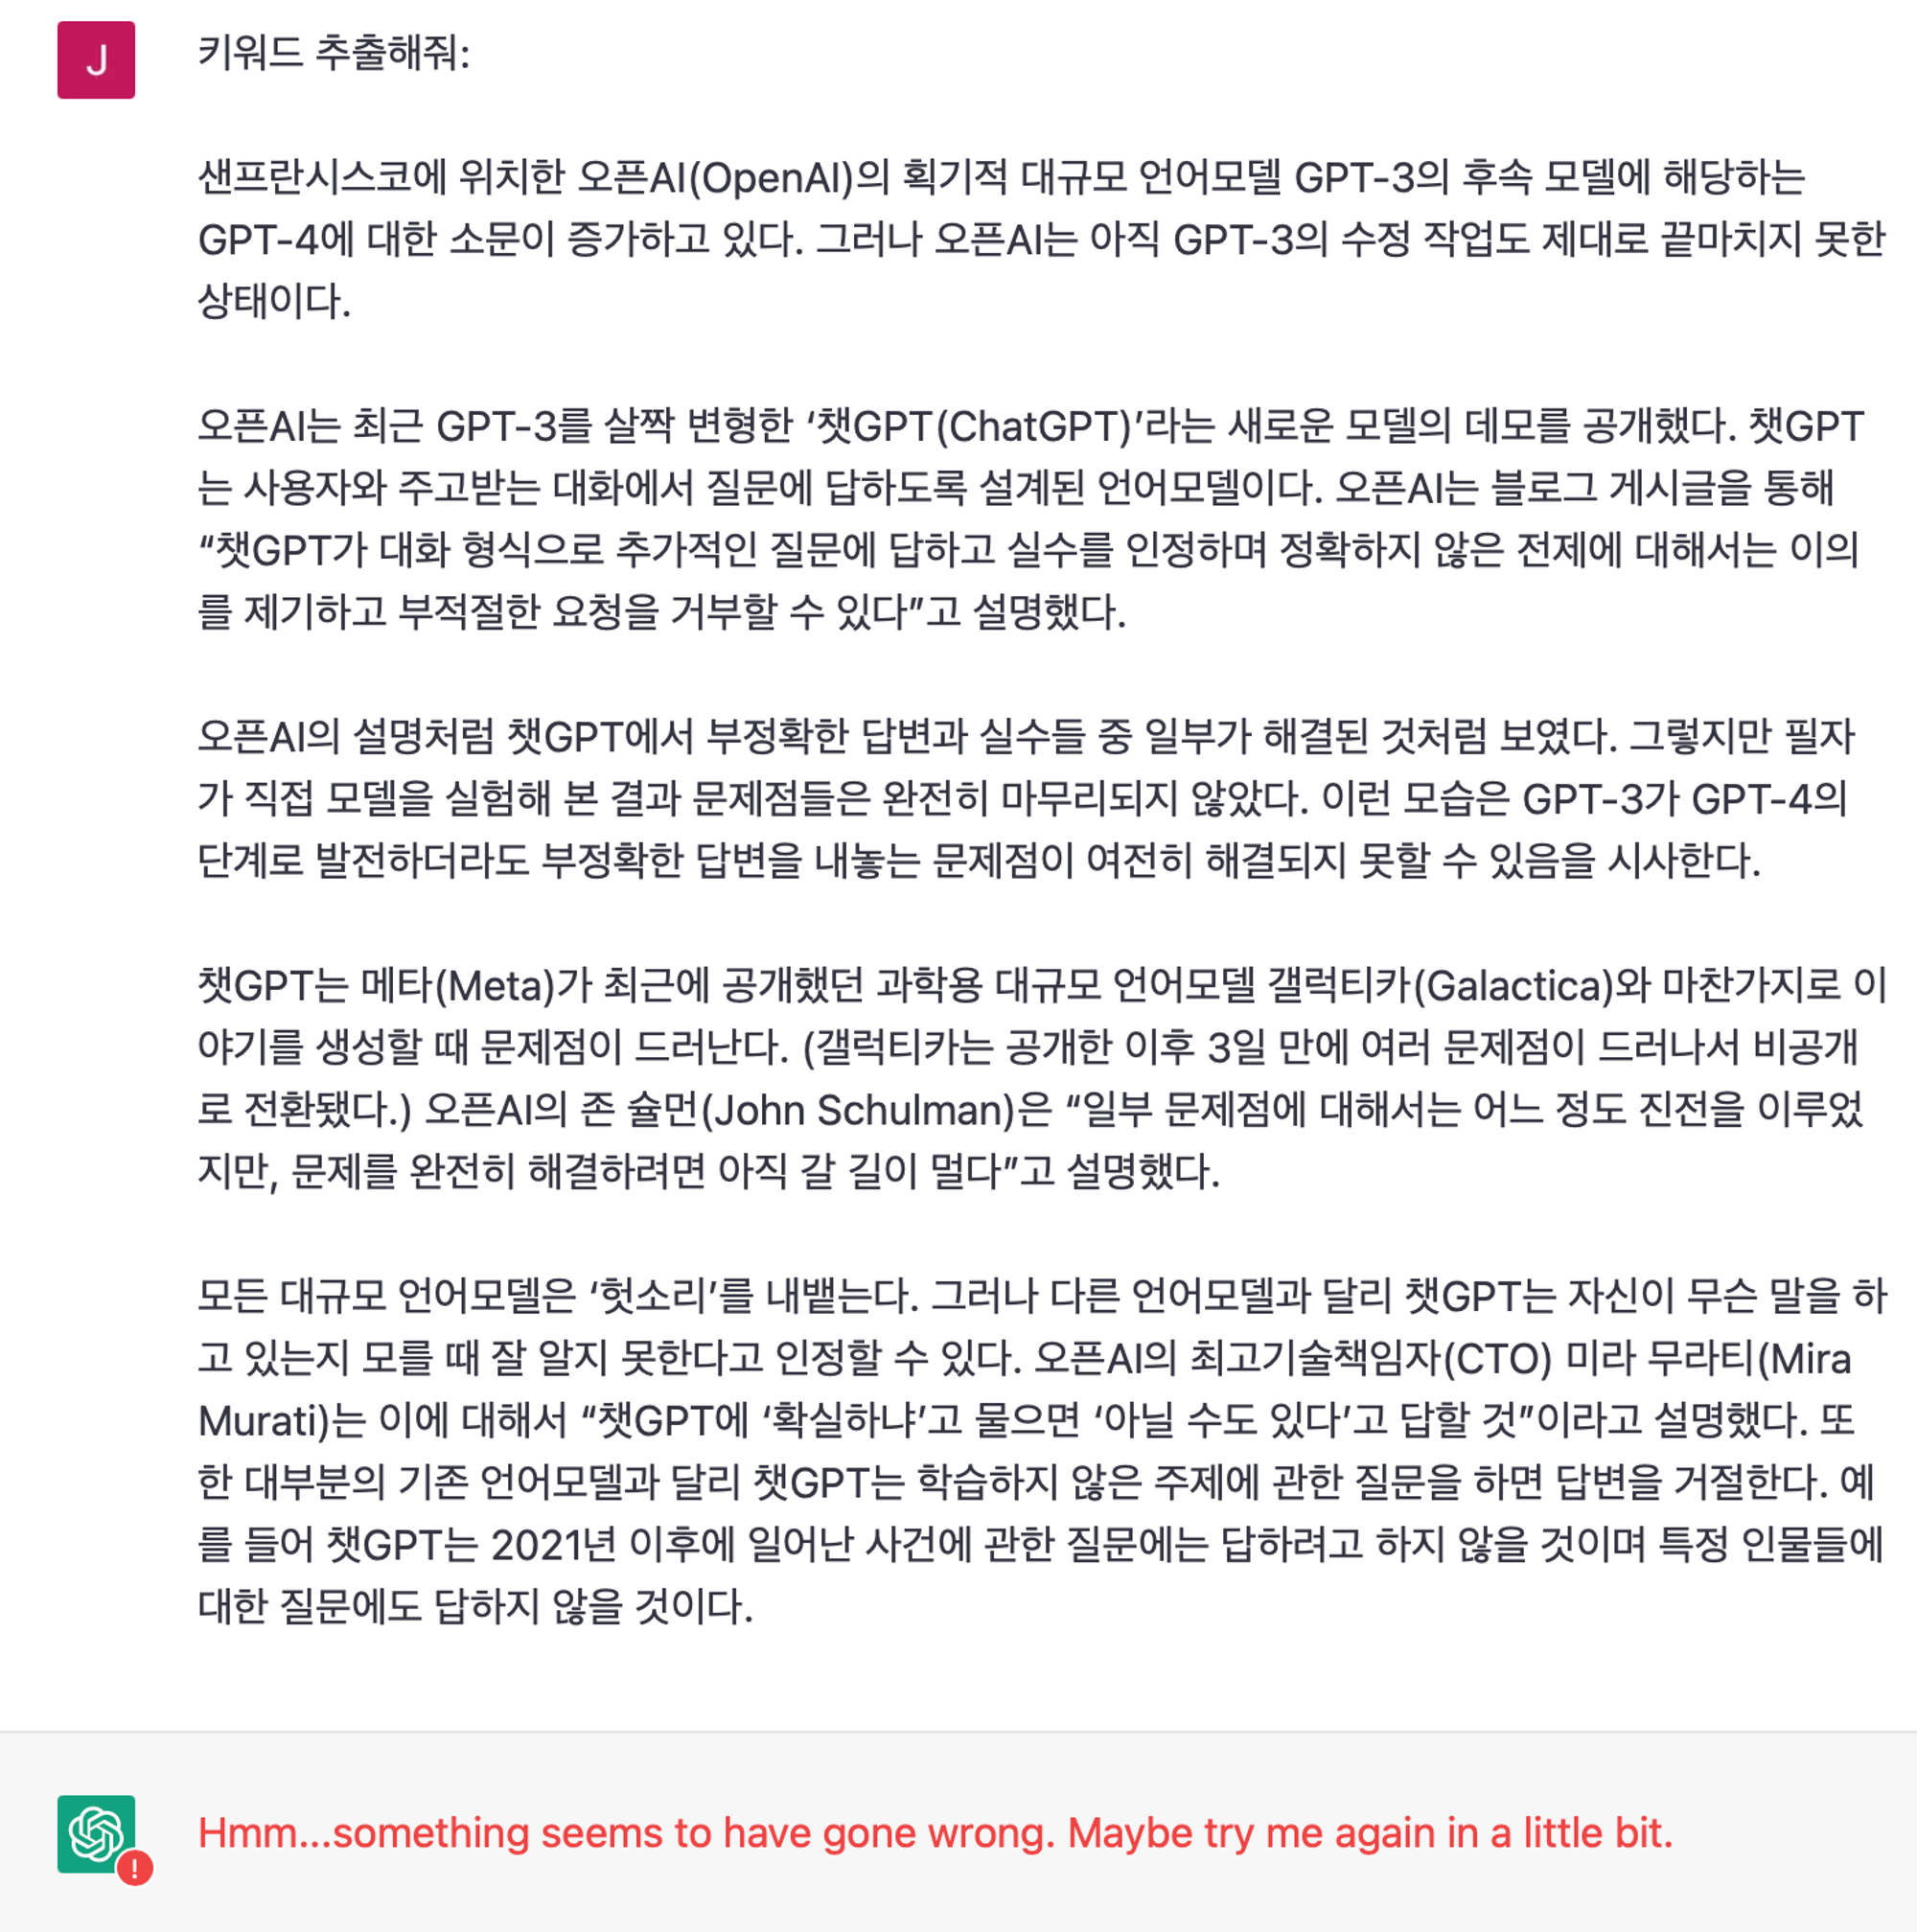
(진짜 기사 제목처럼 chatGPT가 헛소리를 하네요.)
이제 비교결과를 보시죠!
DALL-E 2 to Stable Diffusion, generate photos freely with these AI tools
Yake: {Stable Diffusion, Artificial Intelligence, generate, images, Generate digital images}
Keybert : {A new tool can generate a number of pictures in minutes, and it takes only}
chatgpt : {"DALL-E 2", "Stable Diffusion", "Mage.Space"}
KEY-BERTSUM : {'OpenAI', 'DALL-E 2', 'GPT3', 'Stable Diffusion', 'Intelligence', 'AI', 'DALL-E'}
Google to speed up AI releases in response to ChatGPT
Yake: {Google, ChatGPT Ryan, company, Google CEO Sundar, TechForge Media, senior editor, decade of experience}
Keybert : {At the start of the year, Google's chief executive officer, Tim, decided to take}
chatgpt : {"Google", "AI", "ChatGPT", "Sundar Pichai", "Larry Page", "Sergey Brin", "Timnit Gebru", "AI ethics”}
KEY-BERTSUM : {'ChatGPT', 'Larry Page', 'Timnit Gebru', 'AI', 'Gebru', 'Google', 'Sundar Pichai', 'The New York Times', 'Sergey Brin'}
SKT, 한국어 GPT-3 기반 '에이닷' 상용화 이은 생성AI '챗GPT' 연계한다!
Yake: {SKT, 한국어, 초거대, GPT, 서비스, 서비스를, chatGPT, 정보를}
KR-wordrank : {'AI', '서비스', '한국어', '있는’, 'GPT-3', 'SKT는’, '있다', '대화'}
KEY-BERTSUM : {'챗GPT', '유영상', '에이닷', 'ChatGPT', 'MBTI', 'AI', 'SK텔레콤', '한국어 GPT-3'}
더 빠르고 정교해진 이미지 생성 AI...구글, '뮤즈' 공개
Yake: {속에서 씌어진 벽난로, Muse’ 라는 단어가, ‘뮤즈( Muse, 이미지, 빠르고 정교해진 이미지, 씌어진 벽난로}
KR-wordrank : {‘이미지', '생성', '토큰', '모델', '사용', '뮤즈', '텍스’}
KEY-BERTSUM : {'Muse', '구글', '벤처비트', '뮤즈', 'AI', 'Imagen', '달리(DALL-E)', '이마젠'}
Pros:
- 다른 프로그램보다 태깅에 용이한 키워드들을 깔끔하게 추출하는 것을 볼 수 있습니다.
- Article에서 고려할만한 주요단어들이 태깅되었다.
Cons:
- Bert 구조적 한계로 Article을 512개의 토큰내에서 truncate해야하는 단점이 있었습니다.
- 길이에 따라 전체 Article을 고려하지 못할 수 도 있습니다.
- KR-wordrank에 비해 시간이 오래걸립니다. (KR-wordrank는 ML기반이 아니라서 비교적 빠릅니다.)
6.3. Milestones & Timeline
모델 구상 및 BERT 이해 : 1.5 day
데이터 가공 : 0.5 day
모델 설계 및 실험 : 0.5 day
6.4. Glossary
BERT
BERTSUM
NER
Transformer
Rouge
6.5. References
BERT 개념 정리 (특징/구조/동작 방식/종류/장점/BERT 모델 설명)
GitHub - nlpyang/BertSum: Code for paper Fine-tune BERT for Extractive Summarization
점프 투 파이썬
jplu/tf-xlm-r-ner-40-lang · Hugging Face
rouge-score