정규화 1
√ Overfitting 해결을 위한 Regularization 방식
이 때 사용하는 방식이 regularization이다.
Regularization은 ‘정규화’라는 말로 번역이 되기도 하지만,
‘일반화’라고 번역을 하는 것이 더 적합한 것 같다.
이 용어는 기계 학습뿐만 아니라 통계에서도 흔히 사용이 되는 용어이다.
Regularization은 일정의 penalty 조건에 해당이 된다.
지난 [Part III. Neural Networks 최적화] 1. Overfitting의
‘오캄의 면도날(Occom’s razor)’ 이론에서 소개했던 것처럼,
대체로 복잡한 쪽보다는 간단한 쪽으로 선택을 유도한다.
통상적으로 기계학습이나 통계적 추론을 할 때
cost function 혹은 error function이 작아지는 쪽으로 진행을 하게 된다.
단순하게 작아지는 쪽으로만 진행을 하다 보면,
특정 가중치 값이 커지면서 오히려 결과를 나쁘게 하는 경우도 있다.
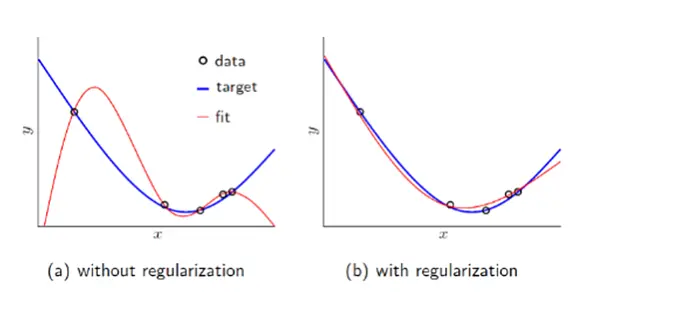
이와 같은 regularization 방식이 학습에 더 좋은 학습 결과를 가져오는 경우를 보여주는 그림이다.
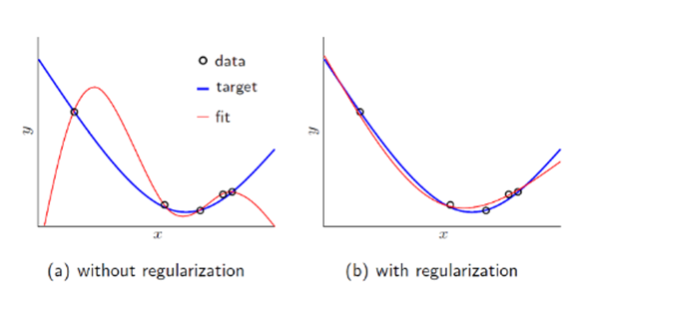
오버피팅 (Overfitting)의 문제점이 학습의 성능을 떨어뜨린다.
문제 설명: 너무 단순하게 오차(에러)를 최소화하려고만 하면, 특정 가중치(weight) 값이 지나치게 커져서 모델이 데이터를 너무 잘 맞추려고 하다 보니, 오버피팅이 발생할 수 있습니다. 이는 훈련 데이터에 과도하게 맞춰진 모델이 새로운 데이터를 제대로 처리하지 못하게 만드는 원인입니다.
예시 1: 집값 예측 모델
만약 우리가 집값을 예측하는 모델을 만들고 있다고 가정해봅시다. 이 모델은 다양한 입력값(예: 집의 면적, 위치, 방의 개수 등)을 기반으로 가격을 예측합니다.
오버피팅 상황: 모델이 너무 훈련 데이터에 맞추기 위해 노력한 나머지, 특정 변수(예: 집의 면적)에 가중치를 지나치게 부여하게 됩니다. 이로 인해 모델은 면적이 크면 무조건 비싼 집이라고 예측하려 하고, 다른 중요한 요인(위치나 시설 등)은 무시하게 됩니다.
이렇게 특정 가중치가 지나치게 커지면, 훈련 데이터에서는 잘 맞지만 새로운 데이터에서는 성능이 떨어집니다. 예를 들어, 면적이 큰 집이지만 위치가 안 좋은 경우에도 무조건 비싼 가격을 예측해버리는 것입니다.
정규화 기법 적용:
이때, 정규화(regularization) 기법을 사용하면 모델의 가중치가 지나치게 커지지 않도록 제한을 둡니다. 이렇게 하면 각 변수(입력값)에 적절한 가중치를 부여하여, 모델이 새로운 데이터를 만났을 때도 일반화된 성능을 낼 수 있게 됩니다.
즉, 정규화는 모델이 '집의 면적'뿐만 아니라 '위치', '시설' 등의 다양한 요인을 균형 있게 고려하도록 돕는 역할을 합니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.