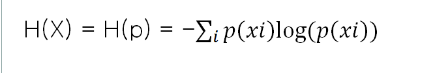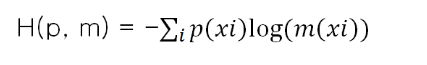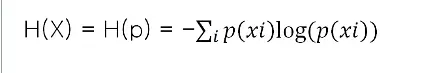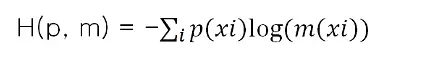프로덕트

아직 프로덕트가 없습니다.

아티클

전체 보기
권예영

권예영

Hyperparameters

"Hyperparameters"

신경망을 통해 학습을 하게 되면, 쉽게 설명하기 어려운 많은 문제들을 해결할 수가 있을 것 같은데, 안타깝게도 잘 안 되는 경우도 많다. (신경망이 복잡할수록 이 문제는 더 커진다.) 이는 신경망의 학습 방법이나 구조의 문제가 아니라, 신경망의 hyperparameter들이 제대로 설정되지 못해, 학습이 효과를 발휘하지 못하기 때문이다.
이것은 마치 사람들이 학습할 때, 학습에 좋은 환경이 조성이 되어 있어야 학습이 효과적으로 되는 것과 비슷하다고 생각하면 된다. 맹목삼진지교를 떠올려보면 좋을 비유가 될 것 같다.

이번 class에서는 신경망이 좋은 결과를 내기 위해서 반드시 고려해야 할 hyperparameter들에 대해 살펴볼 예정이다.


신경망이나 기계 학습에서의 hyperparameters란?

그간 class를 통해 신경망의 가중치(weight)나 바이어스(bias) 값을 알아내는 것이 신경망 학습의 목표라고 배웠는데, 이 hyperparameter라는 것들이 갑자기 튀어나오니 뭔가 무시무시한 변수가 또 있는가 하고, 좀 당황스러울 수도 있겠다.
하지만, 우리는 이번 class에서 "학습 진도율(η)"이나 "일반화(regularization) 변수(λ)" 등 hyperparameter들에 대해서 이미 살펴본 적이 있다.
학습 진도율이나 일반화 변수가 엉뚱하게 설정이 되면, 신경망을 통한 학습의 결과가 그리 좋지 못하거나 기대 이하의 학습 결과가 나올 수 있는 것이다.

1
0
권예영

권예영

SoftMax 함수

신경망 Activation Function – "SoftMax"

신경망에서 뉴런의 활성 함수(activation function)로 주로 sigmoid 함수를 사용한다.

sigmoid 함수를 사용하는 이유는 [Part II, Neural Networks] 3, Basic Theory에서 살펴본 것처럼, 단순하게 step function이나 linear function을 사용할 때보다 훨씬 많은 일을 할 수 있기 때문이다. sigmoid 함수는 입력단이나 hidden layer에 주로 사용 되며, 출력단에서도 사용 된다.

하지만, 실제 신경망의 응용에서는 출력단에 SoftMax 함수를 더 많이 사용 하며, 특히 분류기(classifier) 관련 application은 SoftMax 함수를 쓰면 훨씬 좋다.

이번 class에서는 SoftMax 함수에 대해 살펴볼 예정이다.

SoftMax에 대한 정의

SoftMax는 수식으로 정리하면 아래 식과 같다.

σ(z)j=ezj∑k=1Kezkfor j=1,...,K\sigma(z)_j = \frac{e^{z_j}}{\sum_{k=1}^{K} e^{z_k}} \quad \text{for } j = 1, ..., Kσ(z)j​=∑k=1K​ezk​ezj​​for j=1,...,K

위 식은 K-차원을 갖는 벡터 zzz를 (0,1) 범위를 갖는 σ(z)\sigma(z)σ(z)로 치환시키는 것과 같다. 자세히 보면, 확률 분포와 같다는 것을 알 수가 있으며, logistic regression이라고도 불린다.

위 식을 좀 더 살펴보자.

ZkZ_kZk​에 대해 편미분을 실시하면, j=kj = kj=k일 때는 양수이고, j≠kj \neq kj=k일 때는 음수가 된다. 즉, ZkZ_kZk​를 증가시키면 해당 뉴런의 출력값 σ(z)\sigma(z)σ(z)는 증가하고, 다른 뉴런의 출력값은 감소하게 되는 성질을 갖게 된다.

위 성질은 강화 학습(reinforcement learning)에 매우 유용하다. 강화 학습([Part 1, Machine Learning] 4. Reinforcement Learning을 참고)이라는 학습 결과에 대한 상과 벌을 보상(reward)으로 학습을 진행한다는 개념이기 때문에 SoftMax의 개념과 맞아떨어진다고 볼 수 있다.

이 수식은 어떤 의미를 가질까? 그리고 sigmoid를 사용할 때와 어떤 차이가 있는 걸까?

Sigmoid를 사용하면, 해당 뉴런으로 들어오는 입력들과 바이어스에 의해 출력이 결정이 된다.

하지만 SoftMax를 사용하면, 해당 뉴런으로 들어오는 입력들과 바이어스에 의해 출력이 결정이 되는 구조는 비슷하지만, 다른 뉴런의 출력값과의 상대적인 비교를 통해 최종 출력값이 결정된다는 점이 다르다.

이것을 전문 용어로는 “non-locality”라고 부른다.

SoftMax의 수식을 살펴보면 알 수 있는 것처럼, 모든 뉴런의 출력값들의 합하면 ‘1이 되기 때문에 평균화(normalization)의 효과를 얻게 된다.

그렇기 때문에 문자 인식이나 숫자 인식과 같은 분류를 목적으로 하는 신경망의 최종단에 SoftMax 함수를 쓰면, 해당 값이 나올 확률을 알 수가 있으며, 가장 큰 값이 나오는 쪽으로 분류가 될 수 있다.

또한 특정 항목의 변화가 최종 출력에 어떤 영향을 끼치는지를 바로 파악 가능한 효과도 덤으로 얻을 수 있다.

이번 class에서는 신경망의 활성 함수로 사용하는 SoftMax 함수의 개념과 이것에 대해 살펴보았다. 다음 class에서는 신경망의 학습의 시간 및 질을 결정하는 Hyper-parameter에 대해 살펴볼 예정이다.

1. 다중 클래스 분류 문제에서의 SoftMax 사용

SoftMax 함수는 다중 클래스 분류(multiclass classification) 문제에서, 모델이 여러 클래스 중에서 하나를 선택해야 할 때 사용됩니다. 예를 들어:

  • 이미지 분류: 고양이, 개, 새 등의 여러 클래스 중에서 주어진 이미지가 어떤 클래스에 속하는지 예측하는 문제.

  • 자연어 처리: 문장의 감정을 분류할 때 긍정, 부정, 중립과 같은 여러 클래스 중 하나를 선택하는 문제.

이러한 경우, SoftMax 함수는 로짓(logit) 값을 확률로 변환하여 각 클래스에 속할 확률을 계산합니다.

2. SoftMax가 작동하는 방식

  1. 로짓 값 계산:

    • 신경망이나 머신러닝 모델의 마지막 출력층에서 각 클래스에 대한 로짓 값(출력값)이 계산됩니다. 이 값들은 정규화되지 않은 상태이며, 클래스에 속할 가능성을 나타냅니다.

    • 예를 들어, 모델이 어떤 이미지에 대해 고양이, 개, 새의 로짓 값을 각각 [2.0, 1.0, 0.1]로 계산했다고 가정해봅시다.

  2. SoftMax 함수 적용:

    • SoftMax 함수는 이 로짓 값들을 확률로 변환합니다. 각 클래스에 대한 확률은 아래 수식처럼 계산됩니다:

    σ(z)j=ezj∑k=1Kezk\sigma(z)_j = \frac{e^{z_j}}{\sum_{k=1}^{K} e^{z_k}}σ(z)j​=∑k=1K​ezk​ezj​​

    • 예를 들어, 고양이, 개, 새에 대한 확률을 계산하면 각각의 확률 값이 나옵니다. 이 값들은 항상 0과 1 사이의 값이며, 모든 확률 값의 합은 1이 됩니다.

      • 고양이 확률: e2.0e2.0+e1.0+e0.1\frac{e^{2.0}}{e^{2.0} + e^{1.0} + e^{0.1}}e2.0+e1.0+e0.1e2.0​

      • 개 확률: e1.0e2.0+e1.0+e0.1\frac{e^{1.0}}{e^{2.0} + e^{1.0} + e^{0.1}}e2.0+e1.0+e0.1e1.0​

      • 새 확률: e0.1e2.0+e1.0+e0.1\frac{e^{0.1}}{e^{2.0} + e^{1.0} + e^{0.1}}e2.0+e1.0+e0.1e0.1​

    계산 결과로 고양이가 예를 들어 0.7, 개가 0.2, 새가 0.1이라는 확률을 얻을 수 있습니다.

  3. 결정:

    • 최종적으로 SoftMax 함수가 계산한 확률 값 중에서 가장 높은 확률을 가진 클래스를 모델이 예측 값으로 선택합니다.

    • 위 예시에서 고양이가 70% 확률로 가장 높으므로, 모델은 "이 이미지는 고양이다"라고 예측합니다.

3. 모델 학습에서의 역할

SoftMax 함수는 주로 모델의 출력 값에 적용되지만, 모델 학습 과정에서도 중요한 역할을 합니다.

  1. 크로스 엔트로피 손실 함수와 결합:

    • SoftMax 함수는 크로스 엔트로피 손실 함수(Cross-Entropy Loss)와 함께 자주 사용됩니다.

    • 모델이 예측한 확률과 실제 클래스 간의 차이를 측정하여 모델이 얼마나 정확한지 평가하는데 사용됩니다.

    • 예를 들어, 실제 정답이 고양이(즉, [1, 0, 0]의 벡터)이고, 모델의 SoftMax 출력이 [0.7, 0.2, 0.1]이라면, 이 둘의 차이를 계산하여 손실을 구합니다. 이를 통해 모델은 예측이 얼마나 정확한지 평가되고, 그에 따라 가중치 업데이트를 통해 성능을 향상시킵니다.

  2. 다중 클래스 문제 해결:

    • SoftMax는 여러 클래스 중 하나를 선택해야 할 때 매우 유용합니다. 모든 클래스에 대한 확률을 계산한 후 가장 가능성이 높은 클래스를 선택하기 때문에, 분류 문제에서 효율적으로 사용됩니다.

4. SoftMax의 장점

  1. 확률 기반 해석: SoftMax 함수는 결과를 확률 값으로 변환해주므로, 예측이 얼마나 신뢰할 수 있는지 해석할 수 있습니다. 예를 들어, 모델이 0.9라는 높은 확률로 특정 클래스를 예측했다면, 이는 매우 신뢰할 수 있는 예측임을 의미합니다.

  2. 다중 클래스 분류에 적합: 여러 클래스를 분류해야 하는 문제에서 SoftMax는 각 클래스에 속할 확률을 계산하여, 가장 가능성이 높은 클래스를 선택할 수 있도록 도와줍니다.

  3. 정규화: SoftMax는 출력값을 정규화하여 모든 확률의 합이 1이 되도록 합니다. 이를 통해 클래스 간 비교를 할 수 있습니다.

5. 실제 사용 예시

  • 이미지 분류: CNN(Convolutional Neural Networks) 같은 이미지 분류 모델에서 마지막 출력층에 SoftMax를 사용하여 고양이, 개, 자동차 등 여러 클래스를 분류합니다.

  • 자연어 처리(NLP): 텍스트에서 감정을 분류하거나, 문장의 주제를 분류하는 문제에서도 SoftMax를 사용하여 각 클래스에 속할 확률을 계산합니다.

결론:

SoftMax 함수는 다중 클래스 분류 문제에서 모델이 여러 클래스 중 하나를 선택할 확률을 계산하는 데 사용됩니다. 이 함수는 모델의 예측값을 확률로 변환하여, 가장 높은 확률을 가진 클래스를 예측 결과로 선택하게 합니다. 머신러닝에서 모델이 분류 문제를 학습하고 예측할 때, SoftMax는 예측 값의 확률 기반 해석을 가능하게 하고, 이를 통해 더 나은 성능을 끌어낼 수 있습니다.


SoftMax 함수가 강화 학습(Reinforcement Learning)과 잘 맞는 이유는, 확률 기반의 행동 선택과 탐험과 활용 간의 균형을 효과적으로 조절하는 특성 때문입니다. 이를 구체적으로 설명하겠습니다.

1. 강화 학습에서의 행동 선택:

강화 학습에서는 에이전트가 환경에서 행동을 선택하고, 그에 따라 보상(reward)을 받아 학습하는 과정이 진행됩니다. 이때, 에이전트는 가능한 여러 행동(action) 중에서 하나를 선택해야 하는데, SoftMax는 이러한 상황에서 각 행동의 선택 확률을 계산하는 데 유용합니다.

SoftMax 함수가 강화 학습에 적합한 이유:

확률 기반의 행동 선택: SoftMax는 각 행동에 대해 확률 분포를 생성합니다. 즉, 각 행동에 부여된 값(보상 예상값 또는 Q-값)을 바탕으로 행동을 선택하는 확률을 계산해줍니다. 이렇게 확률적으로 행동을 선택하는 것은 강화 학습에서 매우 중요한데, 이는 에이전트가 항상 가장 높은 보상만을 추구하는 것이 아니라 다양한 행동을 탐색할 수 있게 해줍니다.

2. 탐험(Exploration)과 활용(Exploitation)의 균형:

강화 학습의 중요한 목표 중 하나는 탐험(Exploration)과 활용(Exploitation) 사이의 균형을 맞추는 것입니다.

탐험(Exploration): 에이전트는 새로운 행동을 시도하고, 이를 통해 아직 알지 못하는 환경을 학습해야 합니다.

활용(Exploitation): 에이전트는 이미 학습한 정보를 바탕으로 가장 큰 보상을 줄 수 있는 최적의 행동을 선택해야 합니다.

SoftMax 함수는 이 두 가지 요구를 균형 있게 조절해줄 수 있습니다. 탐험과 활용의 균형이 중요한 이유는, 에이전트가 항상 최대 보상을 주는 행동만을 선택하면 새로운 행동을 시도하지 않게 되고, 반대로 항상 새로운 행동만을 시도하면 보상이 높은 행동을 충분히 활용하지 못하게 되기 때문입니다.

SoftMax의 역할:

보상의 차이에 따라 확률적으로 행동 선택: SoftMax는 보상이 큰 행동에 더 높은 확률을 부여하면서도, 보상이 낮은 행동에도 일정 확률을 부여합니다. 즉, 항상 최선의 행동만 선택하는 것이 아니라, 때로는 새로운 행동을 시도할 확률도 부여하게 됩니다.

보상의 차이가 크다면, 확률이 더 명확하게 나뉘고, 보상의 차이가 적다면 모든 행동이 선택될 확률이 고르게 분포됩니다.

예를 들어, 두 행동이 각각 80점과 70점의 보상을 줄 수 있다면, 80점이 더 자주 선택되겠지만 70점도 일정한 확률로 선택될 수 있습니다. 이를 통해 다양한 행동을 탐험할 수 있는 기회를 제공합니다.

3. Q-값과 SoftMax의 결합:

강화 학습에서 사용되는 대표적인 알고리즘 중 하나인 Q-러닝에서는 각 행동에 대한 Q-값(행동의 기대 보상)이 계산됩니다. SoftMax는 이 Q-값을 확률로 변환하여 에이전트가 행동을 선택할 때 사용합니다.

Q-값이 클수록 해당 행동이 선택될 확률이 커집니다. 하지만, Q-값이 낮은 행동도 0이 아닌 확률로 선택될 수 있어 탐험의 기회를 제공합니다.

이는 Epsilon-Greedy와 같은 방식과는 차이가 있습니다. Epsilon-Greedy는 일정 확률로 무작위 행동을 선택하는 반면, SoftMax는 각 행동의 Q-값에 따라 확률적으로 선택을 수행합니다. 즉, 보상의 크기에 따른 비례적 선택을 유도하므로, 탐험과 활용의 균형을 더 세밀하게 조정할 수 있습니다.

4. 보상에 대한 민감도 조절:

SoftMax 함수는 행동의 선택 확률을 계산할 때 온도 매개변수(temperature parameter)를 사용해 행동 선택에 대한 민감도를 조절할 수 있습니다.

온도 매개변수 τ\tauτ (temperature)는 SoftMax 함수의 분모에 영향을 줍니다. 이를 통해 에이전트가 탐험과 활용 사이에서 더 자유롭게 선택할 수 있게 도와줍니다.

τ\tauτ 값이 크면, 모든 행동의 확률이 비슷하게 분포되며 탐험이 많이 일어납니다.

τ\tauτ 값이 작으면, 보상이 큰 행동에 더 높은 확률이 부여되어 활용이 많이 일어납니다.

따라서, SoftMax 함수는 강화 학습에서 온도 매개변수를 통해 에이전트가 탐험과 활용 간의 균형을 유연하게 맞출 수 있도록 돕습니다.

5. 정리:

SoftMax 함수는 강화 학습에서 확률적으로 행동을 선택하는 데 유용합니다. 이는 항상 최적의 행동만을 선택하지 않고, 새로운 행동을 탐색할 기회도 제공해줍니다.

탐험과 활용의 균형을 유지할 수 있게 하여, 에이전트가 학습 과정에서 최적의 성능을 발휘할 수 있도록 합니다.

온도 매개변수를 사용하여 에이전트의 행동 선택에 대한 민감도를 조절할 수 있으며, 보상의 크기에 따라 각 행동의 선택 확률을 차별화할 수 있습니다.

이러한 이유로 SoftMax 함수는 강화 학습에서 매우 효과적으로 작동하며, 다양한 행동을 탐색하면서도 보상이 큰 행동을 적절히 활용할 수 있는 기회를 제공합니다.


문자 인식 및 숫자 인식에서의 사용:

문자 인식이나 숫자 인식과 같은 문제에서는 여러 가지 가능한 문자나 숫자 중 하나를 선택해야 합니다.

예를 들어, 손글씨 숫자 인식 문제에서는 '0'부터 '9'까지의 숫자 중 하나를 인식해야 합니다. SoftMax 함수는 각 숫자에 대해 확률을 계산하고, 가장 높은 확률을 가진 숫자를 최종 결과로 선택하게 합니다.


0과 1사이에서 상대적인 분포로 최대한 확률높은 선택지를 나타낸다.

다른 선택지를 배제하지 않고 확률적인 분포로 조정이 가능하기에 또한 상대비교적 특징때문에(각각의 선택지가 서로에게 영향을 준다) 강화학습과의 시너지가 좋다. (다양한 행동을 탐색하고 실험하며 상벌로 파악할 수 있기 때문에)
1
0
권예영

권예영

Cross-Entropy Cost Function에 대해(학습 속도 저하를 줄이는 솔루션)

출처: 라온피플 아카데미 블로그

신경망(Neural Network) Cost Function으로써의 "Cross-Entropy Cost Function"

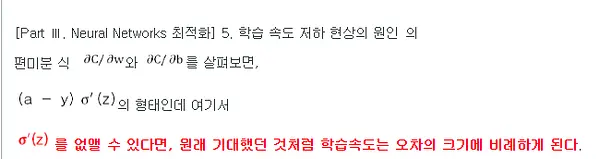
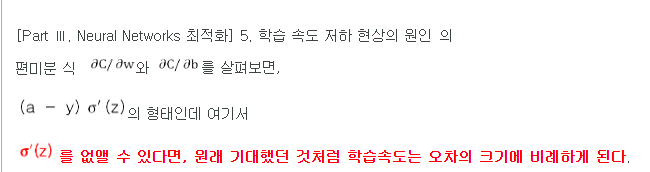
[Part III., Neural Networks 최적화] 5. 학습 속도 저하 현상의 원인에서는 신경망의 학습 속도 저하 현상의 원인에 대해서 살펴보았다.
마치 산 정상에서 공을 떨어뜨리면 경사가 클수록 빨리 굴러 떨어지는 것처럼, 오차가 클수록 학습 속도가 빨라야 할 것 같은데 유감스럽게도 그렇지 못하다.

이것은 신경망의 cost function으로 흔히 사용되는 MSE(평균제곱오차, Mean Square Error)와 활성함수로 Sigmoid 함수를 사용하는 경우, Sigmoid 함수의 특성과 결합하면서 문제가 생기기 때문이다.

image.png

Sigmoid 함수의 미분 값= σ′(z) (MSE가 큰 오차에 민감하게 반응하는 특성을 지니고 있는데 Sigmoid 함수는 극단값을 0과 1에 매우 가깝게 수렴해 학습에 오차가 나는 것이다.)

그렇다면 cost function으로 MSE 방식 대신에 다른 함수를 사용하고 비슷한 효과를 얻을 수는 없는 것일까?

그 주인공이 바로 이번 Class의 주인공인 cross-entropy cost function이다. MSE와 비슷하게 표현하기 위해 ACE(Average Cross-Entropy)라고도 부른다.


Cross-Entropy의 역사

Cross-Entropy라는 다소 괴상한 이름은 1997년 Rubinstein이 희소 사건의 확률을 추정하기 위한 용도로 발표되었는데,
후에 희소 사건뿐만 아니라, 일반적인 조합 최적화(combinatorial optimization)에도 적용이 가능하다는 것이 밝혀지면서 널리 쓰이게 되었다.

원래 엔트로피(Entropy)는 클라우지우스가 열역학 제2의 법칙, 즉 “열은 높은 온도에서 낮은 온도로만 흐른다”는 것을 설명하기 위해 고안된 개념이지만, 1877년 볼츠만에 의해서 확률적인 방법으로 새롭게 정의되었으며, 열과 관계 없는 자연 현상도 설명할 수 있게 되었다.

현재는 분야를 가리지 않고 쓰이는 용어가 되었으며 (심지어는 철학에서도), 자연의 변화와 방향을 가리킬 때 사용된다.

특히, 신경망(Neural Networks)에서 Cross-Entropy는 손실 함수로 활용되어 모델이 예측한 확률 분포와 실제 값 사이의 차이를 계산하는 데 사용됩니다. 이는 모델이 얼마나 잘 예측하고 있는지 평가하는 데 중요한 역할을 합니다.


신경망에서의 Cross-Entropy의 활용

Information theory에서 엔트로피는 확률분포의 무작위성(randomness)을 설명하는 용도로 사용이 되며,
확률분포 p를 갖는 랜덤 변수 X를 표현하기 위한 최소의 비트 수를 나타내며 아래와 같이 표현된다.

image.png

Cross-Entropy는 2개의 확률 분포의 차이를 나타내는 용도로 정의가 되었다.
이 이름이 생소하다면, cross-correlation의 개념을 연상해보면 좋을 것 같다.

Cross-correlation은 두개의 함수와의 correlation 관계를 나타낼 때 사용이 된다.

반면에 CE(Cross-Entropy)는 두개의 확률 분포가 얼마나 가까운지 혹은 먼지를 나타내며,
2개의 확률 분포 p(x)p와 m(x)에 대한 CE는 아래와 같이 나타난다.

image.png

위 식에서 p와 m이 같다면, Entropy와 식이 같아진다는 것을 알 수가 있다.
즉, 차이가 클수록 값은 많이 나오고, 두 개가 같아질 때 최소한의 값이 나온다.

위 수식을 잘 생각을 해보면, cost function처럼 기대값과 실제 연산값의 차가 클수록 큰 결과가 나오고,
항상 양의 값이기 때문에 cost function으로 사용이 가능함을 알 수 있다.


Cross-Entropy 수식의 의미:

이 수식은, 여러 예측 값들이 실제 값과 얼마나 차이가 나는지를 계산하고, 그 차이를 크게 부각시켜서 학습에 반영합니다. 예측이 틀릴수록 오차가 더 커지고, 맞으면 오차가 작아져서, 모델이 더 잘 예측할 수 있도록 돕습니다.

  • 시그마 기호: 여러 예측 값을 모두 더해서 전체적인 오차를 구합니다.

  • 로그 함수: 예측이 틀렸을 때, 그 틀린 정도를 강조해서 더 큰 오차로 반영합니다.

  • Cross-Entropy는 최종적으로, 모델이 얼마나 잘 예측했는지를 평가하는 방법이며, 틀릴수록 더 큰 패널티를 줍니다.


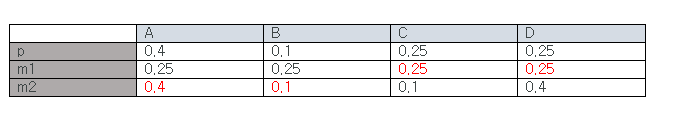
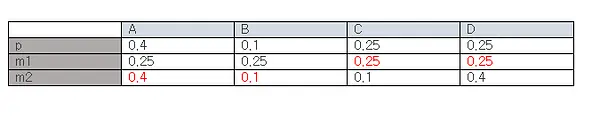
다음의 간단한 예를 보자.
랜덤 변수 X의 실제 분포가 p이고,
이것을 m1과 m2로 추정할 경우라고 하면, 어느 것이 더 좋은 추정일까?

image.png

겉보기에는 별 차이가 없어 보이지만,
Cross-Entropy를 구하여 수치적 관점에서만 살펴보자.
그럼, Entropy H(p) = 1.8601이고, Cross-entropy H(p, m1) = 2.01, H(p, m2) = 2.0201다.
결과만 놓고 본다면, m1이 좀 더 좋은 추정이 된다.


MSE보다 CE CostFunction이 속도는 빠르지만 학습효과의 측면에선 아직 모르겠다.

1
0
권예영

권예영

학습 속도 저하 현상의 원인 (MSE와 SIgmoid함수, Gradient Descent의 특성)

참고: 라온피플 아카데미 네이버 블로그

신경망 학습 속도의 문제점 - “학습 속도 저하”

옛날에 요줌싸가 어린이는 키를 쓰윽 써서 동네 한 바퀴를 돌게 했고, 그 이후는 아이가 크게 망신을 당해 다음부터는 요줌을 가리도록 해주기 위함이라고 했다. 물론 지금은 잘못된 이론이라는 말도 있다.

이처럼, 사람은 크게 망신을 당할 정도로 큰 실수를 하게 되면, 그 충격으로 인해 다음부터는 그 실수를 하지 않게 되는 경향이 있다. 즉, 큰 에러가 발생할수록 학습이 잘 되는 경우가 종종 있다. (물론, 늘 그런 것은 아니지만)

신경망 학습에서도 이런 일이 일어날까? 원래 나와야 할 값(훈련 데이터의 결과 값)과 망에서 실제로 수행을 한 결과와의 차이가 크면 학습을 정말로 잘 하게 될까?

일반적으로 신경망의 cost function으로 사용하는 MSE(평균제곱오차, Mean Square Error) 방식을 사용하면 유감스럽게도 그렇지 못하다.

왜 그럴까? 이는 cost function으로 MSE 방식을 사용하고 활성함수로 Sigmoid 함수를 사용하는 경우 Sigmoid 함수의 특성 상 발생하면서 문제가 생기기 때문이다.

MSE와 Sigmoid의 결합 문제

MSE와 Sigmoid 함수를 함께 사용할 때 문제가 되는 이유는 다음과 같습니다:

  1. Sigmoid 함수의 출력이 포화될 때:
    Sigmoid 함수는 출력값을 0과 1 사이로 압축합니다. 그러나 입력 값이 매우 크거나 매우 작을 경우, 그 출력값이 거의 0이나 1에 가까워집니다. 이때 미분 값이 0에 가까워져, 가중치 업데이트를 위한 기울기 값이 사라지게 됩니다. 그 결과 역전파를 통해 오류를 전파할 때 가중치가 거의 업데이트되지 않고, 학습 속도가 매우 느려집니다.

  2. MSE의 큰 오차에 민감한 특성:
    MSE는 큰 오차에 민감하게 반응합니다. Sigmoid 함수의 포화 구간에서 MSE는 큰 오차를 계산하게 되지만, Sigmoid 함수가 오차에 대해 거의 반응하지 않기 때문에 큰 오차에도 불구하고 학습이 제대로 이루어지지 않습니다. 즉, MSE는 오차를 크게 반영하려 하지만 Sigmoid의 특성상 그 오차가 효과적으로 반영되지 않는 문제점이 있습니다.

예시로 설명

  • 예시: 만약 모델의 실제 출력값이 0.1이고 예측값이 0.9라면, MSE는 이 차이를 크게 보고 학습률을 높이려고 할 것입니다. 그러나, Sigmoid 함수는 출력이 0.9에 매우 가까울 경우, 이미 포화 상태에 도달해 기울기가 0에 가까워져 학습이 거의 이루어지지 않게 됩니다. 그 결과, MSE가 큰 오차를 인식해도 Sigmoid 함수의 특성 때문에 학습이 잘 이루어지지 않는 현상이 발생합니다.

-> MSE가 큰 오차에 민감하게 반응하는 특성을 지니고 있는데 Sigmoid 함수는 극단값을 0과 1에 매우 가깝게 수렴해 학습에 오차가 나는 것이다. 오차에 대한 계산이 명확히 이루어지지 않아, 역전파도 제대로 이뤄지지 않는다는 뜻이다.


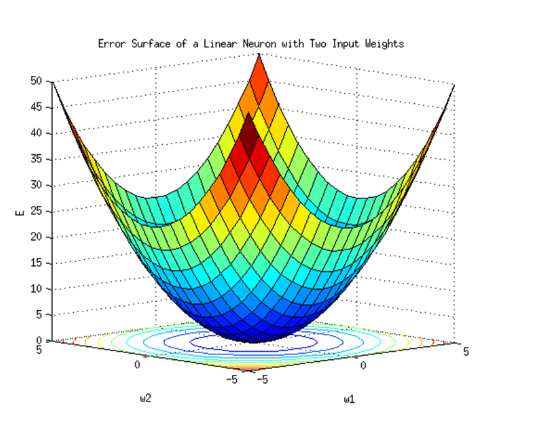
Gredient Descent

image.png

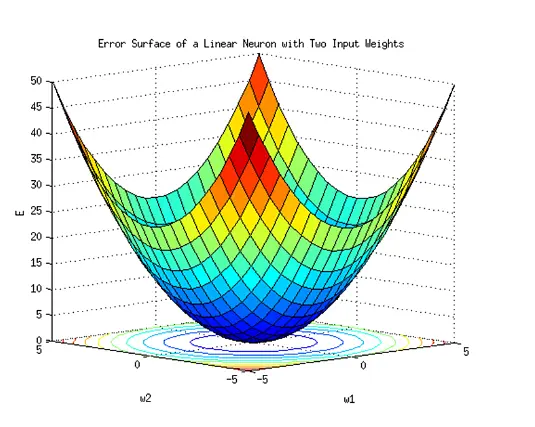
경사 하강법은 오차 함수의 기울기를 따라 가중치를 업데이트하며 최적의 값을 찾아가는 방식입니다. 학습 초기에는 오차가 크기 때문에 기울기가 크고, 이로 인해 가중치 업데이트가 빠르게 진행됩니다. 하지만 학습이 진행될수록 오차가 줄어들고, 기울기도 점점 작아지면서 가중치의 변화가 점점 미세해지게 됩니다.

이 과정이 마치 오목한 그릇에서 공이 바닥으로 굴러가는 것과 비슷합니다. 처음에는 기울기가 크기 때문에 공이 빠르게 움직이지만, 바닥 근처로 갈수록 기울기가 작아지면서 공이 느리게 움직입니다. 이처럼 학습이 수렴하는 과정에서 속도가 저하되며, 이는 경사 하강법의 본질적인 특성입니다. 결국, 최적값에 가까워질수록 학습 속도가 느려지는 것이 경사 하강법을 사용할 때 나타나는 학습 속도 저하의 주요 원인입니다.

-> 학습이 수렴하는 과정에서 속도가 저하된다. 예측값과 실제값이 유사해지는 과정에서 속도가 저하되므로 학습의 효율이 개선되지 않는 문제가 발생된다. 이런 경우에는 적절한 지점에서 stop을 해줘야 한다.

1
0
권예영

권예영

Dropout

출처: 라온피플 아카데미 네이버 블로그

Hidden Layer의 개수가 많아질 경우의 장단점?
일반적으로 신경망에서 hidden layer의 개수가 많아지면, 즉 deep neural network이 되면, 더욱 많은 문제를 해결할 수 있도록 학습 능력이 좋아진다.

하지만, 망의 크기가 커지면 커질수록 overfitting에 빠질 가능성이 높아지고, 신경망에 대한 학습 시간도 길어지는 문제가 있으며, 적절한 결과를 도출하려면 훈련 데이터의 양 또한 늘려야 한다.

1. Overfitting의 가능성

예시: 당신이 학생에게 수학 문제를 가르치는 상황을 생각해봅시다. 학생이 문제 유형 몇 개만 집중적으로 공부하고 이를 완벽하게 암기하면 시험에서는 그 문제에 맞는 답을 쉽게 낼 수 있습니다. 그러나 시험에서 새로운 문제 유형이 나오면 그 학생은 준비되지 않은 문제를 제대로 풀지 못합니다. 이는 학생이 문제를 암기한 것이지, 문제의 원리를 이해한 것이 아니기 때문에 일어나는 현상입니다.

신경망도 비슷합니다. hidden layer가 많아지면 네트워크가 매우 복잡해지고, 이는 훈련 데이터에 너무 잘 맞는, 즉 훈련 데이터의 특정 패턴에만 맞춘 과도하게 복잡한 모델을 만들 가능성이 커집니다. 이 경우 새로운 데이터(테스트 데이터)에 대해 성능이 떨어지는데, 이를 overfitting이라고 부릅니다. 모델이 데이터를 '암기'하는 것처럼 작동하기 때문에 새로운 상황에서는 잘 대응하지 못합니다.

2. 학습 시간이 길어짐

예시: 만약 어떤 학생에게 복잡한 수학 문제를 풀게 하고, 각 단계에서 세부적인 설명을 듣는다고 생각해봅시다. 단순한 문제는 빨리 해결되지만, 복잡한 문제는 각 단계에서 더 많은 시간이 필요합니다. 비슷하게 신경망에서 hidden layer가 많아지면 각 layer가 데이터를 처리하는데 시간이 더 많이 걸립니다. 또한 각 layer 간에 전달되는 정보가 많아지므로 계산해야 할 파라미터도 기하급수적으로 늘어납니다. 따라서 학습 시간도 길어지게 됩니다.

3. 훈련 데이터 양의 필요성

예시: 만약 당신이 5개의 수학 문제를 가지고 학생에게 수업을 할 때, 간단한 공식만 가르쳐도 그 문제들을 해결할 수 있다면 적은 학습량으로 충분히 수업이 끝날 수 있습니다. 하지만 100개의 복잡한 문제를 가르쳐야 한다면 더 많은 예시와 설명, 그리고 문제 풀이 시간이 필요하게 됩니다. 신경망에서도 layer가 많아지고 복잡해질수록 더 다양한 패턴을 학습하려면 더 많은 데이터가 필요합니다. 데이터가 적으면 모델이 충분한 일반화 능력을 가지지 못하고 특정한 패턴에 맞춰지기 때문에 성능이 저하될 수 있습니다.

결론적으로:

  • Overfitting: 너무 많은 layer로 인해 훈련 데이터에 과도하게 맞춰진 모델이 생성됩니다.

  • 학습 시간: 더 많은 파라미터를 학습해야 하므로 학습 시간이 길어집니다.

  • 데이터 양: 모델이 일반화하려면 더 많은 패턴을 학습해야 하므로 더 많은 데이터가 필요합니다.

이러한 이유로, hidden layer를 많이 추가하는 것에는 장점이 있지만, 동시에 적절한 규제 방법(Dropout 같은 기법)과 충분한 훈련 데이터가 필요합니다.


Dropout 개요
이렇게 망의 크기가 커질 경우 Overfitting 문제를 피하기 위한 방법이 dropout이며, 논문이 발표된 지 채 10년이 넘지 않았다.

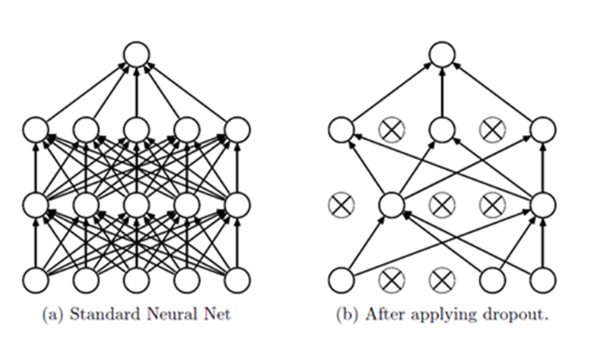
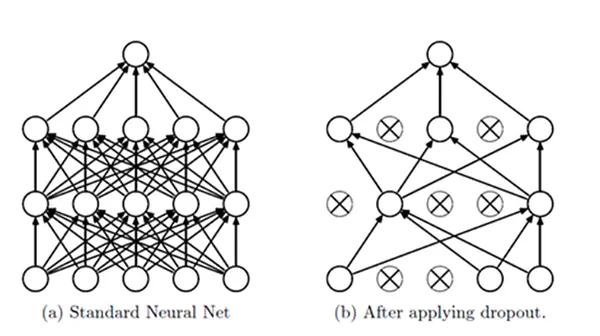
Dropout은 아래의 그림 (a)에 대한 학습을 할 때, 망에 있는 모든 layer에 대해 학습을 수행하는 것이 아니라 그림 (b)와 같이 망에 있는 입력 layer나 hidden layer의 일부 뉴런을 생략(dropout)하고 줄여든 신경망을 통해 학습을 수행한다.

일정한 mini-batch 구간 동안 생략된 망에 대한 학습을 끝내면, 다시 무작위로 다른 뉴런들을 생략(dropout) 하면서 반복적으로 학습을 수행한다.

image.png

Dropout 효과
그럼 이렇게 dropout을 하는 이유는 무엇이고, dropout은 과연 효과가 있을까?

① Voting 효과
Dropout을 하는 첫 번째 이유는 투표(voting) 효과 때문이다.
일정한 mini-batch 구간 동안 줄어든 망을 이용해 학습을 하게 되면, 그 망은 그 망 나름대로 overfitting이 되며,
다른 mini-batch 구간 동안 다른 망에 대해 학습을 하게 되면, 그 망에 대해 다시 일정 정도 overfitting이 된다.

이런 과정을 무작위로 반복을 하게 되면, voting에 의한 평균 효과를 얻을 수 있기 때문에,
결과적으로 regularization과 비슷한 효과를 얻을 수 있게 되는 것이다.

② Co-adaptation을 피하는 효과

또 다른 이유로 co-adaptation을 피하는 효과를 들 수 있다.

Regularization에서 살펴본 것처럼, 특정 뉴런이 바이어서 가중치 값을 갖게 되면

그것의 영향이 커지면서 다른 뉴런들의 학습 속도가 느려지거나

학습이 제대로 진행이 되지 못하는 경우가 있다.

하지만 dropout을 하면서 학습을 하게 되면,

결과적으로 어떤 뉴런의 가중치나 바이어서 특정 뉴런의 영향을 받지 않기 때문에

결과적으로 뉴런들이 서로 동조화(co-adaptation)이 되는 것을 피할 수 있다.


1. 투표(Voting) 효과

Dropout을 통해 신경망에서 일부 뉴런을 무작위로 제외하면서 학습을 반복하게 되면, 각기 다른 작은 신경망들이 독립적으로 학습됩니다. 이렇게 여러 작은 신경망들이 조금씩 다른 방식으로 학습한 결과를 평균적으로 합산하면, 더 일반화된 학습 결과를 얻을 수 있습니다. 이는 과적합을 방지하는 데 도움이 됩니다. 즉, 여러 작은 모델의 투표를 통해 더 나은 성능을 도출하는 효과입니다.

2. 동조화(Co-adaptation) 방지 효과

신경망에서 특정 뉴런이 다른 뉴런에 지나치게 의존하게 되면, 학습이 왜곡되거나 불균형하게 이루어질 수 있습니다. Dropout은 뉴런 간의 의존성을 줄여, 각 뉴런이 독립적으로 학습하도록 만들어줍니다. 결과적으로 네트워크가 더 강건하고 일반화된 학습을 할 수 있게 도와줍니다. 이를 통해 특정 뉴런에 과하게 의존하는 현상인 동조화를 방지합니다.

특정 학습 데이터나 자료에 영향을 받지 않는 보다 강건한(robust)한 망을 구성할 수가 있게 되는 것이다.

이것은 마치 오랜 시간 동안 지구상에 존재하는 생명체들이

유전적 복제와 아닐 양성 식을 통해 유전자를 결합하고

보다 강인한 유전자들이 자연의 선택을 받아 살아남는 것과 마찬가지이다.

1
0

포스트

전체 보기
권예영

권예영

역전파(Backpropagation)란?

역전파는 신경망 학습에서 중요한 알고리즘으로,정방향(Feed Forward)으로 신호를 보내고 출력과 실제 값 사이의 오차를 구한 뒤, 역방향(Backpropagation)으로 그 오차를 전파하여 가중치를 조정한다.

Backpropagation: 계산된 오차값을 역방향으로 전파하여 각 가중치에 대한 기울기를 계산한다. 이 과정에서 미분이 중요한 역할을 하며, 오차를 각 가중치에 따라 어떻게 조정해야 할지를 결정한다,

Sigmoid 함수가 역전파에 유리한 이유

계산의 간편성: Sigmoid 함수의 미분은 그 자체의 출력값으로 계산할 수 있어 효율적이다.

출력값의 연속성: Sigmoid 함수는 0과 1 사이의 값을 연속적으로 출력하여, 신경망의 출력이 항상 일정한 범위 안에서 유지되게 한다.

경사 하강법과의 상호작용: Sigmoid 함수의 매끄러운 미분 특성은 경사 하강법을 통해 가중치를 점진적으로 조정할 때 유리하다


0
0