PARD AI 스터디 회고!🤖
2차로 진행된 인공지능 스터디! 1차 보다 한 주제에 대해서 더 깊고, 심도 있는 이야기를 나눌 수 있었던 것 같습니다!
- Hyper-Scale Model Inference의 최적화 문제
- 정보기하학
- 테슬라의 미래전략과 NPU
위의 3가지 주제로 약 1시간 20분의 스터디가 진행되었습니다~🔥
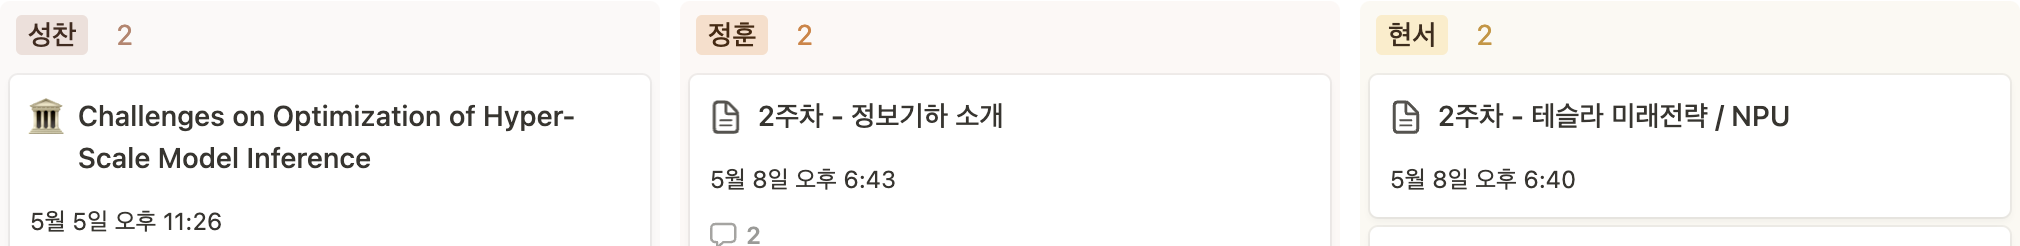
⬆️ 노션에 아카이빙된 이번 주 주제들
내용 요약과 느낀 점
✅ 초대형 추론 모델의 최적화 문제
<내용>
- LLM Inference는 비싸고 비효율적입니다. 하지만 그것을 감수할 수 있는 근거가 있으며, 현실화된 몇 안되는 AI 모델입니다.
- LLM Inference를 위한 최선의 방법은 HBM(고대역 메모리) 등을 장착한 A100/H100입니다. 하지만 Scale-Up이 힘듭니다. (HBM 수급, Power, 가격, 수요,…)
- 이를 해결할 유일한 출구는 모델 압축 기술이고, Quantization / Pruning 등이 많이 연고 되고 있습니다.
- AI 언어 모델, 경량화 기법, 시스템 소프트웨어 최적화, GPU, 하드웨어 구현, 등등
➡️ 성찬님께서 나눠주신 생각들에서 "Fine-tuning을 잘하는 게 중요한건가?", "굳이 큰 모델을 만들어야 하는가?"라는 질문을 들었을 때, "정말 모델의 size만 커지면 높은 지능 수준을 만들어 낼 수 있을까?"라는 생각이 들었습니다. GPT-3 모델의 parameter 수가 175B. 즉, 약 1750억 개인데, 사람 한 명의 뉴런 수는 일반적으로 1000억 개라고 합니다. GPT-3의 size가 사람보다 더 큰데, 여전히 인간의 지능을 넘지 못했기 때문입니다.
✅ 정보기하 소개
<내용>
- 머신러닝은 어떻게 동작할까요? 데이터와 모델이 필요합니다!
- 데이터는 어떻게 만들 수 있나요? 세상의 다양한 데이터 형태를 컴퓨터가 이해할 수 있는 언어로 표현해 냅니다!
- 모델은 어떻게 만들 수 있나요? 모델을 구성하고 있는 것은 코드들이고, 코드를 구성하고 있는 것은 수식들입니다.
- 수식은 무엇을 의미하나요? 수식은 저마다의 철학을 담고 있고, 그 철학들은 어떠한 상황 속에서 어떠한 행위를 해내고 싶은 인간의 욕망이 투영된 것입니다.
- 인공지능 연구자는 어떠한 일을 통해 가치를 창출해내나요? 인공지능 연구자는 기존의 수식들에 담긴 욕망들을 이해하고, 그것을 읽고 활용하는 문해력을 키운 뒤, 관심있는 분야의 문제를 해결하는데 도구로서 인공지능을 사용합니다!
➡️ 딥러닝의 한 신경, parameter는 하나의 수식으로 이루어져 있기 때문에 결국 그 수식 내에 국한될 수 밖에 없다는 것이 인상적이었습니다. 이 부분 때문에 딥러닝이 아직 인간의 지능을 넘지 못하고 있는 것의 원인 중 하나라는 생각이 들었습니다.
✅ 테슬라의 미래전략과 NPU
<내용>
- Tesla의 Vision : 지속 가능한 에너지로의 전환을 통한 친환경 에너지 사회
- 화석 연료 대신 재생에너지로 전기를 만들고 저장하고 유통하겠다
- 전기 자동차를 파는 에너지 회사
- 사람들이 태양 에너지를 발전, 사용, 저장, 거래하는 길목을 차지하겠다
- NPU : AI 가속기, AI 반도체라고 부르며, AI 알고리즘 특유의 패턴에 특화된 반도체
- AI가 Training에서 Inference(추론)의 단계로 넘어갈 때, 많은 양의 전력량이 필요하므로, 비용을 줄이기 위해 NPU가 필요
➡️ GPU와 NPU의 사이에서 적절한 합의점을 찾을 필요가 있을 것 같다는 생각이 들었습니다! 범용성만을 추구하면 전력 문제와 더불어 전성비의 손실이 크고, 특화성만을 추구한다면 호환성의 문제가 생길 것이기 때문에 결국 중간 지점에서 어느 한 쪽에 치우치지 않는 구현과 제작이 필요할 것 같다는 생각이 들었습니다! 또 결국 그런 Unit이 살아 남을 수 있을 것 같습니다. 감사합니다 :)
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.