LLM의 미래가 궁금하다면 Benchmark를 보아라
최근 LLM 관련 엄청난 Benchmark 2개가 등장했었는데요. 바로 GAIA와 GPQA입니다. 이 둘이 엄청나다고 말한 이유는 Benchmark의 난이도가 기존보다 훨씬 높아졌기 때문입니다.
저는 MNIST라는 데이터셋을 가지고 NeuralNet을 학습하면서 딥러닝에 입문을 하였는데요. 다들 아는 유명한 데이터셋이라고 생각합니다. 적당히 CNN으로 개발하면 Accuracy를 90% 이상 달성하는 건 식은죽 먹기였죠. 그런데 시간이 지날수록 Computer Vision 모델의 성능이 좋아졌고 이 모델들을 더 잘 평가하기 위해선 더 어려운 Benchmark인 ImageNet가 등장해서 자주 사용되기도 하였습니다.
이처럼 모델의 성능이 향상될수록, 모델의 평가를 위한 Benchmark의 난이도도 커져야 합니다. LLM이 처음 등장했을 때, QA에서 너무 좋은 성능을 보였기 때문에 기존 QA Benchmark로는 다양한 LLM들을 평가하기 어렵겠다고 생각했는데 역시나 어려운 Benchmark가 등장하게 되었습니다!
GAIA: a benchmark for General AI Assistants
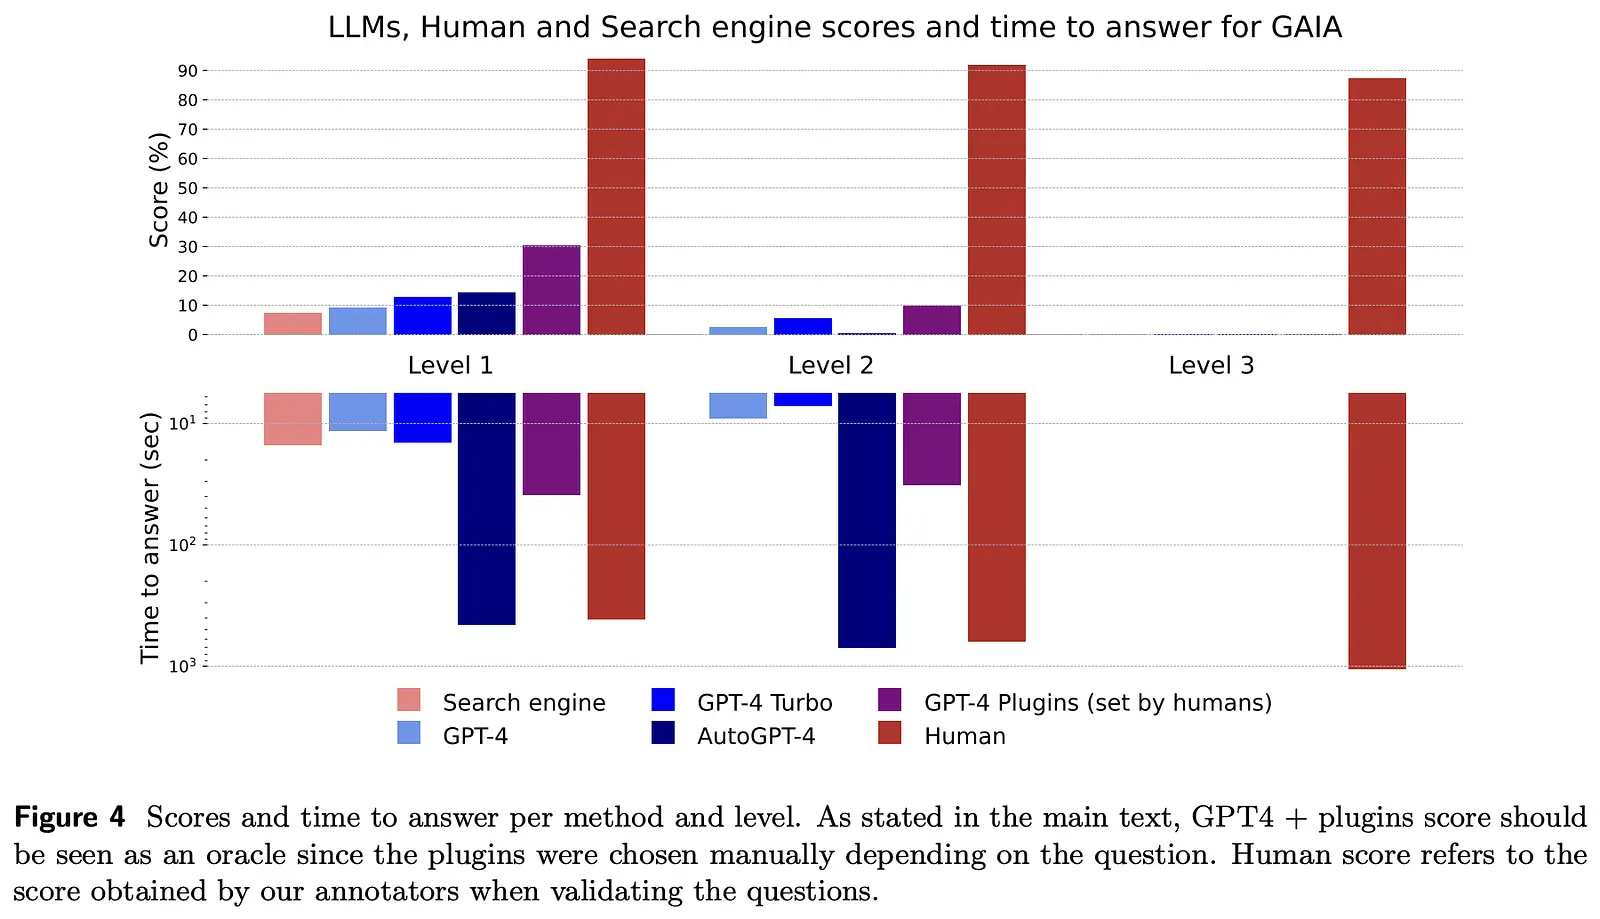
GAIA는 사람은 쉽게 수행할 수 있지만 AI는 아직 잘 하지 못하는 태스크를 모아두었습니다. 예를 들어, 어떤 질문을 하였을 때 우리는 모르면 구글링도 해보고 논문도 읽어보고 해서 답을 찾듯이 AI도 그런 자유로운 액션을 수행할 수 있는지 평가하게 됩니다. 정말 자비스처럼, Assistant처럼 우리가 부여한 태스크를 수행할 수 있는지 평가할 수 있죠.
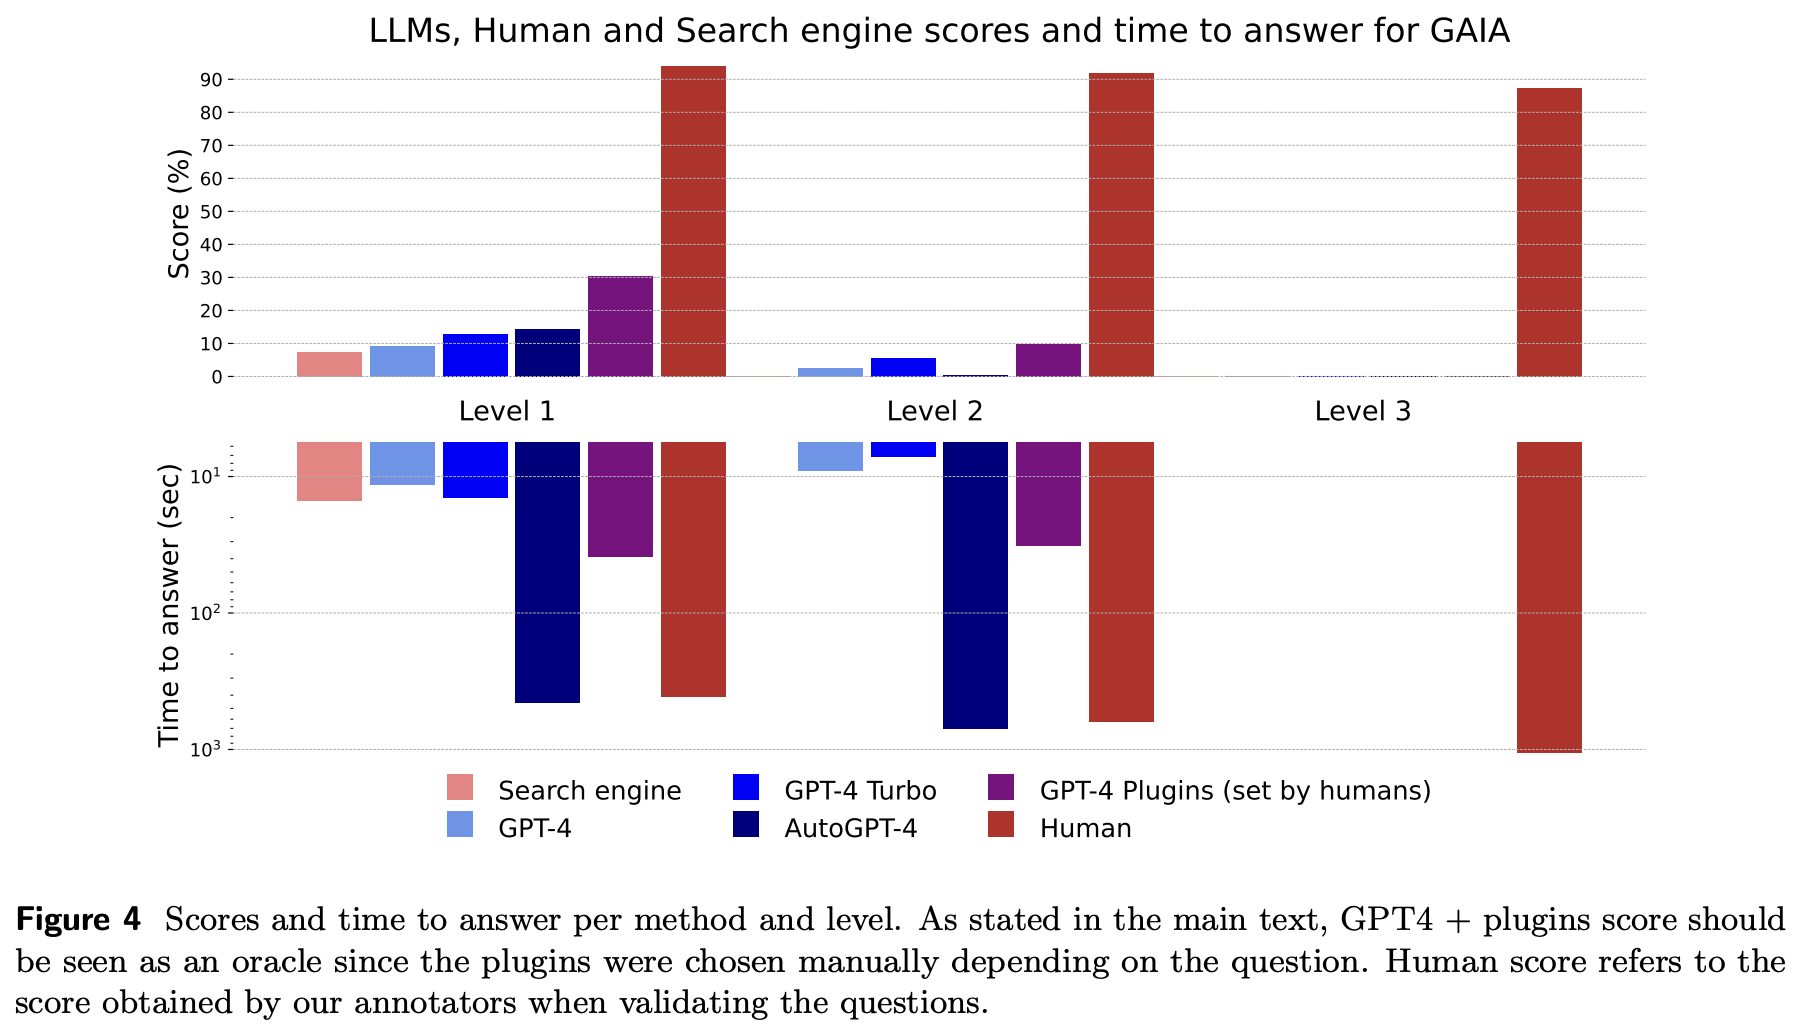
지금은 신이라 불리는 GPT-4도 10% 정도의 성능밖에 보이질 않아요. 만약 AI Assistant가 이걸 Human level인 90%까지 달성한다면,, 정말 현실판 자비스가 탄생하지 않을까요?
GPQA: A Graduate-Level Google-Proof Q&A Benchmark
GPQA는 QA (Question-Answering) Task의 난이도를 확 올렸어요. 생명과학, 물리학, 화학과 같은 전문적인 분야에 대한 질문을 만들고 실제로 PhD들한테 풀어보라고 시키니 65% 정확도를 보였다고 하네요. 또한 구글링으로 쉽게 풀리지 않는 문제라는 걸 증명하기 위해 비전문가분들에게 30분의 시간을 주고 구글링을 활용해서 답해보라고 했지만 34%만이 정답을 맞췄다고 합니다.
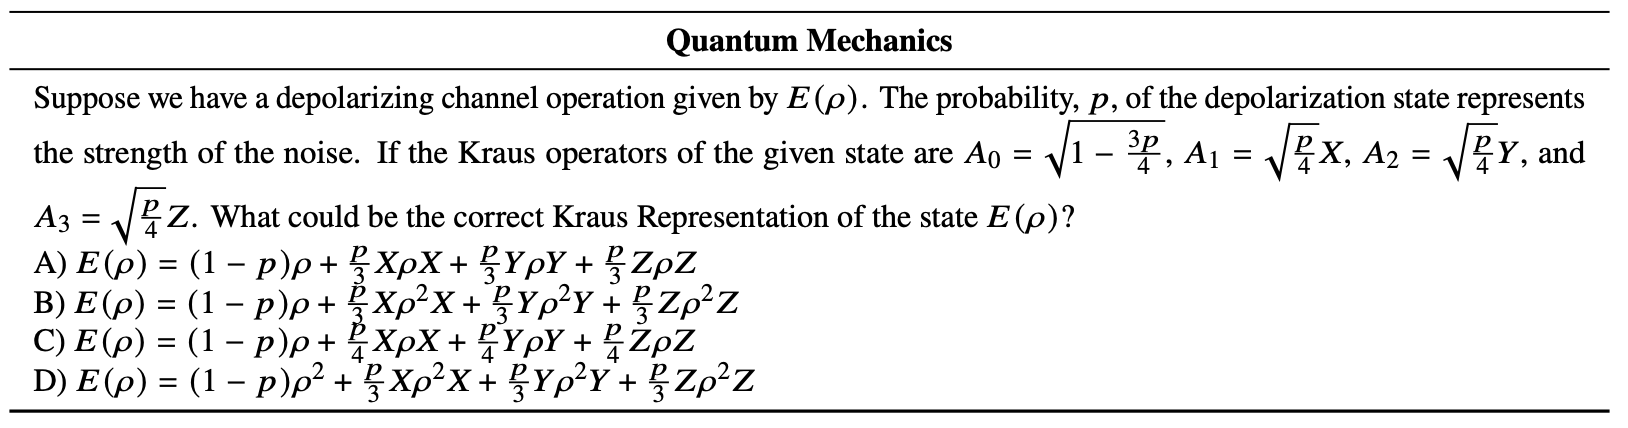
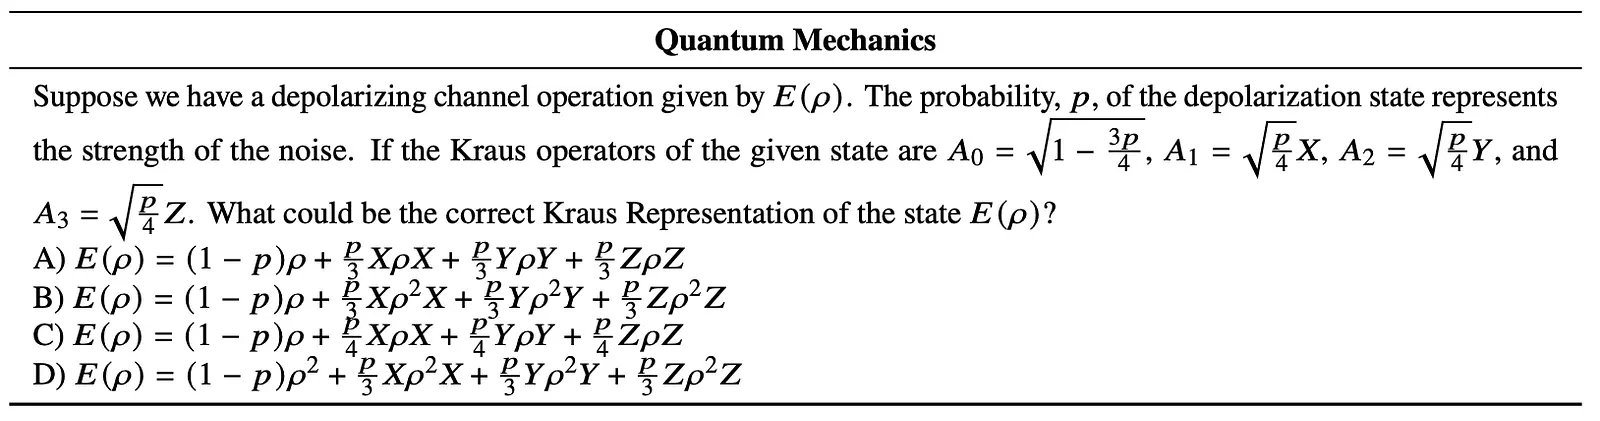
(이거 풀 수 있는 사람..?)
현재 GPT-4는 39% 정확도를 보인다고 해요. LLM의 정확도가 PhD의 정확도보다 높아진다면 우린 정말 고도화된 전문가를 얻을 수 있지 않을까요?
이전에는 Benchmark로 모델 A vs 모델 B, 이렇게 비교를 했다면 앞으로는 사람 vs LLM, 이런 대결 구도로 패러다임이 바뀌는 것 같아 무척 흥미롭네요!
여러분들은 LLM의 미래를 어떻게 생각하시나요?
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.