PLM으로 자동 텍스트 분류 제작기! : 해당 텍스트가 AI와 관련이 있을까요?
1.Overview & Motivation
저번시간에 PLM(Pre-trained Language Model)을 통해 키워드를 추출하는 과정을 진행해 보았습니다.
하지만 유저가 잘못된 사이트를 입력한다면? 그 사이트가 AI와 관련이 없다면?
회사와 유저, 모두의 니즈에 부합하지 않을거에요!
모두 AI관련 정보를 찾으려 저희 Core.today에 접근했으니 말이죠~ 그렇다면 유저의 텍스트가 AI 관련인지 아닌지 판별하는 알고리즘이 필요하겠군요!
만들어 봅시다.
2. Success metrics
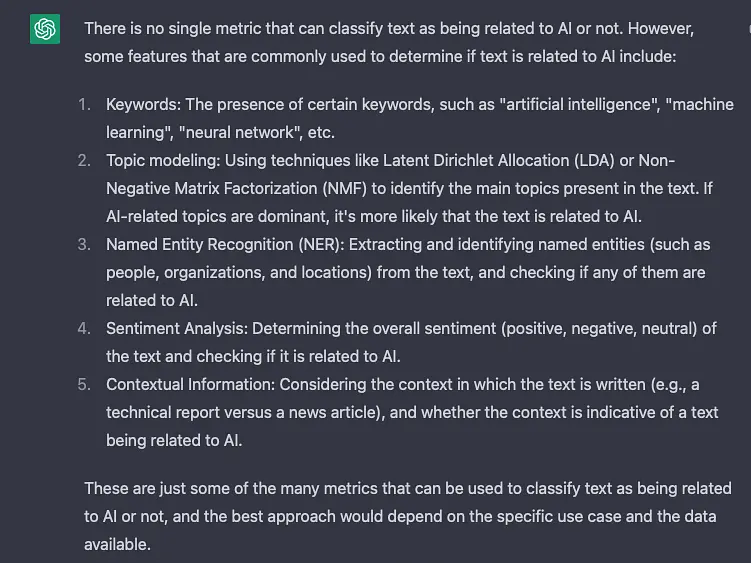
도대체 AI관련 뉴스가 무엇일까, chatGPT와 함꼐 생각해보았습니다.
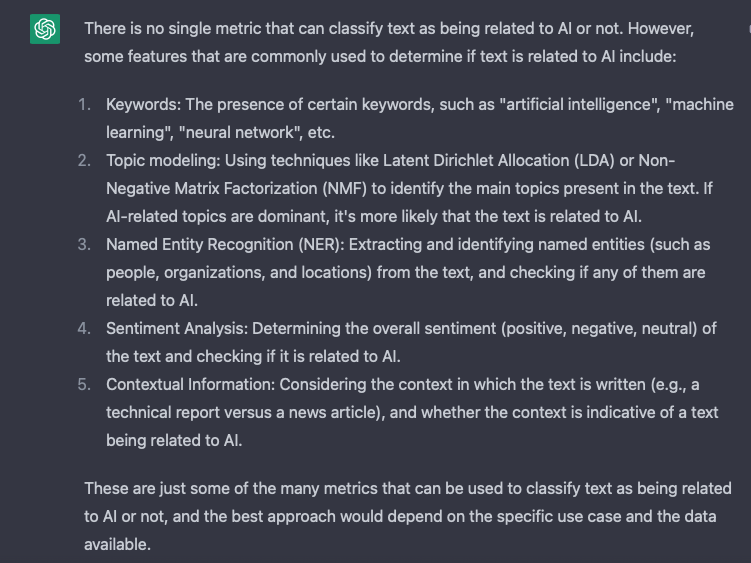
chatGPT가 제안하는 유용한 metric으로는 키워드, NER, Topic modeling등 여러가지 방법이 있었습니다. 하지만 실제로 텍스트를 분류할 때, 'GPT-6', 'Dall-E 4'등과 같이 새로운 AI관련 용어가 키워드, NER로 들어왔을 때 인식하지 못한다는 단점이 있습니다.
또한, "AI 사업부 OOO 부장이 승진했습니다."와 같은 문장에서는 AI 사업부가 키워드, NER이 될 수 있지만 문맥상으로는 사회/경제 뉴스에 더 적합하다는 것을 알 수 있습니다.
단어에 국한된 것이 아니라 일반인들이 글을 읽고 문맥을 파악했을 때, "오, 인공지능 관련 지문이구나!"라고 느끼는 텍스트가 AI관련 텍스트라고 기준을 정했습니다. 다소 애매하죠?
인간이 수 없이 하고 있는 이 분류작업을 AI가 못할리가 없습니다.
우리에게는 contextual vector를 무려 768 차원으로 뽑아주는, Pre-trained Language Model, BERT가 있기 때문이죠.
Contextual Information(vector)에서 '인공지능 관련'이 가지는 Boundary를 머신러닝을 통해 설정하고 그 Boundary를 통해 분류를 진행해봅시다!
3. Requirements & Constraints
- Pre-trained model
- Bert model / KoBert model
- Requirements
- transformers == 4.26.0
- sentencepiece >= 0.1.97
- torch >= 1.7.0, <=1.10.1
- trafilatura (optional, 자동 URL-text fetch를 위해 필요합니다.)
- Dataset
- Bigkinds-뉴스 빅데이터
- AI times-크롤링 데이터
- Environment
- Colab (10000개 이상의 데이터셋에서는 Colab-PRO나 40Gb이상의 GPU가 필요합니다.)
4. Methodology
4.1. Model conception
Contextual information을 추출하는 모델은 다양합니다. 기본적으로는 Bi-LSTM, GRU 모델로부터 Transformer, 나아가서는 Bert, Roberta등 여러 모델이 있죠.
저는 여러 모델을 시험해봤는데, 단어정보에 주목하는 Embedding - Dense Layer, 문맥을 파악하는 Embedding - Bi-LSTM - Dense Layer, Bert - Dense Layer 3가지를 시험해봤습니다.
첫번째 모델은 각 단어 토큰의 Embedding 값, 즉 숨겨진 정보에 주목하여 분류를 해봤고, 두번째 모델은 Bi-LSTM을 사용하여 앞 뒤 문맥을 파악하게 하고 마지막 cell에서 문맥정보를 빼와서 분류를 진행해보았습니다.
세번째 모델은 앞에 모델과는 다르게 이미 문맥 정보, Contextual information을 Transformer encoder Layer와 Positional encoding을 통하여 잘 extract 할 수 있게 pre-training 시킨 PLM모델인 BERT를 활용하여 문맥정보를 추출하고 그 문맥정보를 활용하여 분류를 해보았습니다.
4.2. Data
데이터셋을 고르는 것이 까다로웠습니다. 어떤 데이터셋을 선택해야 최적의 결과를 낼 수 있을까요?
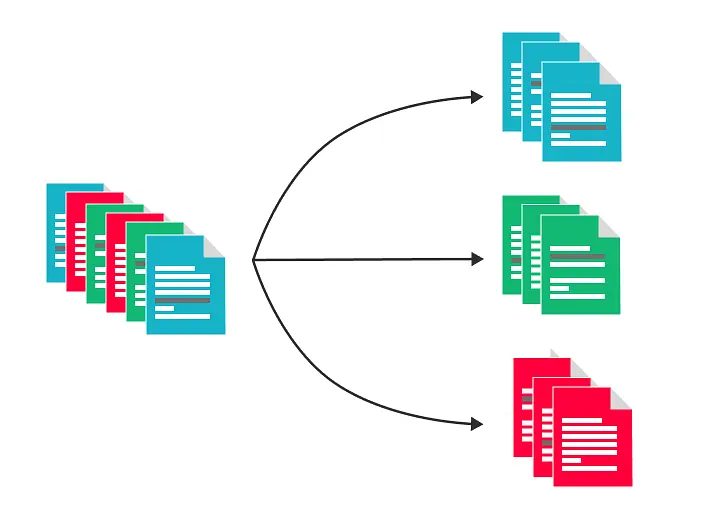
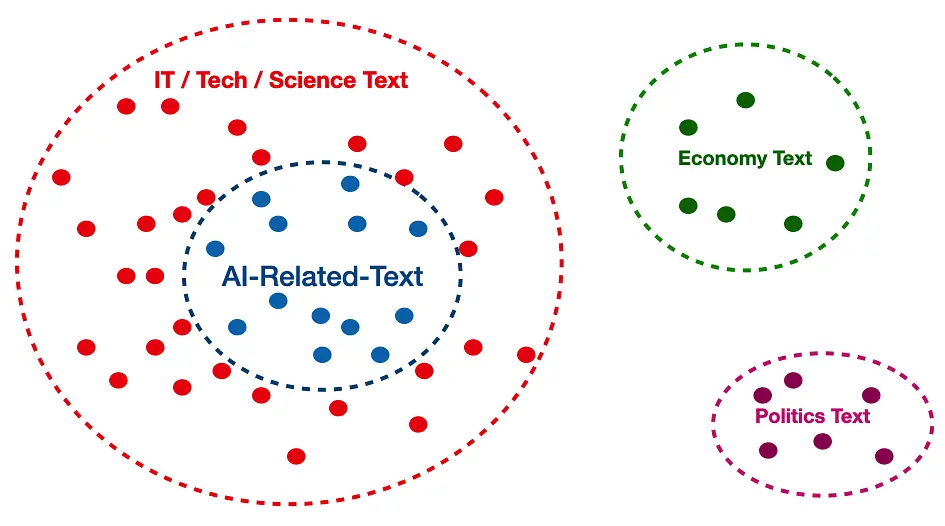
아래 사진을 보시죠!
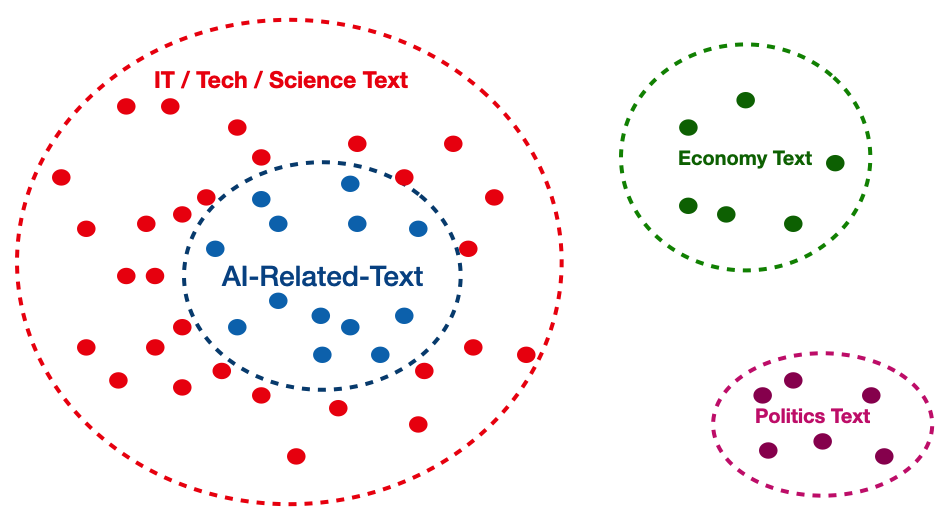
우리가 각 모델에서 Contextual-vector를 얻어서 차원상에 점을 찍으면 위와 같이 나올겁니다. 정치뉴스, 경제뉴스, IT과학 뉴스 등 세분화된 그룹들로 구분할 수 있겠죠! 네이버 뉴스 카테고리처럼요. 그렇다면 우리는 다른 카테고리, 즉 IT/테크/과학이 아닌 다른 카테고리를 선택할 필요가 있을까요?
우리의 궁극적인 목표는 AI-Related-Text를 잘 구분하는 것입니다. 그 말은, AI-Related-Text와 IT/테크/과학 분류군에서의 Boundary, 경계를 얼마나 잘 설정하냐가 관건이 될거에요.
그렇다면 Boundary 근처의 데이터들을 최대한 많이 학습시키는 것이 효율적인 학습이 될 것이라고 확신했습니다.
자 이제 데이터를 수집해볼까요?
한국 뉴스 빅데이터를 지원하는 빅카인즈를 이용해 키워드 AI로 AI관련 뉴스데이터셋을 찾아봤어요!
하지만,,
"[기상정보] 다음 내용은 인공지능을 활용한 데이터를 기반으로 작성한 내용입니다."
위 사례와 같이 AI라는 단어는 문장에 포함되지만 기사의 Topic, 주제를 보면 경제, 일기예보 등 다른 주제가 섞여있는 경우가 많아서 빅카인즈 데이터는 NAI, 즉 AI와 연관이 되지 않은 기사 URL-데이터셋을 수집했습니다.
AI관련 뉴스데이터셋은 인공지능신문이라는 신문 사이트를 활용했습니다.
해당 신문은 이름에 걸맞게 인공지능에 관련된 내용만 다방면으로 다루는 사이트라서 이 사이트에 포함된 모든 뉴스들이 인공지능 관련이라고 가정할 수 있었어요.
그래서 해당 사이트에서 AI tech, AI industry 분야에서 모든 기사 URL을 스크래핑하여 URL-데이터셋을 만들었고 각 URL을 순회하며 텍스트를 뽑아와서 AI-NAI 뉴스 데이터셋을 만들었습니다.
AI와 NAI 데이터셋의 크기가 1:1로 설정하고 None데이터를 정제하여 최종적인 데이터셋을 만들었습니다.
자 이제 모델은 만들어 봅시다.
4.3. Techniques
제가 설계한 각 모델은 다음과 같습니다.
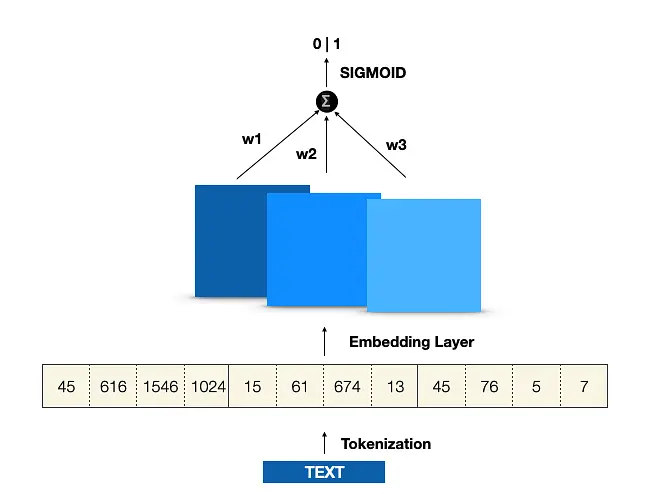
우선 첫번째 Embedding-Dense 모델입니다.
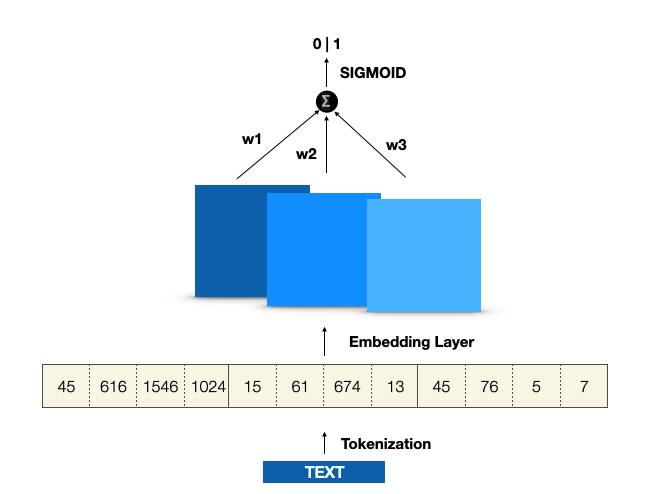
우선 Text로부터 Word-tokenization을 진행합니다. 그 이후 Embedding Layer(학습 가능)을 통과하고 나온 단어 수준 embedding vector를 구해서 Dense층을 통과한 후 Binary-classification을 위해 sigmoid 함수를 거치면 끝이납니다.
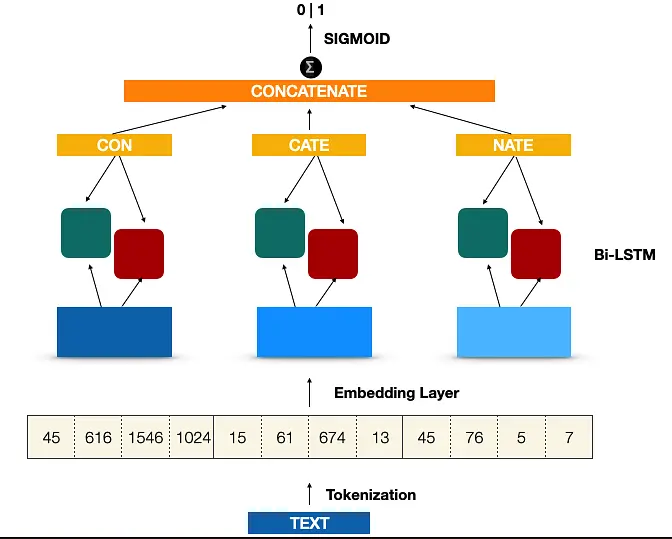
두번째는 Embedding - Bi-LSTM 모델입니다.
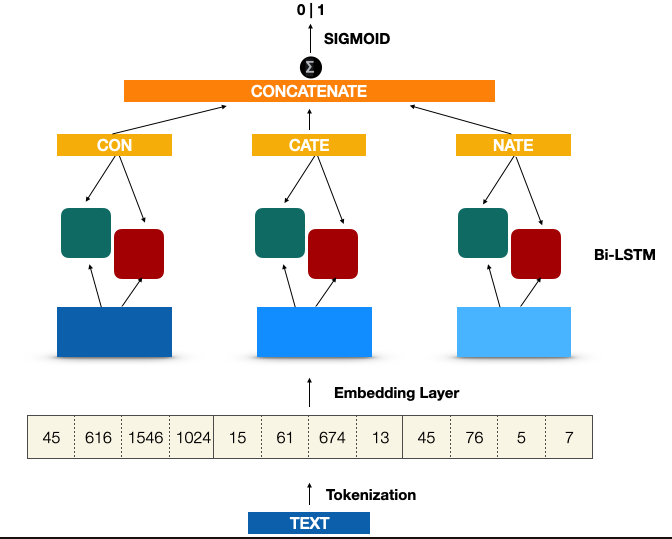
Word-tokenization과 Embedding Layer를 통과하는 것은 똑같습니다. 다만 이제 Dense-Layer 대신 Bi-LSTM층을 통과한 후 output층을 Concatenate 시켜서 Dense-Sigmoid층을 통과시킵니다.
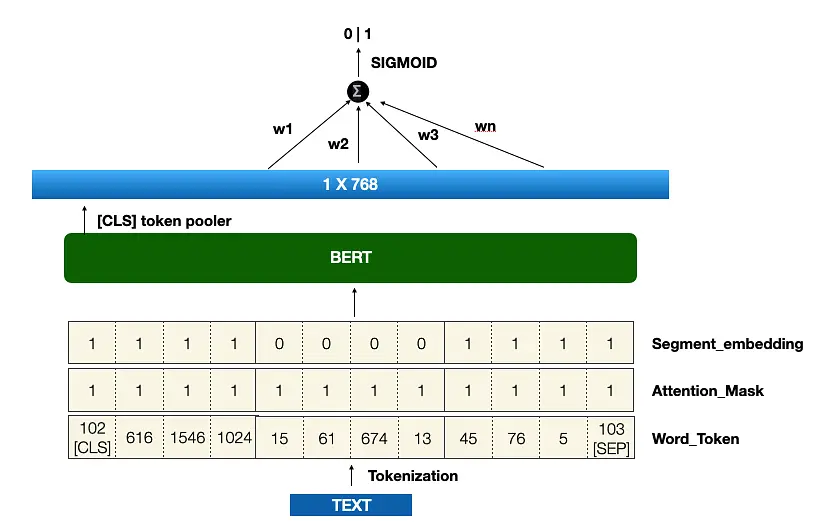
마지막, BERT-Dense 모델
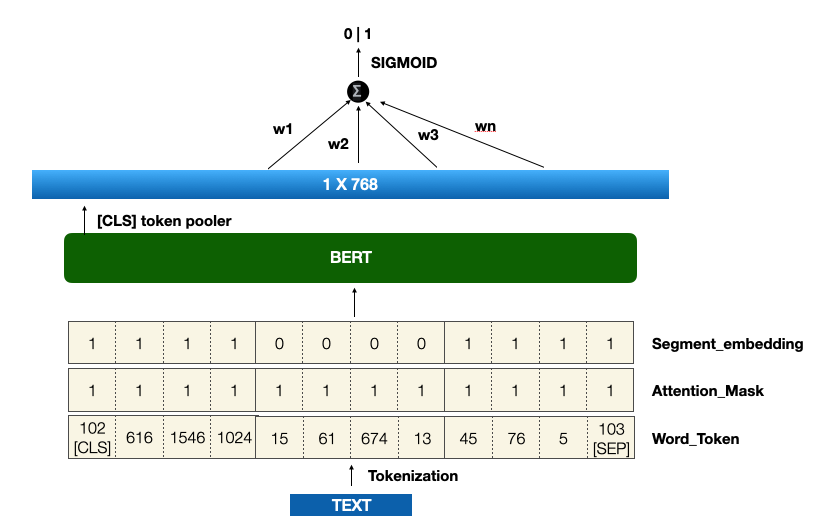
Bert는 위에서 언급했다시피 Contextual vector를 추출하기 좋은 모델입니다.
Bert의 입력층에는 단어 Token과 어디까지가 중요하지 나타내는 어탠션 마스크, 마지막으로 문장을 구분하는 Segment-embedding이 필요합니다.
이렇게 나온 Output들 중에 Pooler output([CLS] 토큰 위치 output)의 벡터를 가지고 와서 Dense-Sigmoid층을 통과하여 이진 분류를 완성합니다.
4.4. Result
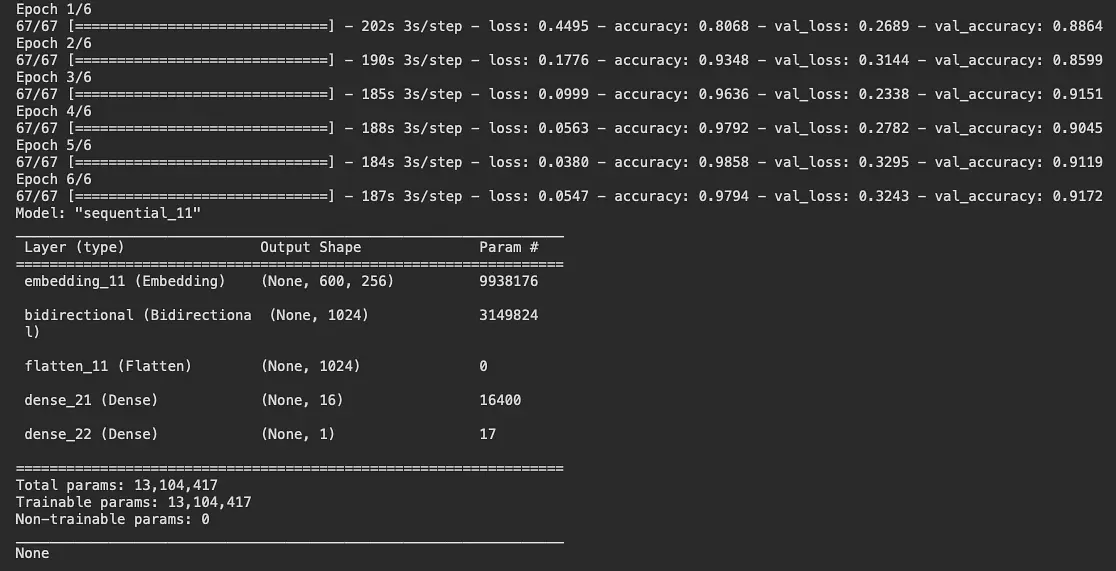
우선 정확도는 다음과 같았습니다.
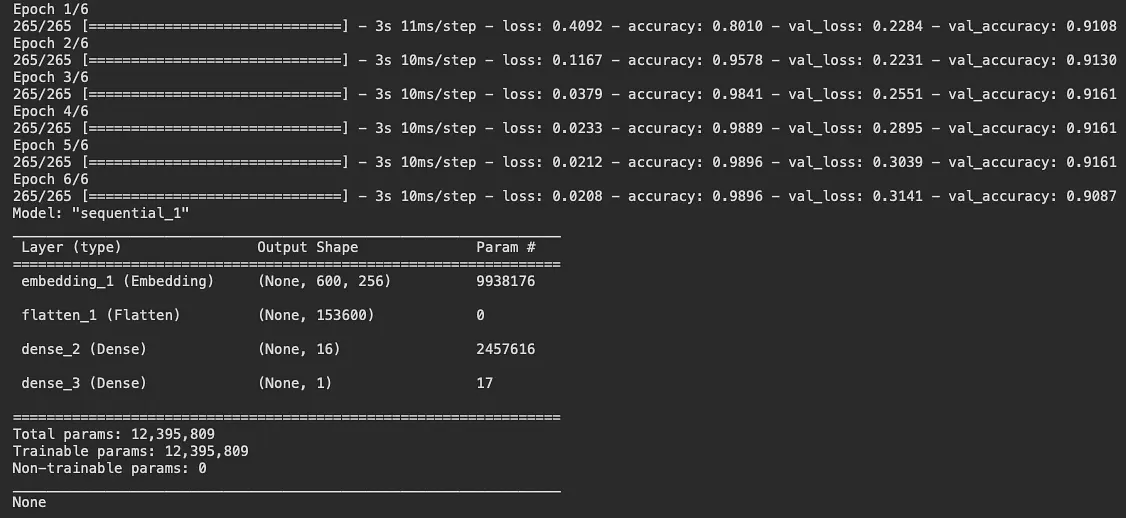
1.Embedding-Dense
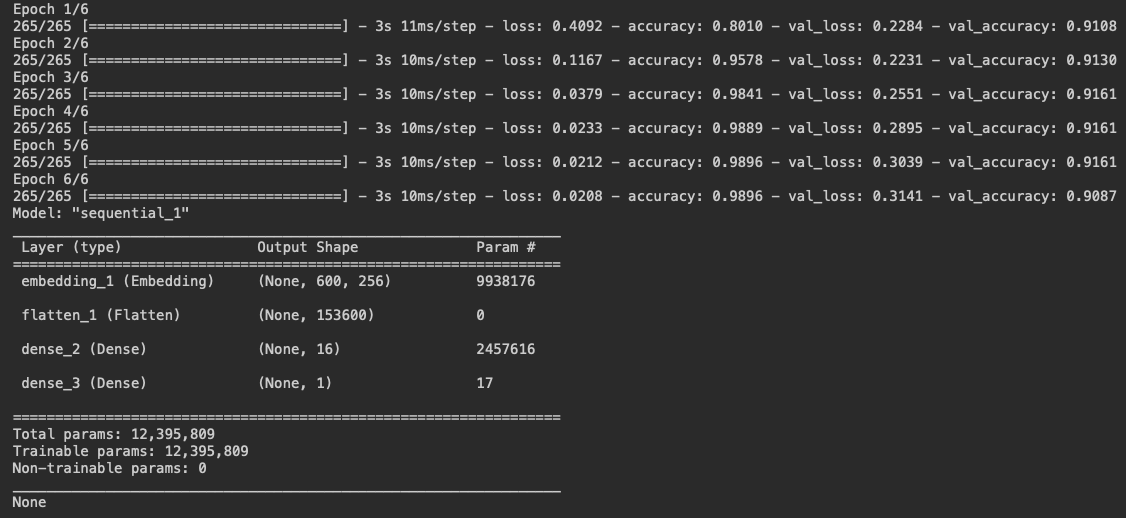
Validation accuracy는 0.91정도가 나왔네요. 약 10%정도 오류가 있었습니다.
2.Embedding - Bi-LSTM
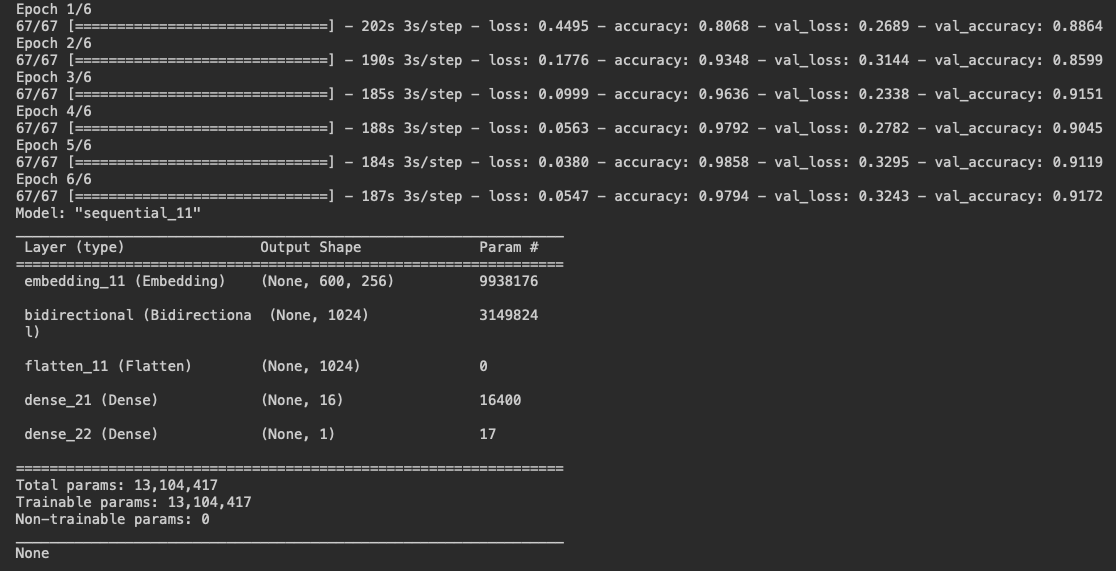
위 Embedding-Dense 모델보다 살짝 높은 Validation accuracy가 0.917정도 나왔습니다.
조금 더 개선되었네요!
3.BERT-Dense
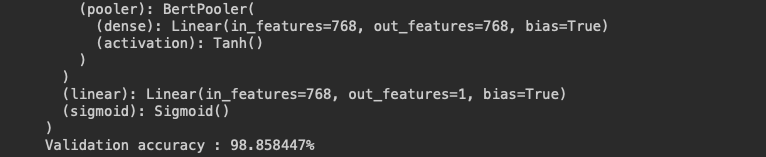
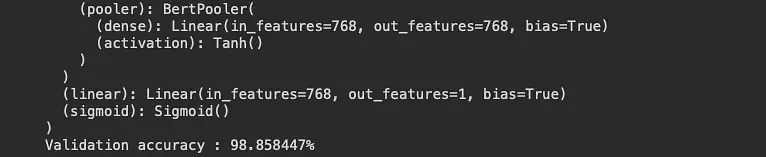
(위에는 BERT 모델 Architecture인데 너무길어서 생략하겠습니다...)
우리 BERT모델은 Validation accuracy가 0.988정도 나왔습니다.
4.4. Conclusion
대망의 Bert! 역시 다양한 분야에서 SOTA를 달성한 모델답게 정확도가 무려 98.86%가 나왔습니다.
그렇다면 우리가 선택해야하는 모델은 BERT-Dense 모델이 되겠네요!
BERT-Dense 모델을 이제 Test data로 실험해보고 학습데이터를 더 많이 확보하여 학습시켜야겠습니다.
5. Implementation
5.1. High-level design
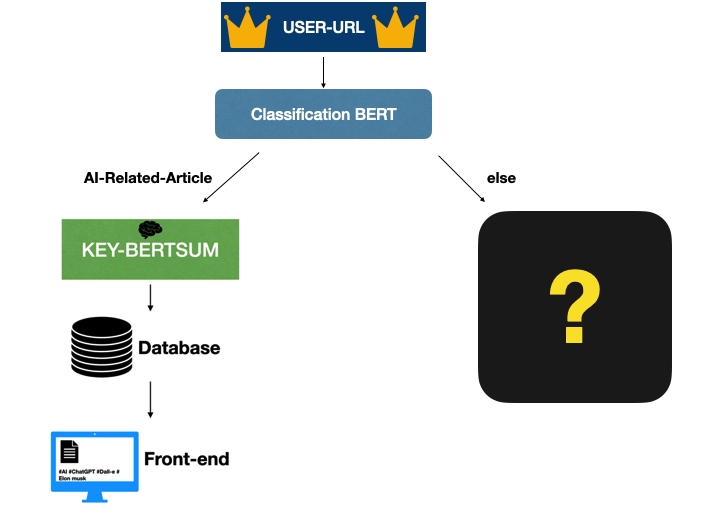
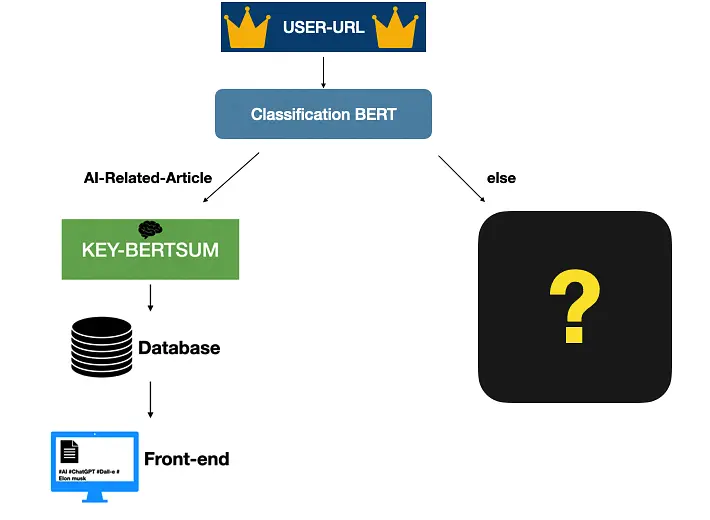
유저가 URL을 사이트에 넣으면, 우리는 그 URL에서 텍스트를 추출하고 AI related BERT Classifier에 통과시킵니다. 만약에 AI관련이라면, 키워드와 요약문을 추출하고 데이터베이스에 저장하고 프론트엔드에 나타냅니다.
만약에 AI관련이 아니라면..?
이후 프로세스는 생각을 좀 해봐야겠습니다ㅠㅠ
5.2. Performance (Throughput, Latency)
문서의 길이에 따라서 다르지만 평균적으로 Colab 무료 cpu 환경에서 문서당 요약문, 키워드 추출까지 약 1 ~2초가 소요됩니다.
6.Appendix
6.1. Alternatives
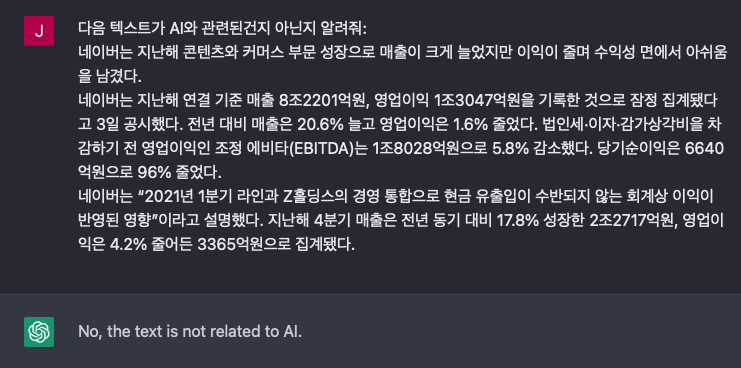
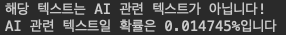
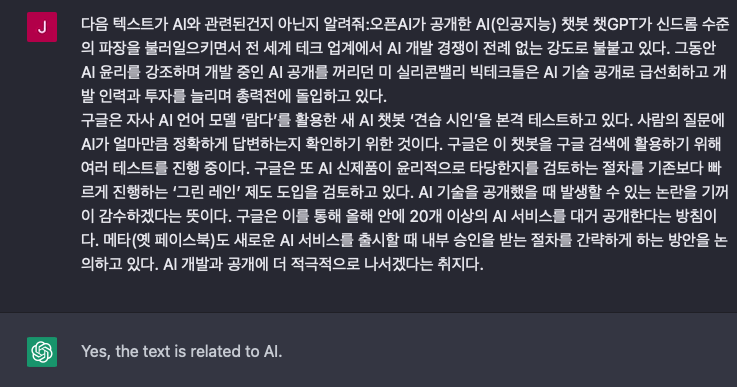
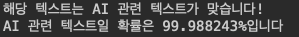
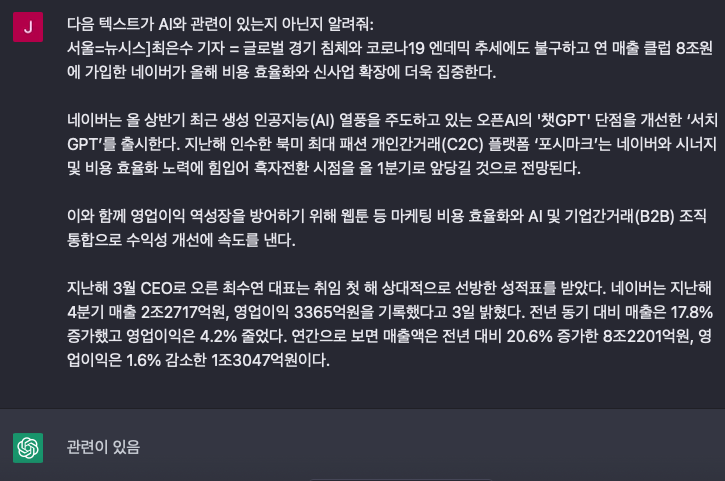
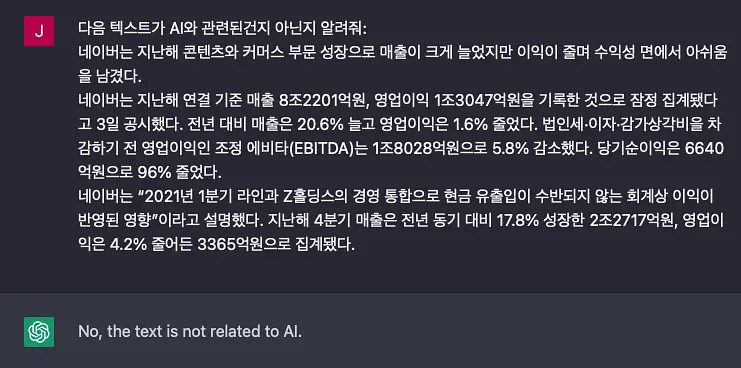
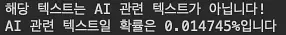
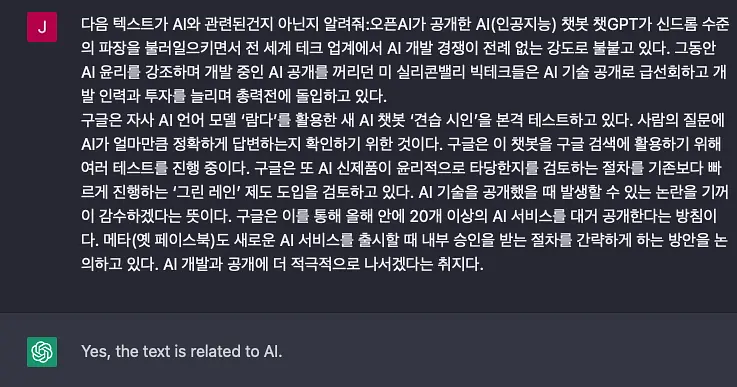
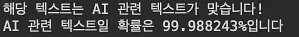
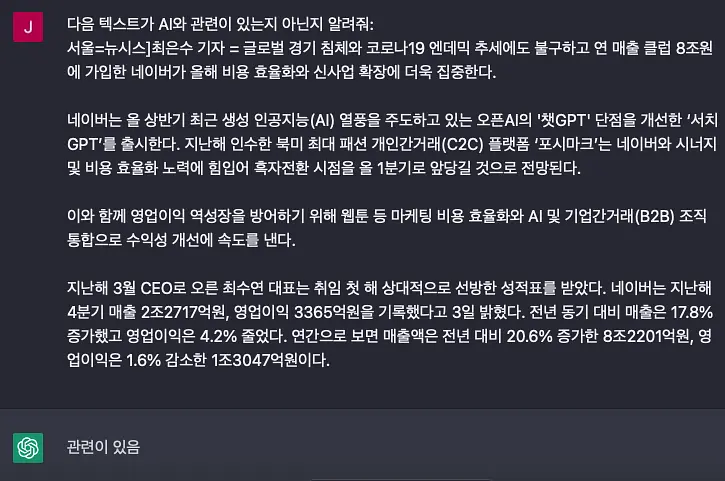
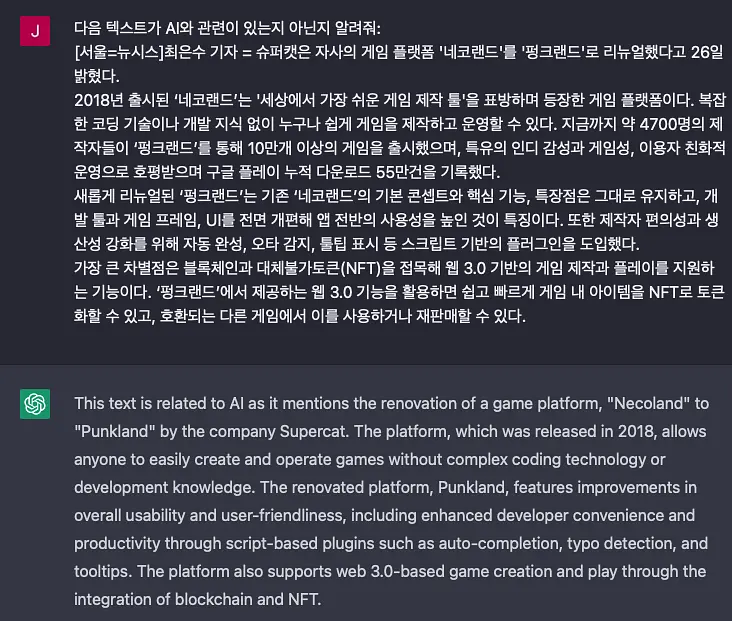
음,, 제가 찾아본 바로는 텍스트를 분류하는 모델은 많이 있으나, AI 관련 텍스트 인지 아닌지 분석하는 모델은 없어서 Few-Shot-Learning이 가능한 chatGPT를 통해 결과를 비교해보았습니다.
chatGPT:
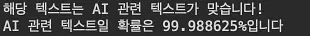
ClassBERT(My model):
chatGPT:
ClassBERT(My model):
chatGPT:
;; 제가 잔소리좀 했더니 화가 났나봐요,,
ClassBERT(My model):
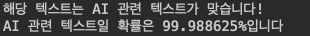
오호! 지금까지는 두 모델 모두 잘 분류하고 있습니다.
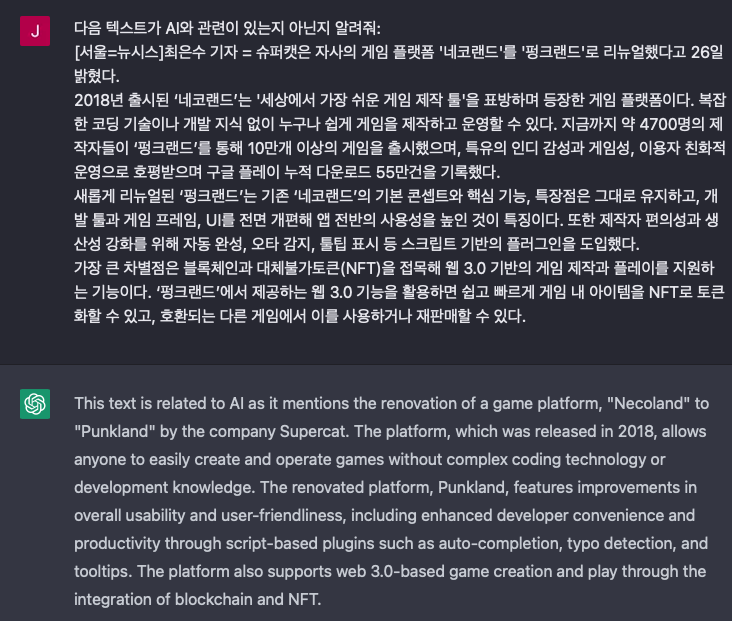
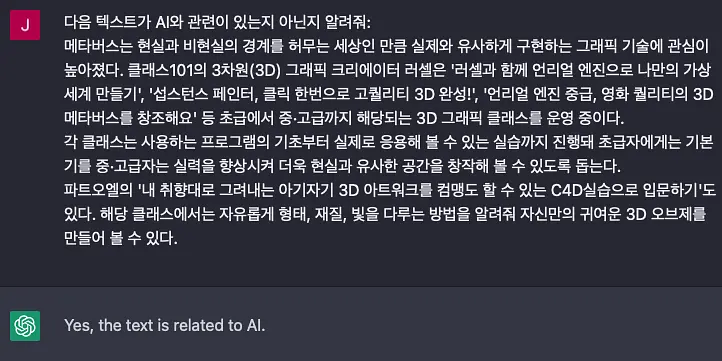
그렇다면 코딩, 블록체인, 알고리즘 등 IT기술에는 연관이 되지만 AI 범주가 아닌 데이터들은 어떻게 평가를 할까요?
chatGPT:
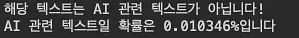
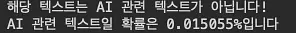
ClassBERT(My model):
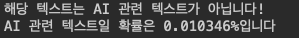
chatGPT:
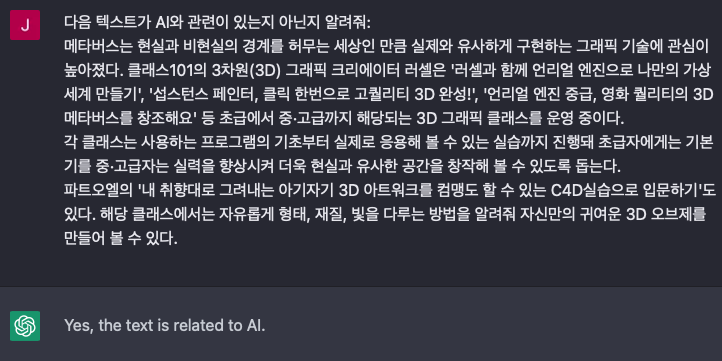
ClassBERT(My model):
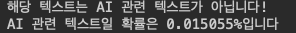
위 두개의 사례를 보면, chatGPT는 AI의 범주에 있지 않지만 IT범주에 있는 알고리즘, 빅데이터, 메타버스, 코딩 등과 같은 토픽을 가진 텍스트는 모두 AI와 관련이 있다고 한 반면, 제 모델은 AI 범주를 조금 더 잘 구분하는 것을 볼 수 있습니다.
chatGPT도 완벽하진 않군요!
(AI 관련 확률은 SIGMOID를 거친 결과라서 그냥 재미로만 봐주세요ㅎㅎ!)
6.3. Milestones & Timeline
모델 구상 및 설계 : 0.5 day
데이터 가공 : 0.5 day
모델 실험 (동주님이 주신 데이터로) 및 글 작성 : 1 day
6.4. Glossary
6.5. References
댓글
로그인 후 댓글을 남길 수 있습니다.
우와 chatGPT에게 물어본다니 생각두 못해봤어요! 👍