머신러닝 기본 이론
출처: 라온피플 아카데미 네이버 블로
Hebbian Rule
앞서, 신경망의 역사([Part II. Neural Networks] 2. History)에서 살펴보았던 것처럼,
1949년 심리학자인 Donald Hebb는 뉴런의 시냅스에 기반한 학습의 법칙을 발표하였다.
그는 생물학적인 신경망에서 학습이 이루어지면 특정 입력으로 들어오는 신호 자극에 잘 반응할 수 있도록 시냅스들의 세기가 결정이 된다는 사실에 주목하였다.
그의 이름을 딴 Hebbian rule에 따르면, 학습이란 시냅스 연결의 세기(strength)를 조정하는 것으로 정의했으며,
기본적인 학습 방법은 2개의 뉴런이 동시에 활성화 시키려면, 뉴런 연결된 가중치(weight)를 높이면 된다.
-Perceptron 개념
1957년에 Rosenblatt는 "Perceptron"이라는 용어 및 개념을 발표했다.
발표 당시, 뉴런의 활성함수(activation function)로 "step function"을 사용했기 때문에
지금처럼 "sigmoid function"을 사용하는 뉴런에 비해 제약이 많았지만,
입력의 중요도에 따라 출력이 결정이 되는 수학적 모델로서는 의미가 있다.
여기서 입력의 중요도는 가중치에 따라 결정된다는 개념이 도입되었으며,
아래 그림처럼, 2 layer feed forward 구조에서는
여러 개의 입력을 받아 1개의 출력을 결정하는 신경망의 경우를 살펴보면,
출력은 가중치와 입력의 곱의 합이 특정 기준(threshold)보다 작으면 0이 되고, 크면 1을 출력한다.
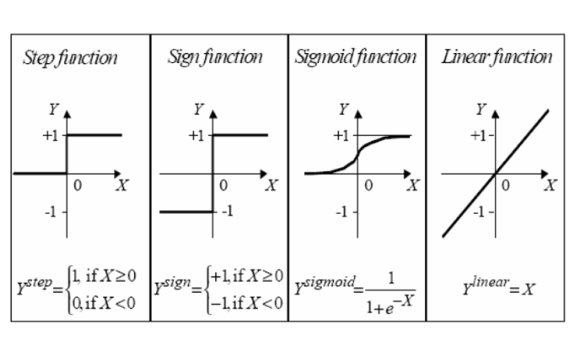
Step function의 원리는 매우 간단한 임계값 기반의 결정 함수로, 입력값이 주어진 임계값(threshold)을 넘는지 여부에 따라 출력을 결정하는 방식입니다. 기본적으로, 입력값이 임계값보다 작으면 0을 출력하고, 임계값을 넘으면 1을 출력하는 구조입니다.
Sigmoid Functions
해결책은 활성함수로 Perceptron처럼 Step function을 사용하는 대신에, "Sigmoid 함수"를 사용하는 것이다.
활성화 함수로 "Sigmoid 함수"를 사용하면,
0에서 1까지 연속적으로 변하는 출력값을 갖기 때문에,
가중치나 바이어스를 조금 변화시켰을 때 출력이 조금씩 변화하도록 만들 수 있다.
Sigmoid 함수는 아래와 같은 식을 갖는다:
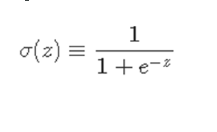
여기서 zzz는 각각의 입력(x1, x2, x3, ...)과 가중치(w1, w2, w3, ...)를 곱한 값에 bias를 더한 값이며,
입력이 결정이 되면, 가중치나 바이어스를 약간 변화시켰을 때(즉 편미분을 하였을 때),
출력이 그에 상응하여 변화하는 것을 확인할 수 있다.
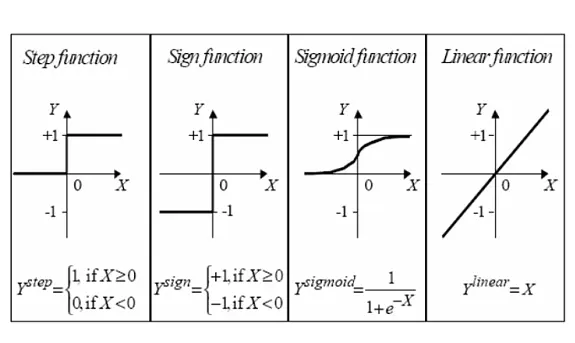
Sigmoid 함수는 연속적인 출력값을 반환하는 활성화 함수로, 입력값을 더 부드럽게 처리합니다. Step 함수처럼 단순히 두 값으로 나누는 것이 아니라, 입력값이 클수록 출력값은 1에 가까워지고, 입력값이 작을수록 출력값은 0에 가까워집니다. 하지만 그 사이에는 0에서 1 사이의 연속적인 값을 갖기 때문에 더 미세한 변화를 반영할 수 있다.
Gradient-Descent
여기서 중요한 점은 가중치나 바이어스의 작은 변화량에 대해서 출력의 변화량이 linear 하다는 점이다.
이런 선형적인 특성으로 인해,
가중치나 바이어스를 조금씩 바꾸면서 출력이 원하는 방향으로 움직이도록 만들 수 있다.
이것을 유식한 용어로는 Gradient-Descent 방법이라고 하며,
최적값을 찾아갈 때 흔히 사용하는 방법이다.
좀 더 부연설명을 하면,
gradient-descent 방법은 오목한 그릇에서 공을 굴리는 경우를 생각하면 이해하기가 쉽다.
어떤 지점에서 굴리기를 시작하더라도,
그릇의 밑바닥까지 내려가면 최적값에 도달했다고 볼 수가 있다.
이 때 내려가는 방향을 선택하면,
공이 특정 위치에 있을 때, 그 미분값(gradient)가 음이 되는 방향을 선택하면 된다.
이 과정을 반복하다 보면 공은 결국은 바닥에 내려가게 되듯이,
어떤 특정 위치에서 시작을 하더라도
그 위치에서 편미분 값이 음수가 되는 방향을 계속 선택하면 최적값에 도달하게 된다.
Gradient Descent는 기울기를 사용해 함수의 출력값을 최소화하는 방향으로 변수들을 업데이트해 나가는 과정입니다. 이 방법은 특히 비용 함수(Cost Function)나 오차 함수(Loss Function)를 최소화할 때 많이 사용된다.
Supervised Learning
이것은 어떻게 보면 학습의 원리와 유사하다.
미리 값을 알고 있는 훈련 데이터를 통해,
가중치와 바이어스를 조금씩 변화시켜 가면서 출력이 최적의 상태가 되도록 하는 방법이
바로 지도 학습(supervised learning)이다.
가중치와 바이어스의 최적값을 찾아가는 방법은 얼핏 보면 쉬워 보이지만,
1개의 뉴런에 여러 개의 입력이 연결이 되고,
또 그런 뉴런이 여러 개가 있다면 변화시켜야 할 가중치와 바이어스가 점점 많아지게 된다.
어떻게 최적값을 찾아갈 수 있을까?
막연하게 막고 품는 방식으로 여러 개의 값을 무작위로 바꿔 간다면 과연 최적값에 도달할 수 있을까?
이것에 대한 해답은 역전파(back-propagation) 방법을 사용하면 된다.
최적값을 찾아가는 방식: 역전파
이진분류 문제에서 Step 함수는 입력값에 따라 0 또는 1의 출력만 제공하기 때문에, 미세한 변화를 반영하기 어렵습니다. 이를 보완하기 위해, Sigmoid 함수가 도입되어 0과 1 사이의 연속적인 출력값을 제공할 수 있게 되었습니다. Sigmoid 함수는 가중치와 바이어스의 작은 변화에도 출력이 점진적으로 변화하여, 더 세밀하게 학습할 수 있습니다.
또한, Gradient Descent와 역전파(Backpropagation)를 사용하여 모델이 학습하는 과정에서 가중치와 바이어스를 지속적으로 업데이트합니다. 이 과정에서 출력값과 목표 출력값(라벨) 사이의 차이를 손실 함수(Loss Function)로 계산하고, 이를 최소화하는 방향으로 학습을 진행하여 출력값과 목표값 사이의 오차를 줄이는 것이 목표입니다.
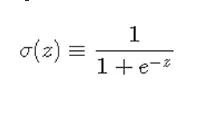
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.