대규모 언어모델에 지식을 주입한다면? -cokeBERT 논문 리뷰를 중심으로 (1)
Nobody phrases it this way, but I think that artificial intelligence is almost a humanities discipline. It's really an attempt to understand human intelligence and human cognition.
아무도 이렇게 표현하지 않겠지만, 인공지능은 거의 인문학이라고 생각합니다. 인공지능은 인간의 인지능력과 지성을 이해하려는 시도입니다.
-Sebastian Thrun
저는 스탠포드 대학교의 교수이자 자율주행의 아버지라고 불리는 세바스찬 스런의 생각에 전적으로 동의합니다.
인공지능은 세상에 없던 새로운 무언가를 만들어가는 과정이라고 생각되어지지만 사실은 여러분들이 숨을 쉬는 한 매일 끊임없이 하고 있는 고도의 사고의 일부를 형편없게 모방한 일종의 알고리즘입니다.
엄청난 학습 데이터와 그 학습 데이터를 학습시키기 위한 거대한 GPU, GPU를 구동하기 위한 더 엄청난 전력 소비까지. 실제로 GPT-3를 학습시킬 때, 45TB의 데이터와 512개의 V100 GPU, 28,000KW의 전력이 사용되었습니다. 가구 연 전력소비량의 3배에 육박하는 엄청난 전력량이죠. 반면에, 인간은 하루에 100W 정도의 에너지를 갖는 음식이면 충분하죠!
이 엄청난 비효율을 조금이라도 극복하기 위해서는 효율의 끝판왕인 인간의 인지, 사고과정을 최대한 모방하는 것이 좋은 방법이 될 것입니다.
서론이 좀 길었는데, 정말 인간처럼 글을 읽고 이해하는 NLP모델을 만들기 위해, 이제 우리가 어떻게 글을 읽고 이해하는지 생각해봅시다.
예를들어 다음과 같은 문장을 해석해봅시다.
"chatGPT와 Dall-E등이 최근 ML을 연구하는 사람들 사이에서 가장 뜨거운 주목을 받고있다."
사람은 위와 같은 문장을 해석할 때, 문장에 나온 단어들만 가지고 해석하지 않습니다.
실제로는 다음과 같이 해석하게됩니다.
"GPT구조를 사용하는 대규모 언어 생성 모델 chatGPT와 대규모 이미지 생성 모델 Dall-E와 같은 대규모 생성모델이 ML연구원 사이에 인기를 끌고 있구나!"
왜 이런 해석이 가능할까요?
그 이유는 바로 배경지식 덕분입니다.
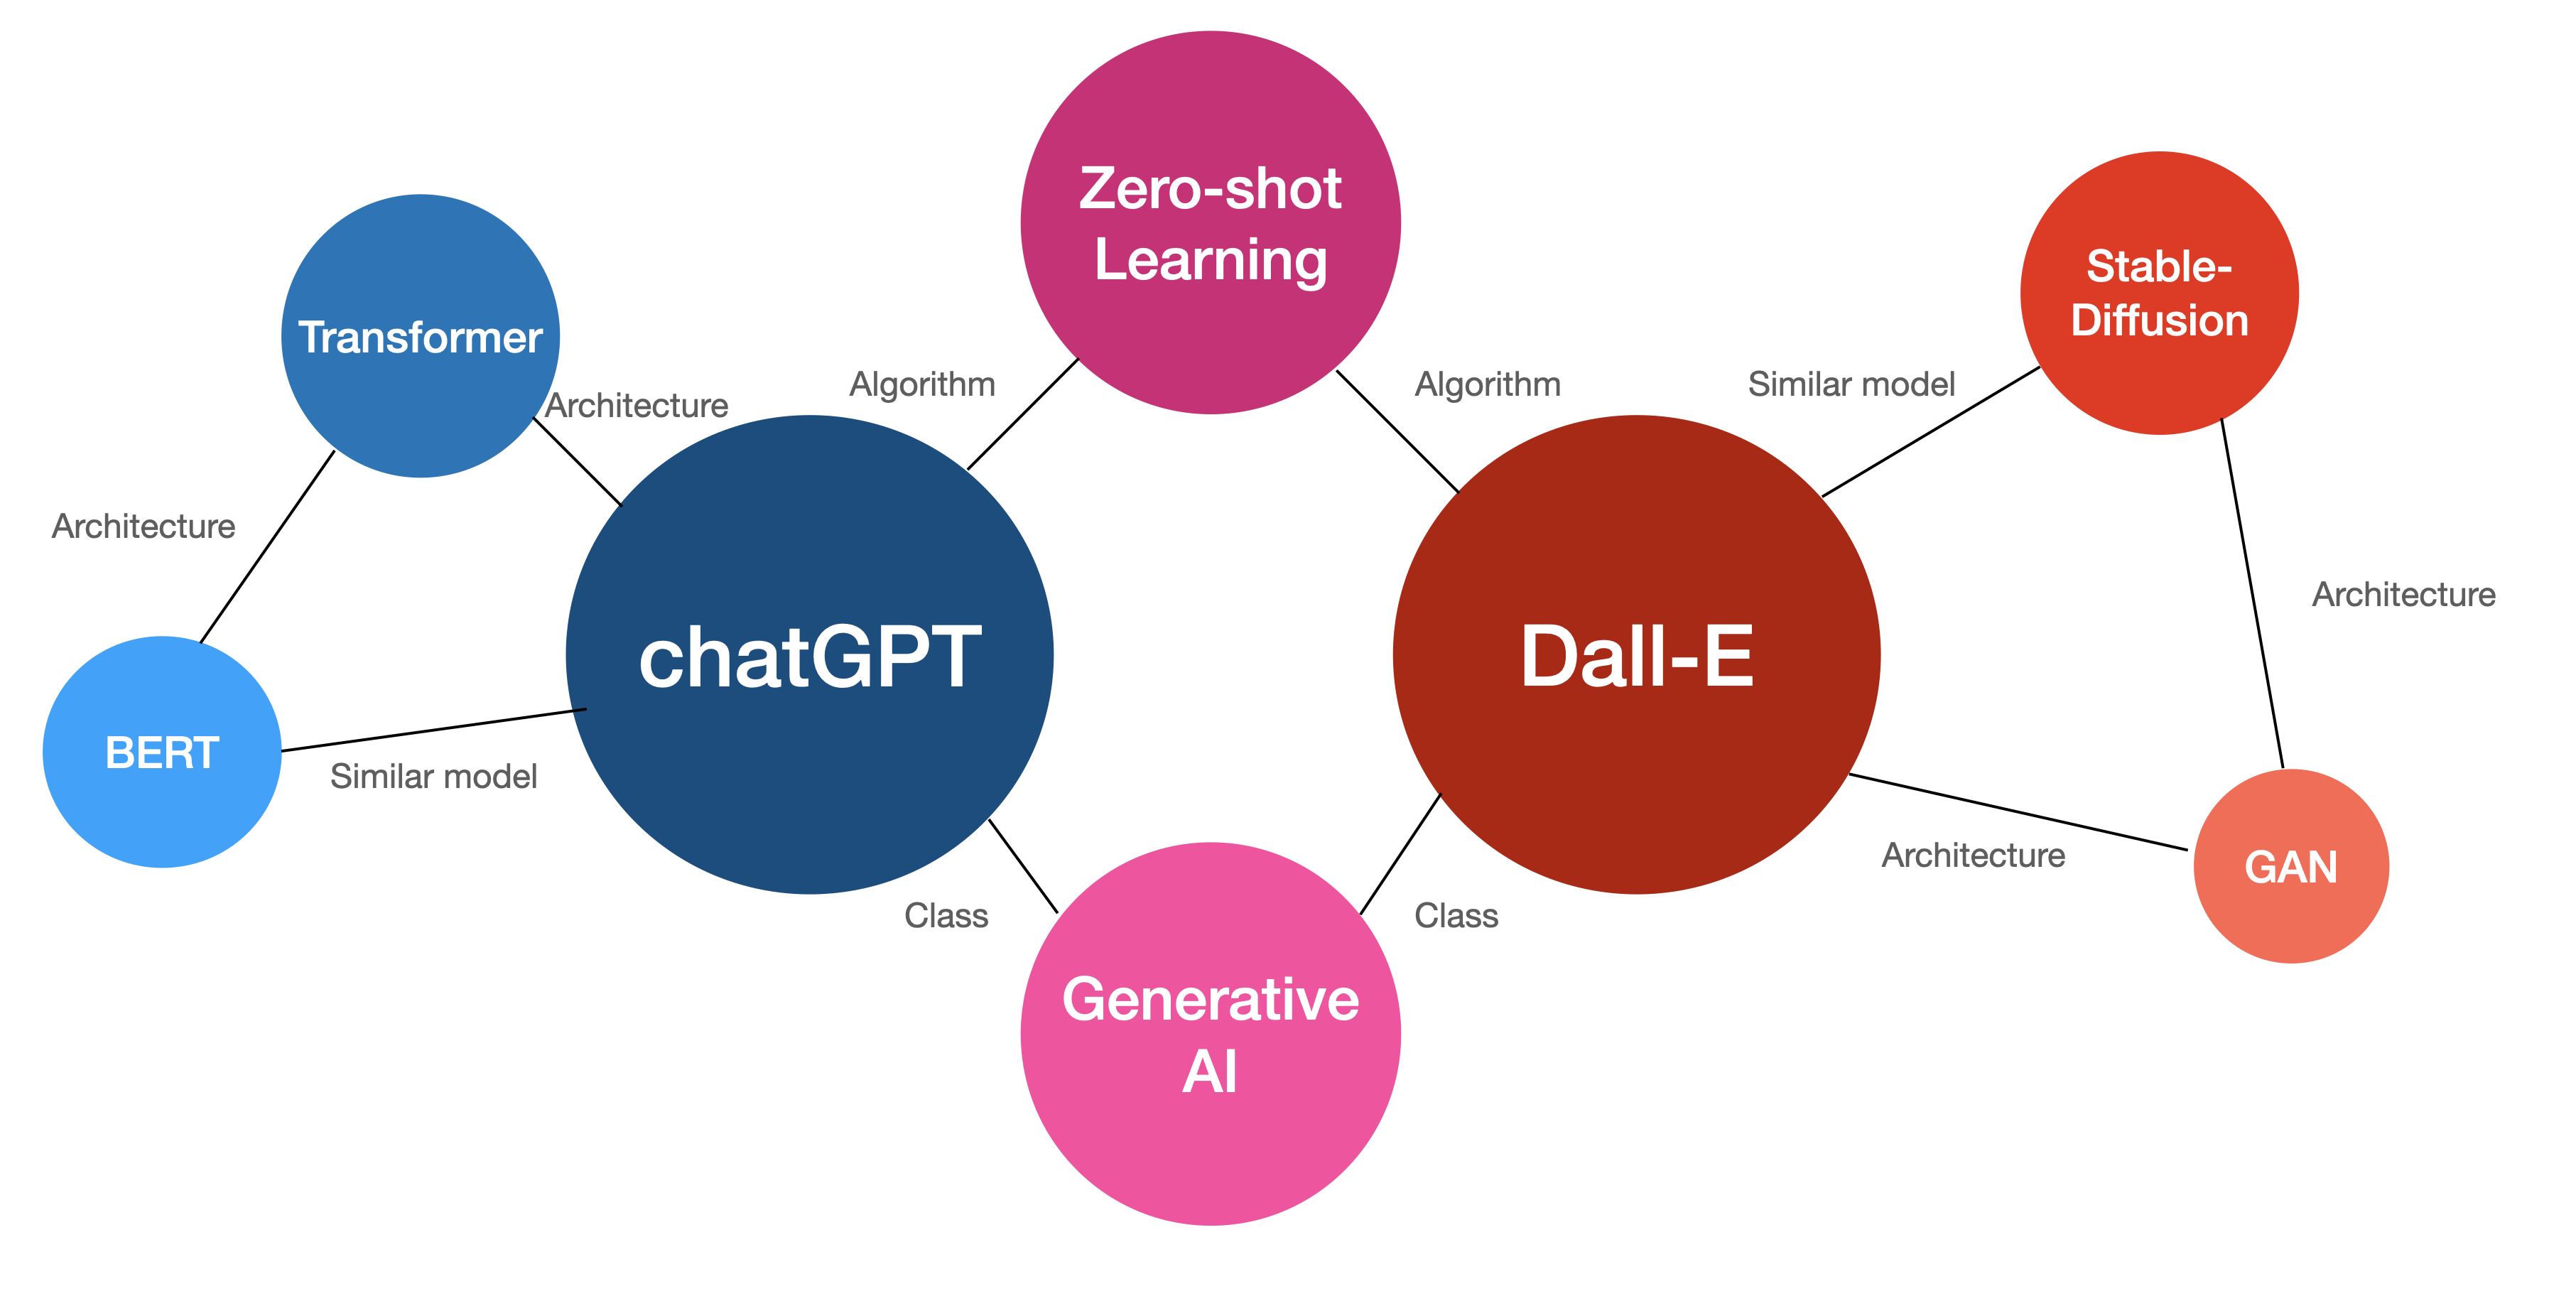
인간은 위와 같은 잘 짜여진 Entity 간, 단어들 간 의미관계를 이미 배경지식으로 가지고 있기 때문에 같은 문장을 보고도 읽고도 조금 더 고차원의 해석이 가능한 것입니다.
컴퓨터는 이렇게 해석하지 못할까요?
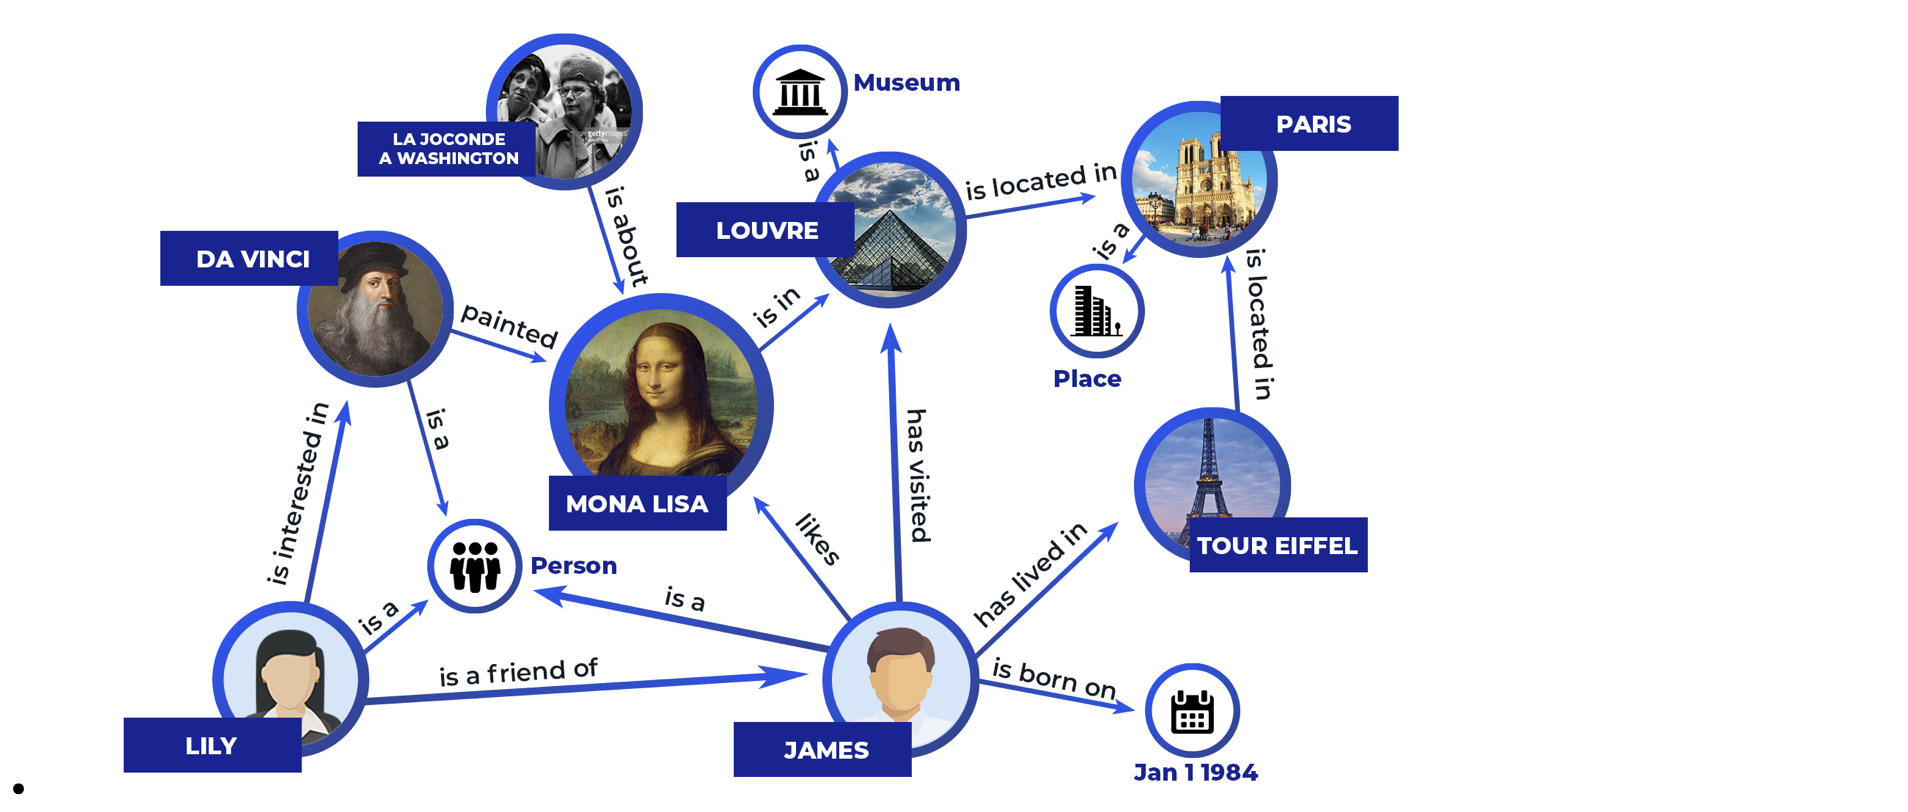
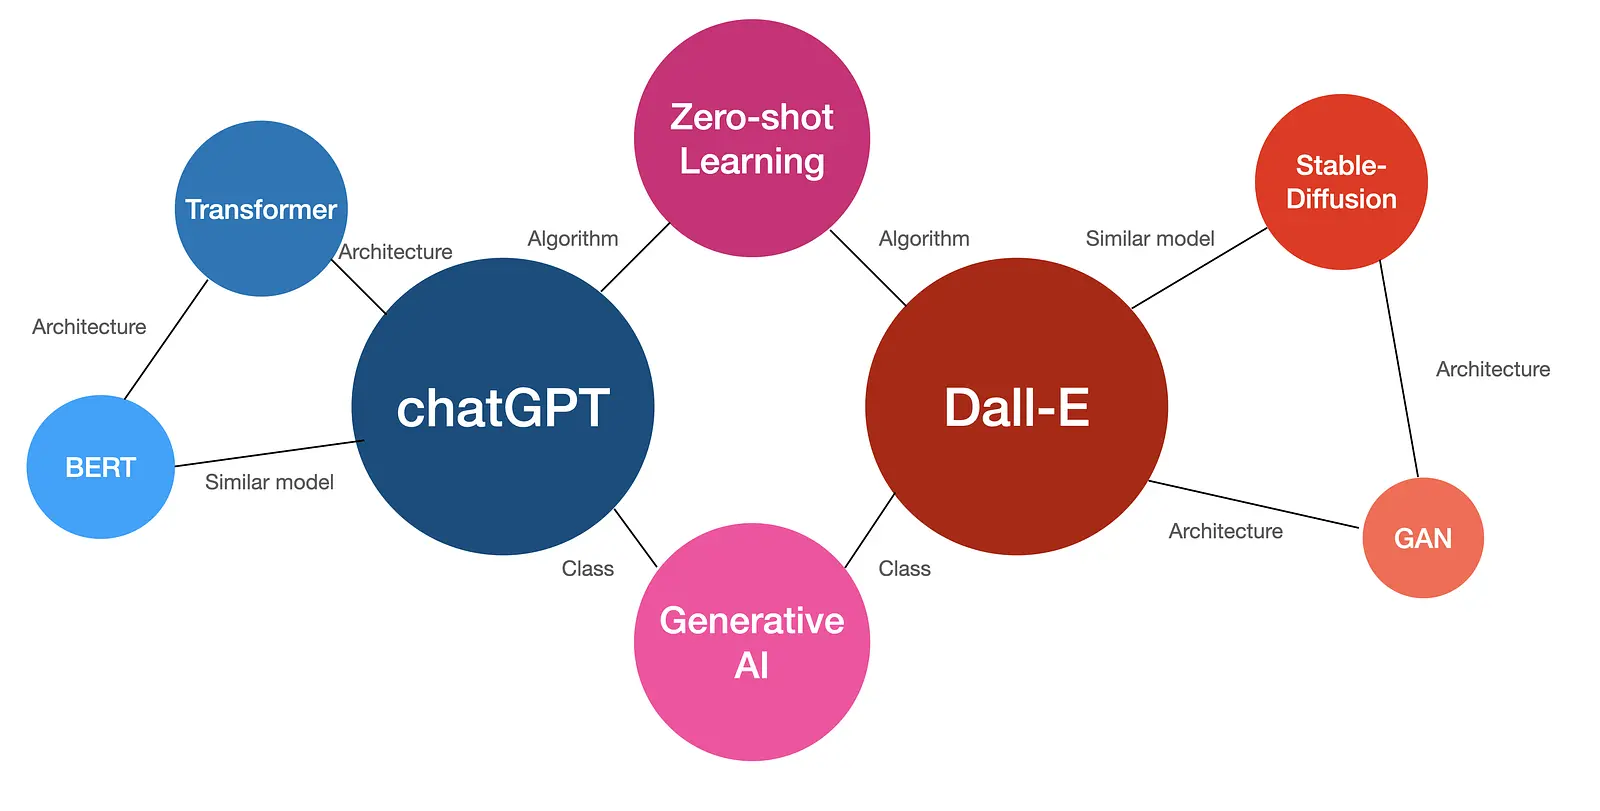
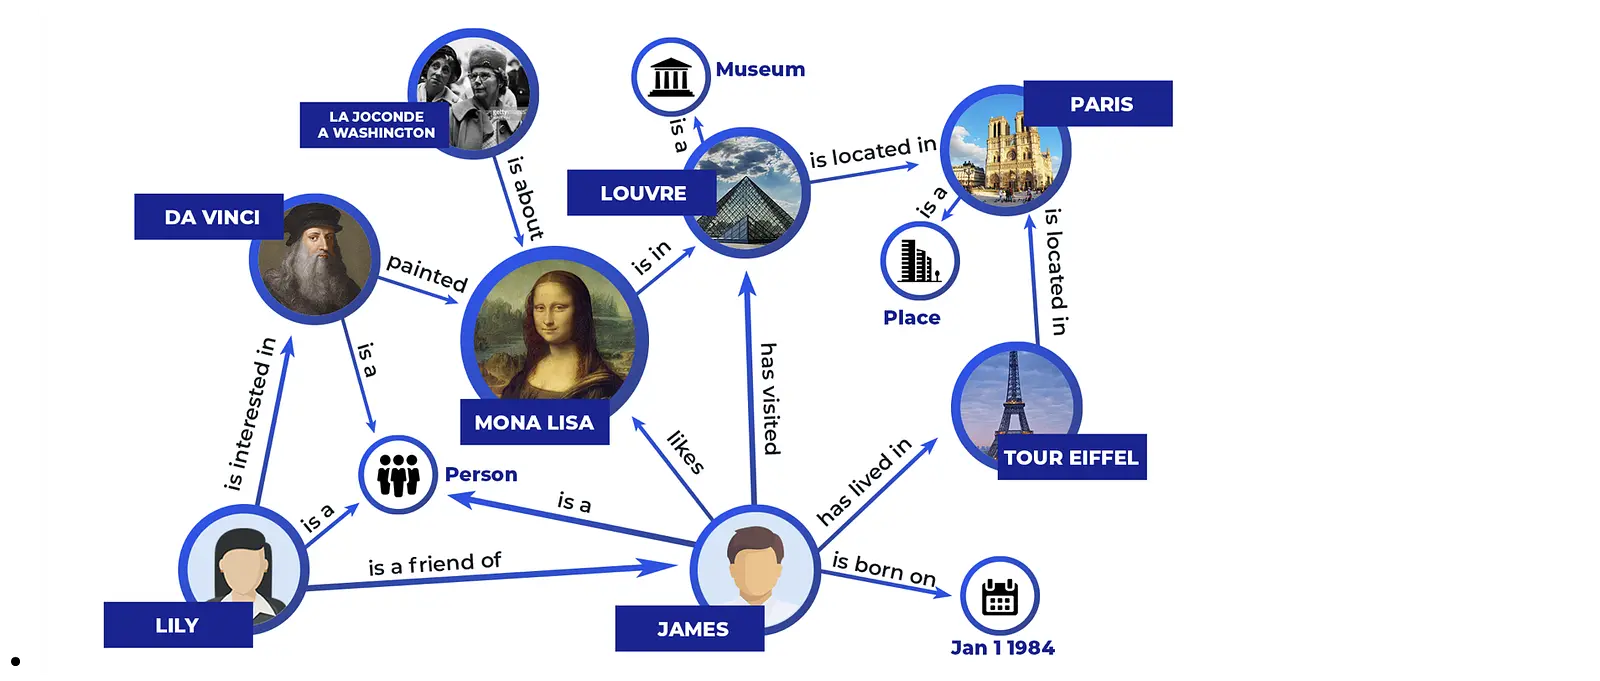
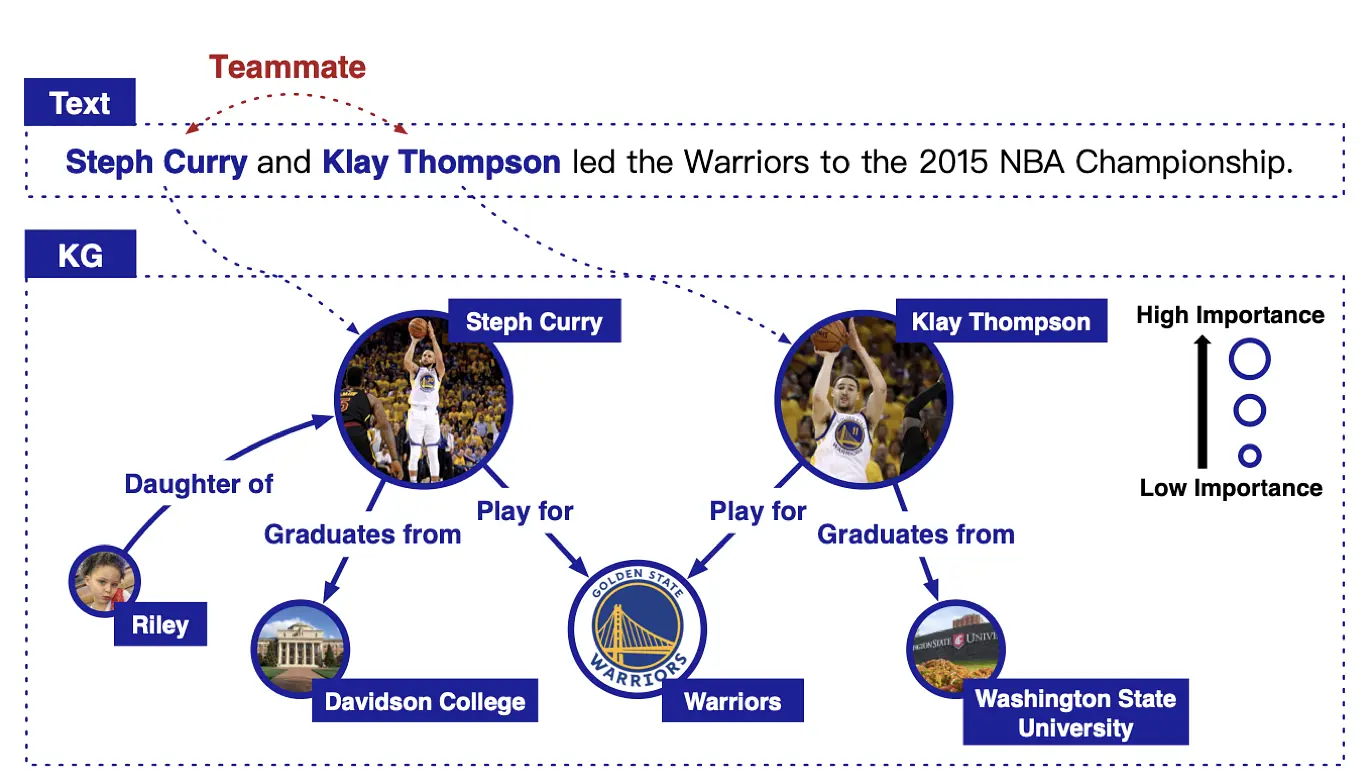
위와 같은 단어들 간의 관계를 나타낸 Graph를 Knowledge Graph, KG라고 불립니다. 이 KG들과 문맥을 파악해주는 Transformer, BERT를 적절히 결합한다면 컴퓨터도 조금은 인간처럼 문장을 읽고 해석할 수 있지 않을까요?
이 생각으로부터 등장한 논문들이 Knowledge Enhanced Pre-trained Language Model입니다.
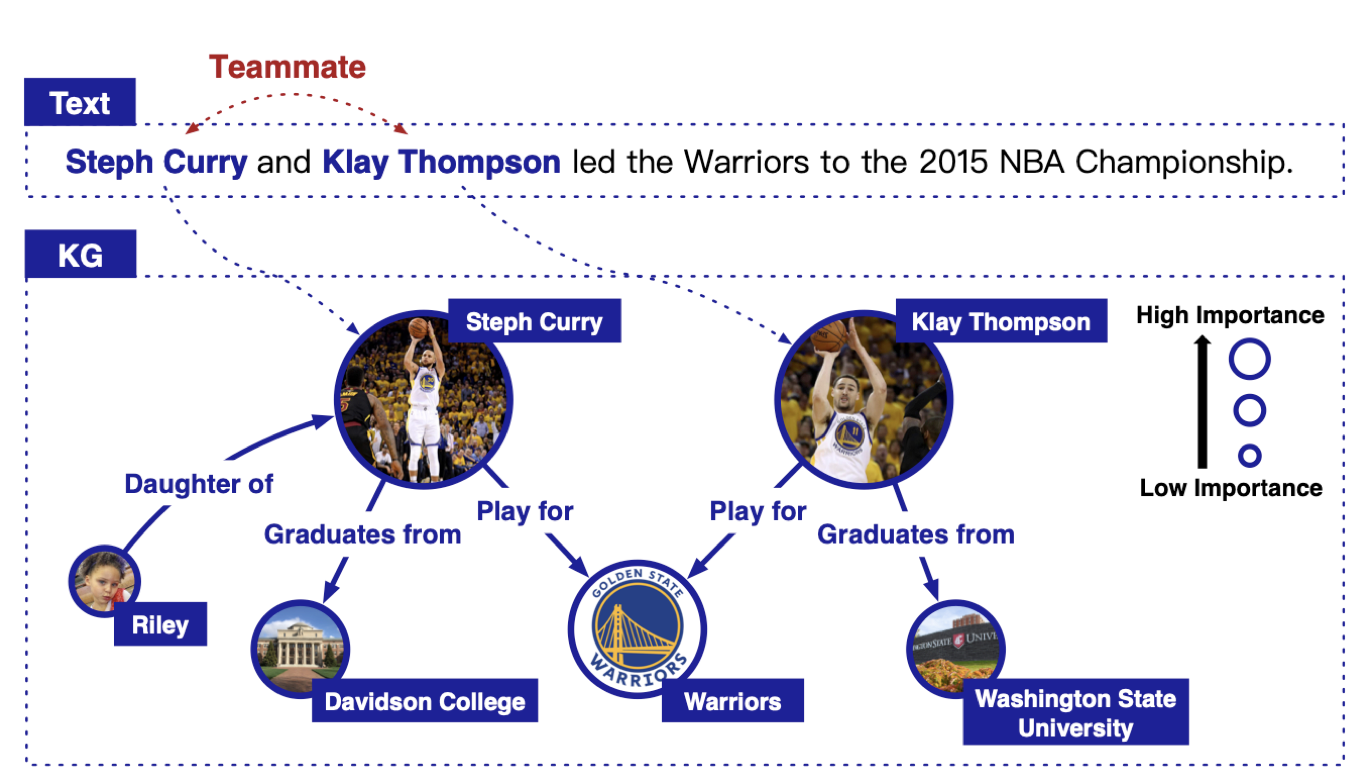
cokeBERT 논문에서도 적극적으로 reference로 활용하고 있는 ERNIE와 K-BERT, K-Adapter등이 등장했죠.
하지만!
위 논문들에서는 작은 문제들이 있었는데, 우선 ERNIE!
ERNIE는 KG를 BERT와 결합하는 모델이기는 하지만, TEXT 표면에 들어난 Entity 정보만 가지고 그래프 관계를 해석합니다. 만약에 "chatGPT와 Dall-E등이 최근 ML을 연구하는 사람들 사이에서 가장 뜨거운 주목을 받고있다."라는 문장이 들어오면 표면상 들어난 chatGPT, Dall-E 등과 같은 Entity Node 사이의 관계만 고려하기 때문에, Transformer, GAN과 같이 Entity Node로 부터 그래프상 edge(간선)의 개수가 2개 이상으로 떨어진 Node의 단어는 고려하지 못하는 문제점이 있었습니다.
ERNIE를 적용한다면 세부 내용까지 세세하게 다루는 Aritcle일 경우 표면상에 들어난 Entity Node가 많아서 KG에서 유의미한 관계를 분석하여 좋은 결과를 낼 수도 있지만, 짧은 문장일 경우 Text에 들어난 Entity가 부족하여 좋은 결과를 내지 못할 가능성이 큽니다.
K-BERT, K-Adapter의 경우에는 어떨까요?
K-BERT, K-Adapter는 다행히도 표면상에 들어나지 않은 Node들의 관계도 분석합니다. 마찬가지로
"chatGPT와 Dall-E등이 최근 ML을 연구하는 사람들 사이에서 가장 뜨거운 주목을 받고있다."라는 문장을 입력받으면 ERNIE와는 다르게 Transformer, Generative AI, Zero-shot Learning 등의 연관된 Node들을 고려합니다. 하지만! K-BERT, K-Adapter에서는 연관된 Node를 선택할 때, 문맥에 맞게 동적으로 선택하는 것이 아닌, 어떤 문장이 오더라도 Entity가 같으면 같은 Node를 선택하는 정적으로 Node를 선택합니다.
예를 들어 "chatGPT가 윤리적 문제를 일으킬 가능성이 있다."라는 문장을 입력받았다면 치팅, 논문 대필 등과 같은 연관 Node를 선택해야하지만 Transformer, OpenAI와 같은 문맥에 관계가 적은 Node를 선택할 수도 있습니다.
위 모델들이 가지고 있는 단점등을 해결하기 위해서 등장한 모델이 바로 cokeBERT입니다.
ERNIE의 단점을 극복하기 위해서, 표면에 들어나지않은 KGs의 Node도 고려했고, K-BERT의 단점을 극복하기 위해 연관된 Node의 가중치 문맥을 기준으로 부여해서 동적으로 선택을 한 모델이 바로 cokeBERT입니다.
이제 cokeBERT에 관해 자세히 알아볼까요?
위 개념들을 학습하고 읽는다면 훨씬 이해가 쉬울거에요!
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.