Cross-Entropy Cost Function에 대해(학습 속도 저하를 줄이는 솔루션)
출처: 라온피플 아카데미 블로그
신경망(Neural Network) Cost Function으로써의 "Cross-Entropy Cost Function"
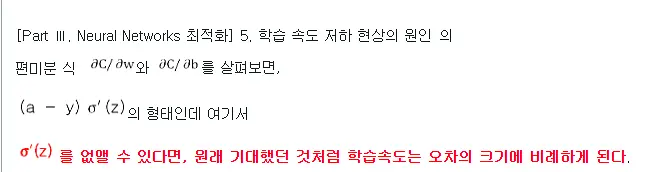
[Part III., Neural Networks 최적화] 5. 학습 속도 저하 현상의 원인에서는 신경망의 학습 속도 저하 현상의 원인에 대해서 살펴보았다.
마치 산 정상에서 공을 떨어뜨리면 경사가 클수록 빨리 굴러 떨어지는 것처럼, 오차가 클수록 학습 속도가 빨라야 할 것 같은데 유감스럽게도 그렇지 못하다.
이것은 신경망의 cost function으로 흔히 사용되는 MSE(평균제곱오차, Mean Square Error)와 활성함수로 Sigmoid 함수를 사용하는 경우, Sigmoid 함수의 특성과 결합하면서 문제가 생기기 때문이다.
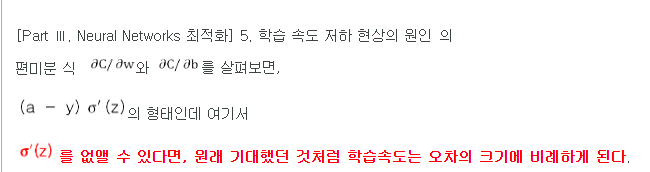
Sigmoid 함수의 미분 값= σ′(z) (MSE가 큰 오차에 민감하게 반응하는 특성을 지니고 있는데 Sigmoid 함수는 극단값을 0과 1에 매우 가깝게 수렴해 학습에 오차가 나는 것이다.)
그렇다면 cost function으로 MSE 방식 대신에 다른 함수를 사용하고 비슷한 효과를 얻을 수는 없는 것일까?
그 주인공이 바로 이번 Class의 주인공인 cross-entropy cost function이다. MSE와 비슷하게 표현하기 위해 ACE(Average Cross-Entropy)라고도 부른다.
Cross-Entropy의 역사
Cross-Entropy라는 다소 괴상한 이름은 1997년 Rubinstein이 희소 사건의 확률을 추정하기 위한 용도로 발표되었는데,
후에 희소 사건뿐만 아니라, 일반적인 조합 최적화(combinatorial optimization)에도 적용이 가능하다는 것이 밝혀지면서 널리 쓰이게 되었다.
원래 엔트로피(Entropy)는 클라우지우스가 열역학 제2의 법칙, 즉 “열은 높은 온도에서 낮은 온도로만 흐른다”는 것을 설명하기 위해 고안된 개념이지만, 1877년 볼츠만에 의해서 확률적인 방법으로 새롭게 정의되었으며, 열과 관계 없는 자연 현상도 설명할 수 있게 되었다.
현재는 분야를 가리지 않고 쓰이는 용어가 되었으며 (심지어는 철학에서도), 자연의 변화와 방향을 가리킬 때 사용된다.
특히, 신경망(Neural Networks)에서 Cross-Entropy는 손실 함수로 활용되어 모델이 예측한 확률 분포와 실제 값 사이의 차이를 계산하는 데 사용됩니다. 이는 모델이 얼마나 잘 예측하고 있는지 평가하는 데 중요한 역할을 합니다.
신경망에서의 Cross-Entropy의 활용
Information theory에서 엔트로피는 확률분포의 무작위성(randomness)을 설명하는 용도로 사용이 되며,
확률분포 p를 갖는 랜덤 변수 X를 표현하기 위한 최소의 비트 수를 나타내며 아래와 같이 표현된다.
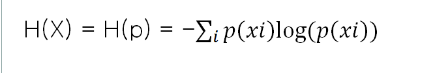
Cross-Entropy는 2개의 확률 분포의 차이를 나타내는 용도로 정의가 되었다.
이 이름이 생소하다면, cross-correlation의 개념을 연상해보면 좋을 것 같다.
Cross-correlation은 두개의 함수와의 correlation 관계를 나타낼 때 사용이 된다.
반면에 CE(Cross-Entropy)는 두개의 확률 분포가 얼마나 가까운지 혹은 먼지를 나타내며,
2개의 확률 분포 p(x)p와 m(x)에 대한 CE는 아래와 같이 나타난다.
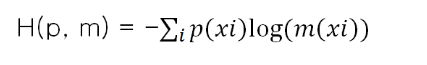
위 식에서 p와 m이 같다면, Entropy와 식이 같아진다는 것을 알 수가 있다.
즉, 차이가 클수록 값은 많이 나오고, 두 개가 같아질 때 최소한의 값이 나온다.
위 수식을 잘 생각을 해보면, cost function처럼 기대값과 실제 연산값의 차가 클수록 큰 결과가 나오고,
항상 양의 값이기 때문에 cost function으로 사용이 가능함을 알 수 있다.
Cross-Entropy 수식의 의미:
이 수식은, 여러 예측 값들이 실제 값과 얼마나 차이가 나는지를 계산하고, 그 차이를 크게 부각시켜서 학습에 반영합니다. 예측이 틀릴수록 오차가 더 커지고, 맞으면 오차가 작아져서, 모델이 더 잘 예측할 수 있도록 돕습니다.
시그마 기호: 여러 예측 값을 모두 더해서 전체적인 오차를 구합니다.
로그 함수: 예측이 틀렸을 때, 그 틀린 정도를 강조해서 더 큰 오차로 반영합니다.
Cross-Entropy는 최종적으로, 모델이 얼마나 잘 예측했는지를 평가하는 방법이며, 틀릴수록 더 큰 패널티를 줍니다.
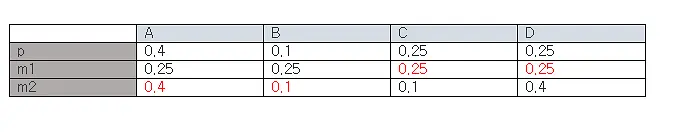
다음의 간단한 예를 보자.
랜덤 변수 X의 실제 분포가 p이고,
이것을 m1과 m2로 추정할 경우라고 하면, 어느 것이 더 좋은 추정일까?
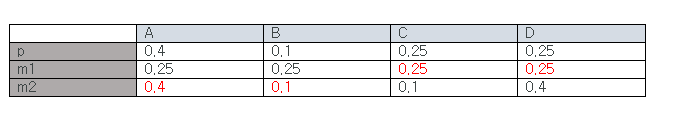
겉보기에는 별 차이가 없어 보이지만,
Cross-Entropy를 구하여 수치적 관점에서만 살펴보자.
그럼, Entropy H(p) = 1.8601이고, Cross-entropy H(p, m1) = 2.01, H(p, m2) = 2.0201다.
결과만 놓고 본다면, m1이 좀 더 좋은 추정이 된다.
MSE보다 CE CostFunction이 속도는 빠르지만 학습효과의 측면에선 아직 모르겠다.
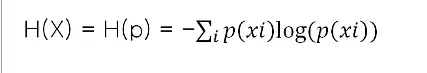
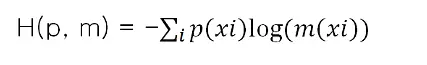
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.