Overfitting 과적합
출처: 라온피플 아카데미 블로그
Supervised Learning을 위한 훈련 데이터
통계에서 좋은 결과를 얻으려면, 표본조사를 할 때 전체를 대표할 수 있는 우량한 샘플을 취하고, 그 샘플들로부터 전체를 잘 설명할 수 있는 모델을 만들어야 한다.
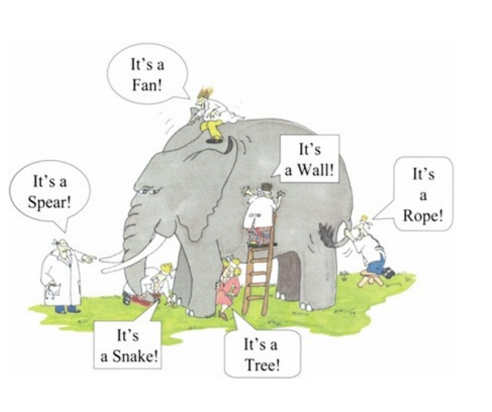
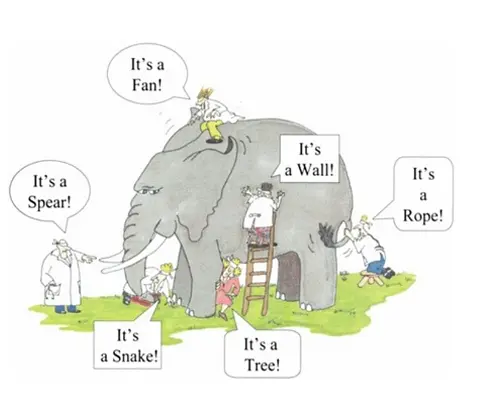
전체를 대표할 수 없는 치우친 샘플을 얻게 되면, “장님 코끼리 만지기”처럼 엉뚱한 결과를 초래할 수도 있다.
마찬가지로 지도학습(supervised learning)을 사용하는 기계학습법에서도 선택한 학습 알고리즘뿐만 아니라 학습을 위한 훈련 데이터(training data)의 질에 따라 학습의 결과가 좌우된다.
Overfitting이란 통계나 기계 학습에서 사용되는 용어로서, 제한된 샘플(혹은 훈련에 사용한 한정된 데이터)에 너무 특화가 되어, 새로운 샘플에 대한 예측의 결과가 오히려 나빠지거나 학습의 효과가 나타나지 않는 경우를 말한다.
우리말로는 "과적합"이라는 용어로 번역이 되기도 하는데, 좀 어색한 것 같다. Overtraining과 같은 의미로 사용되기 때문에 개인적으로는 "과학습"으로 번역하는 편이지만, 오십보 백보인 것 같다.
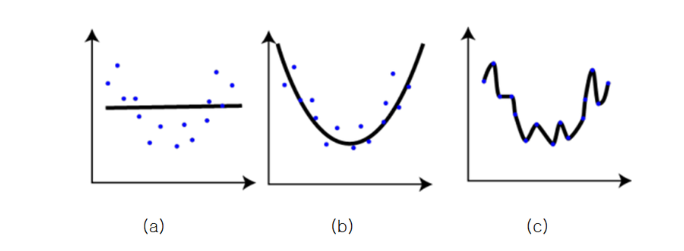
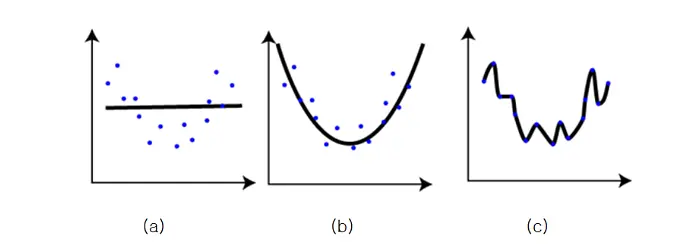
위 그래프는 Overfitting을 설명할 때 흔히 사용하는 그림이다. 그림에서처럼 파란색의 점들이 있을 때, 그 점들을 대표하는 곡선을 추정하는 경우를 상상해보자.
왼쪽 그림 (a): 직선으로 단순하게 추정한 경우, 몇몇 보기에도 오류가 많음을 알 수 있다.
오른쪽 그림 (c): 모든 점들을 그대로 살려 추정한 경우이다 하지만 새로운 데이터가 들어왔을때 예측 능력이 떨어진다.
가운데 그림 (b): 주어진 점들의 특성을 잘 나타낸다. 모든 점들을 그대로 살리진 못했지만, 새로운 데이터가 들어왔을때 예측능력이 c보다 뛰어날 것이다.
Overfitting을 해결하는 방법 ?
그렇다면, 어떻게 예측하는 것이 최적의 결과를 도출해 낼 수 있을까? 즉, Overfitting의 문제에서 벗어날 수 있을까? 결론부터 말하면, 정답은 없다. (c)가 올바른 추정일 수도 있고, (b)가 올바른 추정일 수도 있다. 결과적으로는 샘플의 수를 늘리거나 훈련 데이터의 양을 늘리는 것이 정답일 것이다.
하지만 데이터의 양을 늘리는 것은 결과적으로 많은 비용과 노력이 필요하기 때문에 여러 가지 대안이 제시되고 있다.
흔히 적용되는 방법이 “Occam's Razor(오캄의 면도날)” 방법이다.
14세기 영국의 신학자이자 논리학자인 오캄의 저서에 등장하며, 중세의 철학자와 신학자들이 복잡한 논쟁을 배제시키자는 뜻에서 설명이 더 복잡한 이론은 배제할 때 흔히 사용이 된다. 물론 항상 진리는 아니지만, 필요성 없는 개념을 배제하라고 한 “사고 절약의 원리”라고도 불리며, 같은 현상을 설명하는 두 개의 주장이 있다면 간단한 쪽을 선택하라고 한다.
그래서 간단한 쪽을 c와 b중에 선택하라고 하면 당연 b일것이다. 필요성 없는 개념들 즉 데이터들을 배제한 것이다.
댓글
로그인 후 댓글을 남길 수 있습니다.
최근 찾아본 내용 중에 ‘자연스러운 행동’은 에너지가 거의 소모되지 않기 때문에, 강제할 필요가 없다고 하더라고요. 그와 반대로 ‘효도’는…