GPT, 뤼튼으로 한글 데이터 카테고라이징 머신 러닝 하기
3시간동안 GPT 4.0, 뤼튼과 함께 작업한 산출물입니다.
GPT를 통해 많이 부족하지만 빠르게 지식을 습득한 케이스입니다.
비슷한 주제의 한글 데이터를 카테고리로 묶는 방법을 물어보았고 비 개발자인 저는 구글 코랩에서 파이썬 언어로 작업되었습니다.
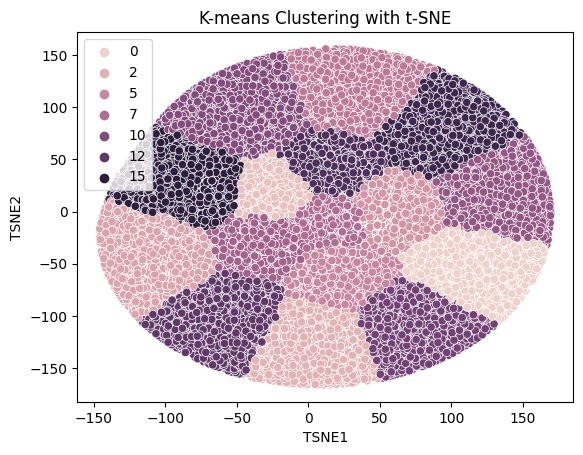
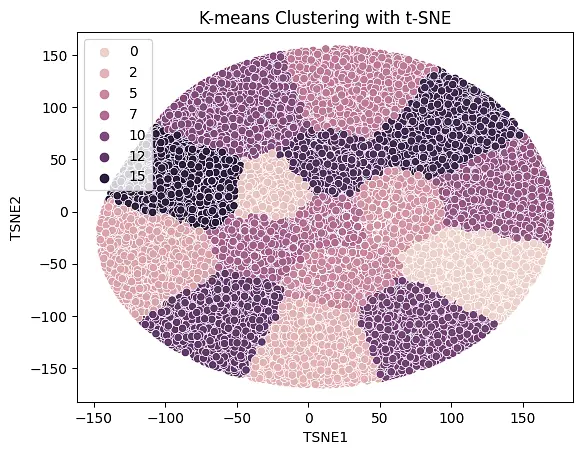
4만개의 한글 데이터를 2차원으로 축소한 후 K-평균 군집화를 적용하고 그 성능을 평가하고 있습니다. 차원 축소는 t-SNE를 사용하였고, 데이터를 군집화 하는데는 K-평균 알고리즘이 사용되었습니다.(저는 뭔 뜻인지 모릅니다.)
t-SNE(T-distributed Stochastic Neighbor Embedding)는 고차원 데이터를 저차원(여기서는 2차원)으로 변환하는 기법입니다. 이런 기법은 주로 고차원 데이터를 시각화할 때 사용됩니다.
K-평균(K-Means)은 주어진 데이터를 K개의 클러스터로 묶는 알고리즘으로, 각 클러스터와 거리 차이의 분산을 최소화하는 방식으로 동작합니다.
결과에 대해 해석하자면,
실루엣 점수(Silhouette Score): 클러스터링의 품질을 측정하는 지표로, 1에 가까울수록 클러스터링의 품질이 좋다는 것을 의미합니다. 학습 데이터셋의 실루엣 점수는 약 0.342, 테스트 데이터셋의 실루엣 점수는 약 0.341로, 클러스터링의 품질이 적절하다고 할 수 있습니다.Silhouette Score: 이 지표는 -1에서 1 사이의 값을 가집니다. 이때, 1에 가까울수록 클러스터 내의 샘플들이 얼마나 밀접하게 모여 있는지를 나타내며, 이는 잘 구성된 클러스터를 의미합니다. 반면에, -1에 가까울수록 샘플들이 클러스터에 잘못 배정되었다는 것을 의미합니다. 0에 가까울 경우, 클러스터 오버랩이 있을 가능성이 있습니다. 보통 0.5 이상의 값이면 괜찮은 클러스터링 결과로 볼 수 있습니다. 여기서 Silhouette Score가 0.34정도로 그리 높지 않습니다. 이는 클러스터 간의 분리가 그리 잘 이루어지지 않았다는 것을 의미할 수 있습니다.
Davies-Bouldin Index: 이 지표는 클러스터의 분산과 클러스터 간의 거리를 기반으로 클러스터링의 품질을 측정합니다. 값이 낮을수록 클러스터링의 품질이 좋다는 것을 의미합니다. 0에 가까운 값이 이상적이지만, 일반적으로 1 이하면 양호한 결과를 나타내는 것으로 간주됩니다. 여기서 Davies-Bouldin Index가 0.81로 1 이하이므로, 클러스터링이 양호하게 이루어졌다고 판단할 수 있습니다.
원하는 캠핑 장소에 캠핑 용품 대여, 설치, 반납, 청소 올 인원 서비스
댓글
로그인 후 댓글을 남길 수 있습니다.
AI 활용 방법에 대해 공부하는 중이신 걸까요?
네 맞아요! AI를 통해서 빠르게 습득할 수 있는 하드 스킬을 공부하고 있어요.