실리콘밸리 개발썰

실리콘밸리 개발썰

실리콘벨리 테크 회사들의 개발 문화 탐방

공개 10 멤버

가이드라인

["개발 이야기를 나눠보아요 :) "]

이다니엘

이다니엘

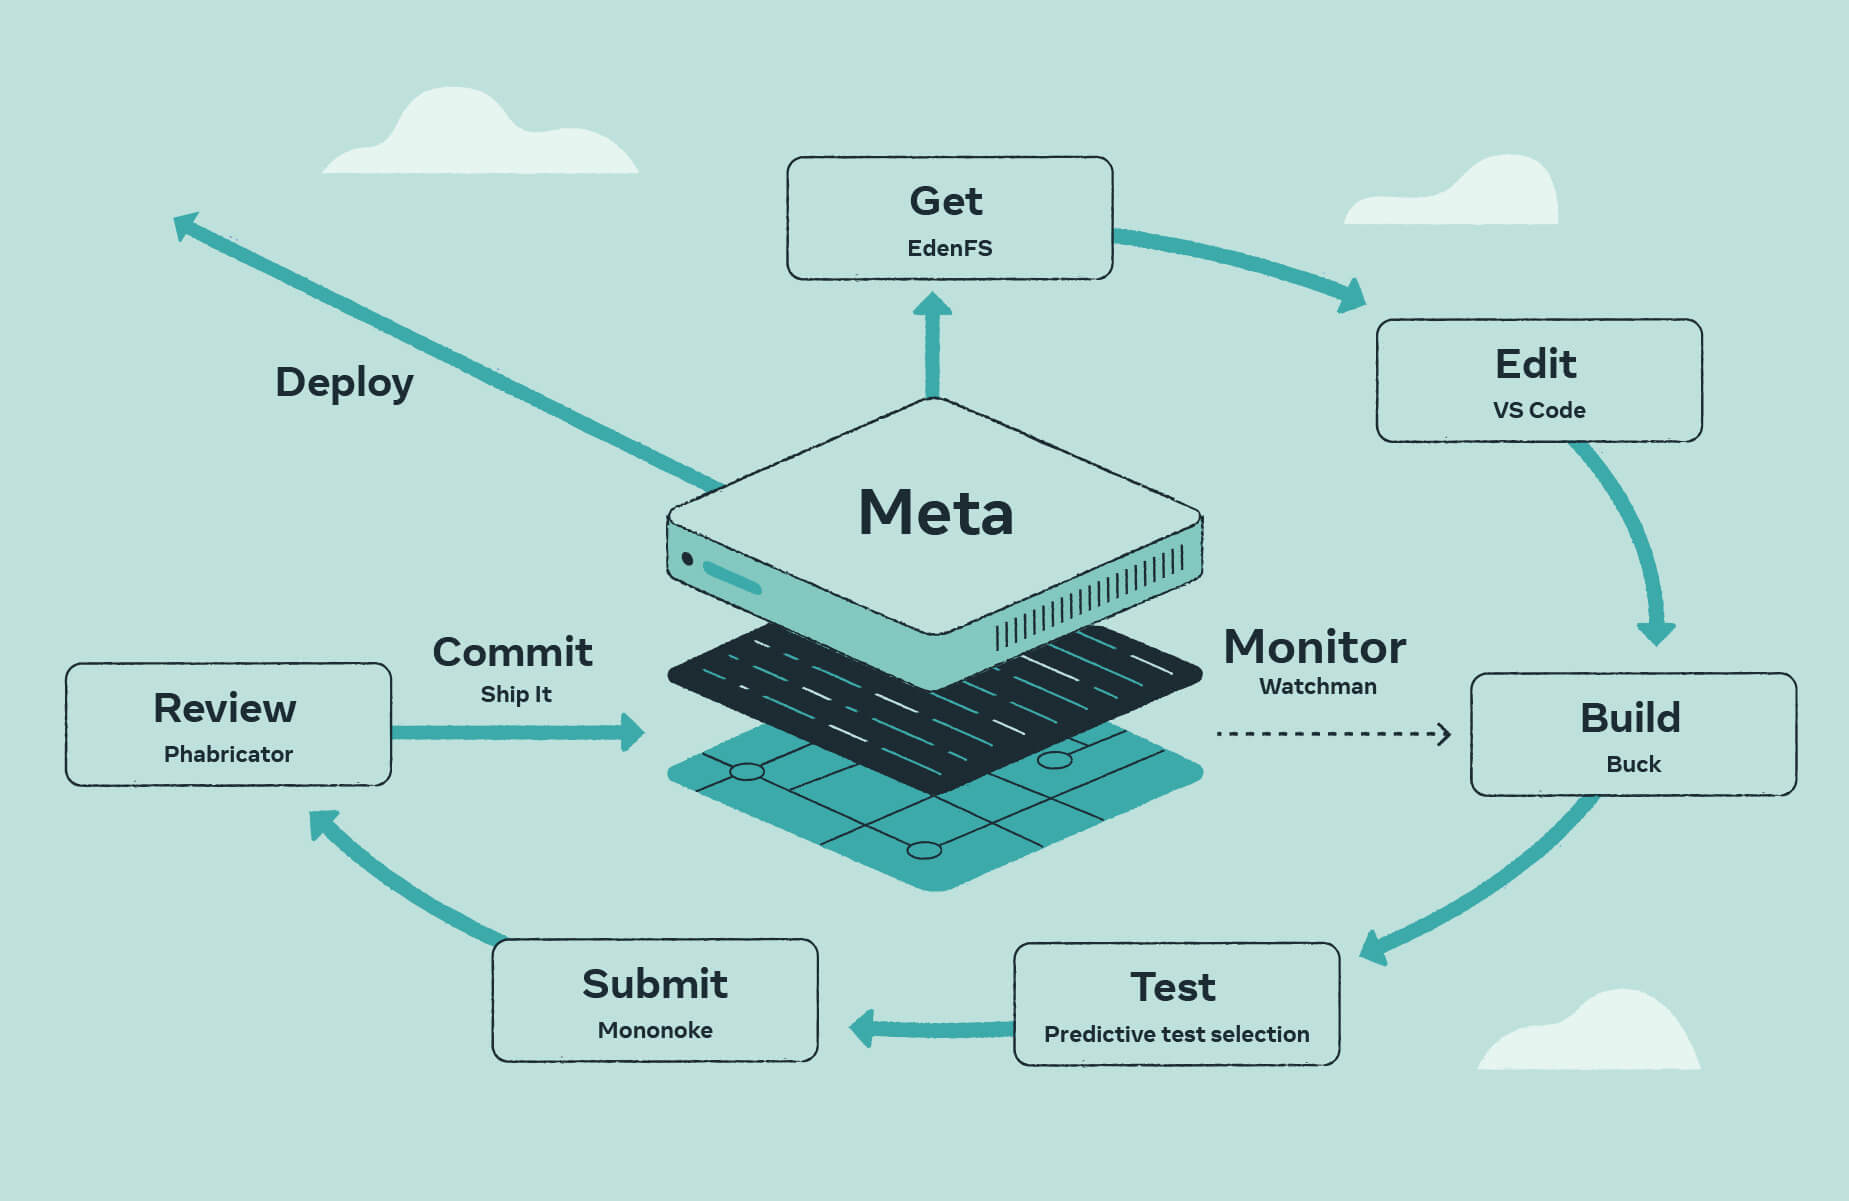
몇 천 명의 Meta 개발자들의 생산성을 책임지는 개발 도구들

Sapling: Meta에서 직접 개발한 버전 관리 시스템. GitHub이 대중화 한 Branch/Pull Request 모델이 아닌 Commit/Stacked Change로 코드를 리뷰하고 가꾼다. 또 Sapling의 virtual file system을 활용해 Meta의 거대한 모노리포에 있는 수억 개의 파일을 효과적으로 수정할 수 있다고 한다.

https://sapling-scm.com/


Buck2: Meta에서 사용되는 모든 프로그래밍 언어를 지원하는 통합 빌드 시스템. 수천 개의 빌드 머신과 리모트 캐슁을 활용하여 Meta의 제품들을 지탱하는 대규모 서버의 빌드를 빠르게 처리해준다.

https://buck2.build/


Infer/RacerD/Jest: Java/C++/Objective-C 코드의 버그를 찾아주는 정적 분석 도구 Infer, 동시성 코드에서 발생하는 문제를 해결해주는 RacerD, 그리고 유명한 JS 테스트 프레임워크인 Jest!

https://fbinfer.com/


놀랍게도 위에 언급된 도구들은 모두 Meta에서 오픈소스로 공개되어 누구나 사용해 볼 수 있다. 우리 팀도 Meta의 개발툴을 채택해 보는 것도 재미있것 같다.
url thumbnail

Meta developer tools: Working at scale

Developers at Meta use a number of tools in their workflows, many of which are open source so you can try them yourself.

https://engineering.fb.com/2023/06/27/developer-tools/meta-developer-tools-open-source/

5
0
이다니엘

이다니엘

Discord팀이 조 단위 메세지를 Cassandra DB에서 ScyllaDB로 이전해 성능과 안정성 두마리 토끼를 다잡은 썰

Discord는 매일 수백만의 유저가 작성하는 수십억의 메시지를 저장한다. 누적 조 단위의 메시지를 저장하기 위해 Discord 개발팀은 어떤 DB 기술을 사용할까?


→ Discord 개발팀이 처음 선택한 DB는 MongoDB였다. 하지만 시간이 지나 유저와 데이터 양이 가하급수적으로 늘며 MongoDB의 한계를 느끼고, Cassandra로 전환하게 되었다.


→ Cassandra 클러스터가 150개 이상의 노드로 커지면서 운영과 성능 문제가 많이 발생했다. 특히, 특정 노드에서 쿼리가 몰리는 문제 (hot partition)가 발생 시 개발자가 직접 노드를 조정해야 하는 번거로움이 생겼다.


→ 이런 상황에서 Discord 팀은 Cassandra와 호환되는 ScyllaDB의 발전을 주목하게 되었다. Discord 개발팀이 저장하는 메시지 이외의 다른 데이터를 새로운 ScyllaDB 클러스터로 이전하면서 그 성능과 안정성을 검증했고, 만족스러운 결과를 얻었다.


→ 하지만 가장 큰 데이터인 메시지를 ScyllaDB로 이전하기 위해서는 많은 준비 작업이 필요했다. 그 중 가장 중요한 요소는 "Data Service"의 개발이었다. Discord 팀이 선호하는 Rust로 작성된 이 서비스는 DB의 부하를 줄이기 위해 데이터 요청을 병합하는 (request coalescing)등 여러 기술을 적용했다.


→ "Data Service"의 개발로 hot partition 문제에 어느정도 보호를 받게 되었지만, Cassandra의 한계를 (예: GC 튜닝) 계속 느끼게 되었다. 700TB가 넘는 DB를 이전하기 위한 프로그램을 새로 작성하고(Rust!), 약 10일간의 작업 끝에 모든 데이터를 ScyllaDB 클러스터로 이전하는데 성공했다.


→ 170개가 넘는 노드를 가진 Cassandra 클러스터에서 70개 조금 넘는 노드를 가진, 더 효율적인 ScyllaDB 클러스터로 전환하며, 장애 발생 빈도가 줄었고 쿼리 성능도 개선되었다. 개발팀은 1년이 지난 지금까지도 아주 만족하고 있다고 한다.


https://discord.com/blog/how-discord-stores-trillions-of-messages

8
2
이다니엘

이다니엘

Cloudflare SRE팀이 초당 45M HTTP 요청을 처리하는 ELK 스택 로그 시스템을 Clickhouse로 교체한 썰

Cloudflare 플랫폼은 초당 45,000,000개 이상의 HTTP 요청을 처리한다 🤯


모든 HTTP 요청마다 하나씩 뽑히는 로그를 처리하는 대규모 서비스의 로그 분석 시스템은 어떻게 운영될까?


Cloudflare는 오래동안 Elasticsearch-Logstash-Kibana (ELK) 스택을 이용해 로그 분석 시스템을 구축해왔다. 하지만 엄청 큰 Elasticsearch 클러스터를 관리하면서 다음과 같은 문제들을 겪었다고 하는데:


→ 로그 데이터처럼 고정된 스키마를 지정하기 어려운 비정형 데이터를 Elasticsearch에 저장할 때 클러스터의 메모리 사용량과 쿼리 성능 중 하나는 피해를 입게 된다. Cloudflare이 요구한 스케일에서 이 문제는 심각했다.

→ Elasticsearch는 멀티테넌시 (multi-tenancy)를 지원하지 않아서, 로깅 시스템을 악용하는 한 사용자가 모든 사용자의 경험을 해칠 수 있었다. 이를 방지하기 위해 상당한 노력이 필요했다.

→ 대형 Elasticsearch 클러스터를 운영하는 것은 (당연히!) 매우 힘들다. 특히 불안정한 클러스터를 복구하는 작업은 정말 복잡하다. JVM 위에서 실행되는 Elasticsearch는 가비지 컬렉션 튜닝이 필수적이다 (이런 튜닝은 사실상 흑마법과 같다... 🪄)


2022년, Cloudflare의 SRE 팀은 이런 문제들로 인해 운영하기 어려운 Elasticsearch를 컬럼 지향 DBMS인 Clickhouse로 교체하기로 결정했다. Clickhouse로 전환된 새로운 파이프라인은:


→ 특별한 튜닝 없이도 훌륭한 성능을 보여주었고

→ 운영은 Clickhouse의 스케일링 모델 덕분에 훨씬 간단해졌고

→ 새로운 데이터 모델과 압축 도입으로 인해 디스크 사용량이 90% 감소했다!


Clickhouse를 글을 자주 보인다고 느꼈는데, 이미 Cloudflare같은 큰 기업에서 성공적으로 도입한 기술인지는 몰랐다. 꼭 한번 써볼 기회가 있으면 싶다!

url thumbnail

Log analytics using ClickHouse

When a request at Cloudflare throws an error, information gets logged in our requests_error pipeline. The error logs are used to help troubleshoot customer-specific or network-wide issues

https://blog.cloudflare.com/log-analytics-using-clickhouse/


5
0
ki hyun Lee

ki hyun Lee

클럽에 가입해주셔서 감사해요! 인사이트를 공유하고 소통하는 클럽을 만들기 위해 간단한 소개를 부탁드려요 :)

안녕하세요 저는 현재 경산에서 비인가 대안학교에 재학중인 풀스택 웹 개발자 이기현이라고 합니다.

  • 어떤 제품을 만들고 계신가요 ?

현재 만들고 있는 제품은 Roles라는 제품으로 내가 좋아하는 웹툰, 웹소설이 영화나 드라마로 제작되면 어떻게 될까? 라는 컨셉으로 시작되는 가상캐스팅 커뮤니티입니다.

  • 클럽에 참여하는 이유/목적을 알려주세요!

내년이면 미국으로 유학을 가게 되는데 실리콘 밸리와 관련된 정보들을 듣고 싶어서 참여하게 되었습니다!

  • 현재 고민인 점이 있나요 ?

앞으로의 진로, 진학 등에 관련해서 어떻게 해야할지 고민이 있습니다. 미국 개발자로 취업할 수 있다면 좋겠네요.. ㅋㅋ

7
0
이다니엘

이다니엘

Figma 개발팀이 XXTB 용량의 DB를 다운타임 없이 이전한 썰

이미 AWS에서 제공하는 가장 큰 서버로 Postgres DB 서버를 몇 대나 돌리고 있었지만, 매년 3배씩 늘어나는 서비스 트래픽 때문에 궁지에 몰린 Figma팀의 개발 일지.


관전 포인트:

→ 2020년 Figma의 기업 가치는 2조달러가 넘는 시점. Figma는 이 시점까지도 "엄청 큰 DB" + read replica로 서비스를 지탱할 수 있었다. 우리는 가끔 "엄청 큰 SQL DB"가 감당할 수 있는 트래픽을 과소 평가 하는 것 같다.

→ Horizontally Scalable한 DB 기술을 채택하는 대신 디비를 여러 도메인으로 쪼개는 방법을 채택했다.

→ 솔루션을 채택하고, 마이그래이션을 실행하는 모습이 인상깊다. 정확이 어떤 솔루션이 필요한지, 고안한 솔루션의 오차 범위는 어느정도 인지, 점진적으로 데이터를 옴기며 새로 얻은 정보를 어떻게 활용할 것인지. 다 계획대로! 진짜 Software "Engineer" 같다.


url thumbnail

The growing pains of database architecture

How the Figma infrastructure team reduced potential instability by scaling to multiple databases

https://www.figma.com/blog/how-figma-scaled-to-multiple-databases/


9
0