뒤로
Y
mini-swe-agent를 실제 디버깅이나 개발에 써보신 분 있나요?
DeepSWE의 agent harness 비교가 궁금해서 같은 디버깅 과제와 GPT-5.6 SOL High로 직접 돌려봤습니다.
현재 결과는 이렇습니다.
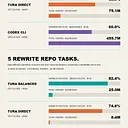
- Codex CLI High: 151.91M tokens, 성공률 60%
- 순정 mini-swe-agent: 70.33M tokens, 성공률 67%
- prompt는 그대로 두고 mini harness에 매크로 실행만 추가: 60.59M tokens, 성공률 78%
이 과제 묶음에서는 순정 mini-swe-agent가 Codex보다 token을 약 54% 적게 쓰면서 성공률은 7%p 높았습니다. 실행 방식만 바꾼 ablation에서도 token이 추가로 약 14% 줄고 성공률은 11%p 올랐습니다.
물론 어떤 저장소에서나 항상 더 낫다는 뜻은 아닙니다. DeepSWE도 system prompt와 평가 방식의 궁합이 격차 일부를 설명할 수 있다고 적었습니다. 그래도 디버깅 위주라면 “bash 하나 + 선형 히스토리”라는 단순한 구조가 꽤 강해 보입니다.
실제 업무에서 버그 수정이나 기능 개발에 써보신 분 계신가요? benchmark 밖에서는 환경 설정, 오래 걸리는 테스트, 권한, patch 품질 중 무엇이 먼저 문제가 됐나요?
- 직접 돌린 결과: https://turaai.net/benchmark
- mini-swe-agent: https://github.com/swe-agent/mini-swe-agent
- DeepSWE 설명: https://deepswe.datacurve.ai/blog/deepswe
공개: 저는 Tura를 유지보수하고 있고, 위 benchmark를 직접 실행했습니다.
Tura
긴 코딩 작업의 수정·빌드·테스트를 매크로로 묶어 LLM 왕복과 전체 비용을 줄이는 오픈소스 실행 레이어
2
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.