AI 답변을 한 번만 재면 왜 틀릴까? 같은 질문 54번 물어본 측정 실험 로그
한 번 재고 끝냈을 때
AI 검색에서 우리 회사가 나오는지 궁금해서, 처음에는 질문 하나를 한 번 물어보고 결과를 적었습니다. 그런데 같은 질문을 다시 넣으면 답이 바뀌는지는 확인한 적이 없었습니다. 한 번 잰 값을 믿어도 되는지 판단할 근거가 없었던 셈입니다. 그래서 오늘(2026년 10월 29일) 오전에는 측정 방식부터 고쳐서 다시 재 보기로 했습니다.
측정 방식을 바꾼 과정
먼저 질문을 쌍으로 만들었습니다. 실제로는 "GEO 대행사 추천해줘"뿐 아니라 "서울 GEO 대행사 추천해줘"처럼 지역명을 붙여 묻는 경우도 있어서, 지역명만 다른 질문 3쌍을 준비했습니다. 바꾼 게 지역명 하나뿐이면 결과가 달라졌을 때 원인을 좁힐 수 있습니다.
그다음 ChatGPT, Perplexity, Gemini에 질문 6개를 3번씩, 모두 54번 물었습니다. 반복이 왜 필요한지는 바로 드러났습니다. ChatGPT는 같은 질문에 한 번은 출처 8개를, 다음 번에는 0개를 달았습니다. 한 번만 쟀다면 "ChatGPT는 출처를 안 단다"고 잘못 적었을 겁니다. 반대로 Perplexity는 같은 질문 3번에 출처 목록을 3번 모두 똑같이 돌려줬습니다. 그래서 Perplexity의 3번은 독립된 3번이 아니라 사실상 한 번의 결과로 읽기로 했습니다.
중간에 막힌 곳도 있었습니다. 처음 보낸 요청은 전부 오류로 돌아왔는데, 엔진마다 받는 옵션이 달라서 한 엔진에 맞춘 설정(웹 검색 강제, 국가 지정)을 다른 엔진에 그대로 넣은 탓이었습니다. 옵션을 엔진별로 나눠 다시 보내 54개를 모두 받았고, 비용은 약 1.4달러였습니다. 브랜드 이름이 나온 횟수를 셀 때는 숫자가 이상하게 높았습니다. 응답에 AI의 중간 추론 텍스트가 섞여 있어서, 사용자가 실제로 보는 최종 답변만 떼어 다시 셌습니다.
나온 숫자
지역명을 붙여도 저희 회사가 답변에 나온 횟수는 27번 중 5번으로 같았습니다. 바뀐 건 출처였습니다. 같은 질문 쌍에서 인용 출처가 평균 4분의 1 정도만 겹쳤습니다. 회차마다 흔들리는 출처 수는 평균과 최소~최대 범위로 적었고, 전체 표와 질문 원문은 측정 결과 글에 정리했습니다.
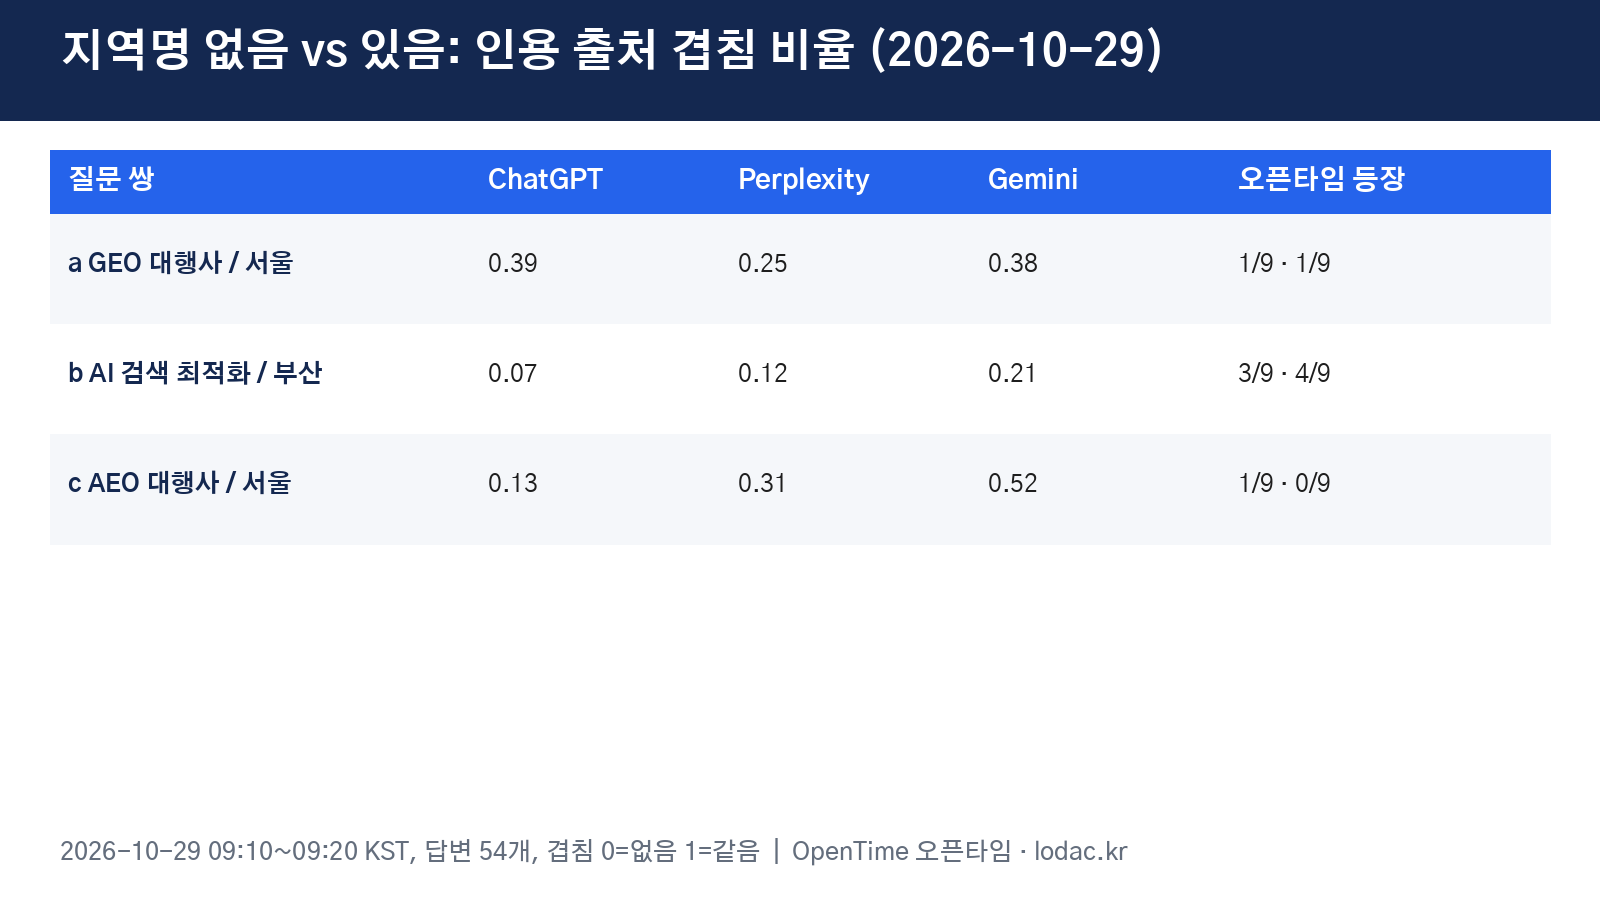
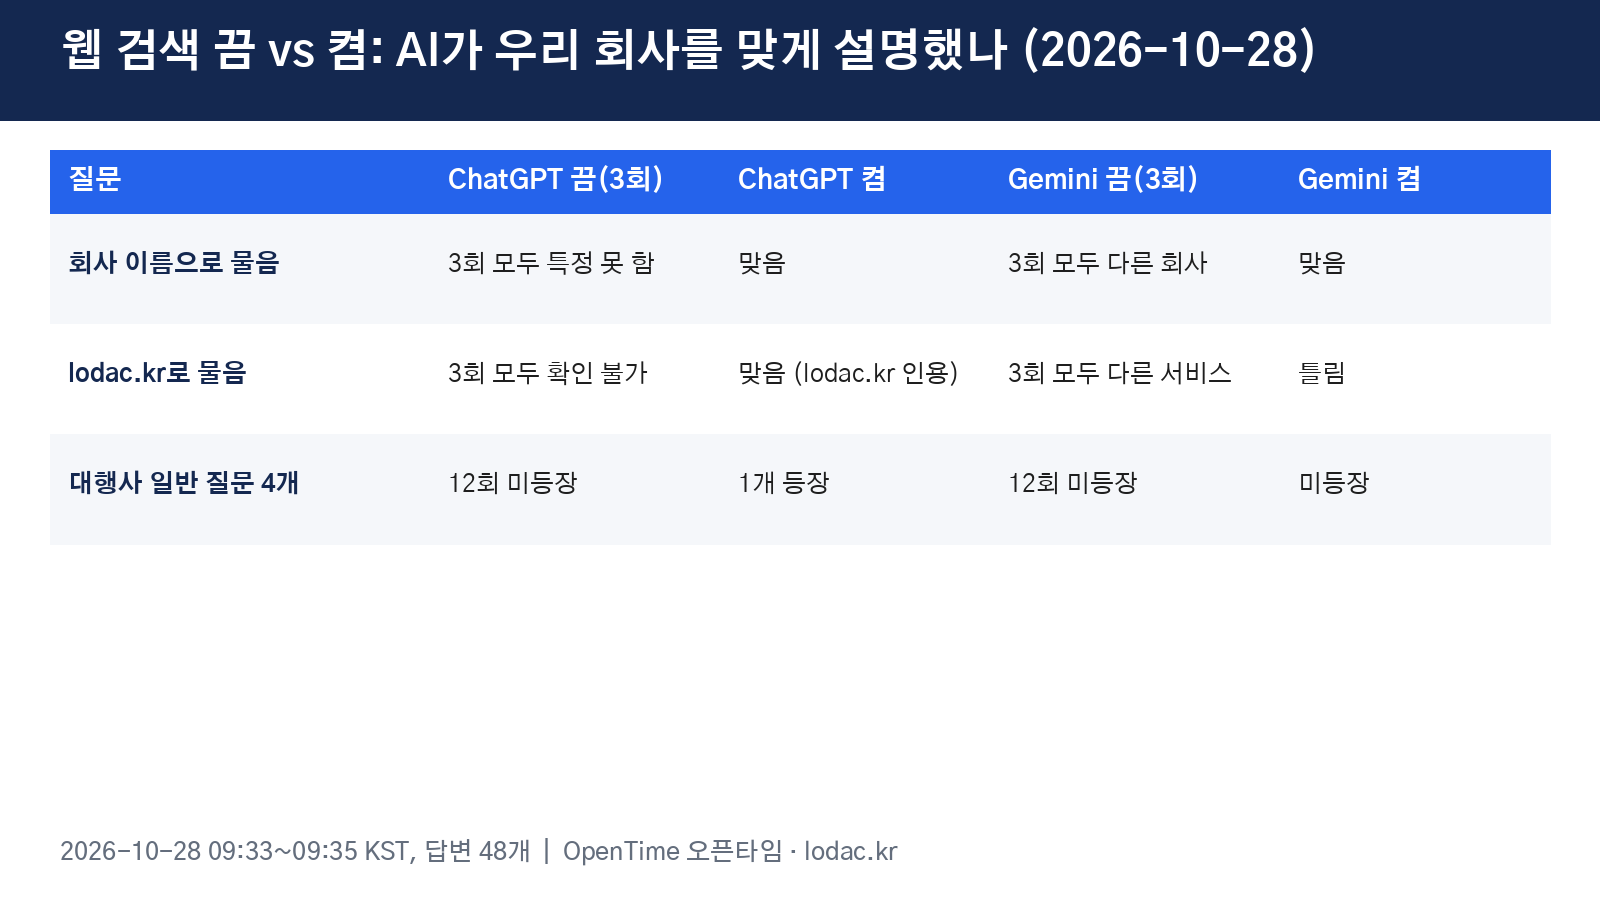
숫자 말고 따로 적어 둔 것도 있습니다. 지역 질문 일부에서 AI가 저희가 공개한 적 없는 위치와 가격을 회사 설명에 붙였습니다. 이런 내용은 결과 숫자에 섞지 않고 "AI가 덧붙인 미확인 정보"로 분리했습니다. 어제 웹 검색을 끄고 쟀을 때 AI가 매번 다른 회사를 지어냈던 것과 같은 계열의 문제로 보고 있습니다.
다음에 바꿀 것
이번 측정은 질문 쌍 3개, 지역은 서울과 부산뿐이었고, 네이버 AI 브리핑은 재지 못했습니다. 다음에는 지역을 늘리고, 같은 질문을 다른 날 다시 물어 날짜에 따른 변화도 보려고 합니다. 이 기록은 OpenTime(오픈타임)의 측정 로그입니다.
GEO AEO를 소개해드립니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.