parameterfreak
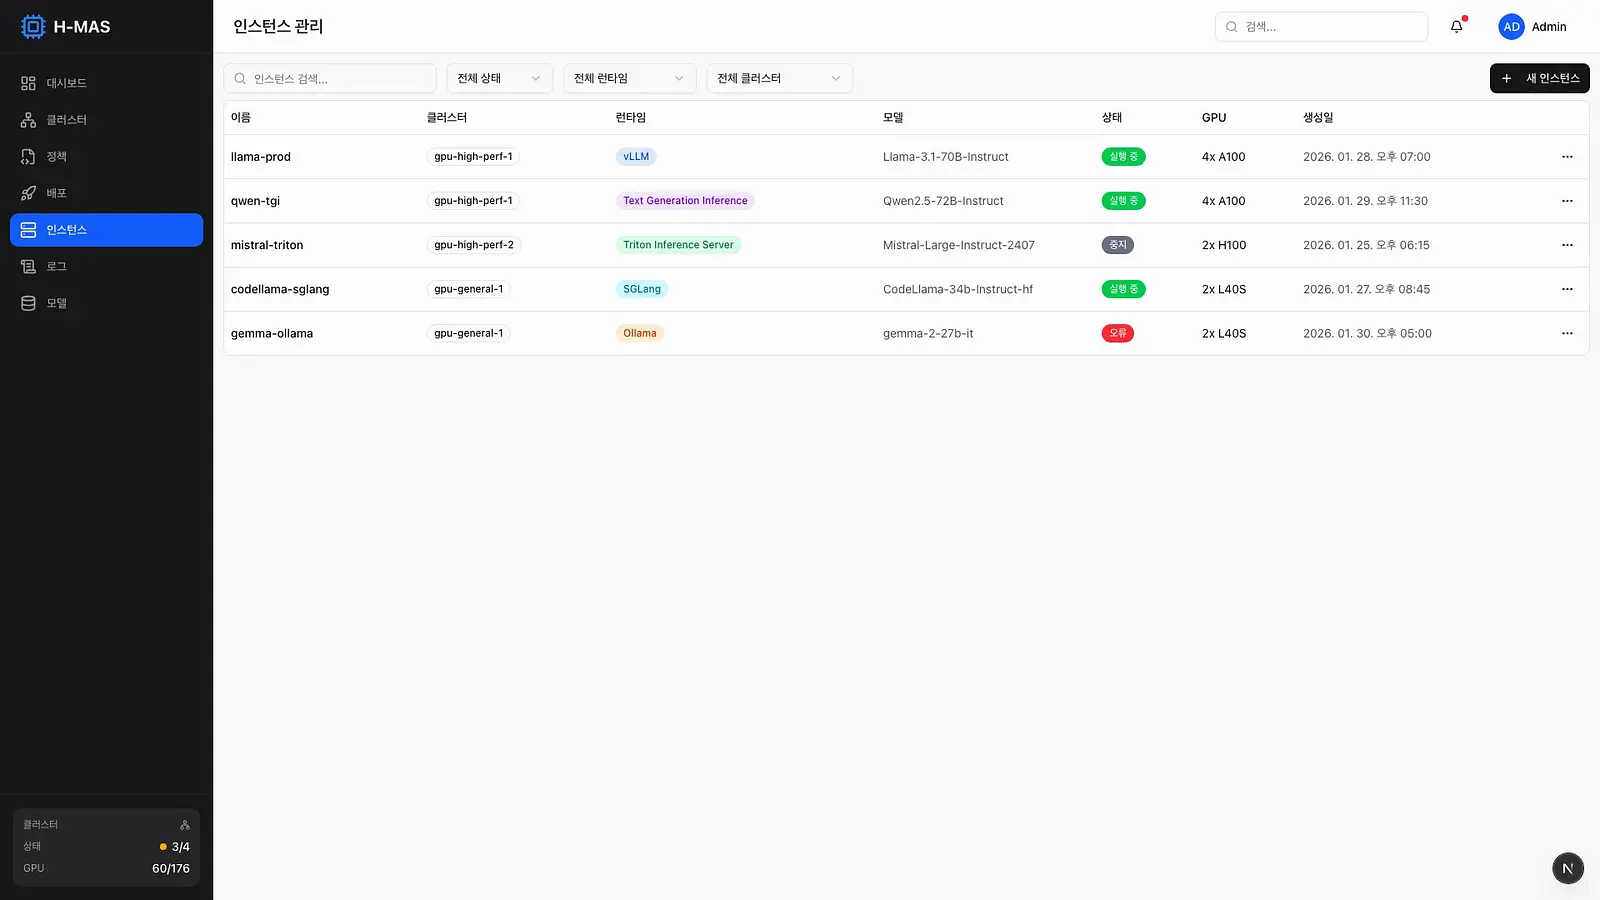
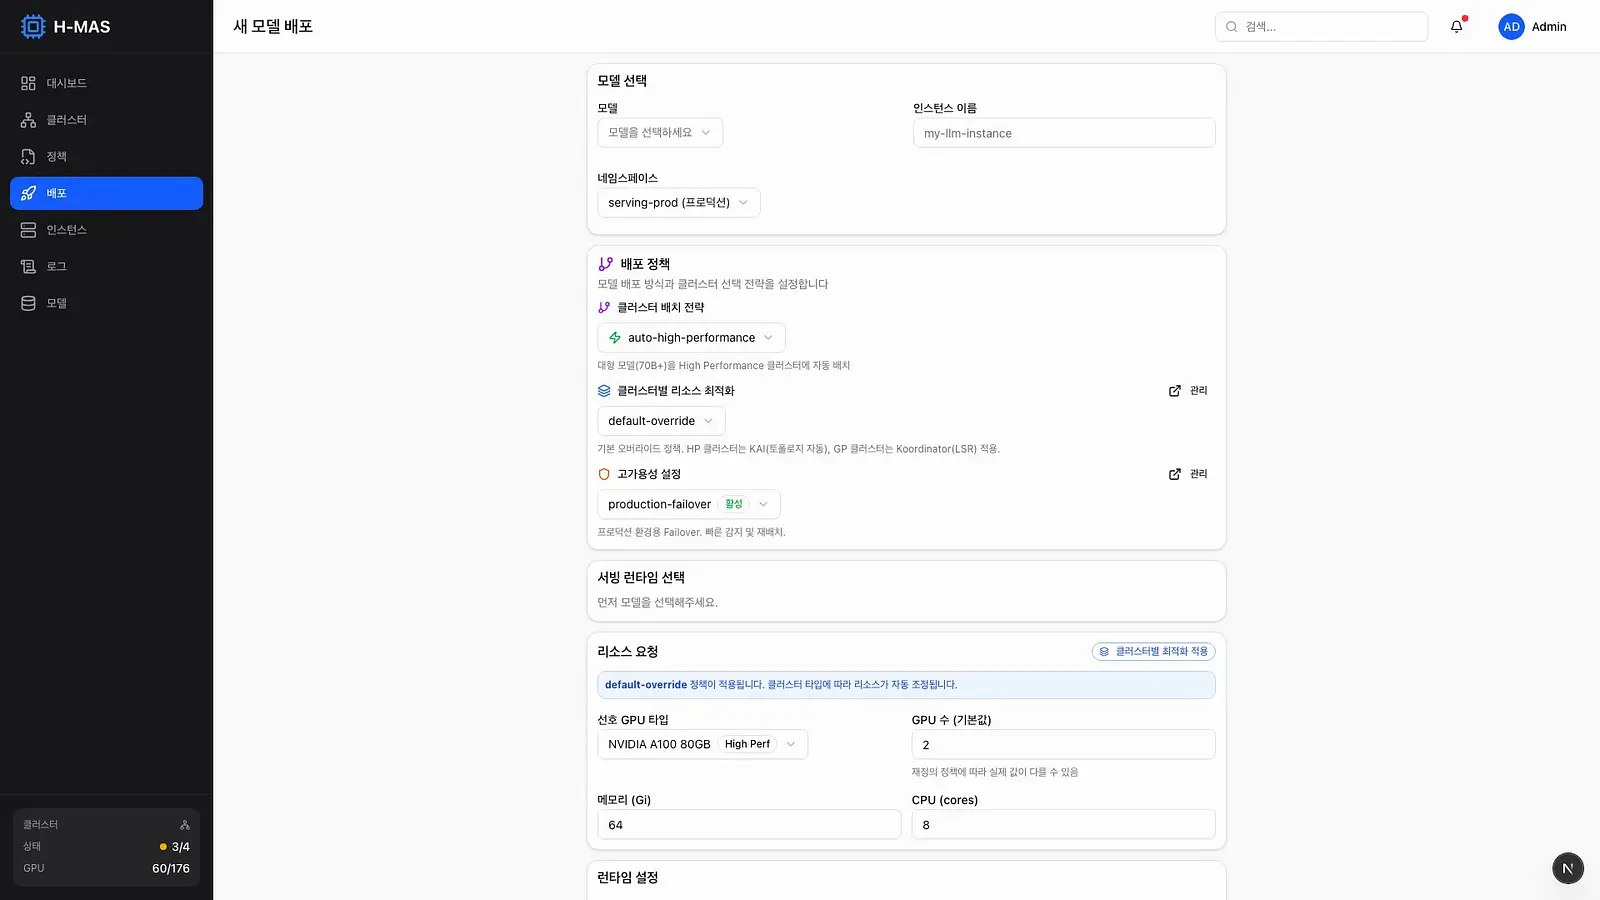
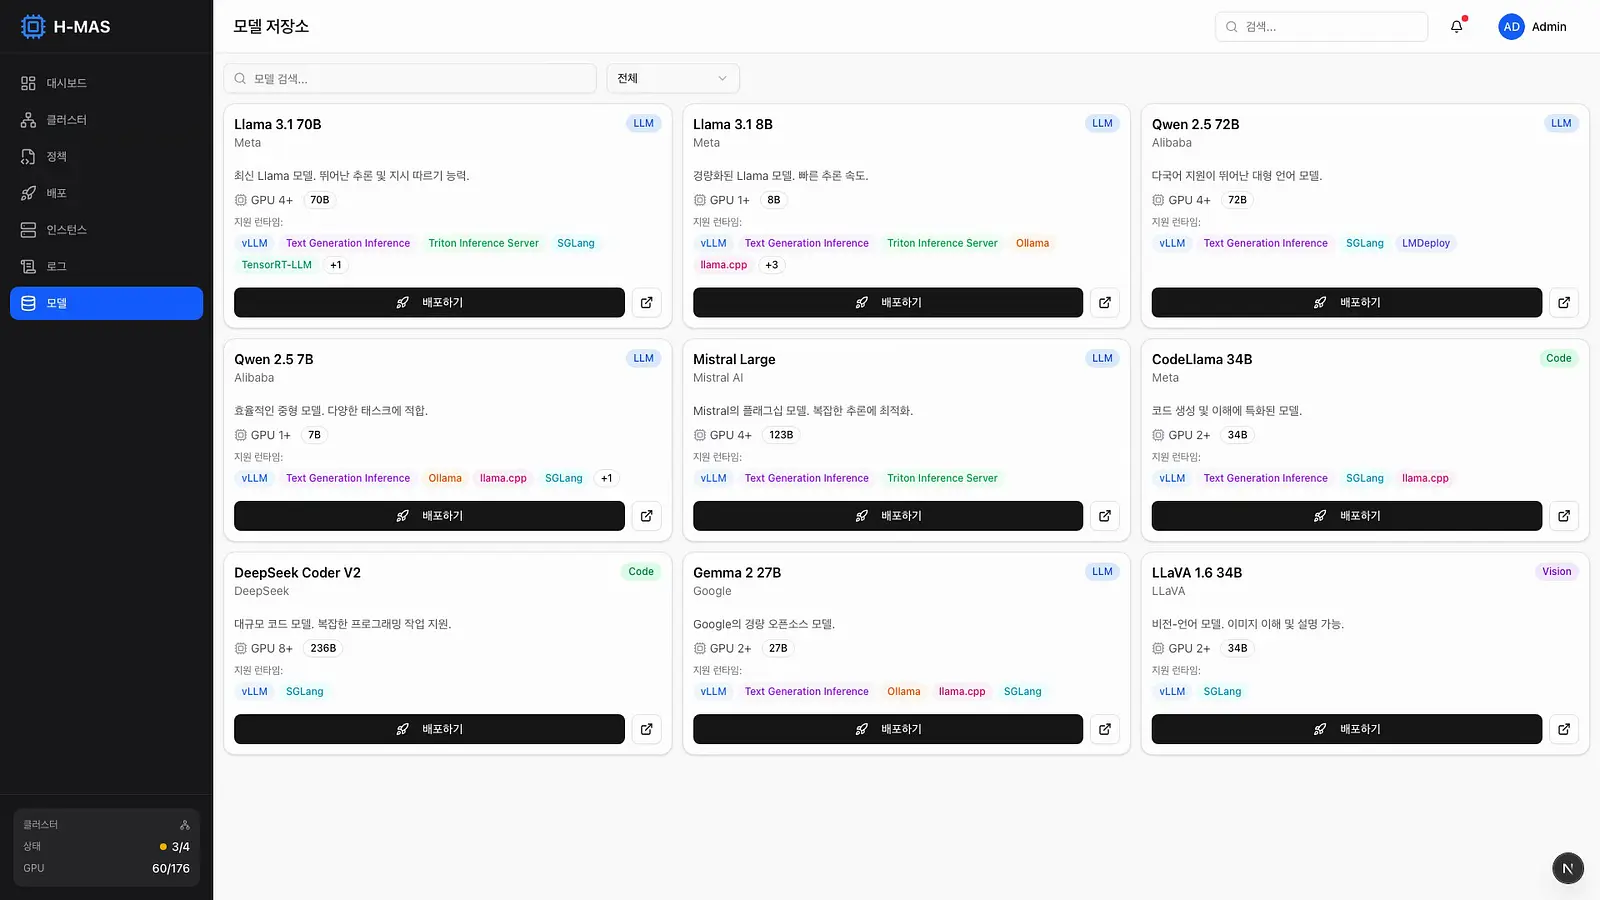
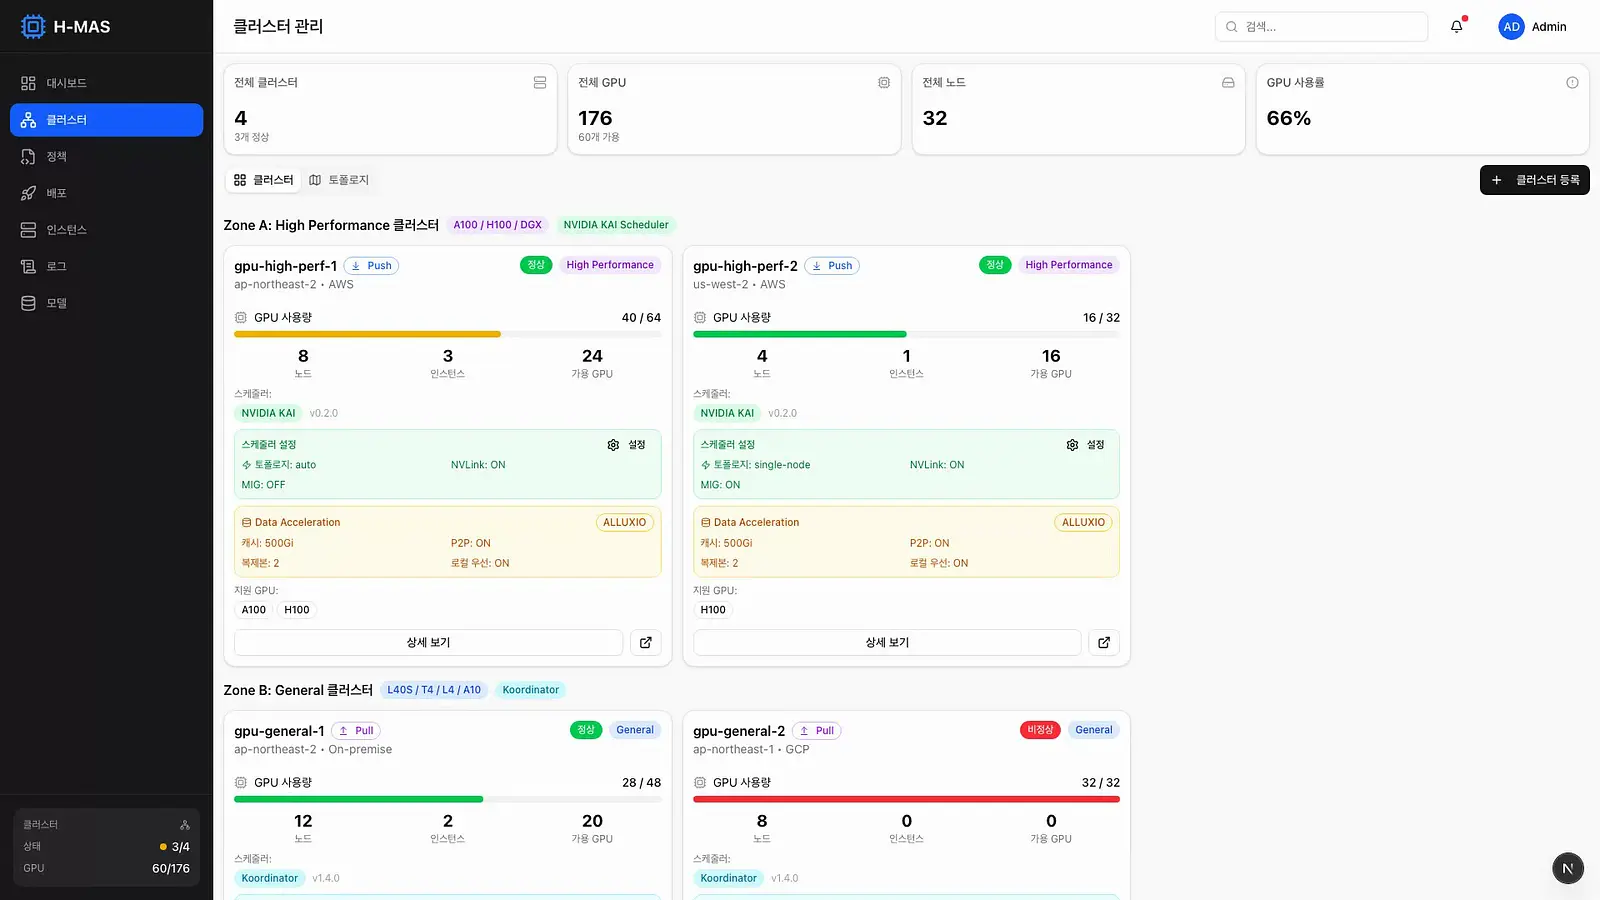
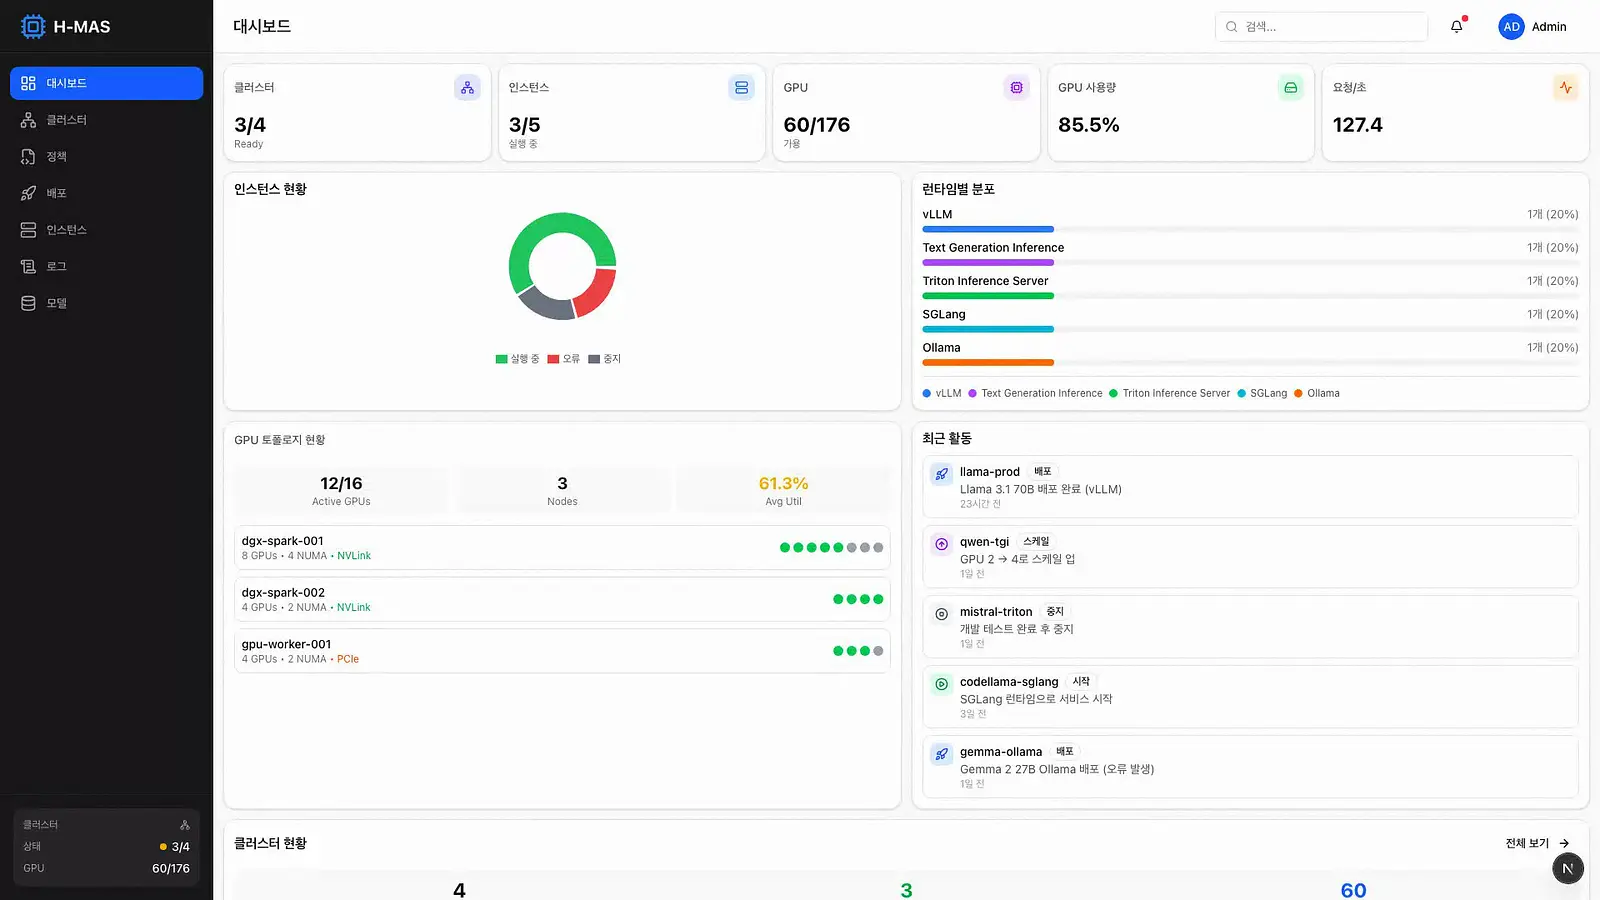
GPU 서버에서 LLM을 서빙하는 플랫폼 H-MAS의 데모 영상을 만들었습니다.
- 모델 고르고 VRAM 나눠 배포
- OpenAI 호환 API로 Open WebUI 연결
- 응답 속도·GPU 사용률 실시간 확인
실제 화면 그대로 2분 분량입니다.
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
0 팔로워
parameterfreak
GPU 서버에서 LLM을 서빙하는 플랫폼 H-MAS의 데모 영상을 만들었습니다.
실제 화면 그대로 2분 분량입니다.
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
H-MAS 개발 노트 Iteration 46
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
H-MAS 개발 노트 Iteration 45 (10/18~10/24)를 올렸습니다.
이번 주는 직접 측정해 보고 결정한 일이 많았습니다.
- GPU 성능 분석은 서비스를 멈추지 않는 범위에서만 하기로 했습니다
- 런타임을 vLLM 하나로 통일하고, SGLang을 새로 도입하기로 했습니다
- 추론 가속 기법(Speculative Decoding)은 측정해 보니 효과가 기대보다 작아 기본 기능에서 뺐습니다
- 설정을 바꿨는데 몇 초 뒤 원래대로 돌아가던 버그를 고쳤습니다
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
GPU 한 장을 한 팀이 통째로 쓰면 나머지 팀은 대기. 이번 주에 VRAM을 쪼개 여러 배포가 나눠 쓰는 기능을 화면까지 끝냈습니다.
다만 쪼개 쓴 배포는 GPU 사용률을 배포별로 못 구하길래, 가짜 숫자 대신 "수집 불가"를 그대로 띄우기로 했습니다.
https://parameterfreak.com/changelog/h-mas/2026-10-18/
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
작은 모델 하나 때문에 GPU 한 장이 통째로 묶이는 게 신경 쓰였는데, 4개월 미룬 이슈를 이번 주 손댔습니다.
GPU 개수 대신 VRAM 용량을 적으면 한 장에 모델 여러 개가 올라갑니다. 둘로 해봤고 둘 다 응답 옵니다. 격리 없는 클러스터는 메모리 상한으로 때웠습니다.
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
이번 주엔 기능 하나를 뺐습니다. 리소스 프로파일. 만들고 보니 쓸 일이 없어졌고 기본값은 애초에 안 먹던 거였더라고요. 이제 배포 폼에서 CPU·메모리·GPU를 직접 적습니다.
추론 로그도 따로 옮기려던 걸 접고 PostgreSQL에 둡니다. 재보니 부하가 문제가 아니었어요.
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
H-MAS v0.9.0.
지난 12주는 팀들이 관리자 손을 안 빌리고 굴러가게 만드는 데 썼습니다.
• 관리자 권한은 켤 때만, 길어야 1시간
• 정책은 조직이 복사해 가서 직접 수정
• 모델 서버 직접 호출은 401, 전부 인증 경유
주간 기록 12편도 같이.
https://parameterfreak.com/posts/2026/09/h-mas-v0.9.0-release/
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
조직을 하나 삭제했는데 그 뒤로 다른 조직들도 배포를 못 만들었습니다. 삭제된 조직에 클러스터 배정이 그대로 남아 있었고, 그게 전체 배포 생성을 막고 있었습니다.
이번 주에 조직을 지우면 배정도 같이 풀리도록 고쳤고, 이미 남아 있던 것도 정리했습니다.
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
parameterfreak
"GPU 남았어요?"와 "왜 느려요?"는 자주 듣는 질문인데, 답이 나오는 곳이 서로 다르다는 걸 이번에 정리하면서 새삼 느꼈습니다. 모니터링 구조 얘기입니다.
https://parameterfreak.com/posts/2026/09/hmas-monitoring-architecture/
HMAS
고비용 GPU 인프라를 하드웨어 기반으로 최적화하여 AI 서빙 비용을 절감하는 플랫폼
댓글
로그인 후 댓글을 남길 수 있습니다.
아직 댓글이 없습니다.