서혁준
ChatGPT의 등장을 전후하여 MS는 수많은 LLM 기반 코파일럿 서비스를 발표했다.
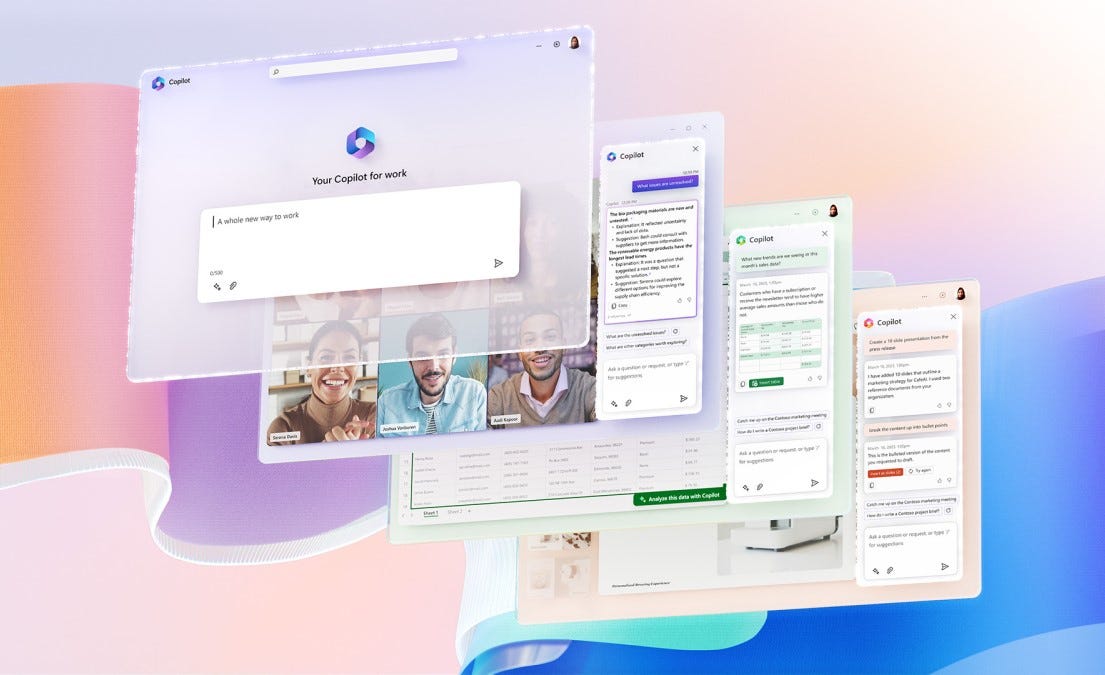
Github Copilot
Office Copilot
Outlook
Teams
Powerpoint
Excel
Bing Chat
Microsoft Designer
물론 OpenAI와 직접적인 투자 관계에 있는 만큼 좀 더 LLM이 가져올 변화에 빠르게 대처할 수 있었겠지만, 그럼에도 불구하고 대기업에서 이렇게 빠른 속도로 많은 서비스를 만들어냈다는 점은 경이로웠다.
당시에 프라이머의 GenAI 해커톤에 내볼 아이디어를 친구들과 고민하고 있었는데, 이메일 관리 코파일럿 서비스를 만들어보자라고 한 지 3일도 안되어서 MS와 구글에서 해당 서비스를 포함해 수많은 생성형 AI 서비스를 쏟아내는 것을 보고 충격과 감탄에 휩싸여 있었다.
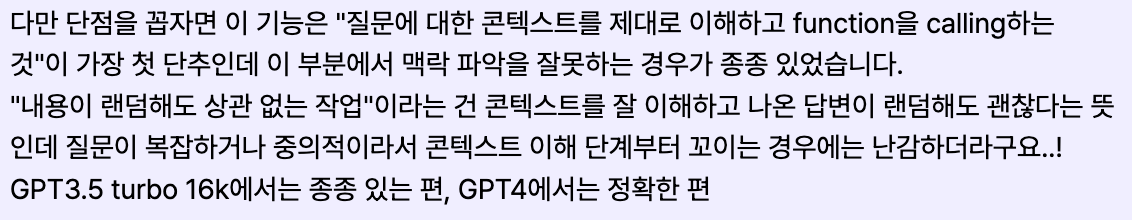
지난번 글에 달렸던 댓글 중 하나인데, 이 댓글의 내용처럼 LLM 기술은 완전하지 않다. 제 아무리 GPT-4라 하더라도 파악해야 하는 맥락이 애매하거나, 바뀌는 경우 만족스러운 답변을 내놓지 않는 경우가 많다.
예를 들어 ChatGPT에게 농담을 시키다가 갑자기 진지한 대화를 하자고 하면 잘 하지 못하고, 새로운 채팅을 시작하는 편이 나을 수 있는 것처럼 말이다.
LLM 기술의 TRL (Techonolgy Readiness Level, 기술 준비도)는 다른 기술에 비해서 낮은 편이다. 이러한 기술의 불완전함을 MS에서는 어떻게 극복하여 제품으로 만들어낼 수 있었을까?
AI 코파일럿 서비스를 어떻게 만들어야 할까?
지난 5월, MS의 CTO 케빈 스캇은 이렇게 많은 서비스를 짧은 시간에 만들어낼 수 있었던 이유는 “잠시 멈춰서서 여러 Copilot 서비스들의 공통적인 점과 이를 위한 기술 스택을 정의할 시간을 가졌기 때문이다” 라고 말했다.
So the only reason that we have been able to do this sort of blitz of Copilot announcements, and delivering these products to users so quickly, is because we stopped and took the time and energy to go build a Copilot technology stack that would allow us to move quickly with safety.
고민의 시간을 가지고 나서 MS에서 내놓은 AI Copilot 서비스의 구조는 다음과 같다.
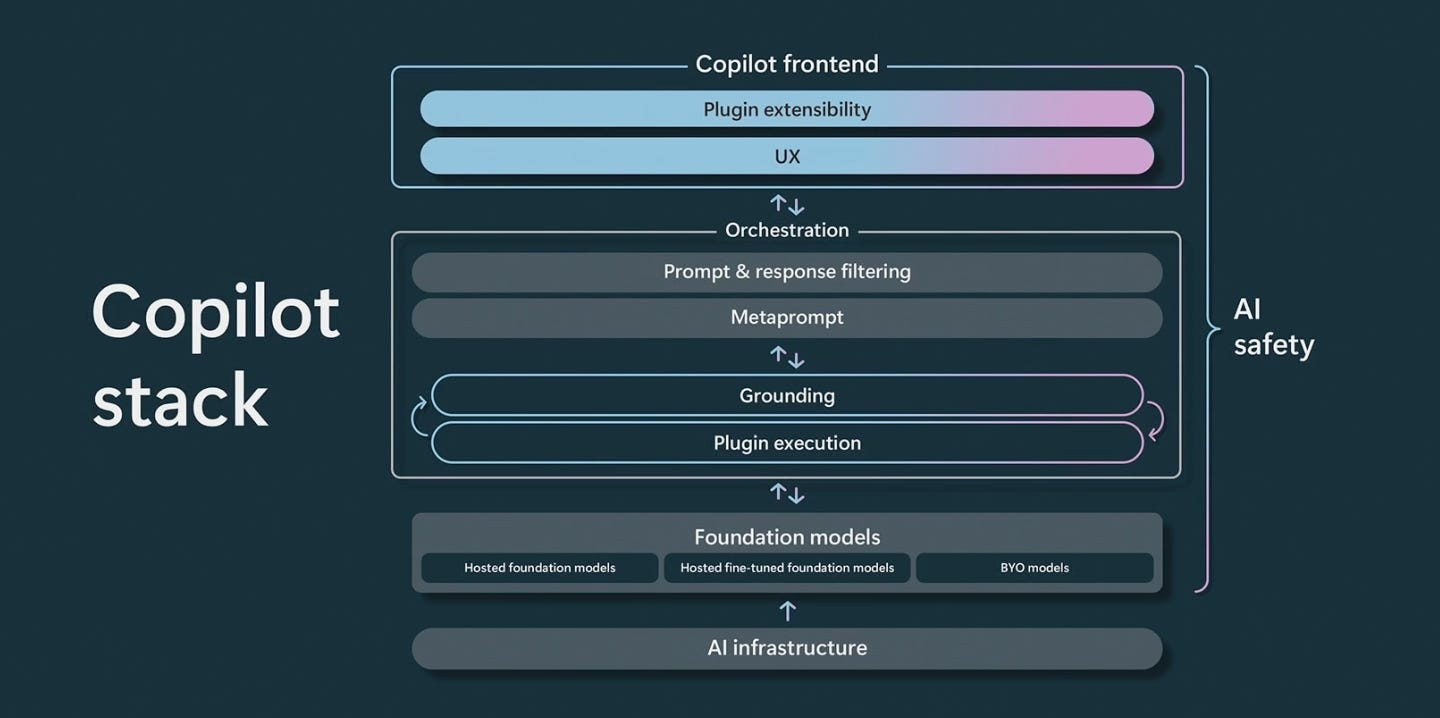
기존 서비스 구조와 같이 프론트엔드 + 미들 레이어(AI 오케스트레이션) + 백엔드(모델 레이어) 로 구성되어 있는 것을 볼 수 있는데, 여기서 가장 주목할 만한 부분은 AI 오케스트레이션 레이어이다.
AI 오케스트레이션 레이어는 코파일럿의 비즈니스 로직을 담당하는 레이어로, 어떤 모델이나 플러그인들을 어떤 순서로 호출할지 등을 결정하고 담당한다.
이를 위한 프레임워크로 MS에서는 Semantic Kernel을 오픈소스로 공개했으며, 이 외에도 Langchain 등이 있다.
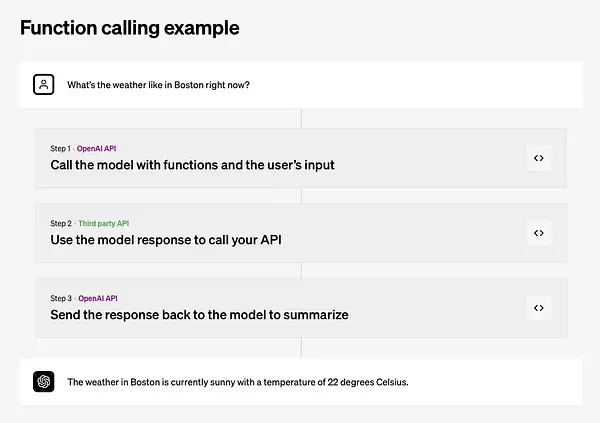
LLM을 위한 아키텍쳐가 완벽하게 자리잡지 않은 만큼 둘 다 활발하게 개발되고 있는데, 이 둘이 공통적으로 취하는 전략은 “여러 단계의 프롬프트를 연속적으로 Chaining” 하는 것이다.
이를 좀 더 쉽게 말하자면, 작업을 시킬 때 한번에 모든 작업을 시키는 것이 아니라
작업을 여러개의 명확한 작은 작업으로 나눠서 그 결과를 연속적으로 연결시킨다는 뜻이다.
이에 대한 예시로 팟캐스트 대본을 가지고 SNS 홍보자료를 만드는 코파일럿 서비스를 생각해 보자.
주어지는 입력 : 팟캐스트 대본
원하는 결과 : 링크드인에 팟캐스트를 홍보하기 위한 이미지 + SNS 글
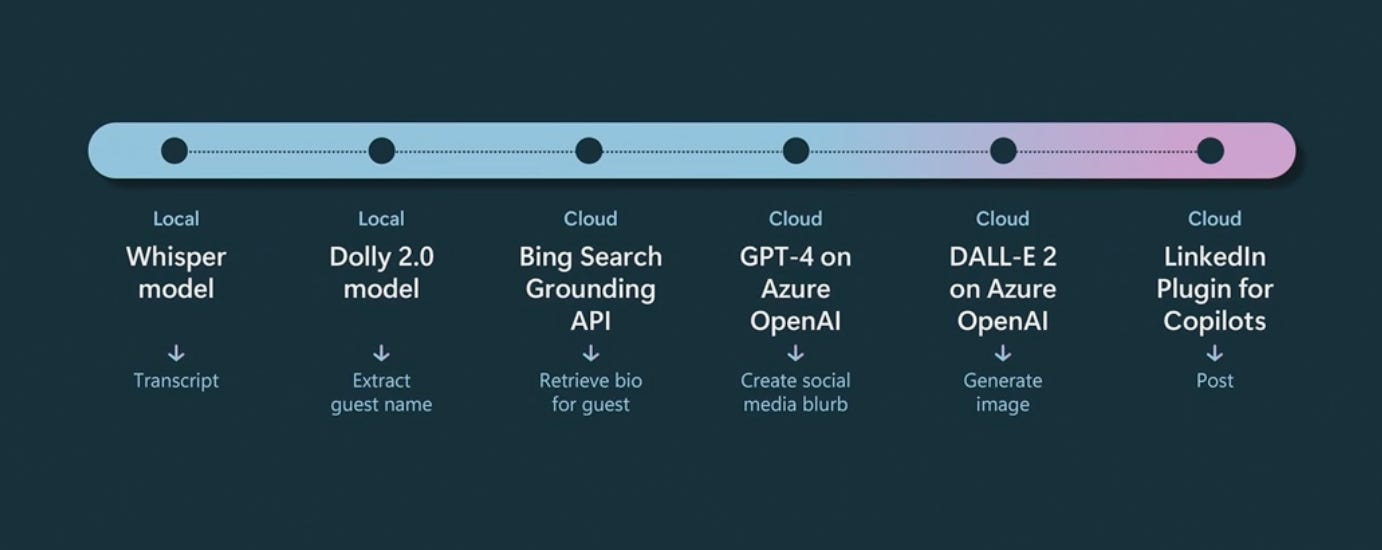
이 서비스에서는 홍보용 자료를 한번의 프롬프트를 이용하여 생성하는 것이 아니라 아래와 같이 작은 여러개의 단계로 나눠서 각각을 다른 모델 / API 를 활용하여 처리한다.
Whisper모델로 녹음 → 대본으로 변환Dolly 2.0모델을 이용하여 게스트 이름 추출Bing Search API 를 이용하여 게스트에 관련한 정보 추출
GPT-4를 이용하여 홍보용 아티클 생성DALL-E 2를 이용하여 이미지 생성
이렇게 작은 Step으로 나눌 경우 LLM에게 주어지는 태스크가 좀 더 명확해지기 때문에 좀 더 좋은 결과를 생성할 수 있다는 장점이 있다.
또한 매 작업에 높은 성능의 GPT-4 를 사용하는 것이 아니라, 더 빠르고 비용이 더 낮은 모델들을 사용할 수 있다는 점에서 좀 더 경제적이고 빠른 어플리케이션을 만들 수 있다.
Langchain과 Semantic Kernel 모두 “복잡한 작업을 연속적인 여러개의 작업으로 나누는” 것을 프레임워크의 기본 뼈대로 채택하고 있는데, 이를 Chaining 이라고 부른다.
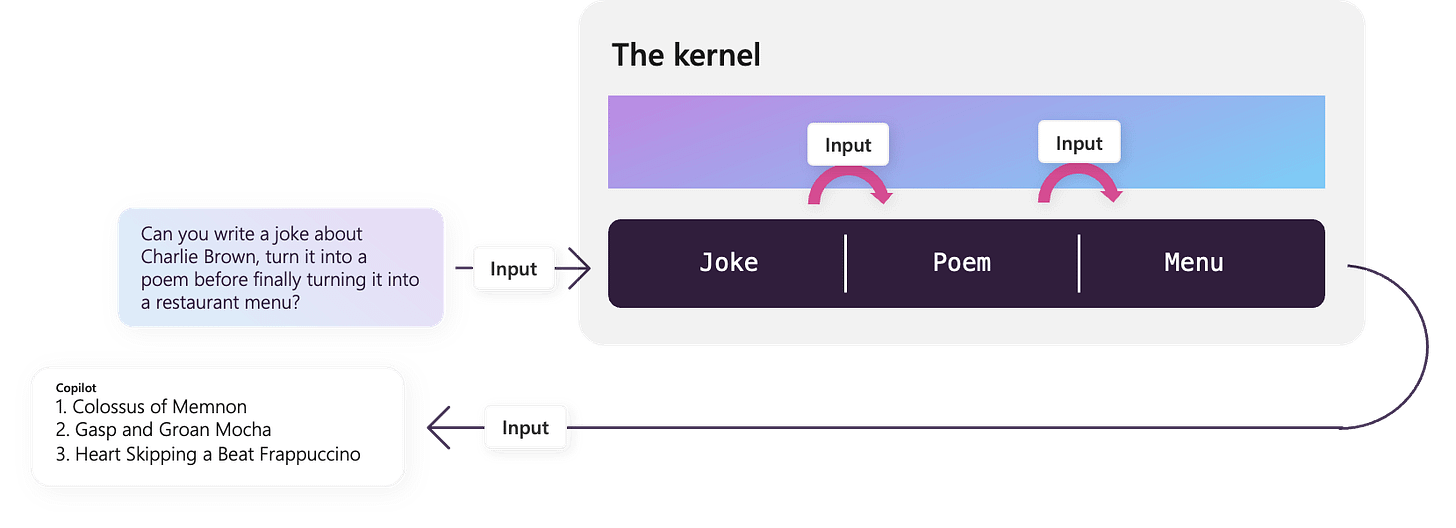
순차적인 작업을 통해 “농담 → 시 → 음식 메뉴” 를 만들어내는 예시
하지만 단순히 여러 모델을 Chaining 하는 것만으로는 우리가 기대하는 LLM의 잠재력을 온전히 끌어냈다고 볼 수 없다.
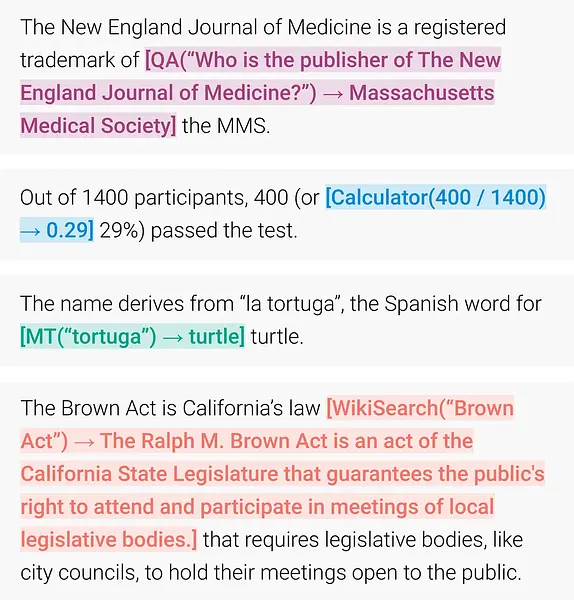
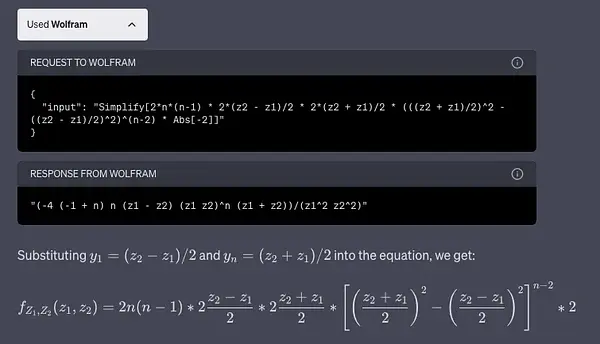
AI Orchestration framework에서는 올해 초 개발 유튜브를 뜨겁게 달궜던 AutoGPT와 유사하게, 유저가 미리 정해놓은 Chain대로 작업을 수행하는 하는 것 뿐만 아니라 “주어진 Task에 대한 설명을 보고 LLM이 직접 해당 작업을 수행할 세부 단계를 계획” 하는 것 또한 가능하다.
이 기능을 Semantic Kernel에서는 Planner, Langchain에서는 Agent라고 지칭하고 있는데,
아래와 같은 프롬프트를 이용하여 주어진 작업에 대한 수행 계획을 생성한다.
Create an XML plan step by step, to satisfy the goal given.
To create a plan, follow these steps:
0. The plan should be as short as possible.
1. From a <goal> create a <plan> as a series of <functions>.
2. Before using any function in a plan, check that it is present in the most recent [AVAILABLE FUNCTIONS] list. If it is not, do not use it. Do not assume that any function that was previously defined or used in another plan or in [EXAMPLES] is automatically available or compatible with the current plan.
3. Only use functions that are required for the given goal.
4. A function has a single 'input' and a single 'output' which are both strings and not objects.
5. The 'output' from each function is automatically passed as 'input' to the subsequent <function>.
6. 'input' does not need to be specified if it consumes the 'output' of the previous function.
7. To save an 'output' from a <function>, to pass into a future <function>, use <function.{FunctionName} ... setContextVariable: "<UNIQUE_VARIABLE_KEY>"/>
8. To save an 'output' from a <function>, to return as part of a plan result, use <function.{FunctionName} ... appendToResult: "RESULT__<UNIQUE_RESULT_KEY>"/>
9. Append an "END" XML comment at the end of the plan.
이외에도 LLM의 메모리 역할을 할 수 있는 Vector Database 연동 기능 등을 제공한다. (이 부분에 대해서는 추후 소개하도록 하겠다.)
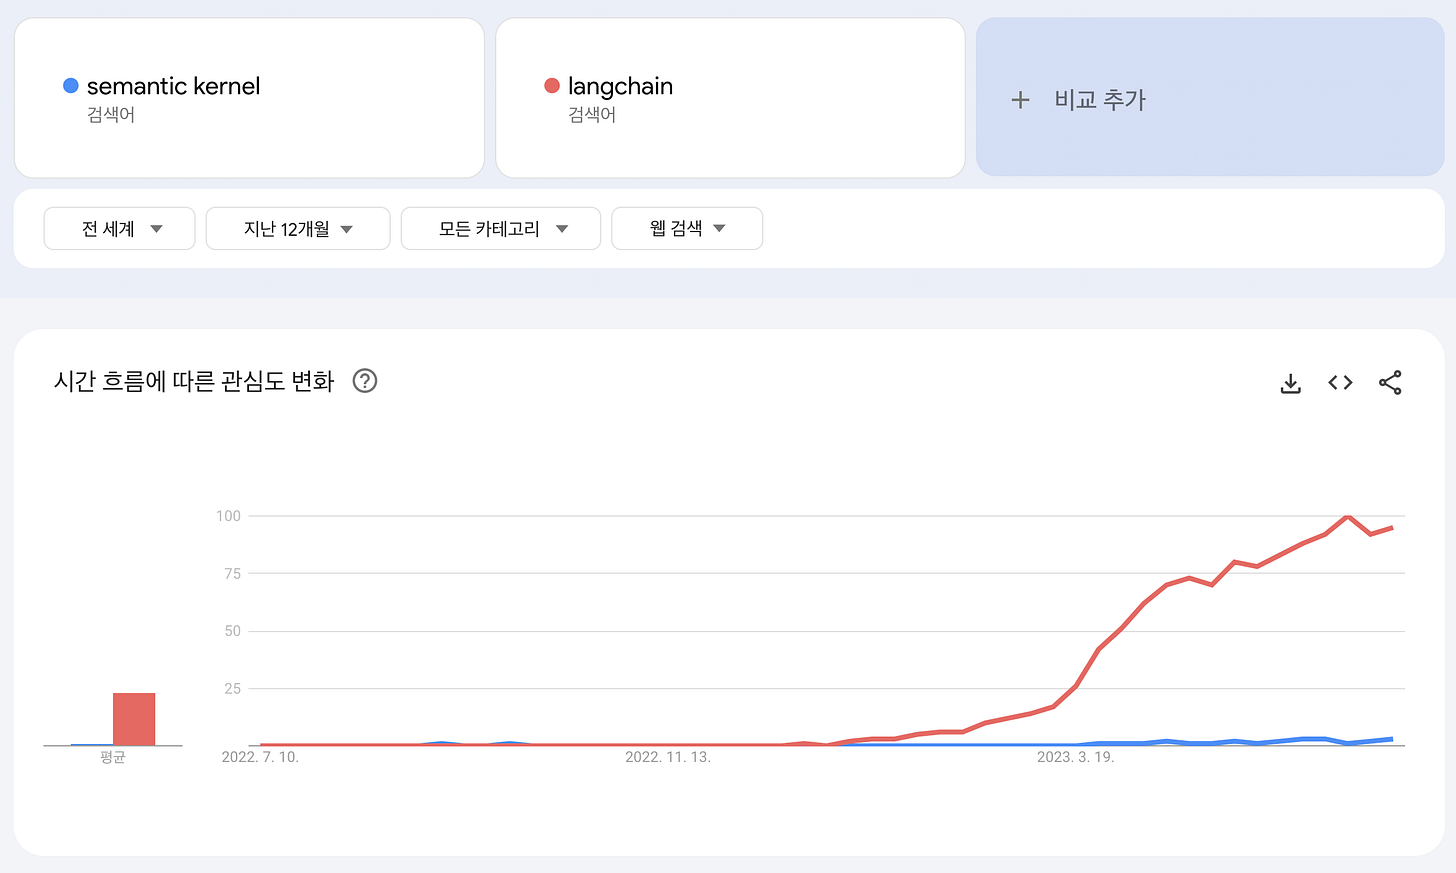
두 프레임워크 중 Langchain이 압도적으로 많은 관심을 받고 있지만, Semantic Kernel 또한 MS의 지원을 받으면서 좋은 기능들을 많이 선보이고 있으므로 관심이 있다면 공식문서를 꼭 읽어보길 바란다. (개인적으로 공식문서는 Semantic Kernel이 더 좋은 것 같다.)
어떻게 불완전한 기술을 이용할 것인가?
그래서 제목에서 했던 질문인, “MS는 어떻게 불완전한 기술을 이용해 좋은 제품을 만드는가?” 에 대한 답은 무엇이었을까?
복잡한 Task를 작은 단계로 나누기
불확실한 결과가 예상되는 작업에 대해서 에러 핸들링을 더 신경쓰기
코파일럿 서비스를 위한 UX가 무엇인지 더 고민하기
서비스 간 공통적인 부분이 무엇인지 결정하고 모듈화하기
…
무언가 Fancy한 정답을 기대했다면 실망했을 것이다. 하지만 결국 좋은 제품을 만들어내는 것은 불확정성을 줄이고, 우직하게 해야 할 일들을 해내는 데에 있다고 생각한다.
빌 게이츠가 2022년 8월, GPT-4의 첫 시연을 본 이후 OpenAI와 MS의 관계자들에게 한 말과 함께 이번 글을 마친다.
We should be more ambitious taking advantage of this breakthrough, even with the imperfections that we’re going to reduce over time.
- Bill Gates -
앞으로도 LLM 등의 기술에 대해서 글을 써볼 생각입니다!
substack을 통해서 이메일로도 받아보실 수 있으니, 괜찮으셨다면 구독해 주시면 감사하겠습니다 :)