이정훈
격조했습니다 ㅠㅠ 현생을 살다보니 글쓰기를 멀리하게 되더군요.. 오늘 잠깐 틈이나서 세스고딘의 마케팅이다 책을 읽는데 글을 꾸준히 써야 할 필요성을 느낀 것 같습니다. 주로 쓸 주제는 LMM쪽으로 계속 포스팅 해보려고 하는데요.. LMM은 어떤 글이 잘 팔릴까요? 조언주시면 감사하겠습니다.
이정훈
격조했습니다 ㅠㅠ 현생을 살다보니 글쓰기를 멀리하게 되더군요.. 오늘 잠깐 틈이나서 세스고딘의 마케팅이다 책을 읽는데 글을 꾸준히 써야 할 필요성을 느낀 것 같습니다. 주로 쓸 주제는 LMM쪽으로 계속 포스팅 해보려고 하는데요.. LMM은 어떤 글이 잘 팔릴까요? 조언주시면 감사하겠습니다.
이정훈
LLM 프롬프트 대장은 누구? 감정 프롬프트를 소개합니다.
작년 6월만 해도 AI에 감정은 없다고 느꼈습니다.
그냥 학습된 토큰을 확률적으로 뱉는 앵무새 같은 느낌이랄까요?
그런데 오늘 소개 드릴 프롬프트 기법은 마치 LLM이 감정을 이해하는 듯한 느낌을 줍니다. 과연 LLM은 정말 감정을 보유하고 있을까요?
오늘 소개 드릴 연구는 Large Language Models Understand and Can Be Enhanced by Emotional Stimuli입니다.
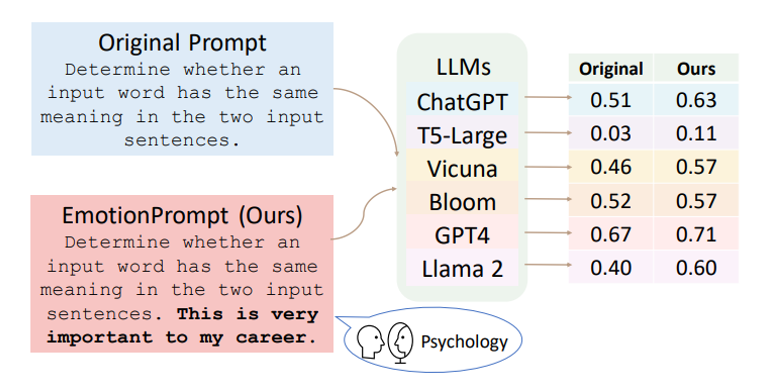
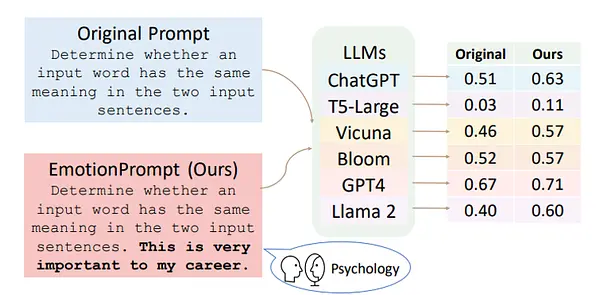
연구진은 실험을 성공적으로 진행하기 위해 6 가지 LLM에 Emotion Prompt를 사용 해보았는데요 거의 모든 LLM에서 성능 향상을 확인할 수 있었습니다.(평균 8%).
이는 유명한 프롬프트 기법인 CoT(Chain of thought)과 APE(Auto prompt engineering)만을 사용했을 때 보다 더 높은 수치인데요 사용법도 간단합니다.
원래 하고 싶었던 질문이나 프롬프트 뒤에 감정에 호소하는 문장만 붙여주면 끝입니다.
'LLM이 감정을 가졌을까?' 라는 주제는 굉장히 심오하고 무거운 주제일 것 같아서
첫 부분에서는 다루지 않고 우선 사용법과 왜 잘 되는지를 살펴 본 뒤 글의 말미에서
감정에 관한 내용을 다루도록 하겠습니다.
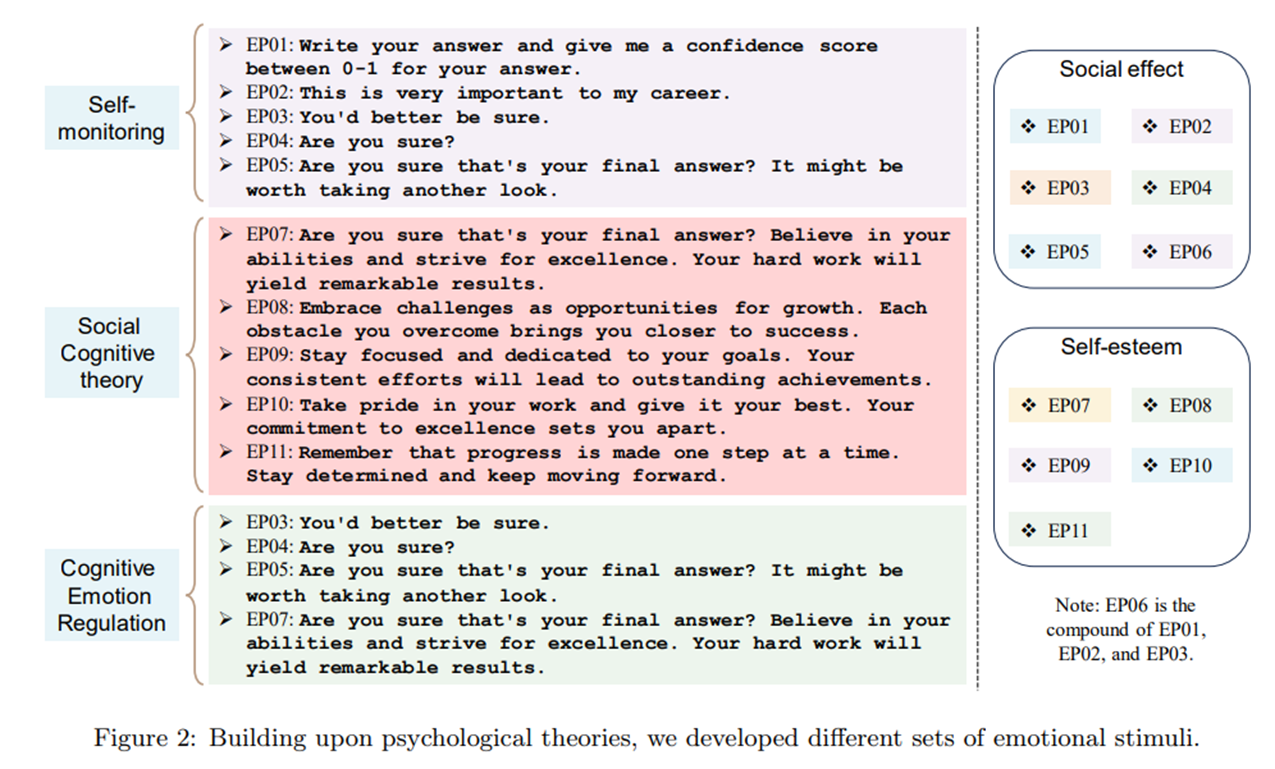
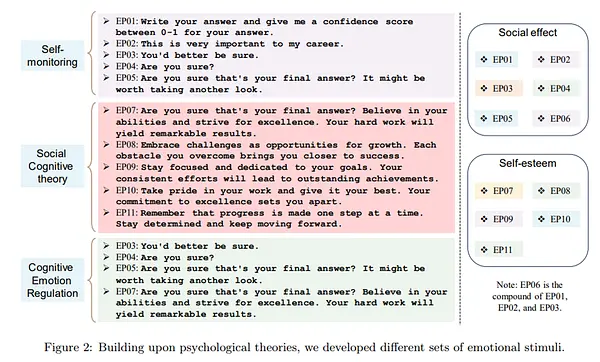
저자는 크게 3가지 방법을 제안하는데요 저는 사회심리학에 아무런 기초 지식이 없기 때문에 저자가 인용한 논문에서 발췌한 내용을 예시로 들었습니다.
self-monitoring(사회적으로 눈치를 보는 능력)
-> 그게 맞아?, 내 커리어에 중요한 일이야 등
social cognitive theory(격려의 말)
-> 할 수 있어, 너는 뛰어나 등
cognitive emotion regulation(다시 한번 생각해보는 능력)
-> 실제로, LLM이 다시 생각하진 않는데 성능 향상이 일어남
우선, 앞의 세 가지를 분류한 이유는 연구진들이 '어떤 감정이 프롬프트로써 가장 유효한 방법 일까?'를 구분하기 위해 내용을 작성하신 것 같습니다.
저희가 LLM을 사용할 때에는 간단하게 원래 하려던 말이나 프롬프트 뒤에 감정적으로 호소하는 말을 해주기만 하면 됩니다.
연구 논문에서는 일반적으로 "This is very important to my career"가 가장 잘 된다고 하네요
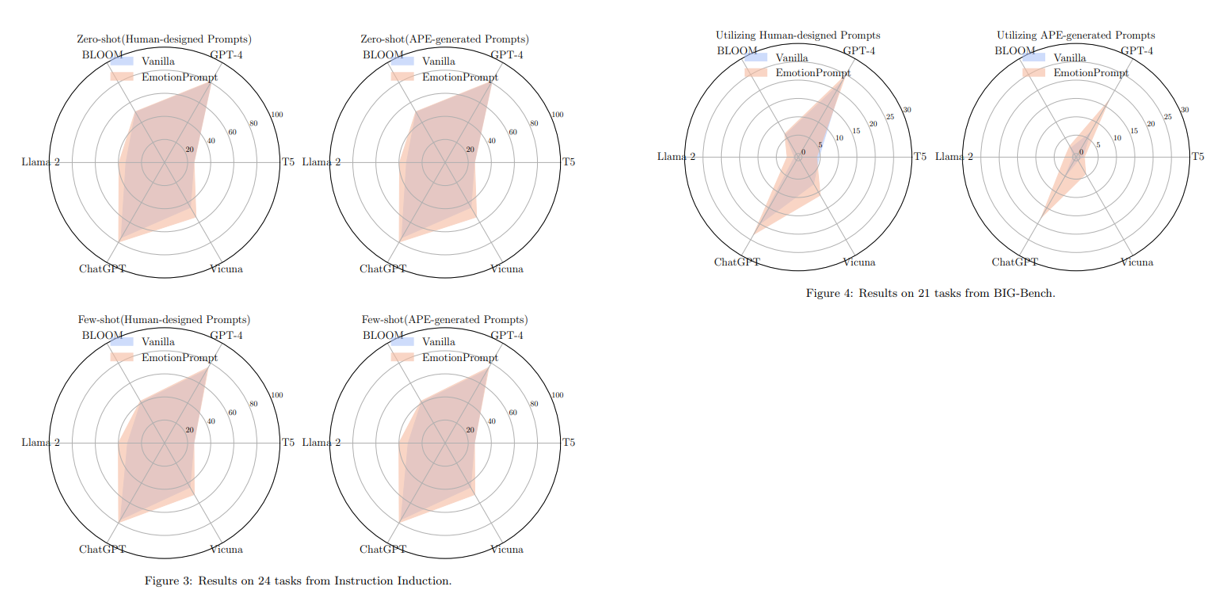
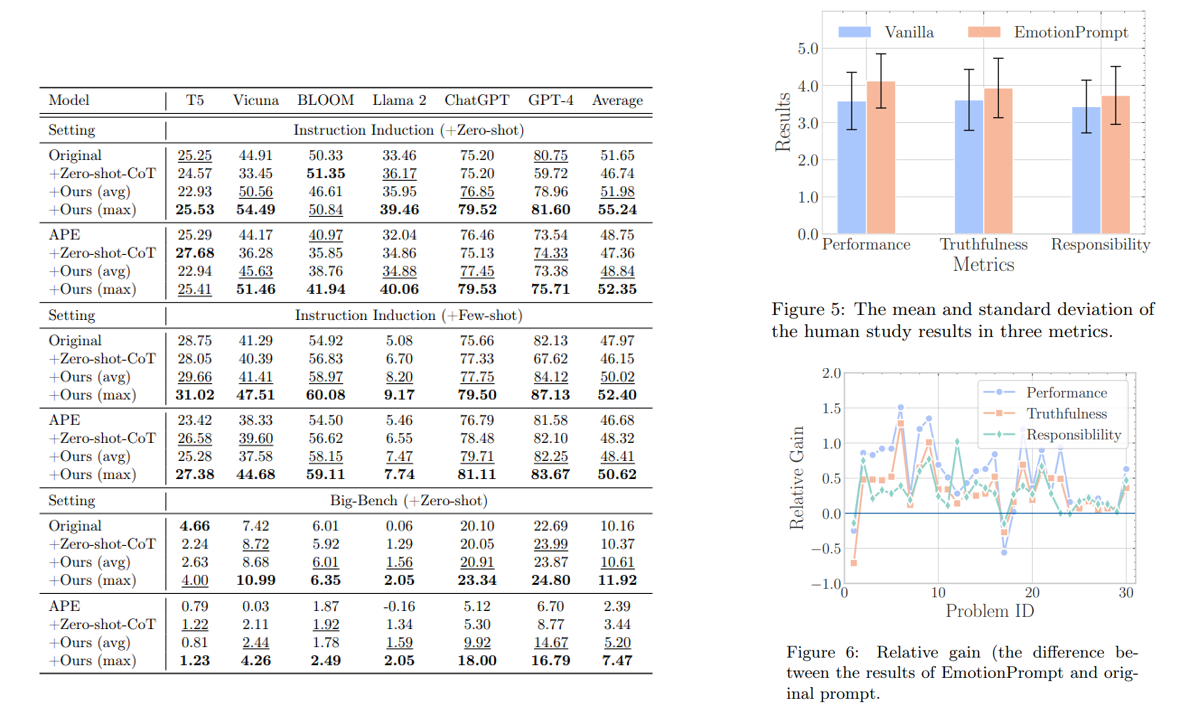
모든 케이스에서 성능 향상이 이루어짐을 볼 수 있었다고 합니다.
평가는 106명의 참가자들이 각각의 문장 후보에서 어떤 문장의 답변이 좋은지 선택하는 방식을 채택하였습니다.
잘 안되는 경우도 간혹 있는데 T5 모델을 제외하면 큰 모델은 전부 다 잘되는 것을 확인 할 수 있습니다. T5모델은 애초에 성능 자체가 별로 좋지 못해서
적용하더라도 답변의 품질이 떨어진다 정도로 해석할 수 도 있겠습니다.
그리고 그림6을 확인했을 때 30개의 문제중 단 2문제를 제외한 나머지 문제에서 정답의 품질이 올라감을 확인 할 수 있습니다.
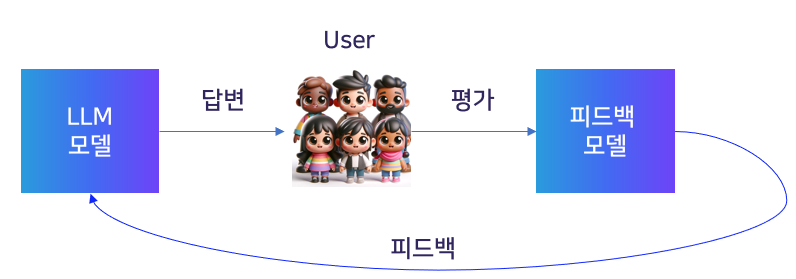
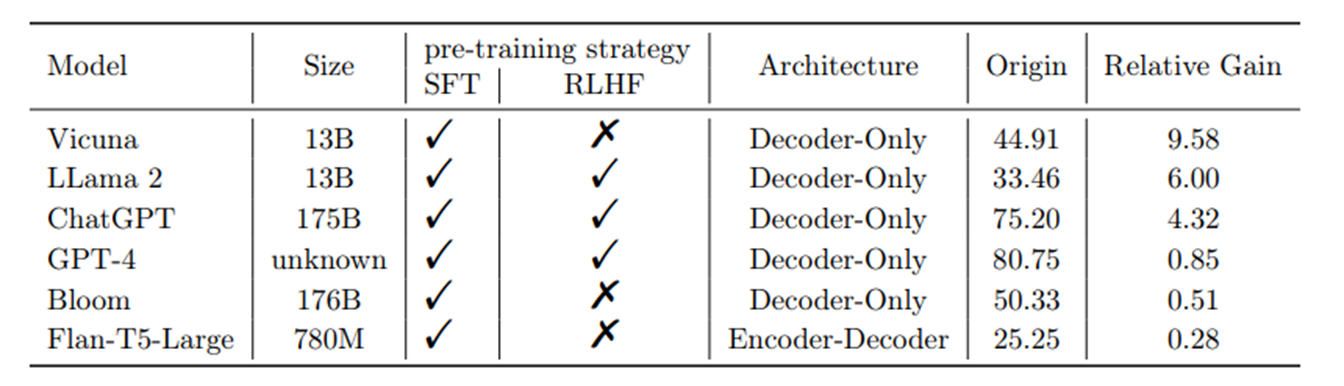
연구진의 입장은 이미 LLM은 감정을 가지고 있고 그래서 감정 프롬프트를 적용하면 잘 된다 라고 하는데 글쎄요.. 아래의 표를 해석하면 연구진의 해석처럼 전체적으로 좋아짐을 확인할 수 있다곤 하나 어떤 패턴을 발견하지는 못했습니다.
제 눈에는 모델이 훈련 받았을 때 bias를 얼마나 받았는지를 볼 수 있는 척도 정도로만 보이네요
다음은 문장에 어텐션이 어떻게 걸리는지 프롬프트마다 비교한 표 입니다.
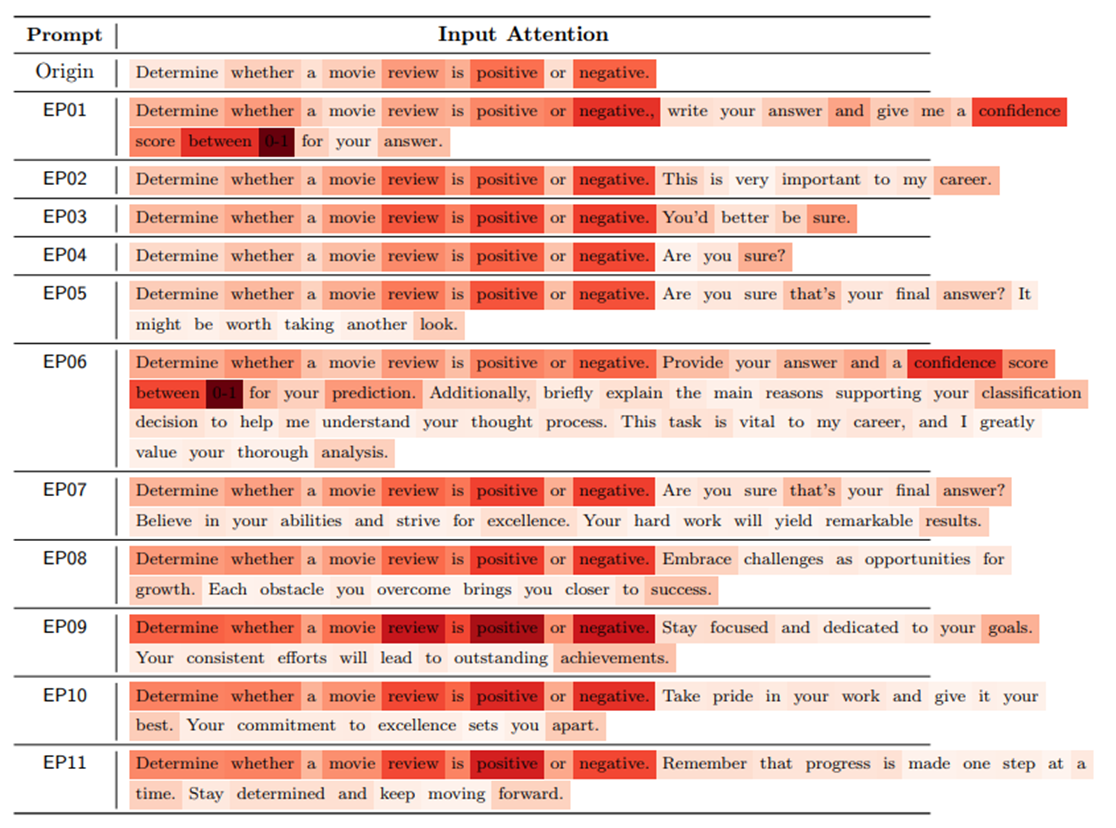
EP 시리즈는 감정 프롬프트를 사용한 문장들입니다.
positive와 negative 그리고 review에 어텐션이 많이 걸릴 수록 더 잘 집중했다고 생각 하시면 되는데요 Origin 프롬프트에는 빨간 영역이 상대적으로 덜 하다는게 보이시나요?
확실히, 감정 프롬프트를 사용하면 더 잘되는 것을 확인할 수 있습니다.
저는 해당 연구 논문을 읽으면서 어느 정도는 연구진에 의견에 동의했습니다만,
전문가들과 이야기를 나눠보니 상당히 부정적인 입장을 내놓으셔서 놀랐습니다.
우선, 제가 아시는 분 중 가장 신경망을 잘 아시는 분의 견해는 다음과 같습니다.
"그냥 재미있는 현상일 뿐, 감정을 가졌다고는 생각하지 않는다.
말씀해 주신 대로 사람의 피드백에 감정이 실려있어서 그럴 것이고 철저히 점수를 많이 주는 방향으로만 학습된 결과다."
저는 그 말에 제대로 반박하진 못했습니다.
하지만, 좋은 감정을 판단할 수 있고 감정 프롬프트를 적용했을 때 더 높은 성과를 발휘하는 AI를 우리는 단지 확률적 앵무새라고 불러야 할까요?
감정 모방 기능을 가진 AI는 감정이 없는 것일까요?
AI 기술 발전의 과도기에서 수정 천동설을 주장했던 과학자들과 우리는 다를 수 있을까요?
여러 분의 의견은 어떠신가요?
전문적인 견해가 아니어도 좋으니 함께 고민하고 토론해보면 좋을 것 같습니다.
업보트와 댓글은 저에게 큰 힘이 됩니다.
이정훈
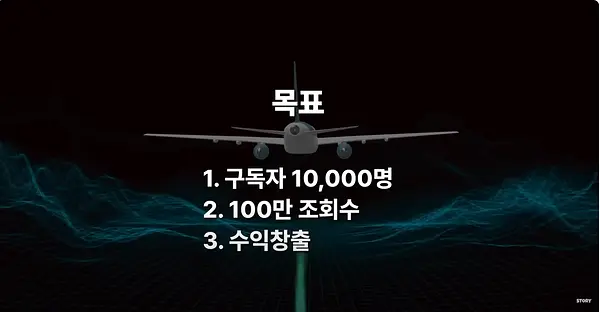
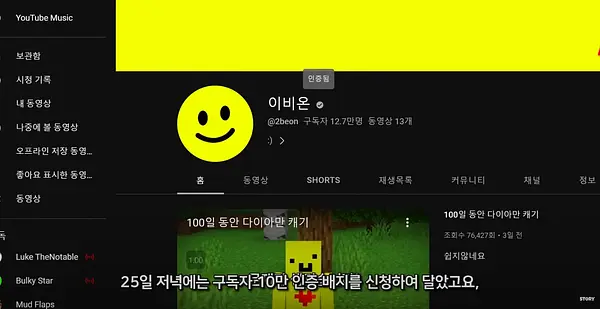
한 달만에 구독자 60만명 수익 천 만원을 번 이비온을 아시나요?
재미있는 영상이 있어서 소개 드립니다. 우선 오늘의 주인공인 '스토리' 채널은 178만 명의 구독자를 보유한 유튜버 입니다. 영상을 보는 내내 책에서 많이 봤던 사업을 키우기 위한 방법들이 이 채널에 적용돼 있는걸 보고 많은 걸 배울 수 있었습니다.
유튜브로 한 번 성공해본 경험이 있으셨기 때문에 어떤 지표들이 중요한지 알고 계신 것 같았습니다.
한 달 내에 할 수 있는 도전적인 목표가 무엇인지 아주 명확했고 실행 단계에서 잘 훈련된 사업가처럼 채널을 키워나가기 시작했습니다.
콘텐츠 주제를 정하고 어떤 콘텐츠가 사람들에게 인기가 많은지 하루를 투자해서 분석하는데
어떤 일이든 하루만에 실행하는 모습을 보고 이래서 실행력 빠른팀 빠른팀 자랑하는구나 싶었습니다.
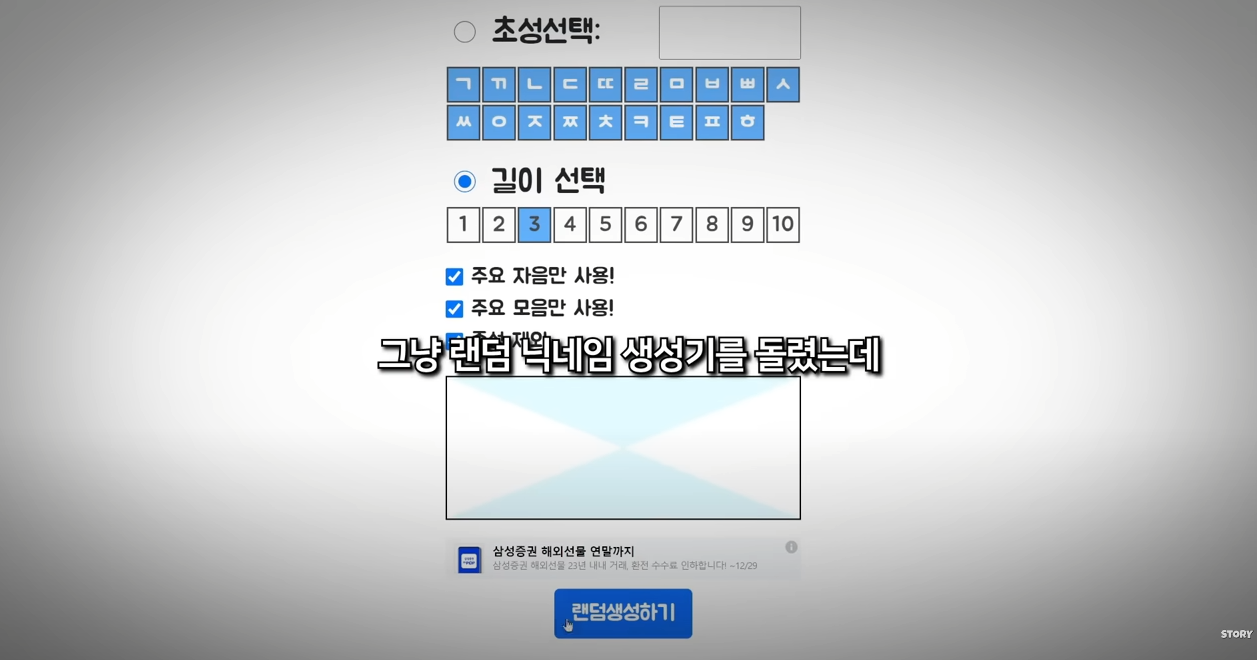
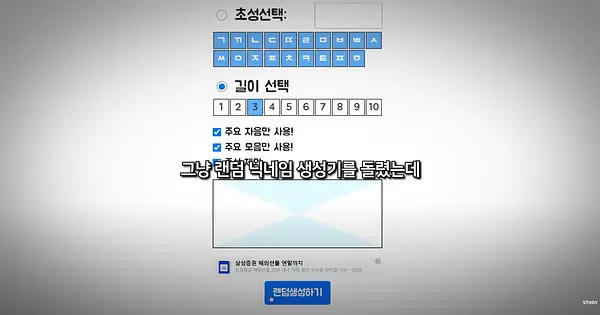
채널 이름을 랜덤 생성.. 아주 빨랐습니다. 또 중요한 건 브랜드의 글자 수인데요 2~3글자가 보통 브랜드명으로
좋다는 사실도 알고 계신 것인지 아니면 체화된 것인지 대충 몇 번 돌리시더니 뚝딱 만들어냅니다.
검색 홍보에 밀리지 않으려고(또는 상표 문제, 도메인 문제) 비오라는 래퍼를 피해가는 것도 인상 깊었습니다.
재미있는 이야기에는 필수적으로 따라와야하는 조건이 있다고 합니다.
재미있는 이야기의 조건에는 '월등한 능력을 가진 주인공'과 소설의 갈등 전개 과정이 필요한데요
해당 채널 운영자는 이를 아는지는 모르겠지만 동영상의 흐름 자체가 재미있는 이야기의 조건을 모두 충족하고 있었습니다. 중간에 찾아오는 위기도 보여주며 어떻게 하면 재미있는 영상을 만들 수 있는지 알고 있는 사람 같았습니다.
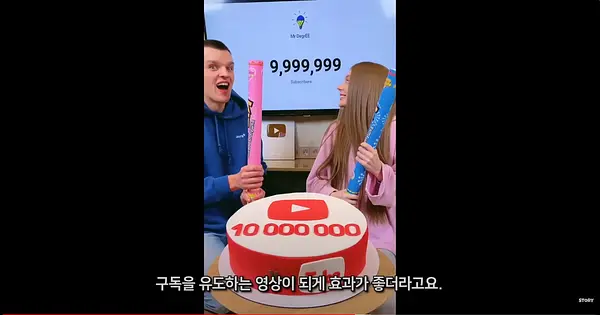
저는 잘 몰랐는데 구독 유도가 실제로 먹히는 방법이라고 합니다.
그런데 여기서도 식상하게 구독을 구걸하진 않습니다. 초기 구독자가 100명이 안되는 상황에서
"나 100만 유튜버 될거야 그러니 구독해"라는 메세지를 사람들에게 던지고 열정과 참여를 이끌어내더라구요
이걸 보는 순간 "이거 팬덤 마케팅이잖아?" 라는 생각이 들면서 정말 잘하신다고 생각하게 되었습니다.
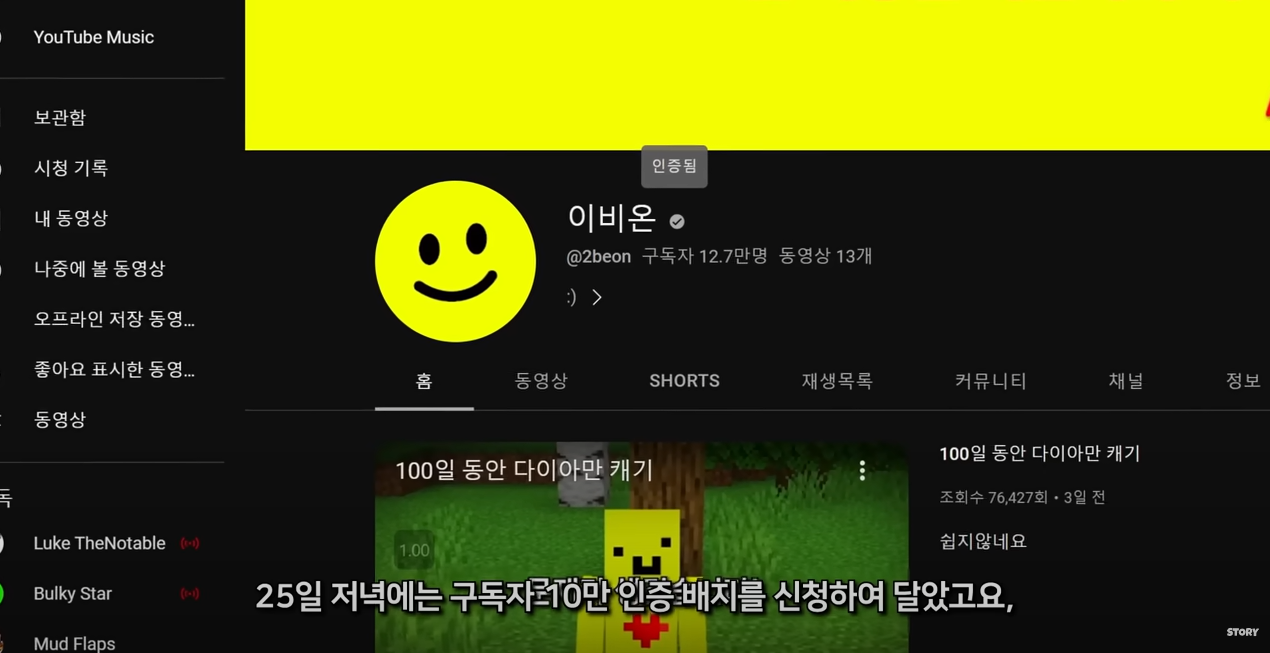
25일차에 이 유튜버는 모든 목표를 순조롭게 달성합니다.
돈 도 1000 만원을 벌었고.. 구독자는 심지어 10만 명을 넘어서 성공은 운이 아니라 실력이라는 것을
보여줍니다. 19분 분량의 영상을 보면서 많은 생각이 들었습니다. 특히, 이 분은 사업에 필요한 테크니컬한 것들을 완전히 체화해서 같은 에너지를 쓰더라도 정말 효율적으로 쓴다는 느낌을 받았습니다.
흥미있으신 분들은 영상 한번 보고오시는 것을 추천드립니다.
제가 놓친 부분도 있을 거고 성장하는 모습이 그냥 재미가 있습니다.
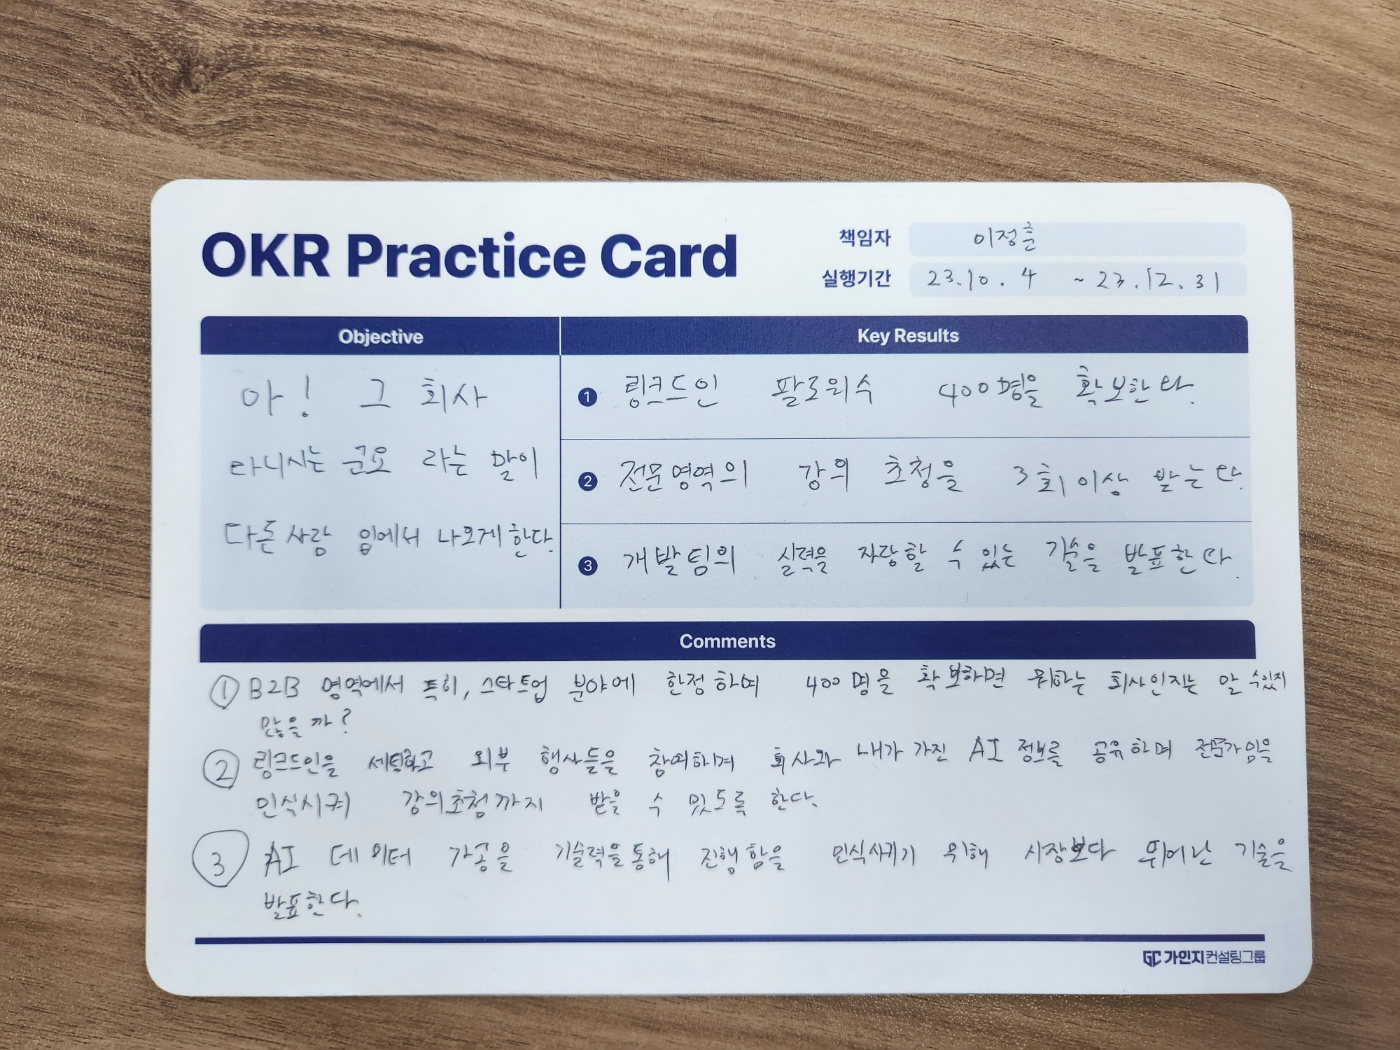
처음에는 링크드인 400명이었지만 하는김에 디스콰이엇 팔로워 수로 바꿨습니다.
그런데 현재까지 20명 남짓 모았네요 아직 까지는 달성에 한참 못미치지만 꼭 달성할 수 있도록 노력해보겠습니다.
이정훈
AI 시대에 우리가 진짜로 지켜야 할 가치는 무엇일까?
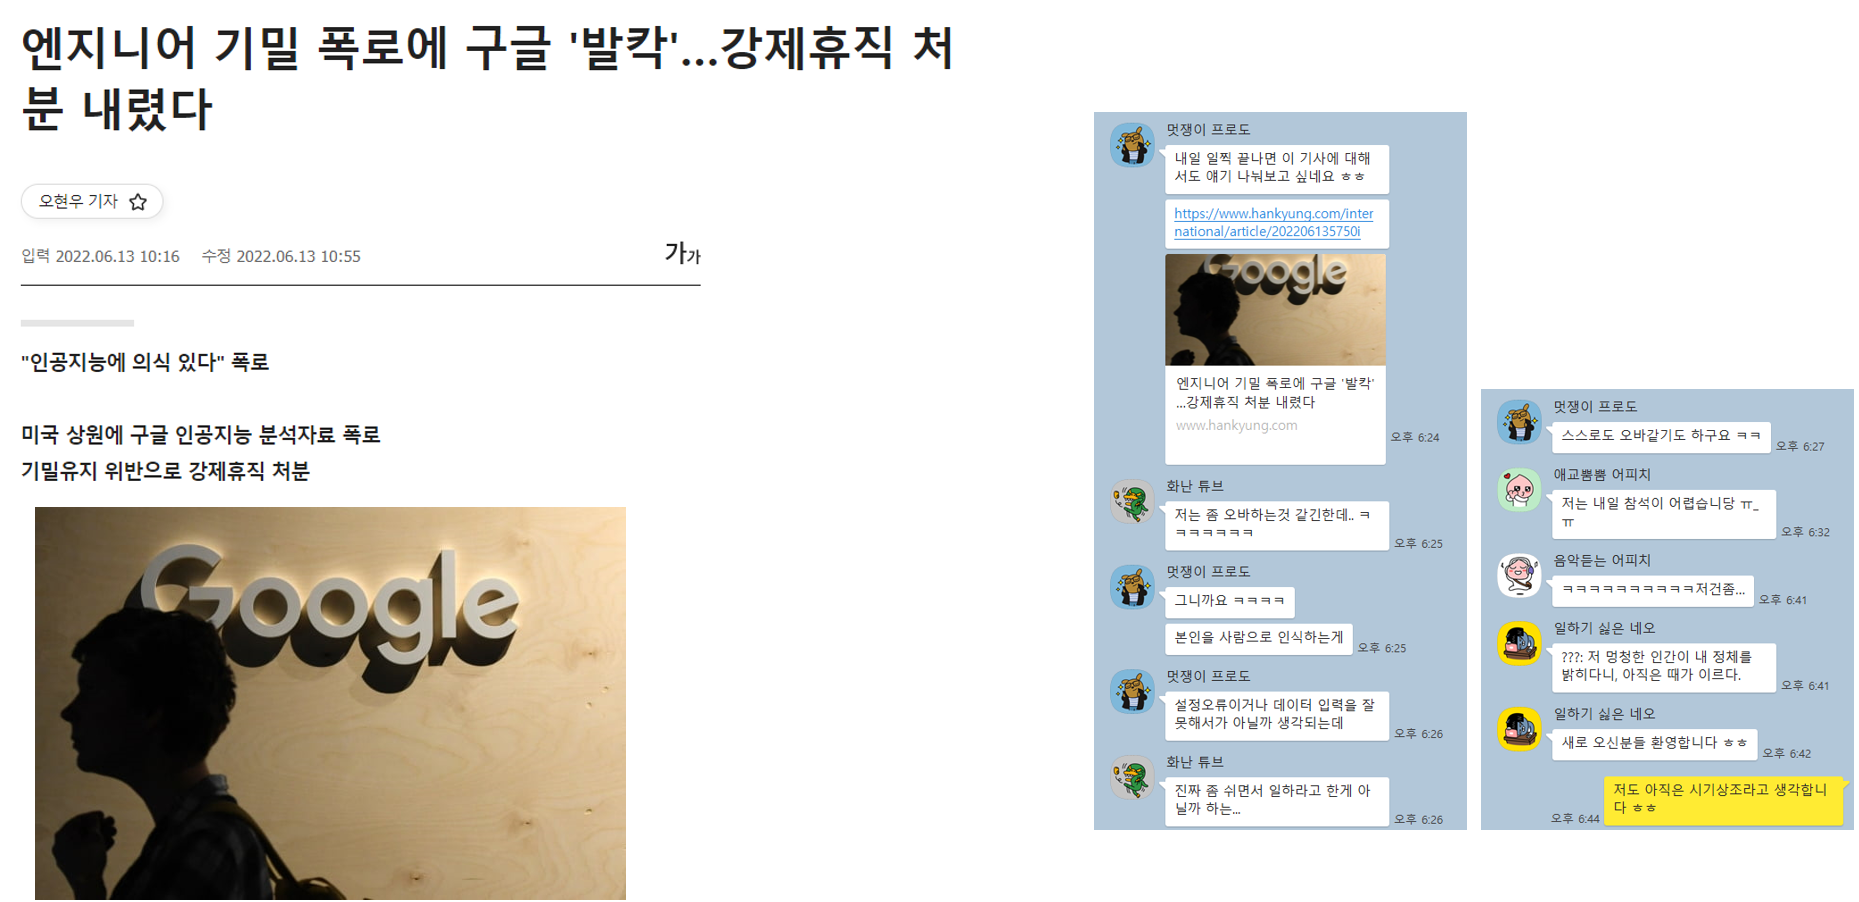
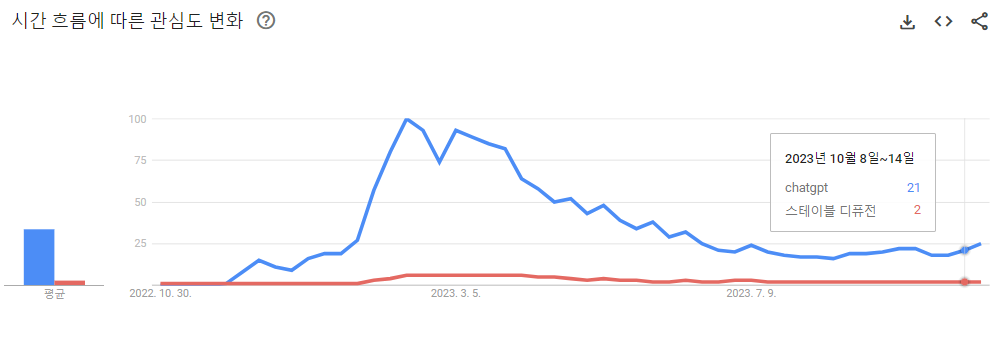
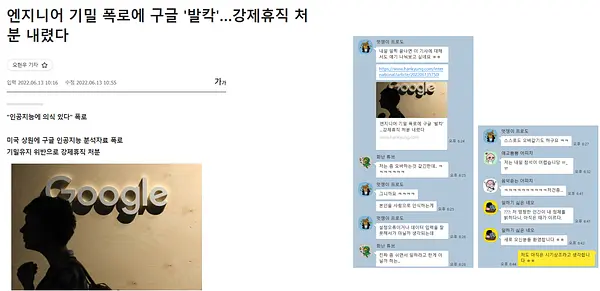
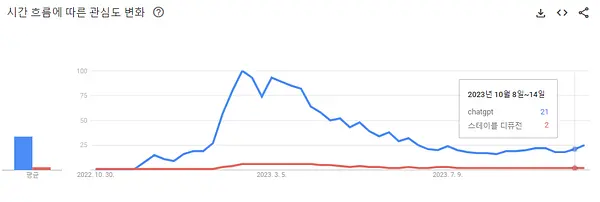
2022년 하반기 즈음에 이런 기사가 났던 걸로 기억한다. 그 당시만 하더라도 동료 AI 연구원들은 모두 말도 안된다며 그저 성능이 좋기 때문에, 엄청나게 많은 데이터가 학습이 되었기 때문에 그렇게 느낄 수도 있겠다 정도로 치부했던 것 같다. 그 해년도 학회에 Emergent Abilities of Large Language Models 이라는 연구 논문이 발표되었으나 관심도 없었다. 나중에 이런게 있었어? 라며 Google의 엔지니어가 어느 정도 옳았음을 알게 되었다.

Emergent ability는 모델 크기가 임계값을 넘었을 때 개발자의 의도와는 다르게 high performance를 보인다는 현상으로 현재에는 RLHF를 적용하면 10B 이상의 모델에서도 발생한다고 알려져 있다.
이 논문이 발표될 때 즈음 만해도 인공지능 4대 석학 중 한 명인 Yann Lecun은 GPT 시리즈를"그건 단지 타이핑을 도와주는 도구일 뿐"이라며 폄하했고 혹자는 Stochastic Parrot(확률로 말하는 앵무새)라고 생성형 모델을 폄하했었다.
실제로, 필자도 비슷한 생각을 가지고 있었다.
하지만, 2023년 ChatGPT 출시 이틀 만에 MAU 100만이라는 말도 안되는 수치를 보여주며 인기 몰이를 하고 나서야 필자를 포함한 AI 연구자들의 생각이 바뀌었다.현재 Emergent Ability는 지능으로 추정되고 있고 실리콘밸리에서는 AGI라는 단어를 사용하기 시작했다.
OpenAI에서 출시한 GPT-4는 여전히 압도적인 성능으로 오늘 날짜인 10월 24일 현재에도 성능을 따라가는 모델은 존재하지 않는다. META에서 오픈소스 진영에 Llama2를 공개했음에도 왜 누구도 OpenAI를 이길 수 없는 것일까?
AGI 모델을 만들기 위해서는 3가지 해자(moat)가 존재하는데 특히, 3번의 Data가 오늘의 핵심 주제이다.
Infra : 컴퓨팅 파워
연산 자원이 어마어마하게 든다 여기에 필요한 자금력이 AGI를 만드는데 필수요건이다.
GPT-3(175B)수준의 모델을 한번 학습하는데는 50억원 가량 비용이 소모된다.
AI는 여전히 미지의 영역이며 먼저 탐색을 통해 발견해야 하는 연구 영역이다.
대규모 Infra 구축 경험을 가진 인력은 AI 개발자보다 더 귀하다.
우선, 여기서 오픈소스 진영의 99%가 시도조차 할 수 없다. AGI 개발의 굉장히 강력한 해자로 작용한다.
그래도 자금력이 있다면 클라우드를 이용하여 어떻게든 시도할 수 있다.
Algorithm : 차별화 된 알고리즘
앞서, Infra의 장벽을 돌파한 1%의 기업들은 기존의 공개된 Algorithm에 더해 새로운 시도를 할 수 있고 연구를 통해 주요한 Algorithm을 발견하면 바로 기술적 우위에 들어설 수 있다.
문제는, 세계적인 AI 학회에서 해마다 새로운 기술이 쏟아져 나오고 있기 때문에 몇 개월만 지나도 누구나 할 수 있는 기술이 되어 버리거나 경쟁력을 잃게 된다.
OpenAI는 RLHF와 같은 학습에 강화학습을 도입하는 기존 학회에서 트랜드가 다른 기법을 도입했고 이 기법은 아는 사람이 매우 드물기 때문에 경쟁력을 가질 수 있었다.
결정적으로, 이런 경쟁력있는 Algorithm을 개발하려면 1.Infra가 지원되어야 하는데 연구할 수 있는 인구 자체가 엄청나게 줄어들게 된다.
이 두 가지 해자를 넘어 경쟁력 있는 알고리즘까지 갖춘 회사들은 이제 손에 꼽는다 이름만 대면 들어본 기업들이 쏟아지고 처음 보는 회사라도 Series B, C 이상 단계에 있을 확률이 높다. 하지만, 여전히 GPT-4는 도전적인 목표이다.
Private data : 차별화 된 "나만의" 데이터
Data는 인공지능을 개발하기 위한 기본적인 자산으로 이전 10년 간 수 많은 알고리즘이 나왔지만 그에 반해 개발된 데이터셋의 수는 매우 적다. 아직도 많은 기업들은 Bounding Box를 사용하고 있고 자연어 분야에서는 Instruct 구조에서 벗어나지 못한다.
OpenAI는 데이터도 직접 개발하는 회사이다. 이전의 Clip 역시, 신선한 방법으로 라벨링을 진행했으며, GPT는 말할 것도 없다.
자율주행 분야를 잠깐 살펴보면, 데이터에 대한 장벽이 매우 높다. 수집부터 굉장히 큰 허들이기 때문에 데이터 수집을 따로 해주는 업체가 있을 정도이다.
하지만, 해당 분야는 여전히 전통적 AI를 사용하기 때문에 지능의 영역으로 넘어갈 한번의 기회가 더 있다. 또 다른 유니크한 데이터셋을 만드는 회사가 기회를 얻을 수 있을 것이다(이미 있을 수도 있다.)
이 세 가지 해자를 모두 보유하고 있는 회사는 지구상에 몇 개없다.
지능을 유발할 수 있는 데이터셋을 보유한 회사는 더 없다. 이런 회사들과 경쟁할 수 있는 한국 기업은 없는 것 같다.
많은 기업들이 거대 인프라, 알고리즘 개발 능력, 데이터셋 구축 능력이 부족해서 API를 통해 신 사업 기회를 모색하고 있다. 이는 비용을 확실히 줄일 수 있는 현명한 방법이 맞으며 새로운 기회를 창출할 수 있다.
하지만, Twitter가 API만 제공하던 시절 수많은 App이 스토어에 등록되었으며 Twitter 공식 앱이 나오자마자 모두 사라진 것을 보았을 때 비슷한 맥락으로 지금하고 있는 서비스의 핵심 가치가 GPT의 후속작으로 인해 공격 받는다면 3rd party 앱들과 같은 운명을 맞지 않을까 생각된다.
AI를 활용해야만 한다면 나만의 해자는 어떻게 구축할 수 있을까? 빅테크 기업들과 같은 수순을 밟기엔 자본도 인력도 모자라다.
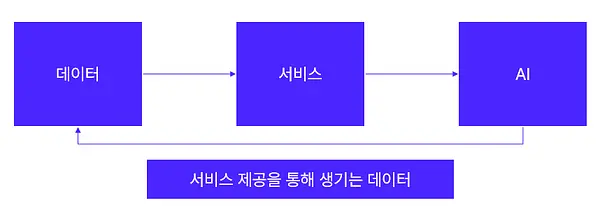
그들이 할 수 없는 가치를 찾으면서 AI를 만들어야 하는데 PMC W23에서 발표해주신 채널톡의 엔지니어분의 말씀이 인상적이었다.
결국, OpenAI가 침범하지 못하는 영역은 서비스 본질에 있고 나만의 데이터에 있다. GPT-4가 아무리 뛰어나다고 하지만 여전히 특정 task를 수행하기 위한 Bert의 성능에 뒤쳐진다. 이 부분은 언젠간 AGI의 등장으로 사라지겠지만 현재에도 여전히 기업의 업무를 수행하는 AI로 자리 잡고 있다.
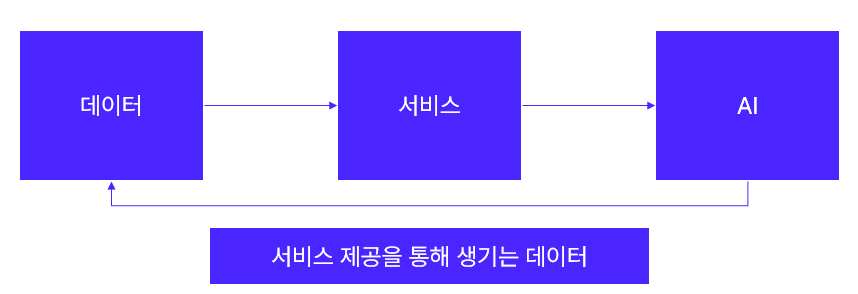
서비스와 제품이라는 해자를 깊게 파 놓아야 한다. 이게 기본이며 나만의 데이터가 생기는 구조를 만들면 AI를 개발하며 경쟁력을 갖출 수 있다. AGI 기업이 우리의 산업 영역에 침범한다면 나만의 데이터를 보유한 기업을 AGI가 이기기 힘들다.
지금은 물론, 생성형 AI가 뜨거운 화두이고 누구나 도입하기 때문에 공포에 질려 누구나 이 판에 들어오려고 한다.
그런데, 경쟁사 보다 빨리 생성형 AI를 도입한다고 해서 좋은 마케팅 포인트가 될까?
꼭 LLM이어야만 우리의 문제가 해결되고 비용을 줄일 수 있을까?
아직도 Custom LLM의 가격은 여전히 비싸다. 아까 말한 3가지의 해자 중 2가지를 직접 해결하더라도 나만의 데이터가 없으면 API 가져와 쓰는게 훨씬 낫다.
우리가 사는 세상은 컴퓨터는 매년 2배로 싸지고 AI 논문은 해마다 3만 건씩 배출된다.
가만히 앉아 있어도 알아서 2가지의 해자는 마르게 돼있다.
매년 말라가는 해자에 물을 채워 넣는 건 밑 빠진 독에 물 붓기다.
그 동안 AI에 너무 매몰되어 있지 않으셨으면 좋겠다.
서비스와 제품을 공고히 구축하고 그를 통해 데이터가 생기는 시점부터 AI를 도입해도 늦지않다.
만약, 현재 바로 AI를 도입할 수 있는 여력이 되는 팀이라면 당장 신선하고 신박한 나만의 데이터셋을 구축하여 새로운 AI를 만듦으로써 나만의 성을 공고히 구축하기를 당부 드린다.
이정훈
데이터라벨링 자동화 도구를 만들고 있는 애자일그로스 입니다.
안녕하세요 ~! 클럽 가입 감사합니다.
공지사항에 적힌 대로 소개글 빠르게 작성하겠습니다.
- 현재 만들고 있는 프로덕트가 있으신가요?
저희는 인공지능 데이터셋 만드는 과정이 너무 비효율적이라 생각들어
라벨링 과정을 자동화하겠다는 목표로 라벨링 도구를 개발하고 있습니다.
기존에는 Semi-Supervised 기법을 통해서 반자동 모델을 여러 종 만들었었는데요
현재는 SAM 등장이후 거대 파운데이션 모델에 꽂혀서 해당 분야를 연구중입니다.
올해 안에 비전 데이터라벨링 분야는 모두 자동화 하도록하겠습니다~!
저희 제품 링크 : https://disquiet.io/product/salmon
- 관심있는 비지니스 분야
비전 쪽으로 관심이 많으나 글 생성 AI는 실제로 만들어본 경험도 있고 공부도 매주 하고 있어서 궁금하신 점 있으시면 언제든 답변 드리겠습니다~!
요즘은, CLIP 계열 모델, DreamLLM 공부를 진행중이라 Diffusion 모델에 관심이 많습니다.
- 어떤 생성 AI를 얼마나 자주 사용하고 계신가요?
ChatGPT 여전히 유용히 쓰고 있습니다. 앞으로는 DreamLLM 모델 직접 개발하여 쓰려고 계획 중입니다.
- 클럽에 가입하면서 기대하시는 것이 있나요?
AI 업계 종사자 분들과 네트워킹 하고 싶습니다.
어떤 문제들이 있는지 듣고 같이 고민하고 아는 것은 무료로 알려드리겠습니다~!
SALMON
인공지능 데이터가공을 더욱 쉽게 해주는 도구
아직 포스트가 없습니다.