Jae Hwan Jeong
여러분들도 알다시피 디스콰이엇에서 최근에 팔로우 기능을 배포하였어요!
이번 기회에 팔로우 기능을 같이 개발하면서 고민해 보았던 부분들, 그리고 이번에 사용 되었던 Redis 의 향후 활용 계획등을 정리해 보려고 합니다. 이 글의 경우 "피드"에 대해서 더 중점적으로 얘기해 보려고 해요.
Motivation
저희는 팔로우 기능에 앞서 좀 더 개인화 된 피드에 대해 고민해 보았어요. 유저별로 더 관심이 갈 만한 포스트들을 피드 상단에 정렬해 놓는다 던지, 우선적으로 보고싶은 메이커의 포스트를 위에 놓는다 던지, 혹은 보고 싶지 않은 유형의 글들을 필터링 할수 있게끔 한다 던지. 정말 많은 기능들이 있었습니다. 하지만 논의 끝에 팔로우 기능을 구현 한다면 활발하게 활동하는 메이커들에 대한 보상체계를 만듦과 동시에 관심있는 메이커의 포스트들만 정리해서 볼수 있는 피드를 일차적으로 구성할수 있다고 판단했어요.
저희가 얘기해 보면서 나온 피드의 종류는 크게 2가지가 있었던것 같아요:
- 팔로잉 피드
- 추천 피드
추천 피드의 경우 흔히 LinkedIn 이나 Facebook 과 같은 플랫폼에서 활용하는 특정 score 에 기반한 포스트 정렬을 생각했어요. 이러한 추천 피드의 경우 먼저 노출되어야 할 포스트가 유저의 활동에 따라 실시간으로 변할 뿐만 아니라 동시 다발적으로 일어나는 유저간의 interaction 에 따라서 정말 많은 포스트들의 respective score 가 바뀌는게 특징이죠.
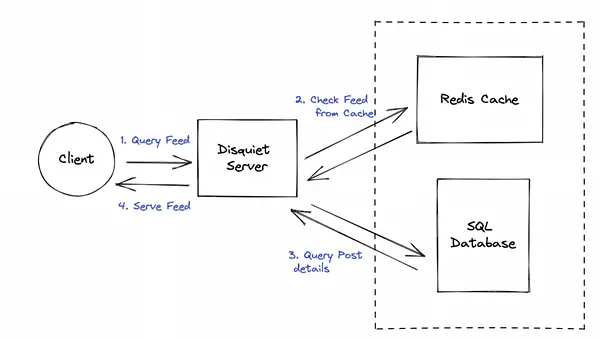
근데 다양한 피드를 조회 하려고 할때 마다 DB 에 있는 포스트들을 동적으로 정렬한다는 것은 너무나도 비효율적이였어요. 특히 아직 배포하지 않은 추천 피드의 경우 유저의 활동에 따라서 포스트의 relevance score 가 자주 바뀌게 되는데 그런 연산을 쿼리 시점에서 하는게 더더욱 비효율적이였죠.
Redis & ZSET
그래서 저희는 유저 별로 사전에 정렬된 피드를 가지고 있는게 좋을거 같다고 생각했고, 큰 소셜 플랫폼들에서 활용 하는 push 모델의 피드 (Fan-out-on-write) 와 pull 모델의 피드 (Fan-out-on-load) 를 둘다 수용할수 있는 Redis 기반의 피드 구현을 생각해 보았어요.
기존의 PostgreSQL 만으로도 충분히 피드 구현이 가능하지만, 추후에 실시간으로 업데이트가 되는 피드의 경우 Redis 에서 제공하는 ZSET 이 너무나도 적합하다는 생각이 들었어요. ZSET 의 경우 KEY , VALUE , 그리고 SCORE 라는 필드를 활용하는데 각 KEY 에 해당하는 SET 마다 SCORE 에 따라서 알아서 정렬이 되게끔 설계되어 있어요 (흔히 게임 플랫폼들에서 플레이어들의 랭킹을 관리할때 Redis 의 ZSET 을 많이 활용 한다고 해요!).
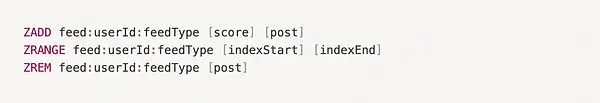
ZSET 으로 피드를 관리 하기 위한 커맨드는 아래 3개만으로 충분합니다:
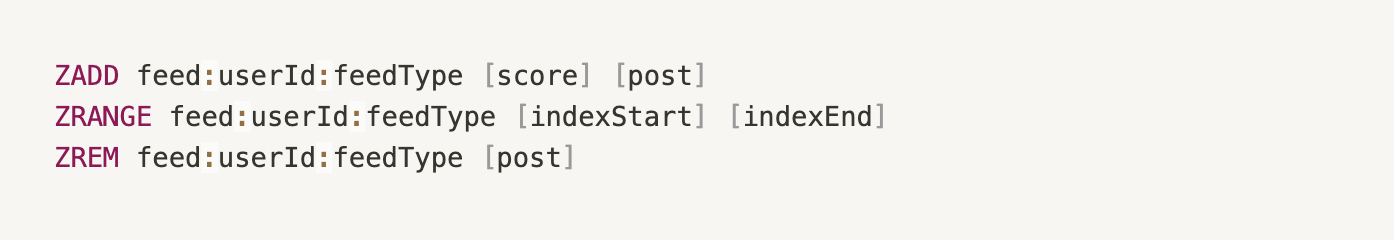
클라이언트에서 특정 feedType 을 요청 하게 될 경우 ZRANGE 혹은 ZREVRANGE 로 해당 피드를
O(log(n) + n) 의 시간으로 불러올수 있게 됩니다! 필요의 경우 ZRANGEBYSCORE 같은 커맨드로 특정 SCORE 범위에 있는 포스트들만 불러올수도 있죠.
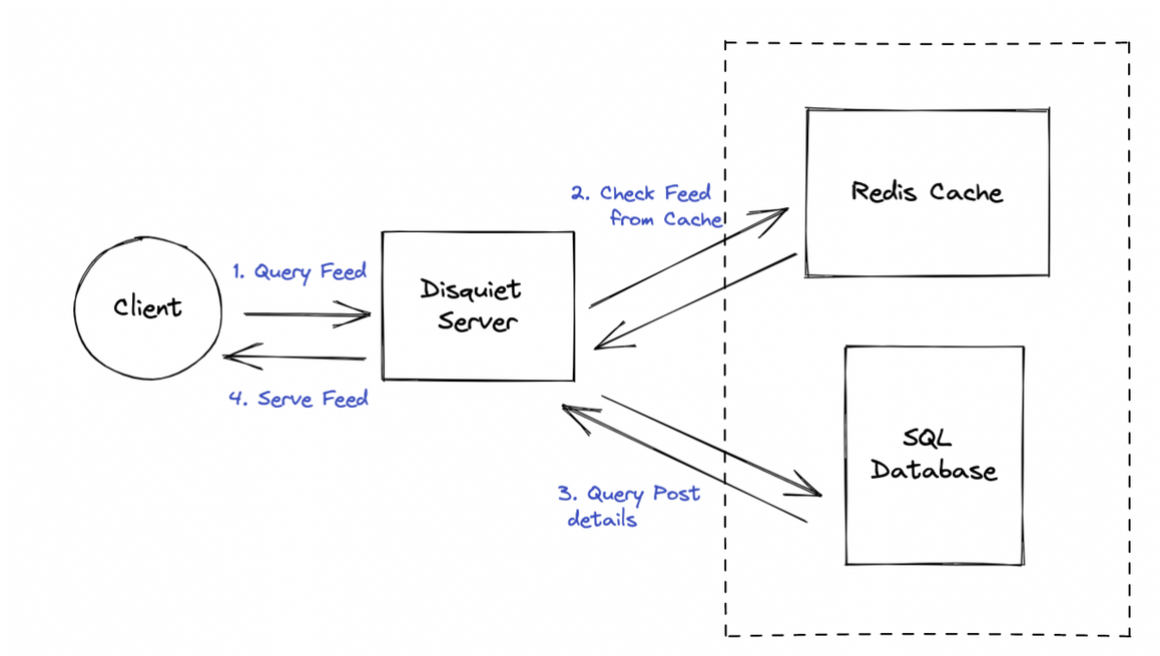
ElastiCache 환경
Redis 가 in-memory 데이터베이스이다 보니까 정말 빠르다는 장점이 있지만, 그만큼 관리 포인트들도 적지 않아요. Redis의 한 “클러스터” 안에는 master node 들과 이들의 복제본인 replica node 들이 존재해요. 마스터 노드들 은 key들을 분산해서 저장하기 위해 서로 소통을 해야되고, master node 에 문제가 생겼을때 replica node 가 데이터 베이스 복원을 도와줘야하기에 master 와 replica 간의 통신도 필요하죠.
하지만, 클러스터가 운영되는 네트워크에 문제가 생기게 되었을때 network partition 으로 인해 클러스터 안의 노드들이 서로 소통을 하지 못하는 문제가 생기게 되는데, 이때 redis 는 처음 설정해 놓은 master node 만큼을 유지하려고 replica node 를 master node 로 “승진” 시키는 작업을 거치게 되요. 이때 나올수 있는 문제가 split-brain problem 이라는 문제에요!
Elasticache 를 통해 Redis 를 운영하게 되면 위에서 일어나는 네트워크 문제나, key re-distribution에 더 잘 대응할수 있고, 저희의 경우 이미 대부분의 인프라가 AWS 클라우드를 통해서 운영되고 있어서 Elasticache 를 통해 feed 를 위한 Redis를 호스팅 하게 되었어요.
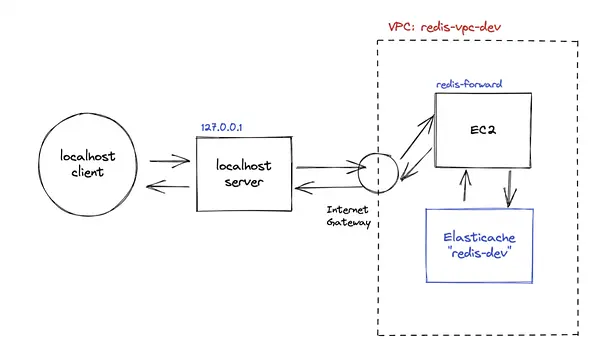
Elasticache를 통해 개발 환경을 만들 경우 주의 해야될 점이 있어요! 바로 Elasticache가 돌아가는 VPC 안의 리소스들만 Redis 의 configuration endpoint 에 접속할수 있다는 점이죠. 저희의 경우 아직은 로컬 환경에서의 개발이 필요했어서 “bastion server” 를 통해서 위 문제를 해결했어요:
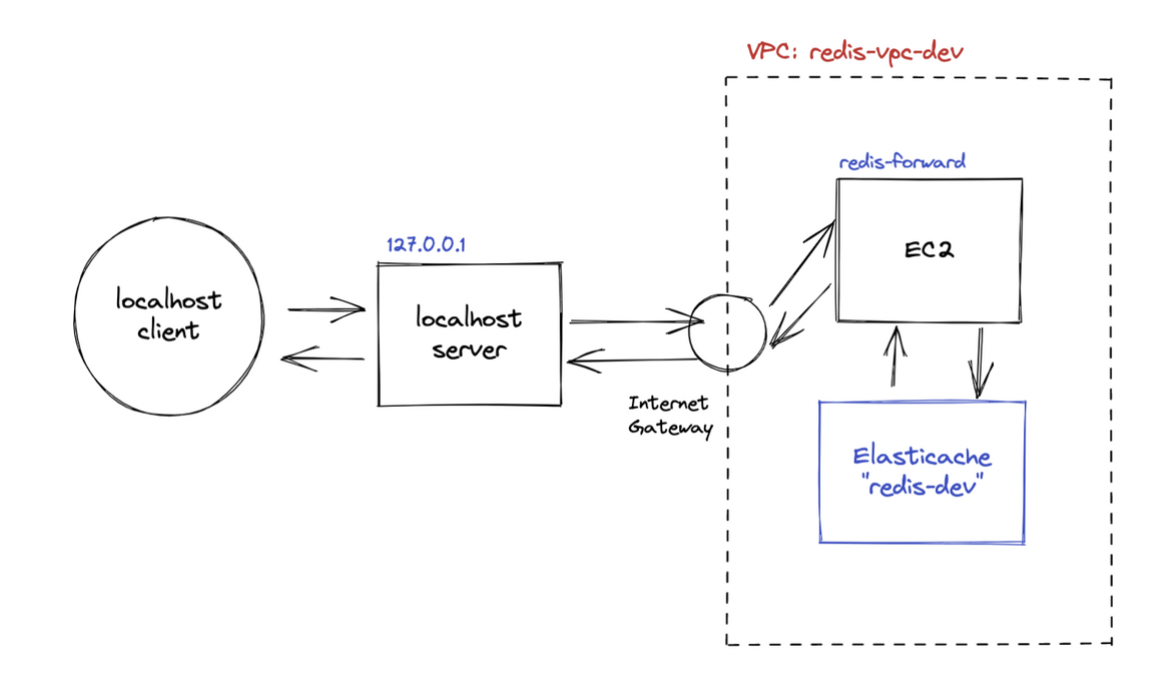
직접적으로 Redis cluster 와 통신을 할수 없기에, internet gateway 와 연결된 EC2 를 활용한 port forwarding 을 통해 개발 환경을 구축 할수 있었어요. Production의 경우 저희 서버가 Elasticache 와 같은 VPC 에 해당하는 subnet 에서 운영되고 있기에 별다른 configuration이 필요하진 않았어요.
대략적으로 저희 피드 구현에 대한 생각과 개발 내용들을 얕게나마 정리해 보았는데, Build-In-Public 을 지향하는 팀으로써 앞으로도 개발적인 내용을 더 많이 공유해 볼까 해요. 지금 현재는 팔로잉 하는 메이커들의 포스트만 볼수 있지만 앞으로는 더 다양한 피드들을 제공함에 있어서도 Redis를 적극 활용할거 같습니다!
다른 메이커 분들도 프로덕트를 만들면서 고민하셨던 개발적인 요소들을 많이많이 공유해 주시길 기대할게요!
디스콰이엇
IT 프로덕트 메이커들을 위한 소셜네트워크