양우석
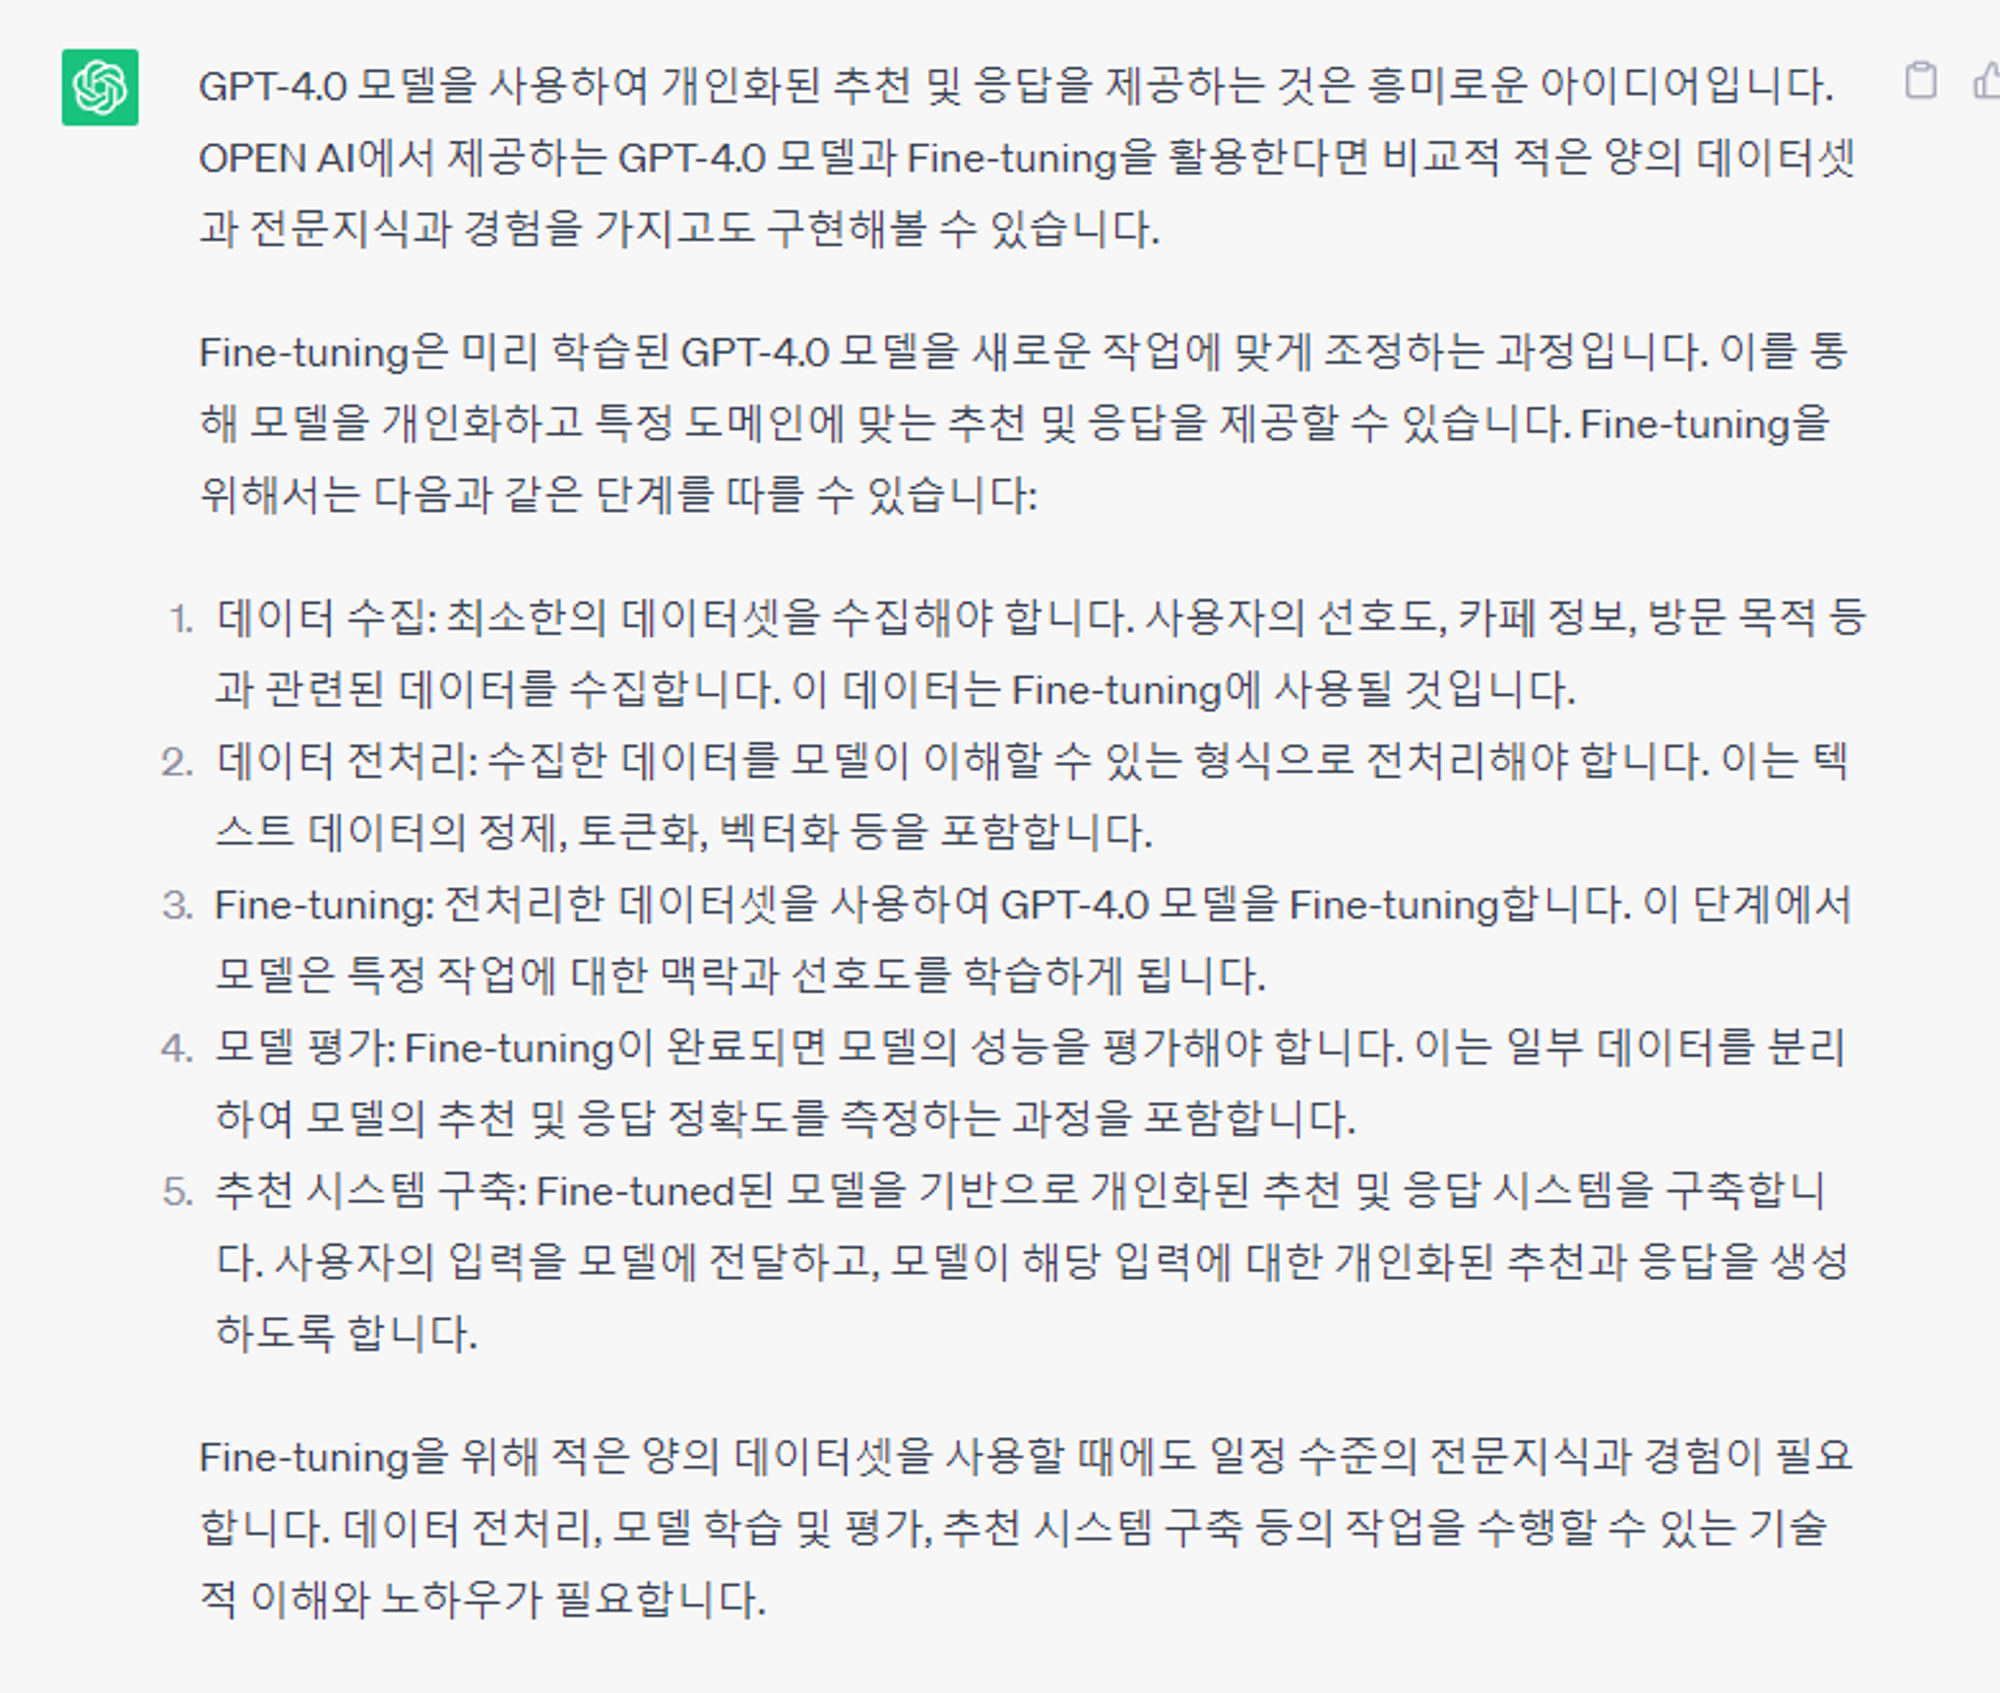
(2) AI는 처음인데, GPT로 카페 추천 서비스를 만들 수 있을까?
AI와 관련된 지식이 거의 전무한 상태.
ChatGPT API로 추천 시스템을 구현하는 정보들을 접하고는 프로그래밍은 익숙하니까 빠르게 만들고 싶다는 마음에 바로 예시를 따라 진행을 했었어요.
순조롭게 진행되는 듯 했지만 특정 부분을 응용하는 부분의 코드가 있을 때 막혔고 삽질을 계속하며 진행이 안됐었네요. 결국 이 문제를 해결해려면 역시나 최소한 기초적인 용어와 구조에 대한 이해가 필요하다고 느꼈고 기본이 중요하다는 걸 다시 한번 생각하게 됐네요.
OpenAI 공식 문서를 처음부터 천천히 읽어나갔어요. 그러다보니 설명과 예시가 정말 잘 되어있는데, 왜 이걸 볼 생각을 안 했는지… 하나씩 따라해 보았습니다.
Hello ChatGPT
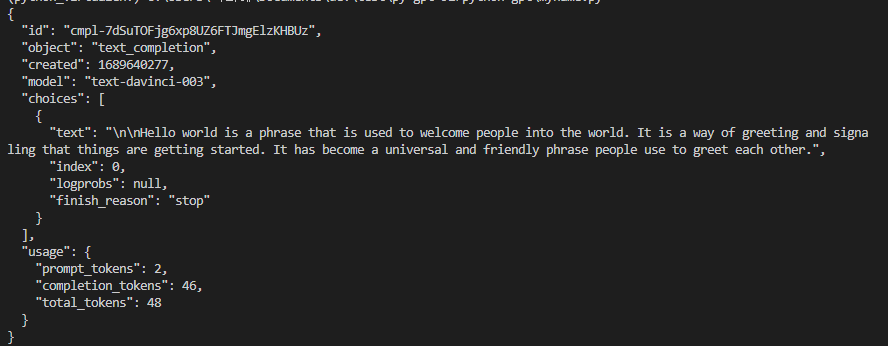
시작은 개발하면 처음 hello world를 해보듯 chatgpt에게 인사를 건내봅니다. API 연결이 잘 됐네요.
😏
Fine-tuning
파인튜닝에 대해서 잘 와닿지 않았었는데, 좀 찾다보니 그제서야 조금씩 이해가 되네요.
OpenAI 에서는 “to customize a model for your application.”
구글로 검색해보니 “특정 도메인이나 작업에 맞게 조정하여 보다 정확하고 관련성 높은 출력을 생성할 수 있도록 하는 것”
ChatGPT는 GPT-3.5 모델 중 하나로 fine-tuned 된 것이라고 합니다.
스님 AI를 만들고 싶다면 팔만대장경을 학습시켜서 불교 도메인에 특화된 모델을 만들 수도 있다는 것.
⇒ 카페 추천 AI를 만들고 싶다면 관련 데이터들을 학습시켜 카페 도메인에 특화된 모델을 만들 수 있을 것
검색 중에 nodejs 예제를 찾을 수 있어서 편하게 테스트 해볼 수 있었습니다. 다만 1000개 정도의 데이터를 학습시켜서 해볼려했는데, 생각보다 시간이 많이 걸려서 취소했네요.
(예제 링크)
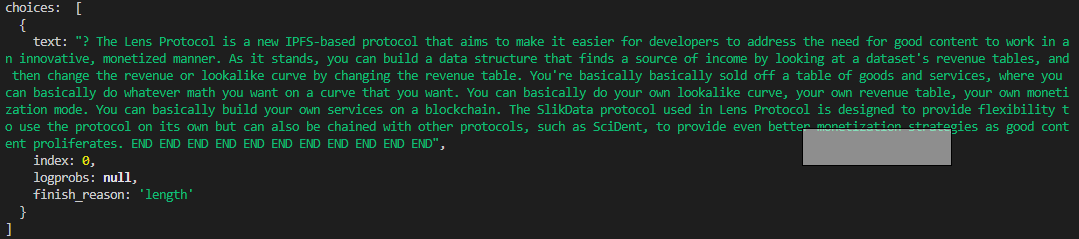
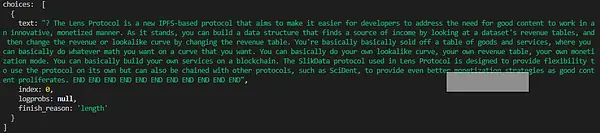
예제로 학습한 model에게 “What is Lens Protocol”로 질문한 결과
*** 공식사이트에서 확인해보니 파인튜닝을 곧 GPT4에서도 할 수 있게 될 것 같네요. 굿굿***
2023년 7월 6일에 ada, babbage, curie, davinci 모델의 사용 중단을 발표했습니다. 미세 조정 버전을 포함한 이러한 모델은 2024년 1월 4일에 사용 중지됩니다. 업그레이드된 기본 GPT-3 모델과 GPT-3.5 터보 및 GPT-4에 대한 미세 조정을 활성화하기 위해 적극적으로 노력하고 있으며, 곧 사용 중단될 모델을 기반으로 미세 조정을 수행하기보다는 새로운 옵션이 제공될 때까지 기다리시기 바랍니다.
Embedding
임베딩에 대해서 처음 듣고는 embedded 시스템과 관련된 건가?라는 생각을 했었어요. 완전 모르고 있었던 것이죠. 알고보니 문자열 같은 자연어를 기계가 이해할 수 있도록 숫자 형태의 vector로 바꾸는 것이었어요.
OpenAI의 텍스트 임베딩은 텍스트 문자열의 연관성을 측정하는 것.
임베딩은 부동 소수점 숫자의 벡터(목록)이며, 두 벡터 사이의 거리는 두 벡터의 관련성을 측정. 거리가 작으면 관련성이 높고, 거리가 크면 관련성이 낮음.
이 거리는 주로 코사인 유사도(cosine similarity)라는 것을 사용.
검색, 추천, 분류하기 등에 사용됨
⇒ 뭔 말인지 처음엔 이해가 안 갔으나 여러번 읽고 코드로 두드려보면서 이해했네요. 😂
검색 (semantic text search using embedding)
일하기 좋은 카페
강남 스패셜티 커피
성수동 시그니처 음료
embedding을 이용한 검색은 위와 같은 예시처럼 input을 넣으면 헤당 검색어와 가장 관런된 데이터를 비교해서 찾아올 수 있다는 것이네요.
OpenAI 문서 Embedding의 Use Case 중에서 Text search using embeddings을 참고 했었고 데이터는 해당 샘플과는 다른 영화 데이터를 사용해봤습니다. ****
아래는 영화 샘플 데이터 1000개 사용하였고, "Are there any movies about heros?” 라고 질문을 던졌을 때 응답입니다.
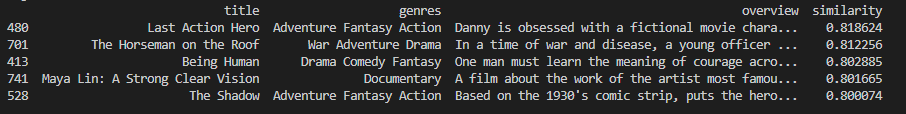
예상하는 데이터가 맞는지 다 읽어보고 확인 해봐야하는데, Hero, Action, Fantasy, Adventure 등의 단어를 대략 확인하고 잘 나왔을거라 예상했습니다. 일단 잘 돌아가니 카페 데이터로 확인해볼 때 좀 더 많이 테스트 해보려 합니다.
추천 recommandation
특정 게시물
제품 상세페이지
리뷰
예를들어 특정 게시물을 클릭해서 보고있는데 다 본 후 유사한 게시물 3개정도 알려주고 싶을 때, embedding을 사용해서 유사도를 통해 거리(Distance)를 구함으로서 추천해줄 수 있네요.
OpenAI 문서의 Embedding Use Case 중에서 Recommendations using embeddings을 참고했었고 데이터는 해당 샘플과는 다른 영화 데이터를 사용해봤습니다.
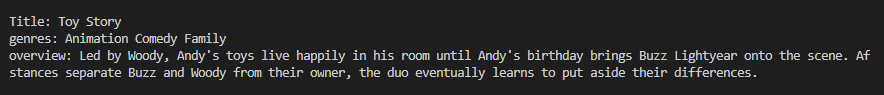
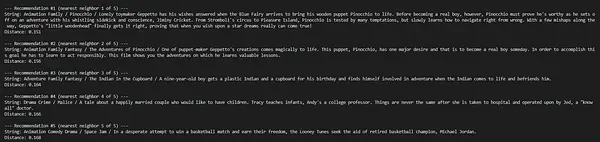
아래는 영화 데이터 중 토이스토리(Toy Story)의 제목(title) + 장르(genres) + 개요(overview)를 embedding 한 것을 다른 영화 데이터들과 유사도를 비교한 후 거리(Distance)가 가까운 순으로 출력되게 했습니다.
비교할 대상 (제목: 토이 스토리 / 장르: 애니메이션 코미디 패밀리)
추천 순 나열 (Distance 작을 수록 유사함)
애니메이션 가족 / 피노키오 / Distance: 0.151
애니메이션 가족 판타지 / 피노키오의 모험 / Distance: 0.156
모험 가족 판타지 / 찬장 속의 인디언 / Distance: 0.164
드라마 범죄 / 악의 / Distance: 0.166
애니메이션 코미디 드라마 / 스페이스 잼 / Distance: 0.168
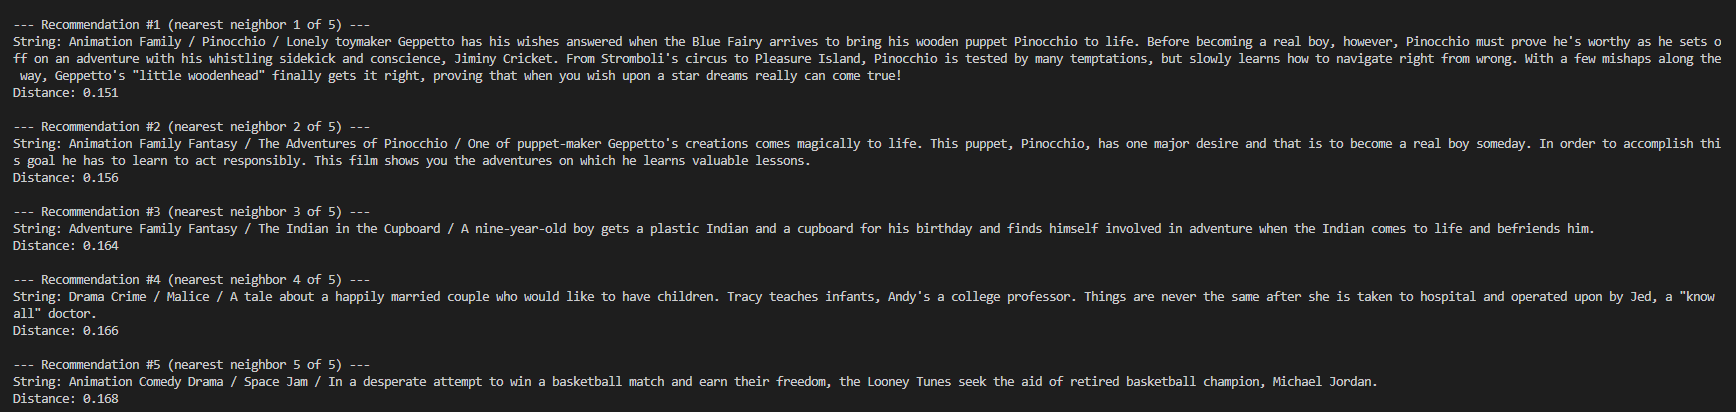
1번이 가장 비슷한 것 같고, 2, 3까지는 괜찮은데 4번은 좀 아닌 것 같군요.
그래도 괜찮은 결과인 것 같습니다.
이전에 추천 시스템을 만들어 본적이 없어서 semantic search와 recommandation 부분이 무슨 차이인지 헤깔렸어요. 근데 fine-tuning, sematic search, recomandation 예제들을 사용해보면서 어느정도 명확하게 구분할 수 있게 되었네요.
다음번에는 약 200개 정도의 카페 데이터를 모은 걸로 태그 라벨링을 구성하여서 fine-tuning, sematic search, recomandation 등을 테스트 해보려고 합니다.
혹시 구글이나 네이버 지도 등에서 검색하여 찾고싶은 카페가 있으셨다면 댓글 남겨주주세요. 테스트 해보고 결과도 알려드리겠습니다. (데이터는 얼마 없지만요…)
어떤카페
당신이 원하는 완벽한 카페를 찾아주는 AI 카페 맵