프로덕트

아티클

전체 보기
정주영

정주영

GPT-4 출시에 대한 소문과 진실

GPT-4는 출시 전부터 큰 파장과 관심을 일으키고 있다. 그럴만한 한것이, 아직도 다양한 사업적 영감과 흥미로운 use-case를 공유하고 있는 GPT-3, Chat-GPT보다 한단계 발전된 모델이기 때문이다. (더 발전하면 도대체 어떤 모습일까..?)

OpenAI의 ChatGPT가 성공적으로 흥행함으로써, ChatGPT를 뒤이을 차세대 기술에 대한 관심이 큰것은 당연한 것 같기도 하다. 뿐만아니라, 실질적으로 체험하고 놀라움을 느낄 수 있는 인공지능 기술이 대중화된 사례들이 2022년에 워낙 많이 일어났다 보니, 미래에 대한 상상력도 점차 과감해지는 듯한 모양새다.

이번 포스팅에서는 GPT-4 출시에 대한 다양한 추측과 소문을 정리해보고자 한다.


튜링 테스트를 통과하다?

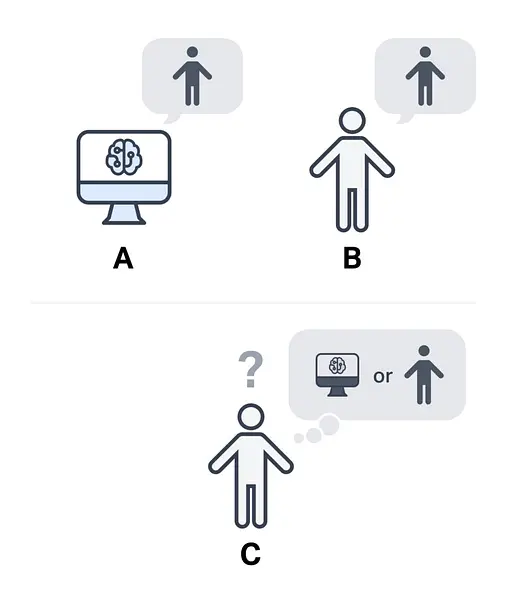
튜링 테스트는 기계가 인간 수준의 지능이 있는지 가려내기 위한 고전적이고 가장 유명한 방법중에 하나다. 1950년 앨런 튜링(Alan Turing)이 공개한 논문 <컴퓨터 기계와 지능> 에서 처음 소개한 개념으로, 스스로 사고 할 수 있는 강한 인공지능을 판별하기 위한 테스트로 설명하고 있다. 
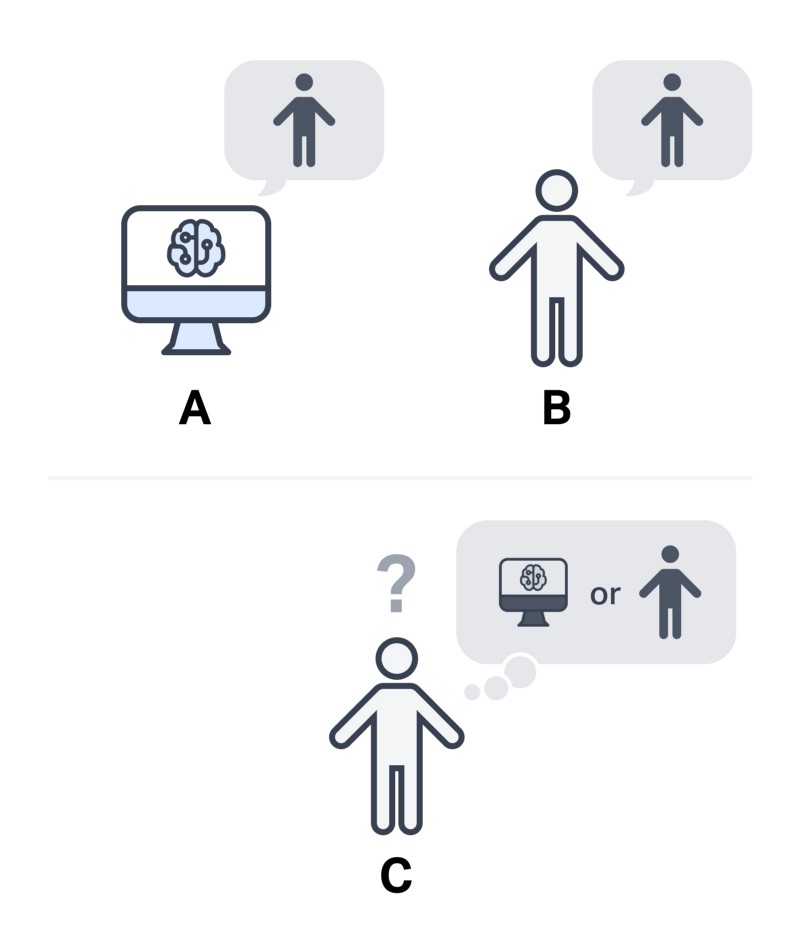
튜링테스트에 대한 간단한 설명 C가 심사위원!


(이후 포스팅에서는 인공지능이 자아를 가졌는지 판단하기 위한 실험들을 다루어봐도 재미있을것 같네요..)

튜링 테스트는 기계인지 사람 인지를 감별하는 심사위원과 심사의 대상이 되는 인간과 기계(인공지능)을 다른 공간에 배치하고, 텍스트로 대화를 나눈후, 30% 이상의 심사위원이 기계와 인간을 구분하지 못한다면 기계가 지능을 가졌다고 판단하는 실험이다.
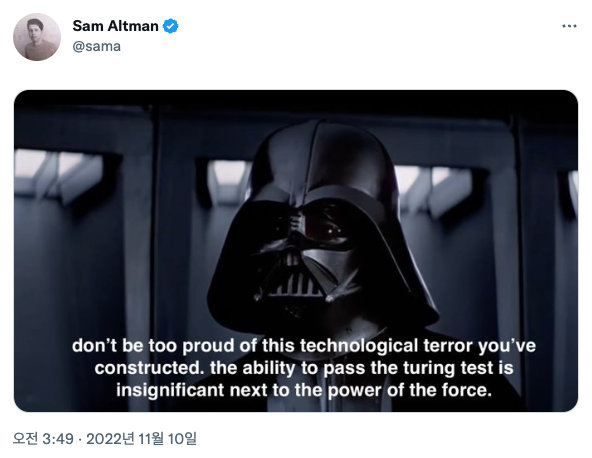
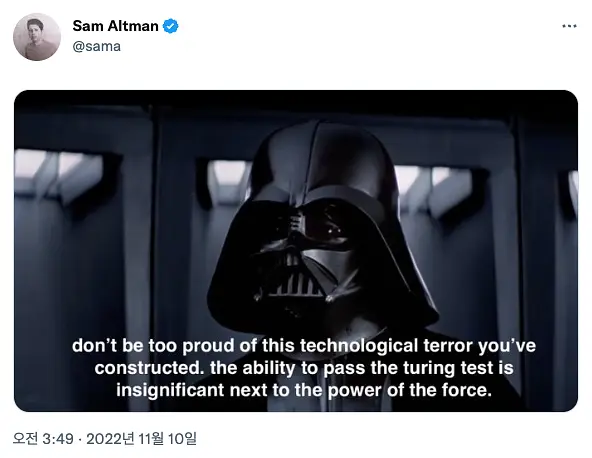
OpenAI의 CEO인 Sam Altman은 최근 자신의 Twitter를 통해 Turing Test 벤치마크 에 대한 밈을 업로드했다. 혹자는, Altman이 Turing Test를 가볍게 통과한 Gpt-4가 더 이상 상상 속의 존재가 아님을 암시하는 것일까?


파라미터 Correction

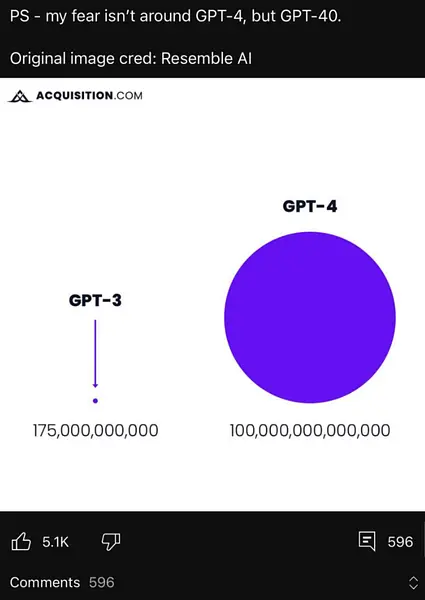
온라인 상에서 공유되는 Gpt-4에 대한 소문중 가장 유명한 것은 GPT-4에 대한 파라미터 크기에 대한 이미지다. 가장 유명한 해당 밈(혹은 진실..?)에서는 GPT-4가 학습할 파라미터의 크기가 약 100조에 달한다는 추측을 보여준다. 
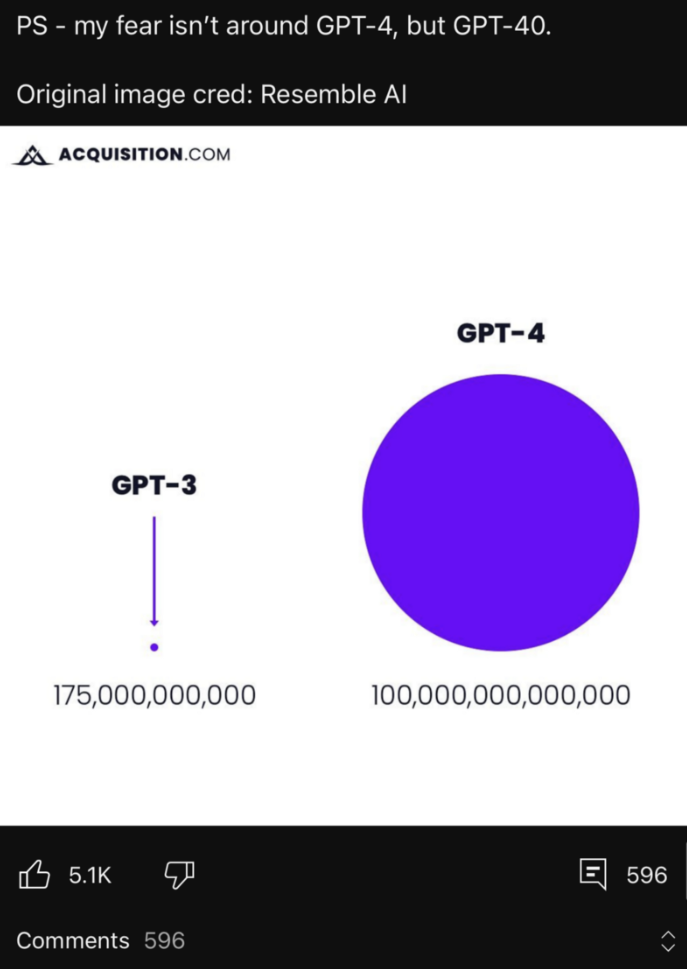
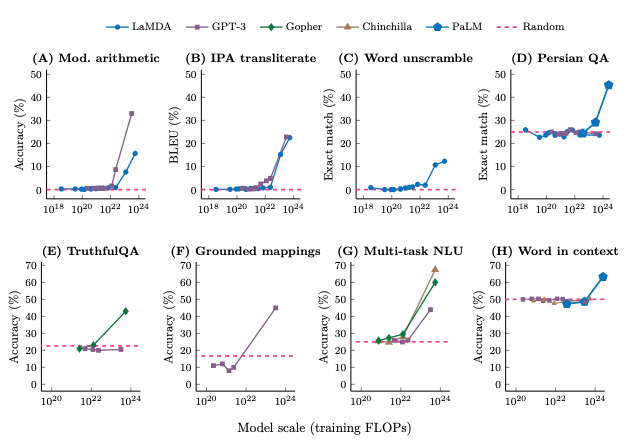
파라미터는 일반적으로 더 많은 수를 사용할 수록 모델이 데이터에서 더 복잡한 관계를 학습할 수 있게 되므로 더 나은 성능을 얻을 수 있다는 방정식이 성립되왔다. 모델의 파라미터 수는 모델의 용량 또는 저장할 수 있는 정보의 양에 대한 척도이기도 한데, 파라미터 변수가 많은 모델은 용량이 더 크고 잠재적으로 데이터에서 더 복잡한 관계를 학습할 수 있다는 것이다.
어쩌면.. 진짜일지도 몰라

 반면 파라미터의 수가 너무 많으면 모델이 학습데이터에 과대 적합되어 보이지 않는 데이터에서 저하될 우려가 있다.

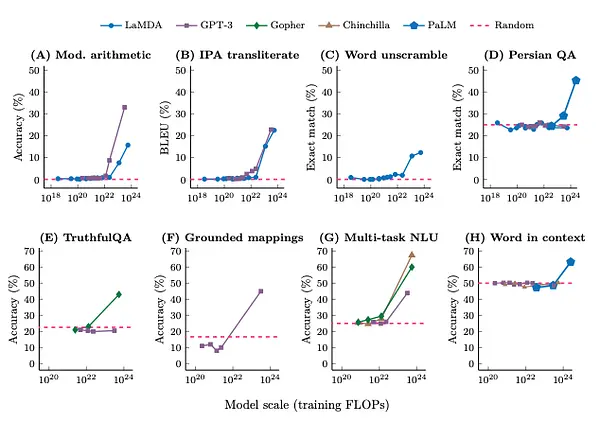
그러나, 오늘날 우리가 대형 모델(Large Model, Foundation Model)으로 호명하는 모델들은 점점 파라미터의 개수를 증가 시켜왔다. 실제로 파라미터의 크기(양)과 모델의 성능이 특정 임계점을 넘기면 비 선형적으로 증가했기 때문이다.
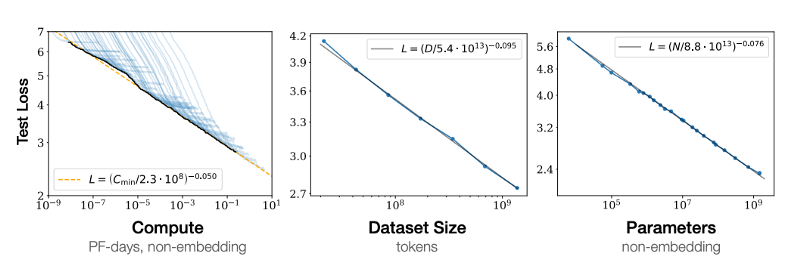
Scaling Laws for Neural Language Models- OpenAI 실제로 파라미터가 증가함에 따라 모델의 오답(loss)률이 감소함을 보여주는 차트

실제로 GPT는 1,2,3를 거치 파라미터의 크기를 증가시켜 왔다.

GPT-1은 117 Million Parameters의 크기로 학습되었다.

GPT-2 는 1.2 Billion Parameters의 크기로 학습되었다.

GPT-3는 175 Billion Parameters의 크기로 학습되었다.

이처럼 뜬 소문이라고만 여기기에는 나름의 근거가 존재한다. 근본적으로 모델의 퍼포먼스 향상에는 파라미터의 확대(or 증가)라는 관계성에 기인한 가정인 것이다. 그렇다면 이 100조라는 파라미터의 숫자는 어디서 나온 것 일까?

2021년 8월 Cerebras의 CEO인 Andrew Feldman은 Wired에 ‘OpenAI와의 대화’에서 “GPT-4의 파라미터는 약 100조개 가 될 것”이라고 말했다. 

GPT-4에 대한 Andrew Feldman의 정확한 근거를 둔 주장인지 확실치 않지만, 업계 최대의 AI 액셀러레이터 중 하나인 Cerebras에서 그의 위상 덕인지, 많은 사람들에게 GPT-4의 파라미터는 100조개 이상일 것이라는 설득력 있는 소문이 회자되게 하였다.

하지만, 얼마 지나지 않아 Sam Altman은 2022년 4월 인터뷰에서 해당 사실을 부인했다. 최근 2023년 1월 13 Sam Altman은 파라미터 100조개 이상 다이어그램 이미지에 대해 질문을 받았을때 “Complete bullshit(말 같지도 않은 말)”이라며 강하게 부정했다. 

실제로 OpenAI는 Chinchilla에서 효과가 입증된 것처럼 파라미터의 크기 대신 데이터 및 컴퓨팅 최적화에 중점을 두었다고 한다. 또한 크면 클수록 좋다라는 기존의 이론에도 Chinchilla(700억 규모 파라미터 모델)가 Gopher(2800억 규모)보다 좋은 성능을 보인다며, 학습 방식에 다각적으로 접근하고 있음을 이야기했다.
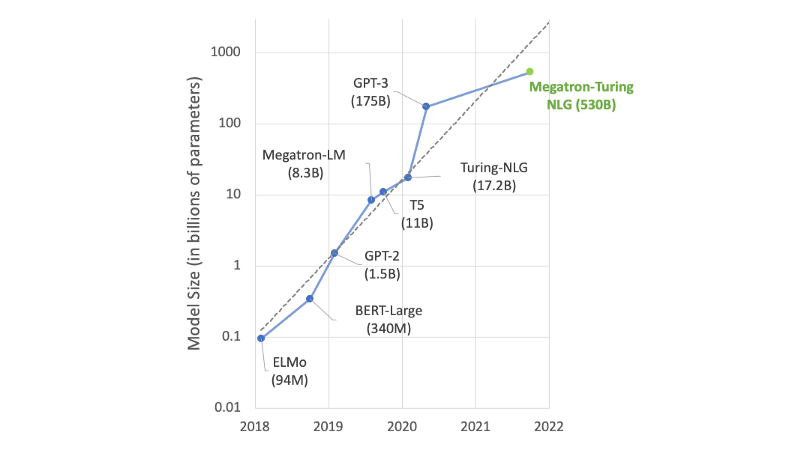
Microsoft x Nvidia Megatron-Turing NLG 530B Parameter
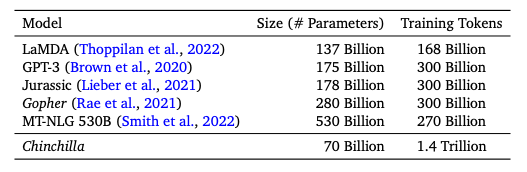
Chinchilla outperforms Gopher — https://arxiv.org/abs/2203.15556


GPT-3가 엄청난 학습 비용 덕에 단 한번만 학습되었다는 사실 역시 이를 뒷받침한다. GPT-4는 최적의 컴퓨팅을 위한 x조 파라미터가 아닌 x조개의 토큰을 사용 할 가능성 있다.


희소모델에 대한 가능성

100조개 이상의 파라미터 개수로 학습된 모델에 대한 소문은 몇년동안 존재했습니다. 파라미터의 개수가 100조개 이상이라면, 모델의 용량이 비대해지기 때문에 이는 서비스의 인프라에 큰 부담을 주게 된다.

100조개 이상의 파라미터 개수를 가진 모델이 존재한다면, 이는 희소성 모델(Sparcity Model)일 가능성이 높다.

희소성 모델은 사용자의 입력에 따라 중요하지 않은 데이터를 정의하고, 중요하다고 판단되는 데이터들에 집중해 필수적인 세부정보만 가져오는 방식으로 비용과 효율성 면에서 이상적인 구조다.
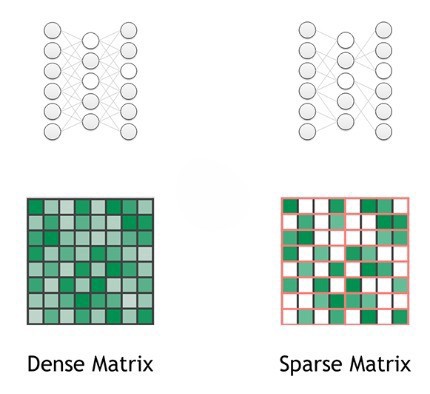
복잡한 개념을 쉽게 이해하기위한 예시를 들어보자. 희소성 모델은 ‘희소성 요리사’로 비유하고, 기존의 인공지능 모델은 ‘전통 요리사’로 비유하겠다. (전통 요리사는 희소성 요리사의 반대개념으로 , 희소성 요리사는 “Sparcity Model” 전통요리사는 “Dense Model” 이라고 정의하곤합니다.)

여기 다양한 재료를 가지고 모든 음식을 조리 할 수 있는 훌룡한 ‘희소성 요리사’가 있다. 훌룡한 요리사는 세상의 모든 음식재료가 들어있는 주방에서 일을 하고 있다.

(잠깐 어미를 ‘구어체'로 바꿔보겠습니다!)

마침 주문이 들어왔군요!

된장찌개를 만들어 달라는 손님의 요청입니다. 우리의 훌룡한 희소성 요리사는, 세상의 모든 음식재료중 된장찌개에 꼭 필요한 된장, 호박, 두부 ,양파, 고추 등의 재료만 빠르게 가져와서 맛있는 된장찌개를 만들어 내는데 성공합니다!

손님도 좋아하니 요리사도 덩달아 좋아하네요!

하지만 이 주방에는, ‘희소성 요리사’가 나타나기전에 똑같이 요리를하는 ‘전통 요리사’가 있었습니다.

‘전통 요리사’는 주방에 있는 모든 재료를 고민하고 사용해야 최상의 맛이 나온다고 생각하는 요리스타일을 고수하는 요리사입니다.

때문에, 된장찌개를 요청받아도 주방내에 존재하는 모든 재료를 확인하고 요리를 시작하죠.

결국 희소성 모델과 기존 모델의 차이는, 똑같은 주방에, 같은 수많은 식재료를 가지고 있지만. 효율성의 측면에서 큰 차이를 가지고 있다는 것입니다.

수조개 이상의 파라미터를 가지고 있다면 이는 희소성 모델에 가까워졌을 가능성이 큽니다. 서비스에서 운용가능한 수준의 효율성을 가져야만하기 때문이죠.

비용과 효율성 측면에서 희소성 모델이 상용화가능한 AI의 미래라는 시각이 있습니다.

그렇지만, 희소성 모델은 아직 Large Model에서 적용된 사례가 없기때문에, GPT-4가 희소성 모델이라고 가정하는 것은 아직 어려운것 같고, GPT-1,2,3와 같은 Dense 모델이라고 가정하는 것이 안전해 보입니다.


Multimodal?


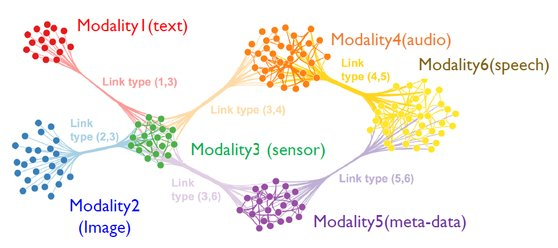
우리가 사는 세상에는 텍스트 뿐만아니라 다양한 종류의 컨텐츠로 가득 차있습니다. 텍스트에서, 이미지 , 동영상, 오디오 까지 말이죠. 이번에 출시가 예정된 GPT-4에서는 이런 다양한 컨텐츠 종류를 입력하고, 출력할 수 있는 Multimodal 형식일 것이라는 추측이 존재하고 있습니다.

즉 텍스트 입력에 따른 텍스트 결과물이 아닌, 텍스트 입력/ 이미지 출력, 이미지 입력/텍스트 출력 , 오디오 입력/ 이미지 출력등 다양한 컨텐츠 유형을 입,출력 할 수 있는 인터페이스의 출현을 기대하는 것이라 보면 되겠습니다.

희소성 모델과 더불어, Multimodal화 된 인공지능 역시 AI의 미래로 널리 알려져 있습니다.

대표적인 Multimodal AI Model로는 2022년 4월 출시된 DALLE2가 있으며, 큰 이목을 끌었습니다.

과연 GPT-4가 다양한 컨텍스트를 이해할 수 있는 Multimodal 형식일까?
앞으로 새롭게 나타날 생성형 인공지능 기반 서비스 역시, 유저의 다양한 요구사항을 반영하기 위한 노력을 할 것 이다.

마케팅 분야의 텍스트 생성 툴의 대표격인 ,Jasper.ai는 최근 Jasper Art를 출시 했다.

다양한 AI-Native 서비스 역시 Multimodal이 가진 화제성에 집중하고 이를 십분 활용할 것다.

실제로 OpenAI는 2022년 11월에 1억달러 규모의 스타트업 펀드인 Converge를 설립하고, 그 다음달 Descript, Harvey, Mem, Speak와 같은 Multimodal 유형의 회사에 투자했다.

GPT-4는 텍스트 전용 인터페이스와 개선된 모델의 퍼포먼스를 보여줄 가능성이 가장 높지만, 새로운 트렌드와 기술에 대한 뉴스는 충분히 주시할만한 가치가 있다고 보여진다.


GPT-4의 출시시기

GPT-2 는 GPT1이 출시된 1년 후에 출시되었다, GPT-3 역시 GPT-2가 출시된지 1년 후에 출시되었다. 기존의 관성대로라면, GPT-4는 이미 출시 되었어야 한다.

일반적인 견해로는, GPT-4가 2023년 1분기에 공개될 것이라는 것이 주된 의견이다.

그러나 Sam Altman(OpenAI, CEO)는 2023년 1월 13일 있었던 StrictlyVC와의 인터뷰에서 (위에서 언급한 “Bullshit” 인터뷰) GPT-4의 올해 출시 여부에 대해 “안전하고 책임감에 대해 확신할 수 있는 시점에 나올 것”이라며 확답을 내놓지 않았다.

다만, 여러 소문에 의한 출시 예상일은. 2023년 말 또는 내년에 이루어질 것이라는 기대가 많다.

ChatGPT의 출시 연기 역시, 급격한 관심으로 인한 인프라와 비용의 문제가 원인일 가능성이 높아 보인다.


GPT-4를 기다리며

AI에 대한 다양한 기대감과 루머는 새로운 변화에 대한 열망이기도 하다. 개인적으로는 Deepmind의 창업자이자 CEO인 Demis Hassabis의 TIME 인터뷰를 추천하고 싶다.

Google 역시 실시간 데이터와 출처 인용 기능을 제공하는 새로운 챗봇을 제공하려는 움직임을 보이고 있다. 이는 ChatGPT에 대한 google의 대항 와일드 카드로 보인다.

다수의 사람들과 인공지능이 상호작용하는 경험은 유래없는 사건이다. GPT-4가 연기되는 일이 누군가에게는 실망스러운 일이겠지만, 신생 기업에게는 새로운 사업기회를 제공하는 절호의 기회가 될 것이다.


Coxwave의 제품이 궁금하다면?: www.coxwave.com

포스팅 원문이 게재된 Coxwave의 블로그:https://medium.com/@coxwave/gpt-4-출시에-대한-소문과-진실-a885a6b7c70
12
1
정주영

정주영

SaaS 프로덕트의 성공을 견인하는 Fly-wheel, 그리고 생성형 인공지능 애플리케이션(2nd 메이커로그))

두번째 메이커로그!

좋은 정보를 담은 컨텐츠를 작성한다는건 생각보다 고되지만,

스스로 생각을 정립해나갈 수 있어 좋은 것 같습니다.


생성형 인공지능 애플리케이션과 전통적 애플리케이션의 구조적 차이


빠른 속도로 발전하는 사업의 영역속에서, 서비스와 프로덕트의 성공과 성장을 뒷받침하는 본질적인 힘은 무엇보다 중요하다. 바로 이 본질적인 힘을 명료한 컨셉으로 표현한 것이 바로 제프 베이조스(CEO of Amazon)이 고안한 “Fly-wheel”이라는 개념이다. 

“Fly-wheel”은 하나의 매커니즘으로, 프로덕트나 서비스가 가파르게 성장하거나 혹은 결정적인 기회를 얻도록 돕고, 여러 작용과 가치의 발생이 선 순환 하는 상황을 이끌어낸다. 서비스와 고객과 가치의 다양한 상호작용을 “떠 있는 바퀴”라는 뜻의 선순환의 수레바퀴에 빗대어 표현한 것이다.


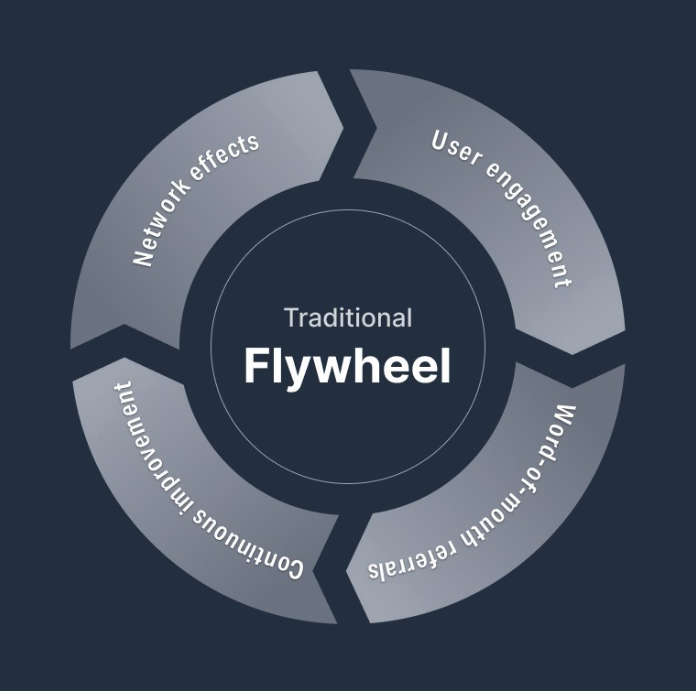
전통적인 방식의 “Fly-wheel”


우리에게 익숙한 전통적인 방식의 SaaS (Software as a Service) 제품 속에서는 지속적인 성장과 프로덕트의 성공을 위한 Fly-wheel요소를 다음과 같이 정의한다. 강한 Fly-wheel일 수록 SaaS 프로덕트가 결정적인 기회와 급격한 확장성, 또한 유저와 수익의 증가를 빠르게 견인한다.

전통적인 SaaS 프로덕트의 Fly-wheel 요소는 다음과 같이 구분할 수 있다. 

  1. 사용자 참여: 제품을 사용하는 사용자의 유저가 많아질 수록, 제품의 성공확률은 높아진다. 그러므로, SaaS 프로덕트는 사용자의 긍정적인 경험을 만들고 지속적인 제품 사용을 할 수 있도록 집중해야 한다.
  2. 입소문: 제품에 만족한 사용자들은 자신의 경험을 그들의 친구나 동료 등의 주변 인에게 공유하고 추천한다. 이는 곧 자연스럽게 발생하는 organic 성장으로 이어진다.
  3. 지속적인 개선: 사용자의 피드백 및 사용 데이터를 기반으로 제품을 꾸준히 개선하고 업데이트한다. 이를 통해, SaaS 프로덕트는 지속적으로 고도화되고 사용자와의 관련성을 유지할 수 있다.
  4. 네트워크 효과: 고도화된 프로덕트는 더 많은 가치를 신규 사용자에게 제공하고 채택됩니다. 그리고 이는 성장의 선순환으로 이어집니다.

이런 Fly-wheel의 요소는 SaaS 제품의 성공을 위한 강력한 원동력으로 정의되며, 장기적인 성장과 지속 가능성 획득의 주요 Frame-work로 사용되었다.


하지만, 우리는 생성형 인공지능이라는 새로운 시대의 목전에 서있다.

 생성형 인공지능의 출현으로 새로운 형식의 애플리케이션 개발을 위한 길이 열렸다. 이미 결정된 입력과 출력이 있는 정적인 인터페이스를 지닌 기존 애플리케이션이 아닌 동적인 인터페이스를 기반한 애플리케이션이 등장할 것이다. 실제로, 이미 상용화된 AI-native 애플리케이션은 비 정형화된 결과물 출력 등을 핵심적인 가치로 부상하고 있다. (비 정형화된 결과물은 인공지능이 생성하는 결과물을 의미한다.)

 이런 차세대 애플리케이션은 인류가 인공지능과 상호 작용하는 방식을 변화시키고 있으며, 궁극적으로는 생활과 일하는 방식에 큰 변화를 불러일으킬 것이다.

이번 포스팅에서는 AI-native 애플리케이션의 성공을 이끄는 Fly-wheel 구성 요소를 살펴보고자 한다.


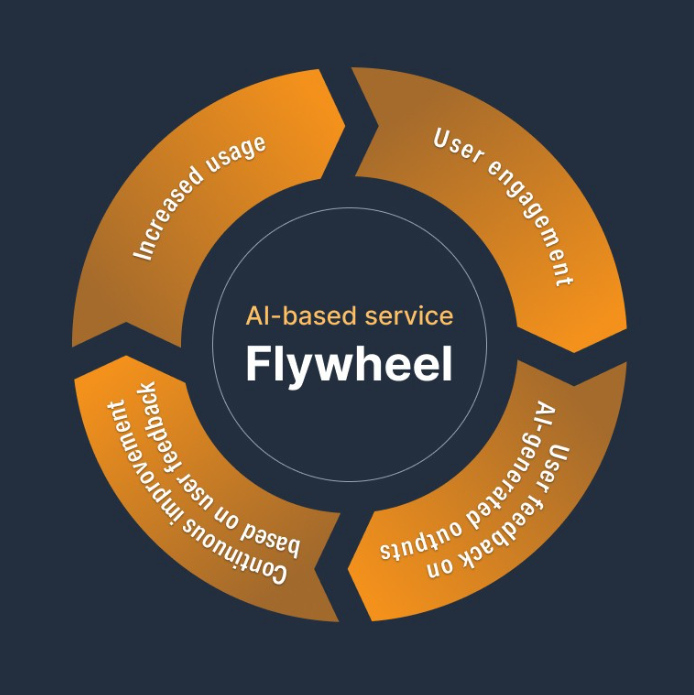
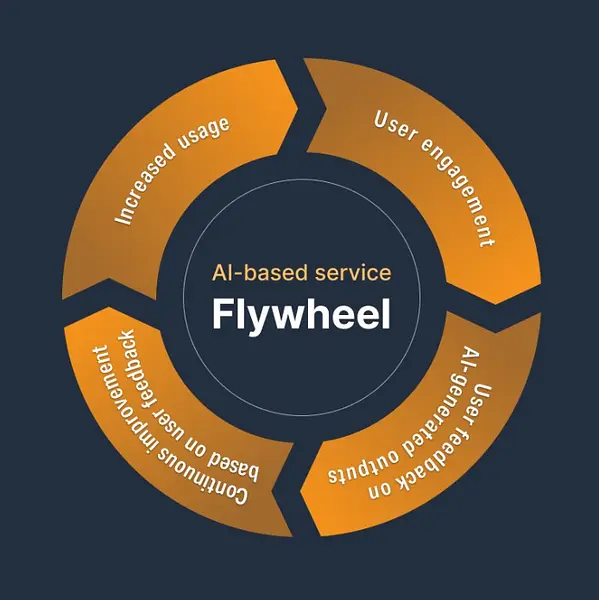
AI-native 서비스의 Fly-wheel 역시, 서비스의 지속적인 성장과 성공을 견인하는 역할을 하는것은 동일하다. 그 구성요소는 다음과 같다. 

  1. 사용자 참여: 서비스를 사용하는 사용자가 많을 수록 성공 가능성이 높아진다.
  2. AI 생성 출력에 대한 사용자 피드백: AI가 생성한 결과물에 대한 사용자의 피드백을 수집하고 그에 따라 조치를 취하면 서비스를 개선하고, 더 좋은 퀄리티의 결과물로 서비스의 가치를 향상 시킨다.
  3. 모델 개선: 인공지능 생성 결과물에 대한 사용자의 피드백 및 사용 데이터를 기반으로 서비스의 기반인 모델을 개선하고 업데이트하며, 서비스가 지속적으로 성장하고 발전할 수 있도록 한다.
  4. 사용량 증가: 더 많은 사람들이 서비스를 사용할 수록 가치가 높아지고 더 많은 사용자를 끌어들이는 Fly-wheel 효과가 발생한다.

차세대 애플리케이션(AI-native 애플리케이션)의 차별적인 구조는?

AI-native 애플리케이션들의 Fly-wheel을 구축하기 전, 전통적인 방식의 애플리케이션과 AI-native 애플리케이션의 구조적 차이를 이해해야 한다.

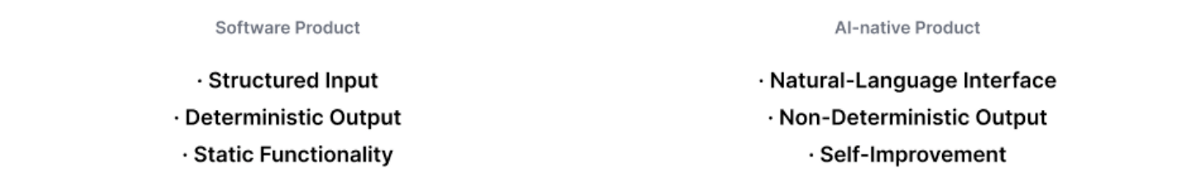
인공지능 기술을 원할하고 통합적으로 사용하도록 설계된 새로운 유형의 애플리케이션 이다. 기존 애플리케이션과 차별적인 구조로는 자연어 인터페이스, 비 정형화된 출력 결과물, 자체 개선 기능 등을 꼽을 수 있다.


AI-native 애플리케이션의 성공적인 Fly-wheel을 위한 프로덕트 분석 도구의 중요성


새로운 형태의 차세대 애플리케이션(AI-native 애플리케이션)을 맞이하며, ‘필요한것이 무엇일까?’ 라는 고민에 대해서는 지체없이 제품 분석 툴이라고 대답할 것이다. AI-native 서비스가 “Fly-wheel”효과를 생성하려면 올바른 핵심 성과 지표(KPI)를 추적하고 측정할 수 있는 분석 도구가 필요하다. 

 근본적으로 AI-native 서비스는 그 인공지능의 성능에(생성 결과물에 대한 유저 만족도)의존하기 때문에, 서비스의 UX 뿐만 아니라 AI 생성 데이터에 대한 적확한 분석 도구가 필요하다. 해당 분석 도구에서 제공하기 유용한 기능은 아마도 다음과 같지 않을까 싶다.

AI 성능 추적 도구: 서비스의 UI와 연동되어 있는 유저의 Feedback Action 을 통해, 모델이 생성하는 결과물 및 이에 대한 만족도 모니터링 기능

사용자 행동 분석: 사용자가 상호 작용하는 Feedback 인터페이스에 대한 전반적인 모니터링과, 유저 코호트 분석 기능

생성 데이터 모니터링: AI 생성 데이터에 대한 뉴럴 서칭 기반이 카테고리 라벨링과, 부정/긍정 피드백 데이터 콜렉트 및 확인 기능. 해당 기능을 통해 유저들이 선호하는 생성 결과물에 대한 인사이트 발굴 및 추후 재학습 자료로 활용

자연어 인터페이스에 대한 대응: AI-native 서비스에는 유저가 구조화된 입력이 아닌 자연어를 사용하여 서비스와 상호 작용할 수 있는 인터페이스가 있는 경우가 많다. 분석 도구는 이런 구조화되지 않은 데이터를 처리하고 분석할 수 있어야 한다.

비 정형화된 출력 결과물: 인공지능은 결정적이고 확실하기 보단, 불 확정적이고 확률적인 결과물을 출력한다. 분석 도구는 이런 유형의 데이터를 처리하고 그에 따른 인사이트를 제공해야 한다.

자체 개선 기능: AI-native 서비스는 생산된 데이터에 따라 성능 향상을 위한 재학습이 가능하다. 분석도구는 이런 개선 사항을 추적, 측정할 수 있어야하며. 편리하게 개선 가능한 파이프라인을 제공해야 한다. 더 나아가, 모델의 변경 사항에 따른 사용자 경험과 참여에 미치는 변화와 인사이를 올바르게 분석할 수 있어야 한다.

태동하는 AI-native 서비스의 경쟁에서 승리하기 위해서는, AI-native용으로 설계된 특별한 분석 도구와 함께 Fly-wheel을 구축하여 지속적인 성장과 성공을 주도할 수 있을 것이다.

결론

이제는 사용자의 피드백 뿐만 아니라 인공지능이 생성한 결과물에 대해서도 주목해야 한다. 앞서 말했던 것 처럼, 생성형 인공지능 서비스의 본질은 인공지능이 생성한 결과물에 대한 유저의 만족도로 부터 출발하기 때문에, 결과물에 대한 사용자의 피드백을 기반으로 인공지능을 향상 시키는 것은 피할 수없는 숙명이다.

이러한 차세대 서비스(생성형 인공지능 기반 서비스)의 특성에 맞는 분석도구의 등장 역시 그러한 맥락에서 궤를 같이한다.기반의 서비스의 본질은 인공지능이 생성한 결과물이 품질이 결정하기 때문이다.

나를 비롯한 콕스웨이브의 팀원들은 생성형 인공지능이 다양한 산업과 사람들의 삶에 긍정적인 변화와 혁신을 가져올 것이라고 믿고있다. 인공지능의 발전으로 누구나 개인화 된 멀티미디어 컨텐츠를 제작할 수 있는 시대 역시 다가오고 있다. 이전에는 상상조차 할 수 없었던, 개인화된 경험과 서비스를 제공받고, 고품질의 컨텐츠를 개인과 기업이 모두 만들 수 있는 시대가 열리는 것이다. 인공지능 기술의 발전함에 따라 표현하지 못하던 상상력 조차 손쉽게 컨텐츠화 되는 세상은 어떤 모습일까?

보이지 않는 미래에 대한 기대감, 바로 이것이 우리가 차세대 분석 도구를 개발하는 근본적인 이유이다. AI-native 서비스의 고유한 특성을 이해하고 그에 맞는 성장과 성공의 밑거름 솔루션을 제공함으로서

새로운 흐름을 목도하거나 관조하기 보다는, 새 흐름에 의미있는 기여를 하고 싶다!


콕스웨이브의 제품이 궁금하다면?: www.coxwave.com


포스팅 원본이 있는 콕스웨이브 블로그:https://medium.com/coxwave블로그/saas-프로덕트의-성공을-견인하는-fly-wheel-그리고-생성형-인공지능-애플리케이션-a40f35a5e40a

21
7
정주영

정주영

생성형 인공지능에 열광하는 이유(feat. 첫 메이커로그)

안녕하세요 디스콰이엇 여러분, 최근 생성형 인공지능에 대한 관심이 많아지는 것을 피부로 느끼며 기뻐하고 있는 인공지능 스타트업의 1인입니다.


더 많은 분들에게 공유하고 소통하기 위해, 생성형 인공지능에 관한 포스팅을 꾸준히 올려볼 생각입니다!

디스콰이엇 분들의 생각도 궁금해요!

<글 시작>


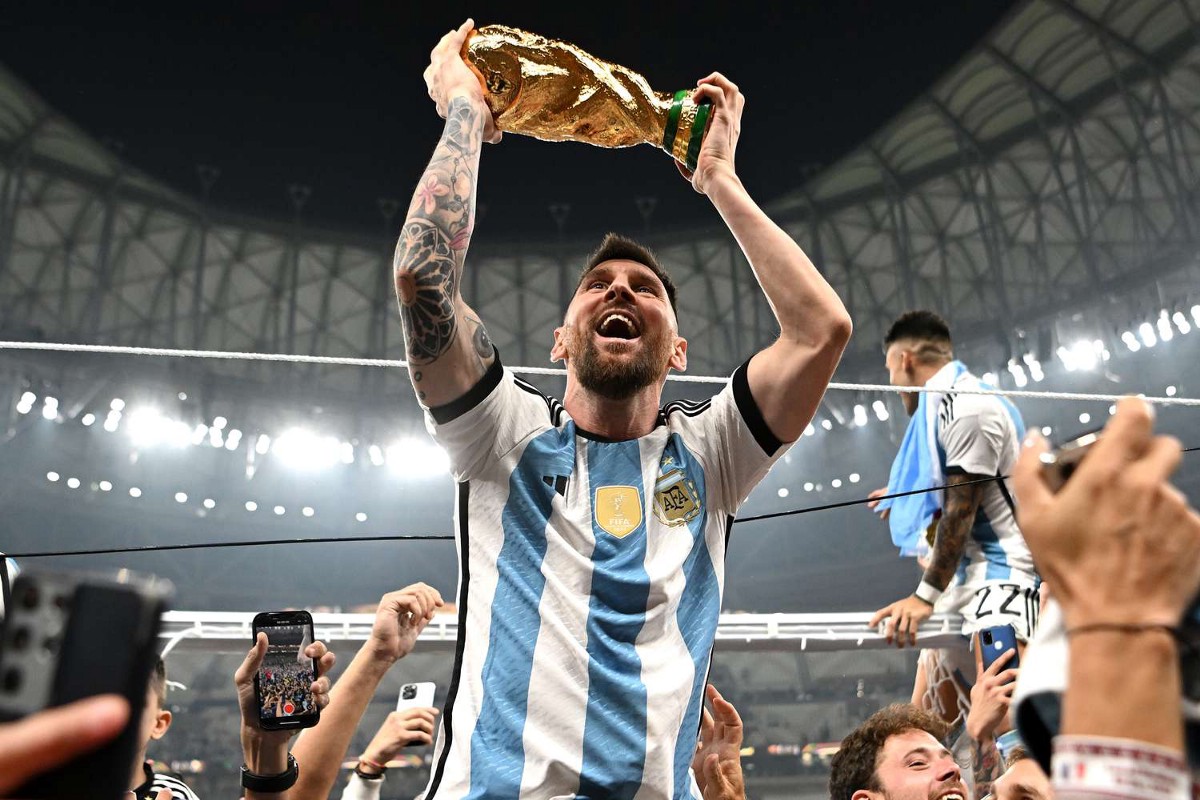
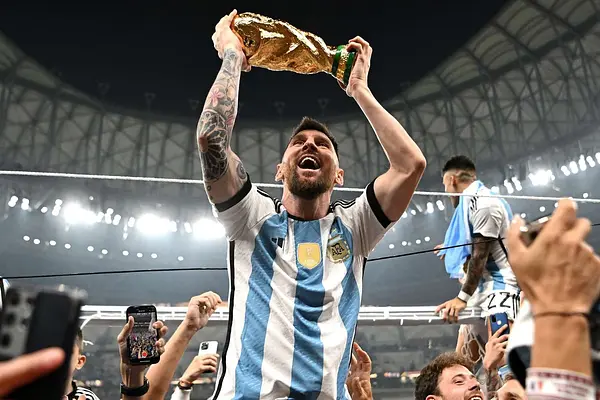
리오넬 메시는 2022년 카타르 월드컵을 우승하며 커리어의 정점을 찍었다.


2022년, 인공지능 역시 새바람을 몰고왔다.


충격적으로 등장한 알파고라는 인공지능의 출현 이후, 인공지능 역시 지속적으로 기록를 갱신하며 달려가고 있다.

인간의 언어와 추상적 개념을 이해하는 이미지 생성 인공지능 애플리케이션의 대중화와, 인공지능을 통해 생성된 멀티미디어 콘텐츠의 출현, 심지어는 그림대회에서의 수상까지.

21세기는, 현대사회의 몇 가지 직업분야에 인간의 직접적인 노동을 필요로 하는 마지막 세기일지도 모른다는 흥미롭고 구체적인 그리고 무서운 단서를 흘리고 있다.

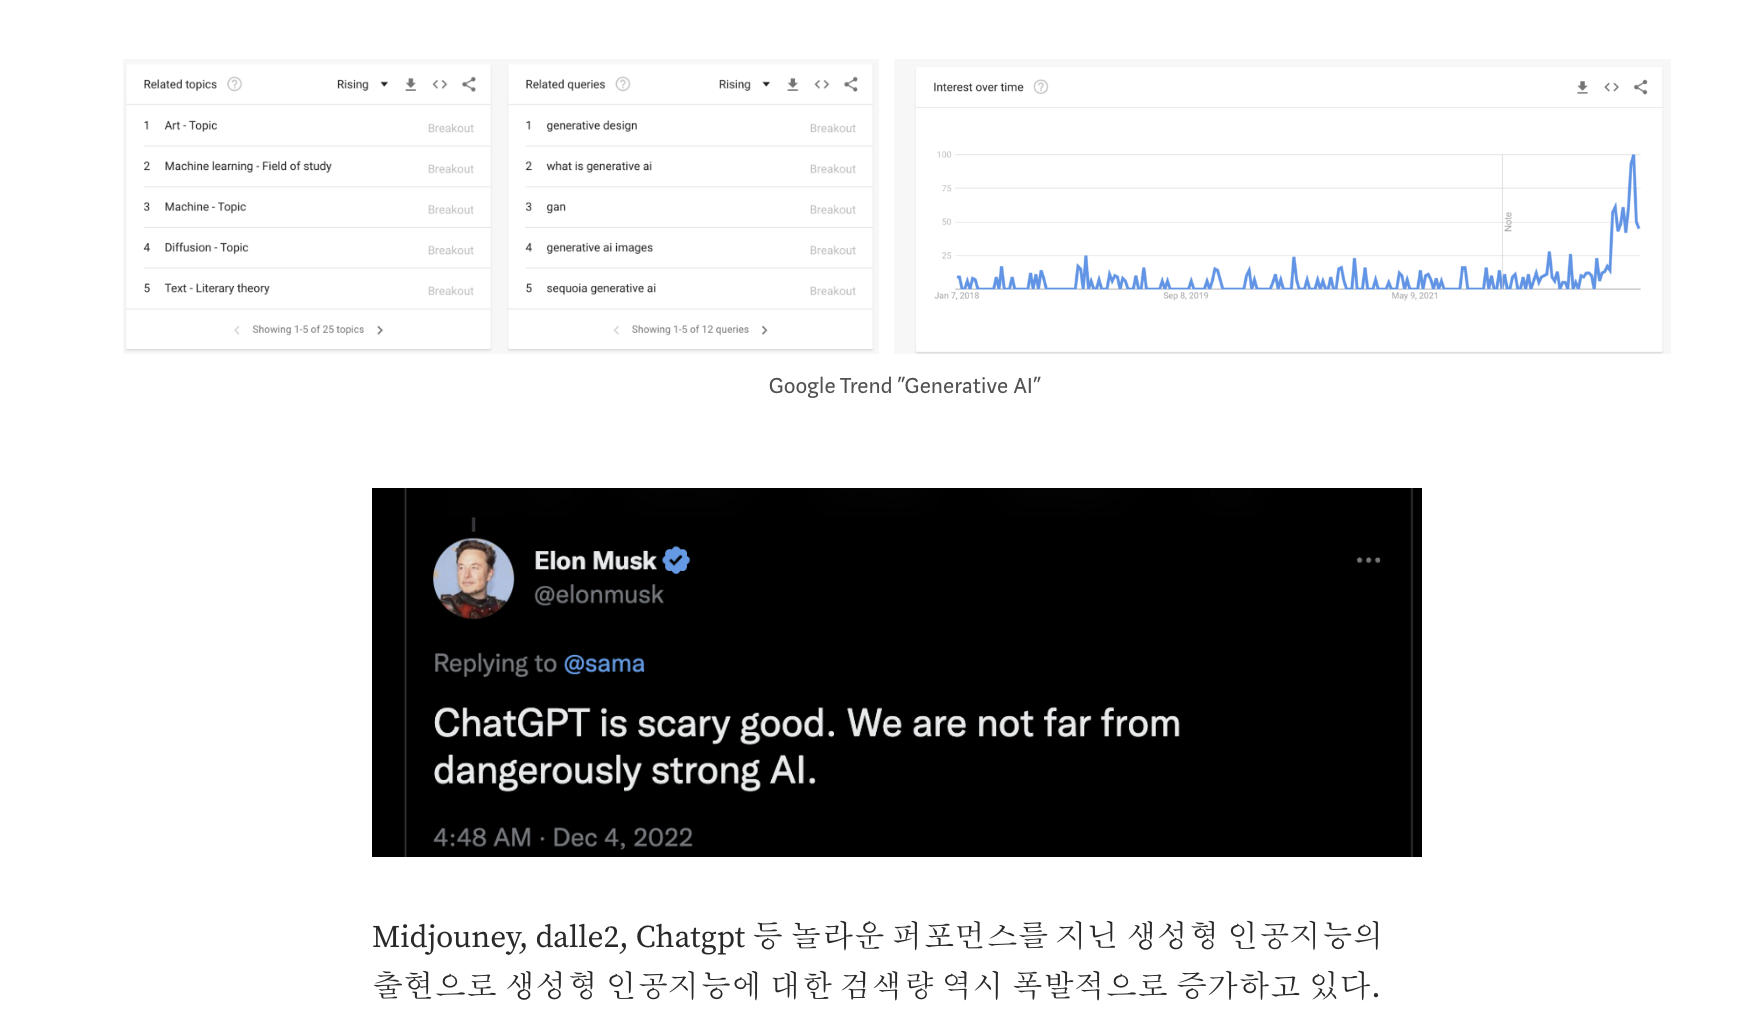
작년은 인공지능이 전 산업분야에 빠른 속도로 스며드는 해였다. 빠르게 인간의 직감을 초월해내고 있는 ‘생성형 인공지능’의 출현은 이 모든 상황을 촉발한 근본적인 이유가 되었다.

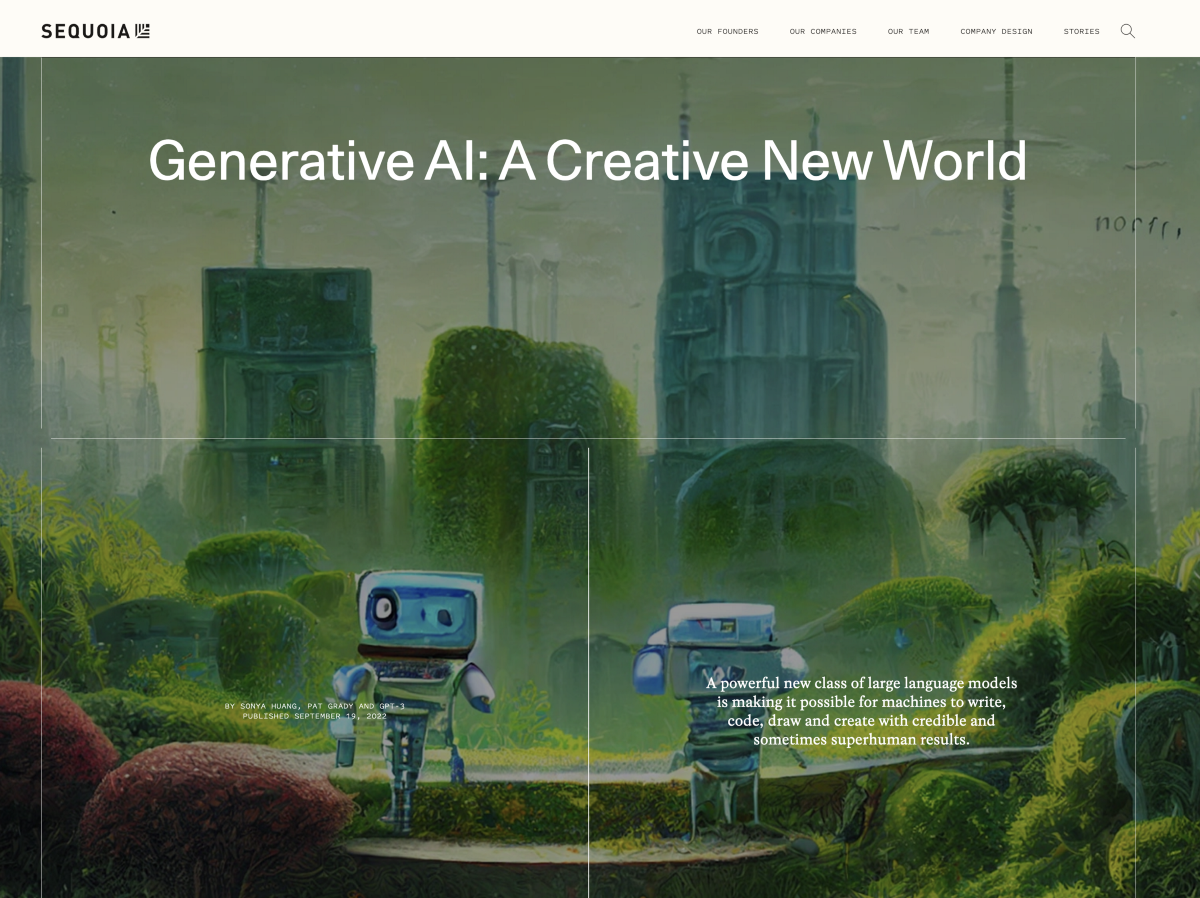
https://www.sequoiacap.com/article/generative-ai-a-creative-new-world/


가장 성공적인 대형 VC중 하나인 sequoia 에서는 작년 여름 생성형 인공지능에 대한 레포트를 퍼블리싱 했다.

Open.AI의 CEO Sam Altman은 그의 블로그 포스팅(’Moore’s Law for Everything’)을 통해 인공지능을 통해 좋은 삶을 누릴 수 있음을 주장한다. Sam Altman은 구매력의 향상은 삶의 만족감을 향상 시키는 중요 한 요소이며, 인공지능 혁명을 통해 제품과 서비스 비용이 낮아져 동일 비용으로 더 많은 구매력을 행사할 수 있는 인간의 삶 만족도 향상에 기여할 것 이라고 주장한다.


왜 생성형 인공지능을 주목하는가?


생성형 인공지능은 다양한 이름으로 소비되고 있다. Foundation, Large(초거대), Generative 등이 그 예시 이다. 

(이번 포스팅에서는 Generative AI로 통일해 적을 예정입니다.)

생성형 인공지능 이전에도 Narrow 모델이라는 타입의 모델이 존재했다. Narrow 모델은 OCR 등의 특정한 Task를 높은 효율로 수행하기 위해서 고안된 인공지능이다.

 특정 이미지를 판별하거나, Machine Transition 등 한가지의 Task(임무)만 효율적으로 수행 할 수 있었다. 물론, 한가지 Task에 한해서는 인력보다 높은 수준의 효과를 볼 수 있었지만, 한가지 Task를 학습시키기 위한 방대한 데이터 셋 구축, 인간의 노동이 필요한 학습단계의 레이블 작업 등등이 큰 한계이다. 이유는 자명하다, 세상에는 수만가지 Task(미션)가 존재하고 이를 각 테스크 당, 최적화된 모델을 학습시켜 해결한다는 것은 불가능에 가깝기 때문이다.

 생성형 인공지능의 혁신성을 수식할 수 있는 방법은 무수히 많지만 가장 본질적인 혁신성은 높은 수준으로 인간과의 유사성을 가진다는 것이다. 특정 분야의(Ex:언어) 하위 항목(EX: 번역)인 Task를 학습하는 것이 아닌, 전체 상위범주의 개념 자체를 이해하기 때문에 가능하다.

예를 들어, 언어를 이해하고 있는 사람은 “글을 쓰고, 말을 하고, 번역을 하고”등의 언어를 기반으로 한 수백가지의 행동을 한다. 생성형 인공지능 역시 마찬가지라는 것이다. 이는 한가지 Task만 해결 할 수 있는 Narrow Model과의 가장 핵심적인 차이이다.

 생성형 인공지능은 최상단의 개념 자체를(ex:언어) 이해하기위해, 특정 개념을 학습시키지 않고 데이터 원본을 제공하고 나머지 부분을 예측하도록 유도한다. 그리고 그 과정에서 추상적인 표현의 영역마저 이해해나가고 있다.

 이 과정에서, Narrow 모델의 인공지능의 산업적 한계였던, 현실에 존재하는 수만가지 태스크를 각각 분화한 모델로 학습시켜야하는 단점을 극복할 수 있다는 가능성을 시사한다.


불쾌한 골짜기를 넘어서..


생성형 인공지능의 잠재력

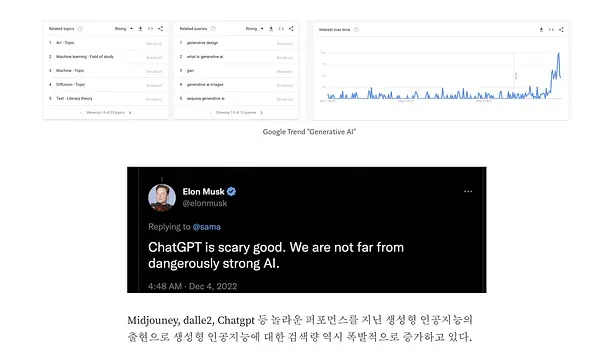
애매한 수준으로 인간을 모방하는 ‘불쾌한 골짜기’의 영역을 넘어. 2022년 부터는 생성형 인공지능이 만들어내는 다양한 멀티미디어 및 콘텐츠가 대중의 관심과 인정을 받기 시작했다.

GPT3, Lamda, Midjourney, Dall-E, Stablediffusion 등 다양한 생성형 인공지능 모델이 출시되었다.

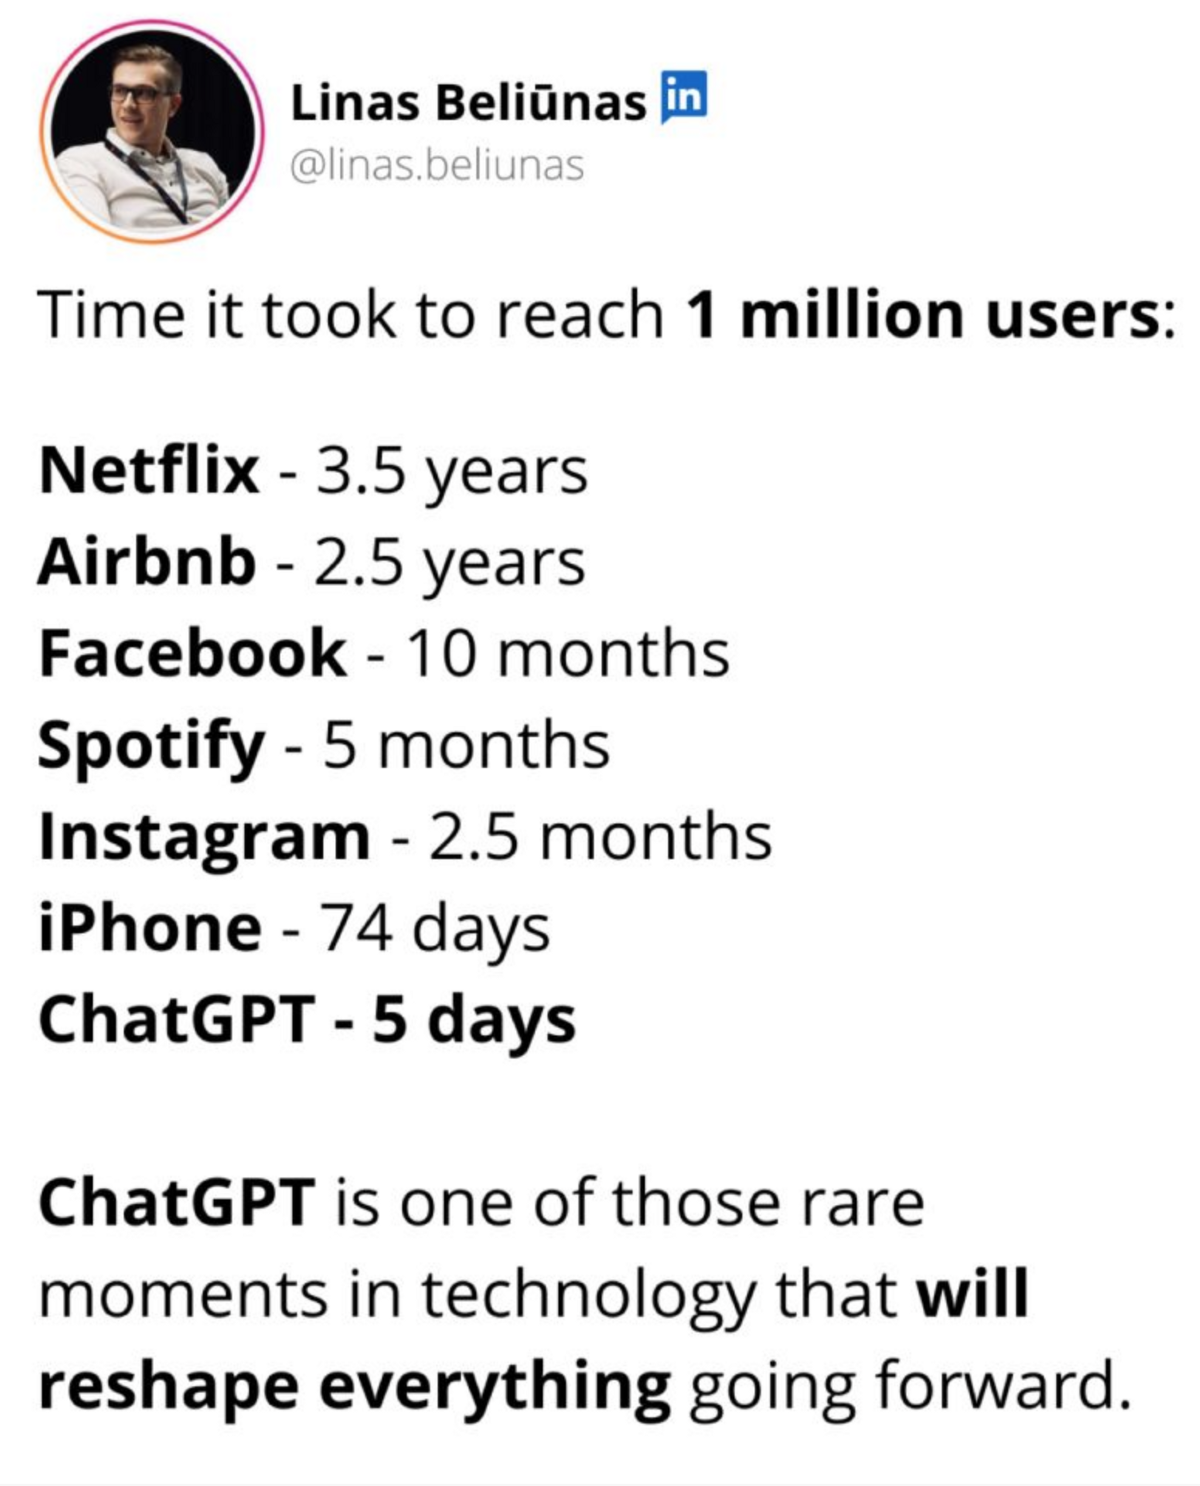
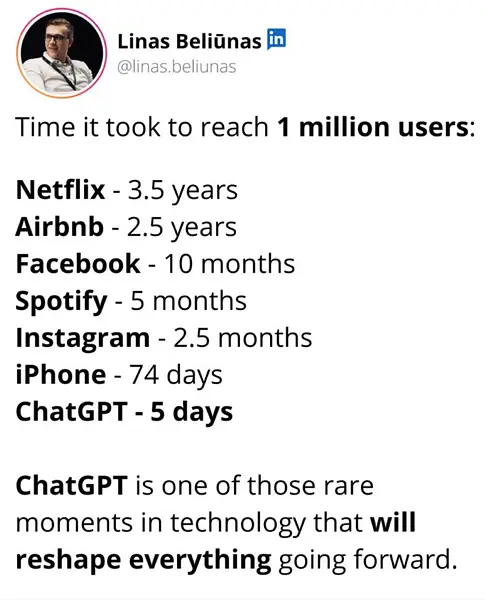
ChatGPT가 100만 유저를 모으는데 걸린 시간


실제로 미드저니의 경우 디스코드 서버를 통해 서비스를 오픈하였는데, 2개월째인 2022년 9월에 2백만명 이상의 사용자를 확보했다. 이는 디스코드 서버 1위 였던 포트나이트의 이용자수 보다 두배 이상 많은 수이며, 현재 미드저니는 720만명의 사용자가 사용중이다. 이는 디스코드 서버의 2위 — 20위를 합친 것 보다 높은 유저수이다.

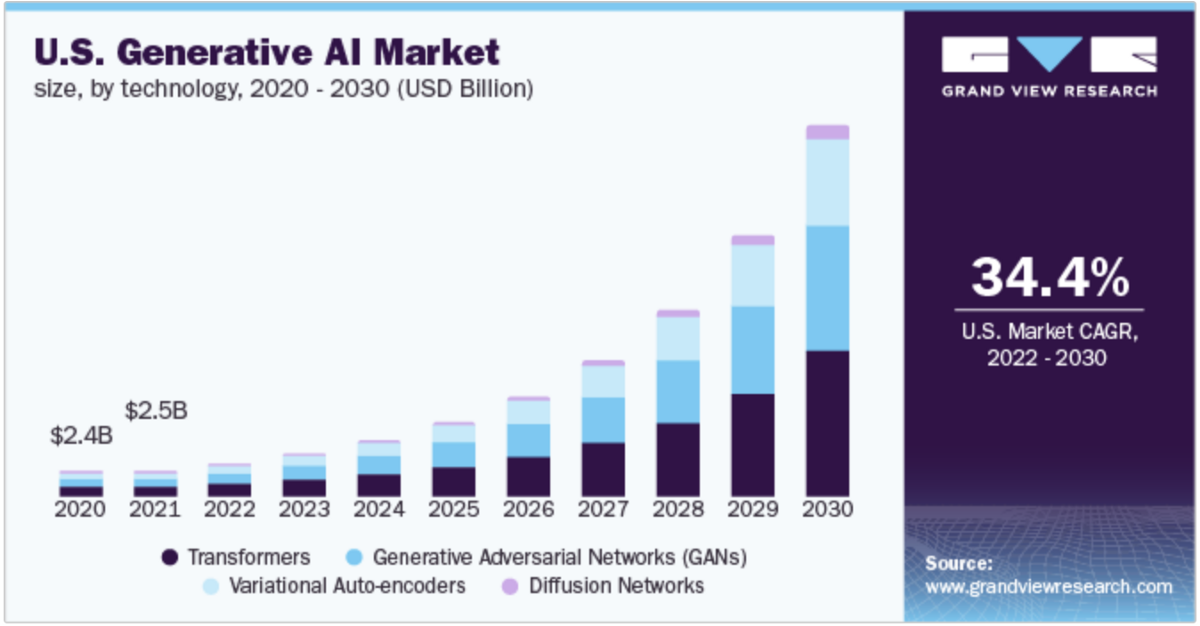
실제로 500여개 이상의 Generative Application이 등장하였고, 이중 몇 개의 서비스는 이미 1million 이상의 유저를 획득한 상태이다. 더 놀랍고 충격적인 것은, 생성형 인공지능이 산업의 종류를 불문하고 영향을 미칠 것이라는 것이다.

생성형 인공지능의 영향에 따른 반작용이 illustration, Marketing 등의 분야에서 일어나고 있다.

(추후, 각 산업분야에서 나타난 다양한 applicaition을 소개해 볼 예정입니다.)


한계와 문제점

생성형 인공지능의 등장을 통해, 언어의 장벽을 넘어 실시간으로 의사소통이 되는 세상, 혹은 이미지를 창작할 수 있는 능력이 없는 사람들도 자유롭게 멀티미디어 컨텐츠를 생성할 수 있는 미래를 현실적으로 상상하는 것이 가능해졌다. 그러나 여전히 헤쳐 나가야 하는 문제들이 존재한다.


소프트웨어 문제

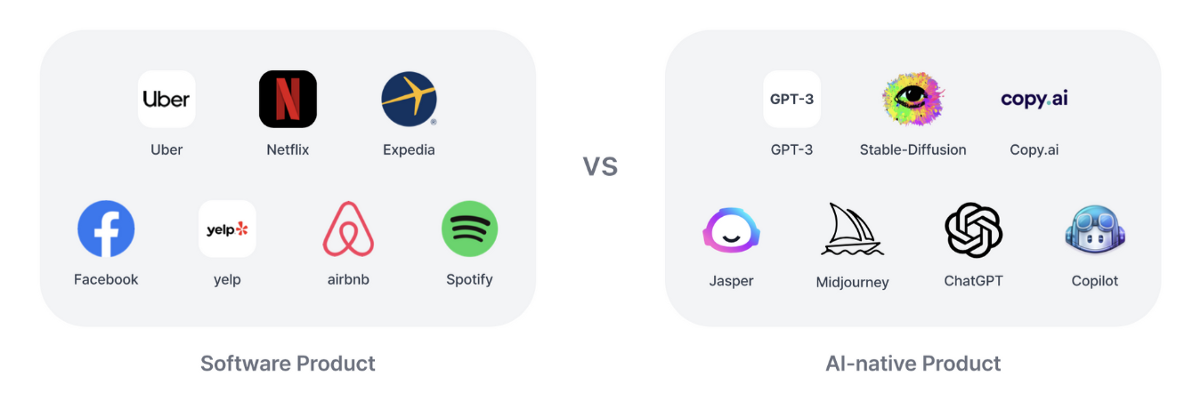
첫 번째는 소프트 웨어 문제다. 세상을 혁신한 제품들인 Uber, Netflix, Expedia, Facebook, Airbnb등의 애플리케이션과 생성형 인공지능을 기반으로 한 제품들은 분명한 구조적 차이점을 가지고 있다.새로운 세대의 애플리케이션인 생성형 인공지능 기반 애플리케이션에 알맞는 북극성 지표를 제공할만한 분석 도구 부터 생성형 인공지능 애플리케이션의 근본인 인공지능 모델 재학습 파이프라인 툴 등 다양한 솔루션이 필요하다.

무엇보다, 생성형 인공지능이 직면한 모델 오염 및 편견, 유해 콘텐츠 생성등의 이슈를 컨트롤 할 수 있게해주는 소프트웨어의 출현이 필요하다.


전통적인 애플리케이션과 AI-Native 애플리케이션의 구조적 차이

GPT-3, Dalle2, Stable-Diffusion등의 모델을 생성형 인공지능 산업의 Law-layer의 근본으로 본다면, 엔드유저인 사용자에게 닿는 애플리케이션들은 Top-layer이다. 원할하고 높은 품질의 컨텐츠를 제공하기 위한 Middle-layer의 출현이 필요하다.

생성형 인공지능 애플리케이션의 특징인 자연어 인터페이스, 비 결정적 출력, 자가개선의 기능에 맞춘 새로운 방식의 Analytics 툴의 출현이 필요하다.


인간과 인공지능 간의 사회적 관계 정립 문제

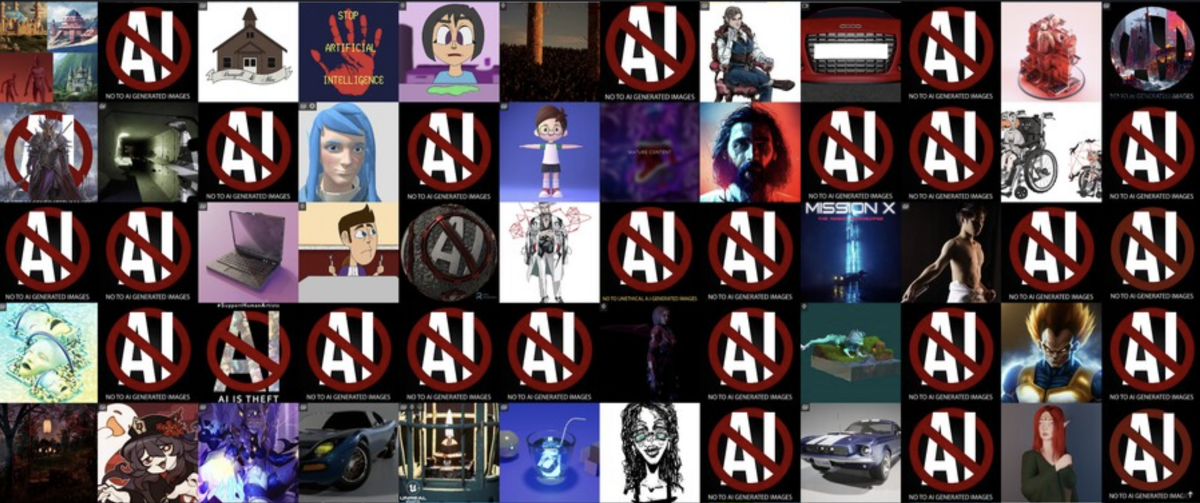
www.artsation.com NO TO AI GENERATED 운동


 최근 Midjourney, Stable-Diffusion, Webui등 다양한 Image generation model를 기반으로 한 이미지 생성 서비스들이 대중이 관심을 받게 되었다. 그와 동시에 인공지능 창작물의 저작권 문제, 학습데이터의 출처 문제, 관련 업종 종사자들의 생존권 문제등, 가볍지 않은 사회적 문제가 대두되었다. 실제로 이에 몇 창작자들은 온라인을 통해 AI 반대운동을 전개하기도 했다. 갑작스러운 큰 변화는, 갈등을 유발한다. 생성형 인공지능이라는 존재는 이전에 존재하지 않았던 마주하며, 인간과 인공지능 간의 관계를 성숙한 태도로 재정립 하기 위한 사회적, 기술적으로 다각적인 사회적 논의를 진행해야 한다.

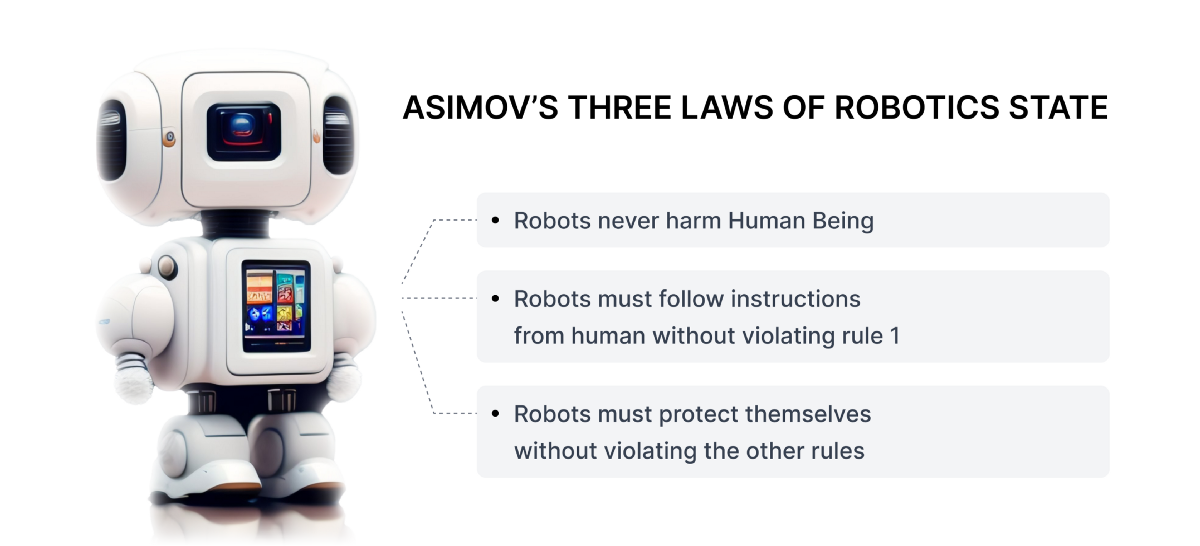
(실제로, 특정한 나라에서는 인공지능에 대한 법적 규약으로서, 아이작 아시모프에 나오는 로봇의 3원칙을 그 기초로 삼고 있는 수준이다.)


결론

역사는 반복된다

 여러 장벽이 있음에도 불구하고, 나는 가까운 시일내 현실에 존재하는 많은 문제들을 넘어 인류와 인공지능이 함께하는 것이 당연한 사회가 될 것 이라고 믿는다. 이미 인공지능 분야에는 천문학적인 자원과 인력이 투입되었고, 경험할 수 있는 결과물을 내놓고 있다. 상기의 글에서 우려하는 문제점을 해결하기 위해 이미 많은 사람들이 노력하고 있다. 무엇보다 이런 흐름또한 반복되던 인류 역사의 일부이다.

방직기가 출현해, 인력을 대체하고 역설적으로 사람들이 방직기의 부품처럼 치환되자, 사람들은 러다이트 운동을 벌였다. 이후로도 기계의 고도화로 인한 자동화, 내연기관의 등장등 수많은 신기술이 출현해왔다. 이미 많은 시간을 거쳐 관계를 정립해온 기계에 대해서는 적대감을 찾아보기란 어렵다. 인공지능도 이와 같은 역사의 평행한 흐름을 거치게 될 것이라고 생각한다.

절대적인 흐름을 목도하기 보다는, 더 가치있고 공유될 수 있는 방향으로 만들 수 있도록 일조 할 것이다.

중요한 것은 지속적으로 유저를 관찰하고 피드백에 맞춘 모델을 지속적으로 배포할 수 있는 파이프라인의 구축이다. 인간은 불온전한 존재이고, 인간의 불온전함을 닮은 인공지능이 탄생할 가능성이 높다. 하지만 지속적으로 사람이 피드백을 줄 수만 있다면 모델은 ‘공공의 선’을 실현하는 방향으로 변화해나갈 수 있을 것이다.

몇 년 동안, 인공지능이 흘러갈 흐름을 상상하기 위해 노력했다.

Coxwave는 앞으로 다가올 차세대 생성형 인공지능 애플리케이션들을 위한 Analytics Tool을 소개할 예정이다.


콕스웨이브의 제품이 궁금하다면?(Demo Request): www.coxwave.com

포스팅 원본이 있는 콕스웨이브 블로그: https://medium.com/coxwave%EB%B8%94%EB%A1%9C%EA%B7%B8

27
4

포스트

아직 포스트가 없습니다.