김승주
스코어에는 다대다 관계가 매우 많이 나타납니다.
솔직히 처음에는 일단 돌아가게 만들자는 마음으로 팀원 분이 추가해 둔 @ManyToMany를 그냥 흐린 눈 하고 넘어갔었는데, 조회 시 너무 번거로워 이대로는 안 되겠다고 느꼈습니다. 초반에는 그래도 중간 테이블을 생성해보려고 했었으나 그것도 그냥 왜인지 모른 채 '다대다 == 중간 테이블'이라는 어떠한 공식처럼 생각하고 다대다 중간 테이블을 구글링해보면 나오는 그대로 적용하곤 했습니다. 구글링을 해보면, 어떤 글은 중간 테이블에 복합 키를 사용해서 구현되어 있고 또 어떤 글은 단일 키를 사용해서 구현되어 있는데 솔직히 둘이 무슨 차이인지도 잘 몰랐습니다. 이번 기회에 다대다 매핑에 대해 좀 더 자세히 알아보기로 했습니다.
@ManyToMany의 사용을 지양해야 하는 이유
관계형 데이터베이스에는 컬렉션 기능이 없어 그 자체로 다대다 관계를 표현할 수 없습니다. 그래서 @ManyToMany 어노테이션을 사용하면 다대다 관계를 표현하기 위해 두 테이블을 조인한 새로운 중간 테이블을 생성해줍니다. 중간 테이블을 자동으로 생성해주기 때문에 편하게 생각될 수는 있지만, 이는 구현에 있어 자율성을 현저히 떨어뜨리는 방식입니다. 자동 생성된 중간 테이블에 필요한 컬럼을 추가하는 것은 불가능하기 때문입니다.
@ManyToMany의 대안: 중간 테이블 구현
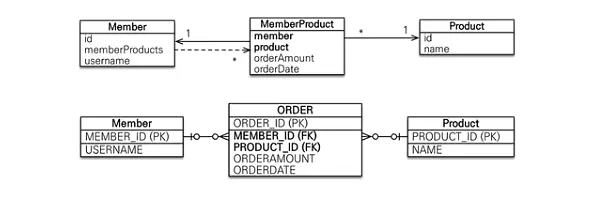
중간 테이블을 생성하기 위한 엔티티를 생성하고, 다대다 관계를 일대다, 다대일 관계로 풀어주는 방식을 사용합시다.
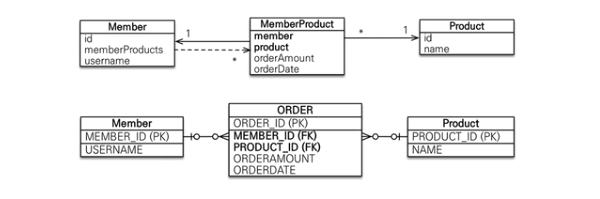
중간 테이블 구현 방식: 단일 키 (비식별 관계) vs 복합 키 (식별 관계)
여기까지는 다른 많은 블로그에 나와 있는 내용입니다.
그런데 이 중간 테이블을 위한 엔티티를 구현할 때
중간 테이블을 위한 엔티티에 별도의 PK를 부여해 단일 키로 사용
별도의 PK를 부여하는 대신 연결하고자 하는 두 테이블의 FK(복합 키)를 중간 테이블의 PK로 사용
(
@IdClass나@EmbeddedId를 추가하고 식별자 클래스를 따로 생성하는 그 방식 말입니다.)
이렇게 두 가지 방식 중 하나를 택해서 구현하곤 하는데, 보통 이 둘 중 하나로 구현하는 방법을 소개할 뿐 이 둘이 정확히 무슨 차이가 있는지에 대해서 설명한 글은 생각보다 찾기가 어려웠습니다..
그래서 한 번 직접 정리해보려고 합니다.
현재 스코어에서
유저(User)와 그룹(GroupEntity)는 다대다(N:M) 관계입니다.
한 명의 유저가 여러 개의 그룹에 가입할 수 있고, 하나의 그룹에는 여러 명의 유저가 존재할 수 있기 때문입니다.
이 두 테이블 간의 다대다 관계를 해소하기 위한 중간 테이블을 구현하는 방식을 정리할 것입니다.
단일 키 사용 (비식별 관계)
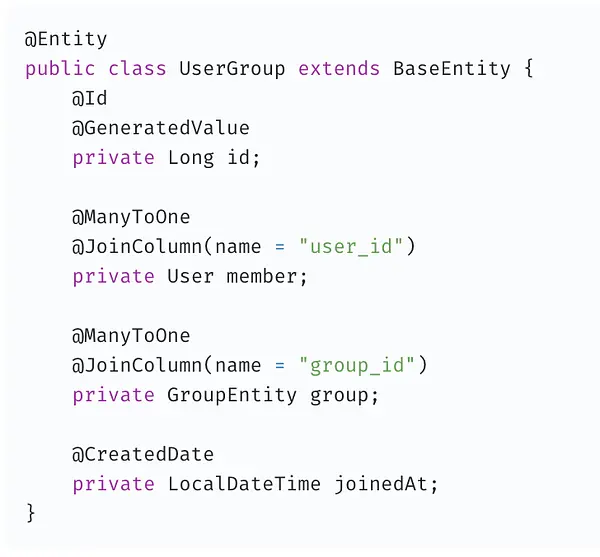
다음과 같이 User와 GroupEntity의 중간 테이블을 생성하기 위한 UserGroup 엔티티를 생성하고, User와 GroupEntity와의 다대일 연관 관계를 설정했습니다.
그룹 목록을 유저가 그룹에 가입한 순으로 정렬해 보여달라는 기획 쪽의 요청이 있어서 joinedAt이라는 필드도 추가했습니다. @ManyToMany를 쓰지 않으니 이렇게 필드를 추가할 수도 있습니다!
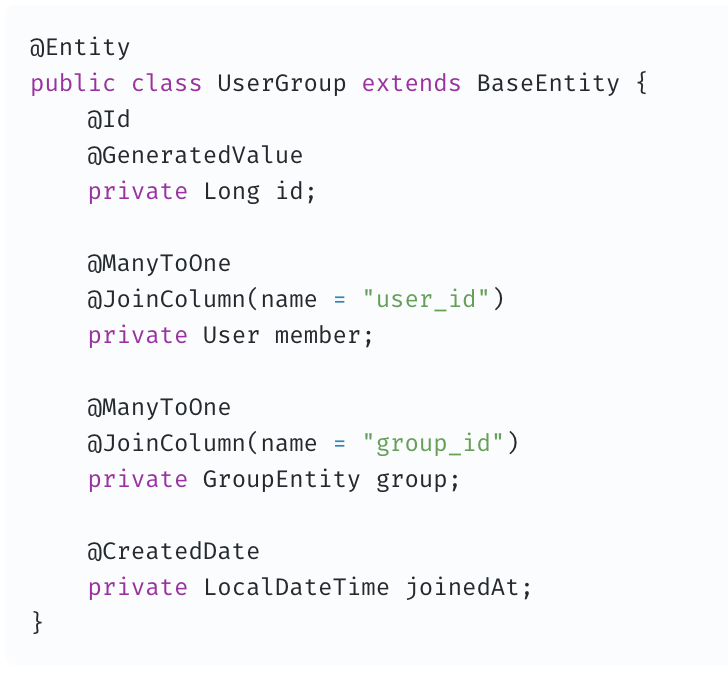
보이다시피, 단일 키 방식으로 구현하고자 이 중간 테이블을 위한 독립적인 PK인 id를 선언해주었다.
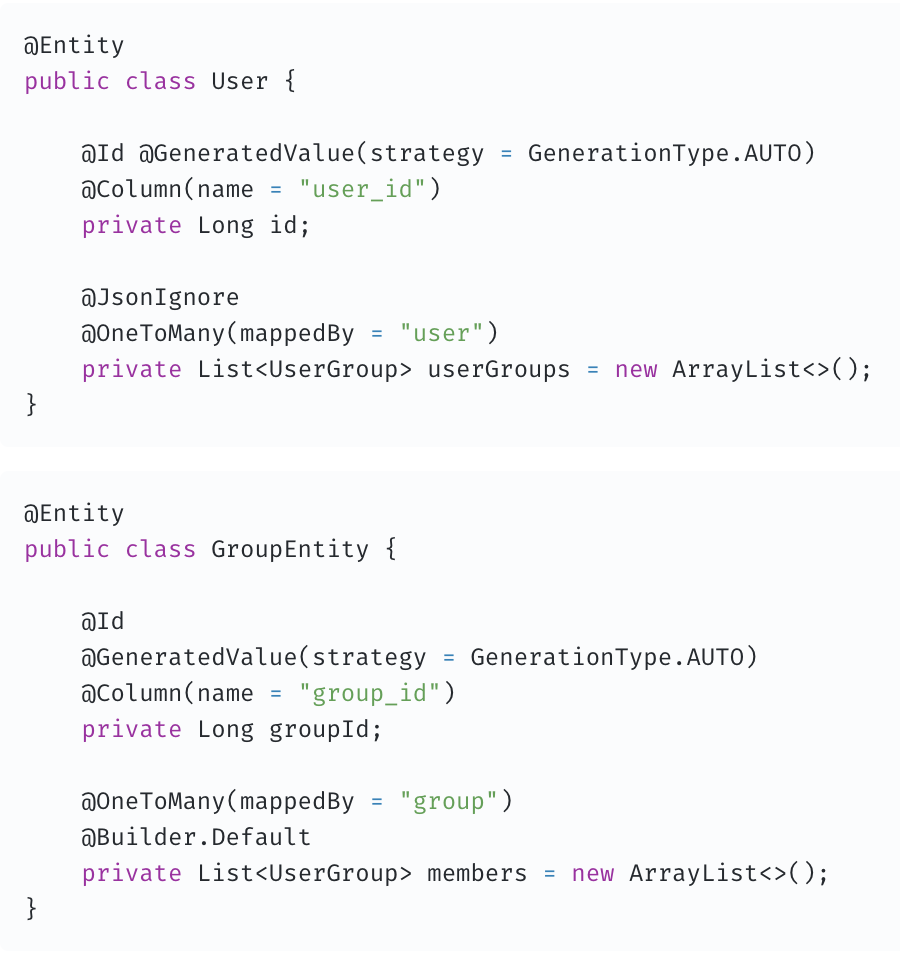
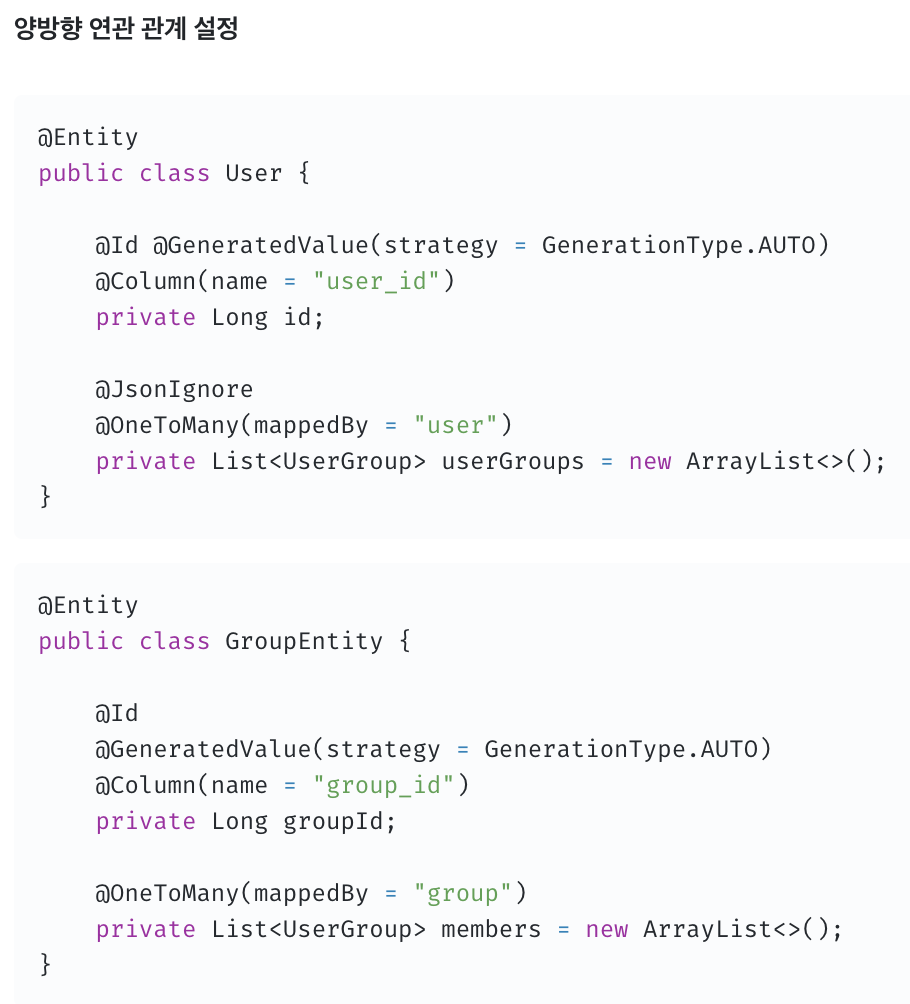
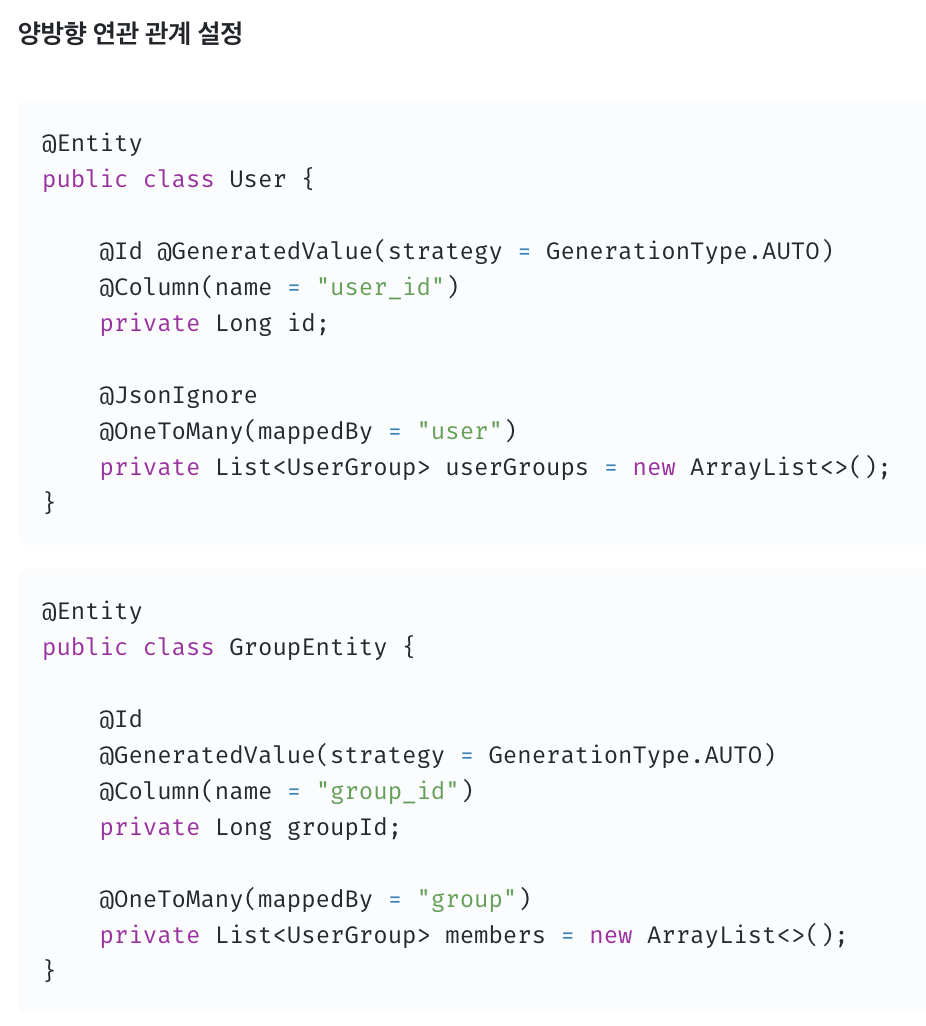
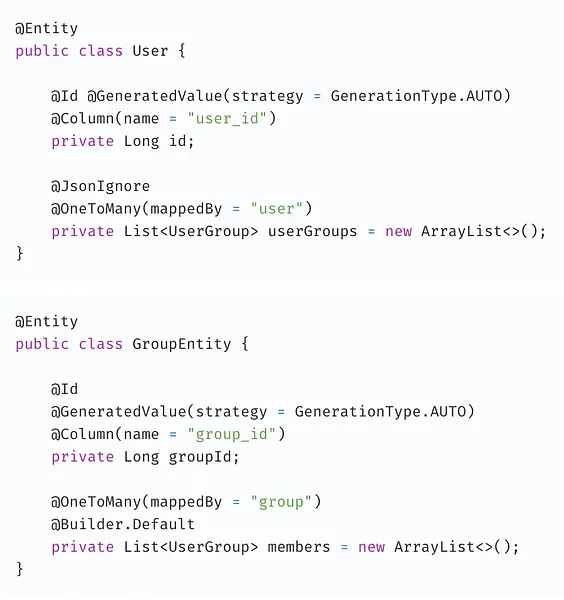
User와 GroupEntity는 서로 양방향 관계를 가져야 한다.
그러므로 User와 GroupEntity에는 이 중간 테이블과의 일대다 관계를 다음과 같이 설정해주었다.
복합 키 사용 (식별 관계)
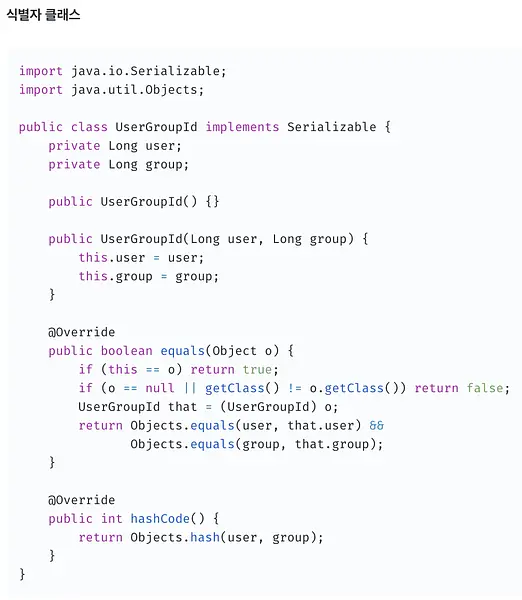
JPA에서 식별자를 둘 이상 사용하려면 반드시 별도의 식별자 클래스를 만들어야 합니다.
이 식별자 클래스는
a. Serializable의 equals와 hashCode 메소드를 구현해야 합니다.
b. 기본 생성자가 존재해야 합니다.
c. public이어야 합니다.
JPA는 복합 키 사용을 위해 @IdClass와 @EmbeddedId라는 2가지 방법을 지원합니다.
@IdClass를 사용한 구현
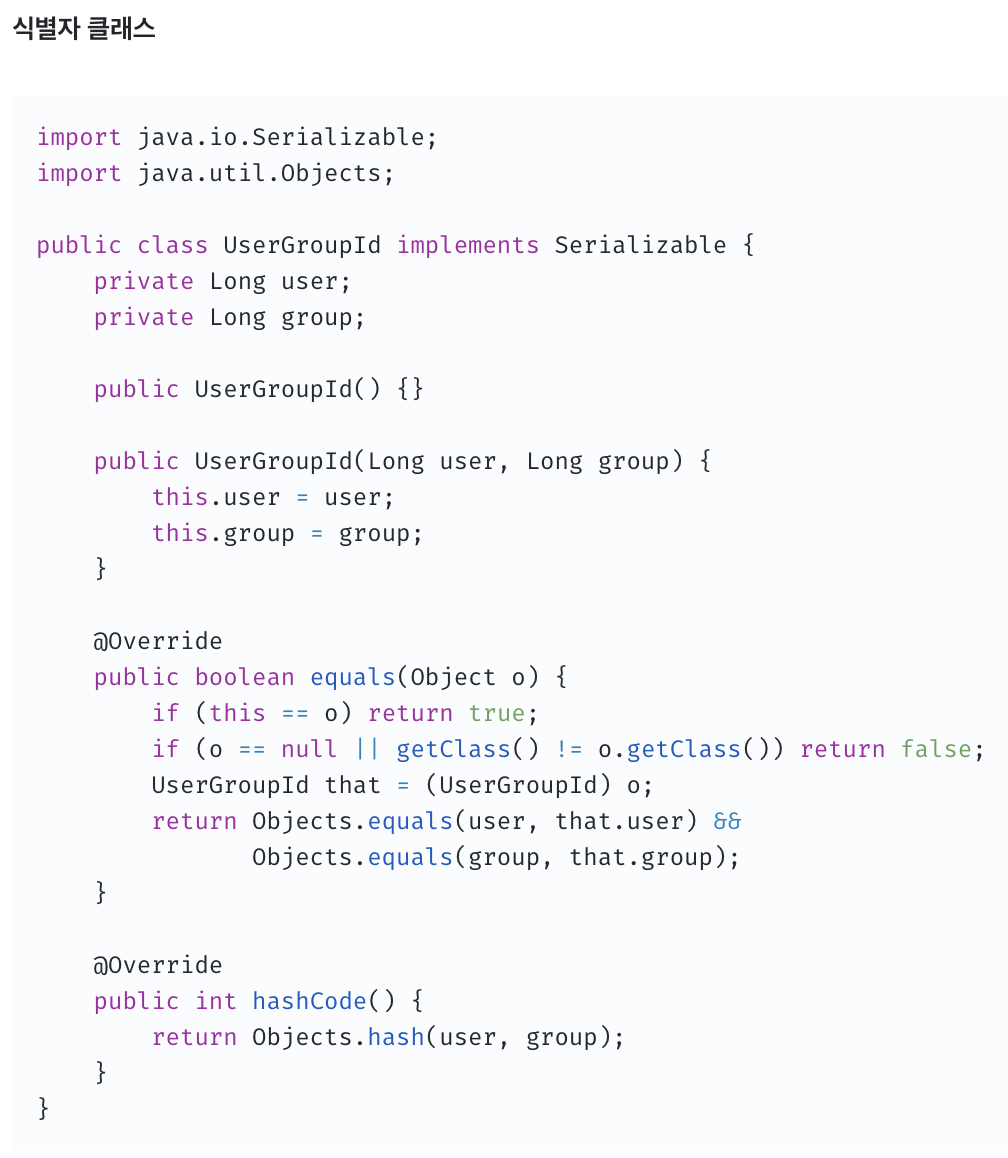
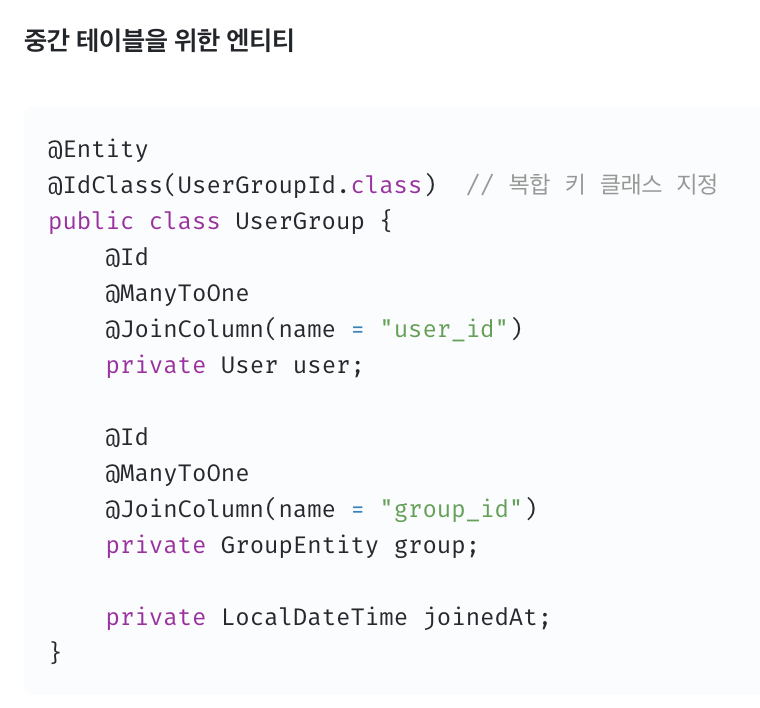
@IdClass는 @EmbeddedId와는 달리 필드별 개별 매핑이 가능해 유연하지만, 복합키가 하나의 객체로 캡슐화되는 @EmbeddedId와는 달리 PK 필드가 엔티티 안에 그대로 노출되기에 객체지향적이지 않다는 단점이 있습니다.
@EmbeddedId를 사용한 구현
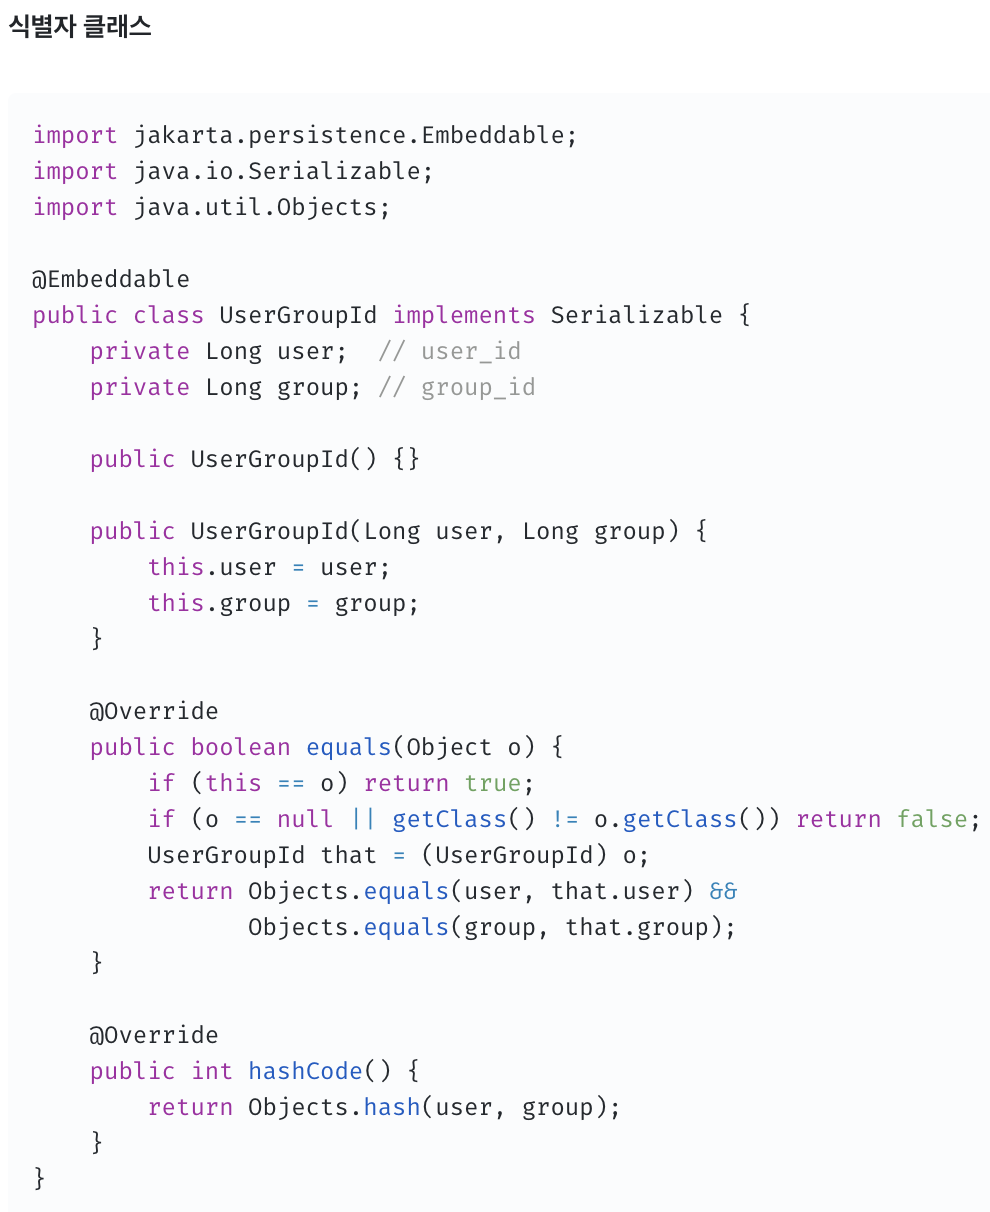
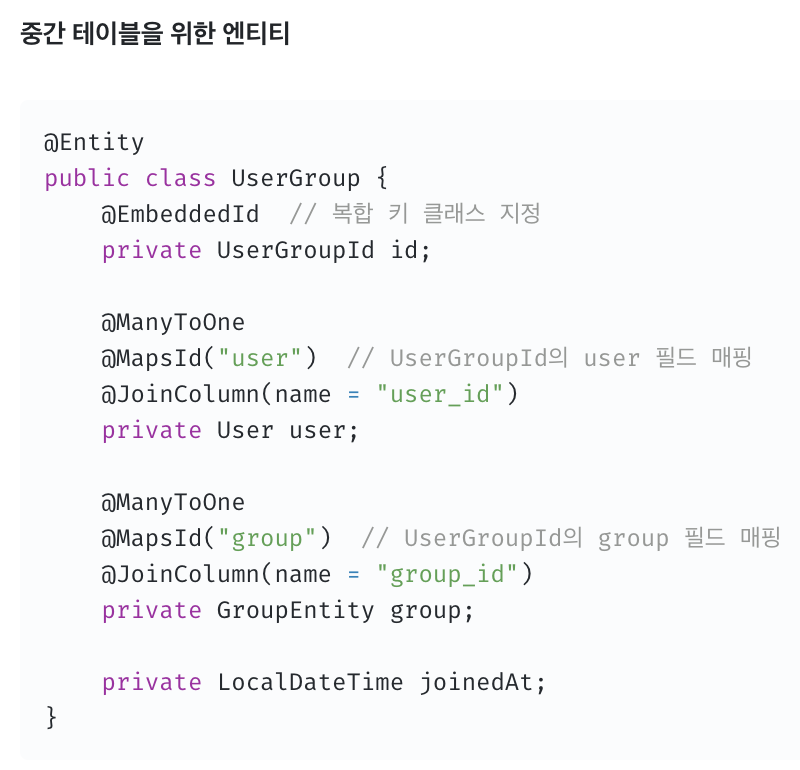
@EmbeddedId는 식별자 클래스의 객체 자체를 PK로 사용하는 방식입니다. 각 키 값을 FK로 사용하고자 한다면@MapsId("필드명")을 사용해야 합니다. 코드가 더 깔끔해지고 객체지향적으로 설계 가능하지만, 개별 필드를 직접 @Id로 매핑할 수 없으므로 유연성이 부족할 수 있습니다.
그렇다곤 하는데 사실 어마어마한 차이는 아니기에 취향 차이에 더 가까운 것 같습니다.
단일 키 vs 복합 키 중 무엇을 사용해야 하는가?
결론부터 말하자면, 중간 테이블 엔티티를 하나의 독립된 엔티티의 지위를 갖게 할 것인지, 단순히 연관 관계를 관리하기 위한 다리 역할만을 하게 할 것인지에 달려 있습니다.
단일 키를 사용해 비식별 관계로 구현하면 중간 테이블 엔티티가 자신만의 고유한 PK를 갖게 되기 때문에 User와 GroupEntity의 존재와 상관 없이 독립적으로 존재할 수 있게 됩니다. 중복된 (user_id, group_id)를 가지는 UserGroup 엔티티가 존재하는 것이 허용되기 때문에, 데이터 무결성을 보장하지 못한다는 단점이 있습니다. 하지만 중간 테이블 엔티티가 독립적인 엔티티로서 존재하게 되면, 단순 관계에 관한 정보뿐만 아니라 두 테이블 간의 추가적인 정보를 담을 수 있다는 이점이 있습니다.
예를 들어 유저가 그룹에 언제 가입했는지, 그룹 내에서 유저의 역할이 뭔지, 그룹 내 유저의 점수가 몇 점인지 등 중간 테이블에 추가적으로 저장해야 할 정보가 많거나 확장 가능성이 높은 시스템인 경우에는 비식별 관계로 구현하는 것이 더 유리합니다.
반면, 복합 키를 사용해 식별 관계로 구현하면 중간 테이블 엔티티는 복합 키((user_id, group_id))를 자신의 PK로 사용하기에 User와 GroupEntity에 대한 의존도가 높아지며, 그렇기에 독립적으로는 존재할 수 없게 됩니다. 하지만 별도의 PK를 갖지 않는다는 것은 데이터의 무결성을 보장하는 측면에서는 더 유리합니다.
예를 들어, 복합 키인 (user_id, group_id)를 PK로 사용하게 되면 동일한 (user_id, group_id)를 갖는 UserGroup 엔티티는 존재할 수가 없게 되기 때문입니다. 즉, 한 유저가 동일한 그룹에 여러 번 가입하려고 하는 시도를 차단할 수 있다는 것입니다.
따라서 중간 테이블에 추가적으로 저장해야 할 정보들이 없는 경우에는 데이터의 무결성 보장을 위해 식별 관계로 구현하는 것이 더 유리합니다.
User와 GroupEntity의 경우 확장 가능성이 높은 관계라 비식별 관계로 구현하는 것이 낫겠다는 판단이 들었습니다. 이전까지는 중간 테이블을 기계적으로 도입했었는데, 이제부터는 각 테이블과 중간 테이블 간의 관계를 더 깊게 고민해서 설계하는 것이 필요하겠다는 생각을 했습니다.
👉 스코어 사용해보러 가기
스코어 SCORE
친구들과 함께 즐겁게 운동하며 기초 체력을 키우는 청소년 전용 운동 기록 앱 서비스