fauxRaccord
이전 연재분의 마무리를 사용자의 취향을 2차원 '벡터'에 매칭시킨다는 어려운 말로 끝냈었어요. 물론 읽지 않아도 괜찮습니다. 중요한 이야기는 지금부터니까요.
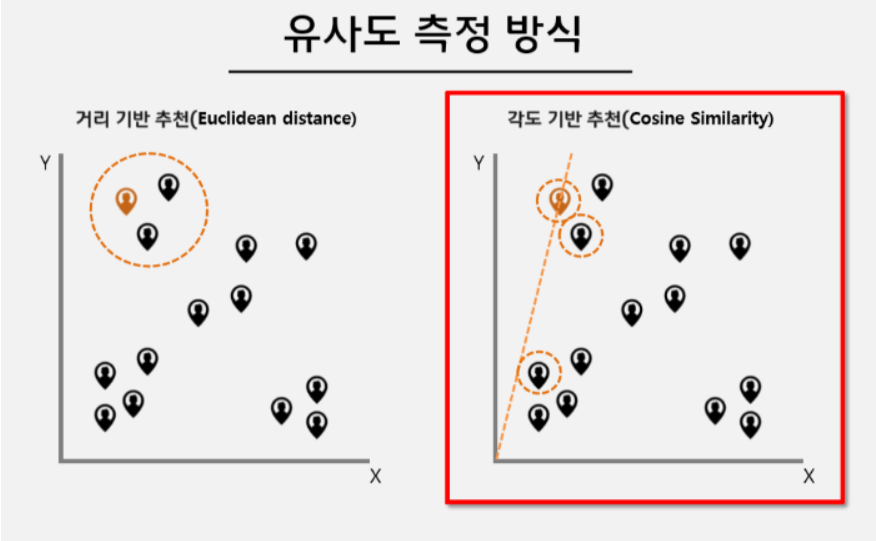
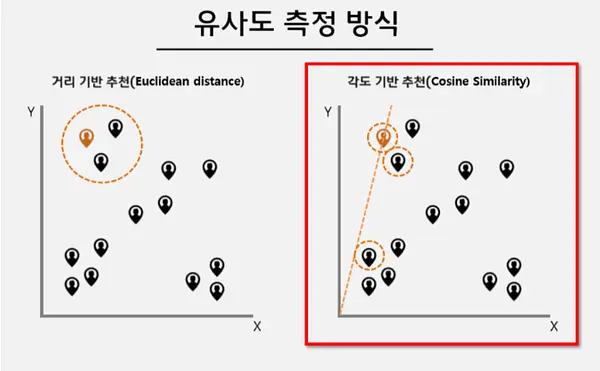
추천 알고리즘은 복잡하지만 가장 기초적인 방법은 둘입니다. 하나는 유클리드 거리에 기반한 계산, 그리고 또 다른 하나는 코사인 유사도에 근거한 계산. 자세히 설명하면 또 너무 복잡해지니까 대충 넘어갑시다. 그런데 이 두 접근법 모두 자료를 벡터로 변환해야 한다는 점이 흥미롭지 않나요?
그러니까 우리가 구하고 싶은 것은 작품과 작품 사이의 유사성임에도 불구하고 우리는 이 작품들을 벡터로 만들어주지 않고서는 이야기가 통하지 않게 됩니다. 우리의 얄팍한 인문학적 지식을 동원해도 된다면, 문자와의 동일시(나와 나라는 기호와의 동일시, 작품과 작품의 벡터와의 동일시) 과정, 또는 상징화 과정을 우리는 발견한 것인지도 모르겠습니다. 물론 디지털 매체에 대한 학술적인 분석을 개진하려는 것은 아닙니다.
사실 조금은 실천적인 이야기이고, 또 어떤 면에서는 비지니스적인 지점도 있습니다.
결론부터 말하면 벡터화 과정에 대한 주권을 사용자에게 돌려줘야 한다고 말하려는 것입니다. 위의 방법처럼 계산된 벡터는 사용자의 행위를 식에 필요한 매개변수로 취급합니다. 일반적으로 우리가 누른 좋아요나 시청기록은 추천 항목이라는 함수에 들어가기 위한 재료에 지나지 않습니다.
다시 돌아와서 개발자로서의 우리를 생각해봅시다. 우리가 설치한 그 많은 패키지의 코드를 뜯어보고 있나요(물론 최근 거대한 exploit이 있었지만)? 물론 그런 분들도 계시겠지만... 보통은 그렇지 않죠. 우리는 그 결과를 신뢰하고 우리 프로그램의 일부로 받아들입니다. 그렇다면 우리는 사용자에게 추천이라는 알고리즘을 위임하고 그 결과를 우리 프로그램의 일부로 받아들이는 것은 어떨까요? 그러니까 사용자의 행위를 매개 변수로 취급하는 것이 아니라 그 자체로 함수로 생각하는 것입니다.
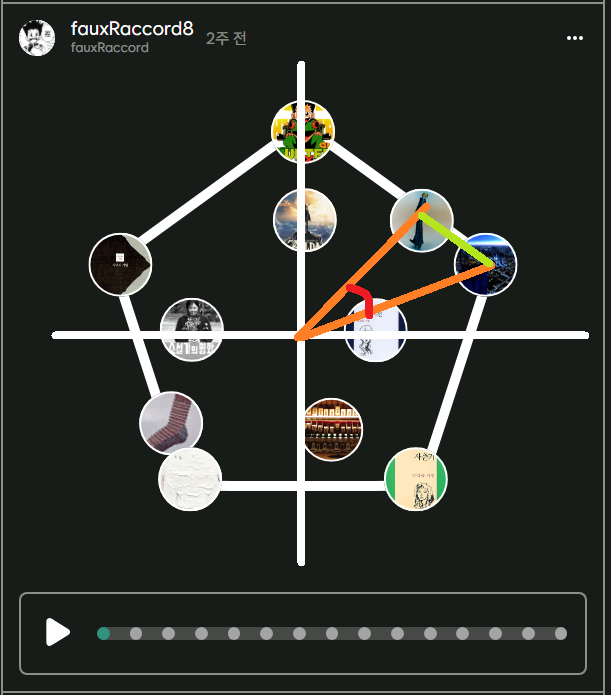
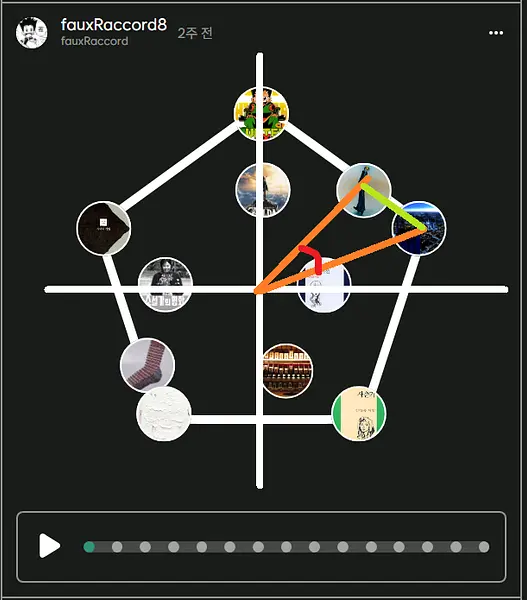
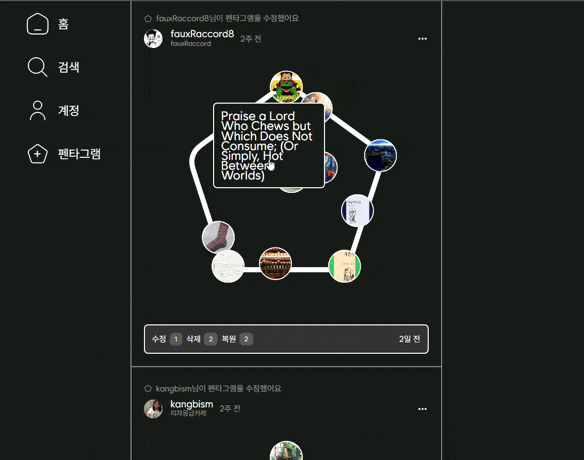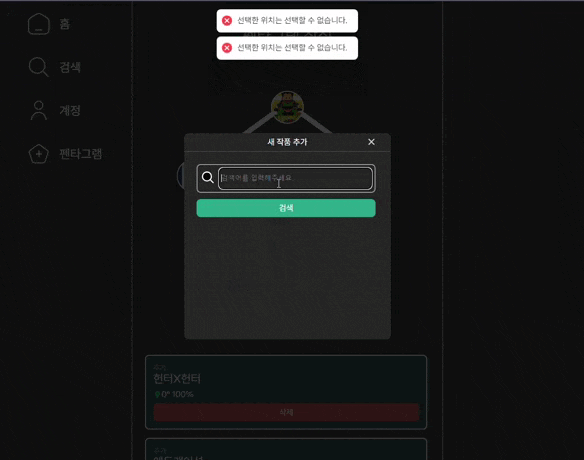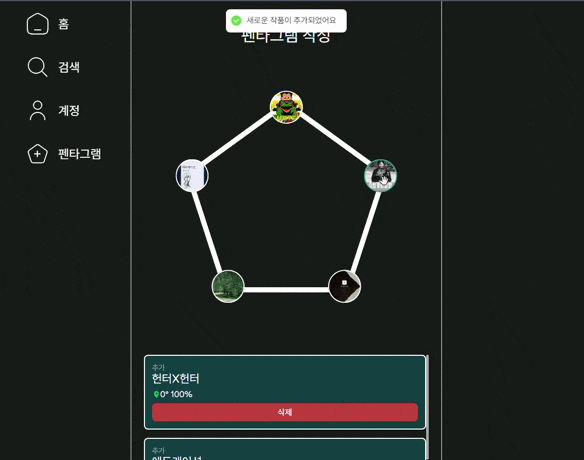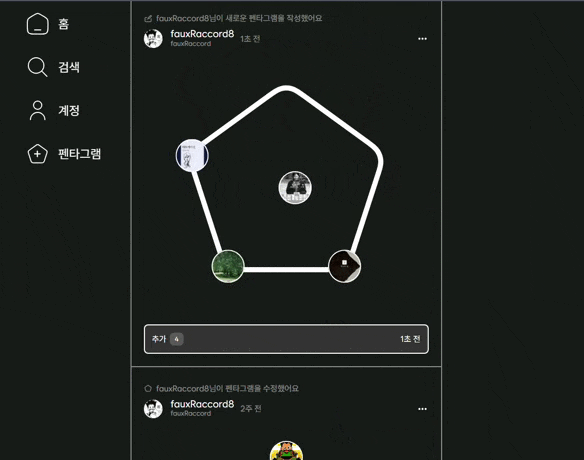
이제 위의 예시 자료가 단순한 작품들의 나열이 아니라 2차원 벡터에 매핑된 작품들이라는 사실이 눈에 들어올 것이라 생각합니다. 이 오각형이 의미하는 바는 무엇일까요? 이제 사용자의 시청 기록에 기반하여 유사성을 도출하는 것이 아니라 사용자가 유사하다고 생각하는 것에 기반하여 유사성을 계산할 수 있다는 말입니다. 또한 단순히 유사성이라는 계산된 결과를 보는 것이 아니라, 다른 사람의 연산 결과, 즉 다른 사람이 판단한 다른 유사성 정보를 직접적으로 탐색할 수 있게 됩니다. 적어도 내가 좋아하는 작품을 다른 사람들이 어떻게 생각하고 그것과 비슷한 작품이 무엇이라고 생각하는지 살펴보고 스스로 결정할 수 있다는 말입니다.
이 지점은 생각보다 중대한 의미를 갖는데, 이는 우리가 온라인 서점의 관련 도서를 생각해보면 금방 다가올 것이라 생각합니다. 관련 도서가 정확했던 적은 정말이지 단 한 차례도 없었습니다. 아니면 다 있는 책이거나 아는 책입니다. 다들 비슷하리라 생각합니다. 구글의 애드센스가 나름대로 제게 추천해주는 상품도 마음에 든 적이 없습니다. 우리는 알고리즘을 생각보다 의심합니다. 반면 남들이 올린 게시물은 적당히 신뢰하기 때문에 바이럴 마케팅이라는 것이 존재할 수 있는 것이겠지요. 이는 추천 결과의 인격화입니다. 우리의 신뢰는 단지 그 결과의 정확성으로 형성되는 것이 아니라 그 배후에 존재하는 (가상적) 인격에 대한 신뢰로 형성됩니다.
정보의 오염을 막을 수 있고 신뢰할 수 있는 원천을 사용자가 직접 탐색할 수 있게 한다면, 우리는 이제 시놉시스를 형태소 단위로 분석해서 계산한 유사도를 정말이지 포기할 수 있게 됩니다. 매번 틀리기만 하는 추천 컨텐츠로부터 해방되어, 능동적으로 탐색할 수 있고(팔로우하고 있는 사람들의 관점에서 평균적으로 유사한 작품), 또 다른 사람들은 그것과 어떤 작품을 나란히 놓고 또 멀리 놓는지 탐색할 수 있게 됩니다.
개인적으로 생각하는 이 방법의 최대 의미는 사실 탈정전화입니다. 그러니까 영화를 처음 보기 시작할 때 우리를 늘 괴롭히던 정전적 이름(르누아르, 트뤼포, 고다르, 히치콕, 혹스)에 기가 눌릴 필요가 없다는 것입니다. 분명 지나고 보면 그렇게 어려울 일은 아니었지만 입문자에겐 가혹한 것들이 있습니다. 이젠 반대로 자신이 재밌는 작품을 찾았을 때, 그 작품이 포함된 비선형적인 리스트들은 새로운 지도가 되어서 정해진 방식이 아닌 다른 방식으로의 작품 감상을 도와줄 수도 있을 것입니다.
물론 여전히 문제는 있습니다. 팔로우하는 사람 기준으로 특정 작품과 유사한 작품을 구하는 것은 굉장히 비싼 작업일 수밖에 없는 것이죠. 당연하지만 결과를 DB에 단순하게 저장해서 유사도를 조회할 수는 없습니다. 사용자에 따라 결과가 다르니까요. 마찬가지로 페이지네이션이 불가능하게 되죠. 가능하다고 하더라도 의미가 없고요. 왜냐면 어차피 순위를 구하기 위해서는 모든 레코드를 exhaustive한 방식으로 계산해야 하니까요.
이 문제를 해결했냐고요? 물론 하지 못했습니다. 근본적으로 불가능한 일인지도 모르겠지요. 사실 지금까지 개발하는 것도 이런 문제보다 더 많은 문제가 있었습니다. 다음 차례에는 제가 중간에 겪었던 문제들을 소개할까 합니다.