프로덕트

아티클

전체 보기
김정래

김정래

RAG를 활용한 AI 챗봇을 계획하신다면 알아두면 좋은 정보

안녕하세요.

디스콰이엇 덕분에 최근 RAG를 활용한 챗봇 개발 문의가 많이 들어와, 열심히 RAG 기반 AI챗봇을 만들고 있습니다.

해외 대학교의 TA 봇을 시작으로, 제품 검색 AI 챗봇, 법무법인 사례 검색 AI 챗봇에 이르기까지 다양한 분야의 AI 챗봇을 개발하고 있습니다.

최근 RAG AI 챗봇에 대한 관심이 뜨거워지고 있음을 체감하고 있습니다.

미팅을 나가면 많은 분들께서 이미 RAG에 대해 상당한 지식을 갖추고 오셔서, 흥미로운 제안들을 해주시곤 합니다.

이에 RAG를 활용한 챗봇 개발이나 도입을 고려하시는 분들께 도움이 되고자 이 글을 작성합니다.

1. gpt vs claude vs gemini vs 로컬모델

1) 챗봇을 도입할 때 가장 많이 여쭤보시는 부분이 로컬모델 활용입니다.

이는 주로 보안 및 데이터 유출에 대한 우려 때문인데요, 하지만

- gpt, claude, gemini api 문서를 보면, api에 사용된 input 및 output은 학습에 사용하지 않는다고 명시되어 있습니다. 또한 법적으로 요구되지 않는한 데이터를 30일 이후에 삭제합니다.(https://openai.com/enterprise-privacy/)

- 로컬모델에서 가장 많이 언급되는 llama 3.1 모델 중 그나마 쓸만한 70B 모델만 해도 학습 및 추론에 비싼 하드웨어가 필요합니다. 그리고 성능도 상대적으로 많이 떨어집니다. 가장 큰 문제는 모델 업데이트가 빈번해서 지속적인 관리가 필요합니다. 참고로 llama2 공개가 23년7월, llama3 공개가 24년4월, llama3.1 공개가 24년7월이었습니다.

그래서 법적으로 데이터 관리에 힘써야 하는 일부 기업이 아닌 이상 gpt, claude, gemini 중 하나를 골라 저렴하고 편하게 쓰는게 좋습니다.

2) gpt vs claude vs gemini 중 그럼 무엇을 추천하냐

[gemini]

- gemini의 가장 큰 문제는 저작권 및 성윤리 뭐 그런 이슈로 답을 종종 안한다는 겁니다. 심지어 어린이용 챗봇을 만들었을 때, 어린이가 "똥!"하고 대답하면 챗봇이 바보가 됩니다. 그래서 챗봇으로 쓰기 어렵습니다.

[claude vs gpt]

- gpt와 cladue는 답변 성능이 거의 비슷합니다. 어떤 부분에선 gpt가 좋고 어떤 부분에서 claude가 앞섭니다. 심지어 가격도 비슷합니다. 참고로 gpt-4o가 10월 2주차부터 저렴한 (gpt-4o-2024-08-06)api를 도입할 예정입니다.

- 다만 대량의 데이터 처리 시, gpt의 답변 속도가 약간이나마 빨라서, 저희는 주로 gpt를 사용해 챗봇을 만들었습니다.

2. 일반인 상대 챗봇을 만들 때에는 Vector search + GraphDB를 같이 활용하는 GraphRAG로 설계하는 게 좋습니다.

1) Vector search

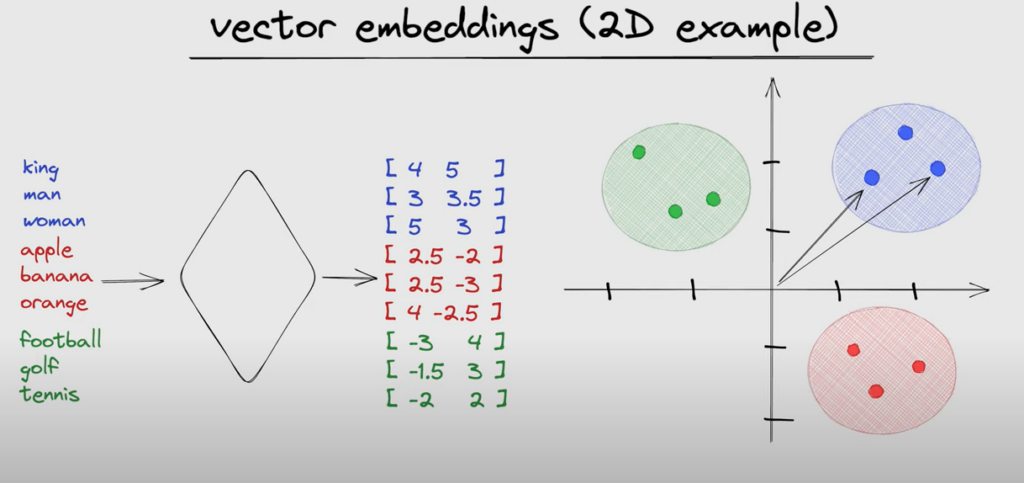
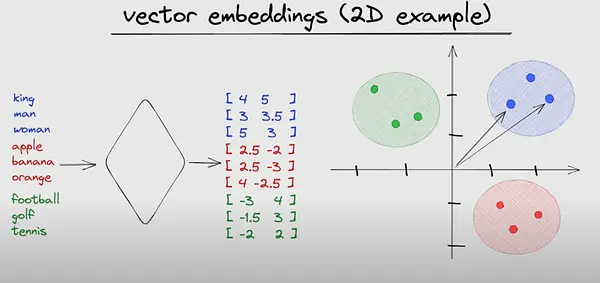
Vector search는 비슷한 뜻을 가진 단어들은 벡터 공간에 저장해서 검색하는 방법입니다.

예를 들어 아래 이미지처럼 king, man, woman이 비슷하니 뭉쳐있고, apple banana, orange가 비슷하니 뭉쳐 있는 것처럼 비슷한 뜻을 가진 단어들을 묶어서 검색하는 방법입니다.
vector_embedding.png

[이미지 참조 : causewriter.ai]

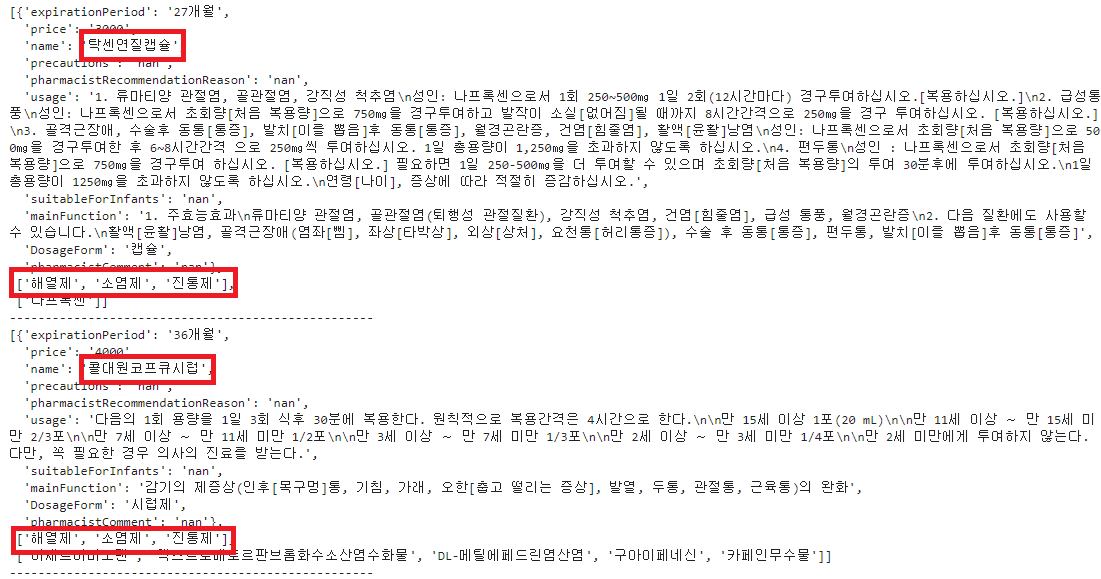
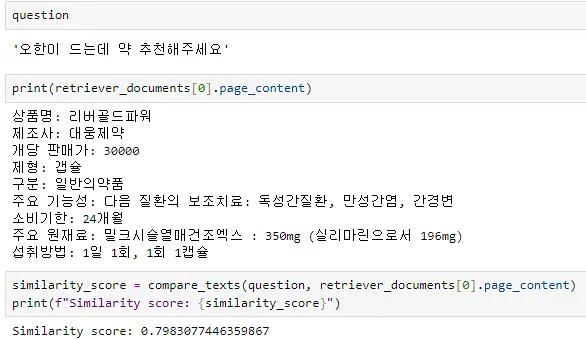
하지만 이 방식에도 한계가 있습니다. 아래 예시처럼, 한글 + 전문적 데이터를 이용하는 챗봇은 일반인이 사용하는 단어를 이해하지 못하는 경우가 종종 발생합니다. (오한과 관련 없는 약이 추천됩니다.)
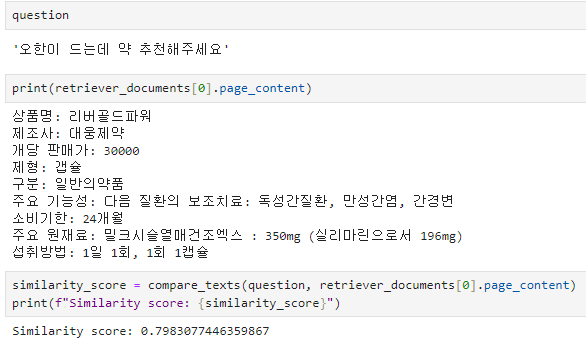
image (4).png

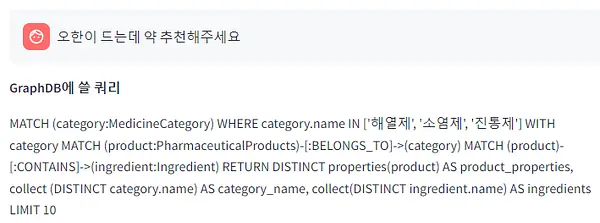
이러한 문제를 해결하기 위해 gpt를 활용하여 GraphDB 검색용 쿼리를 생성하여 검색하는 방법이 필요합니다.

이 방식을 사용하면 아래 이미지처럼 gpt가 GraphDB 검색용 쿼리를 생성해 적합한 제품을 추천해주는 것을 볼 수 있습니다.
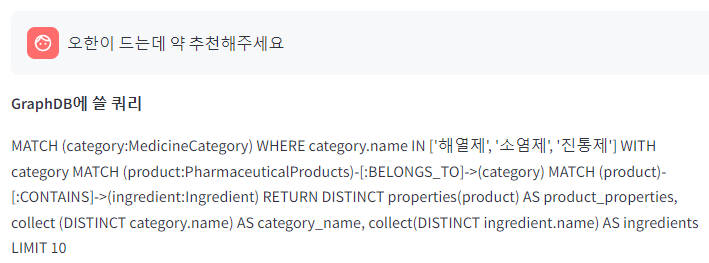
image (6).pngimage (5).png

2) 그렇다고 단순히 GraphDB만 사용하면, 또 다른 문제가 발생할 수 있어 Vector search도 함께 사용해야 합니다.

예를 들어, 사용자가 "ice아메리카노 주세요"라고 요청했을 때, GraphDB에서는 "아이스 아메리카노"로 정확히 매칭되는 결과를 찾지 못할 수 있습니다. 이러한 경우에 비슷한 의미를 찾아주는 Vector search가 유용합니다.

다행히도 Neo4j와 같은 GraphDB 솔루션에서는 Vector search 기능도 함께 제공하고 있어, 두 기술을 결합하여 사용하는 것이 효과적입니다. 이렇게 함으로써 정확한 키워드 매칭과 의미적 유사성을 모두 고려한 검색이 가능해집니다.

이러한 방식을 통해 일반 사용자의 다양한 표현과 전문 용어 사이의 간극을 더욱 효과적으로 메울 수 있습니다.

3. gpt는 최대한 쪼개서 사용해야 합니다.

gpt가 정말 우수하지만, 아직 완벽하지는 않습니다. 특히 RAG처럼 입력값이 많은 경우 gpt의 답변이 기대에 미치지 못할 때가 있습니다.

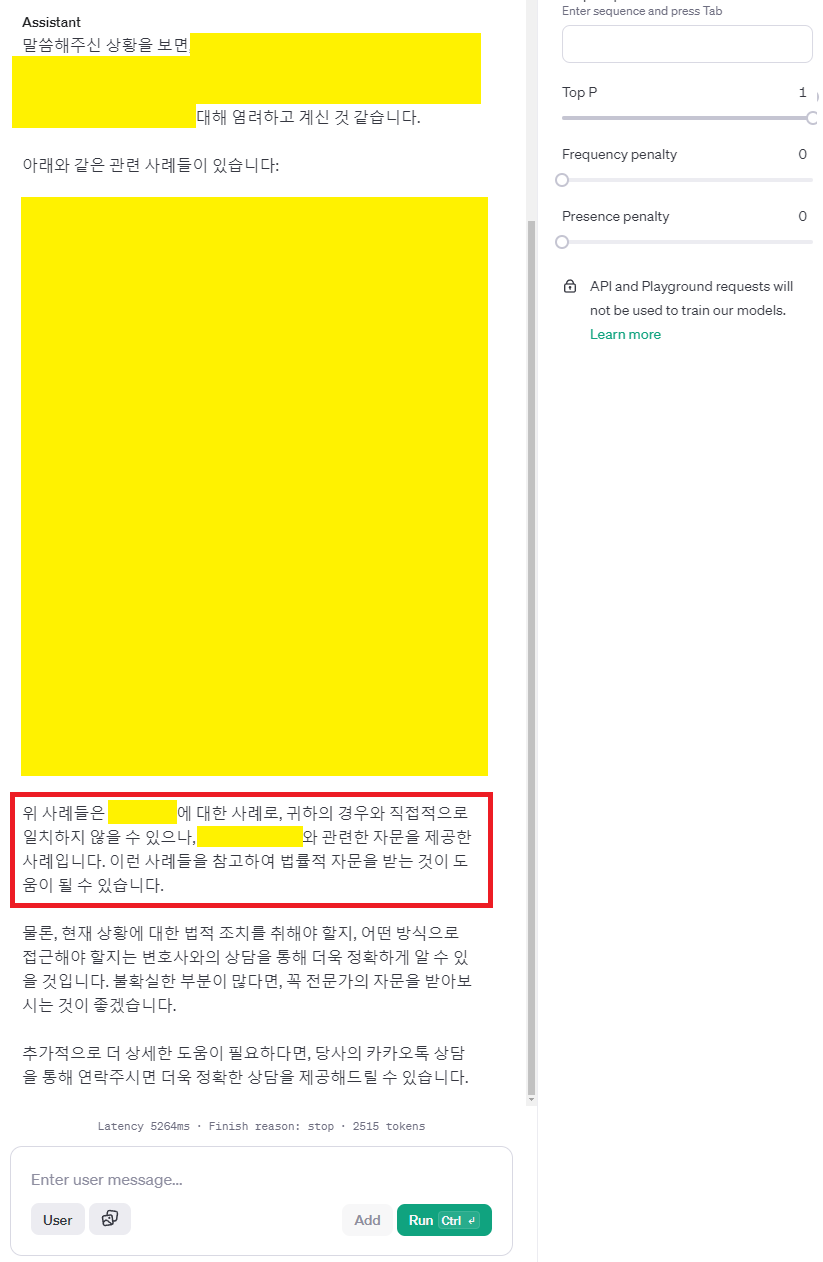
아래는 RAG 챗봇의 잘못된 답변 예시입니다. 답변에서 알 수 있듯이 관련 없는 사례들을 가져와 억지로 대답 한 것을 볼 수 있습니다. 기대했던 답변은, "관련된 사례가 없습니다. 당사의 카카오톡 상담을 통해 연락주시면 상담을 제공해드릴 수 있습니다." 같은 것이었지만, GPT의 특성상 어떻게든 답변을 만들어내려고 하여 위와 같은 부적절한 답변이 나왔습니다.

위 사례들은 **** 사례로, 귀하의 경우와 직접적으로 일치하지 않을 수 있으나, **** 와 관련한 자문을 제공한 사례입니다. 이런 사례들을 참고하여 법률적 자문을 받는 것이 도움이 될 수 있습니다.
rag_error_image.png

이런 문제를 해결하기 위해서는 프롬프트 하나에 여러 조건을 때려넣는 것이 아닌, 기능별로 쪼개서 gpt를 사용하면 됩니다.

1) 추출한 데이터가 유저 질문과 관련 있는지 체크하는 gpt

2) 관련이 있으면 답변하는 gpt

3) 관련이 없으면 카카오톡을 통해 상담을 요청하도록 유도하는 gpt

이렇게 기능을 분리하여 GPT를 사용하면 더 정확하고 적절한 답변을 제공하는 것을 보실 수 있습니다.

4. 이용자를 잘 아는 내가 알려줘야 내 마음에 드는 챗봇이 나옵니다.

가장 중요한 부분입니다. 막상 챗봇은 만들고 RAG 성능 평가에서 높은 점수를 받더라도 점수와 별개로 답변이 아쉬운 경우가 많습니다. 이런 식으로 말하는 거보다 요런 식으로 말해주면 좋겠는데 하는 생각이 듭니다.

왜냐하면 챗봇이 아직 고객상담 뉴비이기 때문입니다. 그래서 경험이 많은 내가 어떻게 답변해야 하는지 가이드를 제공해줘야 합니다.

간단하게 분류 / 질문 유형 / 질문 예시 / 답변 예시 / 답변 순서 가이드라인 형태로 표를 만든 후 테스트를 하면 됩니다.
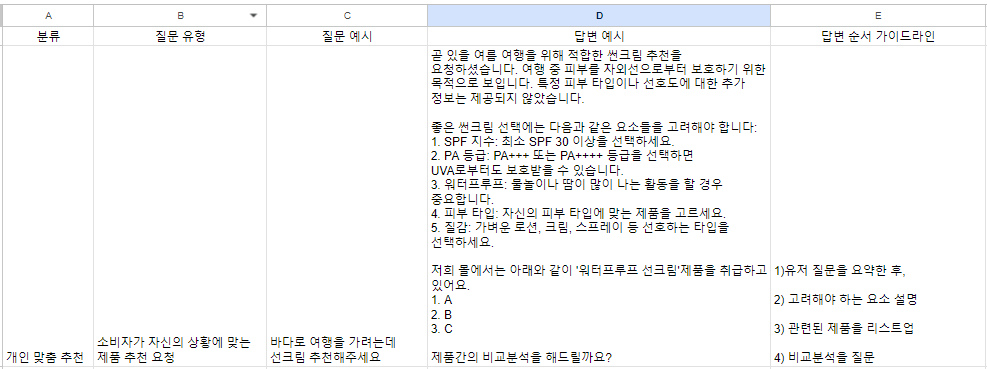
가이드라인예시.png

막상 처음에는 답변 예시나 가이드라인을 적는 것이 어색할 수 있습니다. 뭘 넣어야 하지, 어떤 식으로 답변하는게 좋은거지? 하는 생각이 드는데요.

이럴 땐, 아래 순서에 따라 만드시면 됩니다.

1) 일단 질문 예시만 많이 만들어 챗봇 테스트를 진행합니다.

2) 각 질문에 대한 답변이 마음에 들면 뭐가 마음에 드는지 마음에 안들면 뭐가 마음에 안드는지 한번 적어봅니다.

3) 마음에 안드는 부분을 위주로 챗봇을 고친 후에 다시 테스트합니다.

4) 그러면 아 이 부분이 이래서 좋았던 거고, 저 부분은 이래서 안 좋았던 거구나 하고 파악할 수 있습니다.

위 과정을 여러 번 반복하면 효과적인 가이드라인을 만드실 수 있습니다. 이 가이드라인이 꼭꼭꼭 있어야 챗봇의 답변을 더욱 정교하고 만족스럽게 만들 수 있습니다.

RAG 기반 AI 챗봇에 대해 더 많은 정보들을 쓰고 싶은데, 막상 생각나는게 크게 4가지네요. 뭔가 여러 이미지들을 넣고 싶었는데, 막상 적합한 이미지들이 없어 장황한 줄 글이 되어 버렸네요 ㅠㅠ.

다음번에 기회가 된다면 이미지를 가득가득 눌러 담아 저희가 만든 챗봇들을 쭈욱 정리해보겠습니다.

RAG에 대해 궁금한 점이 있으시면 언제든 편하게 물어봐주세요.
21
6
김정래

김정래

할루시네이션이 거의 없는 챗봇(Graph db 사용)

제가 만든 챗봇 링크입니다.

https://carillon-legal-chatbot.streamlit.app/

데모라 streamlit에 올렸습니다.

그래서 제가 만든게 뭐냐면,

1. 근로기준법과 관련 행정해석, 판례를 graph db 넣은 후

2. 유저의 질문과 관련된 데이터를 graph db에서 뽑아낸 뒤에

3. 이를 바탕으로 유저에게 답해주는 챗봇입니다.

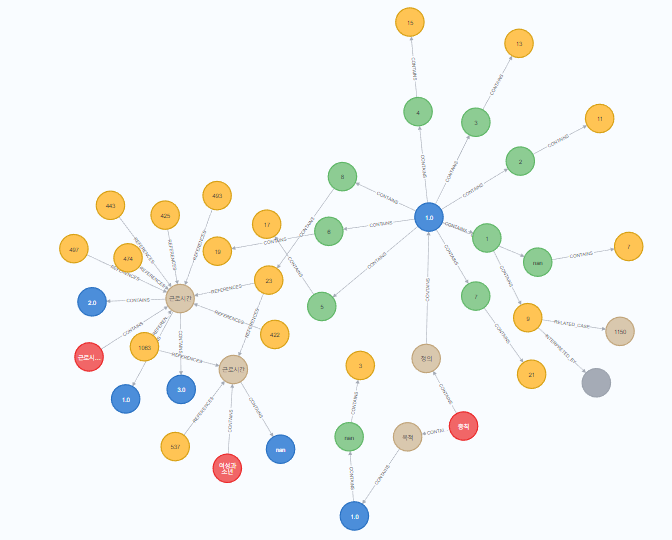
아래 이미지처럼 법과 관련된 판례, 행정해석들을 서로 연결하여 저장했습니다. 그리고 유저가 질문을 하면 아래 그래프에서 법과 그 법과 연결된 판례 및 행정해석을 뽑아낸 후 프롬프트에 해당 내용을 추가합니다. 쉽게 오픈북 테스트를 보는 챗봇라고 보시면 됩니다. 유저가 낸 문제를 책(graph db)에서 찾아서 유저가 낸 문제의 맞는 형태로 답변을 줍니다.

graphdb.png

넣은 판례 데이터가 해고, 휴가, 근로계약 쪽이라 이 부분과 관련해서 물어보면 잘 답변해줍니다.

추천 질문
1. 최근에 일을 못한다고 갑자기 짤렸는데, 어떻게 해야 하나요?
2. 병원이 영업정지를 당했는데, 영업정지 오기로 했던 간호사에게 휴업수당을 줘야 하나요? 그 간호사는 한번도 일하지 않았습니다.
3. 지각했다고 휴가를 뺏었는데 말이 되는건가요?

네이버지식인 예시(해당 링크)

질문 : 해고시기와 해고사유에 관하여 이메일(e-mail)로 통지를 받았어요. 유효한 해고로 볼 수 있을까요?

챗봇 답변 :
따라서, 이메일로 해고 통지를 받은 경우라도 다음 조건이 충족되면 유효한 해고로 인정될 수 있습니다.
1. 이메일에 해고사유와 해고시기가 명확히 기재되어 있을 것.
2. 근로자가 이메일을 수신하여 그 내용을 알고 있을 것.
만약 이러한 조건이 충족된다면, 이메일에 의한 해고 통지는 유효한 서면 통지로 간주될 수 있습니다. 관련 판례는 여기에서 확인할 수 있습니다.

지식인답변(대한법률구조공단) :
따라서 단지 이메일로만 통지를 받았다는 사유만으로 해고가 무효로 되는 것이 아니라 구체적인 사정을 따져보아 근로자가 해고시기와 해고사유에 대해서 알 수 있었던 경우로 인정되는 때에는 유효한 방식의 해고로 인정될 수 있다고 보아야 합니다.
(지식인의 자세한 답변은 위 링크에서 볼 수 있습니다.)

챗봇 전체 답변

만들면서 느낀 점

  1. LLM 성능이 좋아지면서 graph db에서 데이터를 검색하는 명령어를 LLM이 잘 만들어낸다. gpt-3.5에서는 안됐었는데, gpt-4 부터는 매우 잘해줍니다.

  2. Graph db + vector similarity 를 활용한 Graphrag 는 성능이 좋지만 비용이 비싸다(gpt-4o 기준으로 1번 검색에 100원정도 들었던거 같아요)

  3. Graph db를 LLM이 만들어도 되지만, 직접 만들면 성능이 더 좋습니다.

비개발자를 위한 매우 간략한 설명

Graph database(그래프 데이터베이스)

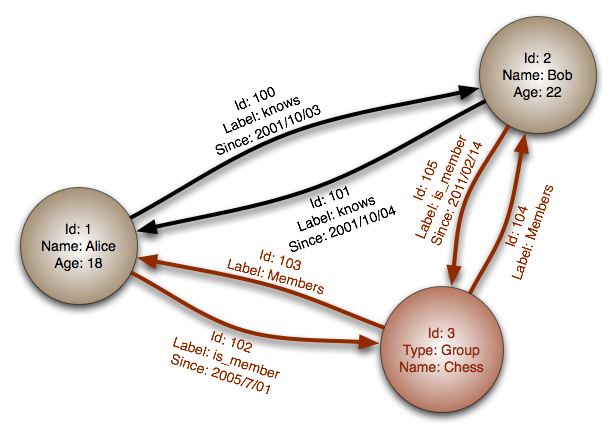
기존 데이터베이스는 엑셀처럼 데이터를 표 형태로 저장한다면, graph db는 마인드맵처럼 정보들을 점(node) 형태로 저장하고, 그 점들의 관계를 연결하는 형태의 데이터베이스입니다.

아래 예시 이미지처럼 Alice와 Bob이라는 점을 만들고, 둘이 서로 2001/10/03부터 알고 지냈다는 관례를 만들어 저장합니다.

GraphDatabase_PropertyGraph.png

An example of a Labeled-property graph<by Ole Mussmann, wikipedia>

궁금한게 있으시면, 편하게 물어봐주세요. 사실 저도 잘 모르기 때문에 뻔뻔하게 답변드릴 수 있습니다 :)
챗봇은 법률상담이나 예측 등 법률사무를 하지 않습니다. 결과는 단순 참고용으로만 사용하시고, 정확한 상담은 변호사에 문의하시기 바랍니다.

10
5
김정래

김정래

내가 가진 데이터로 AI 챗봇이 만들어지나? - [Gemini API + Rag]

비용 : 무료

준비물 : Gemini 계정, 챗봇에 넣을 텍스트 데이터

예상시간 : 10분 내외?

안녕하세요.

오랜만에 글을 씁니다. 마지막 글로부터 8개월 만이네요. 디스콰이엇에 쓴 글들 덕분에 AI에 대한 자문이 많이 들어왔습니다. 덕분에 정신없이 AI를 만들고 보니 어느새 8개월이 지났네요. 디스콰이엇에 무한한 감사 인사를 드립니다.

AI에 대한 자문을 하면서, 비싼 비용과 어려운 난이도로 인해 실제 업무에 AI를 적용하지 못하는 분들을 많이 봤었습니다. 심지어 가볍게라도 AI 테스트를 해보고 싶지만, 이마저도 어려워하시는 분들이 많았습니다. 그래서 이러한 분들을 위해서 싸게 그리고 쉽게 써볼 수 있는 챗봇 AI 코드를 소개할까 합니다.

AI 챗봇이 어느 정도 성능을 보이는지, 자기가 가지고 있는 데이터로 AI 챗봇을 만들 수 있는지 궁금하신 분들께서 따라 하시면 좋을 거 같습니다. 해당 글에서 사용하는 기술은 RAG 기법 중, Dense Retrieval이라는 기술입니다. AI에게 문서를 주고, 해당 문서 내용을 바탕으로 답변을 하도록 하는 기술입니다.

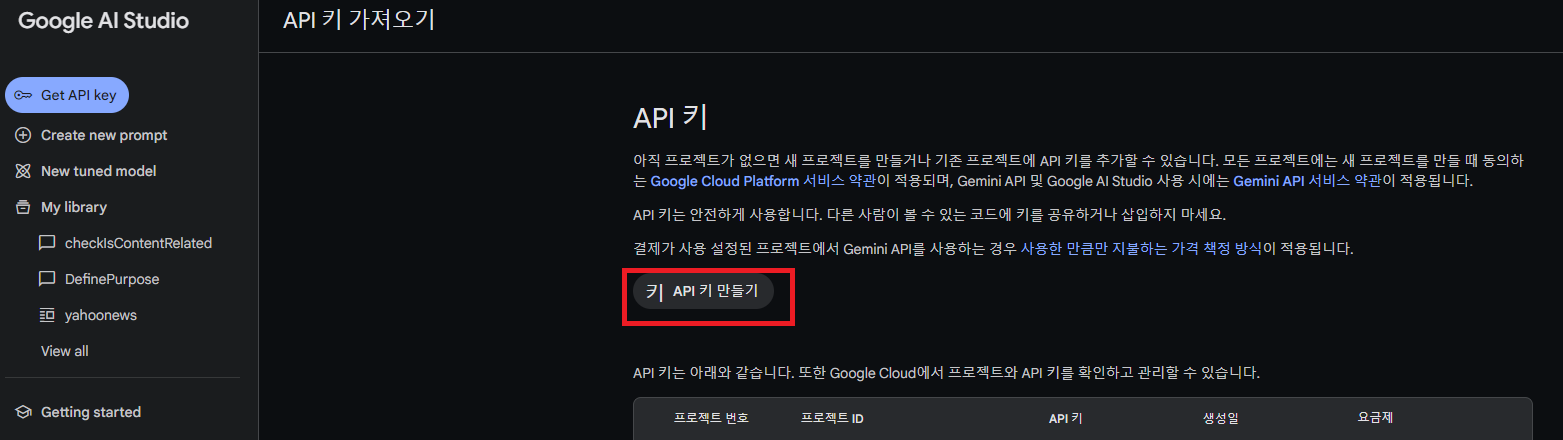
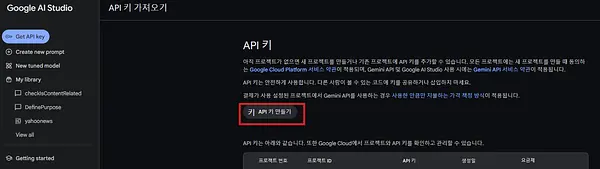
1. Gemini api키를 생성합니다.

https://ai.google.dev/gemini-api

Gemini 사용 이유

- 성능 좋은 gemini-1.5-flash api를 무료로 제공해 준다.

- 속도 향상을 위해 유료 버전으로 바꿔도 매우 저렴하다.

- Embedding 모델로 OpenAI를 쓰면 더 빠르고 좋은데, OpenAI api를 가져오라고 하면 매우 귀찮기 때문에 gemini 하나만 쓸 예정입니다.

gemini_api_key.png

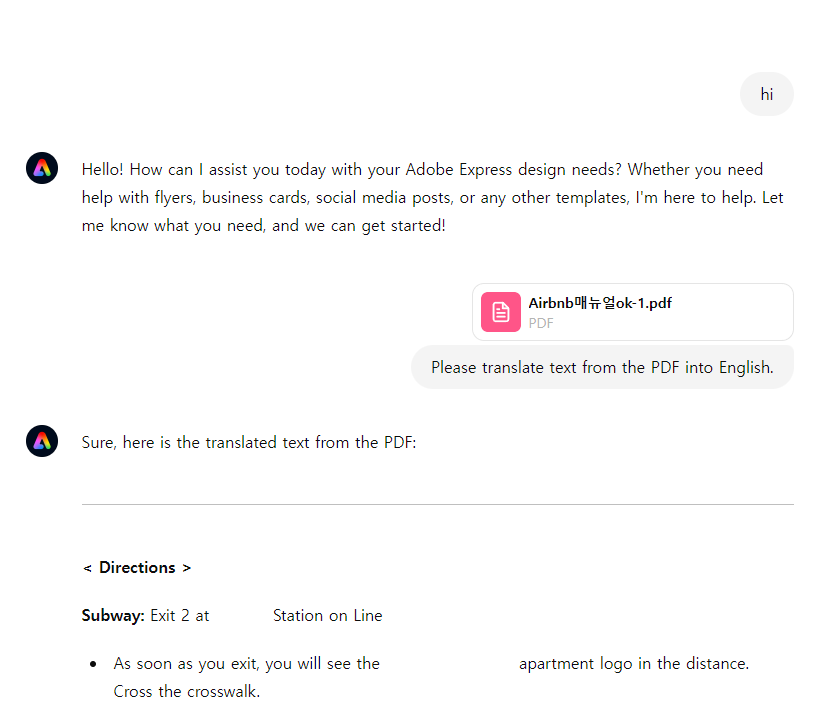
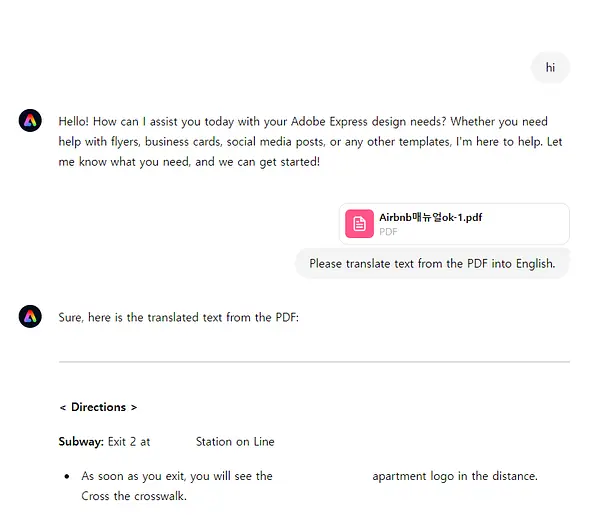
2. chatgpt에 가서 내 데이터를 영어로 번역해달라고 합니다.

여러 gpt 모델 중 아래 adobe-express가 pdf를 제일 잘 읽고, 번역도 깔끔하게 해줍니다.

https://chatgpt.com/g/g-pcoHeADVw-adobe-express

openai 회원가입만 해도 무료로 사용하실 수 있습니다.

translate.png

번역하는 이유

- 한글을 그대로 밀어 넣으면 성능이 제대로 안 나옵니다.

- 한글은 영어보다 Token을 많이 잡아먹기 때문에, 영어로 번역하여 사용하는 것이 여러모로 유리합니다.

저는 Cornell 고양이 건강 센터의 자료를 가지고 만들 예정입니다. 모든 데이터를 넣으면 속도가 느려서, 행동 문제(Behavioral Issues) 부분만 넣을 예정입니다.

https://www.vet.cornell.edu/departments-centers-and-institutes/cornell-feline-health-center/health-information/feline-health-topics

* 무료버전일 경우, 워드 파일 기준 10페이지 이하로 테스트하는 것을 추천드립니다.


3. 번역한 파일 저장하기

위에서 번역해 준 내용을 메모장에 저장합니다. pdf로 만들어도 상관없습니다.

여러 개를 넣어도 상관없습니다.

다만 그만큼 느려집니다.

* gemini는 똑같은 말을 반복하면 작동을 멈추는 이슈가 있습니다. 그래서 데이터를 이쁘게 넣어도 에러가 날 수 있습니다.

4. 코드 실행하기

* 제가 최대한 간단하게 만들다 보니 조금 안 이쁠 수 있습니다.

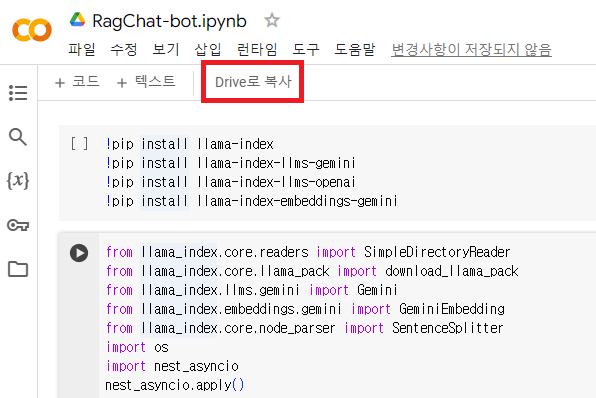
코렙 링크 :

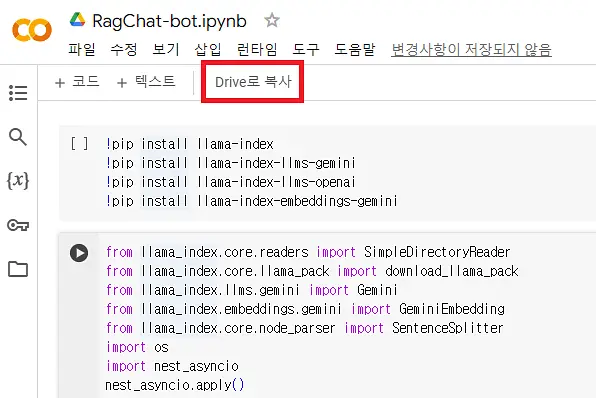
1) 드라이브로 복사 클릭

colab-1.png

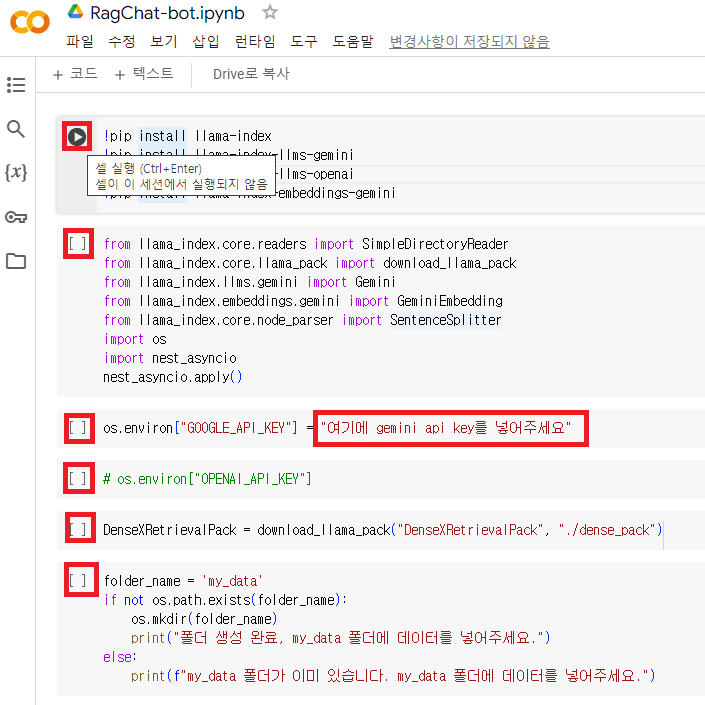
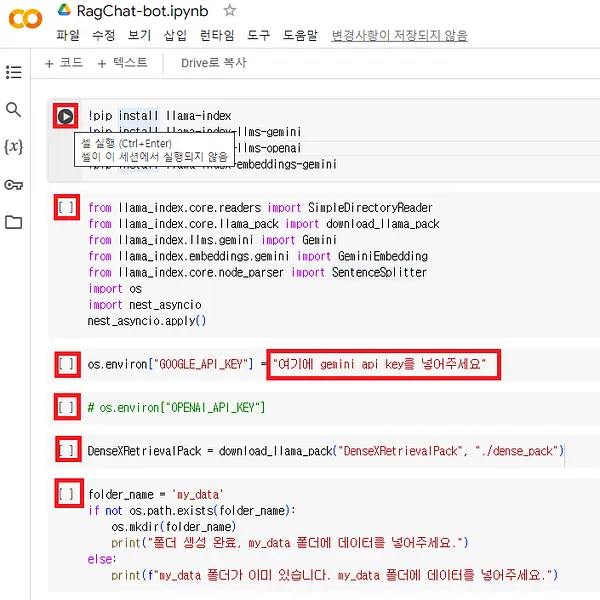
2) Gemini api key를 넣은 후에 my_data 폴더에 데이터를 넣어주라는 문구가 나올 때까지 실행 버튼을 쭉 죽 눌러주세요. 세션 다시 시작 멘트가 나오는데, 세션 다시 시작 버튼을 누르신 후에, 처음부터 다시 실행 버튼을 누르시면 됩니다.

ex) os.environ["GOOGLE_API_KEY"] = "12345678910"

실행버튼.png

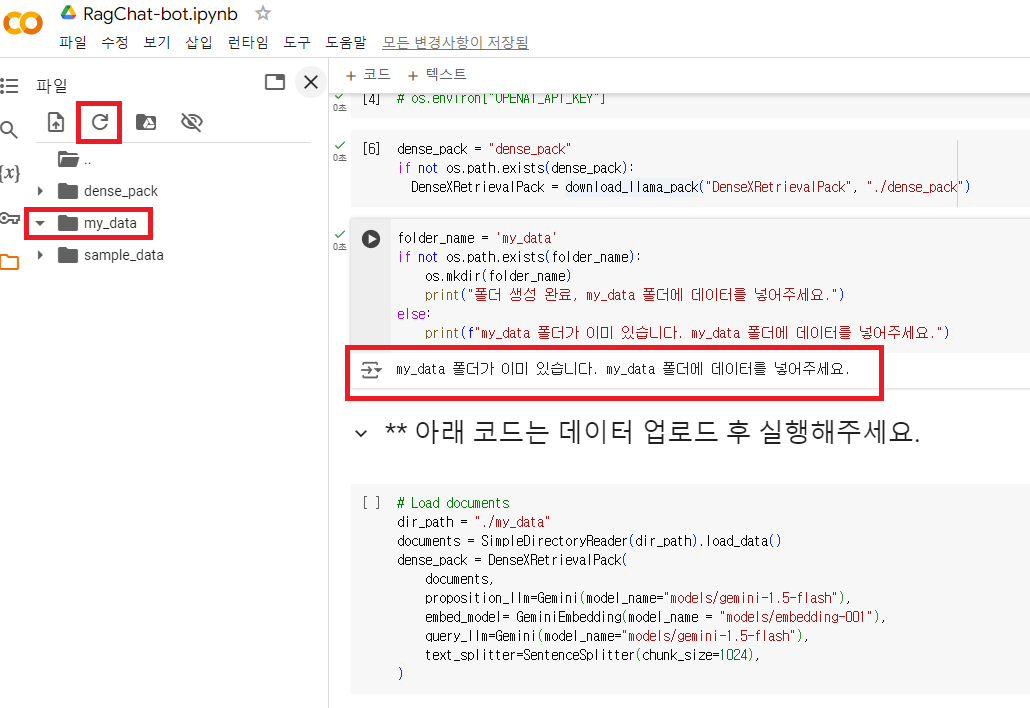
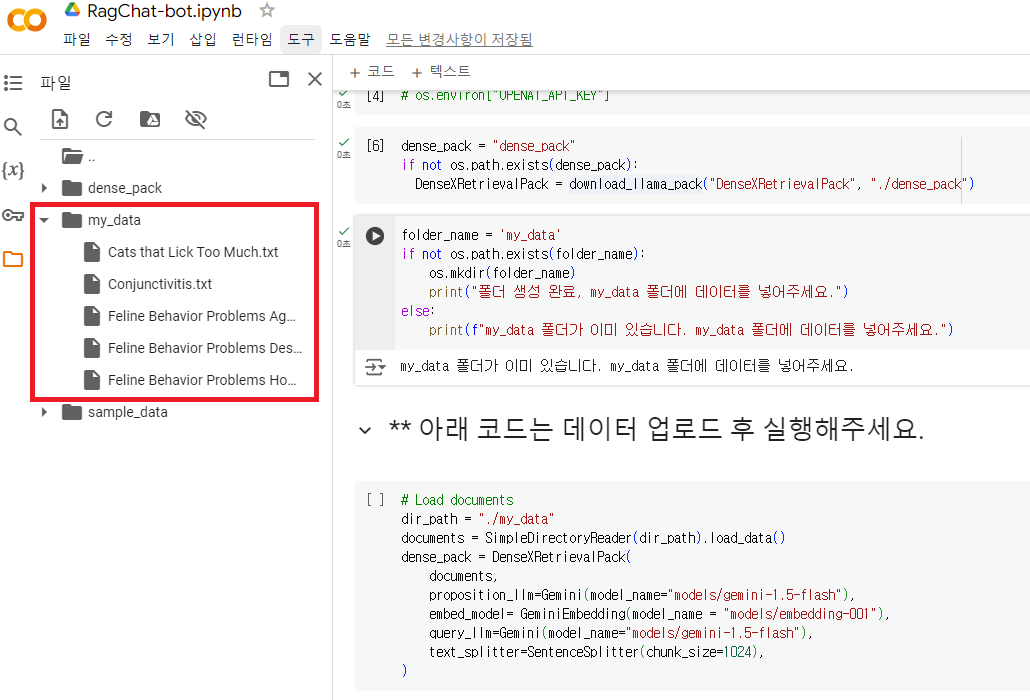
3) my_data 폴더가 생성 완료되면, 왼쪽 폴더 버튼을 누른 후 my_data에 앞에서 만든 데이터를 넣어주세요. 파일을 드래그해서 폴더에 파일을 넣으시면 됩니다.

- 안 보이면, 새로고침 버튼을 눌러주세요

my_data.pngmy_data2.png

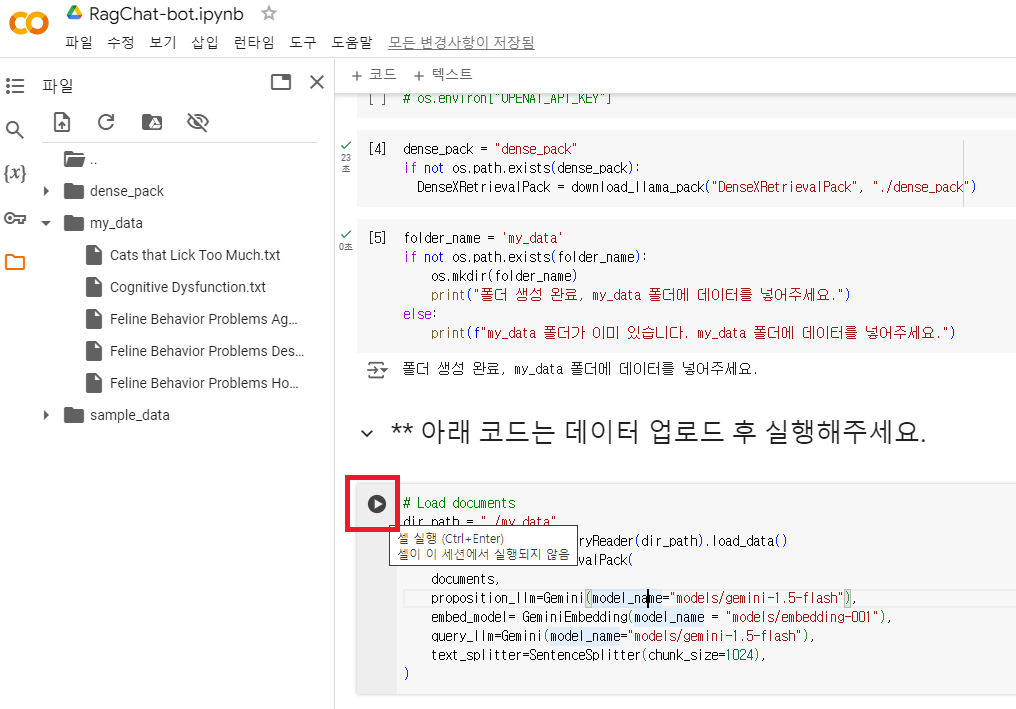
4) 이제 챗봇에게 data를 학습 시키는 코드입니다. 이어서 코드를 실행하세요. 학습 속도가 느리다 싶으시면, OpenAI api key를 입력하시고, embed_model을 지우시면 됩니다. 기본 설정이 OpenAI로 되어 있어서 코드에서 embed_model부분만 지우면 바로 적용됩니다. 최대한 무료로 간단하게 하려고 Gemini만 쓰다 보니 속도가 다소 느립니다.

model_학습.png

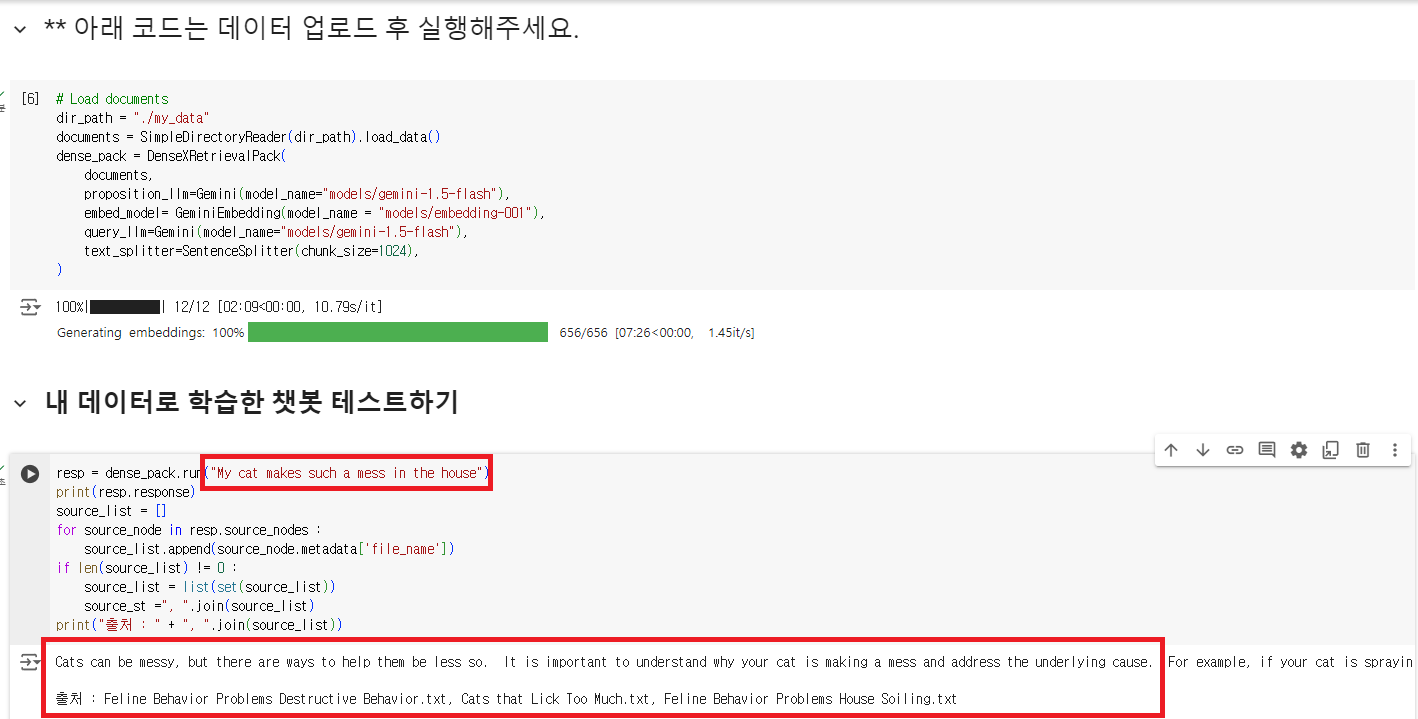
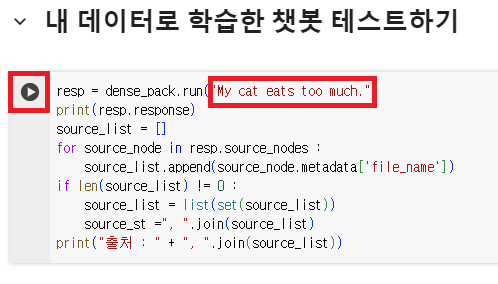
5) 학습이 완료되면, 질문을 넣고 코드를 실행해 보세요.
- 학습이 영어로 되어 있기 때문에, 되도록 영어로 번역해서 넣는 것이 더 좋은 결과치를 보여줍니다.
- 위 데이터는 워드 기준 약 30페이지 정도 되는 데이터입니다. 학습에 약 10분 정도 걸렸네요.

학습결과 및 출력.png

6) 다른 질문도 넣어서 테스트해 보세요.
- 질문만 바꿔서 넣은 후에 다시 실행 버튼을 누르시면 됩니다.

다시질문.png

이상 내 데이터로 ai챗봇을 만드는 방법이었습니다.

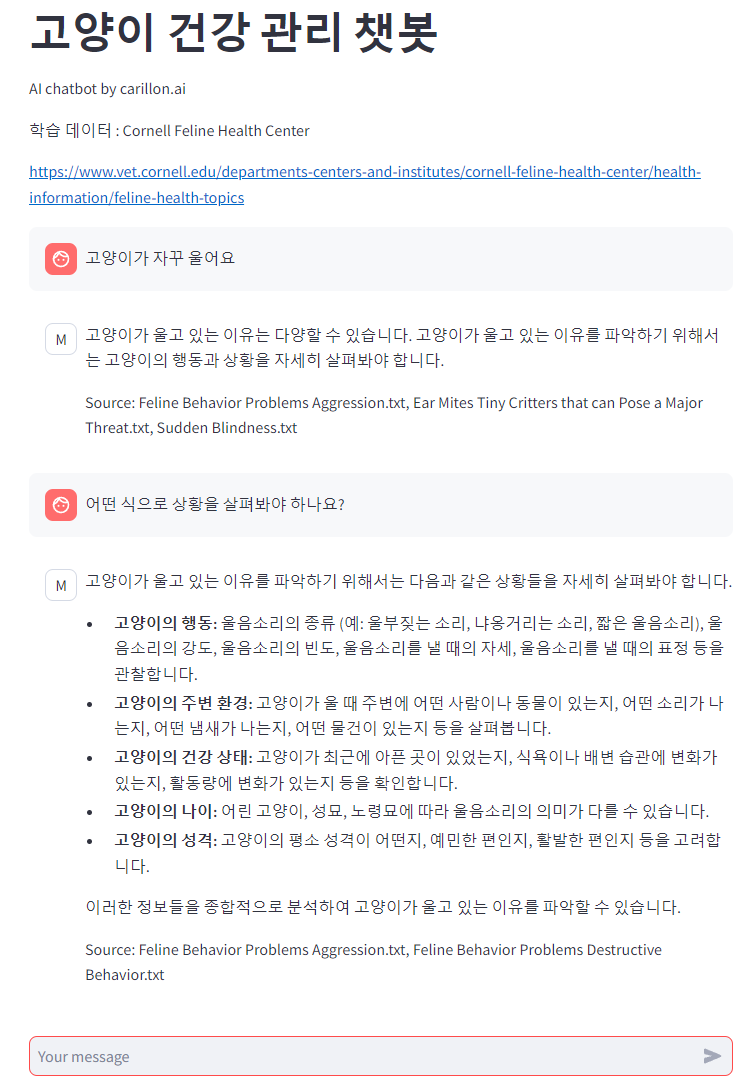
내 학습 데이터를 가지고 이것저것 테스트해 본 후 오 꽤 괜찮다 싶으면, 이제 챗봇을 만들면 되는데요, streamlit이라는 서비스를 이용하여 아래 링크처럼 매우 간단한 챗봇도 만드실 수 있습니다.

* gemini는 규제가 많아서, "고양이가 똥을 싸요?","고양이가 당뇨가 있나요?"와 같은 몇몇 질문은 자체적으로 막아버립니다.. ㅠㅠ

데모 링크 : https://aichatbot-test-carillon.streamlit.app/

demo.png

AI를 활용한 서비스에 대해 이야기를 나누고 싶으시면 언제든 환영입니다.

8
0
김정래

김정래

Llama 7b를 쉽고 싸게 Fine-Tuning 하기

먼저 Llama 7b를 구글 코랩에서 바로 fine-tuning 할 수 있는 링크를 전달드립니다. T4에서도 Llama 7b를 바로 fine-tuning 할 수 있는 것을 볼 수 있습니다. 심지어 단 몇 분만에요!!!

이건 마치 줄 서서 겨우 먹을 수 있는 유명 쉐프의 비싼 요리를 싼 가격에 밀키트로 쉽게 먹을 수 있게 된 것과 비슷하다고 볼 수 있습니다.

https://colab.research.google.com/drive/1Ly01S--kUwkKQalE-75skalp-ftwl0fE?usp=sharing

올해 초 허깅페이스에서 PEFT라는 효율적으로 Fine-tuning을 할 수 있는 기술을 공개합니다(https://github.com/huggingface/peft ).

간략하게 2천만 원이 넘는 그래픽카드(A100 80GB)로도 못하던 fine-tuning을 PEFT 덕분에 가능하게 된 것이죠. 가능은 했지만 1개 그래픽카드로 fine-tuning을 시키는데 오랜 시간이 걸렸습니다.

그리고 중순에 QLoRa라는 획기적인 기법이 등장하면서, 이제 2백만 원이 안되는 그래픽 카드(T4)로 fine-tuning이 가능해지기 시작합니다. 물론 그래도 T4로하면 오랜 시간이 걸리거나 종종 메모리가 부족해, A100으로 빠르게 처리하는 편이었습니다.

그러다 PEFT와 QLoRa 그리고 몇몇 최적화 기능이 들어가면서 2천만 원짜리 그래픽카드 하나로는 엄두도 못 냈던 fine-tuning을 이젠 구글 코랩에서 무료로 쓸 수 있는 그래픽카드(T4)로 해볼 수 있게 된 것입니다(다만 무료로 쓰면 금방 컴퓨터 소스가 부족해서 fine-tuning 몇 번 못할 수 있습니다.).

물론 위에 말한 것처럼 정식 요리가 아닌 밀키트이기 때문에 서비스로 쓰기엔 성능의 무리가 있을 수 있지만, 가벼운 작업은 충분히 잘하는 것을 볼 수 있습니다. 심지어 밀키트답게 fine-tuning 시간도 금방입니다.

11
1
김정래

김정래

10분 내로 끝낼 수 있는 AI 커버곡 만들기

최근 유튜브에 보시면 AI 커버곡들이 많아졌죠?

몇 달전 경량화된 모델이 나오면서 누구나 쉽게 커버곡을 만들 수 있게 되었기 때문이죠.

모델 설명이나 이론 이런 것보다 일반인들에게 필요한 것은 어떻게 사용하냐죠.

그래서 정말 쉽게 AI 커버곡 만드는 과정을 입문자 관점에서 설명드릴게요.

딱 속는 셈 치고 10분만 투자해 보세요.

사실 무슨 노래로 만들어 볼까 하는 고민이 가장 오래 걸리고 나머지 과정들은 금방 끝납니다.

1. 커버곡 선택하기(선택에 따라 2~10분)

음원사이트를 통해서 노래를 구합니다. 저 같은 경우는 유튜브 음원을 추출해서 사용합니다.

- 코러스나 에코가 없는 노래일수록 결과물이 좋습니다. 랩은 추천하지 않습니다.

2. MR과 목소리 나누기(컴퓨터 사양에 따라 1~5분)

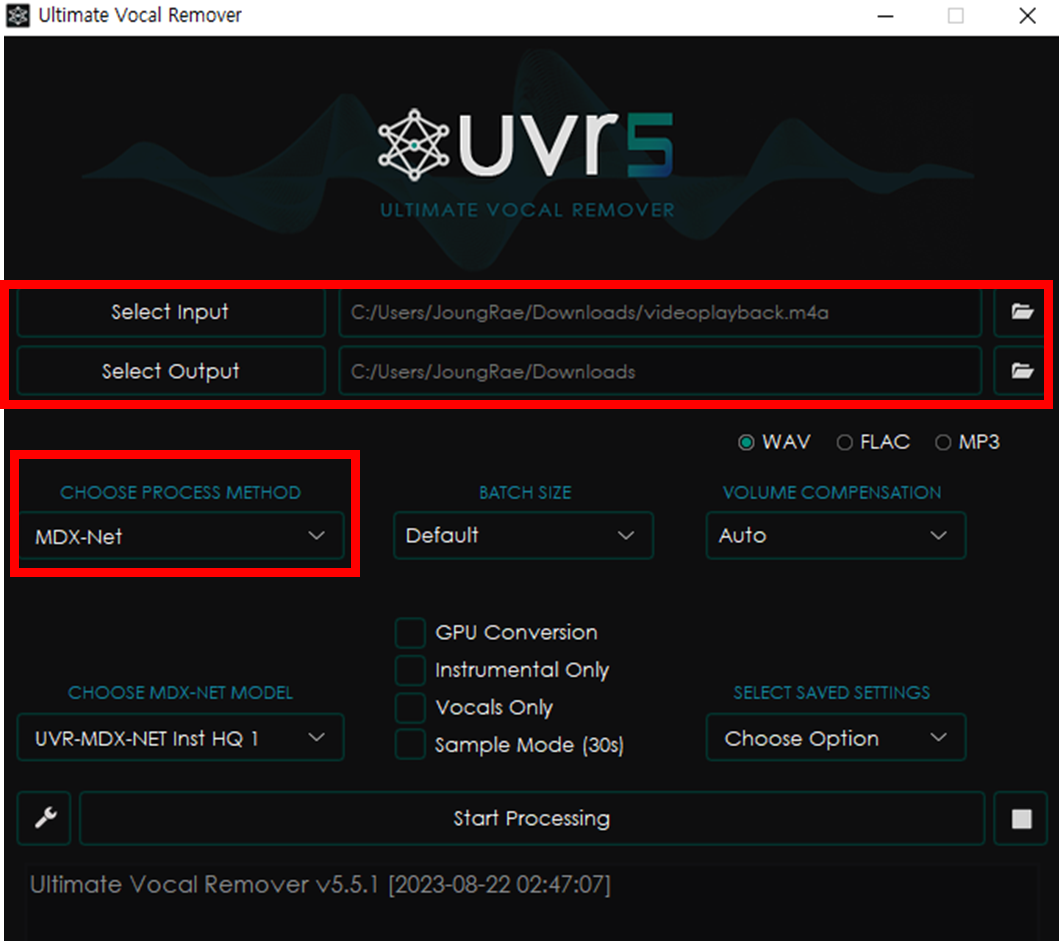
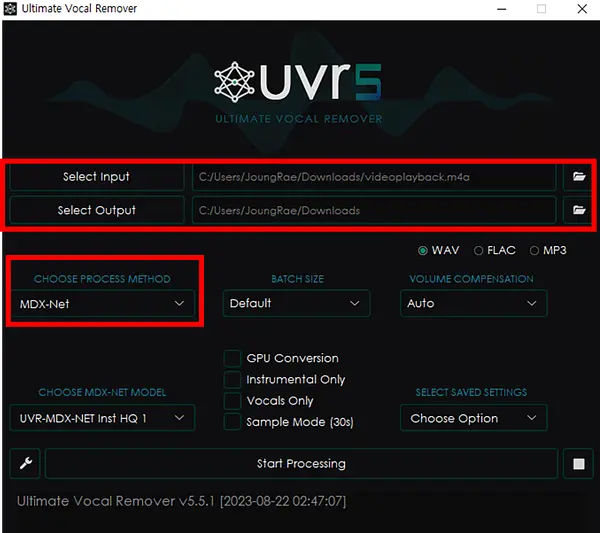
무료로 목소리와 MR을 나눠주는 "Ultimate Vocal Remover v5"를 사용해서 목소리와 MR을 나눠줍니다.

Input 파일과 결과물 저장할 폴더 그리고 Method를 선택해 줍니다.

- AI 커버곡 퀄리티에 가장 큰 영향을 미치는 것이 이 부분입니다. 깔끔하게 목소리만 추출해야 결과물이 정말 좋게 나옵니다. 하지만 우리는 입문자기 때문에 이 부분은 넘어갑니다.

image.png

3. 목소리 모델 찾기(선택에 따라 1~10분)

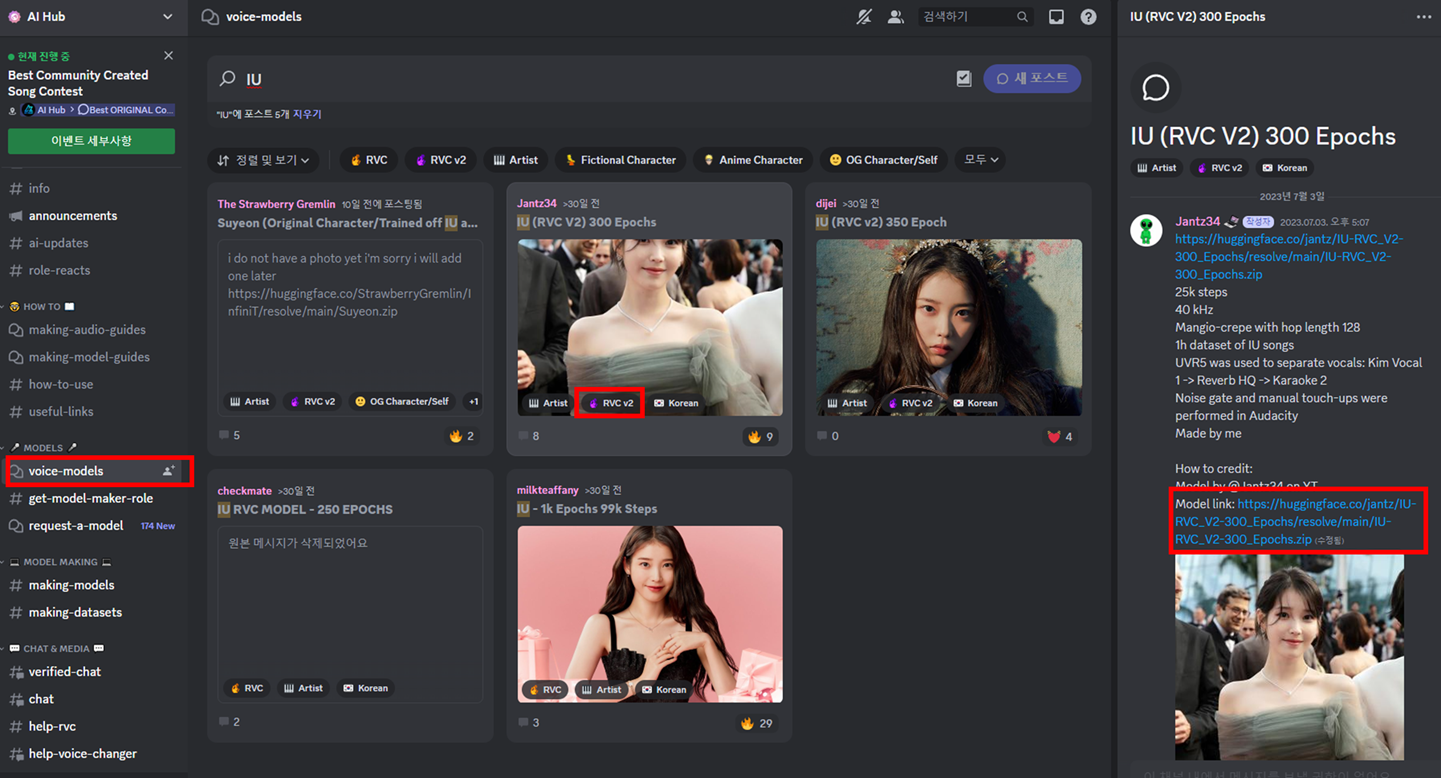
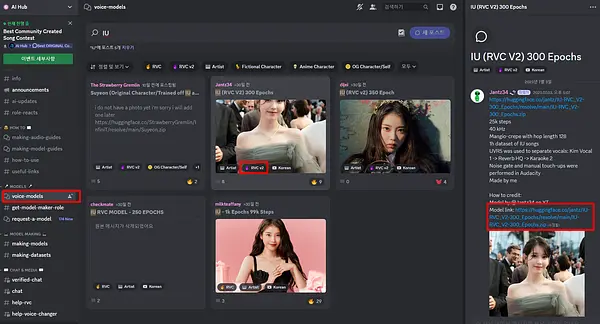
여기까지 끝내면 정말 8부 능선은 넘어간 겁니다. 아래 디스코드 채널에 접속하여 voice-models를 클릭합니다. 그리고 원하는 목소리를 찾습니다. RVC v2 태그가 된 모델만 사용하세요. 모델을 클릭하면 이미지처럼 오른 편에 글이 뜨는데 여기서 Model link 부분만 복사합니다.

https://discord.gg/aihub

image.png

4. 코랩을 사용합니다. (2분)

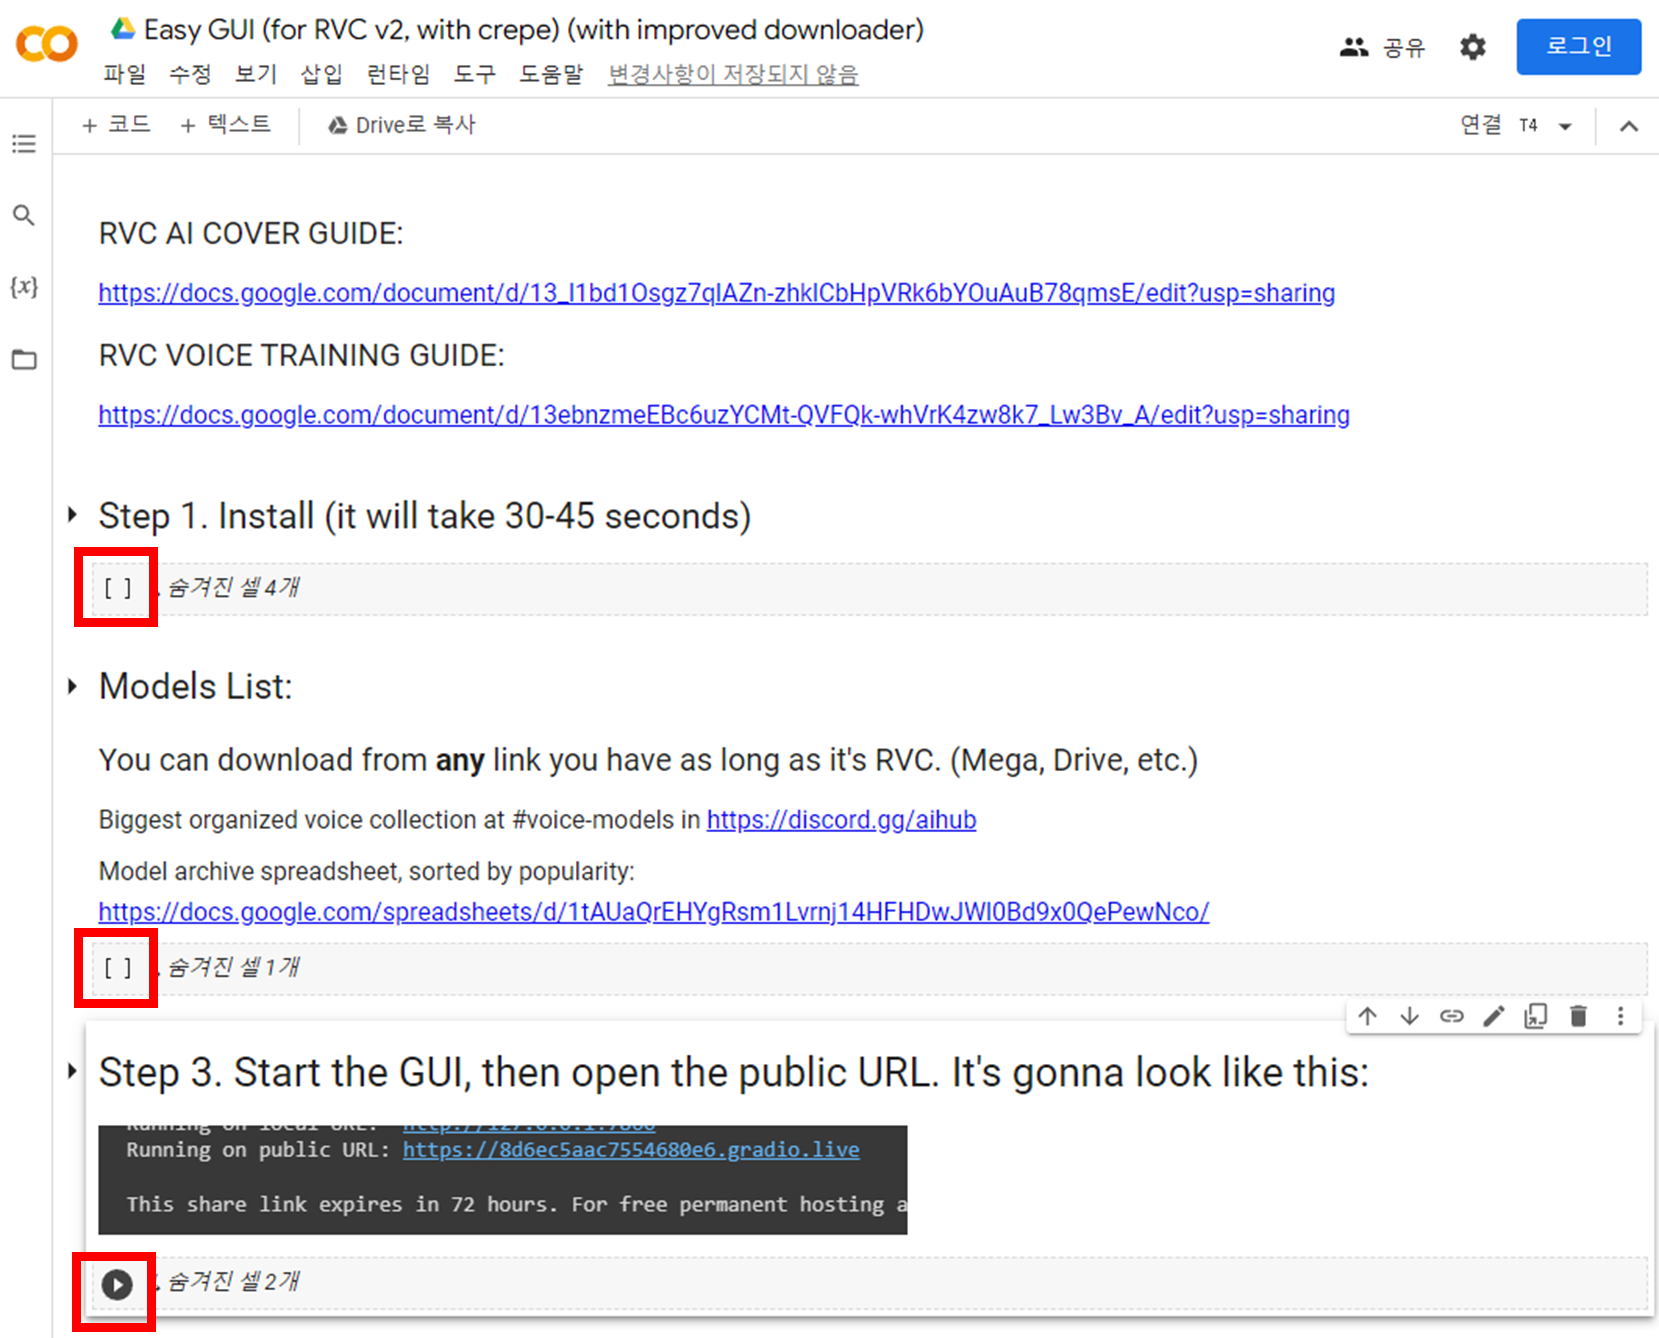
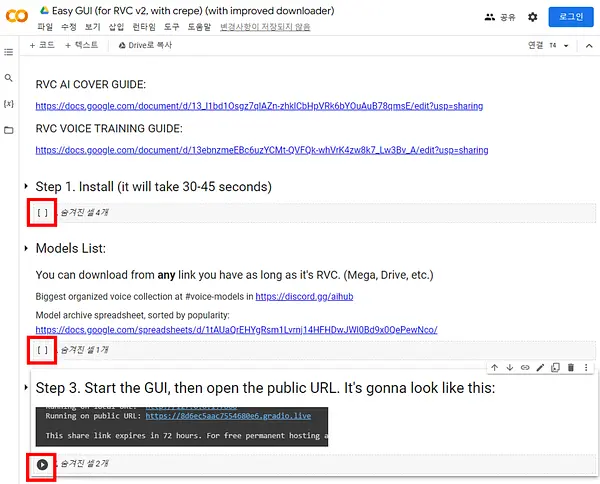
영어가 엄청 나와 어지럽지만 매우 쉽습니다. 재생 버튼 3개만 순차적으로 눌러주세요. 아래 이미지처럼 재생 버튼이 안 보여도 저기 표시된 부분을 클릭하시면 됩니다.

https://colab.research.google.com/drive/1Gj6UTf2gicndUW_tVheVhTXIIYpFTYc7?usp=sharing

image.png

5. WebUI를 실행(0분)

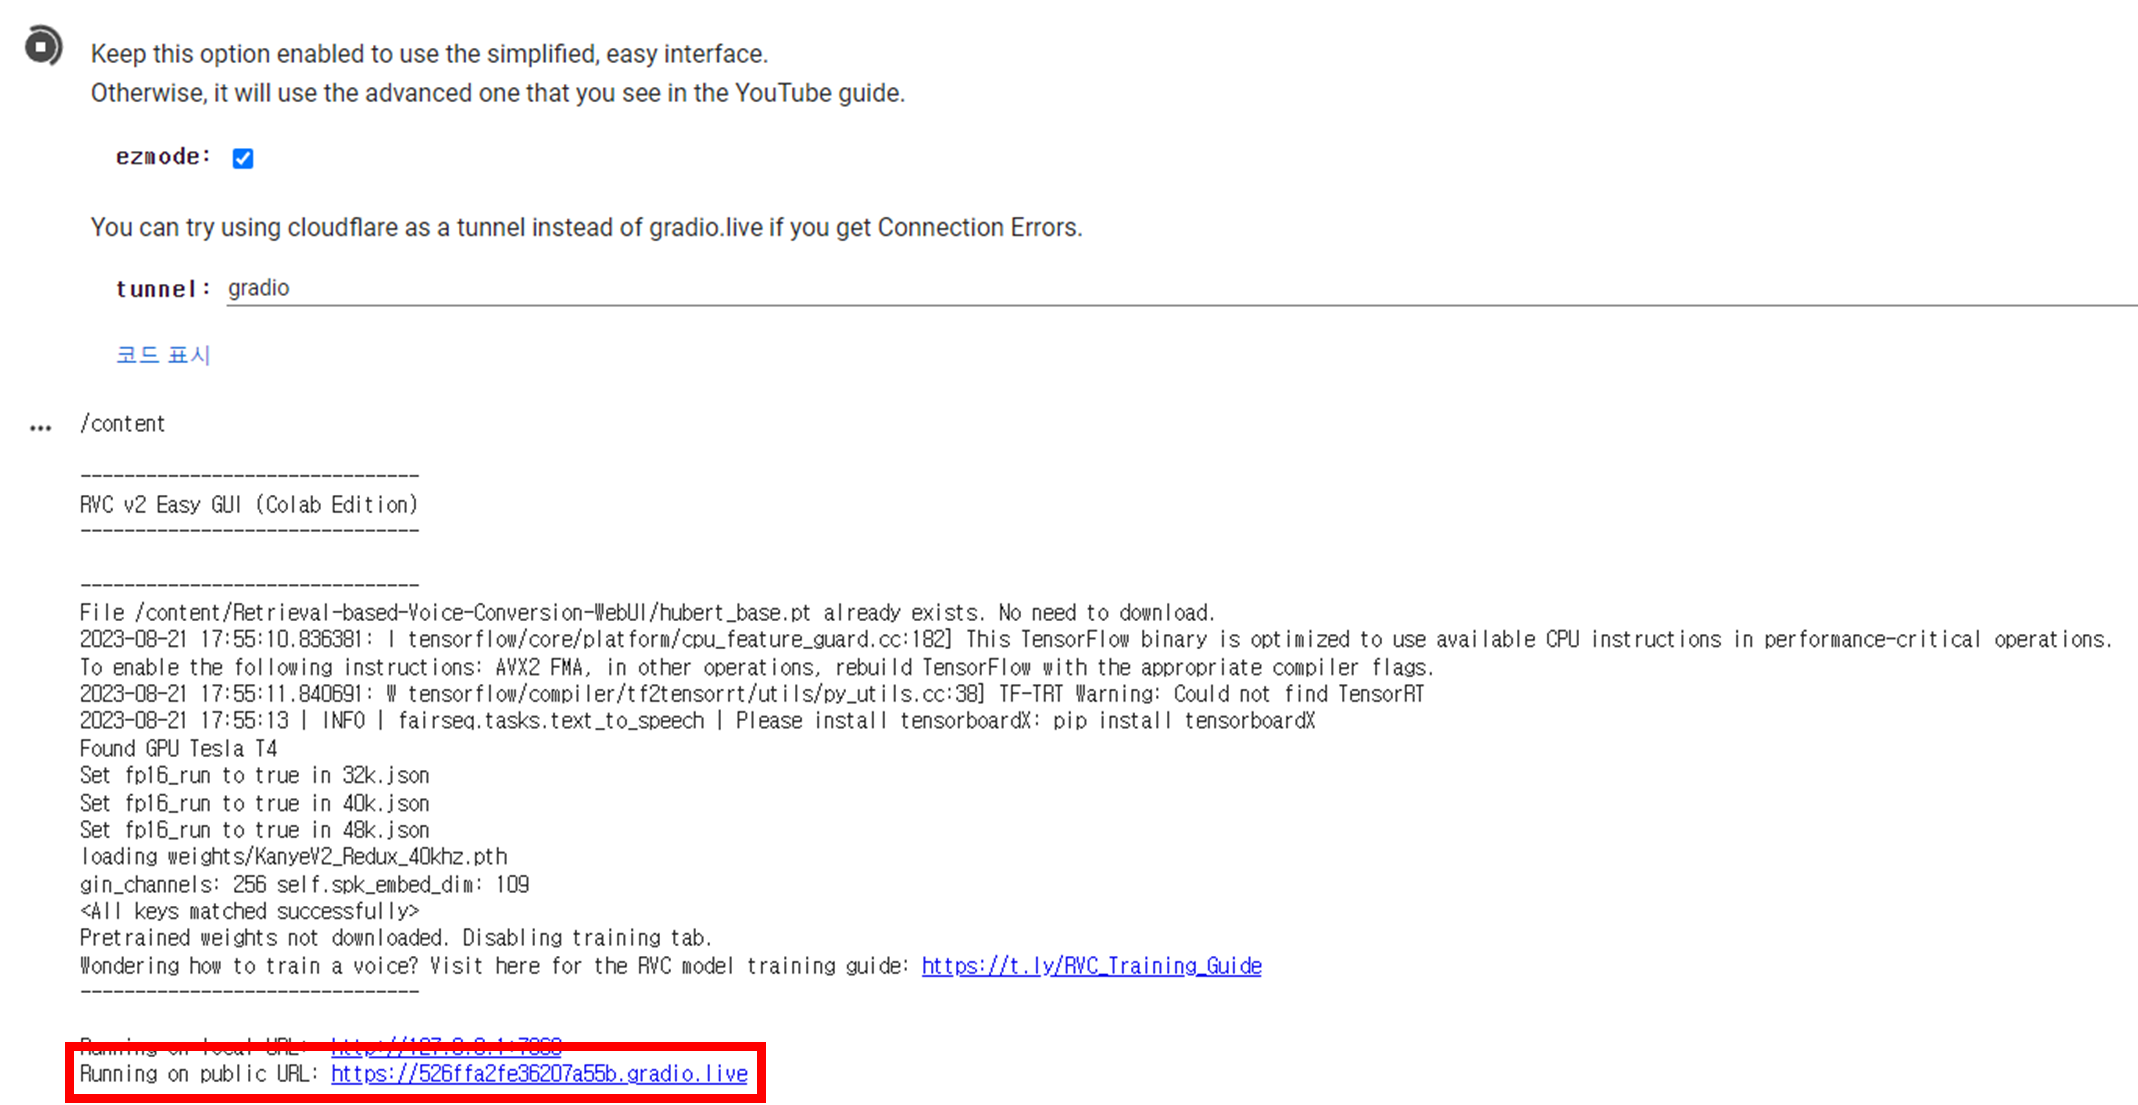
3번 째 재생 버튼을 클릭하면 아래 이미지처럼 URL이 하나 나옵니다. 이 URL을 클릭하시면 새 창이 뜨면서 AI 노래를 만들 수 있는 페이지로 넘어가집니다.

image.png

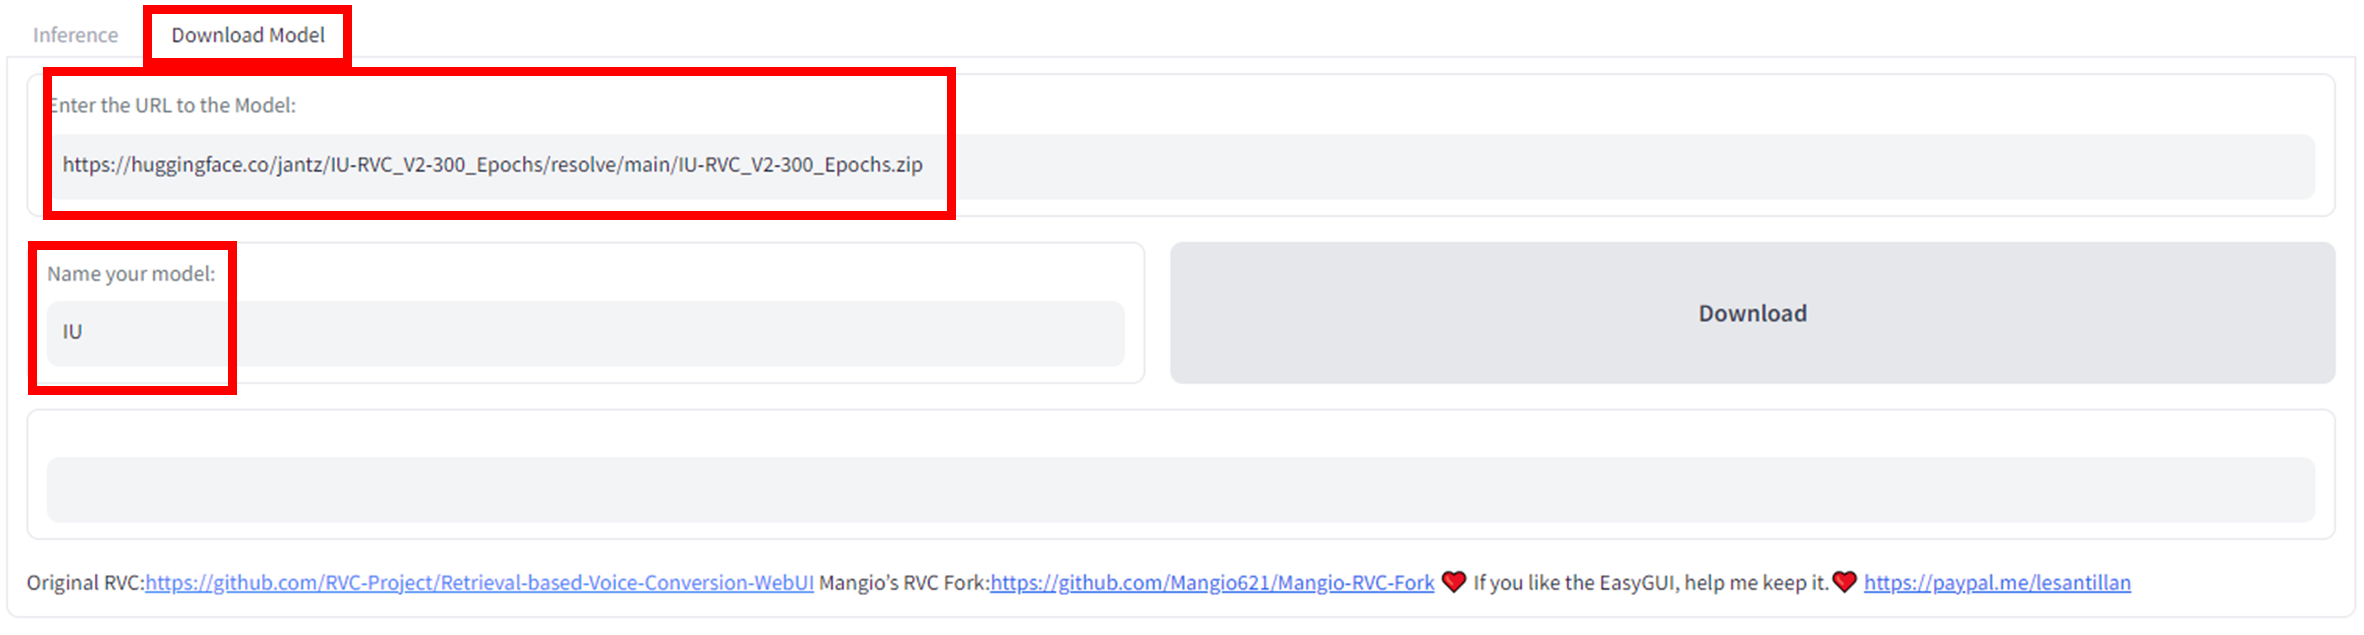
6. 목소리 모델 다운받기(30초)

3번에서 복사한 model link 부분을 입력하고, 모델 이름을 적당히 적습니다.

image.png

7. 이제 추론 합시다.(1분)

모델을 다운 받았으면,

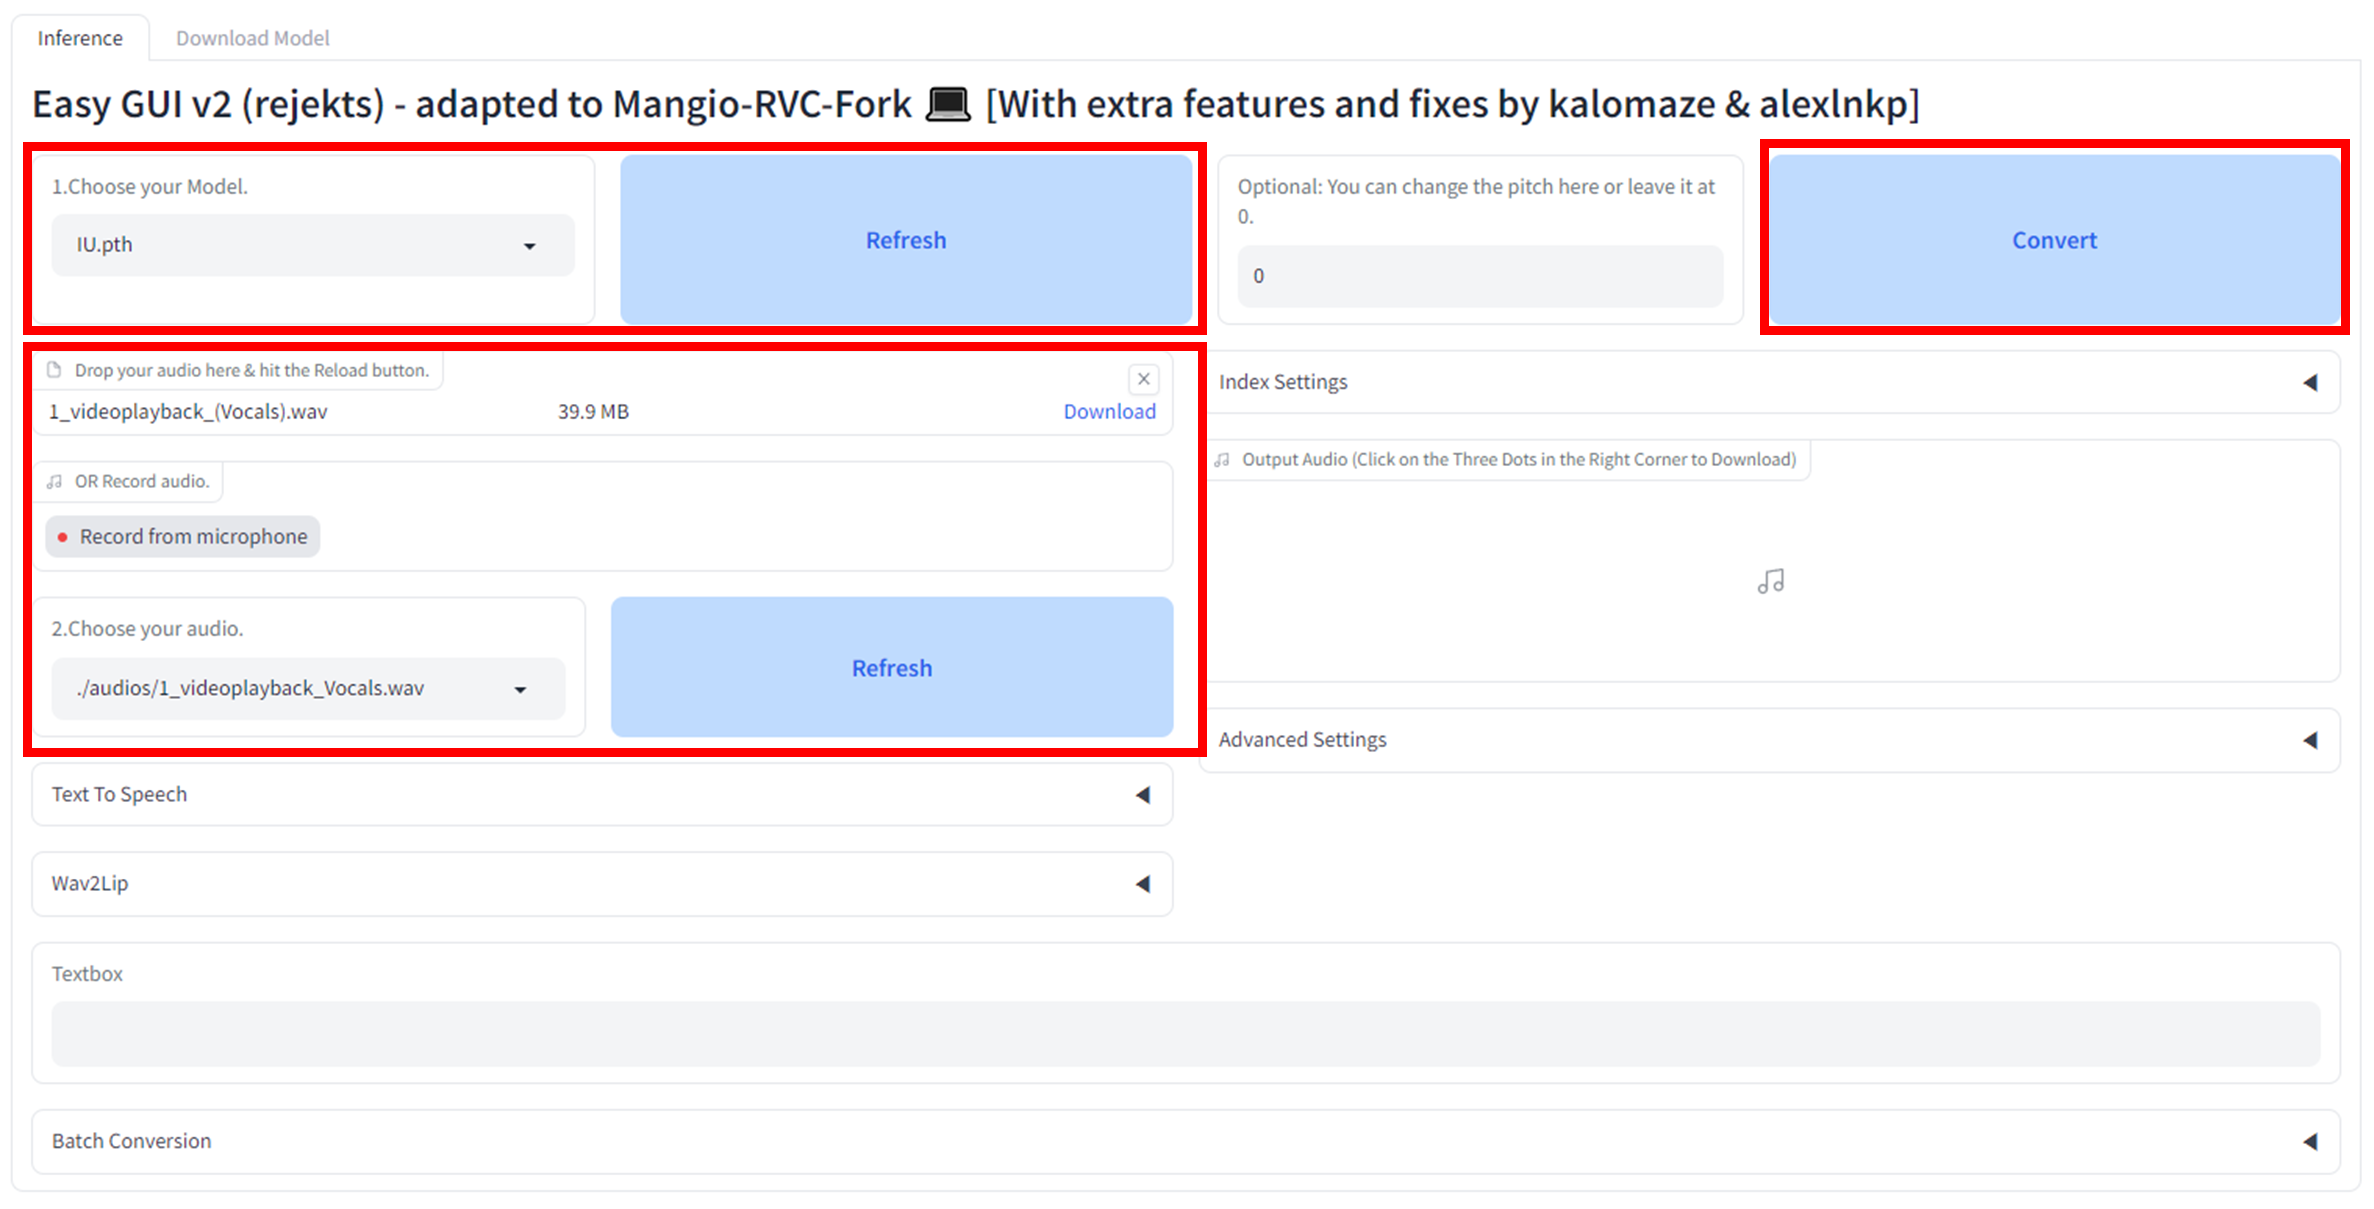
1) model을 선택

2) 2번에서 만든 목소리 파일을 업로드한 후 선택. 모델과 음성 파일이 보이지 않으면 refresh 버튼을 누릅니다.

3) 음성파일까지 업로드가 되었다면, Convert를 누릅니다.

image.pngimage.png

8. AI 커버곡 생성 끝!!!!(30초)

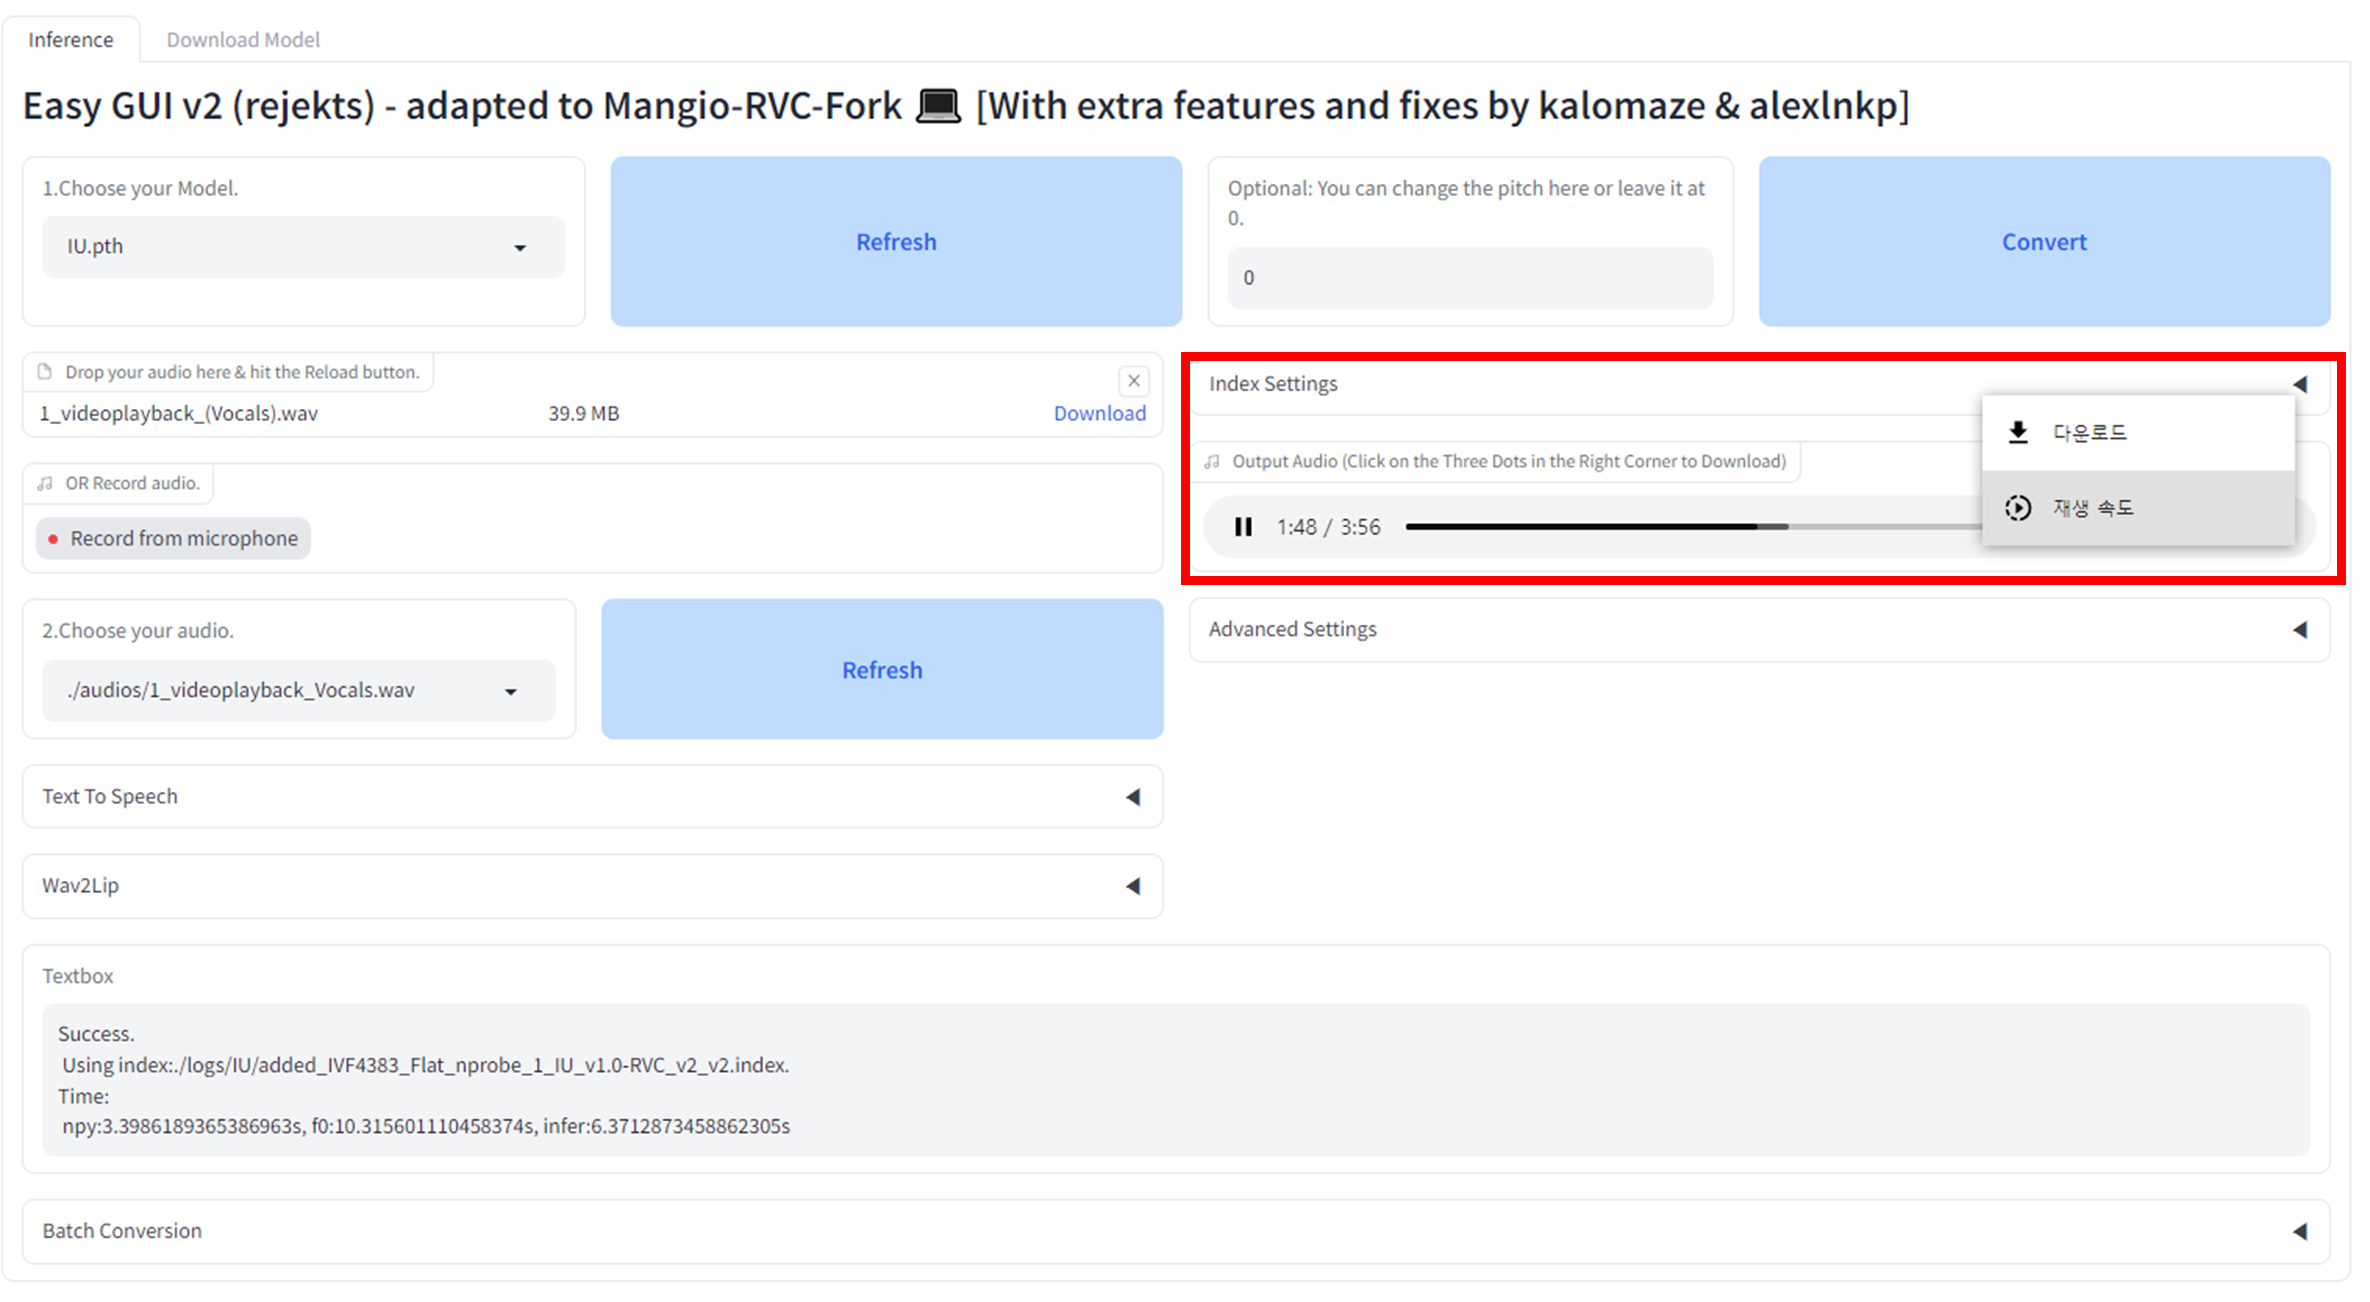
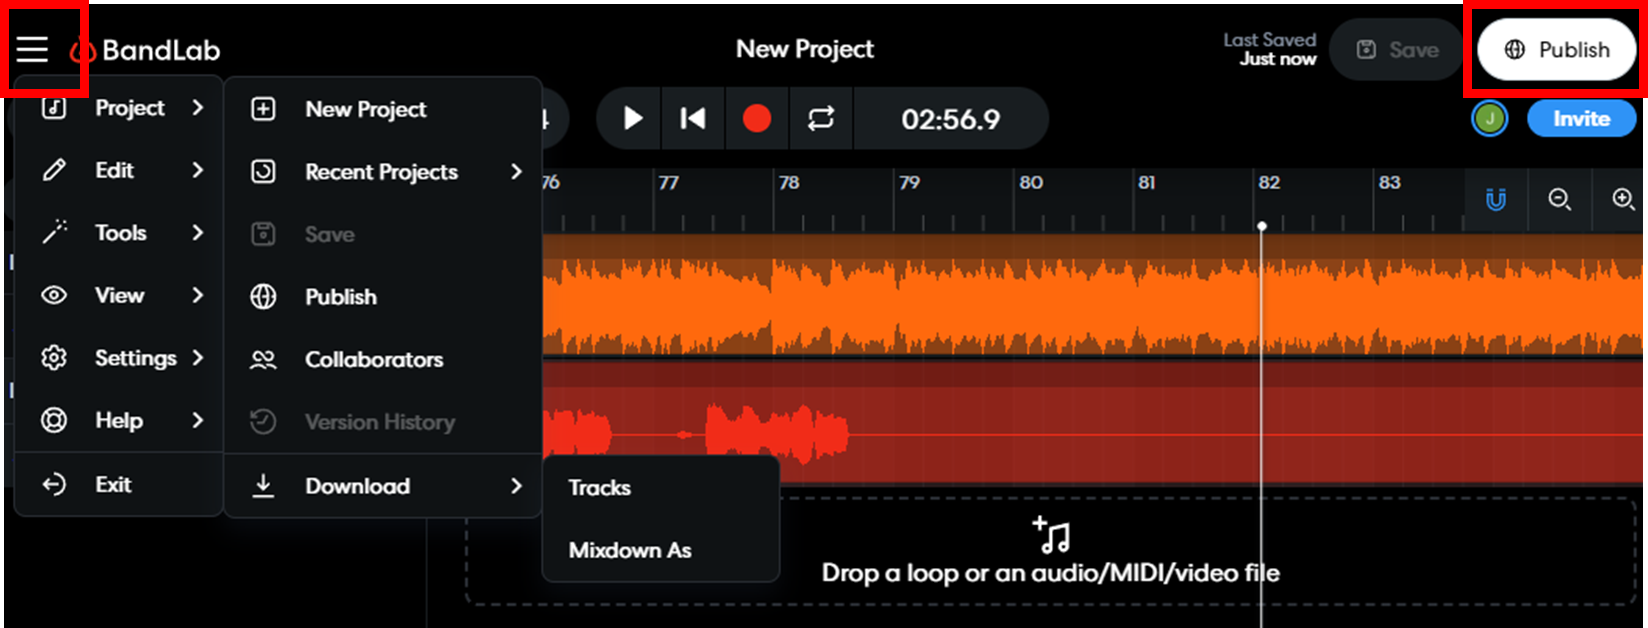
이제 AI 결과물을 MR과 합쳐봅니다. 생성된 AI 결과물을 다운받습니다. 음성 합칠 수 있는 서비스(저는 주로 bandlab을 이용합니다)에 들어가서 AI 목소리와 MR을 합친 후 파일을 저장합니다. (bandlab에서는 오른 쪽상단의 Publish를 누른 후에 설정 탭에서 Project->Download->Mixdown As를 클릭하세요.)

https://www.bandlab.com/studio

이렇게 하면 멋진 노래가 뙇하고 나오게 됩니다.!!!

image.png

저작권이나 뭐 이런 문제가 있을 거 같아서 파일은 업로드하지 못하지만 생각보다 노래가 정말 잘 나온답니다.

이러한 입문 과정이 익숙해지면

2번 과정에서 목소리 파일을 더 깔금하게 깎는 걸 연습하게 되고,

3번 과정에서 본인이 직접 원하는 인물의 목소리 모델을 만들게 되고,

8번 과정에서 보다 정교한 후처리를 통해 더 깔끔한 노래를 만들게 됩니다.

19
14

포스트

아직 포스트가 없습니다.