프로덕트

아직 프로덕트가 없습니다.

아티클

전체 보기
한규진

한규진

AutoRAG - 자동으로 최적의 RAG 파이프라인을 찾아주는 자동화 툴 (feat. RAG 맞춤형 LLM 공개)

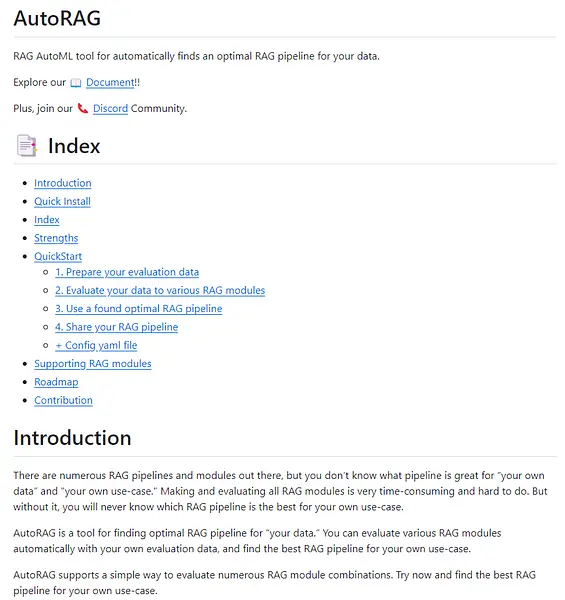
AutoRAG
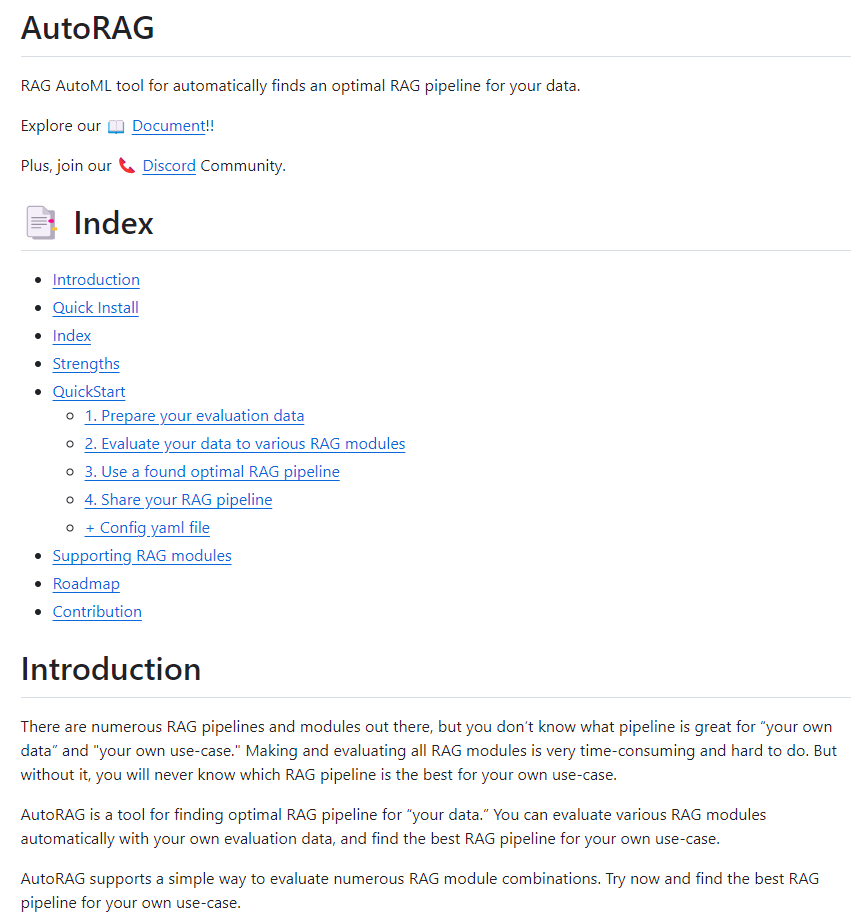
image.png

안녕하세요! 

마커AI에서 LLM 연구를 하고 있는 kyujinpy라고 합니다!😋😋


최근 LLM이 떠오르고, private-LLM에 대한 관심도가 증가하면서, RAG에 대한 관심도 증가하고 있는 것 같습니다😎

RAG는 Retrieval-Augmented Generation의 약자로, 방대한 문서를 기반으로 LLM이 답변을 해주는 시스템을 말합니다.

이는, 방대한 문서 가운데 원하는 정보를 빨리 찾고, 동시에 hallucination 문제점도 줄여준다는 장점이 있습니다!


최근 저희 마커AI 팀에서, RAG pipeline을 담당하던 팀이 AutoRAG라는 RAG 최적화 모듈을 공개하였습니다🤗🤗

AutoRAG에 나오게 된 배경과 AutoRAG를 이용하면 어떠한 장점들이 있는지 설명드리겠습니다!

  • AutoRAG github


RAG를 적용하기 힘든 어려움

기존의 RAG의 문제점은 다음과 같은 문제점이 있었습니다🤔🤔

  • 토이 프로젝트 수준의 RAG 파이프라인은 쉽게 만들 수 있지만, 실제 데이터와 사용 목적에 맞는 높은 성능의 RAG 파이프라인을 구성하는 것은 어려움이 있음.

  • RAG는 데이터와 목적에 따라 어울리는 조합이 모두 다르며 최적의 조합을 찾기 위해서는 많은 실험과 평가를 반복해야 함

위와 같은 문제점으로 인해, 자체적인 LLM을 구축하는 것도 어렵지만, 데이터에 최적화된 RAG 파이프라인을 구성하는 것도 쉽지 않았습니다.

AutoRAG의 장점

저희 AutoRAG는 위와 같은 문제점에 대해서 아래의 해결책을 제시했습니다😎😎

  • AutoRAG에서 현재 지원하는 12개의 모듈로, 960가지의 조합이 나올 정도로 다양함 (임베딩 모델, 언어모델은 조합에서 제외)

  • AutoRAG는 ML을 자동으로 최적화 해주는 AutoML처럼 RAG의 파이프라인을 자동으로 최적화

  • AutoRAG는 yaml 파일을 간단히 수정하는 것 만으로 사용 가능

  • AutoRAG를 실행하면 복잡한 RAG 파이프라인의 각 단계들을 자동으로 평가하여 최적의 파이프라인을 제시함

  • 각 단계별로 평가 결과를 저장하여, 어느 단계에서 가장 큰 성능 하락이 일어나는지, 어떠한 모듈이 가장 성능 향상을 가져왔는지 바로 알게됨

  • 더욱이, 찾은 최적의 파이프라인을 곧바로 fastAPI 서버로 실행하여 사용 가능

  • 찾은 파이프라인을 yaml 파일로 만들어, 본인의 RAG 파이프라인을 공유하는 것도 간편

저희가 만든 AutoRAG를 활용하여 저희 내부에서 자체적으로 테스트도 진행해보았습니다!

AutoRAG를 이용하였을 때 성능과 baseline의 성능을 비교하였을 때, 아래와 같이 성능이 향상된 것을 확인할 수 있었습니다😸😸

  • 베이스 모델로 Mistral 7B를 활용하였고, 데이터셋은 Eli5 데이터셋을 활용하였습니다.

  • Eli5 데이터셋을 활용한 벤치마크 결과, 최적화한 파이프라인에서 retrieval의 Recall이 0.87에서 0.97로 상승, BLEU는 약 22% 성능이 향상


RAG 맞춤형 LLM 공개!?
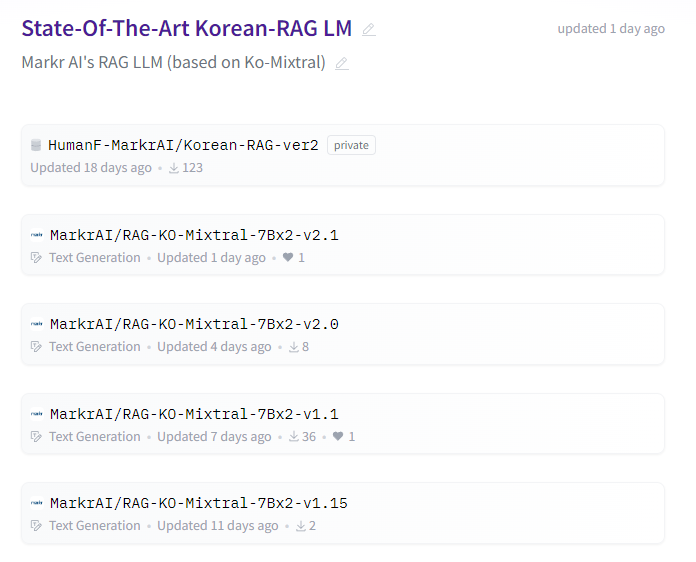
또한 저희 내부에서, 자체적으로 만든 RAG 최적화 LLM도 소개합니다🤗

해당 모델은 RAG와 같이 대량의 문서에서 특정한 질문에 대한 답변을 추출하는데 최적화된 LLM 입니다😁

따라서, 저희 RAG-KO-Mixtral-7Bx2 모델은 아래와 같이 제작되었습니다.

  • MoE 방식을 Mixtral에 적용하고, 한국어 대량 corpus로 학습하여 자체적인 PT를 제작하였습니다.

    • DopeorNope/Ko-Mixtral-v1.4-MoE-7Bx2

  • 자체적으로 제작된 Ko-Mixtral-7Bx2 모델에 GPT-4로 생성한 RAG 데이터셋(private; AIHUB 데이터셋 가공)과 LoRA를 활용해 fine-tuning하였습니다.

    • 제작된 MarkrAI RAG Model

간단한 예시가 보고 싶으신 분들은 아래의 블로그로 방문해주세요!

  • GPT-4 vs RAG-KO-Mixtral-7Bx2

(저희가 공개한 RAG-KO-Mixtral-7Bx2 모델은 비상업적 목적으로만 사용 가능하다는 점도 기억해주세요🧐)


여기까지 AutoRAG를 소개하였습니다!

최근 RAG에 대한 인기가 커지고 있는데, 여러분들도 RAG에 대한 관심이 있으시다면 AutoRAG를 적극적으로 활용해보시기를 바랍니다😘😘

감사합니다! 
7
4
한규진

한규진

Sakura-SOLAR-Instruct: 해외 리더보드 1등 모델 코드 및 하이퍼파라미터 전부 공개!?

안녕하세요!

저번에 디스콰이엇에서 ko-platypus 모델 소개로 처음 인사를 올렸던 kyujinpy입니다!

오늘 여러분들께 소개할 오픈소스! 모델은 Sakura-SOLAR-Instruct 입니다!

Sakura-SOLAR-Instruct에 대한 모든 정보는 아래 github에 있어요!

Github:

HuggingFace:


먼저 간단히 모델을 만들게 된 배경에 대해서 소개해볼께요! ㅎㅎ

최근에 SOLAR-10.7B 모델이 Depth-Up-Scaling 방법론을 활용하여 Open LLM 리더보드에서 1등을 달성하였습니다..!

Depth-Up-Scaling을 통해서 서로 다른 모델의 파라미터를 공유하면서 보다 높은 정확도를 낼 수 있었던 것 같습니다.😉


또한, 최근에 새로운 강화학습 방법인 DPO와 모델들의 파라미터 값을 서로 공유하는 merge(slerp) 방법을 통해 모델의 성능을 많이 이끌어 내는 것을 보면서, SOLAR 모델을 활용하여서 좋은 성능을 내는 모델 튜닝에 도전하게 되었습니다..!

그리고 여러 시도와 고민 끝에 해외 리더보드에 1등을 달성하게 되었습니다.

DPO 방법론을 적용한 모델들도 리더보드에 곧 올라올테니 계속 지켜봐주세요😉😉


그렇다면 어떻게 SOLAR 모델을 가지고 훈련했나요!?

위에서 언급한 것과 같이 slerp merge와 DPO를 가지고 훈련을 진행했습니다!

좀 더 자세히 설명해볼께요..!


Merge 방법론은 무엇인가요!?

Merge(slerp)방법은 mergekit이라는 github에서 쉽게 구현이 가능합니다!

SLERP은 Spherical Linear Interpolation의 약자로, 구면 선형 보간법이라고 합니다!

slerp에 대해서 검색하시면 많은 정보들이 나와서 쉽게 이해하실 수 있습니다!

저는 slerp method를 아래의 2개의 모델에 적용해보았습니다!😋

  • SOLAR-10.7b-Instruct-v1.0

  • SauerkrautLM-SOLAR-Instruct

이렇게 해서 만들어진 모델이 🌸Sakura-SOLAR-Instruct🌸 입니다!

Mergekit에 대한 정보는 github를 참고해주세요!

Github:

DPO 방법론은 무엇인가요!?

DPO 방법은 directly preference optmization의 약자입니다!

해당 방법론은, 두 모델 간의 대답 분포도를 비교하여서 사용자가 원하는 대답으로 분포를 맞춰주는 방법이라고 생각하시면 편합니다! (자세한 내용은 논문을 참고하시면 좋습니다! 수식에 익숙하신 분들이라면 KL-divergence를 떠올리셔도 좋습니다 ㅎㅎ


최근에 모델을 올리기 위해 여러가지 open source models을 보면서, 저와 같이 자원이 부족한 사람들이 학습하기 적합한 dpo 데이터셋을 제 나름대로 추려봤습니다! 😋

  • Intel/orca_dpo_pairs

  • argilla/distilabel-math-preference-dpo

  • unalignment/toxic-dpo-v0.1

저는 여기서 orca_dpo와 math_dpo를 이용했습니다!

toxic_dpo도 이용하고 싶었지만, 이것은 다른 사람들의 시도로 남겨두겠습니다..🙃🙃


여러 DPO 데이터셋을 활용해서 만든 모델의 리스트는 아래와 같습니다! 😋

- Math_dpo

  • 🌸 kyujinpy/Sakura-SOLAR-Instruct-DPO-v1

  • 🌸 kyujinpy/Sakura-SOLAR-Instruct-DPO-v2


- Orca_dpo

  • 🌸 kyujinpy/Sakura-SOLRCA-Instruct-DPO


- Orca_dpo + Math_dpo

  • 🌸 kyujinpy/Sakura-SOLRCA-Math-Instruct-DPO-v1

  • 🌸 kyujinpy/Sakura-SOLRCA-Math-Instruct-DPO-v2


모델을 만들 때, 가장 고민했던 점은 hyperparameters 였습니다..!

하이퍼 파라미터에 대한 정보를 얻기 위해, 밤새도록 모델의 open source에 나와있는 정보들과 과거 log 기록들을 살펴보았고, 제가 시도했던 경험들까지 모두 종합하여 어느정도 경우의 수를 만들었습니다 😇😇

이것을 바탕으로, 여러 하이퍼 파라마터들을 실험 정신으로 각각의 모델에 적용을 해보았습니다!😍

자세한 하이퍼 파리미터와 모델에 대한 정보는 Sakura-SOLAR github 에 모두 공개했습니다!

여러분들에게 하나의 인사이트가 되었으면 좋겠습니다🥰🥰


마무리

KO-LLM 리더보드에 이어서 EN-LLM 리더보드도 1등을 달성해보는 경험을 했다니..정말 감사할 따름입니다. (물론 고충도 많았지만요..! ㅎㅎ)

저와 같이 연구하고 응원하는 모든 분들께 감사드리고, 또 아낌없이 지원해주시는 (주)미디어그룹사람과숲과 (주)마커에도 감사함을 표합니다🤗🤗


다음에도 더 좋은 오픈소스 모델로 찾아뵐 수 있도록 노력하겠습니다🤩🤩

감사합니다!


8
10
한규진

한규진

Open Ko-LLM 리더보드 1등을 달성한 개발자 한규진입니다. (댓글 달면 프로모션 코드 지급해드립니다!)

안녕하세요 여러분!

마커AI에서 LLM 연구원으로 활동하고 있는 한규진이라고 합니다! 또한 현재 한동대학교 재학중입니다😄😄

Disquiet 커뮤니티를 알게 된 이후로 첫번째로 작성해보는 글이여서 무척 떨립니다..ㅎㅎ

저는 원래 Computer vision쪽으로 관심이 많아서 vision과 관련하여 공부를 하고 프로젝트를 진행하고 있었습니다! 🔥🔥

그러다가 좋은 기회로 인해 마커 AI에서 LLM 연구를 하게 되었고, Ko-LLM 리더보드가 처음 열린 이후 예상치도 못하게 1등을 달성하여 저 스스로도 많이 놀랐습니다..ㅎㅎ

여기서 간단하게 Open Ko-LLM에서 1등을 달성했던 Ko-platypus 모델을 소개하겠습니다!👉

  • 해당 모델은 platypus 논문을 바탕으로, 데이터를 번역하고 정제한 후 instruction-tuning을 진행한 모델입니다!

  • 이후에 다양한 데이터와 OpenOrca 데이터를 정제하고 활용하여서 여러 파생 모델들을 제작하였습니다!

  • 생각보다 많은 관심을 받아서 너무나 감사했습니다 ㅎㅎ

🥮Ko-Platypus 🥮개발 이야기가 궁금하신가요!?

LoRA 방법론을 시작으로 여러 PEFT를 공부하고 있던 도중 오픈소스 LLM인 Llama-2가 발표되어 수많은 파생 모델들이 나왔습니다.

이때 Platypus LLM 논문을 접하게 되었는데, 논문 내에서 소개한 데이터 수집 방식과 instruction-tuning 방식을 보고 '나도 Platypus 논문을 바탕으로 한국어를 잘하는 Llama2기반의 모델을 만들고 싶다'라는 생각을 하였습니다.

이때 생겼던 🔥self-motivation🔥을 바탕으로 저는 곧바로 한국어 platypus 프로젝트인 Ko-platypus를 구상하게 되었고, 저의 의견과 계획을 어필하여서 (주)마커AI와 (주)미디어그룹사람과숲에서 지원을 받아 연구를 시작하게 되었습니다!

먼저 Platypus 논문에서 활용했던 데이터셋을 바탕으로 DeepL을 활용하여 전부 한국어로 번역을 진행하였습니다. 그리고 번역된 결과를 바로 활용하여 훈련을 진행하니 예상했던 성능보다 좋지 못했습니다.
저는 원인을 분석하기 위해 데이터를 하나하나 수작업으로 검토하였고, 번역 결과 안에 생긴 오류들을 코드와 수작업으로 대부분 수정하였습니다! 대표적인 데이터 전처리로는 아래와 같습니다!

  • 다양한 컴퓨터 언어(python, java, c++, ...)와 주석은 유지하고, 설명만 한국어로 수정

  • DeepL Pro 번역 결과 중 미완성 변역 결과 직접 수정

  • 고유명사는 유지

  • DeepL Pro 번역 결과가 본래의 데이터에 비해 글자 수가 50% 이하로 낮으면, 번역 결과 수작업으로 체크 후 수정

  • 단일 숫자와 영어 텍스트는 본래의 결과 그대로 활용

자세한 한국어 platypus 데이터셋은 아래의 링크에서 확인하실 수 있습니다!

데이터 전처리로 완성된 KOpen-platypus 데이터를 바탕으로 Llama2 instruction-tuning을 진행하였고, 하이퍼파라미터 튜닝을 여러 번 시도하면서 성능을 이끌어냈습니다..!

그리고 이후 새롭게 열린 Open Ko-LLM 리더보드에 Ko-platypus 모델을 올려 좋은 결실을 맺을 수 있었습니다😊😊

제가 Ko-platypus를 만들면서 가장 행복했던 점은, 리더보드의 성과보다 한국어 오픈소스 LLM에 조금이나마 기여를 했다는 점에서 너무나 기뻤고, 서로 경쟁하면서 실력을 쌓아가고 고민하는 그 시간들이 저에게 너무나 귀한 경험이었고 감사했습니다 ㅎㅎ

앞으로도 AI 오픈소스 진영에서 열심히 연구하고 여러 인사이트를 제공할 수 있는 연구자가 될 수 있도록 더욱 노력하고 성장하겠습니다!😁😁

추가로 Open Ko-LLM 리더보드를 계기로, Upstage의 김성훈 대표님과 좋은 인연이 닿아서 Fast campus에서 LLM 강좌를 준비하게 되었습니다!🤗🤗 @Sung Kim

자세한 정보와 링크는 아래를 참고해주세요!

📚강의 내용은 아래와 같이 3가지 파트로 구성되어 있습니다!

  • Upstage의 노하우가 담긴 SOLAR 모델 제작 히스토리

  • LLM 모델 최신 트렌드 A to Z까지 이해하기

  • LLM fine-tuning 및 리더보드 실습

🚀이런 분들께 추천드립니다!

  • LLM을 입문하고 싶은데 방대한 지식과 코드로 공부하기 망설이시는 분😭!

  • 최근 LLM 분야에서 널리 활용되는 PEFT 방법론에 대해서 배우고 코드 실습을 하고 싶으신 분🙋‍♀️!

  • 허깅페이스 리더보드에 자신의 LLM을 올려보고 싶으신 분👊!

해당 강좌가 수강하시는 여러분들의 LLM 입문에 초석이 되어, 여러분들의 아이디어와 방향성을 토대로 LLM을 직접 만들어보는 계기가 되었으면 좋겠습니다. 더불어서 여러 모델들을 자신만의 방법으로 적용해보면서, LLM을 보는 시각을 넓히고 자신만의 노하우를 구축하시길 바랍니다!🤗🤗

추가적으로 수강을 계획하신 다면 댓글로 남겨주세요!

20% 할인 코드를 지급해드리겠습니다! (~12/11)

긴 글 읽어주셔서 감사합니다!

13
19

포스트

아직 포스트가 없습니다.