프로덕트

아티클

전체 보기
김기오

김기오

고객확보 수난기 -3부

안녕하세요! 저희는 Synnote라는 STT 기반 자동 음성 전사 기록 서비스를 만들고 있습니다.

저의 팀원이 고객확보 수난기를 작성했었는데, 추가적으로 재밌는 일들이 더 생겨서 업데이트 겸 메이커로그를 작성했습니다.

지지난 주부터 저희는 고객확보를 위해 다양한 마케팅을 진행해 왔습니다. 다양한 메이커분들이 제안해주신 대로 인스타그램 광고를 새로이 수정하여 광고에 사용할 컨텐츠를 새로 제작해 보기도 하였습니다. 확실히 다양한 수치는 (CPC 등)은 개선되었지만, 마케팅에 태울 수 있는 자원 자체가 한정적이다 보니 수치가 좋아져도 고객 수가 크게 늘어나지는 않았었습니다.

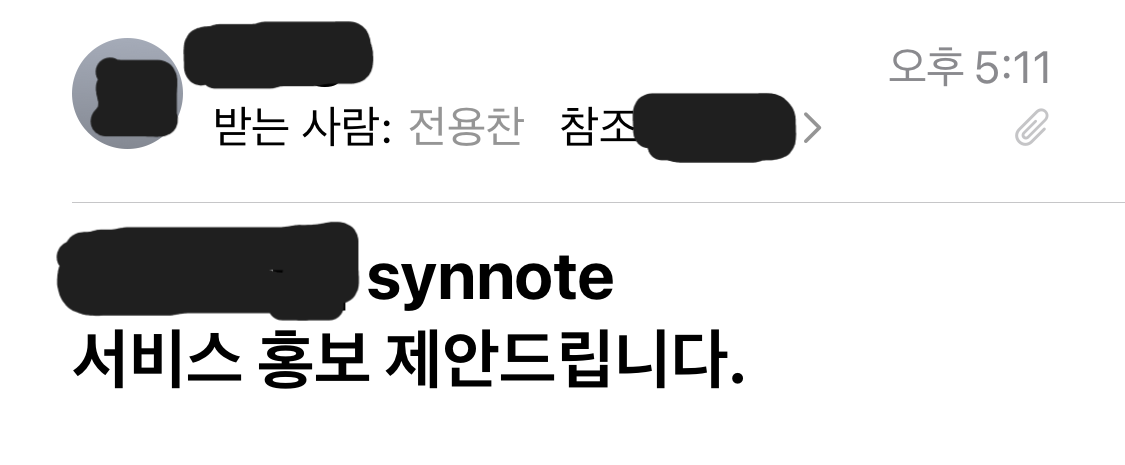
그런데 어느날 재미있는 메일이 도착했습니다.
IMG_4619.png

우리 서비스의 핵심 기능인 도메인 특화 STT 모델 fine-tuning을 위한 데이터 라벨링을 외부 업체에 맡겨 진행했었는데, 해당 업체가 운영하는 플랫폼에서 홍보를 진행하는것은 어떤지 물어보는 메일이었습니다.
저희 팀이 홍보에 매우 고팠었기 때문에 감사한? 마음으로 홍보를 진행해 달라고 부탁드렸고, 결과적으로 광고가 플랫폼에 올라가게 되었습니다! 이때까지만 해도 별 기대를 하지 않고 있었는데..
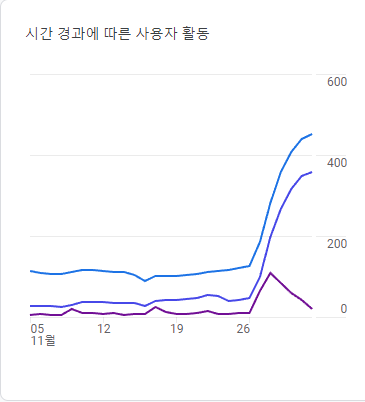
image.png

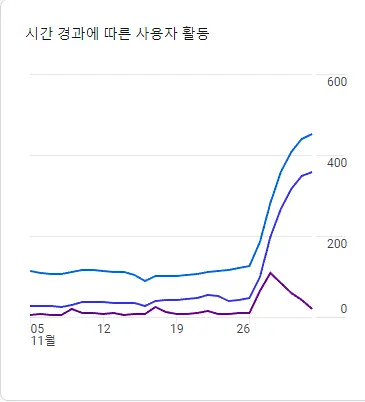
홍보가 올라간 12월 27일 전후로 급격하게 사용자가 증가하기 시작했습니다. 처음에는 갑자기 어떤 일이 일어난 건지 몰랐습니다. 트래픽이 갑자기 늘어나게 되었고 어느 경로로 유입되었는지도 확인이 안되어서 (google analytics 상에서 Direct로만 확인됨) 어안이 벙벙했습니다. 여러가지 종합적인 데이터를 점검한 결과 사용자들이 홍보를 진행한 플랫폼에서 유입이 되었음을 확인할 수 있었습니다!
어떻게 이런 결과가 나왔는지 저희 팀원들끼리 고민을 해 보았습니다. 해당 플랫폼은 주부나 학생들이 용돈 벌이 겸 많이 이용하는 플랫폼이어서, 강의 등을 받아적어 주는 저희 서비스와 니즈가 어느정도 겹친 것 같았습니다.

그러나 기분 좋은 일도 잠시, 이 많은 사용자들이 실제로 저희 서비스의 핵심 기능인 상세 노트 전사 기능을 사용하지도 않고 이탈하는 경우가 90%를 넘는다는 사실을 확인했습니다.

팀에서 머리를 맡대고 사용자가 이탈하는 이유가 뭔지 고민했습니다.처음에는 우리 서비스에서 제공하는 LIVE STT 기능의 성능이 고객들의 기준에 못미치는 성능을 보여서, 그 이후 이용할 수 있는 상세 노트 전사 기능을 이용하지도 않고 이탈하는 것이라고 판단했습니다. 상세 노트 전사의 경우, STT 모델의 구조상 필연적으로 LIVE STT 전사 성능보다 뛰어날 수밖에 없습니다. 따라서 팀원들이 직접 우리의 서비스를 이용할 때에는 LIVE STT가 만족스럽지 않은 결과가 나왔더라도, 서비스의 핵심인 상세 노트 전사 기능이 훨씬 더 좋은 전사 성능을 가진 것을 알고 있어 크게 문제되지 않았습니다. 그러나 사용자 입장에서는 그저 optional한 기능인 LIVE STT 기능의 성능만을 보고, Synnote 서비스 전체의 전사 성능 퀄리티가 떨어진다고 판단하고 이탈할 수도 있습니다. 이부분에대해 고려가 부족했다고 느끼고, 핫픽스로 LIVE STT화면 위에 큰 글자로 '더 나은 전사 성능으로 전사할 수 있다'는 메세지를 썼습니다. 그리고 다시 서비스를 배포했고 결과를 기다렸습니다.

하지만.. 결과는 똑같았습니다. 여전히 대다수의 사용자가 LIVE STT화면에서 이탈하고 상세 노트 전사기능은 이용하지도 않고 있었습니다. 메세지에 문제가 있다고는 생각되지 않았습니다. 어떤 이유에서 사용자가 이탈하는지 고민하는 동안, 새 홍보처를 통한 사용자 유입은 다시 잦아들기 시작했습니다..

이번 일로 배운 결론은, Google analytics를 보다 더 잘 활용하도록 배워야 겠다는 것이었습니다. 지금까지 Google analytics를 기본 기능만 사용하고, 고객들이 어떤 페이지에서 얼마나 시간을 썼는지, 어떤 버튼을 클릭하고 어떤 결정을 했는지 등 세부적인 활동은 전혀 tracking 할 수 없었습니다. 이런 부분에서 갑작스러운 사용자 이탈에도 그 이유를 찾을 수 없는, 답답한 상태에 갇혀있다가 오랜만에 온 호재를 놓치게 되었습니다.
데이터 기반 의사결정이니 뭐니 하는 이야기를 많이 들어왔지만, 이번 사건만큼 데이터의 중요성을 뼈아프게 느낀 적이 없었던 것 같습니다. 이번 일을 계기로 다시 데이터를 수집하고 저장하여 의사결정에 사용하는 것이 얼마나 중요한지 배운것 같습니다. 배움에는 끝이 없다는 걸 느끼면서, Synnote팀의 고객확보 수난기 3편을 마치겠습니다..!
6
2
김기오

김기오

아무것도 없이 STT 모델(OpenAI Whisper) 파인튜닝하기1

돈도💰 데이터도 없이 OpenAI Whisper 파인튜닝하기

저희는 강의, 회의 음성을 받아 적어 자동으로 노트 필기본을 만들어주는 Synnote 서비스를 운영하고 있습니다. OpenAI의 오픈소스 모델인 Whipser를 활용하여 STT(Speech to text)를 하는데요,
서비스를 개발하면서 퀄리티를 높이기 위해서 여러가지 고민을 했는데 그중 하나가 전문 용어도 잘 받아 적을 수 있어야 한다는 요구사항이 있었습니다.🤔

이를 해결하기 위해서 특정 분야마다 관련된 전문 용어, 음성들로 파인 튜닝된 도메인 특화 STT 모델을 직접 만들어 활용하기로 하였습니다!😎

STT 모델을 파인 튜닝하기에 앞서, 저희 팀의 가용 가능& 불가능한 자원은 다음과 같았습니다.

  • RTX 3090 x 4 ✅

  • 트레이닝에 활용할 음성 데이터 🚫

  • 데이터를 구매하거나 레이블링을 요청할 돈 🚫

보시다시피 하드웨어 자원말고는 아무것도 없는 상태에서, 그럴싸한 성능의 파인튜닝 모델을 만들었던 방법을 소개하겠습니다.

유투브로 데이터 수집하기

가장 시급했던 것은 튜닝에 활용할 데이터 수집이었습니다.

Whisper를 훈련하기 위한 데이터로 음성과 해당 음성에 맞게 전사된 대본이 필요했는데, 이 두가지 종류의 데이터를 구할 수 있는 소스인 유튜브🎥를 사용했습니다.
유튜브 동영상에 대본(또는 자막)이 달려있는 경우를 보신 적이 많으실 겁니다.
유투브에는 두가지 종류의 대본이 있습니다. 바로 ASR 엔진이 자동으로 생성한 대본과 사람이 직접 작성한 대본입니다.

image.png

(유튜브 대본의 예시)

여기서 ASR 엔진이 자동으로 생성한 대본은 오타가 많으므로 동영상의 메타 데이터를 분석하여 사람이 직접 작성한 대본만 크롤링하도록 만들었습니다.

이렇게 유튜브로만 데이터를 구성하는 것에는 또 다른 문제점이 있었습니다. 바로 대부분의 데이터가 고급 음향 장비로 녹음되었기 때문에 지나치게 좋은 음질을 가지고 있다는 점입니다.
저희 Synnote가 실제로 사용되는 환경에서 녹음된 데이터는 대부분 음질이 좋지 않기 때문에 저희는 동의하에 오프라인 강연을 직접 녹음하여 추가적인 음성 데이터도 확보했습니다.

데이터 전처리하기

데이터 전처리는 크게 2가지 과정으로 이루어져 있습니다.

  1. 유투브 데이터로부터 고품질의 대본만을 훈련 데이터로 선정 🙌

  2. 음성 데이터의 분할 ✂️

유튜브에서 사람이 작성한 대본만을 수집하였다고 말씀드렸는데, 사람이 직접 작성한 대본이라 할지라도 사용할 수 없는 것들이 많았습니다.


사용할 수 없는 대본의 예시들은 이런 경우입니다.

  • 괄호 안에 상황 설명 ex. (웃으면서)재미있네요.

  • 발화자 이름 삽입 ex. (철수)안녕하세요.

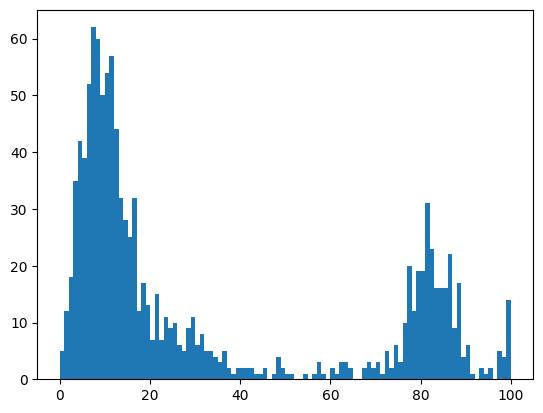
이런 데이터들을 훈련에 활용할 수 없습니다. 이런 데이터들을 솎아내기 위해서, 저희는 Whisper 모델로 음성을 전사시킨 뒤 전사본과 유투브 대본을 비교하여 전사본과 차이가 많이 나지 않는 대본만 훈련 데이터로 선정하였습니다. 이렇게 유투브 대본 - 전사본의 차이값을 데이터별로 비교한 데이터그램 차트를 보면 재미있는 결과가 보이는데요.

image.png

(x축은 CER 즉 차이값, y축은 데이터의 개수입니다)

이렇게 상황 설명이나 발화자 이름 등의 정보가 들어간 데이터들은 대본과 전사본의 차이가 급격하게 커지므로, 좋은 대본과 좋지 않은 대본의 두 그룹으로 데이터가 깔끔하게 분류되는 것을 볼 수 있습니다. CER 50 전후에 threshold값을 두고 왼쪽에 몰려있는 '좋은' 대본들을 활용해서 트레이닝 셋으로 선정했습니다.

다음으로 음성 데이터를 분할하는 과정입니다. WhisperX는 30초 단위로 이루어진 음성 데이터로 pre-training이 되었기 때문에, fine-tuning도 같은 길이의 데이터로 이루어져야 합니다. 여기서 음성을 단순히 30초 단위로 분할하게 되면 연속되는 발화가 어색하게 끊기는 경우가 발생했기 때문에, 완전한 문장 단위로 음성을 깔끔하게 분할 해야했습니다.

이를 위해 저희는 Voice Activity Detection 모델과 한국어 형태소 분석 라이브러리를 사용하여 30초 내외의 완전한 문장으로 이루어진 다수의 분할된 음성 데이터를 확보할 수 있었습니다. 

이외에도 여러 우여곡절이 많았는데요, (트레이닝 GRAM 부족 문제, 실제 성능 비교 단계 문제 등..) 기회가 된다면 다른 메이커로그에서 풀어보도록 하겠습니다! 😆

Synnote

강의나 회의에서 모든 음성을 받아적는 “자동 음성 기록 AI 어시스턴트”

10
1

포스트

아직 포스트가 없습니다.