김건우
Gemma 4로 업그레이드하고, 오답 퀴즈 품질을 뜯어고쳤습니다 — Blank. 업데이트 로그
지난 번 피드백, 감사했습니다
지난 메이커 로그에 남겨주신 피드백 덕분에 개선 방향이 훨씬 명확해졌습니다.
특히 이 두 가지가 반복적으로 언급됐습니다.
- "오답 선택지가 너무 엉뚱하다. 정답이 너무 티나게 눈에 띈다."
- "같은 빈칸 단어가 여러 문제에서 반복 출제된다." 맞는 말이었습니다.
솔직히 처음 구현할 때는 오답 3개를 문서에서 그냥 랜덤으로 뽑아서 넣었거든요. 이번 업데이트에서 이 두 문제를 포함해 전반적으로 손을 많이 봤습니다.
가장 큰 변화: Gemma 3 1B → Gemma 4 E2B
모델을 교체했습니다. 기존에는 Google MediaPipe의 LlmInference로 Gemma 3 1B를 실행하고 있었는데, 이번에 Google AI Edge LiteRT 엔진 기반의 Gemma 4 E2B로 전환했습니다.
변경 전: MediaPipe LlmInference + Gemma 3 1B (.task 파일, ~1.5 GB)
변경 후: Google AI Edge LiteRT Engine + Gemma 4 E2B
교체한 이유는 두 가지입니다.
1. 빈칸 단어 선택 품질 향상 Gemma 3 1B는 프롬프트를 아무리 다듬어도 지시를 벗어난 출력을 낼 때가 있었습니다. "문장에서 명사 하나만 그대로 복사해서 반환해라"는 지시인데, 가끔 전혀 다른 단어를 생성하거나 문장 전체를 그대로 반환하는 경우가 있었고, 이걸 후처리 로직으로 억지로 잡아야 했습니다. Gemma 4로 바꾸니 지시 따르기(instruction following) 안정성이 눈에 띄게 올라갔습니다.
2. 추론 엔진 변경 MediaPipe의 LlmInference API는 내부적으로 많이 추상화되어 있어서 세밀한 설정이 어려웠습니다. LiteRT 기반의 Engine API로 바꾸면서 Backend, SamplerConfig, ConversationConfig를 직접 제어할 수 있게 됐고, 추후 GPU/NPU 백엔드 실험도 가능해졌습니다.
오답 선택지 생성 로직 전면 개선
기존 오답 생성 방식은 간단했습니다.
// 기존: 문서 키워드 중 랜덤 3개
val options = keywordExtractor.extract(document).shuffled().take(3)
이게 문제였습니다. 정답이 한국어 단어인데 오답에 영어 단어가 섞이거나, 정답은 2글자인데 오답이 15글자짜리 전문용어가 들어오는 일이 생겼습니다.
이번에 스코어링 시스템을 도입했습니다.
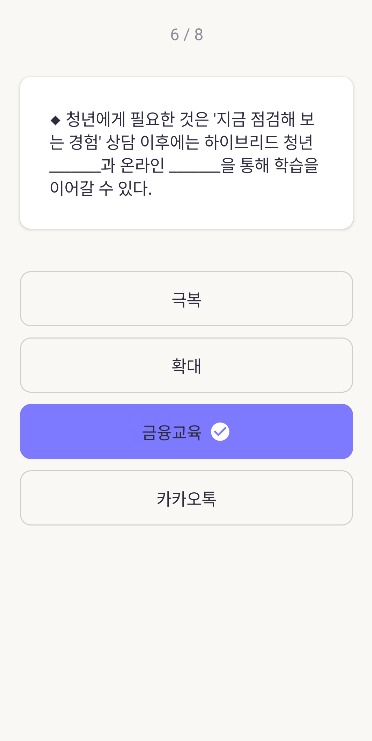
오답 후보를 고를 때 4가지 규칙을 점수로 환산해서 높은 점수 순으로 선택합니다.
규칙 | 내용 | 점수 |
|---|---|---|
언어 일치 | 정답이 한국어면 오답도 한국어, 영어면 영어 | 필터 (불일치 제외) |
글자 수 유사 | 정답과 글자 수 차이 ±1이면 +3, ±2이면 +2, ±3이면 +1 | 최대 +3 |
같은 문장 내 단어 | 해당 문장에 등장하는 단어 우선 | +4 |
출현 빈도 유사 | 문서 내 TF 비율이 0.5~2.0 범위 | +2 |
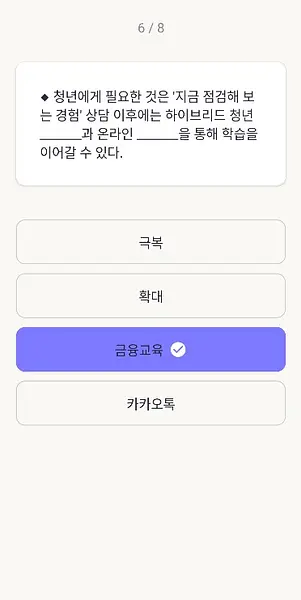
추가로, 이미 다른 문제에서 정답으로 쓰인 단어는 오답 후보에서 제외합니다. (기존에는 A번 문제 정답이 B번 문제 오답으로 등장하는 일이 있었습니다.) 결과적으로 오답 선택지가 훨씬 그럴듯해졌고, 퀴즈 난이도도 적절하게 올라갔습니다.
결과적으로 오답 선택지가 훨씬 그럴듯해졌고, 퀴즈 난이도도 적절하게 올라갔습니다.
퀴즈 다시 풀기 + 광고 추가
두 가지를 함께 추가했습니다.
퀴즈 다시 풀기 (Replay)
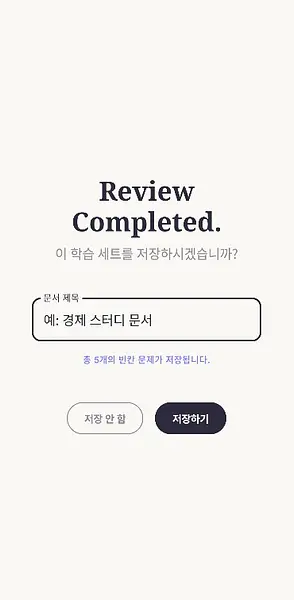
퀴즈를 다 풀고 나면 결과 화면에서 같은 문서로 바로 다시 퀴즈를 시작할 수 있습니다. 복습 앱이다 보니 "한 번 더 풀고 싶다"는 요구가 자연스럽다고 생각했습니다.
AdMob 광고 (배너 + 네이티브)
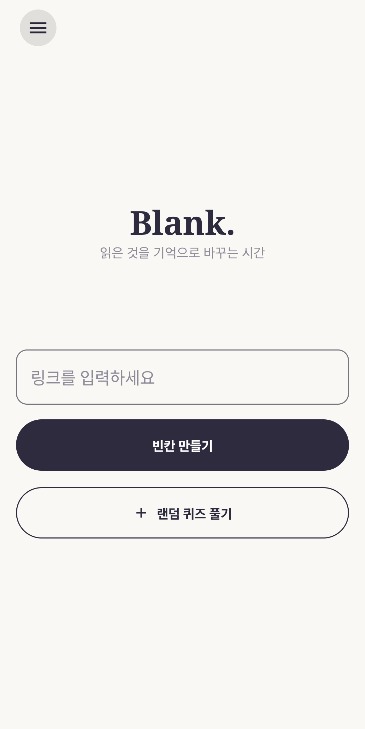
앱을 계속 개선하려면 어느 정도 지속 가능성이 있어야 한다고 판단해서 광고를 붙였습니다. 현재는 홈 화면 배너 광고, 아카이브 화면 네이티브 광고 형태로 적용했습니다. 퀴즈 풀기 화면에는 넣지 않았습니다 — 학습 흐름을 방해하고 싶지 않아서입니다.
현재 상태
항목 | 수치 |
|---|---|
Play Store 다운로드 | 업데이트 예정 |
적용 모델 | Gemma 4 E2B |
추론 엔진 | Google AI Edge LiteRT |
기술 스택 | Kotlin, Jetpack Compose, Koin, LiteRT, Room DB, AdMob |
피드백을 주세요
이번 업데이트 이후 특히 궁금한 것들입니다.
1. 오답 선택지 — 이전보다 그럴듯해졌나요? 아직도 너무 쉽게 정답이 보이는 경우가 있나요?
2. Gemma 4 체감 — 퀴즈 생성 속도나 빈칸 단어 선택의 품질 변화가 느껴지시나요?
3. 광고 경험 — 광고가 학습 흐름을 방해하지는 않나요?
Play Store: https://play.google.com/store/apps/details?id=com.shootsir.blank
직접 써보시고 솔직하게 알려주시면 다음 로그에서 반영 과정을 공유하겠습니다.
Blank.
웹 문서 URL만 넣으면 온디바이스 AI가 빈칸 퀴즈를 자동 생성!