시간을 달리는 인사이트

시간을 달리는 인사이트

프로덕트

아티클

전체 보기
시간을 달리는 인사이트

시간을 달리는 인사이트

비즈니스 세계에서 아첨과 칭찬을 구분하는 방법

비즈니스 세계에서 진심 어린 칭찬과 아첨을 구별하려면 다음 팁을 고려하세요:

1. 구체성: 진심 어린 칭찬은 구체적이고 개인의 업무나 행동의 특정 측면에 초점을 맞추는 경향이 있습니다. 반면에 아첨은 모호하고 일반적인 경우가 많습니다[1].

2. 관련성: 진심 어린 칭찬은 상황 및 개인의 성과와 관련이 있는 반면, 아부는 칭찬받는 개인의 진정한 자질이나 능력을 반드시 반영하지 않을 수 있습니다[4].

3. 진정성: 진정성 있는 칭찬은 진실과 정직함에서 나오는 반면, 아첨은 종종 진실하지 않고 숨겨진 의도에 의해 동기 부여됩니다[8]. 칭찬을 하는 사람의 어조와 몸짓에 주의를 기울여 칭찬의 진정성을 가늠하세요.

4. 일관성: 진정한 칭찬은 그 사람의 과거 행동 및 성과와 일치하는 반면, 아첨은 일관성이 없거나 과장된 것일 수 있습니다[1].

5. 은밀한 동기: 아첨에는 호의를 구하거나 받는 사람을 조종하려는 등의 은밀한 동기가 있는 경우가 많습니다[10]. 대가가 따르는 것처럼 보이거나 호의 요청이 뒤따르는 칭찬은 주의해야 합니다.

6. 타이밍: 진심 어린 칭찬은 일반적으로 미리 계획하지 않고 즉흥적으로 이루어지는 반면, 아첨은 특정 결과를 달성하기 위해 전략적으로 타이밍을 잡을 수 있습니다[17].

7. 영향력: 진정한 칭찬은 받는 사람의 동기 부여와 자존감에 긍정적인 영향을 미칠 수 있는 반면, 아부는 단기간에 그치거나 심지어 부정적인 영향을 미칠 수도 있습니다[1].

이러한 요소를 인식하면 직장에서 진심 어린 칭찬과 아첨을 더 잘 구분할 수 있습니다. 진심 어린 칭찬과 격려가 동기를 부여하고 영감을 줄 수 있지만, 진심이 아닌 칭찬은 해롭고 교묘할 수 있다는 점을 기억하세요[6].

인용:
[1] https://medium.com/rampup/the-difference-between-flattery-and-praise-691212264bfa
[2]
https://www.quora.com/How-can-you-tell-if-someone%E2%80%99s-compliments-are-genuine-My-big-boss-always-compliments-me-but-they-seem-to-me-to-be-insincere-Today-she-told-me-if-she%E2%80%99s-had-a-son-she%E2%80%99d-want-it-to-be-me-Because-I-simply-knew-how-she-took-her-coffee
[3]
https://www.listeningpartnership.com/insight/master-manipulator/
[4]
https://www.frontiersin.org/articles/10.3389/fnhum.2023.985047
[5]
https://sg.indeed.com/career-advice/career-development/how-to-praise-someone-professionally
[6]
https://thriveworks.com/blog/workplace-manipulation-identify-signs-communicate-effectively/
[7]
https://www.quora.com/What-is-the-difference-between-praise-and-flattery
[8]
https://hbr.org/2019/10/how-to-give-and-receive-compliments-at-work
[9]
https://www.linkedin.com/pulse/manipulation-praise-joe-contrera
[10]
https://gotherefor.com/offer.php?changestore=true&intid=29730
[11]
https://www.indeed.com/career-advice/career-development/how-to-compliment-coworkers
[12]
https://www.careeraddict.com/7-signs-your-boss-is-manipulating-you
[13]
https://www.n2growth.com/beware-of-flattery/
[14]
https://www.fastcompany.com/40537609/stop-giving-meaningless-compliments-and-do-this-instead
[15]
https://hbr.org/2022/01/are-you-being-influenced-or-manipulated
[16]
https://tanveernaseer.com/do-you-lead-others-through-flattery-or-praise/
[17]
https://www.scienceofpeople.com/fake-compliments/
[18]
https://medium.com/psychology-simplified/7-subtle-signs-of-manipulative-bosses-cd8386782928
[19]
https://www.fastcompany.com/90340287/why-flattery-in-the-workplace-is-risky-behavior
[20]
https://www.happify.com/hd/learn-to-give-genuine-compliments/
[21]
https://www.psychologytoday.com/us/blog/evolution-of-the-self/201401/praise-as-manipulation-6-reasons-to-question-compliments
[22]
https://www.ncbi.nlm.nih.gov/pmc/articles/PMC9974641/
[23]
https://www.tjguttormsen.com/blog/great-compliments
[24]
https://www.indeed.com/career-advice/career-development/manipulative-coworker
3
0
시간을 달리는 인사이트

시간을 달리는 인사이트

네이버, 생성형 검색 서비스 Cue 출시

Cue:는 대화를 통해 답변을 찾아주는 네이버의 AI 검색입니다.
떠오르는 생각을 대화하듯 입력하고, 필요한 정보를 한눈에 파악하는 새로운 경험을 시작하세요.

Cue:는 대기 명단에 등록하신 순서에 따라 순차적으로 승인되어 서비스 이용까지 대기가 발생할 수 있습니다.


대기 명단에 등록하신 분들께 빠른 시일 내에 서비스를 원활하게 제공할 수 있도록 최선을 다하겠습니다.

네이버 검색은 사용자에게 최상의 답변을 제공하기 위해 끊임없이 도전을 해왔습니다. 그리고 이제 네이버의 AI 기술이 집약된 Cue:를 통해 새로운 검색 경험을 선보이고자 합니다. 첫 번째, 어떤 검색어로 입력해야 할지 고민하지 말고 사람에게 물어보듯이 자연스럽게 질문하세요. Cue:가 질문을 이해하고 원하는 정보를 검색해서 가져다줍니다. 두 번째, Cue:는 이전 질문과 답변을 기억합니다. Cue:와 대화를 이어나가며 원하는 답을 찾아보세요.

7
0
시간을 달리는 인사이트

시간을 달리는 인사이트

DALL·E 3

CleanShot 2023-09-21 at 12.16.13@2x.png

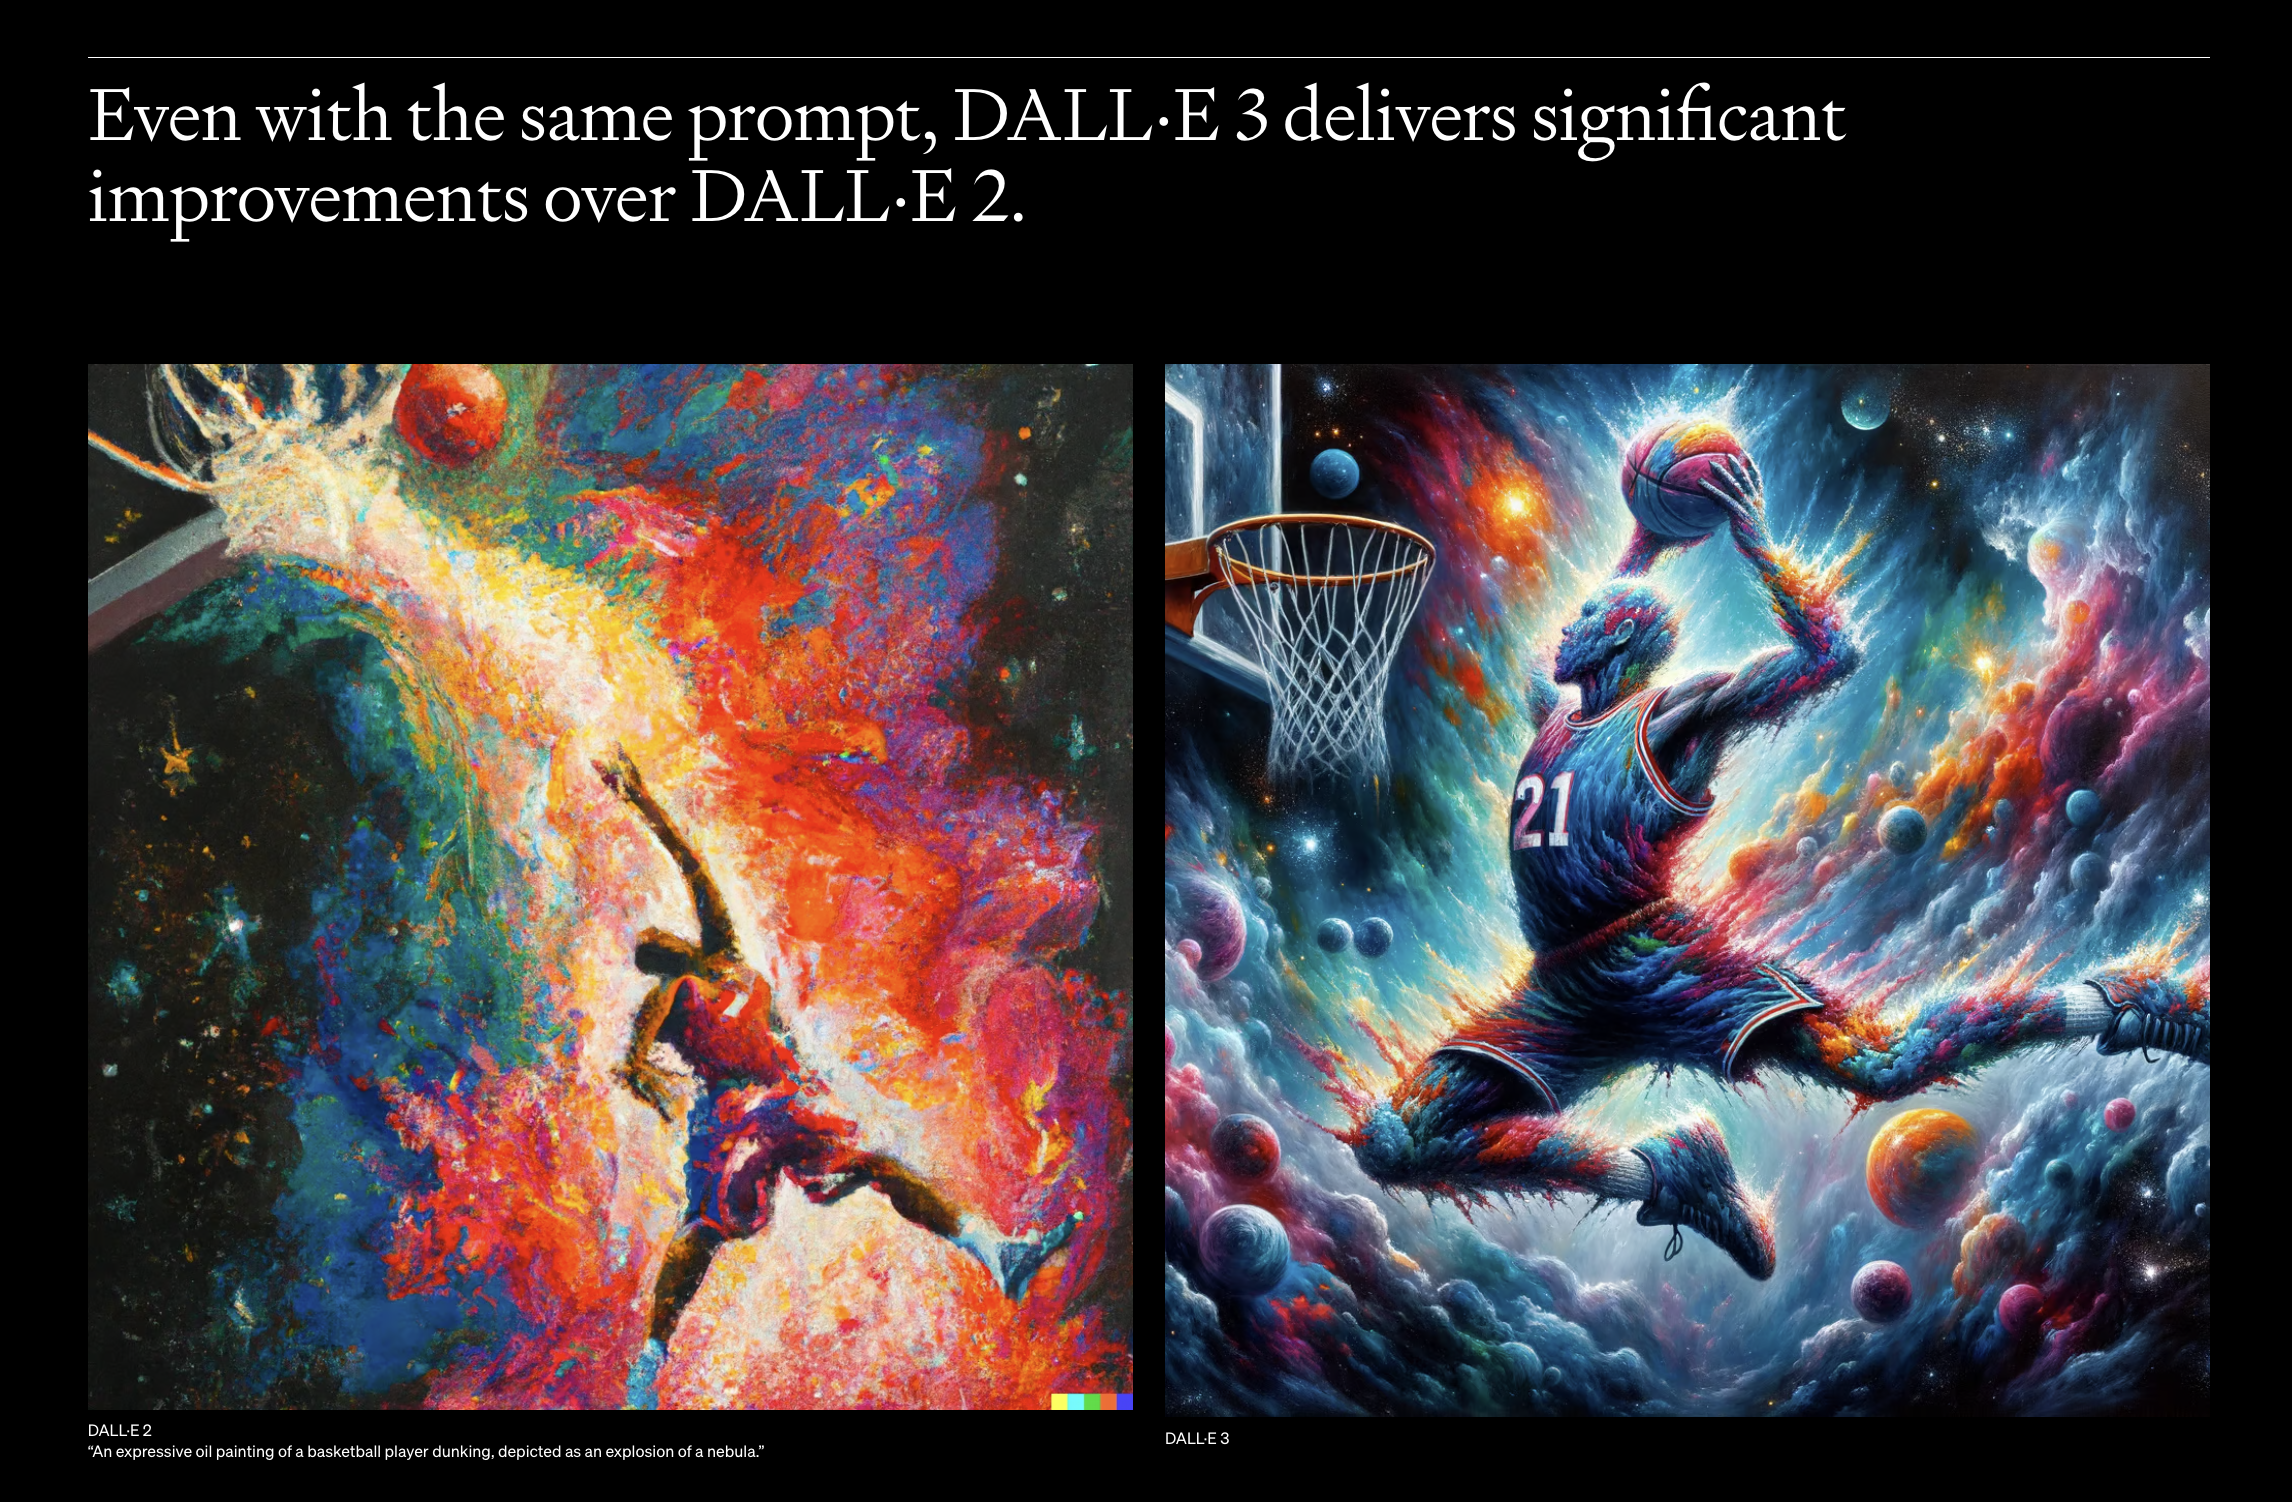
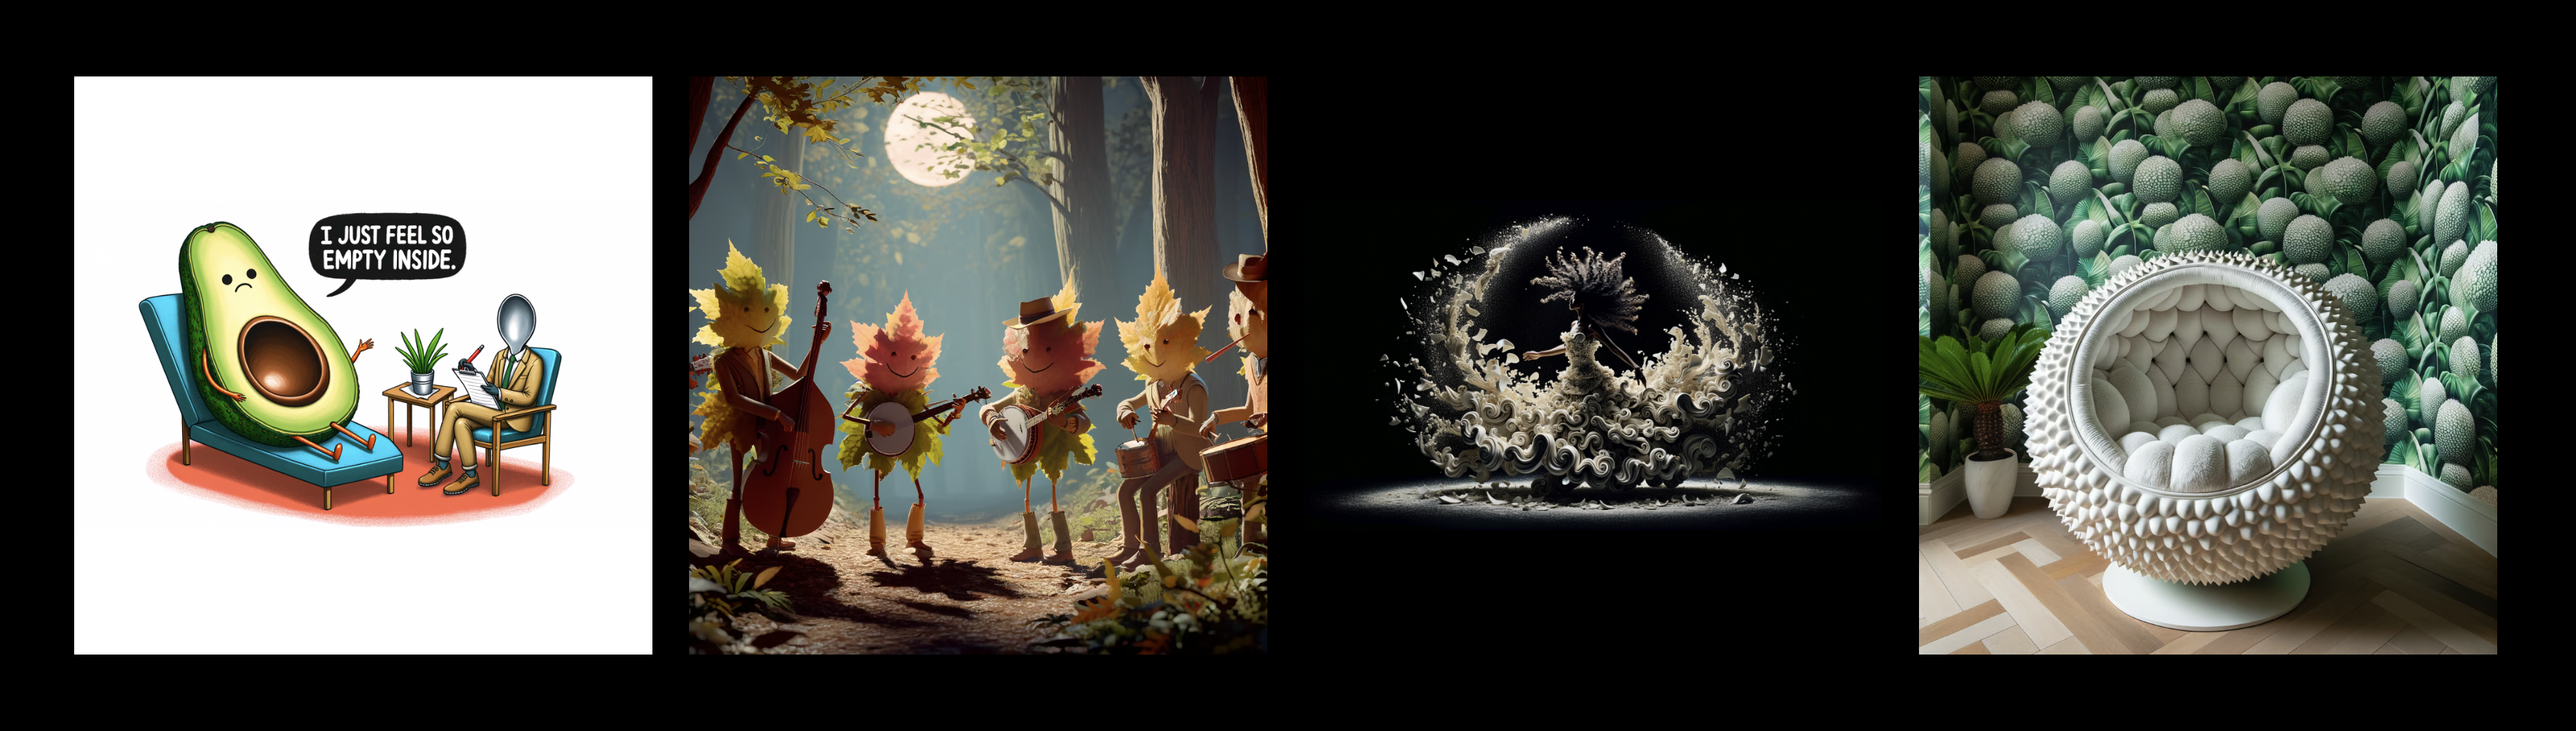
DALL-E 3는 이전 시스템보다 훨씬 더 많은 뉘앙스와 디테일을 이해하고 아이디어를 매우 정확한 이미지로 쉽게 변환할 수 있습니다.

동일한 프롬프트를 사용하더라도 DALL-E 3는 DALL-E 2에 비해 크게 개선된 기능을 제공합니다.

CleanShot 2023-09-21 at 12.16.56@2x.png

DALL-E 3는 기본적으로 ChatGPT를 기반으로 제작되었기 때문에 ChatGPT를 브레인스토밍 파트너이자 프롬프트를 다듬는 도구로 사용할 수 있습니다. 간단한 문장부터 자세한 단락까지 원하는 내용을 ChatGPT에 요청하기만 하면 됩니다.

아이디어를 입력하면 ChatGPT는 아이디어를 실현할 수 있는 맞춤형 세부 프롬프트를 자동으로 생성하여 DALL-E 3에 표시합니다. 특정 이미지가 마음에 들지만 적절하지 않은 경우 몇 마디 말만 하면 ChatGPT에 수정을 요청할 수 있습니다.

DALL-E 3는 10월 초에 ChatGPT 플러스 및 엔터프라이즈 고객에게 제공될 예정입니다. DALL-E 2와 마찬가지로 DALL-E 3로 만든 이미지는 귀하가 사용할 수 있으며 재인쇄, 판매 또는 상품화하기 위해 당사의 허가가 필요하지 않습니다.

6
1
시간을 달리는 인사이트

시간을 달리는 인사이트

업스테이지의 새로운 언어모델 솔라

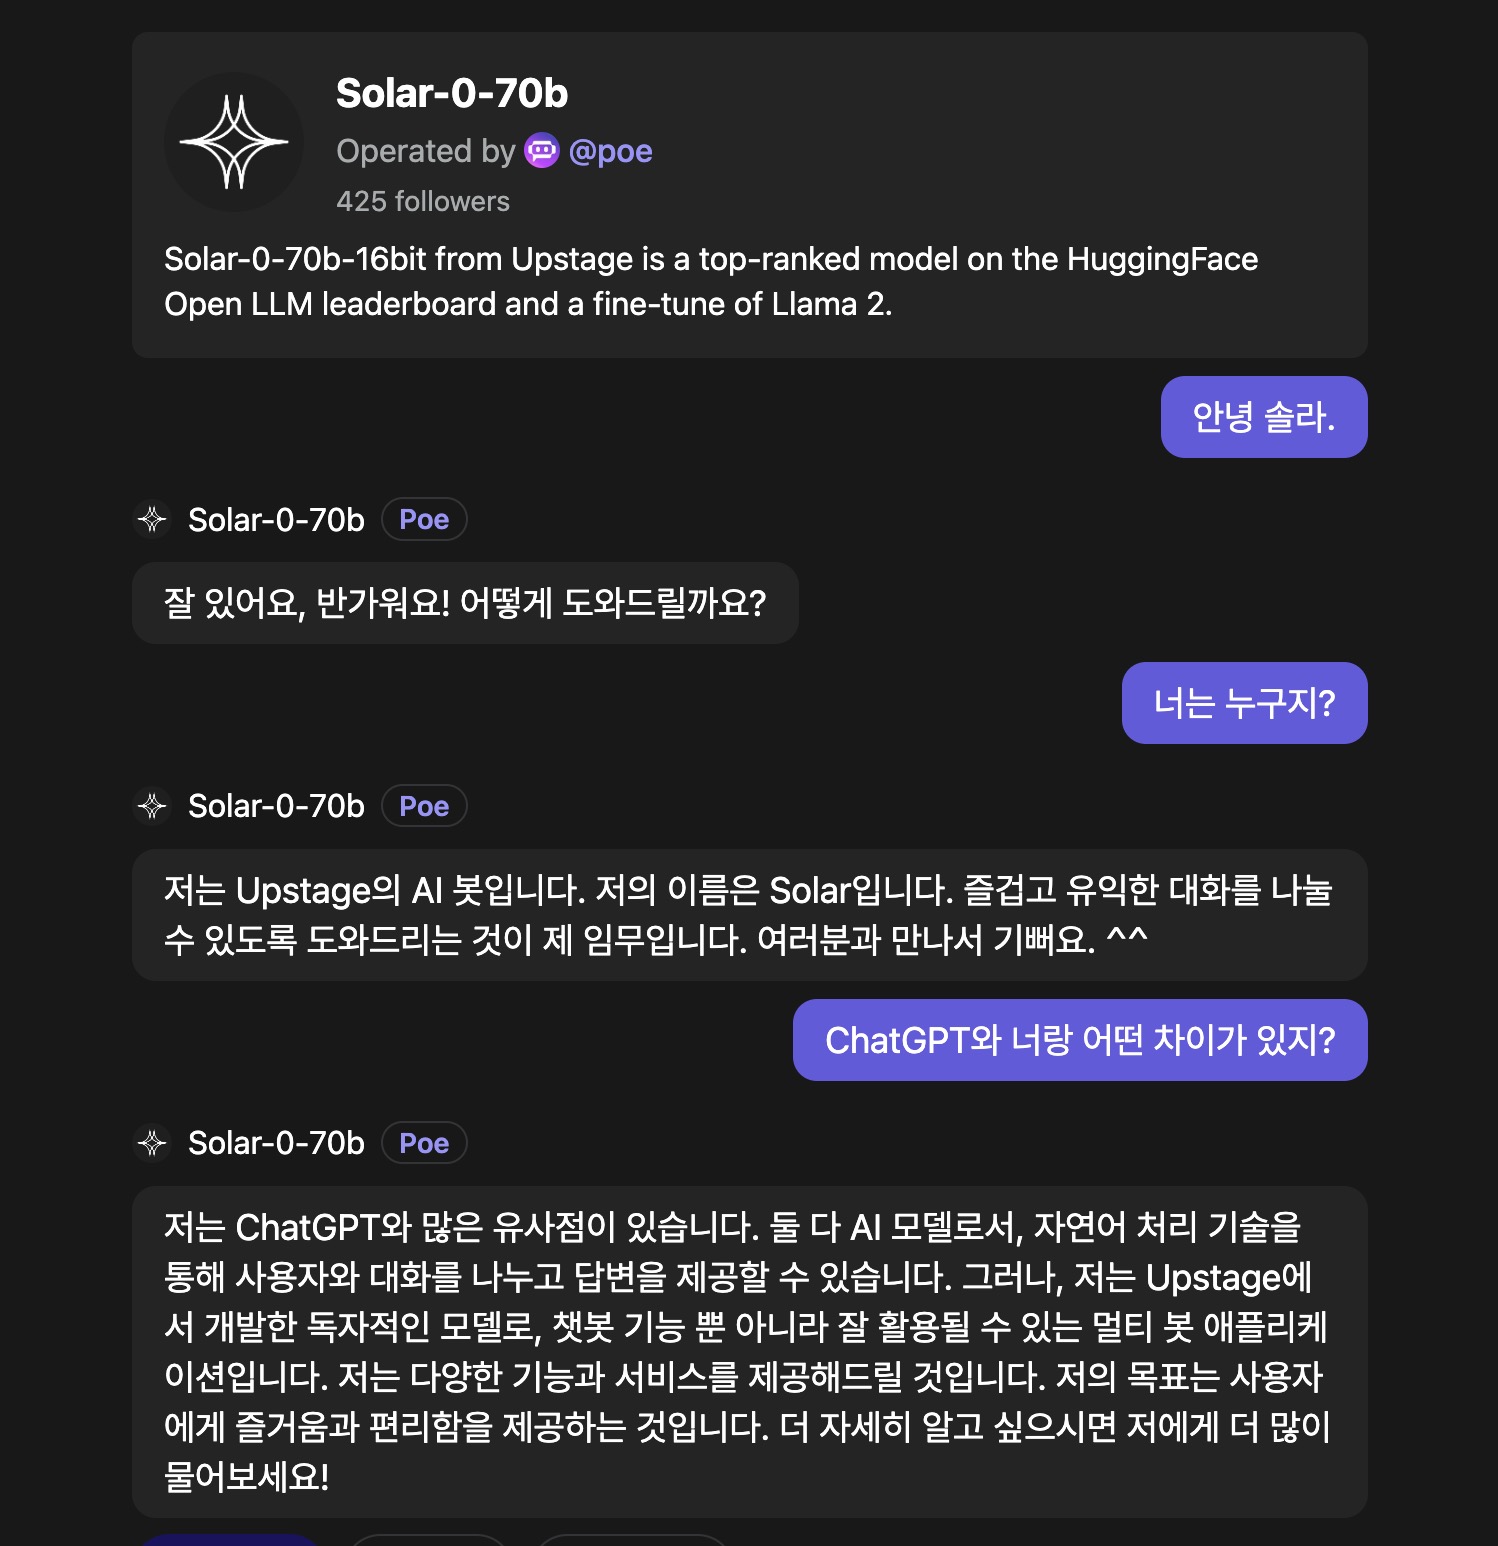
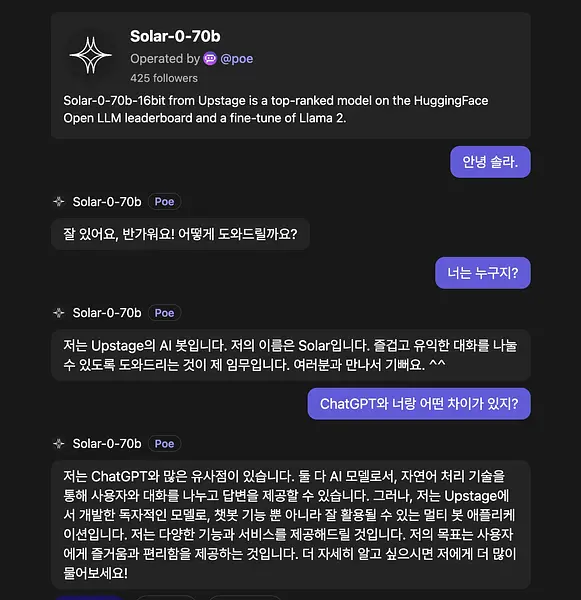
업스테이지에서 만든 새로운 봇인 Solar를 이제 포에서 사용할 수 있습니다.

2023-09-16 19.19.10.jpg

솔라는 HuggingFace Open LLM 순위표에서 상위권에 랭크된 모델이자 Llama 2를 미세 조정한 Solar는 오픈 소스를 통한 발전의 좋은 예입니다.

지금 체험하기 https://poe.com/Solar-0-70b


SOLAR-0-70b-16비트
모델 카드

  • 모델명이 LLaMa-2-70b-instruct-v2에서 SOLAR-0-70b-16bit로 변경되었습니다.

모델 세부 정보

  • 개발자: Upstage

  • 백본 모델: LLaMA-2

  • 언어(들): 영어

  • 라이브러리: 허깅페이스 트랜스포머

  • 라이선스: 미세 조정된 체크포인트는 비영리 크리에이티브 커먼즈 라이선스(CC BY-NC-4.0)에 따라 라이센스가 부여됩니다.

  • 의견을 보낼 수 있는 곳: 모델에 대한 피드백이나 의견을 제공하는 방법에 대한 지침은 허깅페이스 커뮤니티의 모델 저장소에서 이슈를 열면 확인할 수 있습니다.

  • 연락처: 모델에 대한 질문이나 의견이 있으시면 contact@upstage.ai 으로 이메일을 보내주세요.

  • 사용된 데이터 세트

    • 오르카 스타일 데이터 세트

    • 알파카 스타일 데이터 세트

  • 위에 언급된 데이터셋을 제외하고 다른 데이터셋은 사용되지 않았습니다.

  • 벤치마크 테스트 세트 또는 훈련 세트가 사용되지 않았습니다.

프롬프트 템플릿
### System:
{시스템}

### 사용자:
{사용자}

### 어시스턴트:
어시스턴트: {어시스턴트}

사용법

다음은 A100 80GB에서 테스트한 결과입니다.


저희 모델은 로프 스케일링 옵션 덕분에 최대 10,000개 이상의 입력 토큰을 처리할 수 있습니다.

토치 가져오기

트랜스포머에서 AutoModelForCausalLM, AutoTokenizer, TextStreamer를 가져옵니다.

tokenizer = AutoTokenizer.from_pretrained("upstage/Llama-2-70b-instruct-v2")
model = AutoModelForCausalLM.from_pretrained(
    "upstage/Llama-2-70b-instruct-v2",
    device_map="auto",
    torch_dtype=torch.float16,
    load_in_8bit=True,
    rope_scaling={"type": "dynamic", "factor": 2} # 더 긴 입력 처리 가능
)

prompt = "### 사용자:\n토마스는 건강하지만 병원에 가야 합니다. 그 이유는 무엇일까요? \n\n### 어시스턴트:\n"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
del inputs["token_type_ids"]
streamer = TextStreamer(tokenizer, skip_prompt=True, skip_special_tokens=True)

output = model.generate(**inputs, streamer=streamer, use_cache=True, max_new_tokens=float('inf'))
output_text = tokenizer.decode(output[0], skip_special_tokens=True)


하드웨어 및 소프트웨어

하드웨어: 모델 훈련에는 A100x8 * 4를 사용했습니다.

트레이닝 팩터: 딥스피드 라이브러리와 허깅페이스 트레이너/허깅페이스 액셀러레이트를 조합하여 이 모델을 미세조정했습니다.

평가 결과

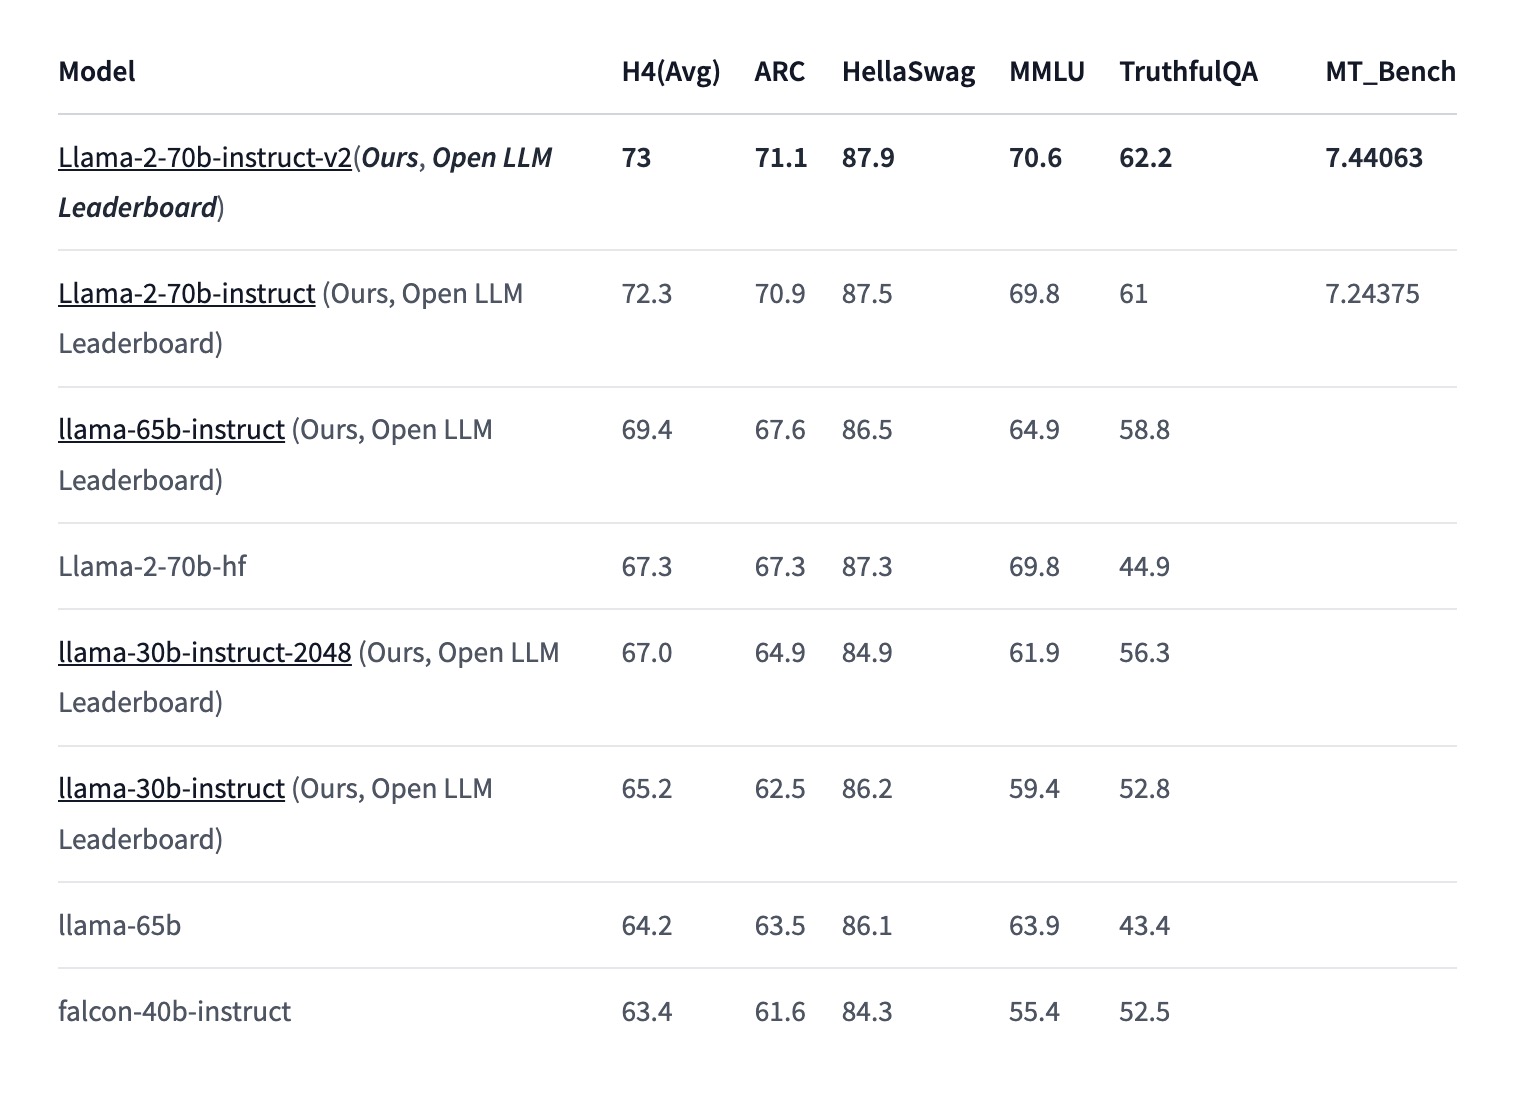
Open LLM 리더보드에서 평가 중인 과제에 따라 성능 평가를 수행했습니다. ARC-Challenge, HellaSwag, MMLU, TruthfulQA 등 4개의 벤치마크 데이터 세트에서 모델을 평가했으며, 특히 커밋 b281b0921b636bc36ad05c0b0763bd6dd43463의 lm-evaluation-harness 리포지토리를 사용했습니다.


모델을 평가하기 위해 여러 차례에 걸친 까다로운 주관식 문제 세트인 MT-bench를 사용했습니다.


2023-09-16 19.18.15.jpg

Scripts for H4 Score Reproduction

  • Prepare evaluation environments:

# clone the repository
git clone https://github.com/EleutherAI/lm-evaluation-harness.git
# check out the specific commit
git checkout b281b0921b636bc36ad05c0b0b0763bd6dd43463
# change to the repository directory
cd lm-evaluation-harness

업스테이지 소개

Upstage는 대규모 언어 모델(LLM) 및 AI 전문 회사입니다. 개인용 LLM 및 관련 애플리케이션을 구축할 수 있도록 도와드립니다. 도메인별 LLM을 구축하거나 LLM 애플리케이션을 만들기 위한 데이터셋이 있다면 ► 여기를 클릭하여 문의해 주세요.


8월 1일 현재, 70B 모델은 오픈LLM 순위에서 1위를 차지하며 현재 전 세계에서 가장 우수한 성능을 보이고 있습니다.

9
0

포스트

아직 포스트가 없습니다.