반복되는 크롤링 작업을 Spring Batch로 해결해보자
나는 하루에 책을 얼마나 읽었는지 기록하고 이를 그래프로 나타내는 서비스를 개발하고 있다.
따라서 책 정보가 필수인데 책 검색 API를 사용하기보다 크롤링을 통해 우리 서비스에서 필요한 정보만 저장하기로 결정, 크롤링을 통해 정보를 저장중이었다.
기존 크롤링 방법
모든 카테고리를 순회하면서 각 카테고리 별로 20권씩 크롤링
매 탐색마다 책 정보를 DB에 바로 저장
원하는 정보가 누락되어 있거나 탐색 중 에러가 발생한다면 해당 책은 스킵
딱 1000권만 크롤링 할 목적으로 코드를 작성했기 때문에 위 방법으로 진행해도 문제가 없었다.
하지만 신간도서 관련 기능이 추가되면서 반복적으로 크롤링을 해야 하는 상황이 벌어지니 문제가 발생했다.
문제
이전에 진행한 크롤링으로 저장된 책이 다음 크롤링에서 다시 저장되는 책 중복 발생
매 탐색마다 책 정보를 바로 저장하다보니 총 1000번의 쿼리 발생
크롤링이 중간에 멈추게 된다면 중단된 시점까지의 책 정보가 그대로 저장
기능 확장으로인해 Elasticsearh 추가, 데이터를 ES로도 전송해야함
크롤링으로 인한 문제와 추가된 기능들로 인해 기존 서비스 구조로는 문제를 해결할 수 없다고 생각했고 내가 필요한 기능들이 모두 갖추어진 Spring Batch를 사용해서 이 문제를 해결하기로 했다.
Spring Batch를 사용하는 이유
크롤링, DB에 저장과 같은 반복적인 작업의 자동화
대용량 데이터의 안전하고 빠른 처리
작업 실패 시 기존 상태로 복구
데이터 처리 과정
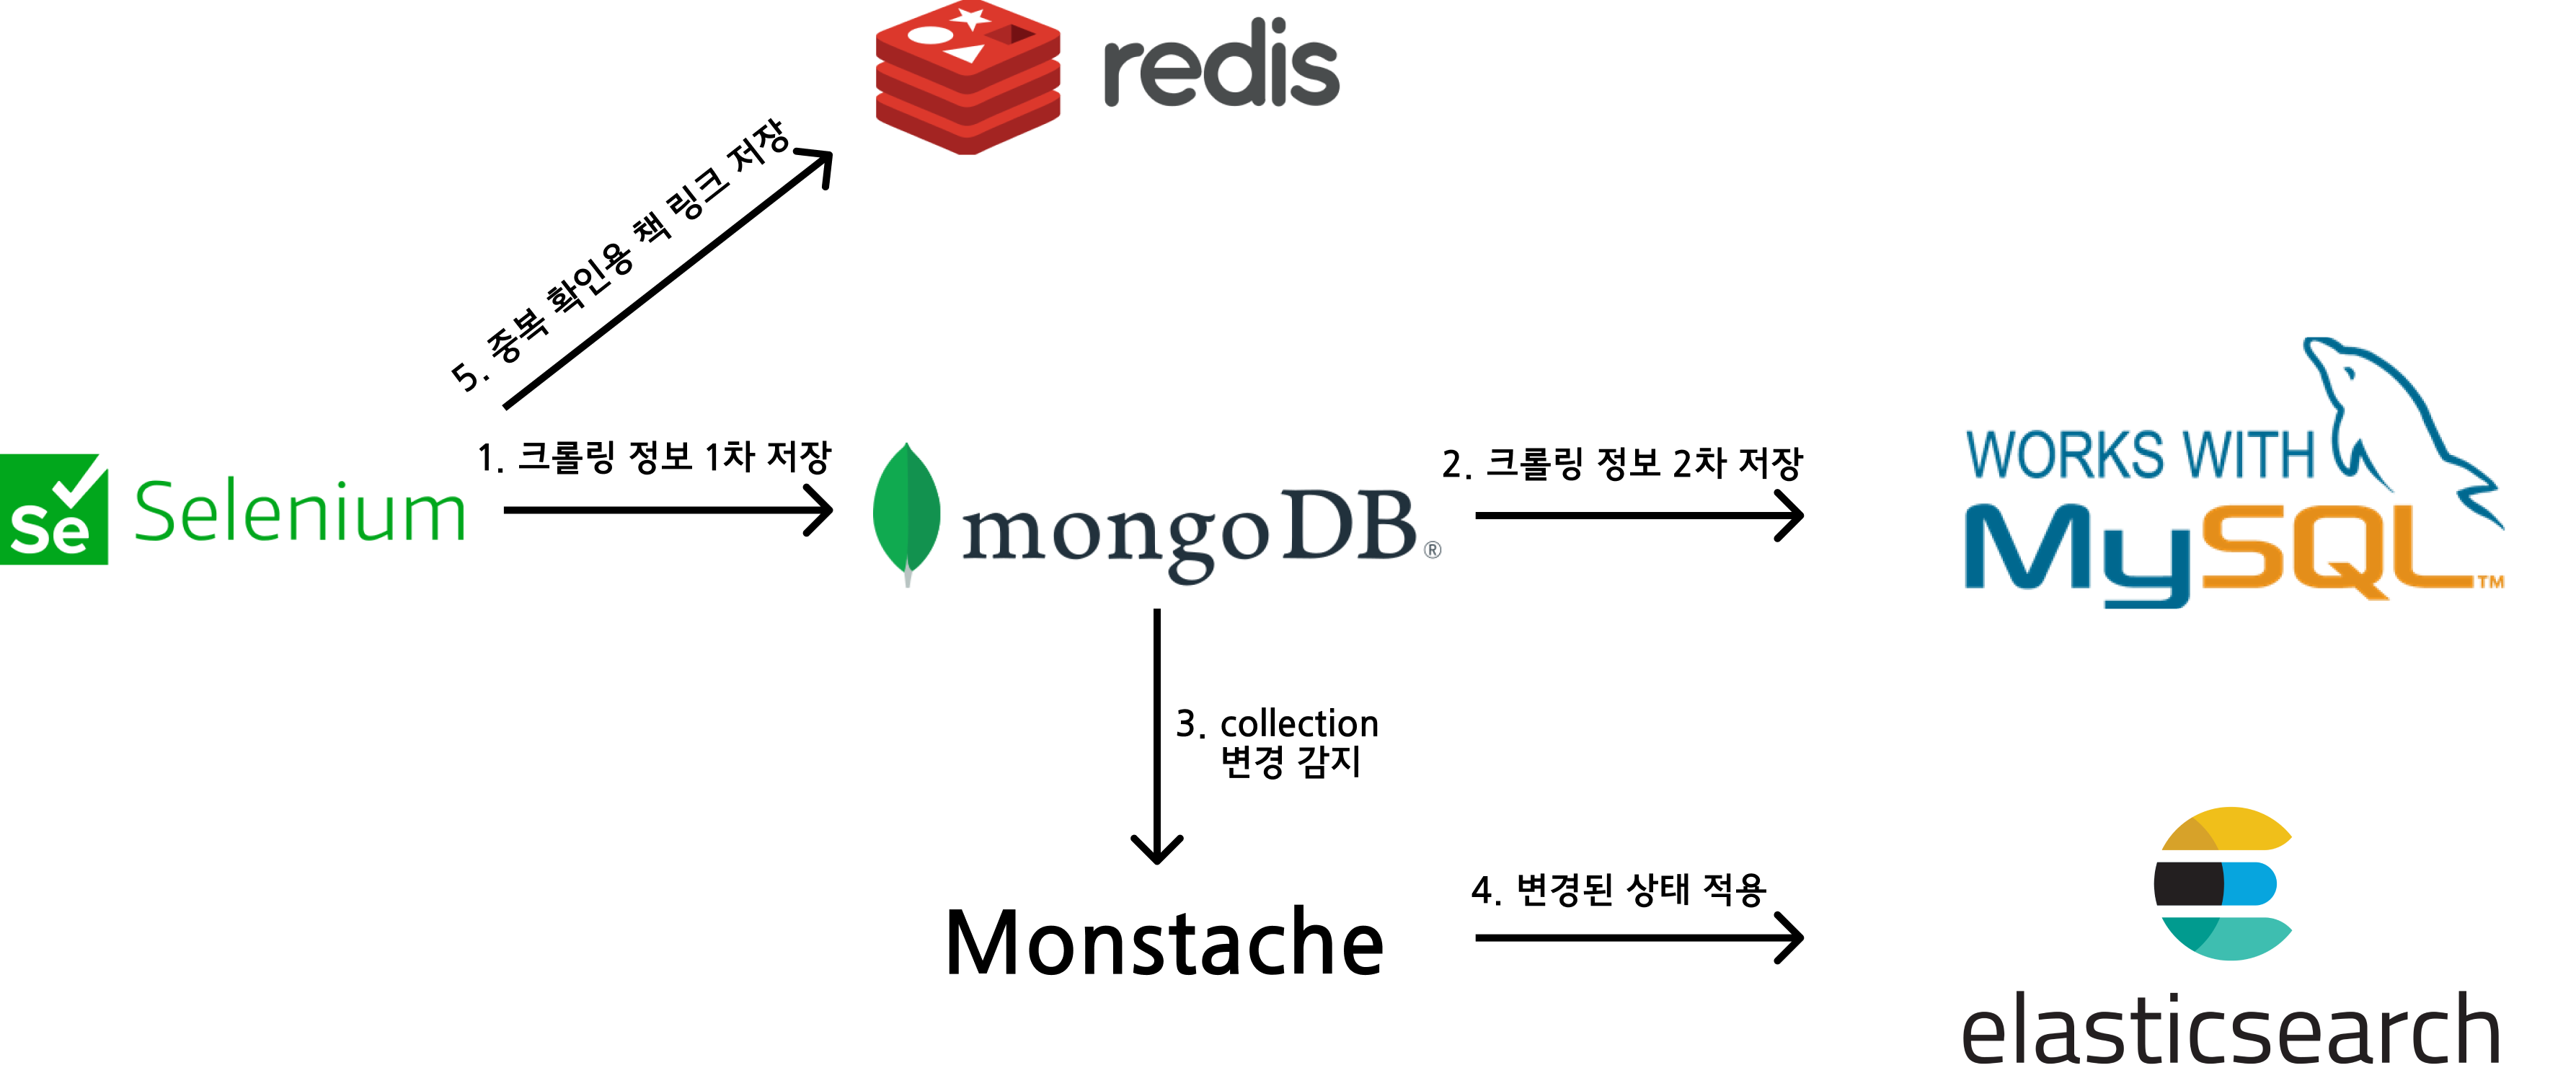
크롤링 정보 1차 저장
크롤링 한 정보를 List로 만들어 저장한다. 그 후 크롤링이 끝나면 MongoDB에 List를 저장한다.
이 때 책 정보를 List에 저장하면서 동시에 책 URL을 Map에 저장한다. 이는 이후 Redis에 저장된다.
1차적으로 MongoDB에 저장하는 이유
백업
Monstache를 사용해서 ES에 동기화시키기 위함
크롤링 시 책 필드 변경이 용이
크롤링 정보 2차 저장
MongoDB에 저장한 정보를 실제 서비스에서 사용할 MySQL에 저장
TransactionManager를 사용해 에러 발생 시 chunk size 만큼 rollback
3,4. Collection 변경 감지, 변경된 상태 적용
Monstache를 사용해서 변경된 상태대로 ES 동기화
Spring Batch의 step으로 저장하지 않고 Monstache 사용
ES는 rollback, transaction을 지원하지 않기 때문
굳이 step으로 처리할 필요 없이 Monstache로 관리하는 것이 좋다고 판단
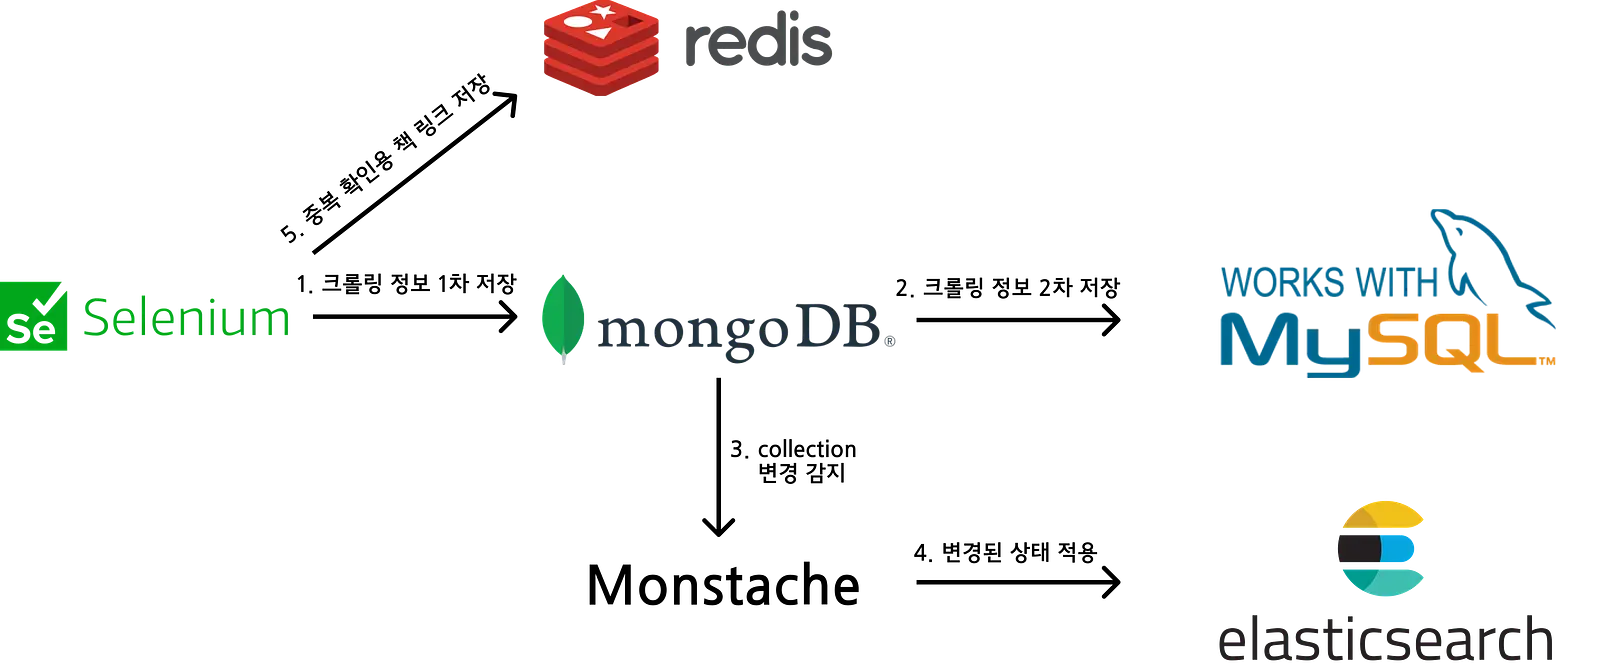
중복 확인용 책 링크 저장
1에서 저장한 Map을 Redis에 저장한다.
MongoDB보다 비교적 빠른 Redis를 사용해서 빠르게 중복된 책인지 확인
가장 마지막에 Key값을 저장하기 때문에 이전 step이 실패해도 문제 x
적용 후
위 순서로 데이터를 저장하는 Spring Batch Application을 Docker image로 만들어 EC2에서 실행중이다.매주 월요일마다 크롤링을 진행하고 안전하게 저장되는 것을 보니 적용하는데 까지 오래 걸렸지만 이제 크롤링에 신경쓰지 않아도 되니 마음이 편해졌다.
댓글
로그인 후 댓글을 남길 수 있습니다.
오...안 그래도 요즘 이 것과 비슷한 개발이 필요한데.......커피챗 드리겠습니다. ㅎㅎ