Large Language Model(LLM) 대신 Small Language Model(SLM)은 어떤건가요?
어제 밤 10X AI Club 1기 멤버들과 두번째 스터디 세션을 열었습니다.
10X AI Club의 멤버이신 박찬진님께서 게스트로 오셔서 Microsoft가 바라보는 앞으로의 생성AI 미래, B2B 기업들에서 공통적으로 가장 많이 원하는 생성AI use cases, 스타트업들이 가져야 할 비즈니스 전략 등에 대해서 짧게 소개하고 Q&A 하는 세션을 가졌어요.
세션의 마지막 슬라이드가 가장 인상 깊었는데, 스타트업, 혹은 서비스를 상용화 시키고 싶은 개인이 프로덕트를 빌딩할때 어떤 것들을 중점으로 둬야하는지 소개해주셨어요.
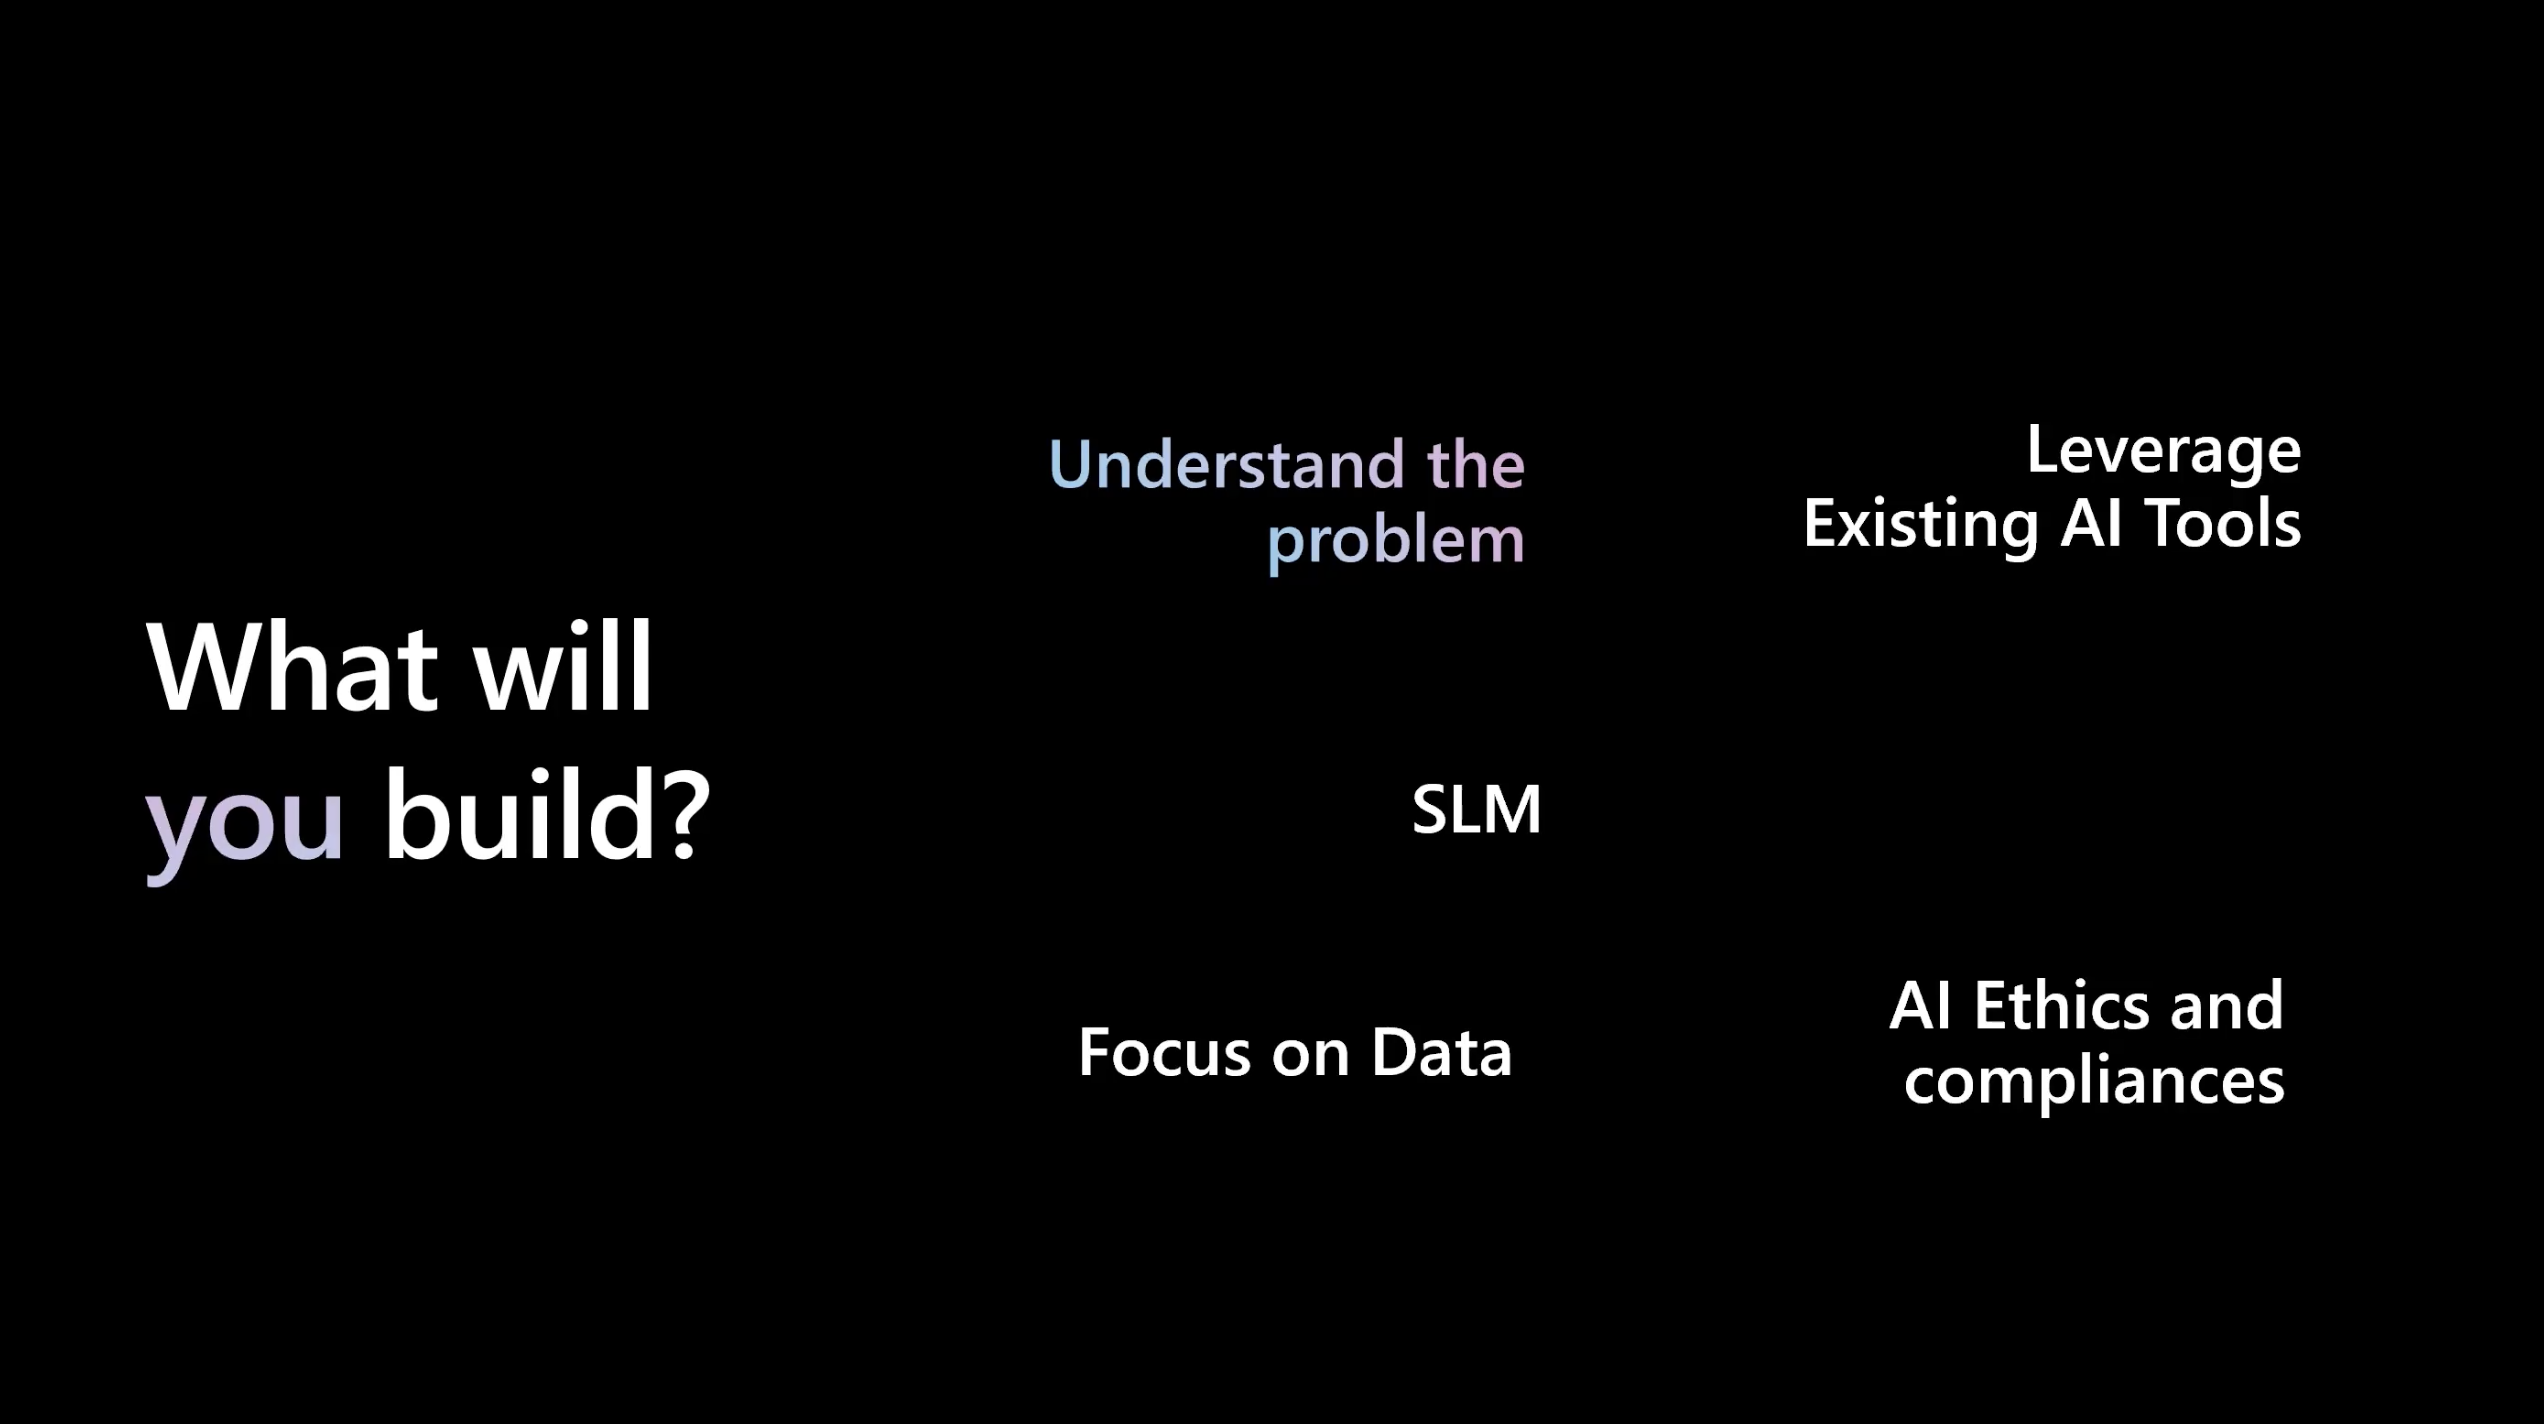
문제를 제대로 파악해라
모든 것을 일일이 만들려고 하지 말고 오픈소스로 나와있는 기존의 AI 툴들을 사용해서 빨리 만들어라
SLM을 사용해라
퀄리티 높고 깨끗한 데이터를 학습시키는게 가장 중요하다
AI 윤리를 중요시 여겨라 (개인정보보호)
하나하나 다 공감이 되면서, SLM이 뭔지 궁금해지기 시작했고, 1기 멤버분들도 이와 관련된 질문들을 해주셨어요.
SLM이 뭔가요? LLM이랑 어떤 차이가 있나요?
SLM을 쓰면 LLM에 비해 장단점이 무엇이 있나요?
SLM을 사용하면 OpenAI의 LLM 모델들을 쓸때에 비해 개인정보보호가 더 잘되나요?
SLM 예시는 어떤 것들이 있나요?
SLM이 뭔가요? LLM이랑 어떤 차이가 있나요?
언어 모델의 유형
언어 모델에 대한 연구는 현재에도 진행형입니다. 본격적으로 작동 원리에 대해 이해하기 전에, 개발 단계를 네 가지로 나눠 알아보겠습니다.
SLM (Small Language Model): 제한된 양의 텍스트 데이터를 학습하여, 작업 전반에 걸쳐 국소적인 문맥을 이해하는 데에 초점을 맞춥니다. 작은 규모에도 불구하고, SLM은 가볍고 실행 속도도 빠른 특징을 가지고 있습니다.
NLM (Neural Language Model): NLM은 기존의 통계 기반 언어 모델보다 더 정확한 성능을 제공합니다. 이러한 모델은 주로 단어 임베딩, 문장 완성, 기계 번역 등 다양한 NLP 작업에 사용됩니다.
PLM (Pretrained Language Model): PLM은 대규모 데이터셋으로 미리 학습되며, 이후 다양한 NLP 작업에 전이학습(Transfer Learning)을 통해 적용됩니다. BERT와 GPT와 같은 주요 모델들은 이 PLM에 속합니다.
연구자들은 PLM을 확장하면 다운스트림 작업에서 모델 용량이 향상될 수 있다는 사실을 발견했습니다. 많은 연구에서 훨씬 더 큰 PLM을 훈련하면서 성능 한계를 탐색해보고자 했죠. 이러한 대형 PLM은 소형 PLM과는 다르게, 일련의 복잡한 작업을 해결할 때 놀라운 능력을 발휘한다는 점이 밝혀졌습니다. 예를 들어, GPT-3는 상황을 학습하여 단발성 과제를 해결할 수 있는 능력을 가졌지만 GPT-2는 그렇지 못했죠. 따라서 연구 커뮤니티에서는 이러한 대형 PLM을 두고 “대규모 언어 모델(LLM)”이라는 용어를 사용하기 시작했습니다. 즉, LLM은 언어 모델의 현주소이자 최종 개발 단계라고 할 수 있습니다.
즉 SLM은 언어 모델의 가장 기초적인 단계에 있는 소규모의 언어 모델이고, 제한된 양의 텍스트 데이터로 조금 더 자세하고 특수한 케이스를 위해 쓰이는 것입니다. LLM은 OpenAI의 ChatGPT와 같이 어떠한 텍스트도 생성해주는 대형 언어모델이고, SLM은 예를 들어 제한된 데이터를 갖고 특정 리서치를 위해서 쓰이는 모델입니다.
SLM을 쓰면 LLM에 비해 장단점이 무엇이 있나요?
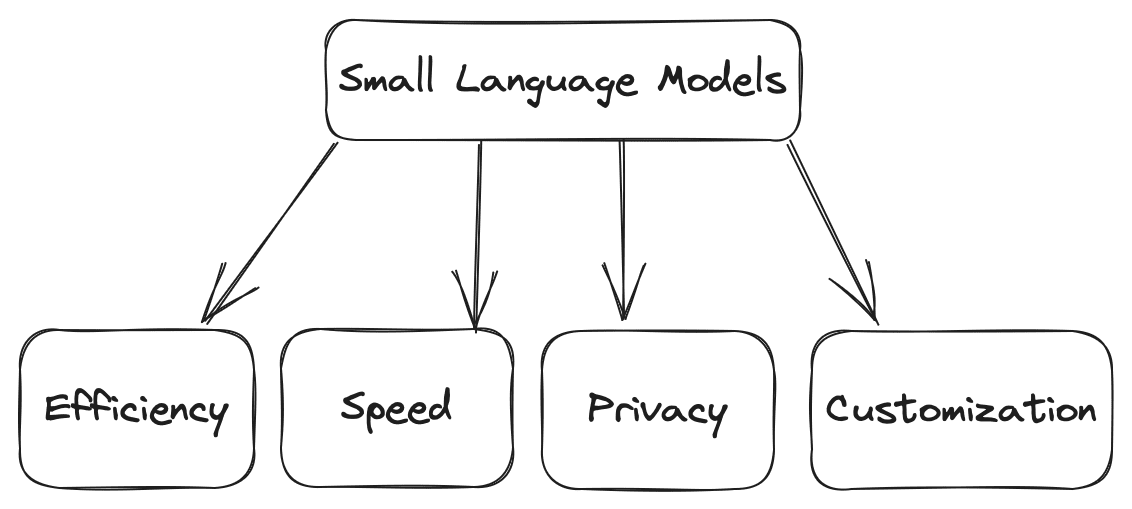
효율성: 대형 언어모델보다 적은 양의 컴퓨팅 파워 요구. GPU, CPU 리소스의 비용 값을 감당하기 힘든 개인/작은 팀들을 위해서는 이런 SLM이 더 효율적.
속도: 언어 모델이 작은 만큼 계산 속도와 텍스트를 생성하는 속도도 빠름. 만약 실시간으로 텍스트를 생성해야하는 앱이거나 많은 트래픽이 몰려오는 앱이라면 소형 언어 모델 추천.
커스텀 모델: 특수한 태스크를 위해 소형 언어 모델을 파인튜닝할 수 있음.
정보 보호: 소형 모델들은 외부 서버 없이 사용할 수 있기 때문에 데이터 프라이버시와 integrity를 유지할 수 있음.
즉 OpenAI와 같은 대형 언어모델을 사용하는 것보다 SLM을 쓸때 학습시키는 정보들의 프라이버시를 더 잘 보호할 수 있겠죠?
찬진님께서 말한거와 같이 특정 산업이나 영역에 최적화된 수직적 use case를 만들려면 소형 언어 모델이 적합할 것 같습니다. 그 대신 대형 언어 모델들 보다는 대화의 퀄리티나 역량이 떨어질 수 있다는 점을 감안해야합니다. 그렇지만 학습 데이터의 양이나 퀄리티가 좋다면 이 데이터만 파인튜닝 시킨 소형 언어 모델이 대형 언어 모델보다 퀄리티를 뛰어넘을 수도 있습니다.
또 다른 점은 대형 언어 모델을 사용하다보면 비용적인 측면을 항상 고려해야하는데, 소형 언어 모델들은 좀 더 빠른 속도와 적은 컴퓨팅 파워, 적은 매개변수 (파라미터 값들)로 비용을 절감할 수 있다는 장점도 있습니다.
💡 여기서 잠깐! 매개변수가 뭔가요?
매개변수란 인간의 뇌와 비유해서 설명하자면 뇌에서 정보를 학습하고 기억하는 시냅스와 비슷한 역할을 합니다. 매개변수가 많을수록 언어 모델의 성능이 높아지겠죠? 즉 대형 언어 모델이면 이 매개변수의 수가 소형 언어 모델보다 훨씬 많습니다. 예를 들어 GPT4는 1.7 trillion (1700억)개의 매개변수 사이즈를 갖고 있습니다.
SLM의 예시는 어떤 것들이 있나요?
가장 잘 알만한 예시로 메타가 출시한 LLaMA 중에서 매개변수가 가장 적은 버전인 Alpaca 7B가 있습니다. 적은 양의 학습 데이터만으로 훈련도 3시간 안에 끝냈지만 성능은 GPT-3.5와 비슷하다고 합니다.
다른 예시로는 최근에 Microsoft에서 발표한 Phi-1.5와 Phi-2 입니다. Phi-1.5는 13억개(1.3B)의 매개변수로 학습한 소형 언어 모델로, 훨씬 적은 비용과 시간으로 대형 언어 모델과 비슷한 성능을 보였고, Phi-2는 27억개(2.7B)로 학습시킨 높은 성능의 모델입니다.
SLM은 LLM을 대체할 수 있을까요?
Microsoft와 같은 경우 아무리 소형 언어 모델들의 성능이 뛰어나도, OpenAI의 GPT-4와 같은 대형 모델들을 완전히 대체할 수는 없다고 했습니다. 대체하는 것보다는, 서로 같이 쓰는 방법을 많은 미국 기업들이 최근에 하고 있죠. 예를 들어, 만약 좀 더 정교한 태스크를 처리해야하는 일이라면 대형 모델을 사용하고, 단순히 문서 요약 및 정리의 업무들이라면 소형 모델들을 사용하는게 더 효율적입니다. 이렇게 한가지의 LLM에 의존하는 것 보다는 동시에 여러 버젼의 LLM을 함께 사용하는 방법도 고려해봐야 할 것 같습니다.
댓글
로그인 후 댓글을 남길 수 있습니다.
질문을 많이 드렸었는데 통합 설명해 주셔서 도움이 되었습니다. 감사합니다.
케이스마다 사용하기 적합한 기술들이 점점 세분화되고 있네요!
맞아요 그렇더라구요!
Mistral AI, Llama 2 70B 모델보다 뛰어난 Mixtral 8x7B 모델 https://news.hada.io/topic?id=12296 Llama 2 70B를 대부분 벤치마크에서 능가하며, 6배 빠른 추론 SLM으로 최적화할 수 있는 커스텀 업무라면 충분히 대체 가능할 것 같습니다. 또한 특정 분야만을 잘 하는 SLM 최적화 모델도 개량되서 나오고 있고요 ^^