[Tip] MZ 세대가 열광하는 인테리어, 10초 만에 하기 🏠
🥲 휴 2주 만에 살아 돌아왔습니다... 이사 정말 힘드네요... (몸살도 났어요)
최근 들어서 가장 오래 글을 안 쓴 기간이었던 것 같습니다.
'왜 바빴는가' 라고 질문을 주신다면,
2주간 스모어톡은 이미지 어시스턴트, 플라멜 출시를 앞두고 최소한 대한민국에 파급력을 줄 수 있는 방식을 고민해 무언가를 준비하고 있었습니다. (여전히 잘 모르겠지만 일단 Go, 정말 커밍쑨...)
또한 도전! K-스타트업 2023 왕중왕전 준비(링크), Open Ko-llm Leaderboard 5위 등극(링크, 10/25 일자 1위) 등 오랜만에 저도 ML 엔지니어가 아닌 CSO(전략 담당) 로서 AI 최신 동향에 대해 다시 확인하는 시간을 가졌던 것 같습니다.
그리고 (제일 중요한) 마침 제가 직전 자취방 계약 만료로 이사를 했어야 했는데요.
와... 이사 정말 힘들더라고요...
그런데 또 막상 텅 빈 집을 보고 계약 후 여기를 무엇으로 채워야 할까를 고민하게 되었습니다.
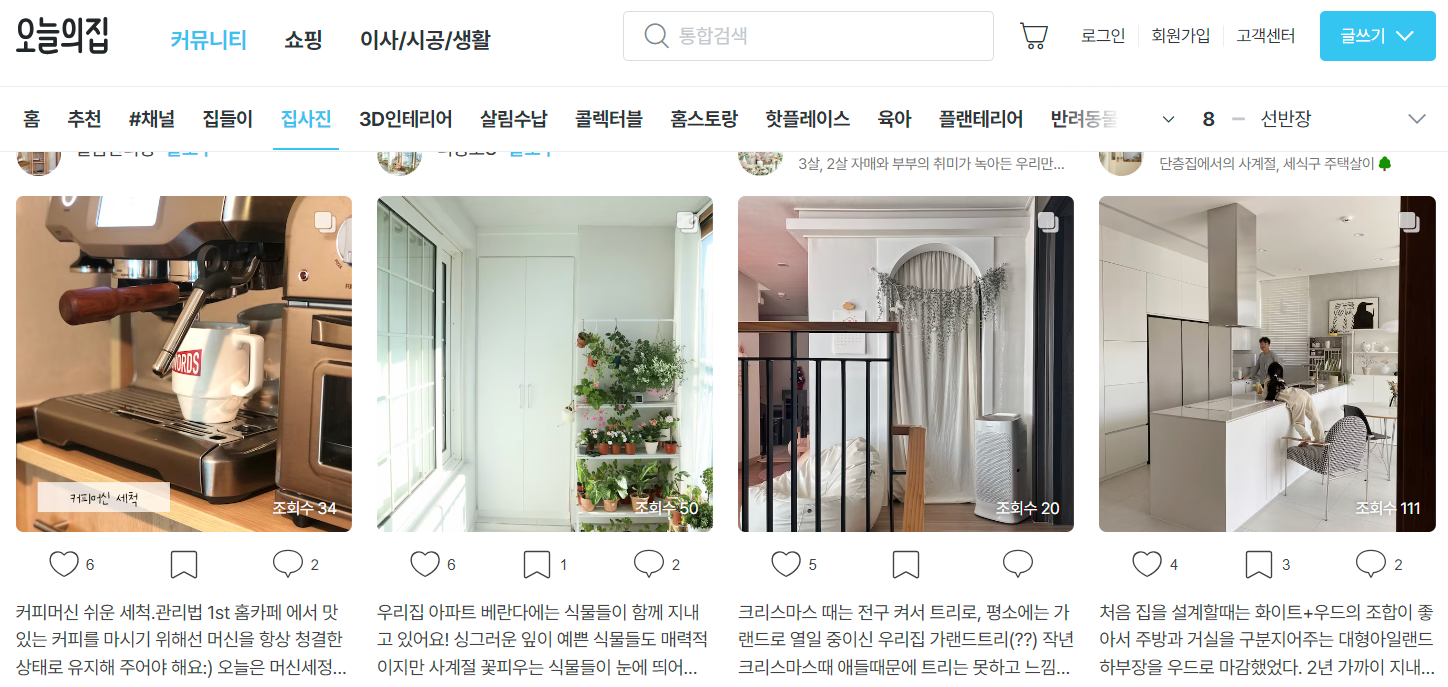
사실 저와 같이 2·30 대로 대표되는 MZ세대 사이에서 '집 꾸미기'에 대한 관심이 높은 상황입니다. 광명 이케아에 찾아 갔을 때에도 정말 많은 청년들이 조립 가구를 둘러보고 있더라고요.
이유는 간단합니다.
어차피 월급으로는 집 마련하기 힘드니 인테리어라도 고급으로 해서 집을 꾸미자라는 것인데요.
대부분의 MZ세대(저 포함)는 자가가 아닌 전·월세를 들어 살고 있습니다. 그리고 '오늘의집' 의 주요 이용자는 25~34세, 현대리바트의 페이지뷰의 약 40%가 MZ세대인 것이 앞의 가설을 뒷받침하고 있다고 보여집니다.
그런데 인테리어는 공간 디자인의 특성에 따른 문제가 존재합니다.
각기 다른 공간에 맞추어야 합니다.
소유한(=제한된) 인테리어 자산을 기반으로 디자인 해야 합니다.
빠르게(!) 끝내야 합니다.
또한 당연하게도 디자인이기 때문에 시각적인 미학 또한 소비자의 구매를 이끌어내는 주요 요소이지만, 그만큼 많은 시안을 준비하기에는 여러 물리적인 어려움이 존재합니다.
인테리어 수요자 입장에서도 오프라인으로 직접 업체를 방문하여 견적을 내고, 2~3주를 소요해 시안을 제공받는 것은 당연히 불편했습니다. (중요! 물론 이 솔루션의 구매자는 인테리어 업체입니다)
그런데...
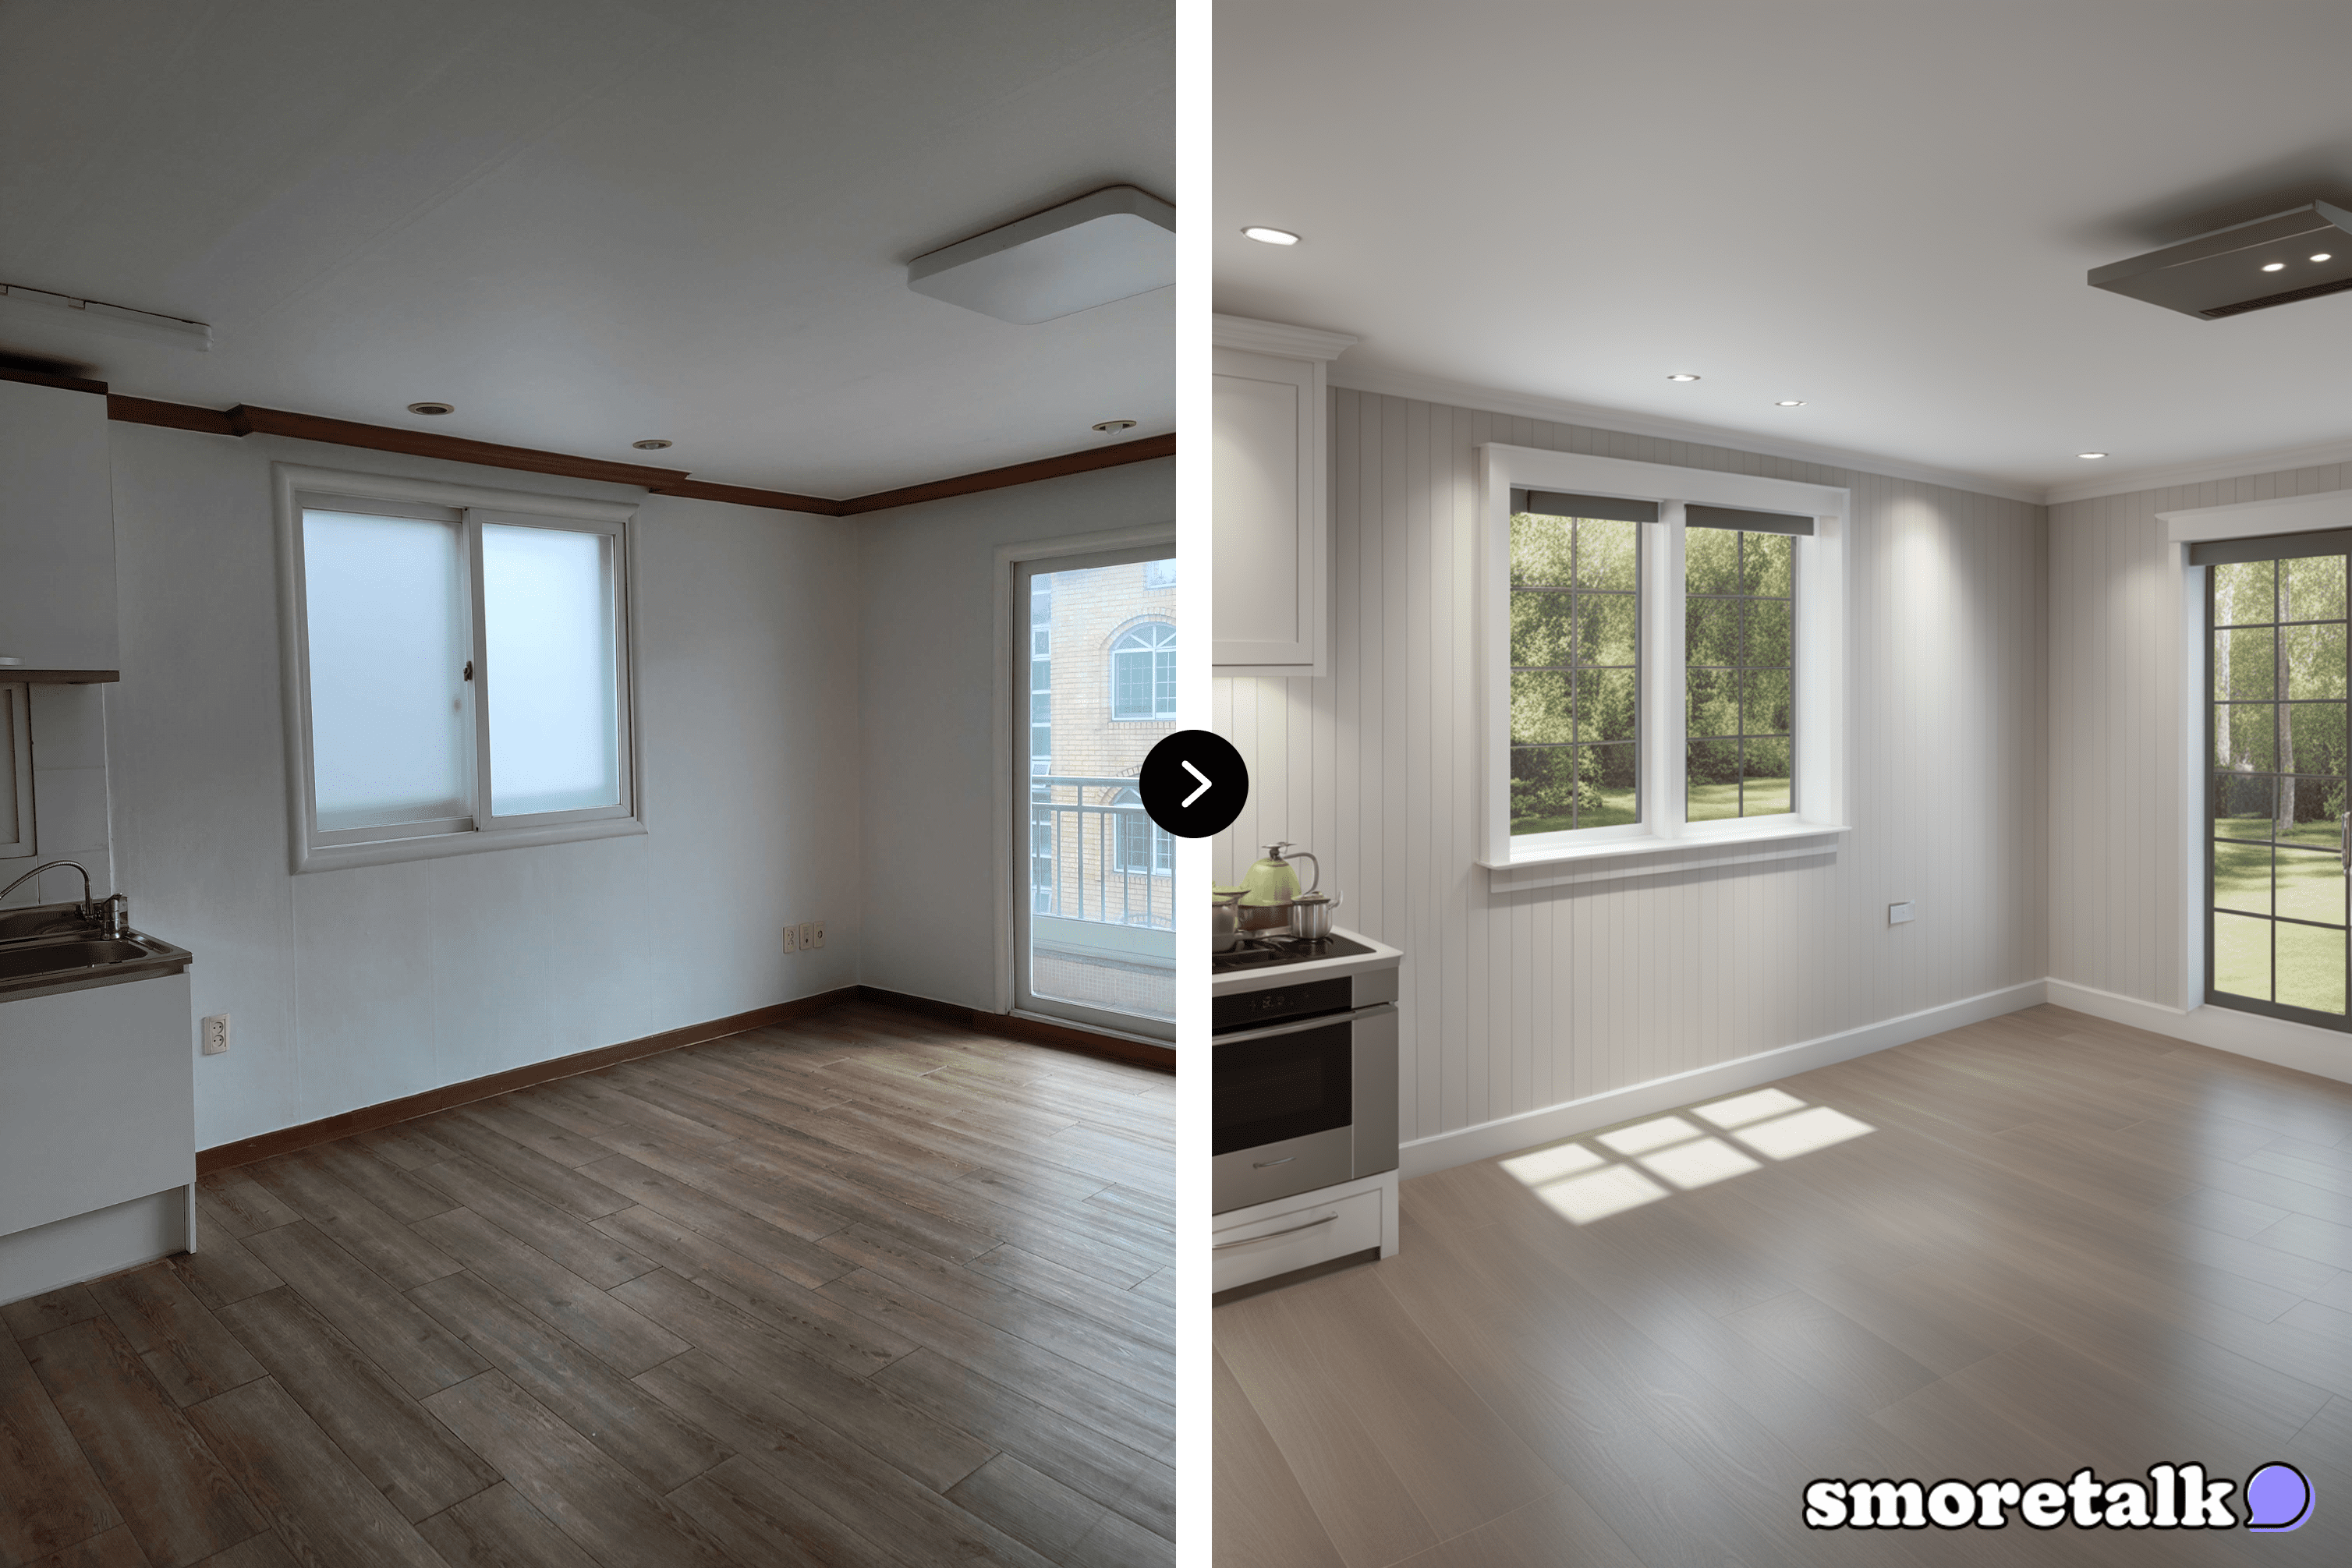
AI와 함께 10초 내로 4개 이상의 시안을 받아 볼 수 있게 되었습니다.
금방 시안을 만든다면, 고객을 설득하는 데 큰 효과가 있지 않을까요?
그래서 국내외에 해당 솔루션을 열심히 개발하는 기업이 존재합니다.
외국에서는,
InteriorAI (by x.com @levelsio, 유명 인디 개발자)
한국에서는,
가 있습니다. (혹시 추가해야 할 기업은 알려주시면 수정하겠습니다)
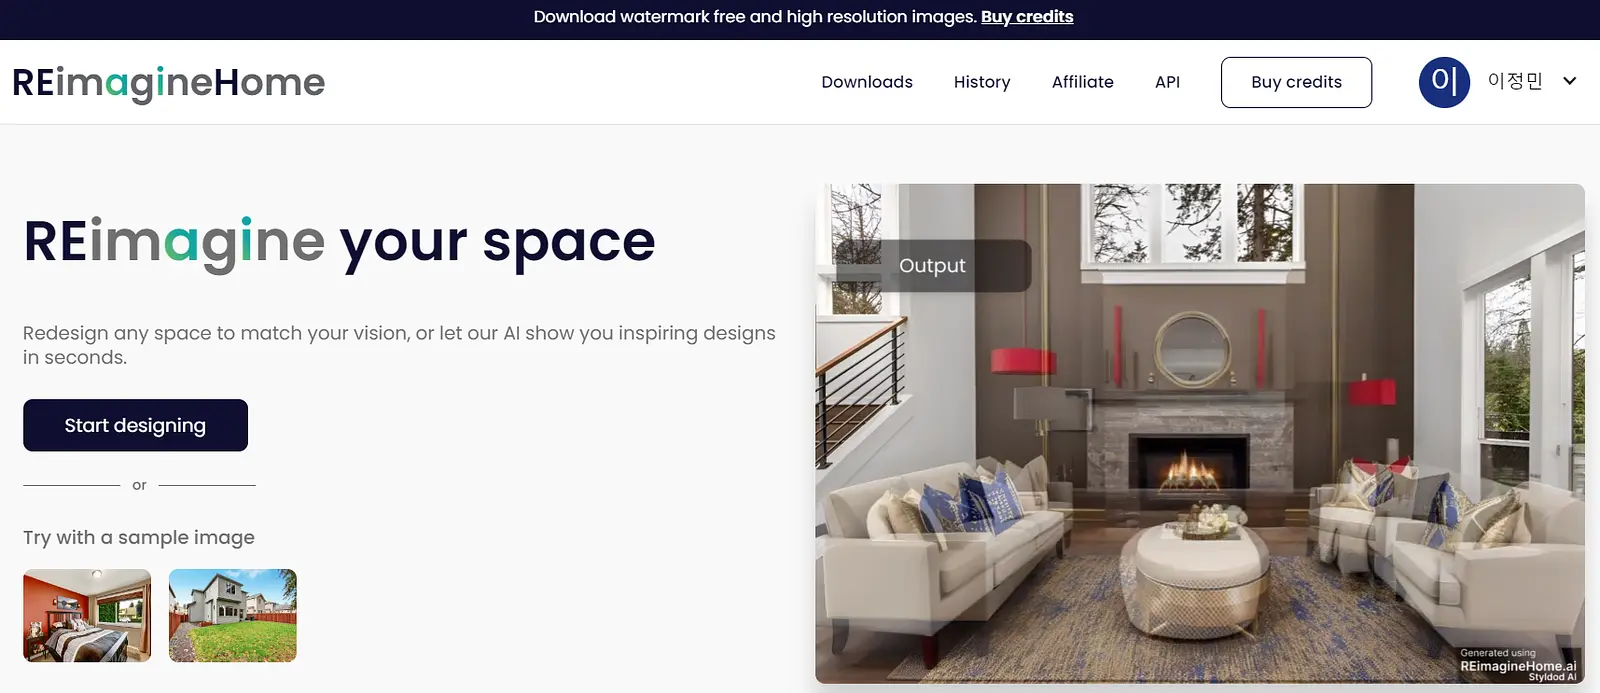
오늘은 그 중 REimagine Home 에 대해 살펴보고, 기능에 대해 실제 코드로 구현해보겠습니다.
(빨리 직접 코드로 만들어보고 싶은 분께서는 아래로 스크롤 해주세요)
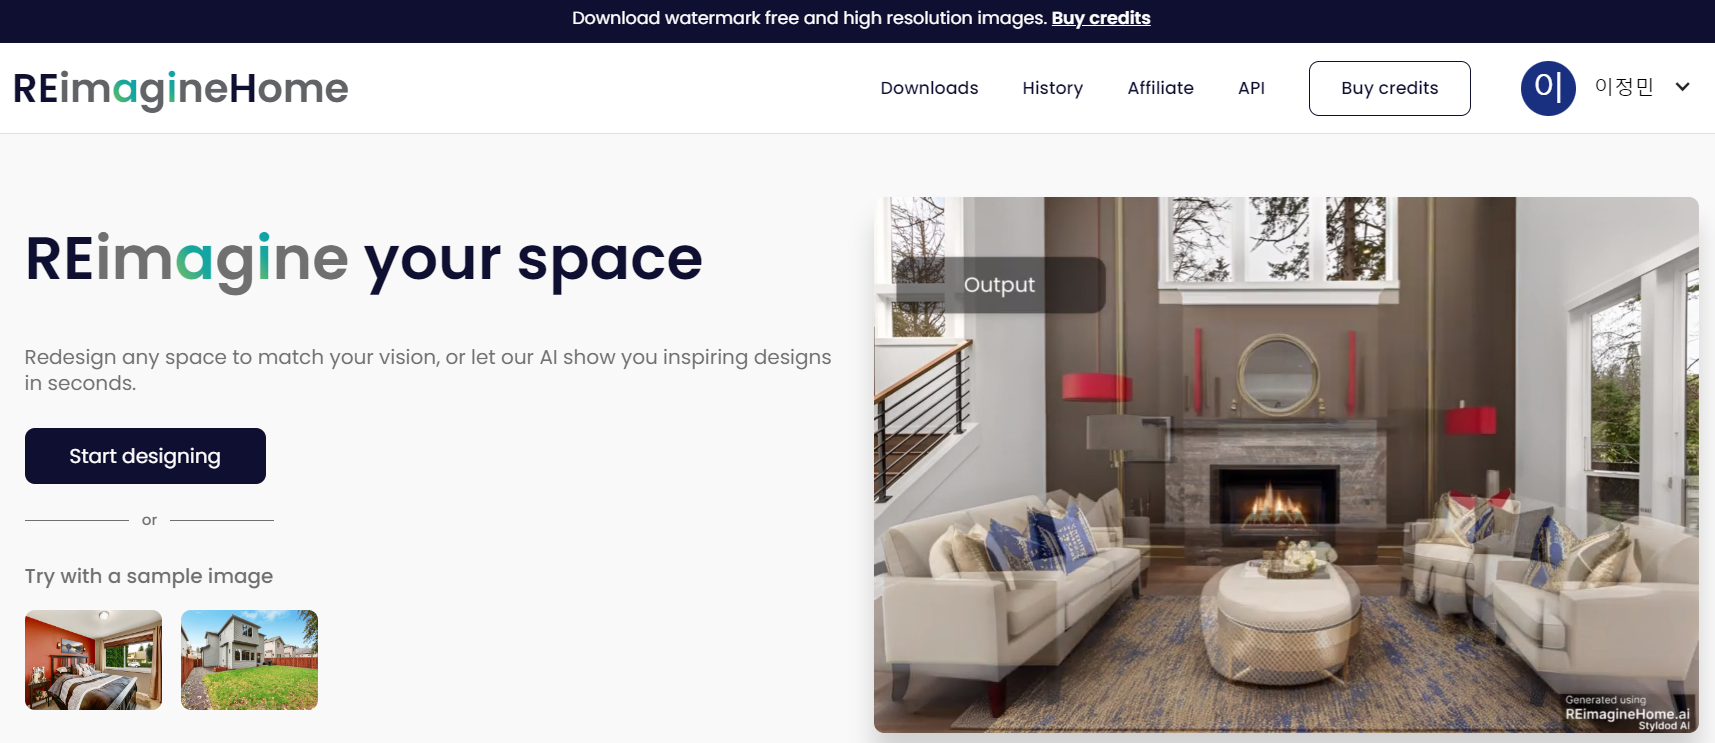
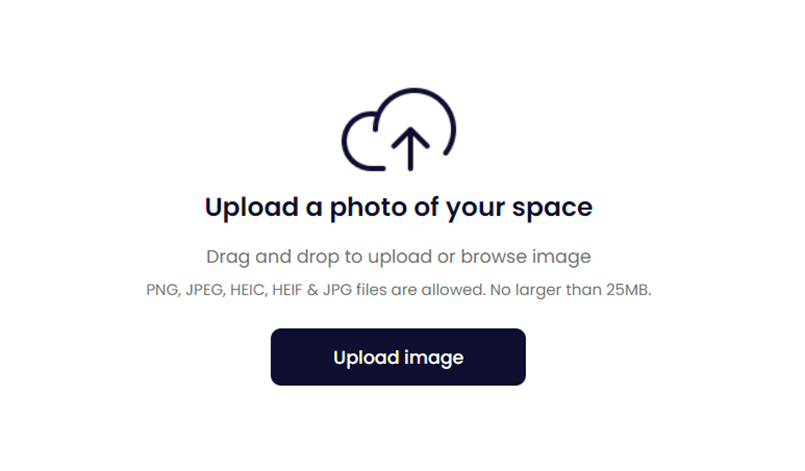
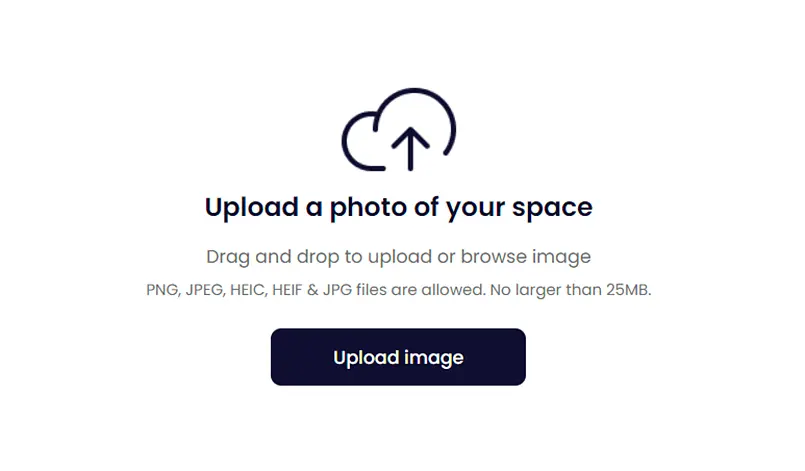
1. 사진 업로드
사진을 업로드 합니다.
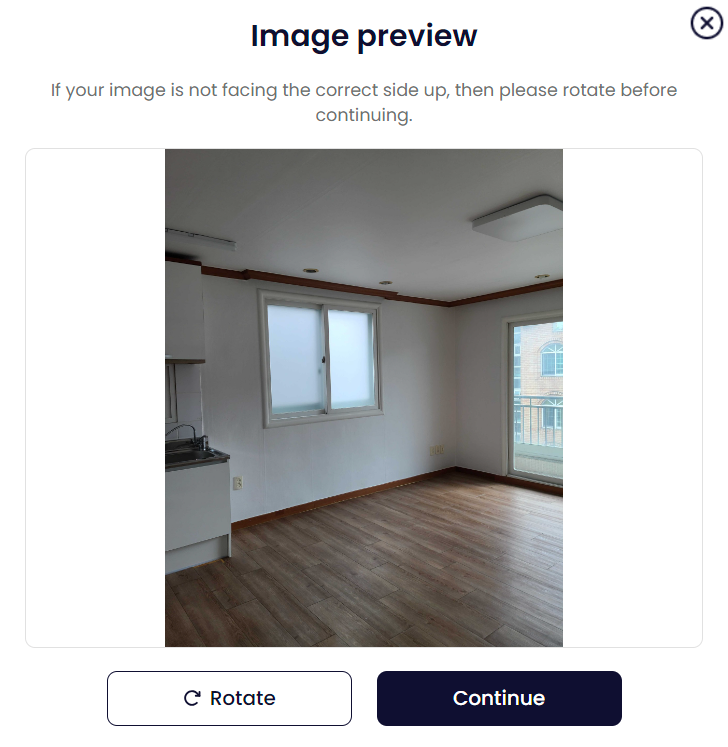
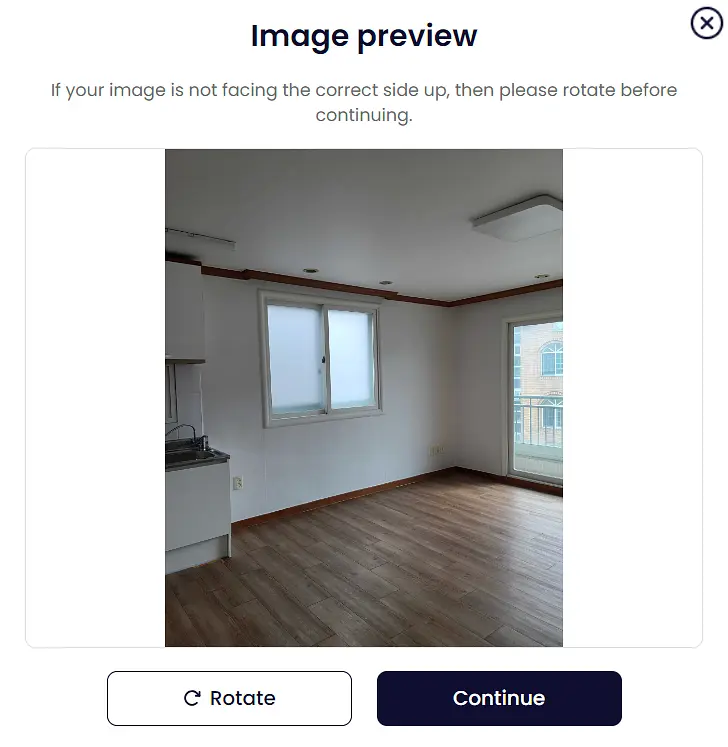
2. 업로드 한 사진 한 번 더 확인
잘못된 구도로 촬영할 시 일부 회전할 수 있도록 한 번 더 확인합니다.
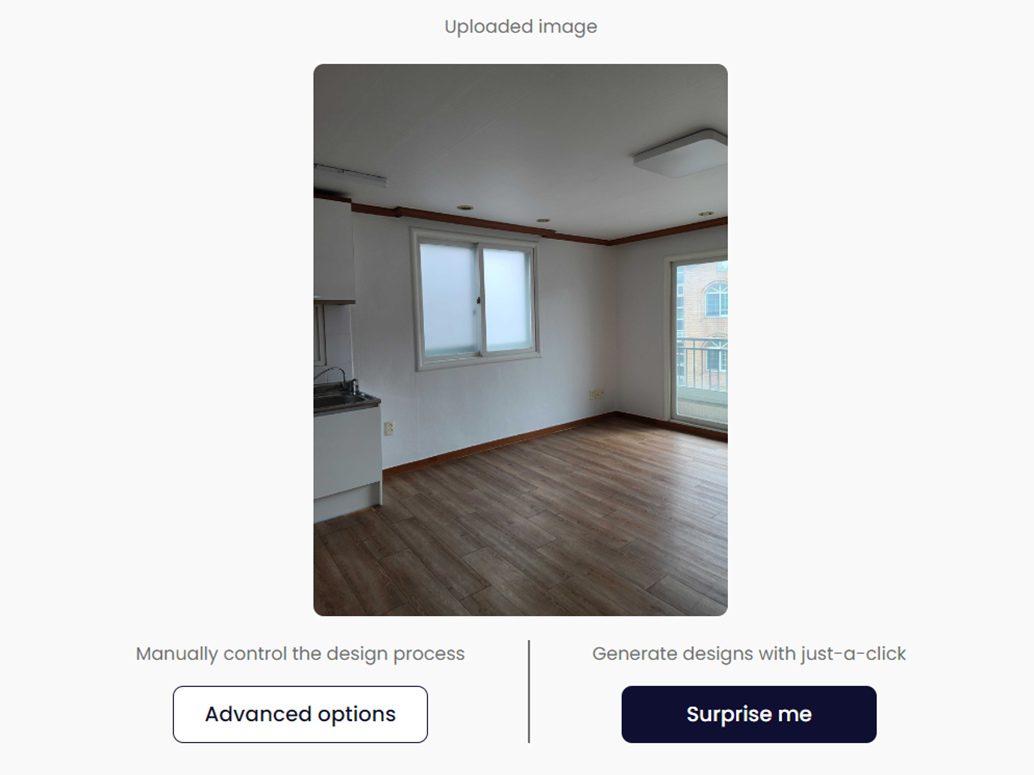
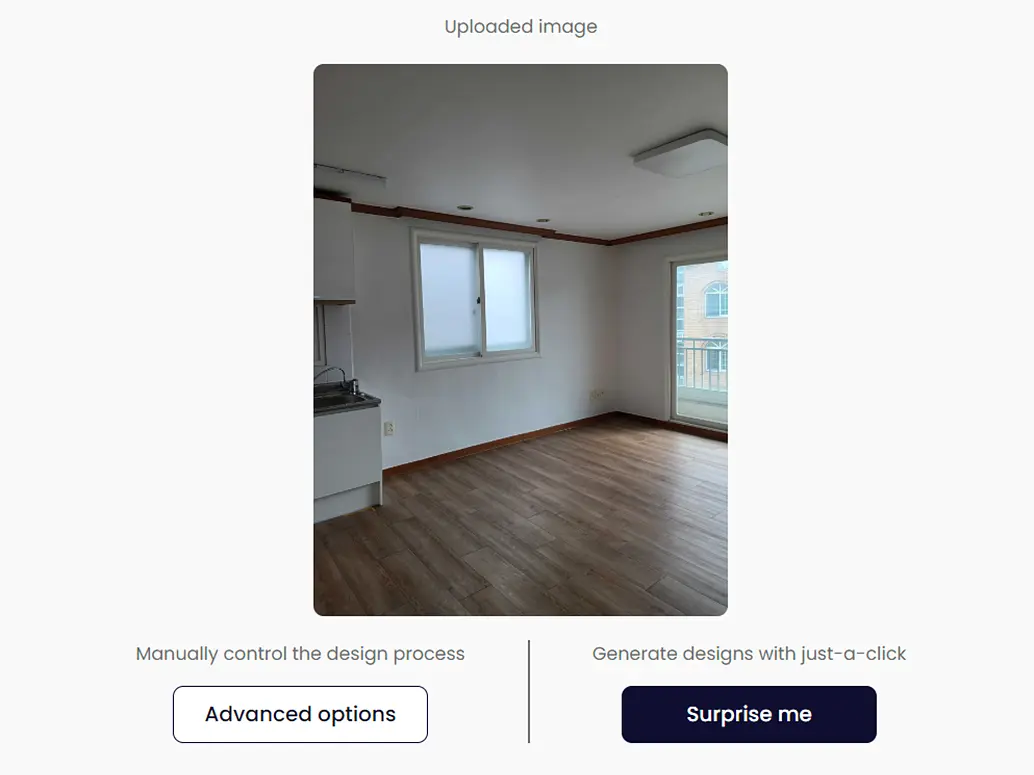
3. 생성 옵션 선택
간편하게 생성할 지 혹은 세부적인 조건을 조정하여 정확하게 생성할 지 선택하게 합니다.
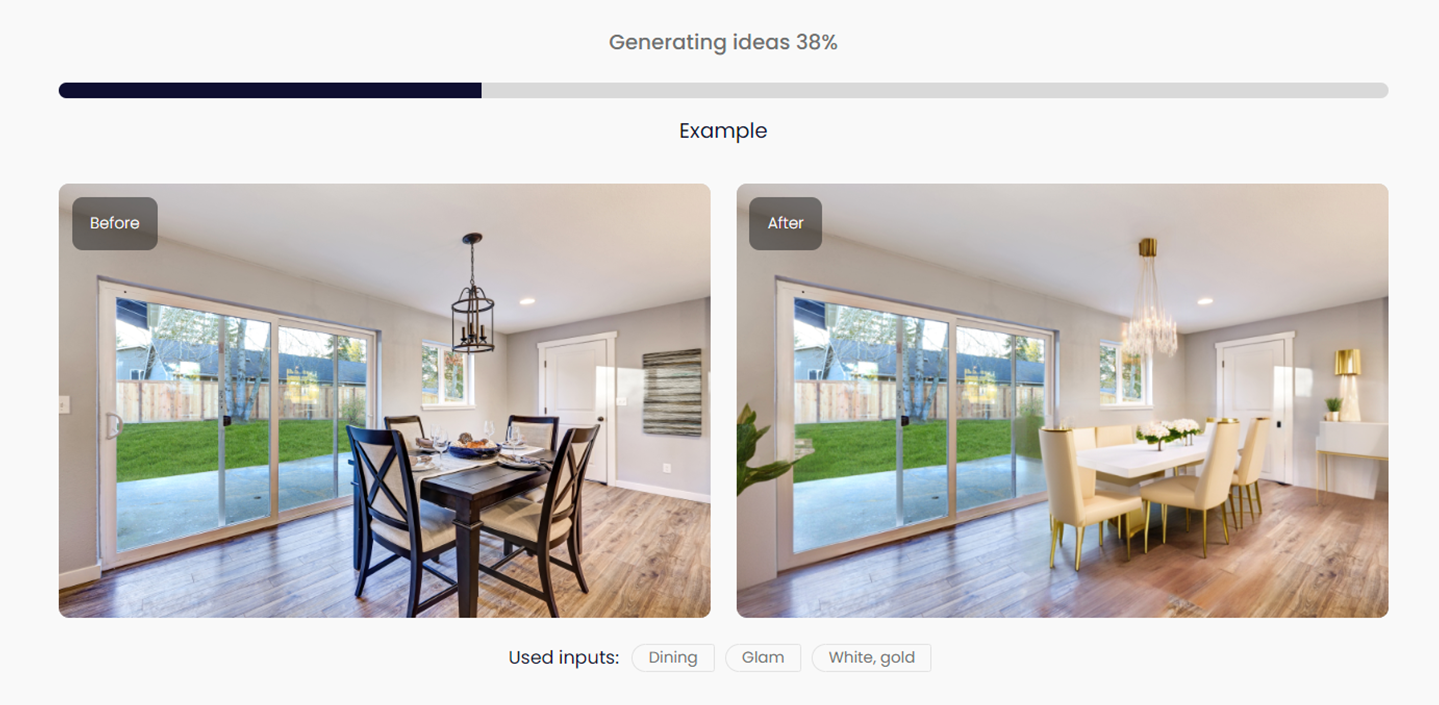
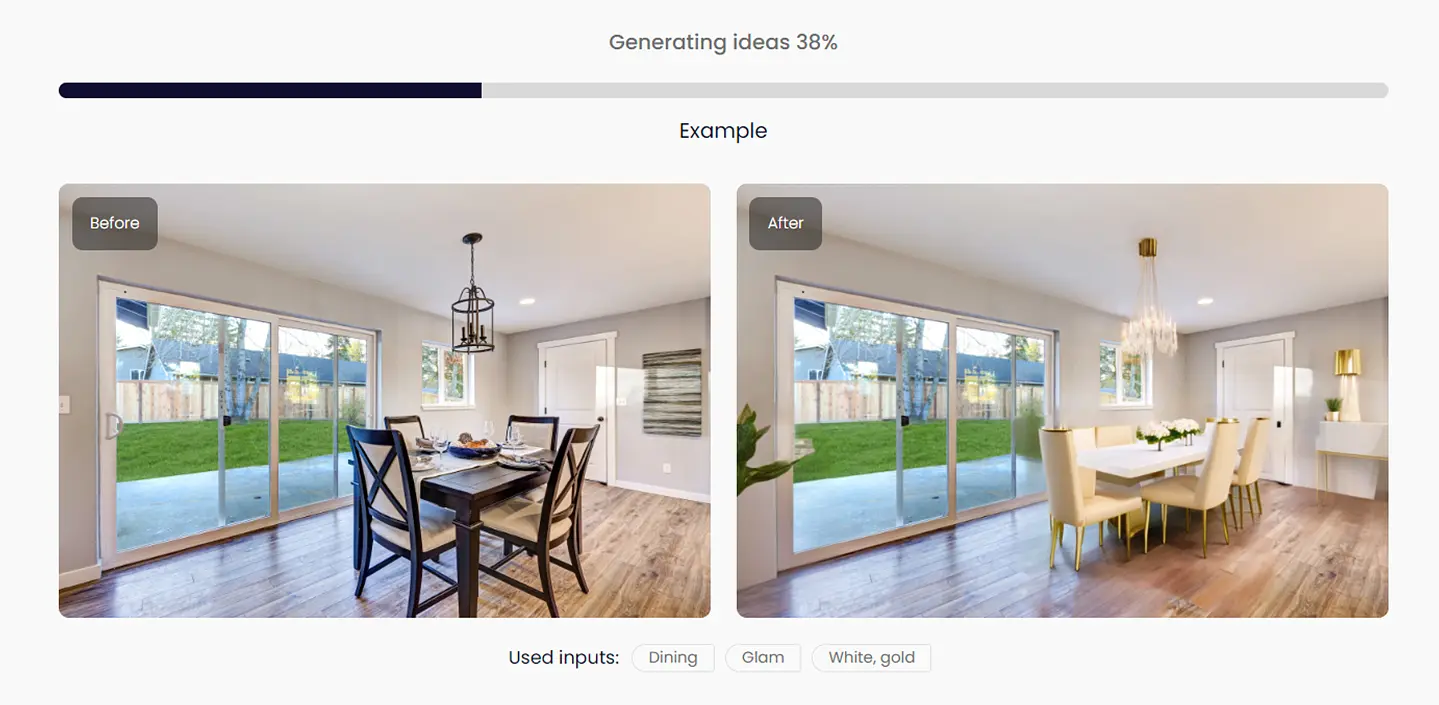
4. 설정 기다리기 (중요💡)
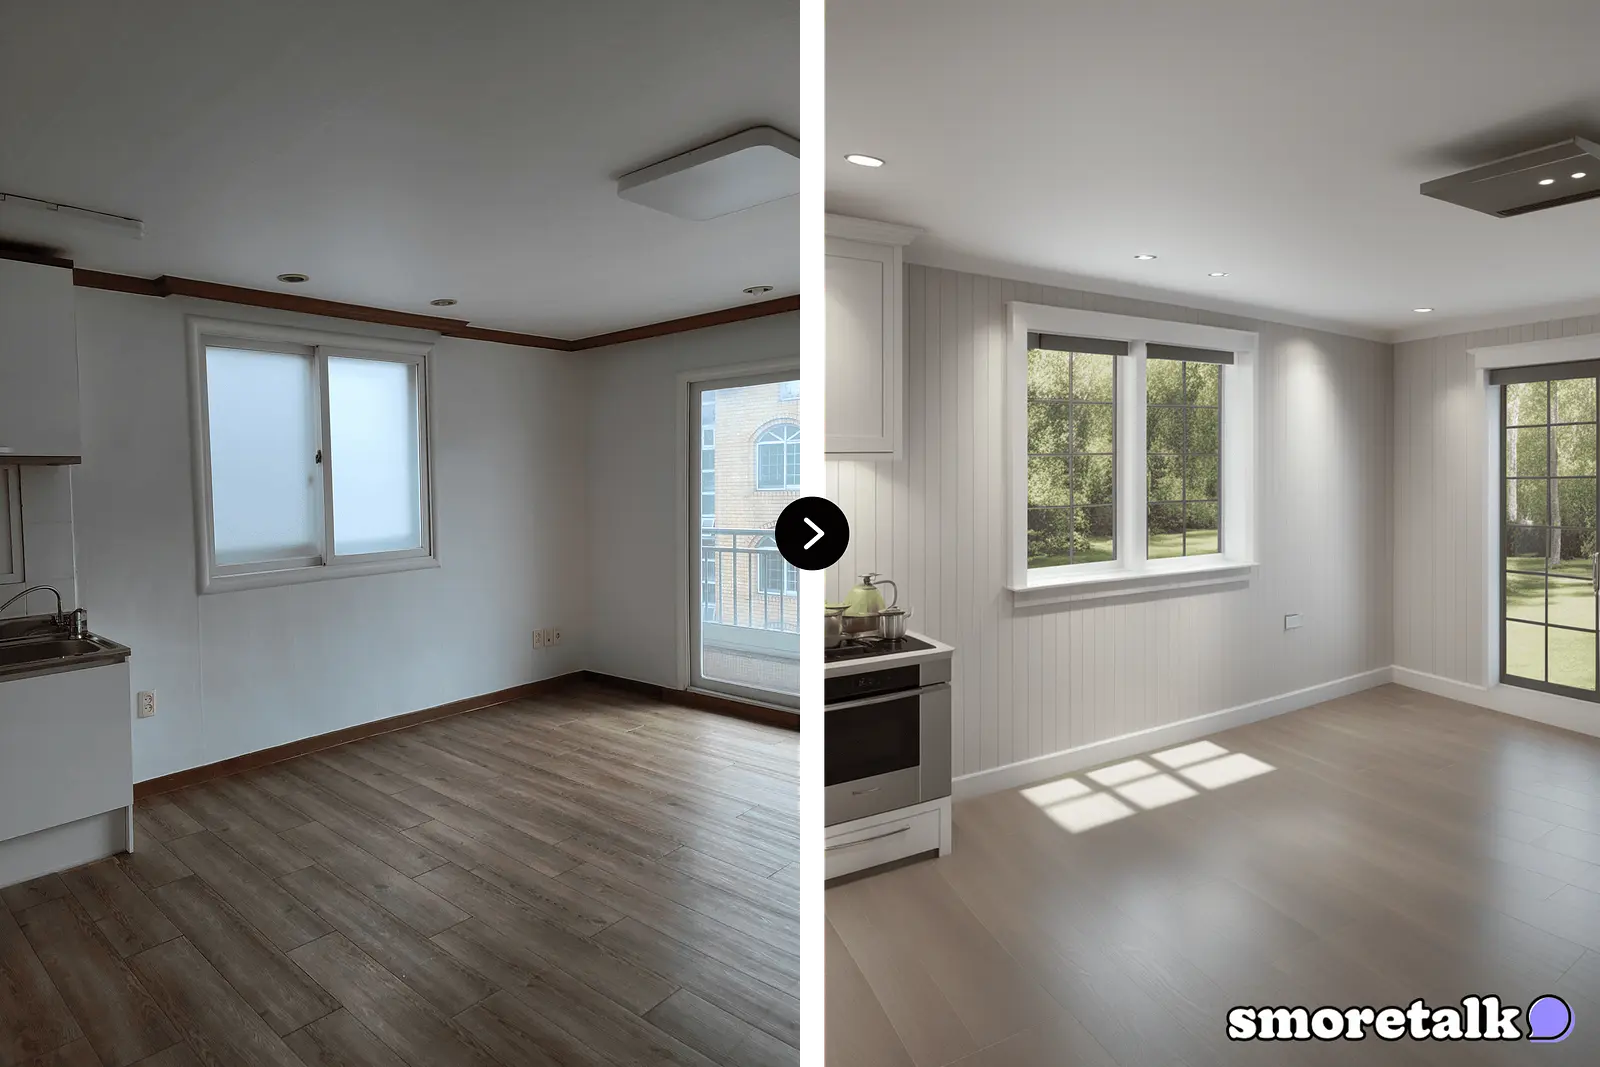
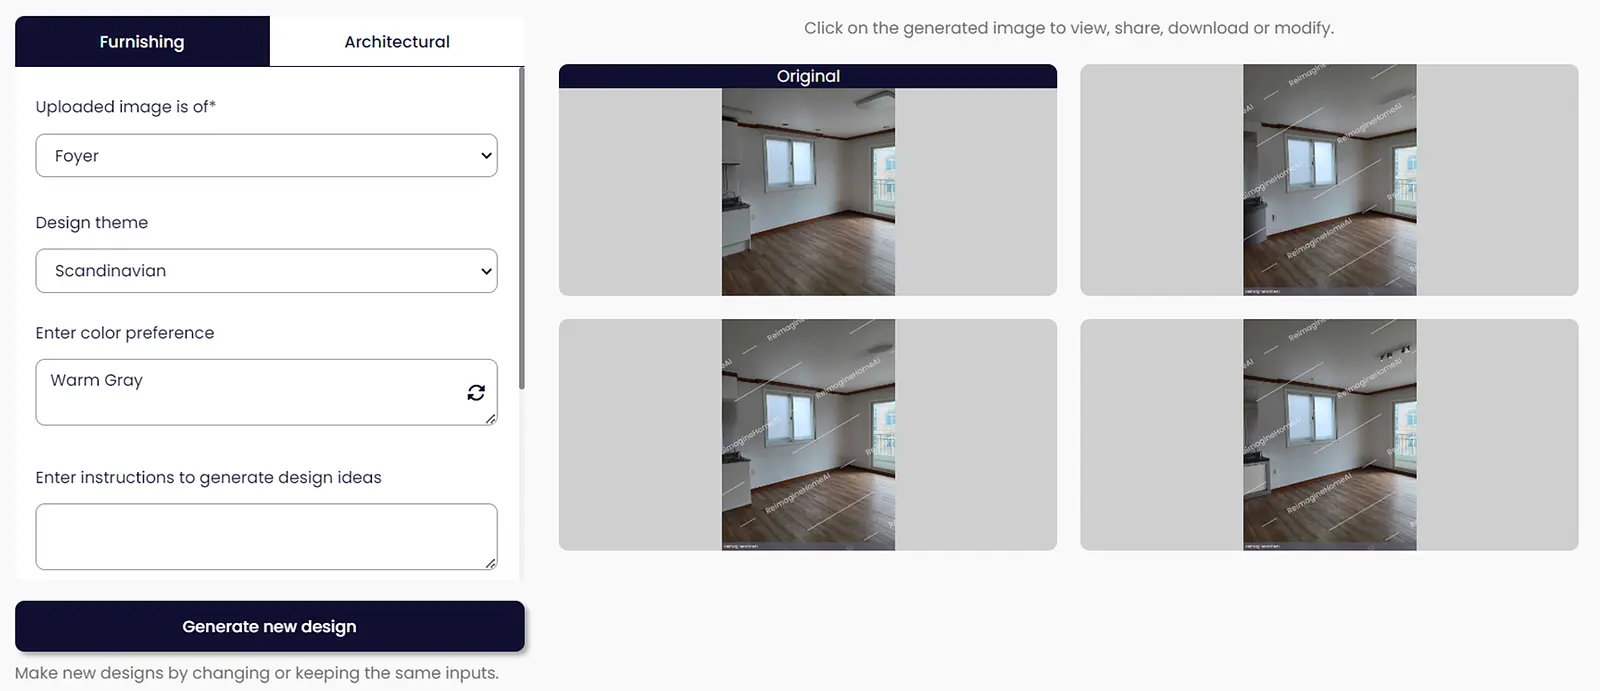
대기 하는 시간 동안 전후 화면을 비교시켜주고, 하단에 어떤 입력 값을 넣는 지 보여줌으로써 사용자의 관심을 유도합니다. 좋은 방식인 것 같더라고요.
5. 생성하기
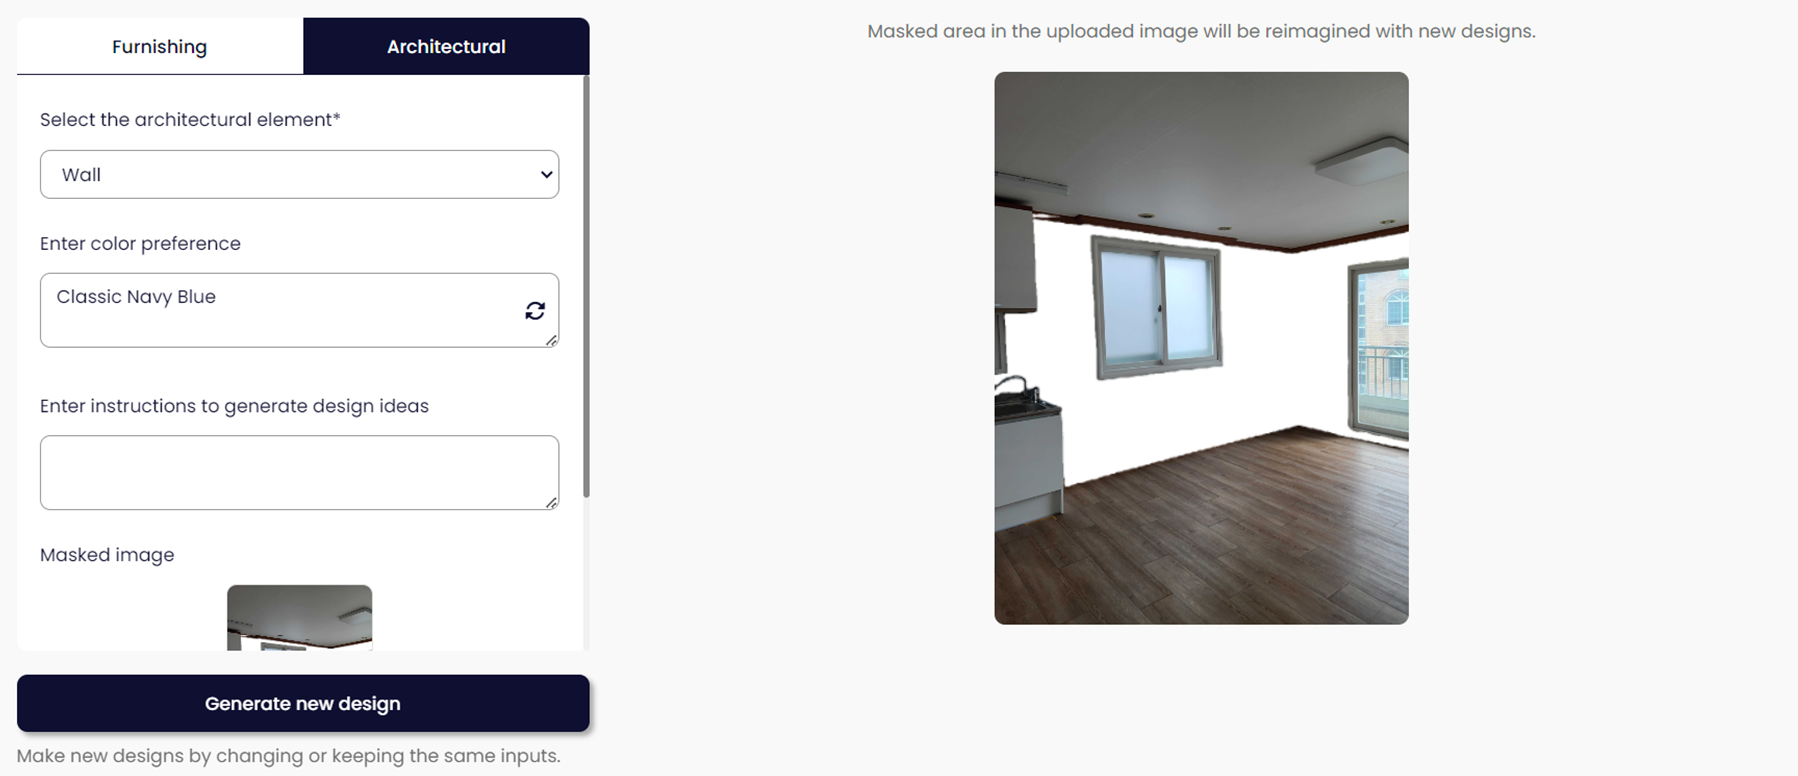
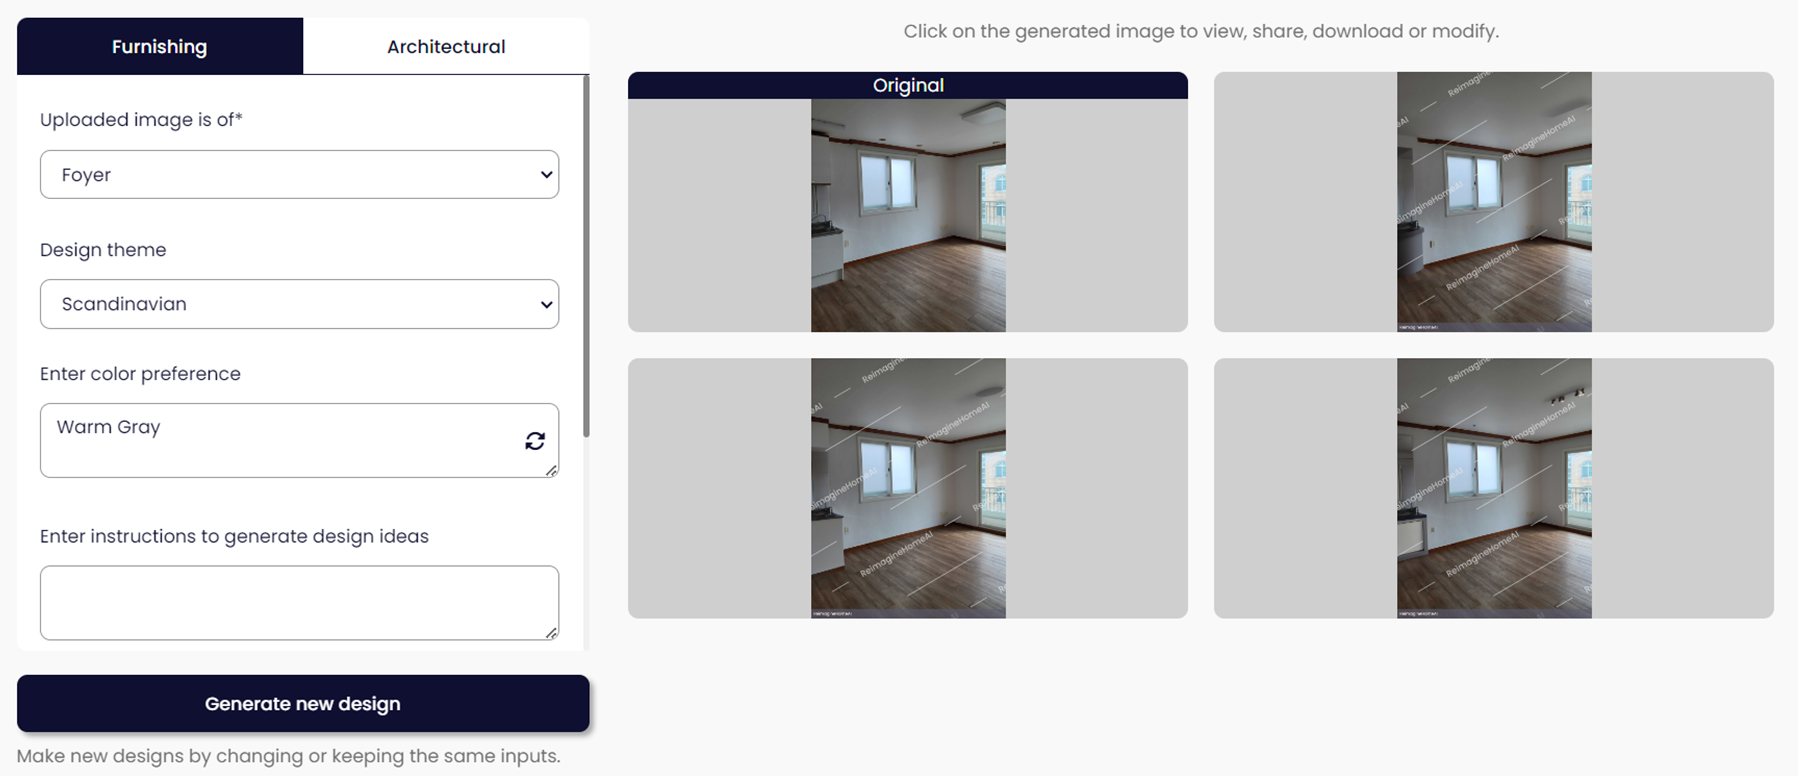
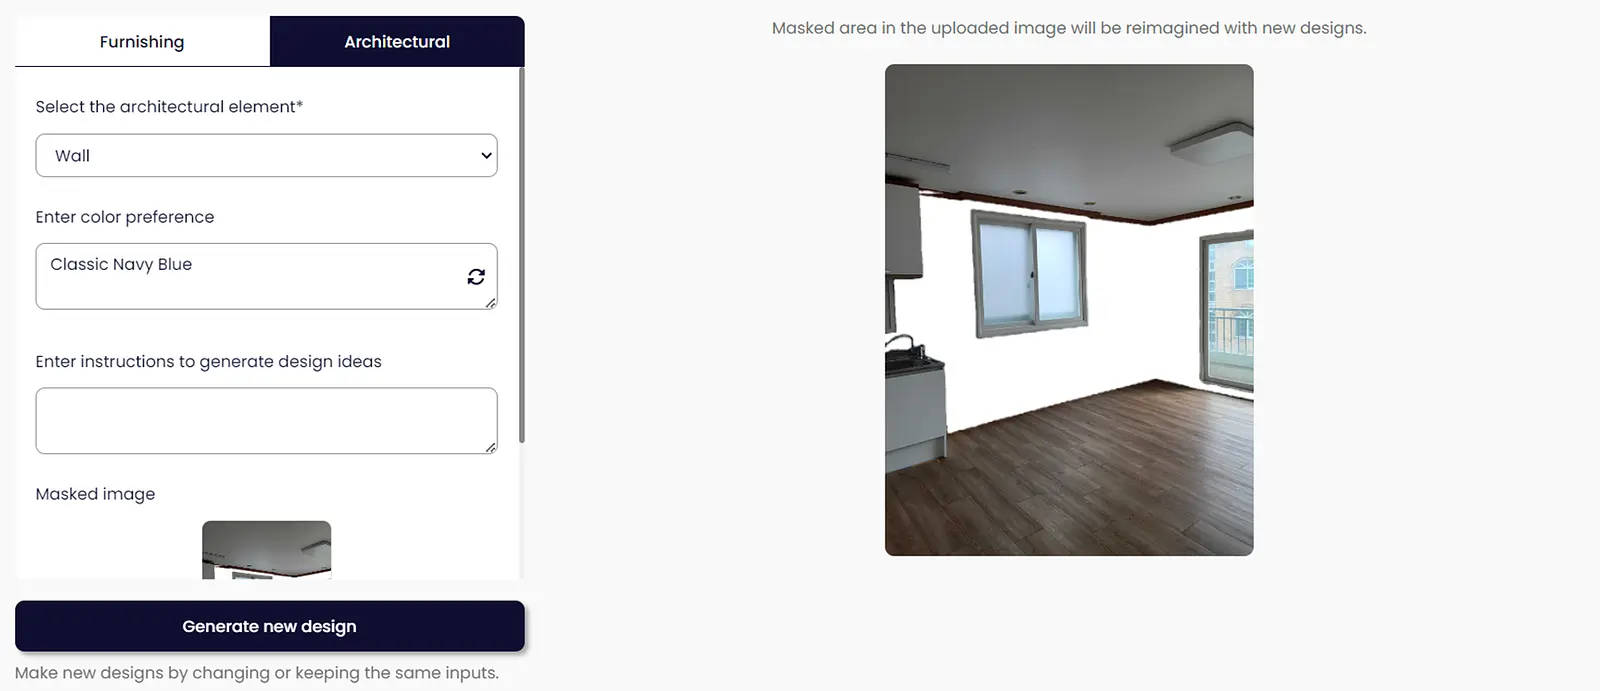
하나는 가구의 재배치를 의미하는 Furnishing, 다른 하나는 실내 구조의 일부를 변경하는 Architectural 입니다.
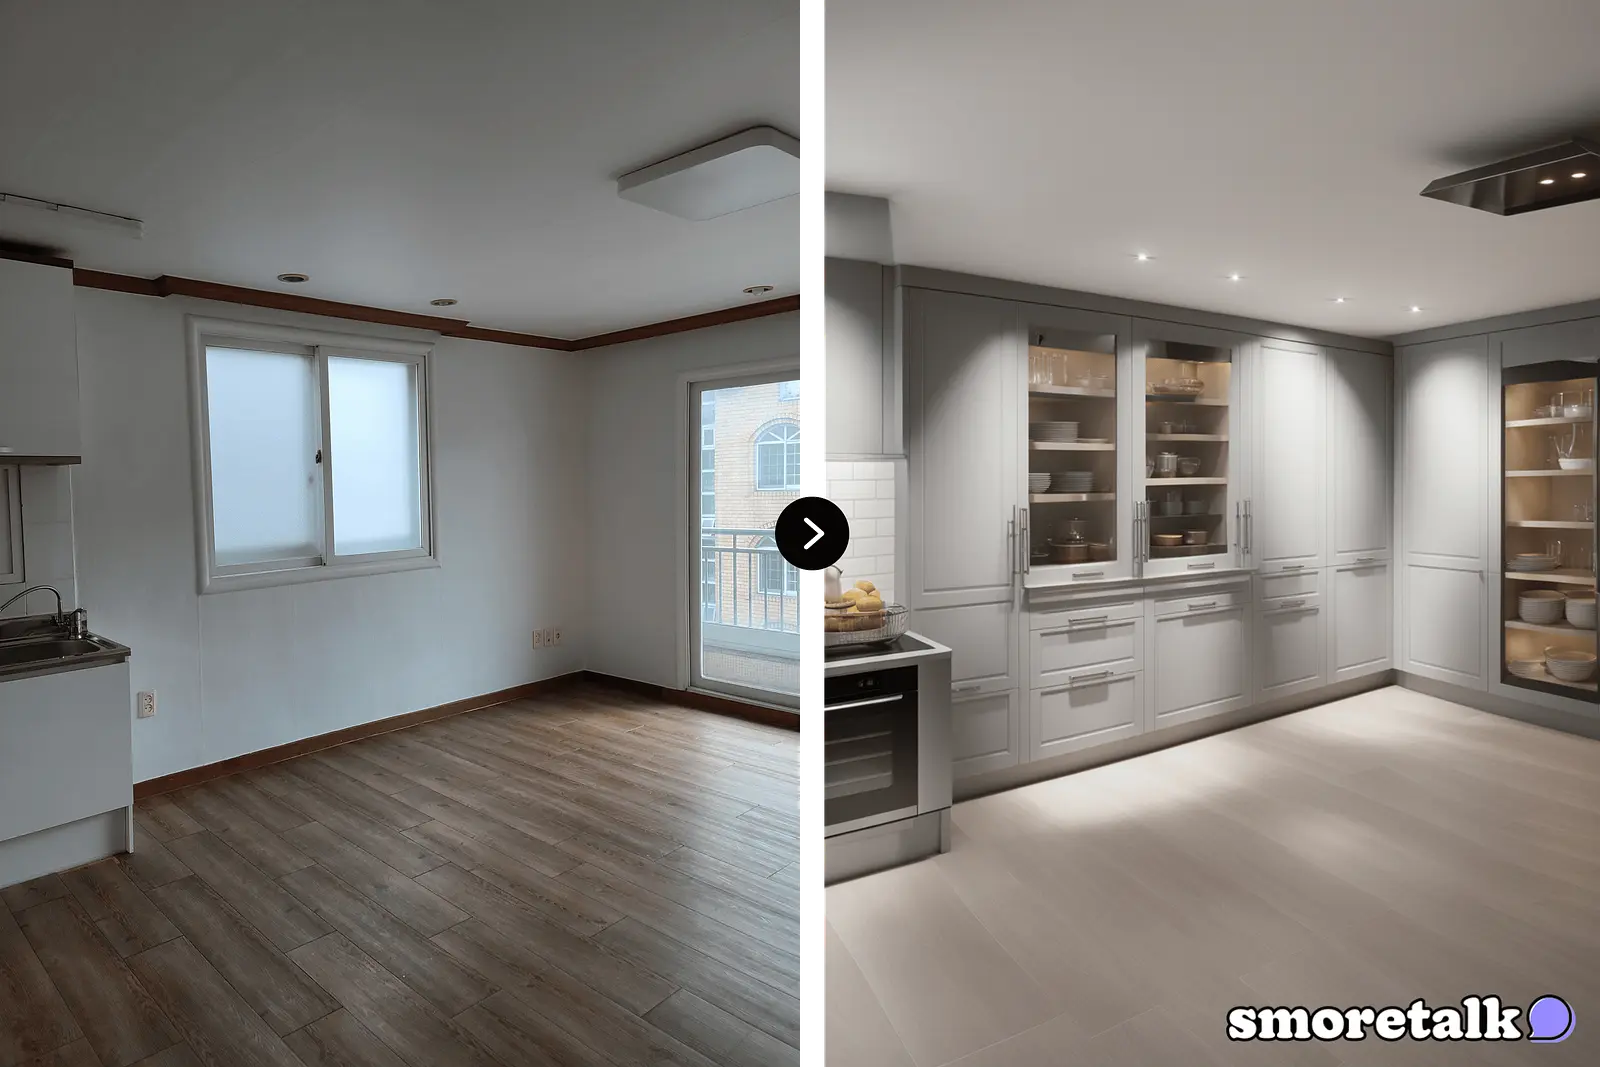
첫 번째, Furnishing 에서는 현재 이미지가 나타내는 장소가 구체적으로 어디인지(거실인지 부엌인지)에 대한 설명을 넣고, 인테리어 테마를 설정합니다. 다음으로 선호하는 색상 톤과 구체적인 지시 사항을 AI에게 안내합니다. (실제 인테리어 디자이너가 고객을 응대하는 과정과 유사하죠?)
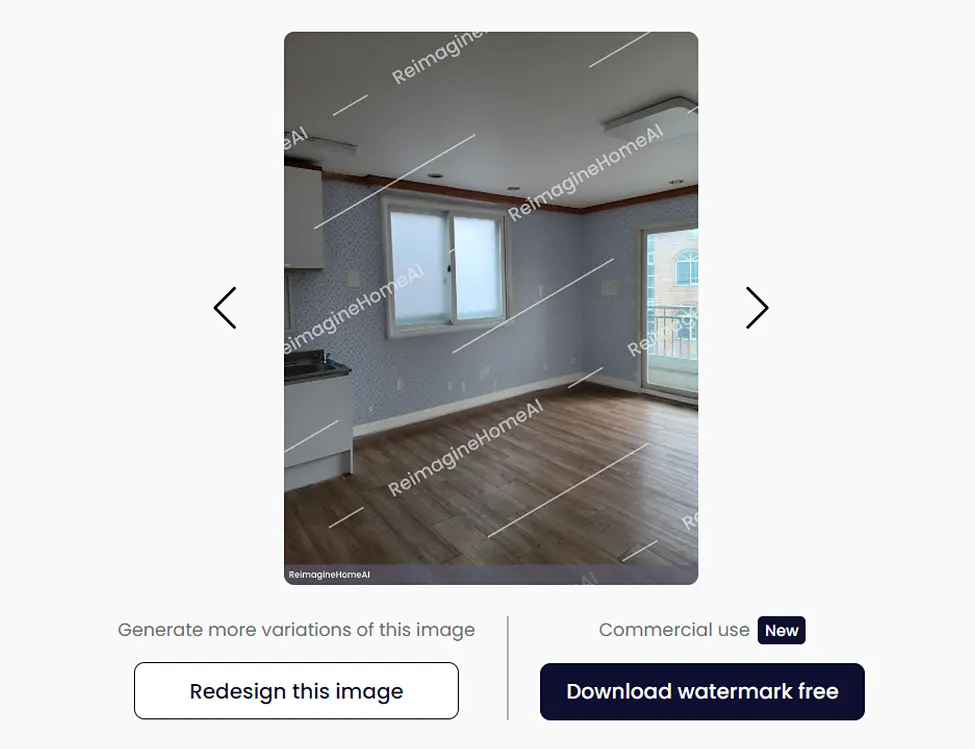
두 번째, Architectural 에서는 현재 이미지의 천장, 벽, 바닥 중 변경을 원하는 것을 선택하여 자동으로 마스킹을 만들고, 선호하는 색상 톤과 구체적인 지시 사항을 AI에게 안내합니다.
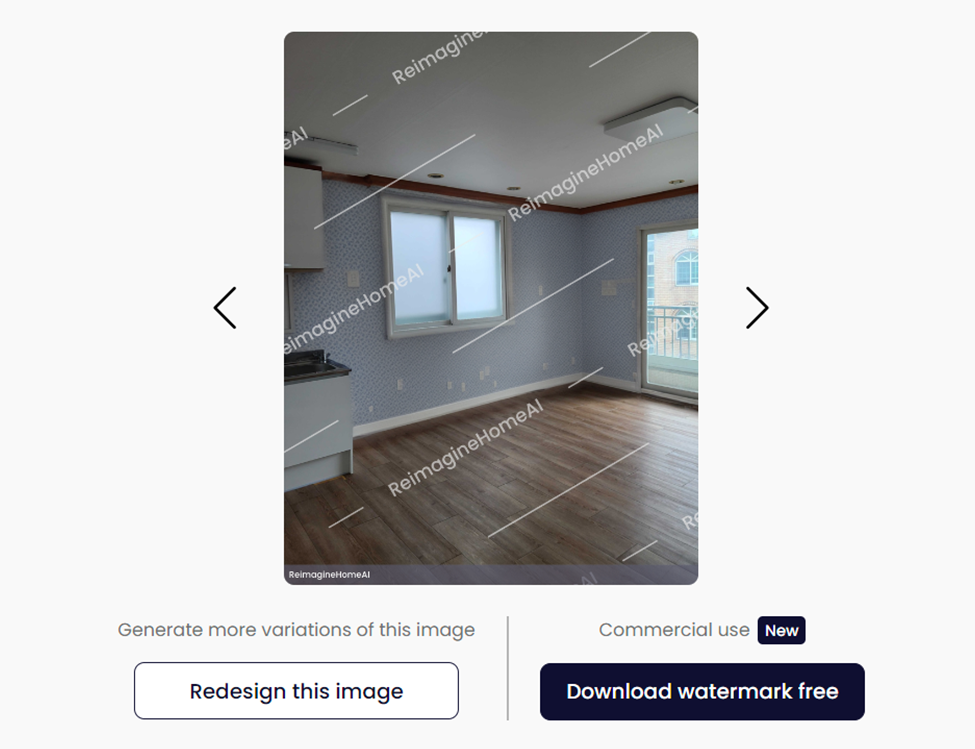
생성을 다하니, 사이트에서는 이제 수고했으니 워터마크를 지우려면 돈을 내지 않겠나...? 라고 말을 합니다.
(저는 제가 만들기 때문에 돈을 안냅...)
과정이 꽤나 간단하지만, UX를 최적화 시켰다는 점이 주목할 만한 것 같습니다.
특히, 구역 별로 오토 마스킹을 해야 한다는 기술적인 설정을 둔 것도 재밌는 포인트라고 생각되었습니다.
실제 인테리어라는 것이 맨 처음 이사할 때를 제외하고는 일부만 변경하기 때문에 이러한 포인트에서 시장 조사가 잘 되었다고 판단했습니다.
그렇다면 직접 만들어 볼 수는 없을까요? 🤔(당연히 핵심이죠?)
이전에 안내해드린 서비스 내 Furnishing 을 구현해볼 예정이며 간단히 설명을 드리겠습니다.
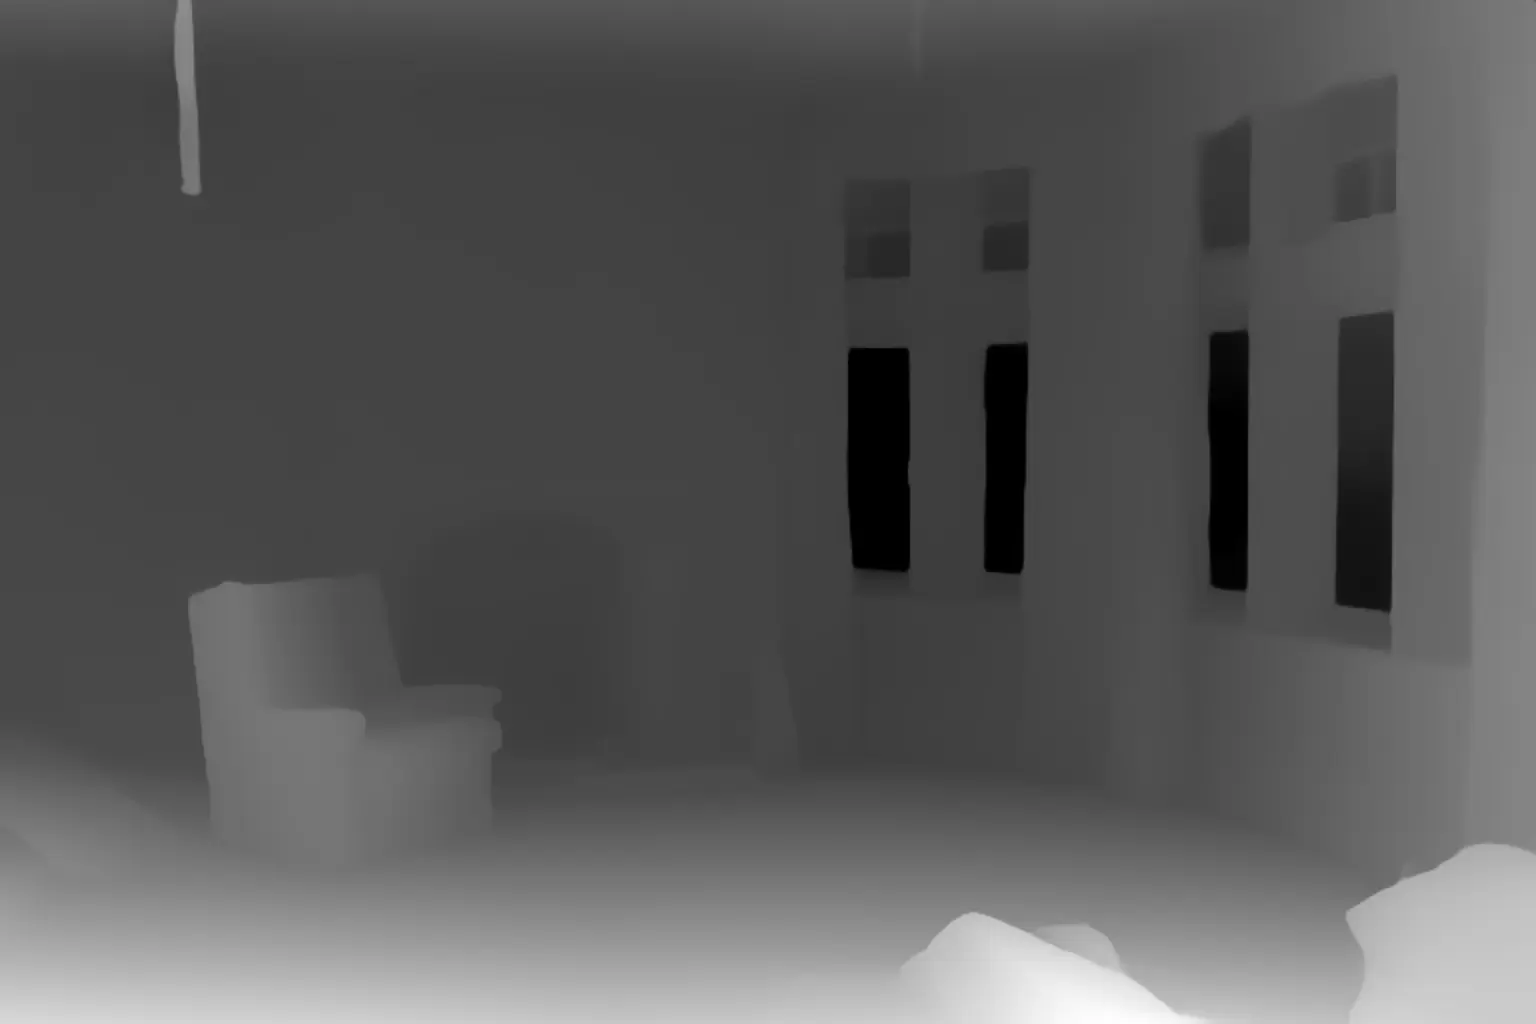
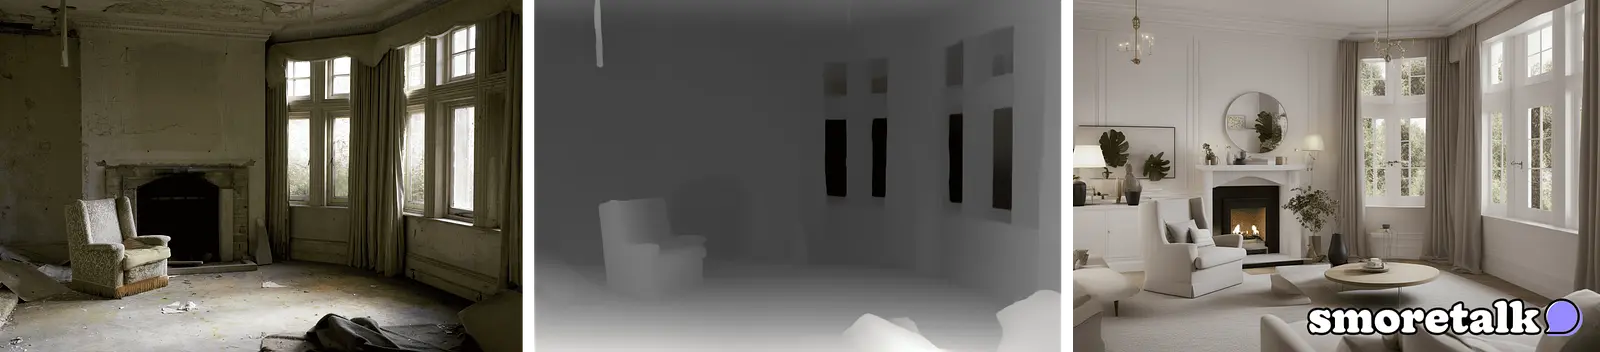
해당 방법은 Embodied AI Foundation 에서 공개한 MiDaS (이미지 내 깊이 측정 모델) 과 Stable Diffusion 의 ControlNet (사전에 주어진 입력값을 통해 생성할 이미지의 형태를 고정) 기능을 활용합니다.
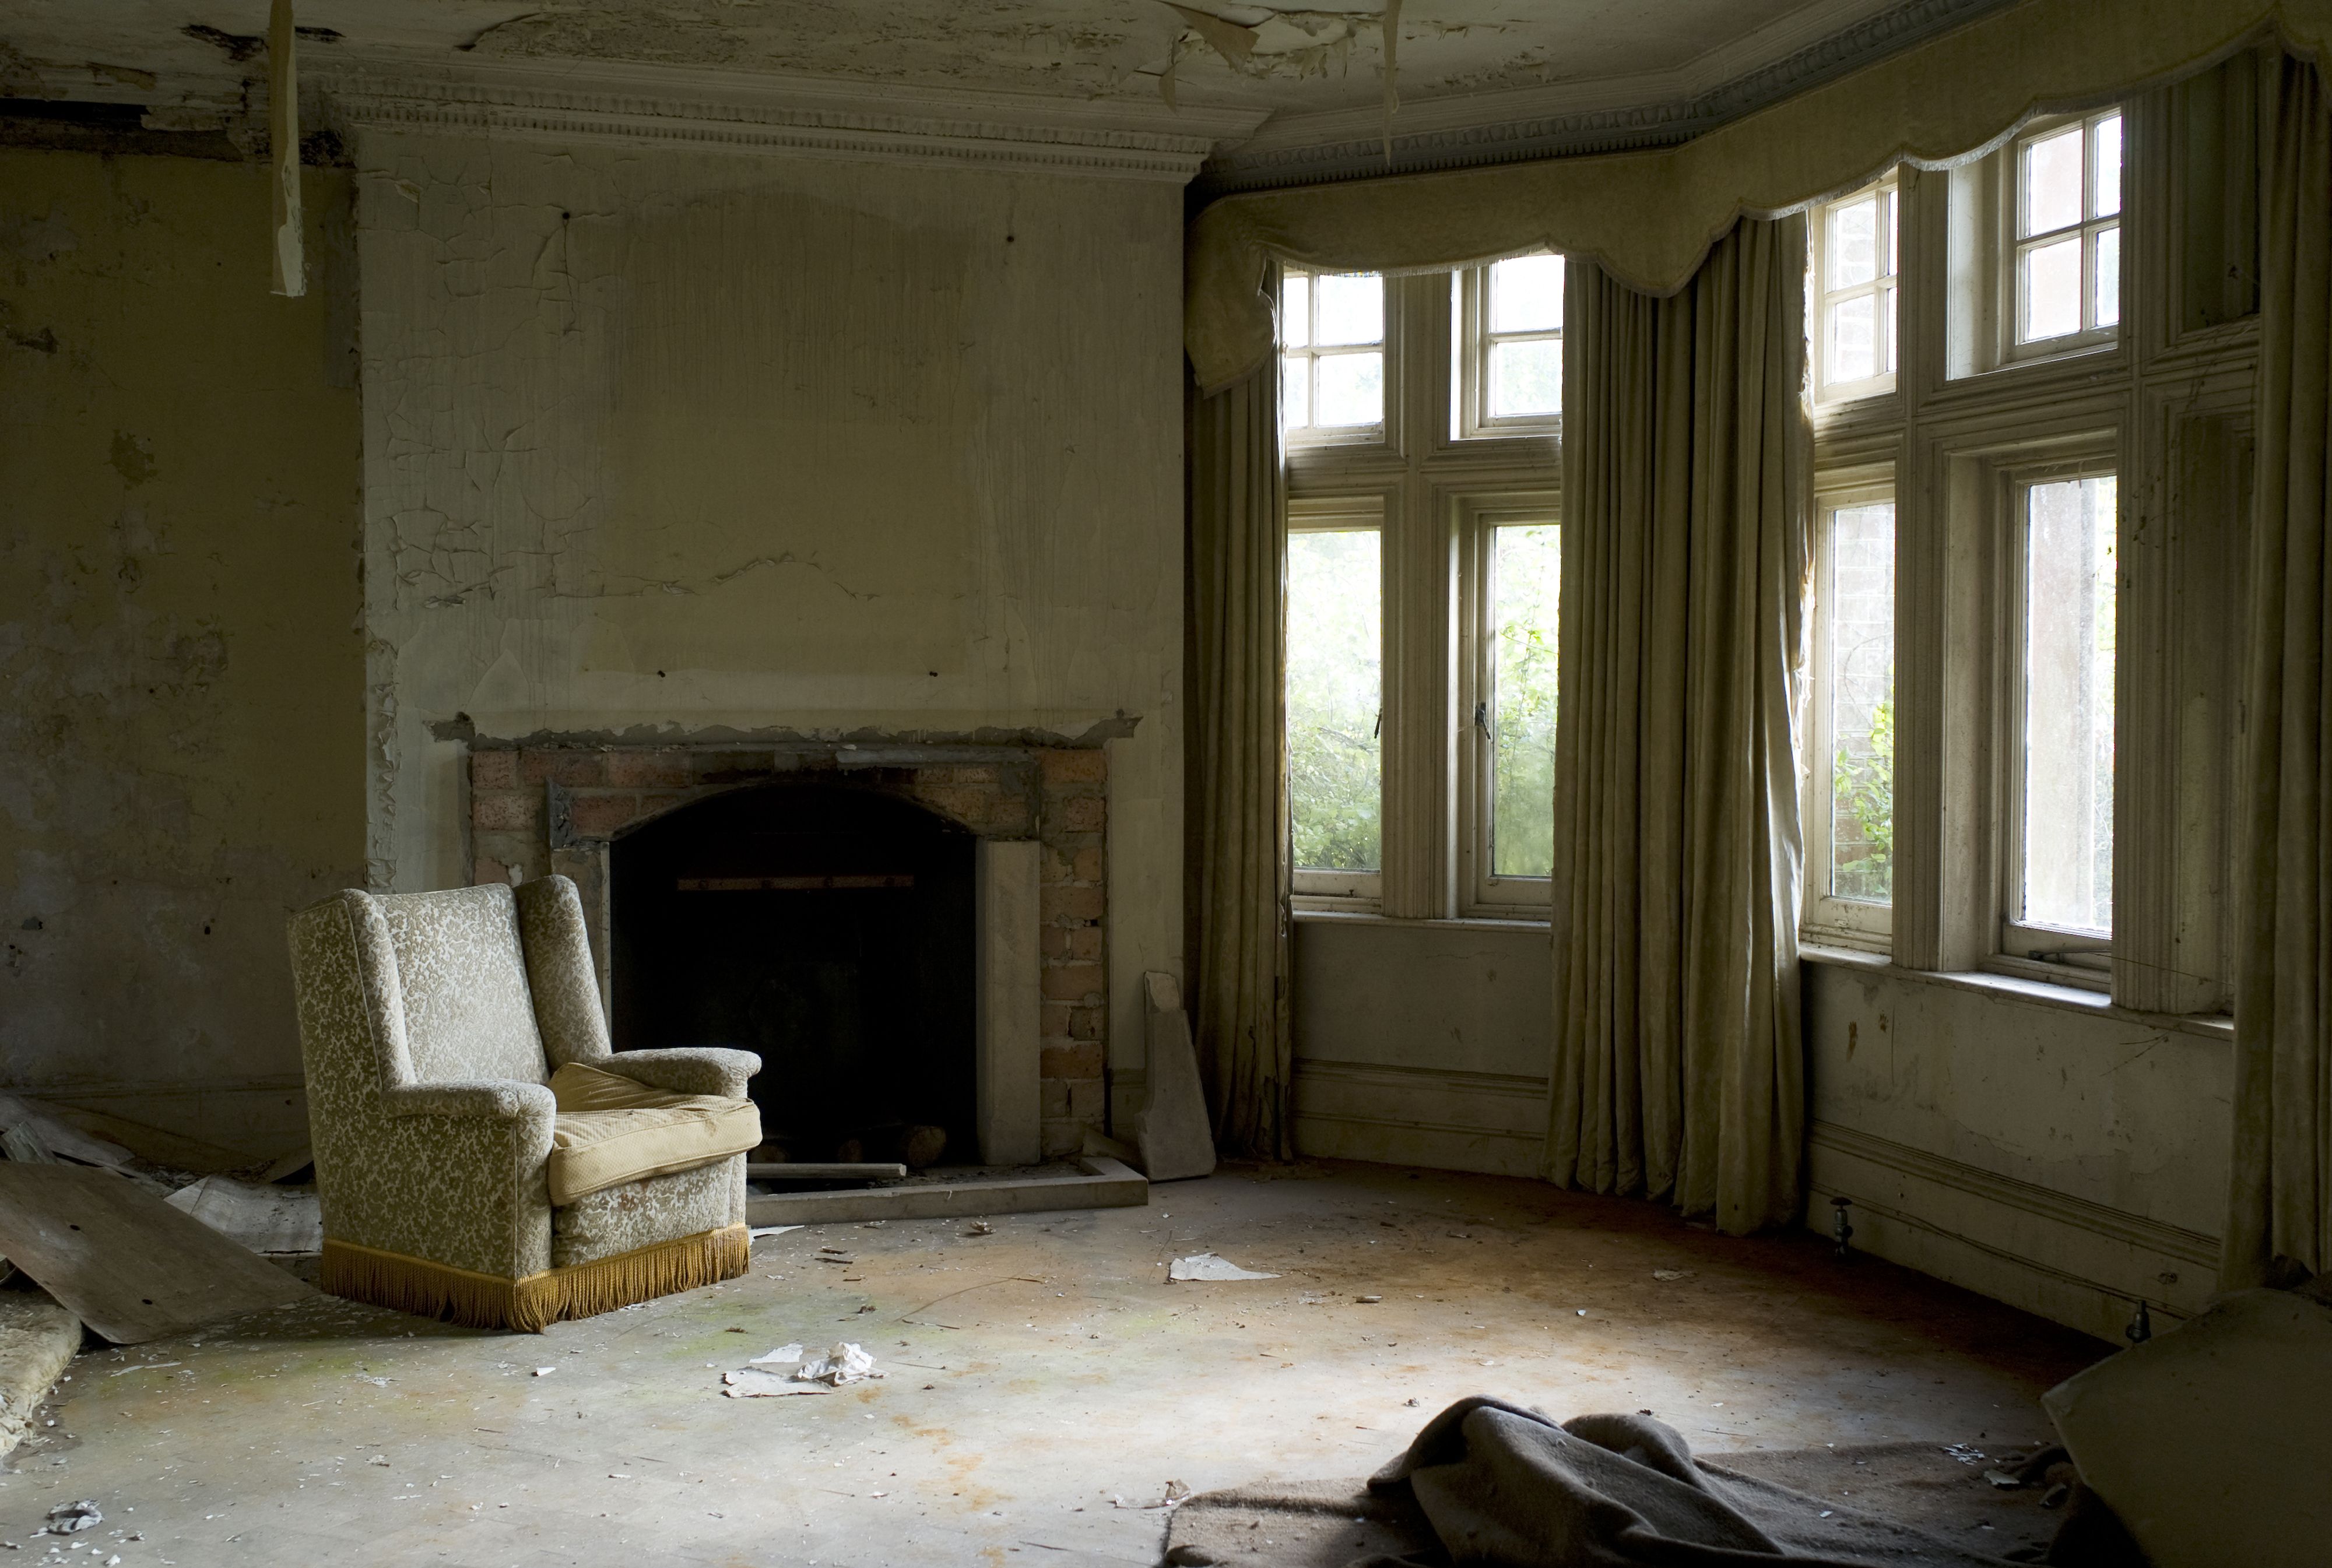
실내 사진 이미지를 준비합니다.
아무거나 인테리어 디자인을 원하는 실내를 찍은 이미지 한 장을 준비합니다.
구글 코랩 (GPU) 을 엽니다.
MiDaS 과 Stable Diffusion 을 사용하기 위해선 GPU 가 필요합니다.
코랩은 클라우드 기반 Jupyter Notebook 환경입니다. 무료로도 사용 가능합니다. (다만 유료로 사용 가능한 V100 이상 부터 사용이 원활합니다)
다음 코드를 입력해주세요.
라이브러리 세팅을 합니다.
라이브러리 설치
# Install libraries

!pip install -q git+https://github.com/huggingface/diffusers.git -U
!pip install controlnet_aux==0.0.7 # for conditioning models and detectors
!pip install -q transformers accelerate -U

# For xformers with correct torch version due to colab update (for memory efficiency)
!pip install -q torch==2.0.0+cu118 torchvision==0.15.1+cu118 torchaudio==2.0.1+cu118 torchtext==0.15.1 torchdata==0.6.0 --extra-index-url https://download.pytorch.org/whl/cu118 -U
!pip install -q xformers==0.0.19 triton==2.0.0 -U
라이브러리 추가
# Set the Generator and the MiDaS Detector

import torch
import numpy as np
from PIL import Image
from controlnet_aux import MidasDetector
from diffusers import AutoencoderKL, DDIMScheduler, StableDiffusionXLAdapterPipeline, T2IAdapter, DiffusionPipeline
from diffusers.utils import load_image, make_image_grid
AI 모델을 GPU 에 설정합니다.
여기에서 중요한 부분은 본 코드에서는 이미지 내 디테일한 표현을 강화하는 LoRA 가중치를 추가해주었기 때문에, 사용자 입력값인 prompt 앞에 'detail_' 을 추가해주어야 합니다.
# load adapter
adapter = T2IAdapter.from_pretrained(
    "TencentARC/t2i-adapter-depth-midas-sdxl-1.0", torch_dtype=torch.float16, variant="fp16"
).to("cuda")

# load scheduler
model_id = "stabilityai/stable-diffusion-xl-base-1.0" # Base model

ddim = DDIMScheduler(
    num_train_timesteps=1000,
    beta_start=0.00085,
    beta_end=0.012,
    beta_schedule="scaled_linear",
    clip_sample=False,
    set_alpha_to_one=False,
    steps_offset=1,
)

# load vae
vae = AutoencoderKL.from_pretrained(
    "madebyollin/sdxl-vae-fp16-fix", torch_dtype=torch.float16
)

# load base for sdxl
pipe = StableDiffusionXLAdapterPipeline.from_pretrained(
    model_id,
    vae=vae,
    adapter=adapter,
    scheduler=ddim,
    torch_dtype=torch.float16,
    variant="fp16",
    use_safetensors=True
).to("cuda")

# save memory and improve inference speed
pipe.enable_xformers_memory_efficient_attention()

# set lora for detailed image
pipe.load_lora_weights("jyoung105/detail-tweaker-XL-lora", weight_name="add-detail-xl.safetensors", adapter_name="detail")
#pipe.set_adapters("detail")

# load MidaS detector
midas_detector = MidasDetector.from_pretrained("lllyasviel/Annotators").to("cuda")

# load refiner for sdxl
refiner_id = "stabilityai/stable-diffusion-xl-refiner-1.0"
refiner = DiffusionPipeline.from_pretrained(
    refiner_id, vae=vae, torch_dtype=torch.float16, variant="fp16", use_safetensors=True)
refiner.to("cuda")

# save memory and improve inference speed
refiner.enable_xformers_memory_efficient_attention()
원래 이미지에서 MiDaS를 통해 Depth 이미지를 추출합니다.
image = load_image(url) #IMPORTANT! url is from your image
midas_image = midas_detector(image, detect_resolution=512, image_resolution=1024)
midas_image = np.array(midas_image)[:, :, ::-1]
midas_image = Image.fromarray(np.uint8(midas_image))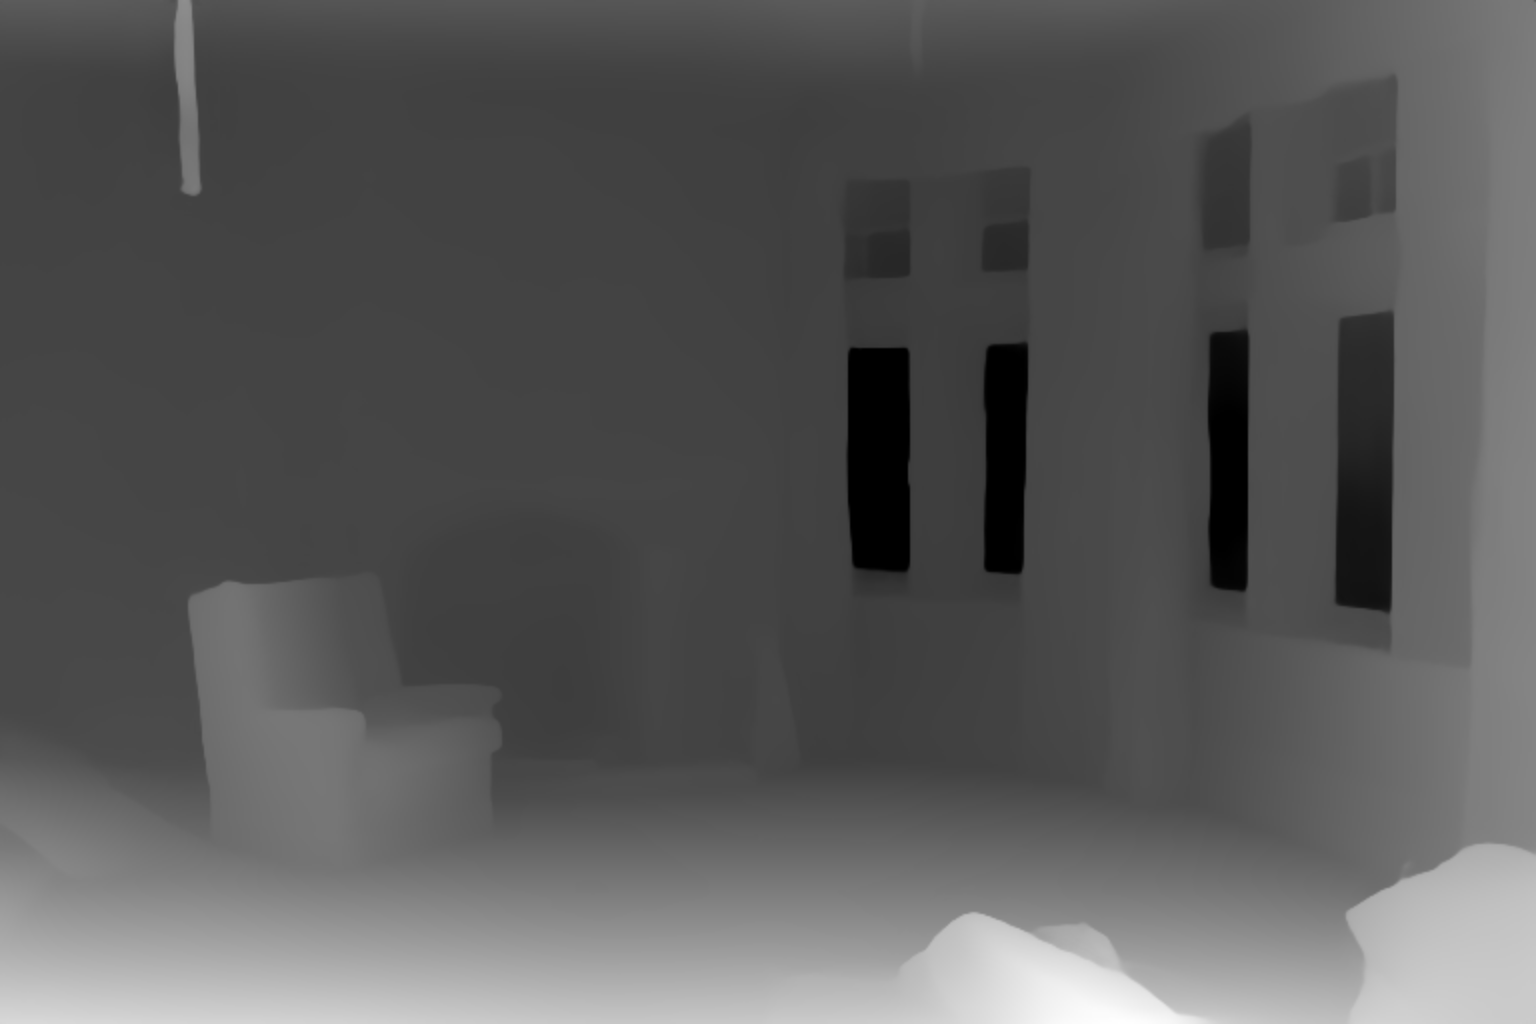
프롬프트 등 원하는 스타일의 이미지를 텍스트 형태로 입력합니다.
prompt = "detail_photo of a room with sofa, 4k, f1.5, highly detailed, high defintion"
negative_prompt = "wrong, anime, cartoon, graphic, text, painting, crayon, graphite, abstract, glitch, deformed, mutated, ugly, disfigured"
seed = 1234567890
generator = torch.Generator(device="cuda").manual_seed(seed)

latents = pipe(prompt=prompt,
               negative_prompt=negative_prompt,
               image=midas_image,
               num_inference_steps=40,
               adapter_conditioning_scale=0.9,
               adapter_conditioning_factor=1.1,
               guidance_scale=8,
               generator=generator,
               output_type="latent",
               cross_attention_kwargs={"scale": 1.5}
               ).images

images = refiner(
    prompt=prompt,
    negative_prompt=negative_prompt,
    guidance_scale=7.5,
    image=latents,
    generator=generator,).images

image = images[0]
image.save("/content/interior.png")
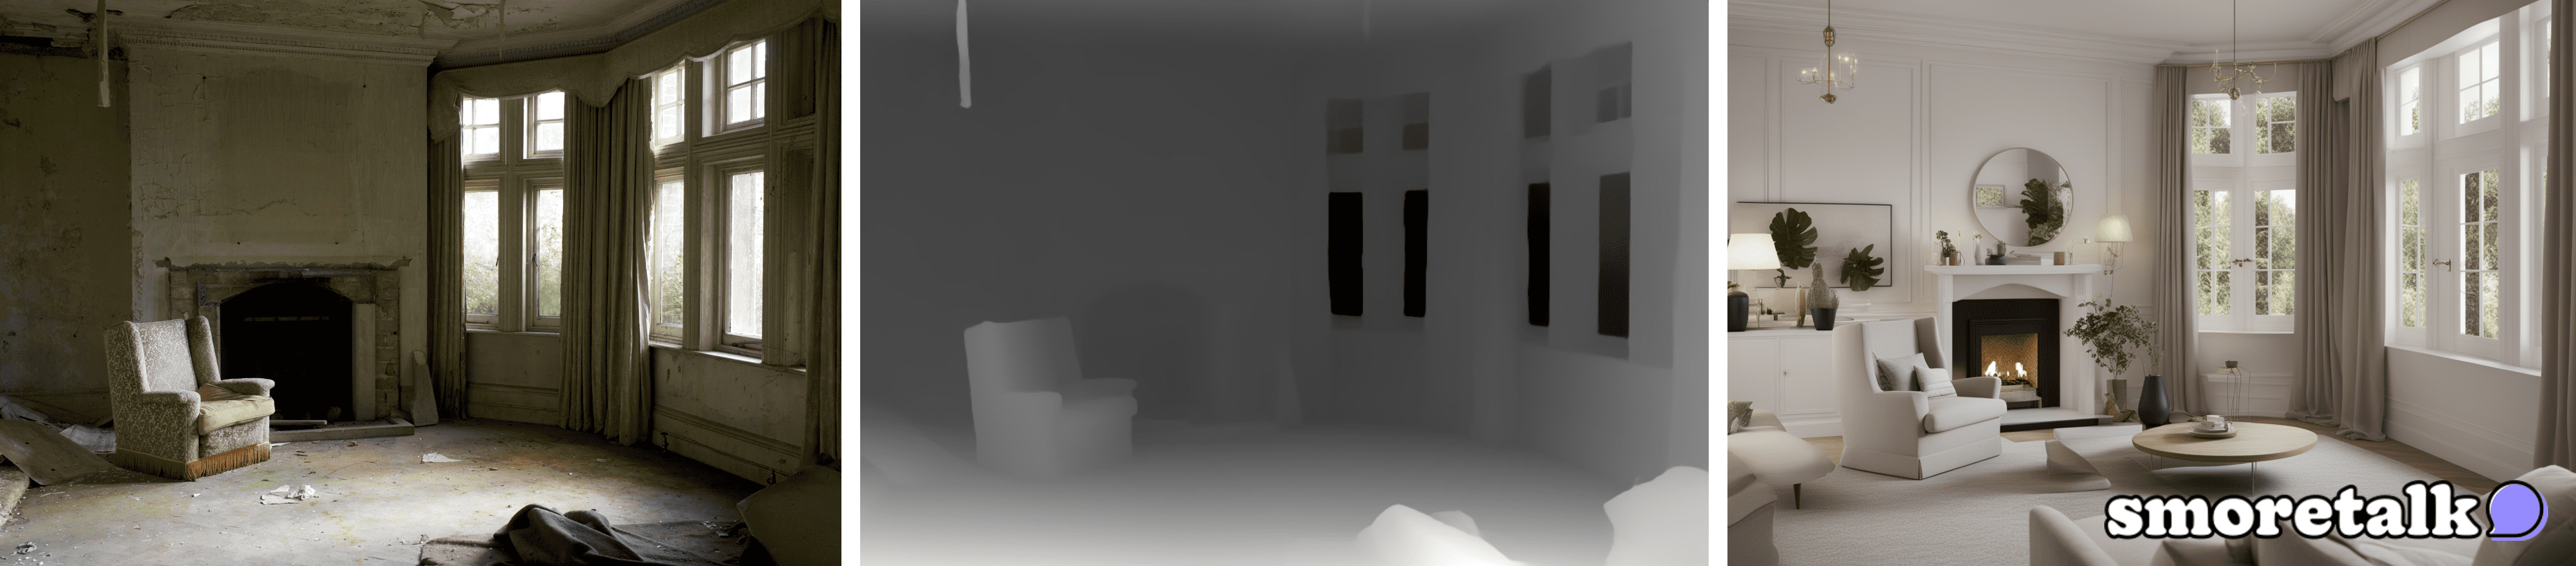
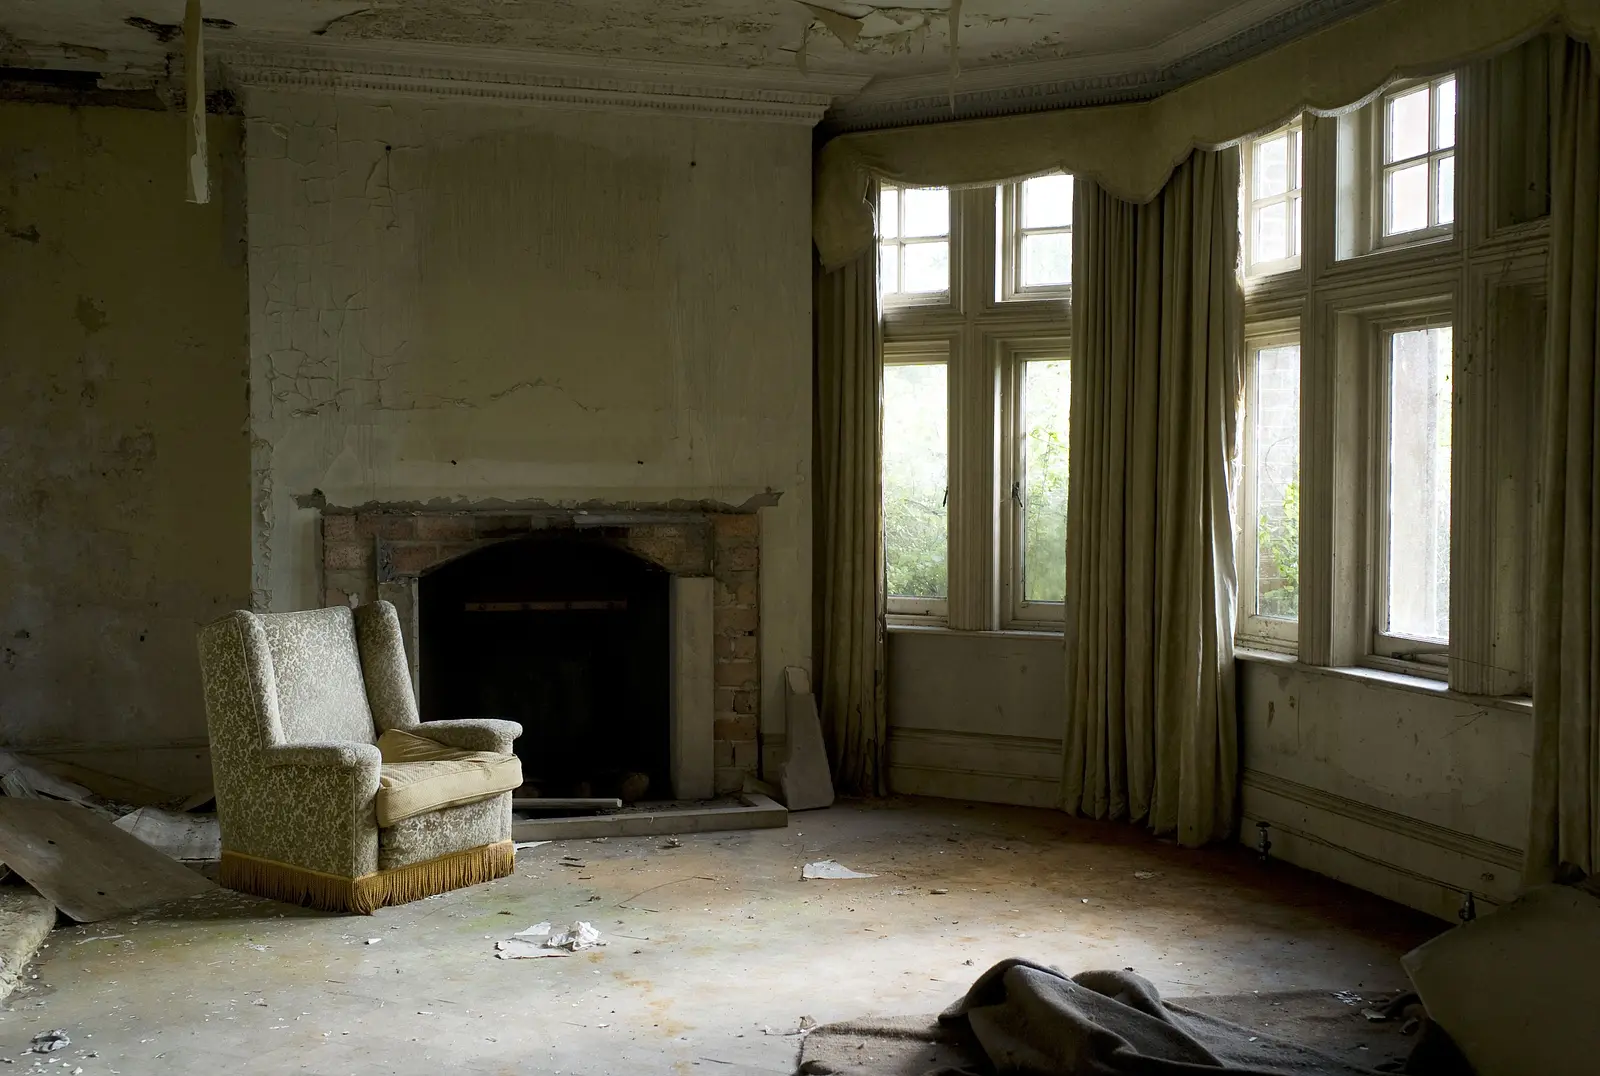
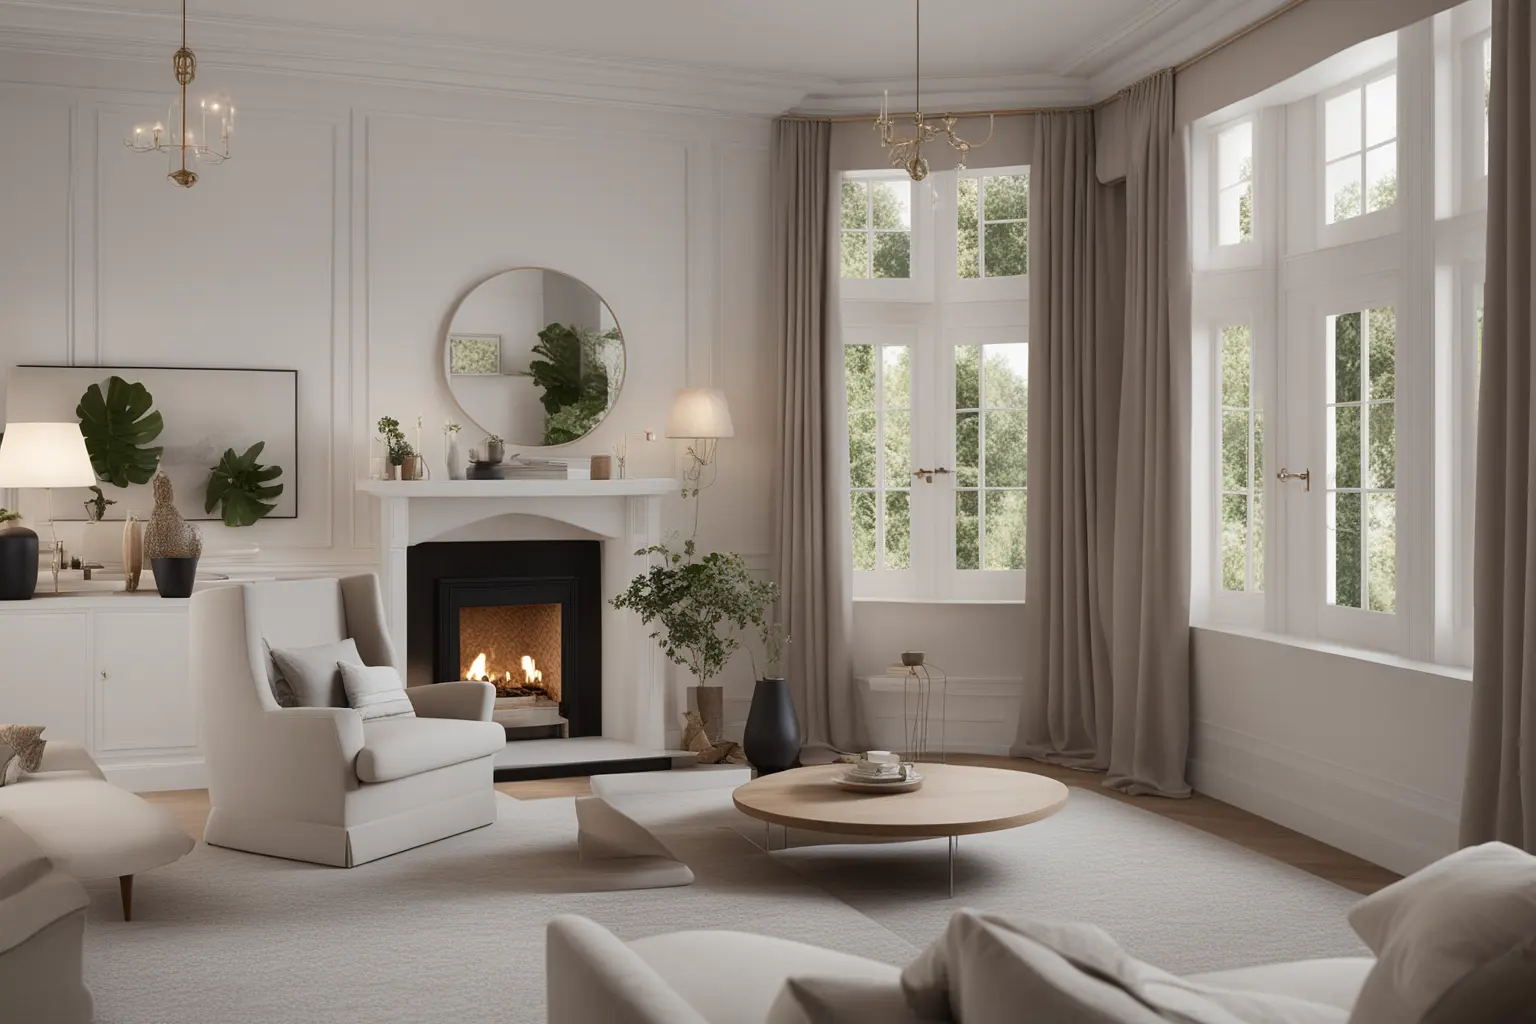
의 과정을 거치면 나오는 이미지들은 다음과 같습니다,
짜잔 🌟
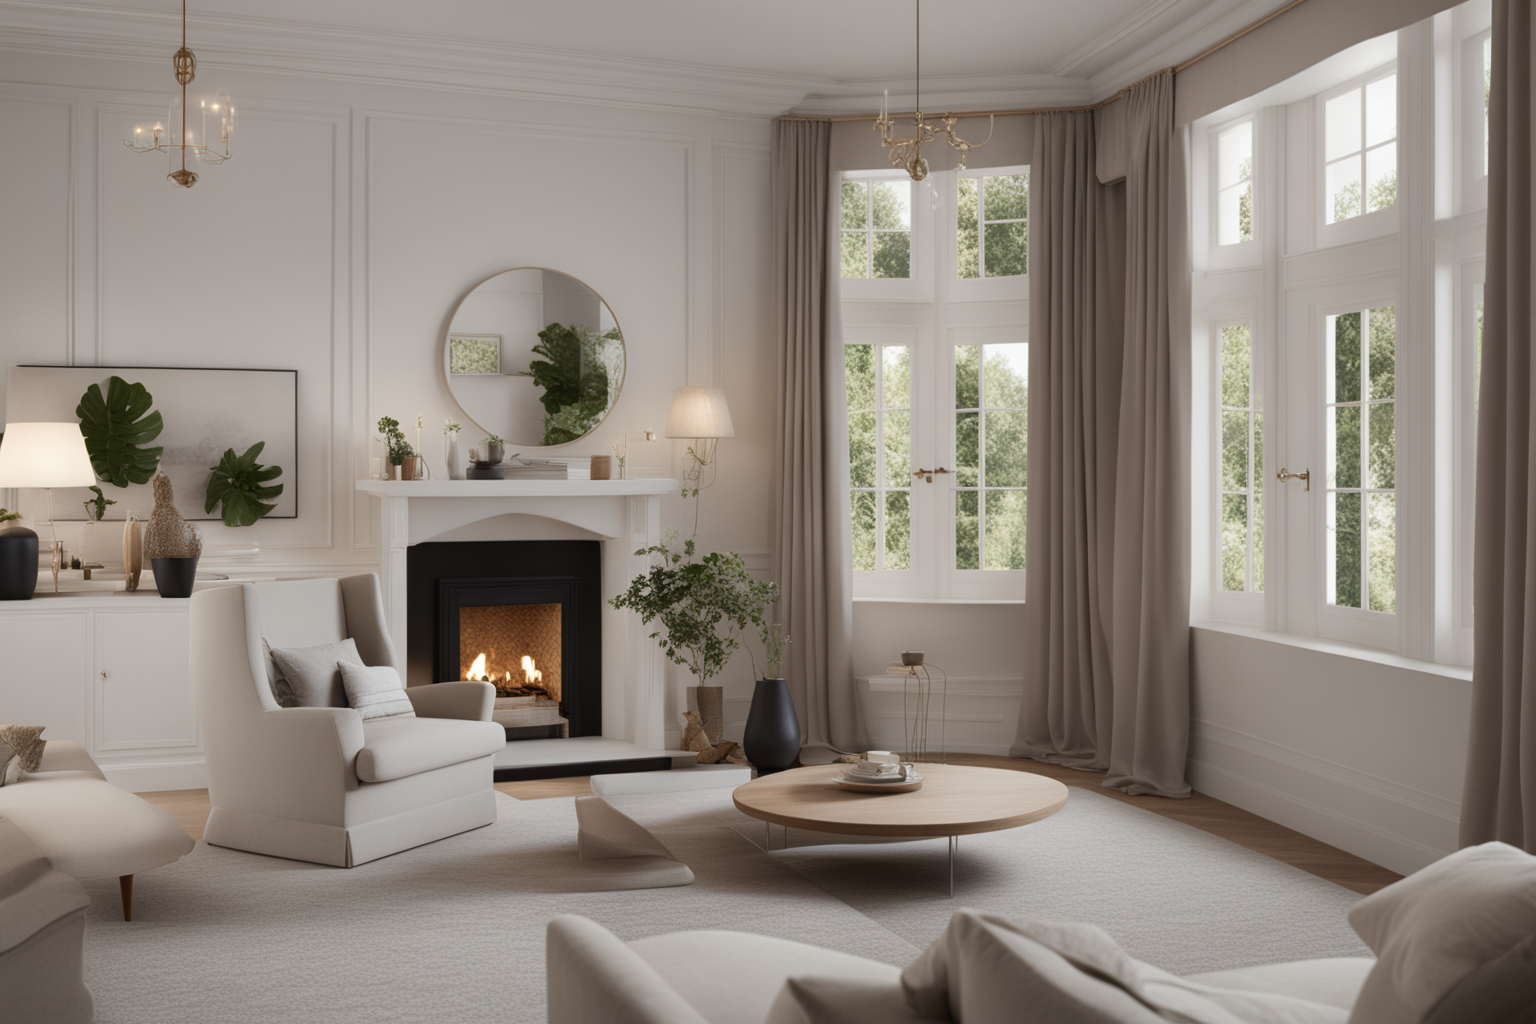
다만 아쉬운 점은 다음과 같습니다.
아래 이미지에서 확인할 수 있듯이, 무엇이 무엇인지를 정확히 확인하지는 못한다. 이 때 필요한 것이 semantic segmentation (구역에 대한 의미를 부여하며 영역 분할).
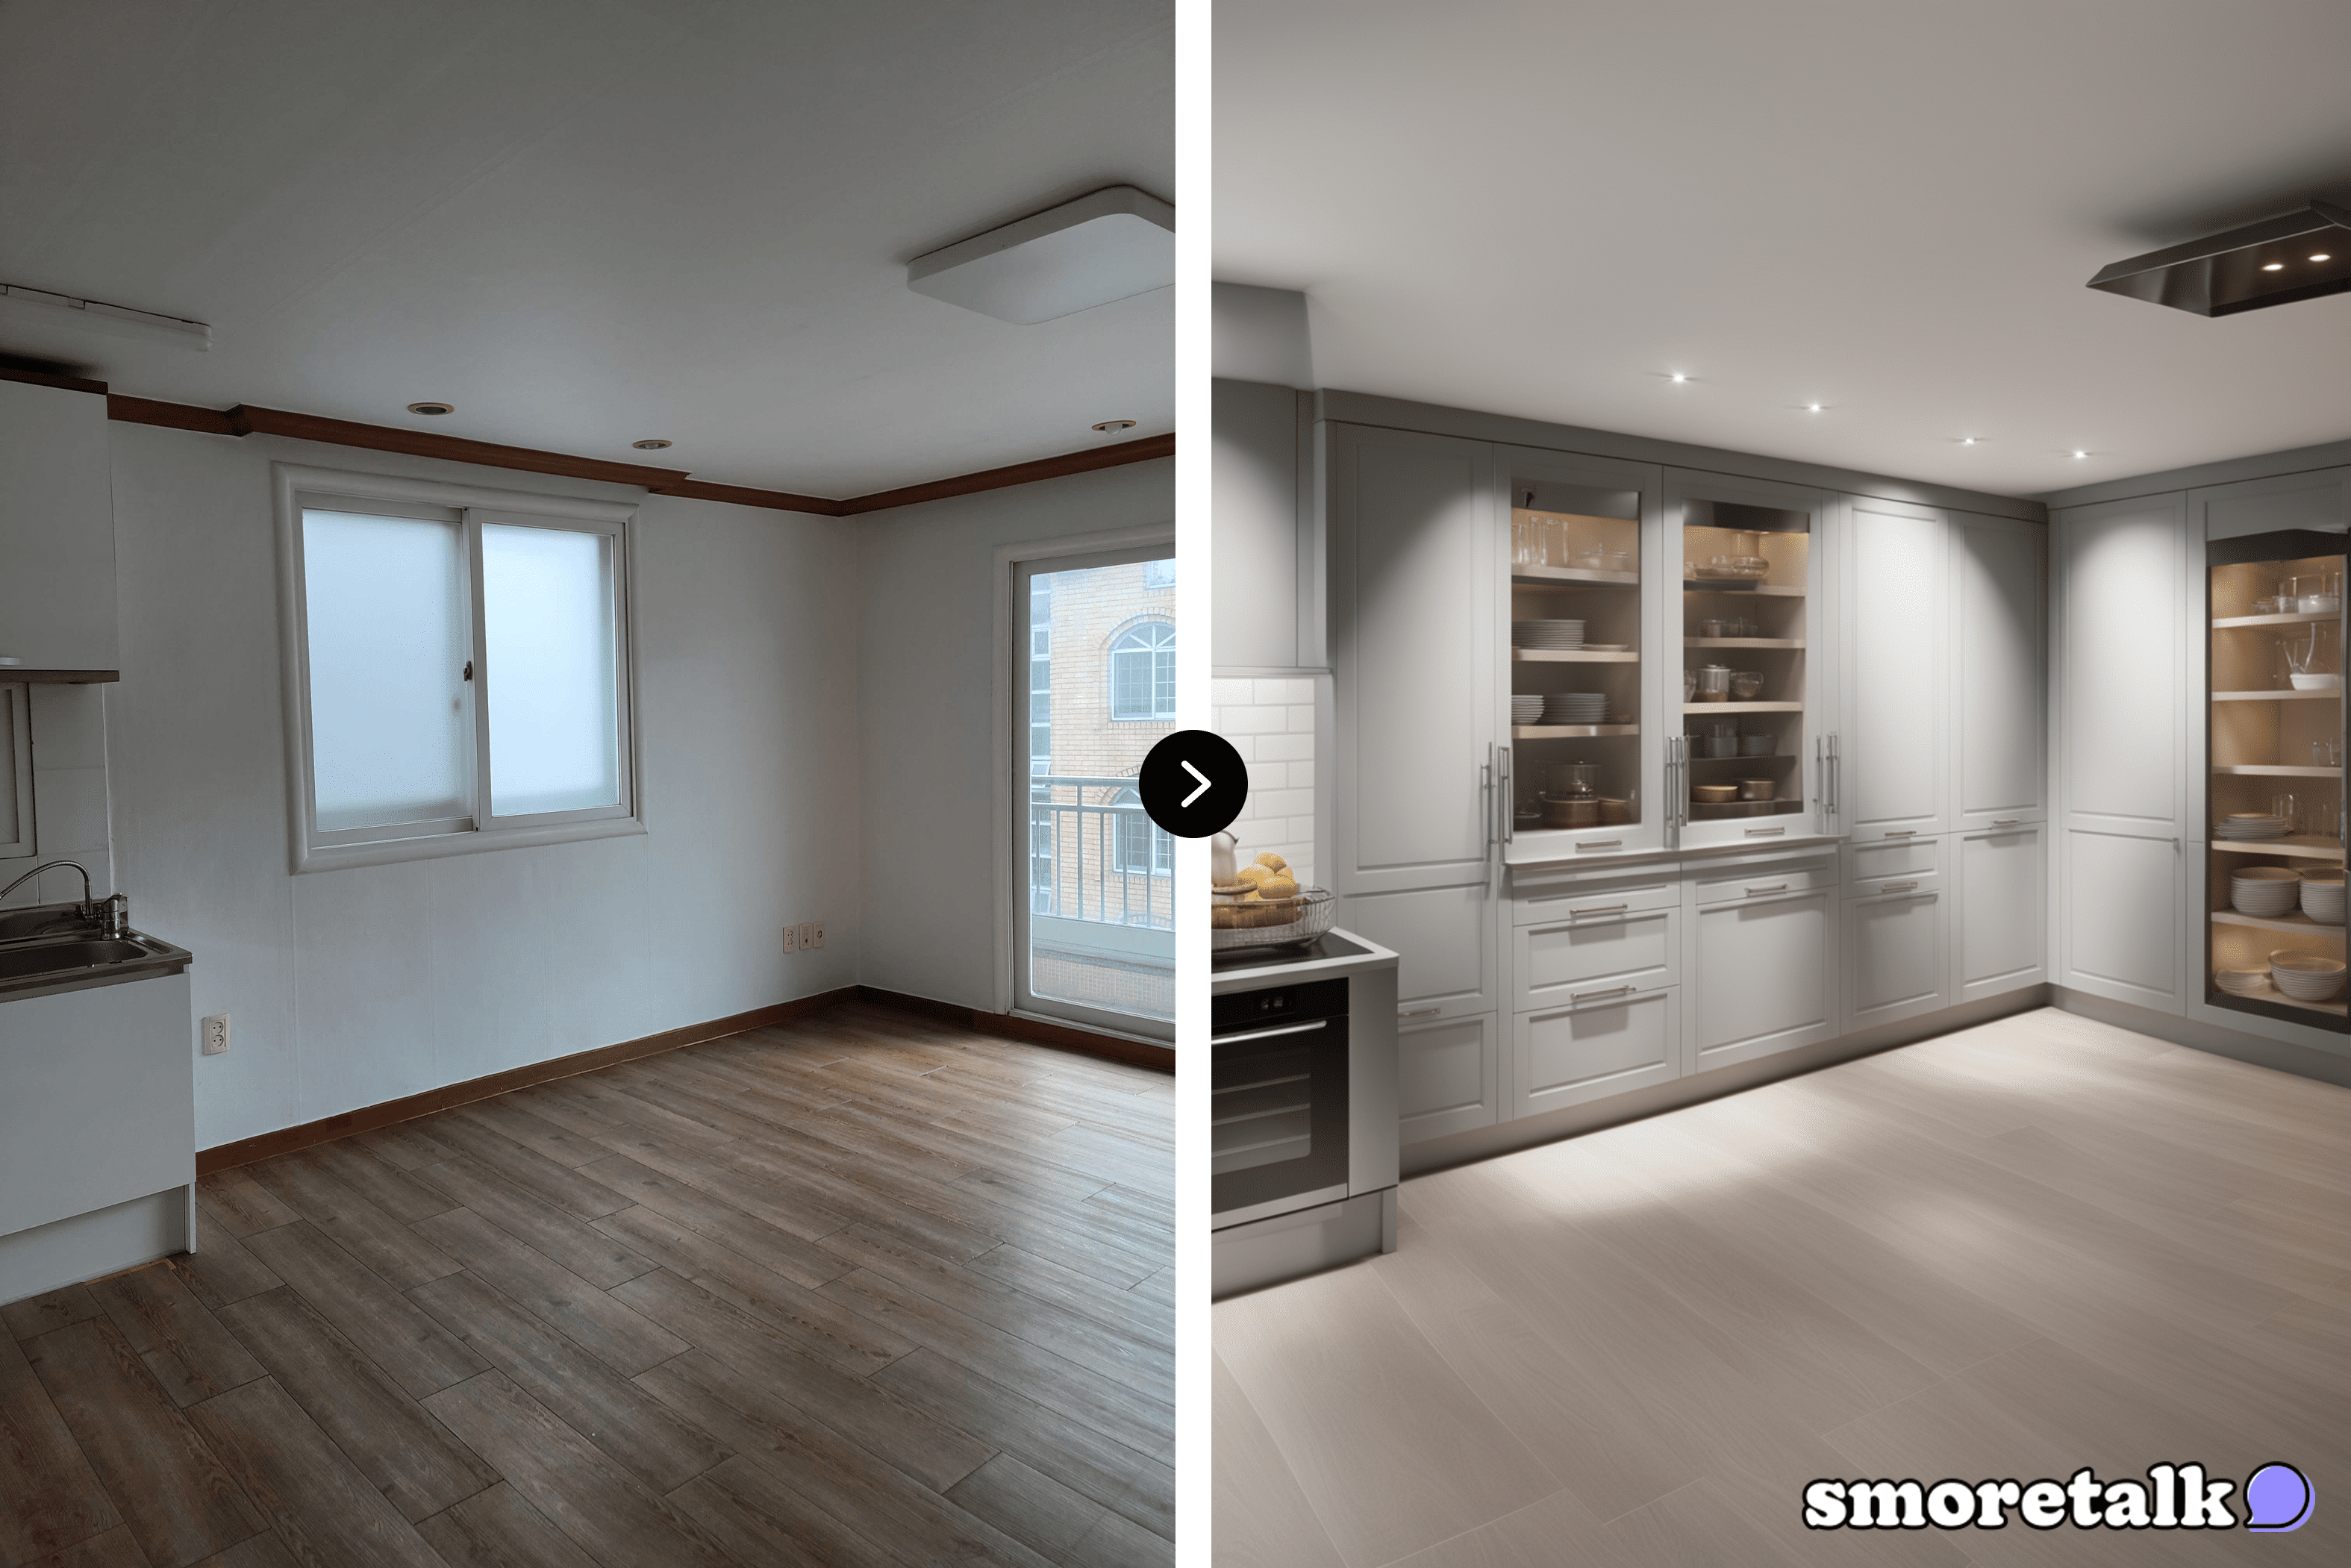
기업에서 사용하길 원하신다면, 본인만의 자산으로 사용 가능해야 하는데 생성 이미지는 무작위적으로 나온다. 이 때 필요한 것이 LoRA (파인튜닝) 또는 IP Adapter (해당 기술 관련 글)
*참고로 단순히 파인 튜닝을 한다고 결과물이 잘 나오는 것은 아닙니다. 상용화 수준을 원하신다면 기술력이 필요합니다.
같이 고민해보고 싶은 분들 또는 서비스하고 싶은데 AI 모델 관련 협업이 필요하시면 연락주세요!
이정민 (스모어톡, tonylee@smoretalk.io)
프롬프트 엔지니어링이 필요 없는 가장 쉬운 검색형 이미지 생성 서비스
댓글
로그인 후 댓글을 남길 수 있습니다.
와.. 좋은 글 공유해주셔서 감사합니다!!
아닙니다 ㅎㅎ Cailyn 님도 매번 좋은 글 공유해주셔서 감사드립니다!
정민님, 저희 기술 이렇게 낱낱이 공개하시면 곤란합니다... 글 내려주세요... p.s. 샤라웃 감사합니다 :) 저희 플랜바이테크놀로지스는 이에 더해 컬러, 재질 변경과 가구 교체 등의 기술을 계속해서 추가하고 있습니다. 많은 관심 부탁 드립니다!
플랜바이 화이팅~~~ 세부적인 디테일에서 해본 사람들과 아닌 사람들에는 차이가 있기도 하고, 개인적으로는 저랑 얘기했지만 경영 측면에서도 기술적으로 준비해야 하는 것이 있잖아요? 잘하시는 팀이어서 걱정 없습니다!
안 그래도 이 글을 플랜바이가 싫어합니다 라고 달려고 했는데..😆
정민님의 허슬링이 존경스럽습니다. 이번에도 좋은 글 감사드립니다.
감사합니다 :) 부족하기만 합니다.