렛서의 다음 인공지능 리포트 맛보기: '달리, 반 고흐, 피카소, 다음은 AI?'
안녕하세요, ‘렛서’의 AI 엔지니어 최동민입니다.
렛서의 지난 리포트, “NLP 연구자가 바라본 AI 동향" 모두 잘 읽어보셨나요? 리포트 발행 전부터 다들 뜨거운 반응을 보내주시고, 발행 이후에도 많은 분들께서 만족스럽다는 피드백을 주신 덕분에 저희 첫번째 리포트를 성공적으로 마무리 할 수 있었습니다.
이번 렛서 리포트는 '달리, 반 고흐, 피카소, 다음은 AI?'라는 제목으로, 비전 생성모델의 동향과 앞으로 시장에 미칠 영향에 대해 다룰 예정입니다. 이번 주 내에 리포트 신청이 시작될 예정이니 다들 기대해주세요!
본격적인 리포트에 앞서, 해당 글에서는 다음 리포트의 일부인 <비전 모델 기반의 서비스 기획하기> 챕터의 내용을 맛보기로 공유드리고자 합니다.
<비전 모델 기반의 서비스 기획하기>
1) 원하는 서비스의 입력과 출력 정의하기
비전 생성모델을 이용하여 서비스를 기획하고자 하는 경우, 해당 서비스가 어떤 입력을 받아서 어떠한 출력을 제공할 지를 정의하는 과정이 우선적입니다. 예를 들어, ‘사용자가 업로드한 이미지에서 배경을 제거하는 서비스'는 입력과 출력이 모두 이미지인 경우에 해당합니다 (입력-사용자가 업로드 한 이미지, 출력-배경이 제거된 이미지).
또 다른 예시로 ‘특정 영상에서 수정하고자 하는 사항을 문장으로 입력하는 방식 기반의 영상 편집'은 비디오와 텍스트를 입력으로 받아 비디오를 출력하는 서비스에 해당합니다 (입력- 사용자가 업로드한 비디오&텍스트, 출력- 사용자의 요구사항에 따라 생성된 비디오).
아래는 비전 생성모델을 바탕으로 기획할 수 있는 서비스 사례들입니다. 여러 예시를 참고하여 원하는 서비스를 비전 모델로 구현할 수 있을지, 또한 해당 서비스의 입출력은 무엇일지 고민해보세요.
[이미지 편집 서비스]
- 텍스트 기반 이미지 편집 서비스 (입력: 이미지+텍스트 ⇨ 출력: 이미지): 이미지와 함께 수정하고자 하는 부분을 텍스트로 입력하면 해당 정보를 반영하여 이미지 수정 (예시: “해당 이미지에서 고양이를 강아지로 바꿔줘”, “해당 이미지가 밤에 찍은 사진인 것처럼 수정해줘”)
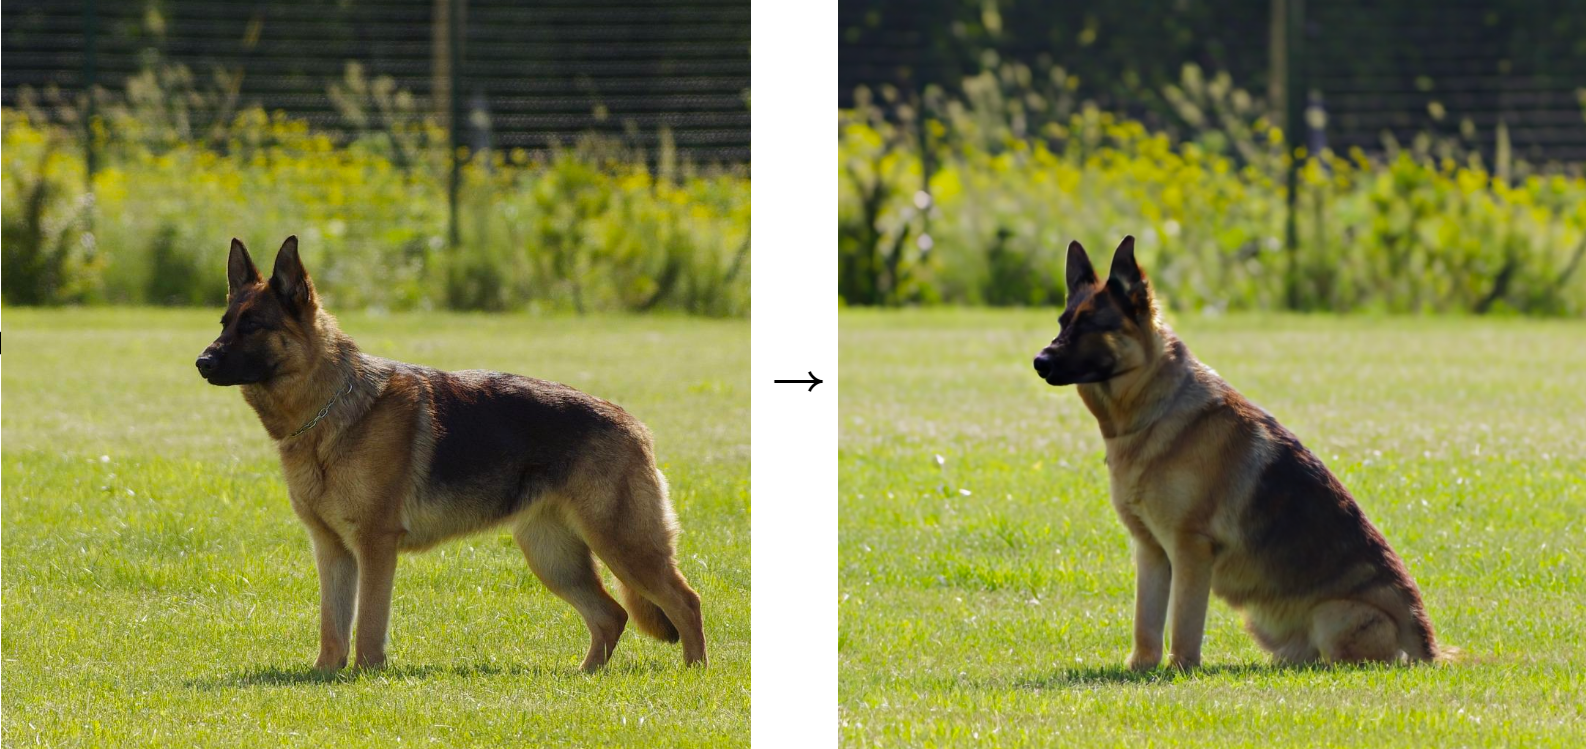
입력 이미지 (왼쪽)에 대해 “앉아있는 강아지 사진” (텍스트)으로 바꿔달라는 지시를 주었을 때의 결과 이미지 (오른쪽) - 출처: https://imagic-editing.github.io/#
- 이미지 합성 서비스 (입력: 이미지+이미지 ⇨ 출력: 이미지): 두 개의 이미지를 업로드하면 이들을 조합하여 새로운 이미지로 합성 (예시: 인물 이미지와 특정 배경이 담긴 이미지를 함께 제공하여 이미지 속 인물의 배경을 바꾸는 서비스, 주어진 이미지에 원하는 화가의 화풍을 입히는 서비스)
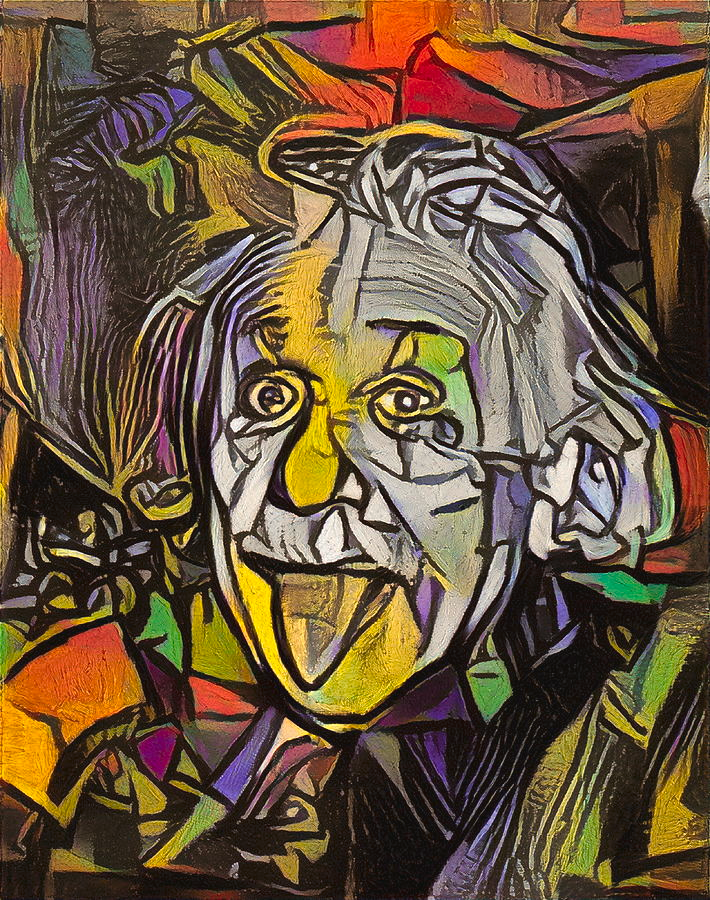
피카소의 ‘우는 여자’와 아인슈타인의 사진을 합성한 이미지 - 출처: https://pixels.com/featured/albert-einstein-meets-weeping-woman-ai-art-ai-artisan.html
[예술/디자인 서비스]
- 캐릭터/NPC 생성 서비스 (입력: 텍스트 ⇨ 출력: 이미지): 원하는 특징을 반영하고 있지만 서로 다른 다양한 캐릭터 동시 생성 (예시: “귀가 뾰족하고 장발이며 발이 큰 캐릭터 50개를 만들어줘”)
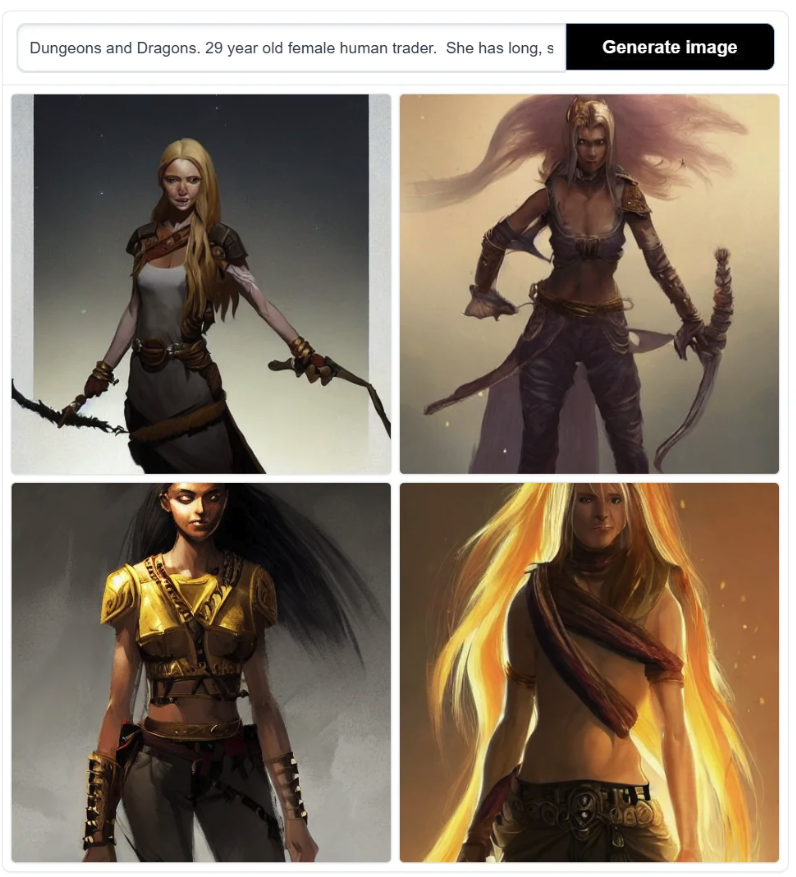
Stable Diffusion을 활용해 “던전 앤 드래곤 스타일로 긴 금발의 생머리인 29세 여성”이라는 텍스트 입력으로 만든 이미지 - 출처: https://www.reddit.com/r/DnD/comments/y1xxnx/tip_characternpc_portrait_generator_with_stable/
[이미지 기반 번역 서비스]
- 이미지 속 글자 번역 서비스 (입력: 이미지 ⇨ 출력: 텍스트): 이미지 속에 포함된 글자를 인식한 후 특정 언어로 번역된 텍스트 출력 (예시: 영어로 된 영수증 이미지로부터 각 메뉴의 한글 이름과 가격 정보 추출)
- 이미지 속 글자 번역 및 표기 서비스 (입력: 이미지 ⇨ 출력: 이미지): 이미지 속에 포함된 글자를 인식한 후 특정 언어로 번역한 다음, 새로운 언어로 번역된 글자를 원본 이미지 상에 씌운 이미지 생성 (예시: 파파고 이미지 바로번역 서비스)

출처: https://www.aitimes.com/news/articleView.html?idxno=133541
2) 정의한 입출력에 해당하는 생성모델 선택 혹은 조합하기
서비스의 입출력을 정의한 다음의 과정은 해당 입력을 바탕으로 적절한 출력을 생성할 수 있는 모델을 선택하는 것입니다. 이 과정에서 단일 생성모델로는 한번에 처리할 수 없는 서비스의 경우, 여러가지 AI 모델 간의 조합을 통해 서비스를 기획할 수 있습니다.
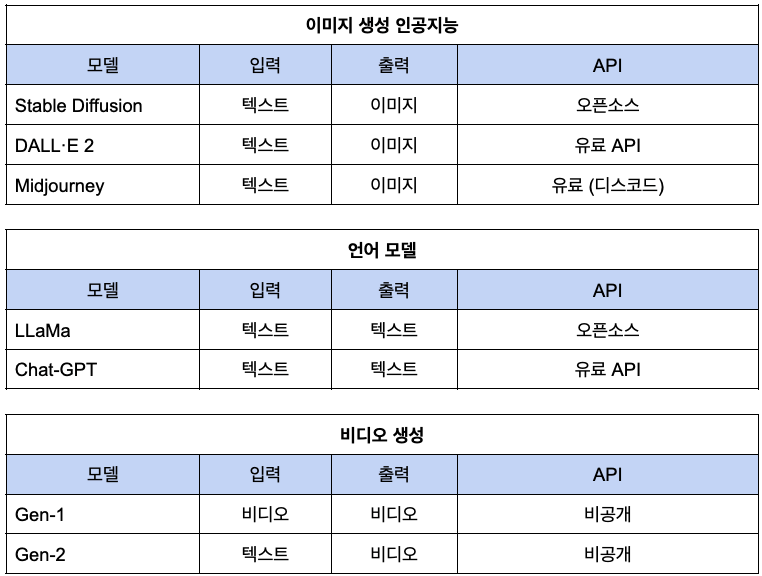
각 생성모델의 입출력 형태와 API 공개 여부를 정리한 표입니다. 앞서 정의한 서비스의 입출력에 어떤 AI를 사용하는 것이 좋을지 해당 표를 바탕으로 결정해보세요.
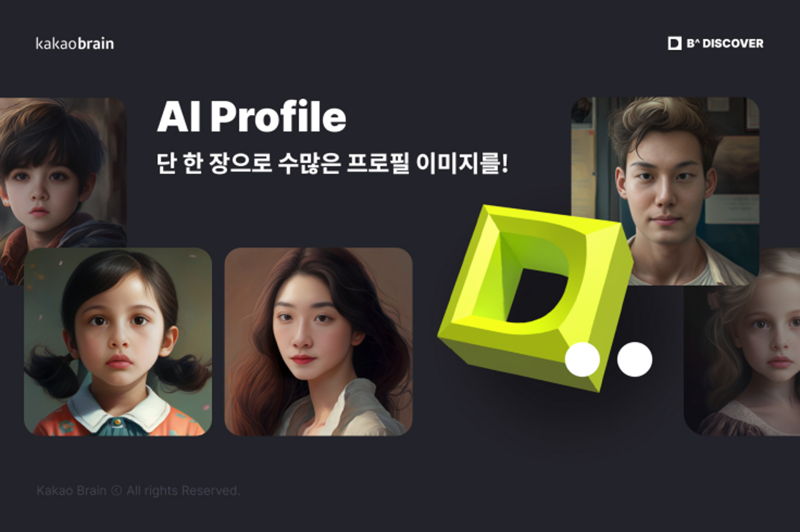
출처:https://bdiscover.kakaobrain.com/ai-profilee
예를 들어, 카카오브레인의 B’ DISCOVER에서 제공하는 AI Profile과 같은 '사용자가 업로드한 셀카 이미지를 바탕으로 해당 사용자의 사진 여러장을 새로 생성해주는 서비스'의 경우, 입력과 출력이 모두 이미지에 해당하므로 Stable Diffusion을 활용할 수 있습니다. (B’ DISCOVER가 Stable Diffusion을 사용했다는 것은 아닙니다.) 또한 Stable Diffusion은 무료 오픈소스이므로 서비스를 구현하여 사용자에게 제공할 때, 클라우드 혹은 서버 비용 이외의 사용자 요청마다의 API 비용이 별도로 들지 않는다는 장점이 있습니다.
3) 직접 입출력을 정의하고 적절한 서비스를 찾기 어려워요
앞선 예시와 표를 참고하더라도, 원하는 서비스 기획을 위해 직접 AI 모델을 조사하고 적절한 조합을 찾는 것은 여전히 어려운 과정입니다. 그렇다면 주어진 서비스 정의에 적합한 AI를 더욱 쉽게 찾을 수 있는 방법은 없을까요? 서비스 기획 시 필요한 AI를 선정하는 과정 또한 ChatGPT의 도움을 받을 수 있습니다. 보다 자세한 내용은 곧 출시될 렛서 리포트 전문을 참고해주세요 :)
해당 글의 검토를 도와주시고 인사이트를 제공해주신 @최혜린, @심규현님에게 감사드립니다.
혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)
최동민
Welcome to my scheduling page. Please follow the instructions to add an event to my calendar.
https://calendly.com/dmchoi-letsur
댓글
로그인 후 댓글을 남길 수 있습니다.
동민님의 글은 항상 북마크를 불러 일으킵니다 :) 양질의 리포트 감사합니다!
강현님 좋은 말씀 너무 감사합니다~ 본 리포트도 도움이 되시길 바래요 ㅎㅎ 감사합니다!! :)