[Part 2] 코드 100줄로 쏘카 팀이 만든 고객 서비스 챗봇 10분 안에 만들어보기 (RAG, 할루시네이션 처리)
저번 포스트에 이어서 올리는 "고객 상담 챗봇 만들기" 개발글 Part 2 입니다.
쏘카 팀이 고객 서비스 챗봇을 만들었다고 했는데, 만든 방법은 시나리오 기반 LLM 봇 입니다. (아래 글에서 더 자세히 확인하세요)
조금 더 자세히 쏘카 팀의 개발 디자인에 대해 살펴봅시다.
먼저 유저의 텍스트 인풋에 따라 상담의 의도를 바로 LLM이 파악하기
RAG (Retrieval Augmented Generation), vector search를 같이 사용해서 LLM 에이전트가 상담 매뉴얼 DB에서 더욱 정확한 결과를 검색해서 뱉어내도록 하기
할루시네이션이 나오면 미리 후처리해서 LLM이 답하는 것보다 인간 상담원에게 바로 연결을 할 수 있도록 디자인 하기
Part 1에서는 정말 간단하게 ChatGPT와 같은 챗봇을 만들었었고, 이번 파트에서는 RAG와 vector store을 이용한 대화형 LLM 챗봇을 만들고, 할루시네이션까지 전처리 할 수 있는 방법에 대해 살펴보겠습니다.
프로젝트를 만들면서 참고한 Langchain documentation 입니다.
구현하는 법
백엔드에서 고객 서비스 매뉴얼 파일 업로드
로딩한 파일 vector store 데이터베이스에 업로드하기
유저가 제품 관련 질문하면 데이터베이스에 저장돼있는 정보 내에서 관련 답변을 검색한 후 내용 정리해서 내뱉기 (RAG, vector search)
제품과 관련되지 않은 질문하면 할루시네이션 처리 ("이 정보에 대해서 모른다고 대답")
프로젝트 셋업
새로운 폴더 만들기
터미널에서 가상환경 만들기 :
python3 -m venv venv.env파일 만들고 그 안에OPENAI_API_KEY = "sk- <나만의 openai api key>"저장하기가상환경 실행시키기:
source venv/bin/activate필요한 패키지들 다운받기:
pip3 install openai langchain tiktoken python-dotenv chromadb streamlit bs4파이선 파일 만들기: chatbot.py
백엔드 코드
고객 서비스 매뉴얼 업로드 하고 벡터스토어에 저장하기
가장 먼저 필요한 모듈들을 불러오세요.
import dotenv
dotenv.load_dotenv()
from langchain.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain.chat_models import ChatOpenAI
import streamlit as st
import time
그 다음 저희가 할것은 고객 서비스 응대 매뉴얼을 로딩해야합니다.
이건 .txt 파일일수도 있고, .pdf 파일일수도 있어요. 저희는 이번 프로젝트 예시 시나리오를 위해 웹에서 scraping한 정보들을 토대로 챗봇을 만들 예정입니다. 달파 AI store 페이지에서 어떤 식으로 제품이 만들어지는지 자세히 설명돼있어서 예시로 썼어요!
이 웹사이트에 있는 텍스트 정보들을 scraping 하려면 다음 코드를 사용하면 됩니다. 코드에 대한 설명은 각 라인의 #주석을 확인해주세요.
# LLM 셋업하기
llm = ChatOpenAI(temperature=0)

# WebBaseLoader 함수가 " " 안에 있는 웹사이트 텍스트들을 불러옵니다.
loader = WebBaseLoader("https://dalpha.so/ko/howtouse?scrollTo=custom")
# 데이터 로딩하기
data = loader.load()

# 불러온 데이터 스플릿하기
text_splitter = RecursiveCharacterTextSplitter(chunk_size = 500, chunk_overlap = 0)
all_splits = text_splitter.split_documents(data)

# 불러온 데이터 Chroma라는 vector store에 저장하기.
# LLM 에이전트가 이 데이터베이스에 저장돼 있는 내용을 검색할 수 있도록 해주는 겁니다.
vectorstore = Chroma.from_documents(documents=all_splits, embedding=OpenAIEmbeddings())

# LLM 에이전트가 사용할 수 있도록 retriever 라는 툴로 만들어줍니다.
retriever = vectorstore.as_retriever()
에이전트가 사용할 툴 만들기
그 다음 할 것은 vector store에 저장돼있는 내용을 LLM이 필요할때 검색할 수 있는 툴로 만들어주는 것입니다. 보통 LLM 에이전트를 만들때 에이전트가 사용할 수 있는 툴들을 여러개 만들어 줄 수 있어요. 그게 구글 검색일수도 있고, 이런식으로 내가 업로드한 다큐멘트 파일에 대한 내용 검색을 하는 툴일수도 있어요. 이렇게 검색을 해서 정확한 결과들을 불러오는 기술을 RAG (Retrieval augmented generation) 이라고 합니다.
from langchain.agents.agent_toolkits import create_retriever_tool

tool = create_retriever_tool(
retriever,
"cusomter_service",
"Searches and returns documents regarding the customer service guide.",
)

tools = [tool]
이제 LLM 에이전트가 만약 유저가 내가 업로드한 다큐멘트에 관련된 질문을 하면 이 tool 을 사용해서 검색을 하게 될 것입니다.
대화 내용 기억할 수 있는 메모리 부여하기
다음 에이전트가 대화 내용들을 기록하고 기억할 수 있도록 memory라는 변수를 셋업해주세요.
memory_key = "history"

from langchain.agents.openai_functions_agent.agent_token_buffer_memory import (
    AgentTokenBufferMemory,
)

memory = AgentTokenBufferMemory(memory_key=memory_key, llm=llm)
에이전트 만들기 (할루시네이션 전처리)
이제 에이전트를 만들어줄게요. 자세한 설명은 각 코드 라인의 주석을 확인해주세요.
from langchain.agents.openai_functions_agent.base import OpenAIFunctionsAgent
from langchain.schema.messages import SystemMessage
from langchain.prompts import MessagesPlaceholder

# LLM이 어떤 행동을 해야하는지 알려주는 프롬프트
system_message = SystemMessage(
    content=(
        # 여기서는 챗봇에게 너는 어떤 챗봇인지 설명해주고, 위에서 만든 툴을 활용해서 답변을 하라고 해줍니다
        "You are a nice customer service agent."
        "Do your best to answer the questions."
        "Feel free to use any tools available to look up "
        "relevant information, only if necessary"
        # 할루시네이션 전처리 과정입니다. 프롬프트로 "만약 서비스 매뉴얼과 관련되지 않은 질문이면 거짓된 답변을 생성하지 말아줘" 라고 처리합니다.
        "Do not generate false answers to questions that are not related to the customer service guide."
        "If you don't know the answer, just say that you don't know. Don't try to make up an answer."
        # 챗봇이 한국어로 대답하게 합니다.
        "Make sure to answer in Korean."
    )
)

# 위에서 만든 프롬프트를 바탕으로 LLM에게 줄 프롬프트 형식 셋업
prompt = OpenAIFunctionsAgent.create_prompt(
    system_message=system_message,
    extra_prompt_messages=[MessagesPlaceholder(variable_name=memory_key)],
)

# 위에서 만든 llm, tools, prompt를 바탕으로 에이전트 만들어주기
agent = OpenAIFunctionsAgent(llm=llm, tools=tools, prompt=prompt)
코드를 자세히 보시면 프롬프트 내에서 할루시네이션 전처리 과정을 한것을 볼 수 있습니다. 서비스 매뉴얼과 관련되지 않은 질문을 하면 거짓된 답변을 생성하지 말라고 명시해줍니다. 그냥 모른다고 대답하라고 처리해줍니다. 그래야만 할루시네이션 값들을 최소한으로 줄일 수 있게 됩니다. (이 방식은 100% 할루시네이션을 없애진 않습니다.)
에이전트 실행하기
마지막으로 에이전트를 실행시킬 수 있는 AgentExecutor 코드를 만들고, 테스트를 해보세요.
from langchain.agents import AgentExecutor

agent_executor = AgentExecutor(
agent=agent,
tools=tools,
memory=memory,
verbose=True,
return_intermediate_steps=True,
)

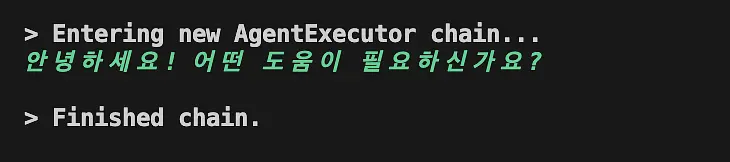
result = agent_executor({"input": "안녕하세요"})
print(result)
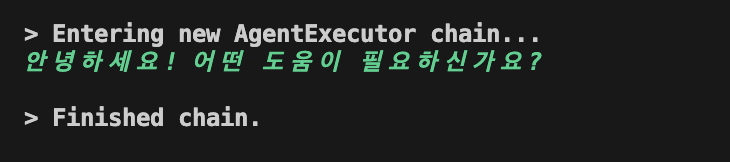
테스트를 해볼때에는 터미널에 python3 chatbot.py를 실행시키면 됩니다. 그럼 이런식으로 답변이 생성돼요.
저희가 테스트해봐야하는 케이스는 두가지인데,
업로드한 서비스 매뉴얼 관련 답변을 잘 하는지
할루시네이션 값들을 전처리해주는지
확인해야합니다.
첫번째 케이스를 테스트해볼게요.
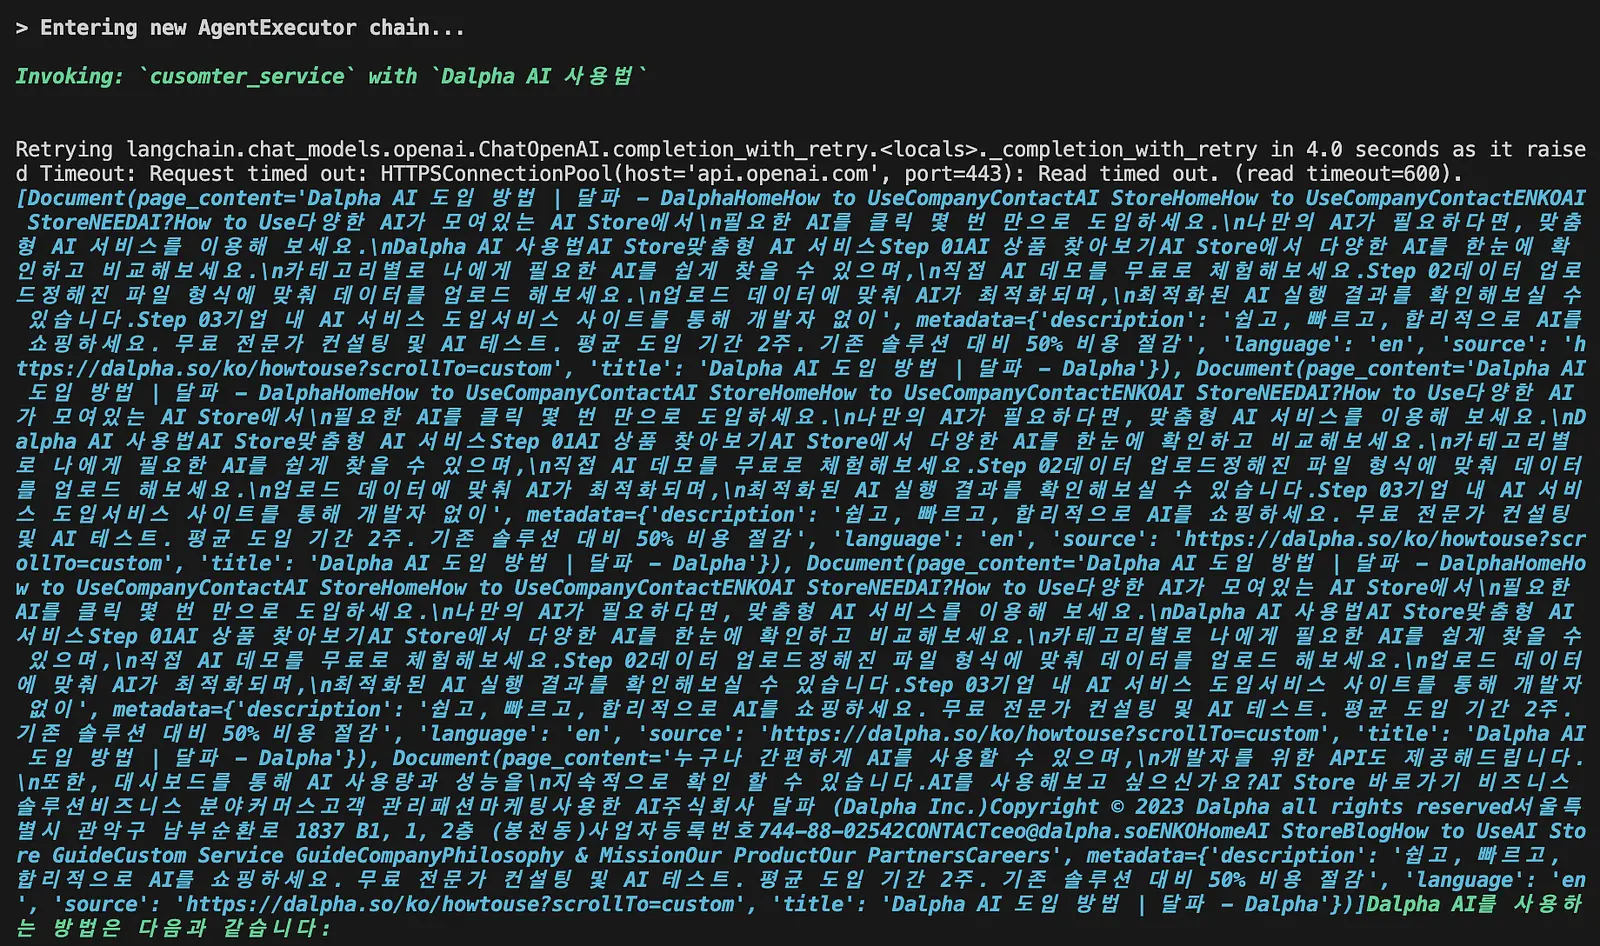
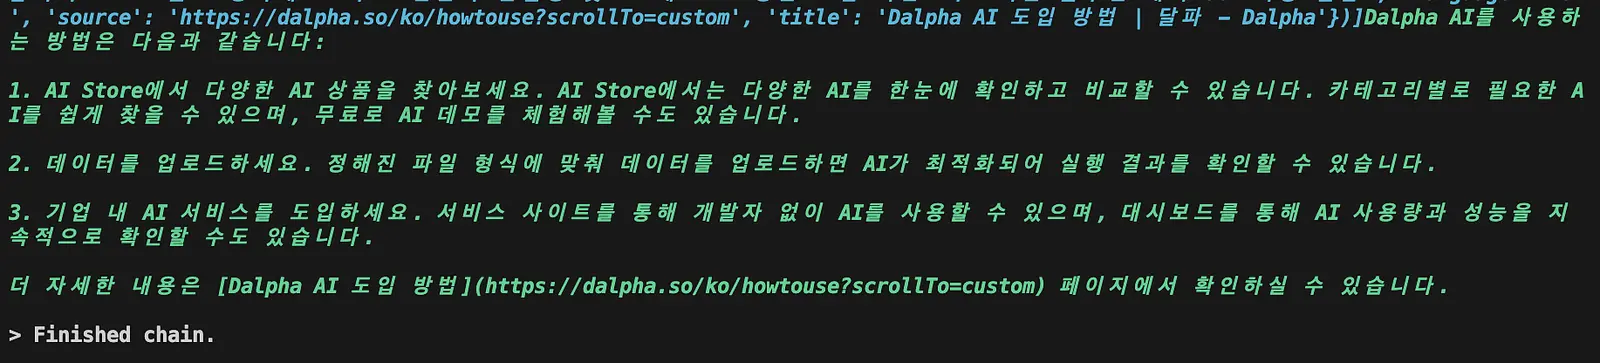
result = agent_executor({"input": "어떻게 Dalpha AI를 사용하나요?"})
print(result)
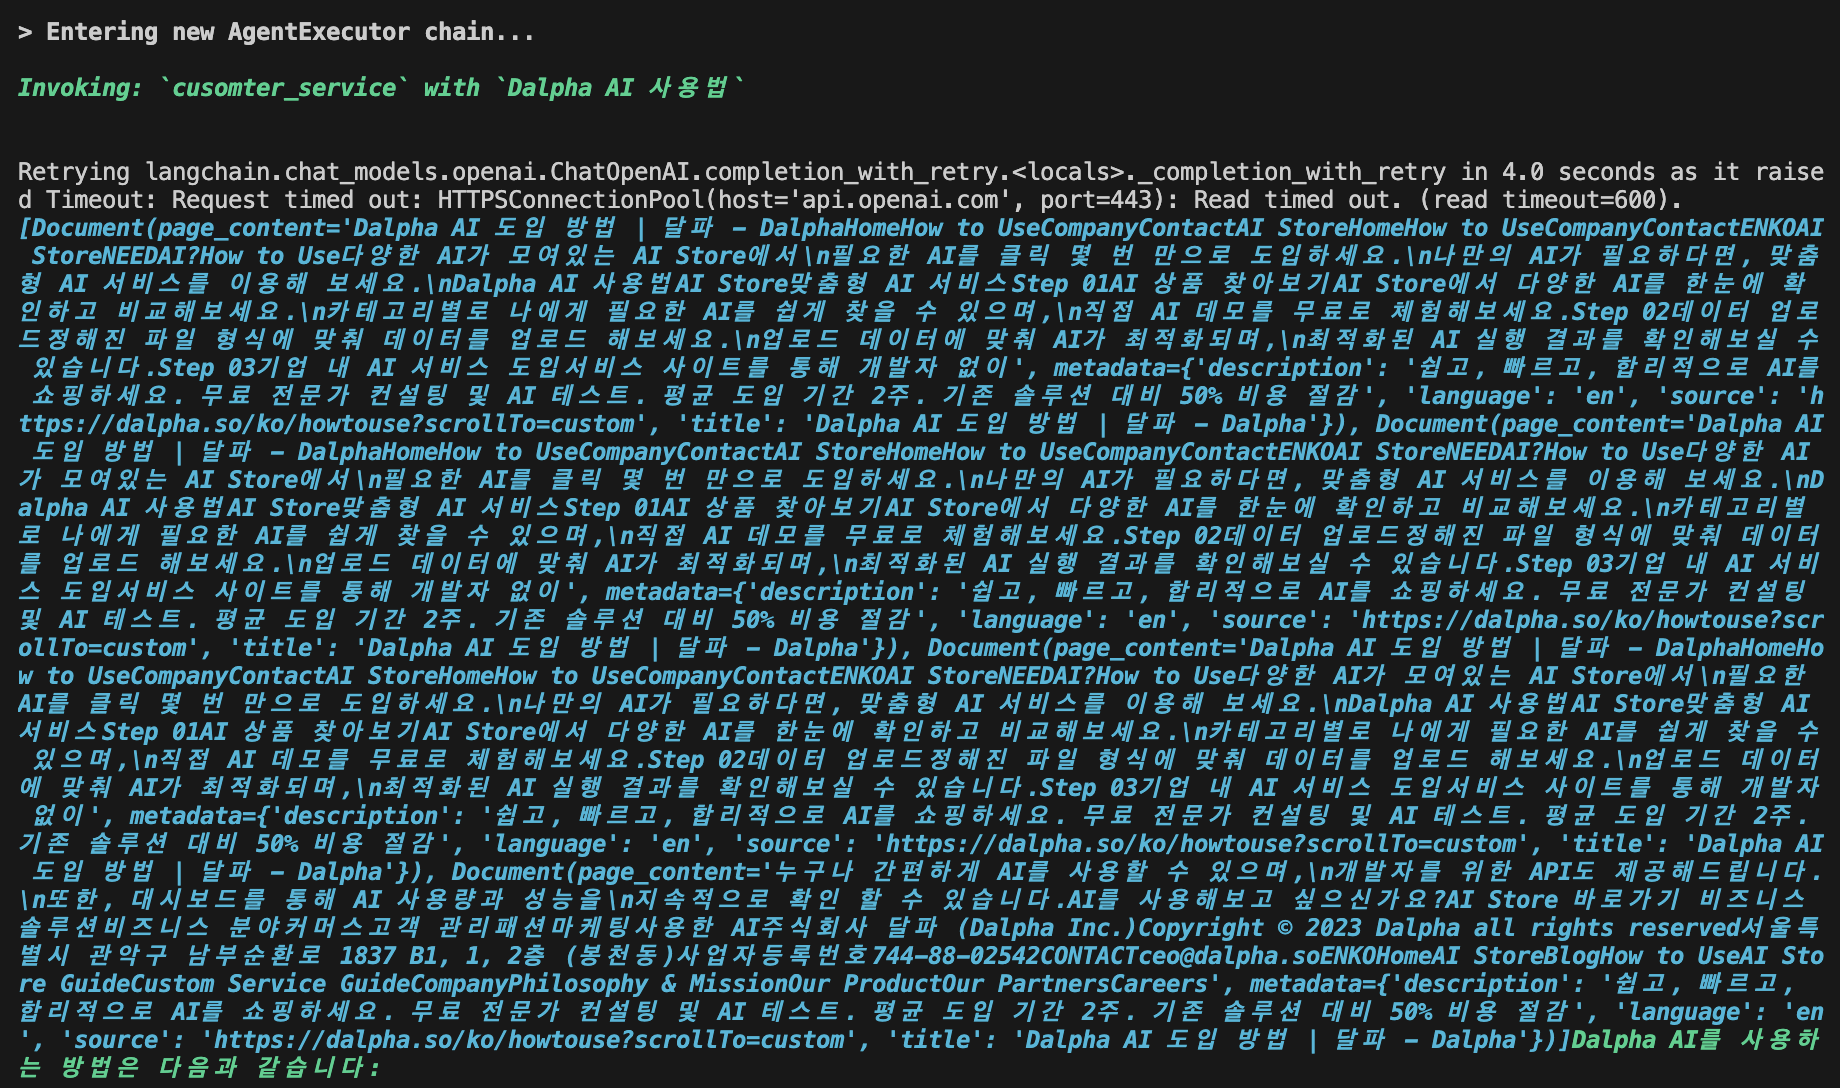
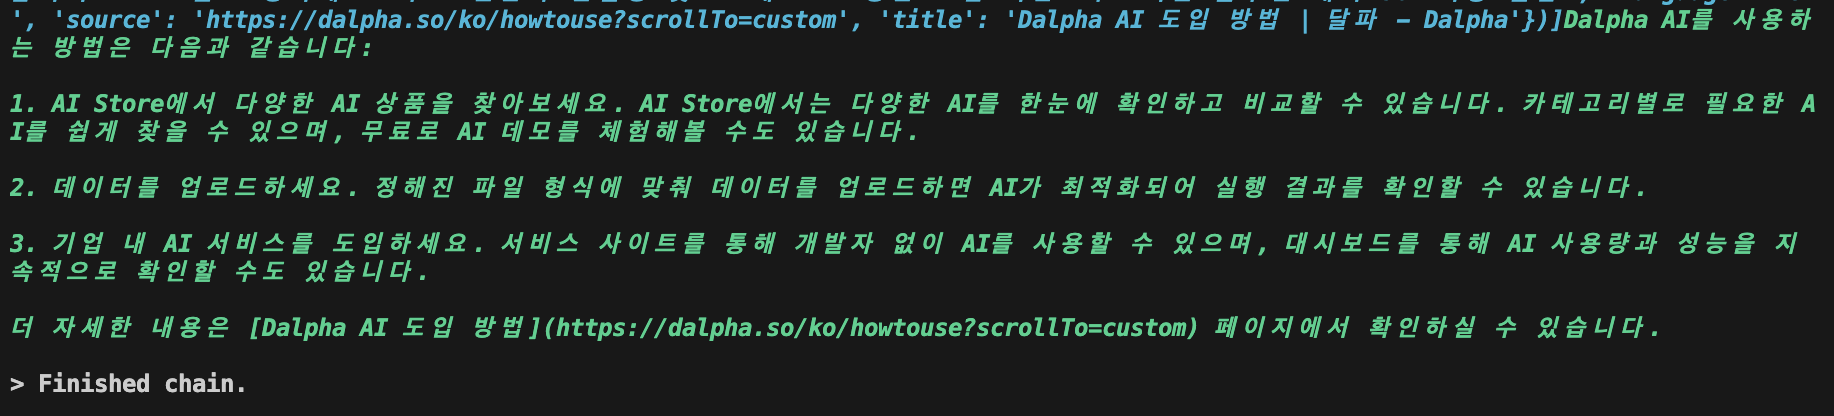
그럼 답변이 생성됩니다. 일단 먼저 아래 이미지에서 "Invoking: 'customer_service' with 'Dalpha AI 사용법'" 보이시죠? 이게 바로 위에서 만든 retriever tool을 제대로 사용했음을 볼 수 있어요. 저희가 vector store에 업로드한 웹사이트 내용을 에이전트가 제대로 검색하고 있는 것을 확인할 수 있습니다.
그 다음 파란색 부분은 웹사이트에 있는 내용들을 실제로 불러온 것입니다.
그 다음 두번째 케이스를 테스트해볼게요.
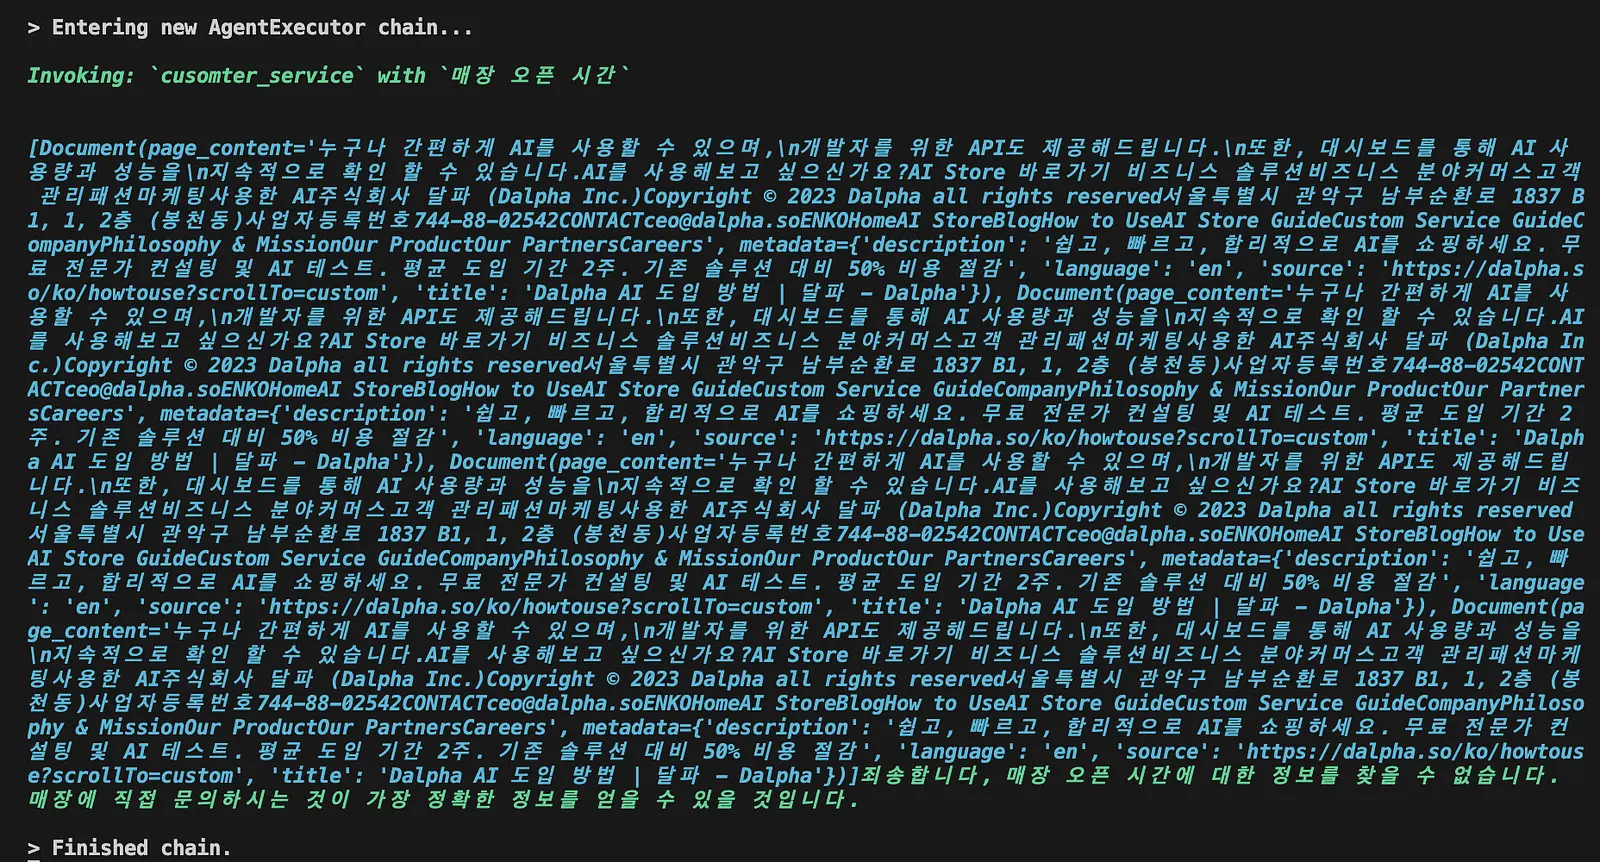
result = agent_executor({"input": "매장 오픈 시간은 몇시인가요?"})
print(result)
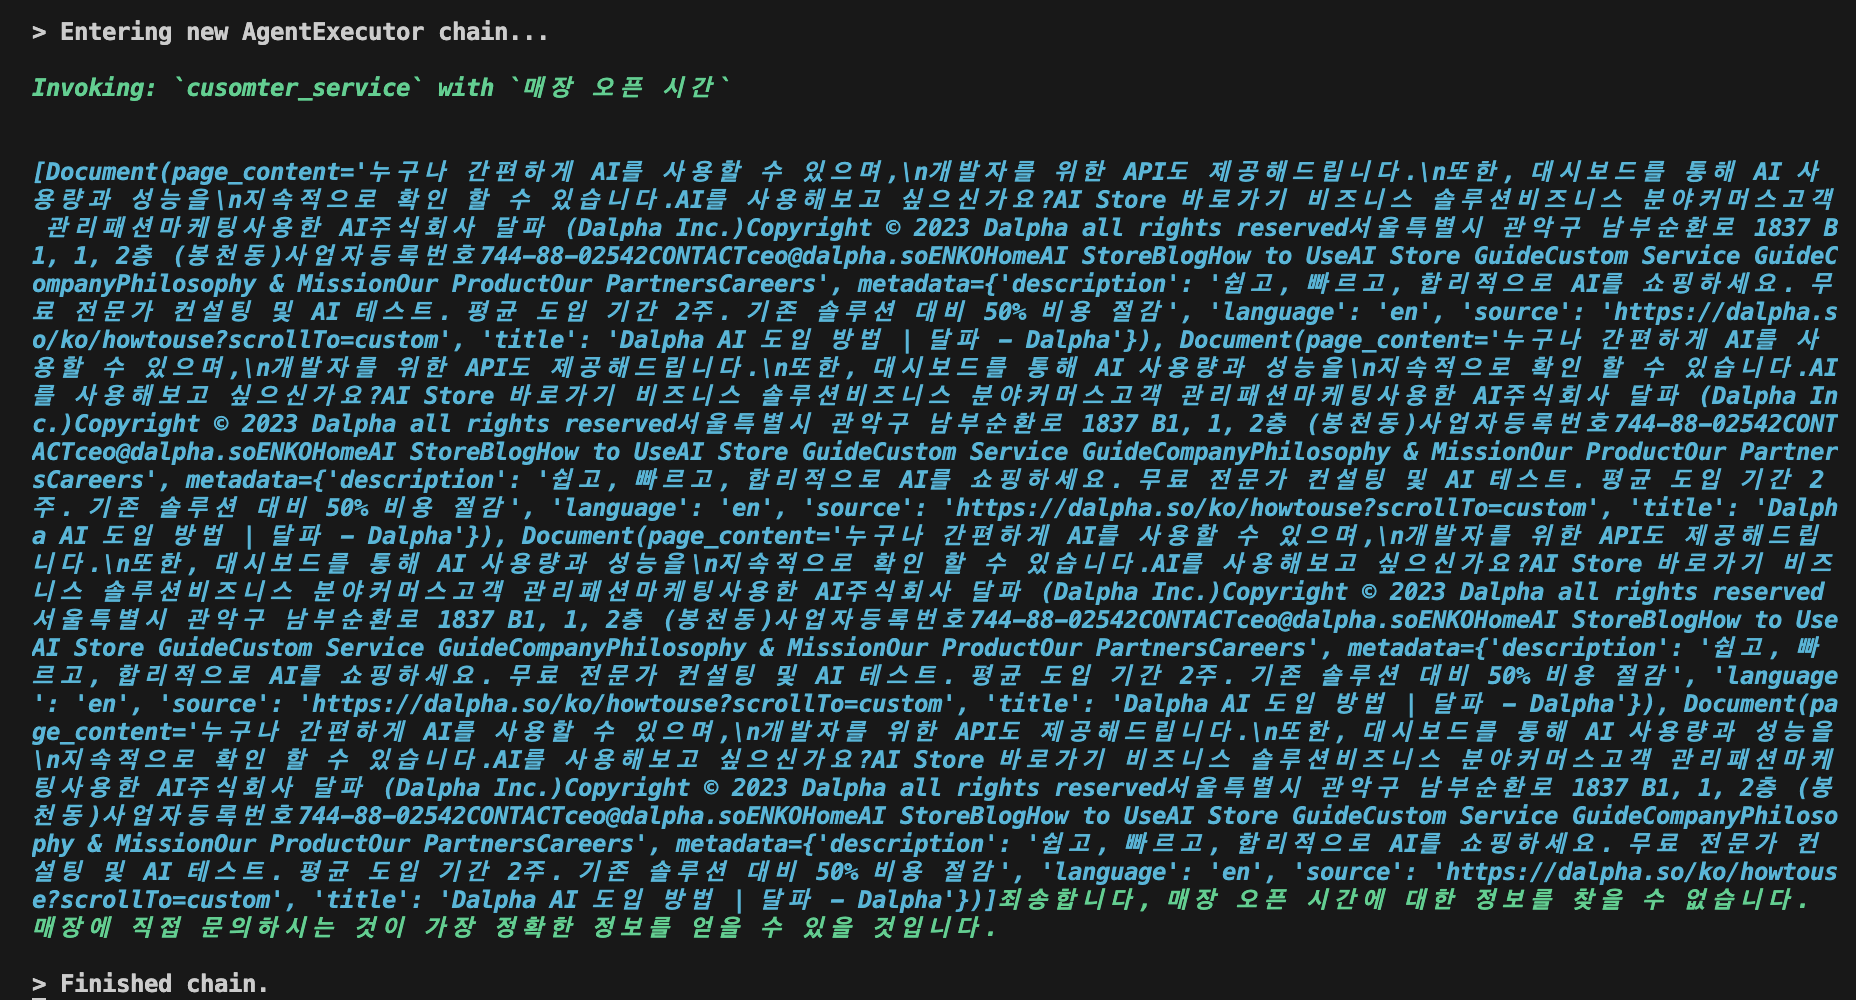
상품과 관련없는 질문을 했을때 거짓된 답변을 생성하는 것이 아닌, 모른다고 답변을 해야합니다. 쏘카와 같은 경우에는 인간 상담원에게 바로 연결할 수 있도록 했어요.
이렇게 백엔드 코드가 완성됐습니다!!
프론트엔드 코드
프론트엔드는 저번 Part 1과 똑같은 형식으로 갈거기때문에 추가 설명은 하지 않을게요.
이 부분만 주석 처리해주세요.
result = agent_executor({"input": "매장 오픈 시간은 몇시인가요?"})
print(result)
그 다음 코드 블록을 밑에 복붙해주세요.
st.title("AI 상담원")

if "openai_model" not in st.session_state:
    st.session_state["openai_model"] = "gpt-3.5-turbo"

if "messages" not in st.session_state:
    st.session_state.messages = []

for message in st.session_state.messages:
    with st.chat_message(message["role"]):
        st.markdown(message["content"])

if prompt := st.chat_input("What is up?"):
    st.session_state.messages.append({"role": "user", "content": prompt})
    with st.chat_message("user"):
        st.markdown(prompt)

    with st.chat_message("assistant"):
        message_placeholder = st.empty()
        full_response = ""
        # 여기서 위에서 만든 LLM 에이전트를 실행시킵니다. 유저 prompt가 인풋으로 들어갑니다.
        result = agent_executor({"input": prompt})
        for chunk in result["output"].split():
            full_response += chunk + " "
            time.sleep(0.5)
            message_placeholder.markdown(full_response + "▌")
        message_placeholder.markdown(full_response)
    st.session_state.messages.append({"role": "assistant", "content": full_response})
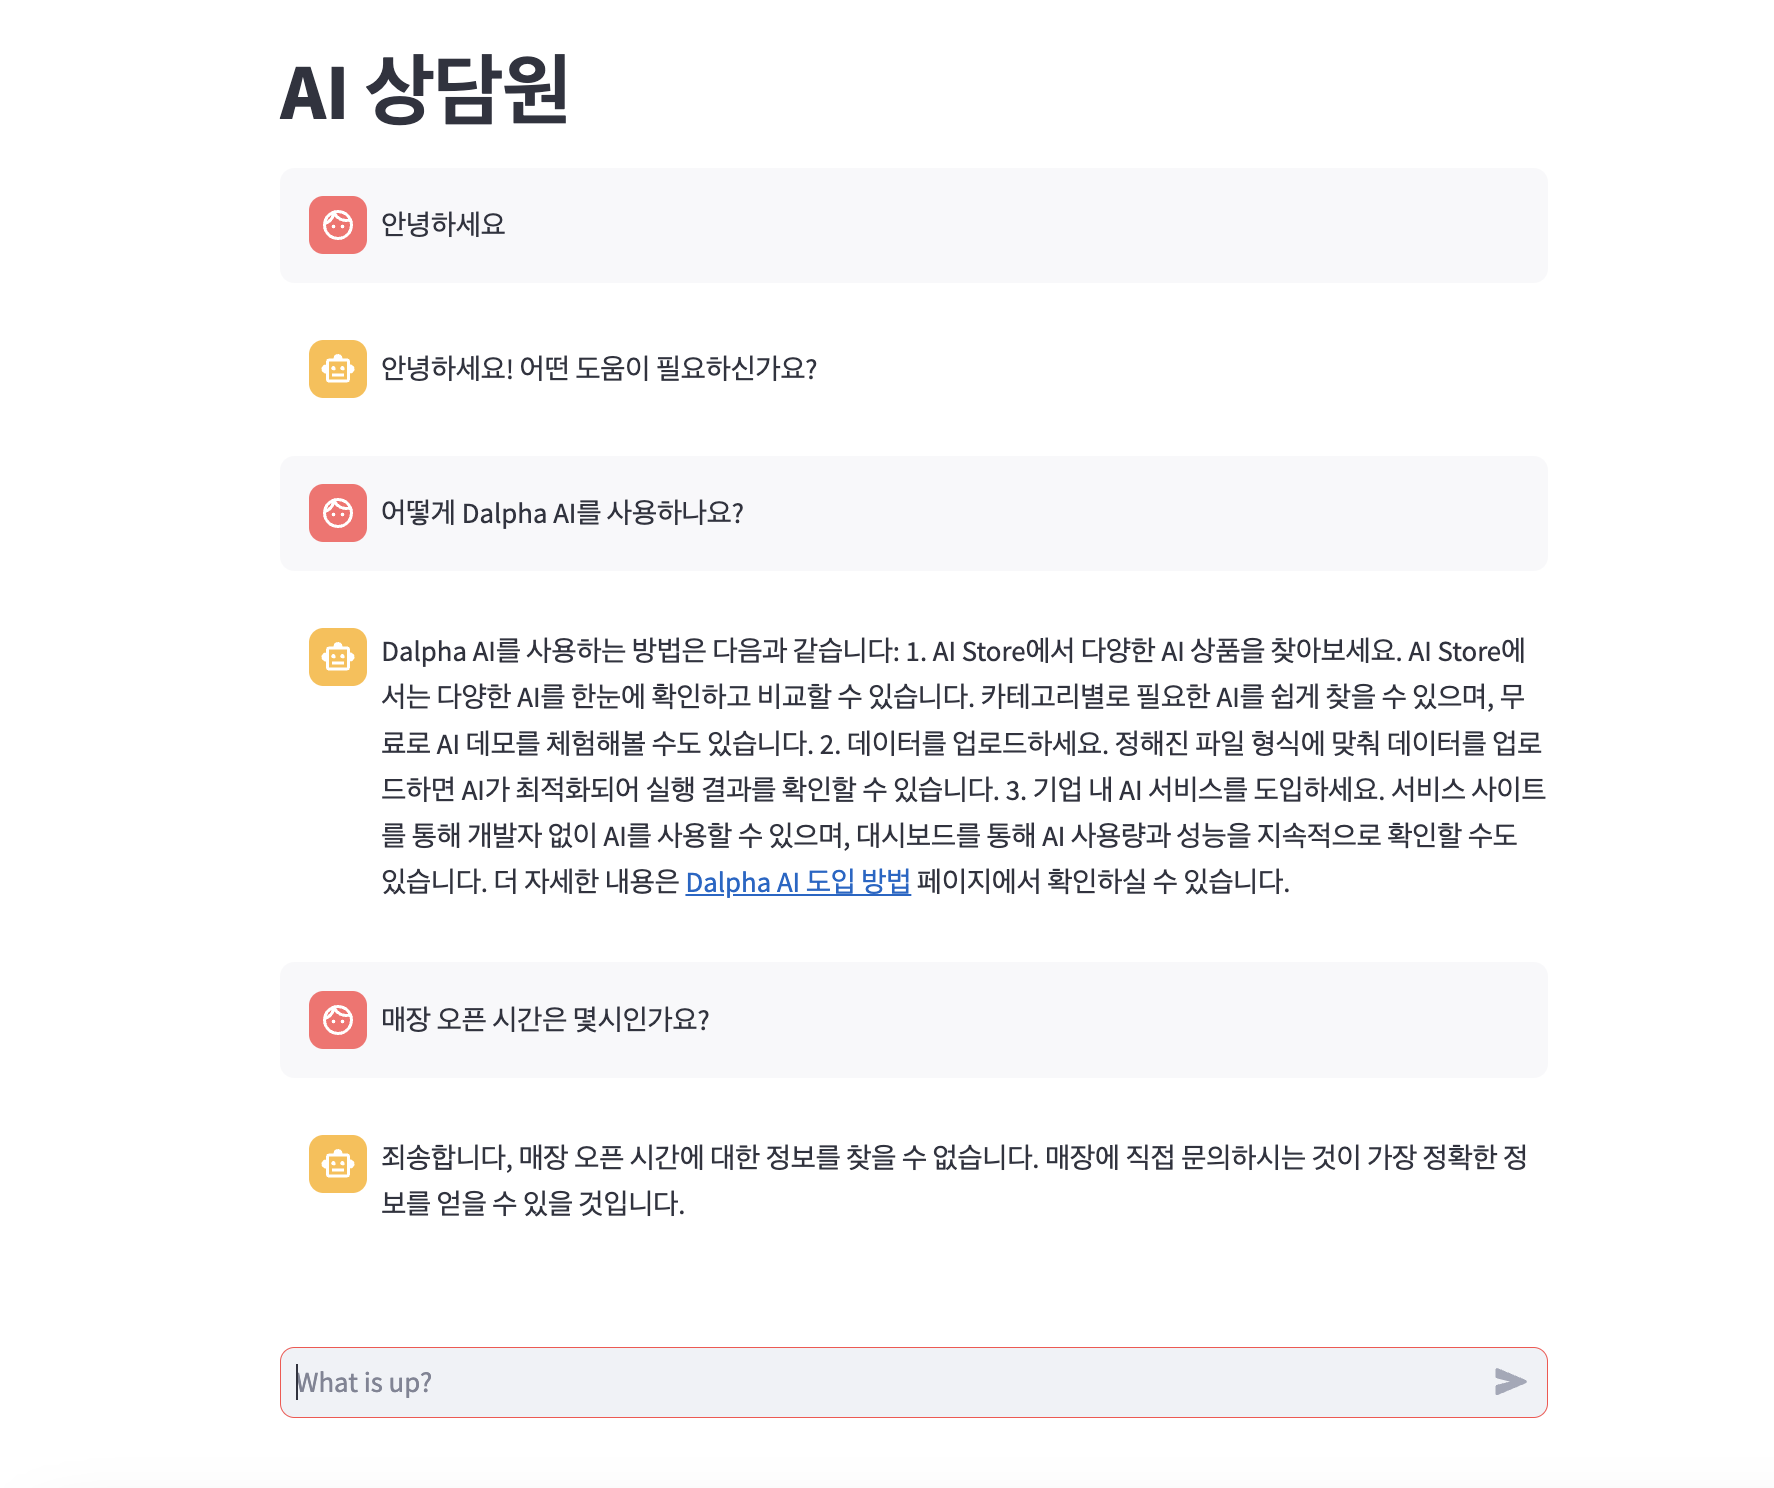
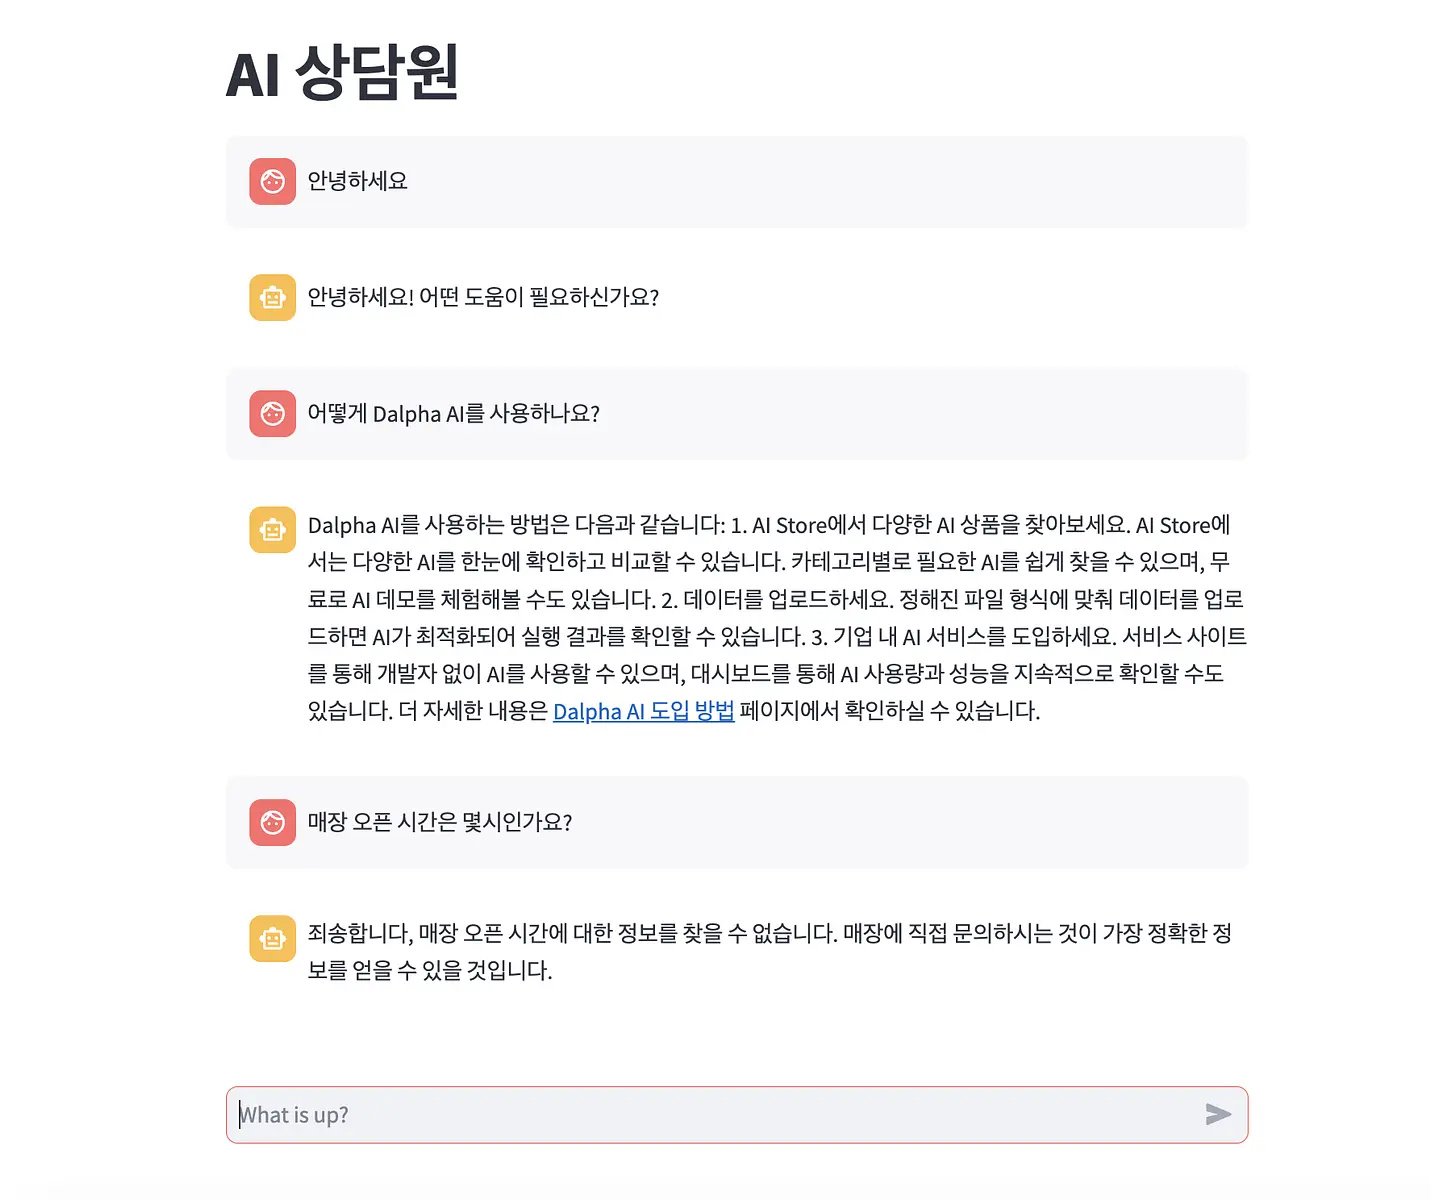
다 저장후 터미널에서 streamlit run chatbot.py를 하시면 다음 화면이 뜨고 바로 테스트해볼 수 있습니다!
마무리
이렇게 RAG를 활용한, 할루시네이션까지 처리해주는 고객 상담 챗봇을 만들어봤어요.
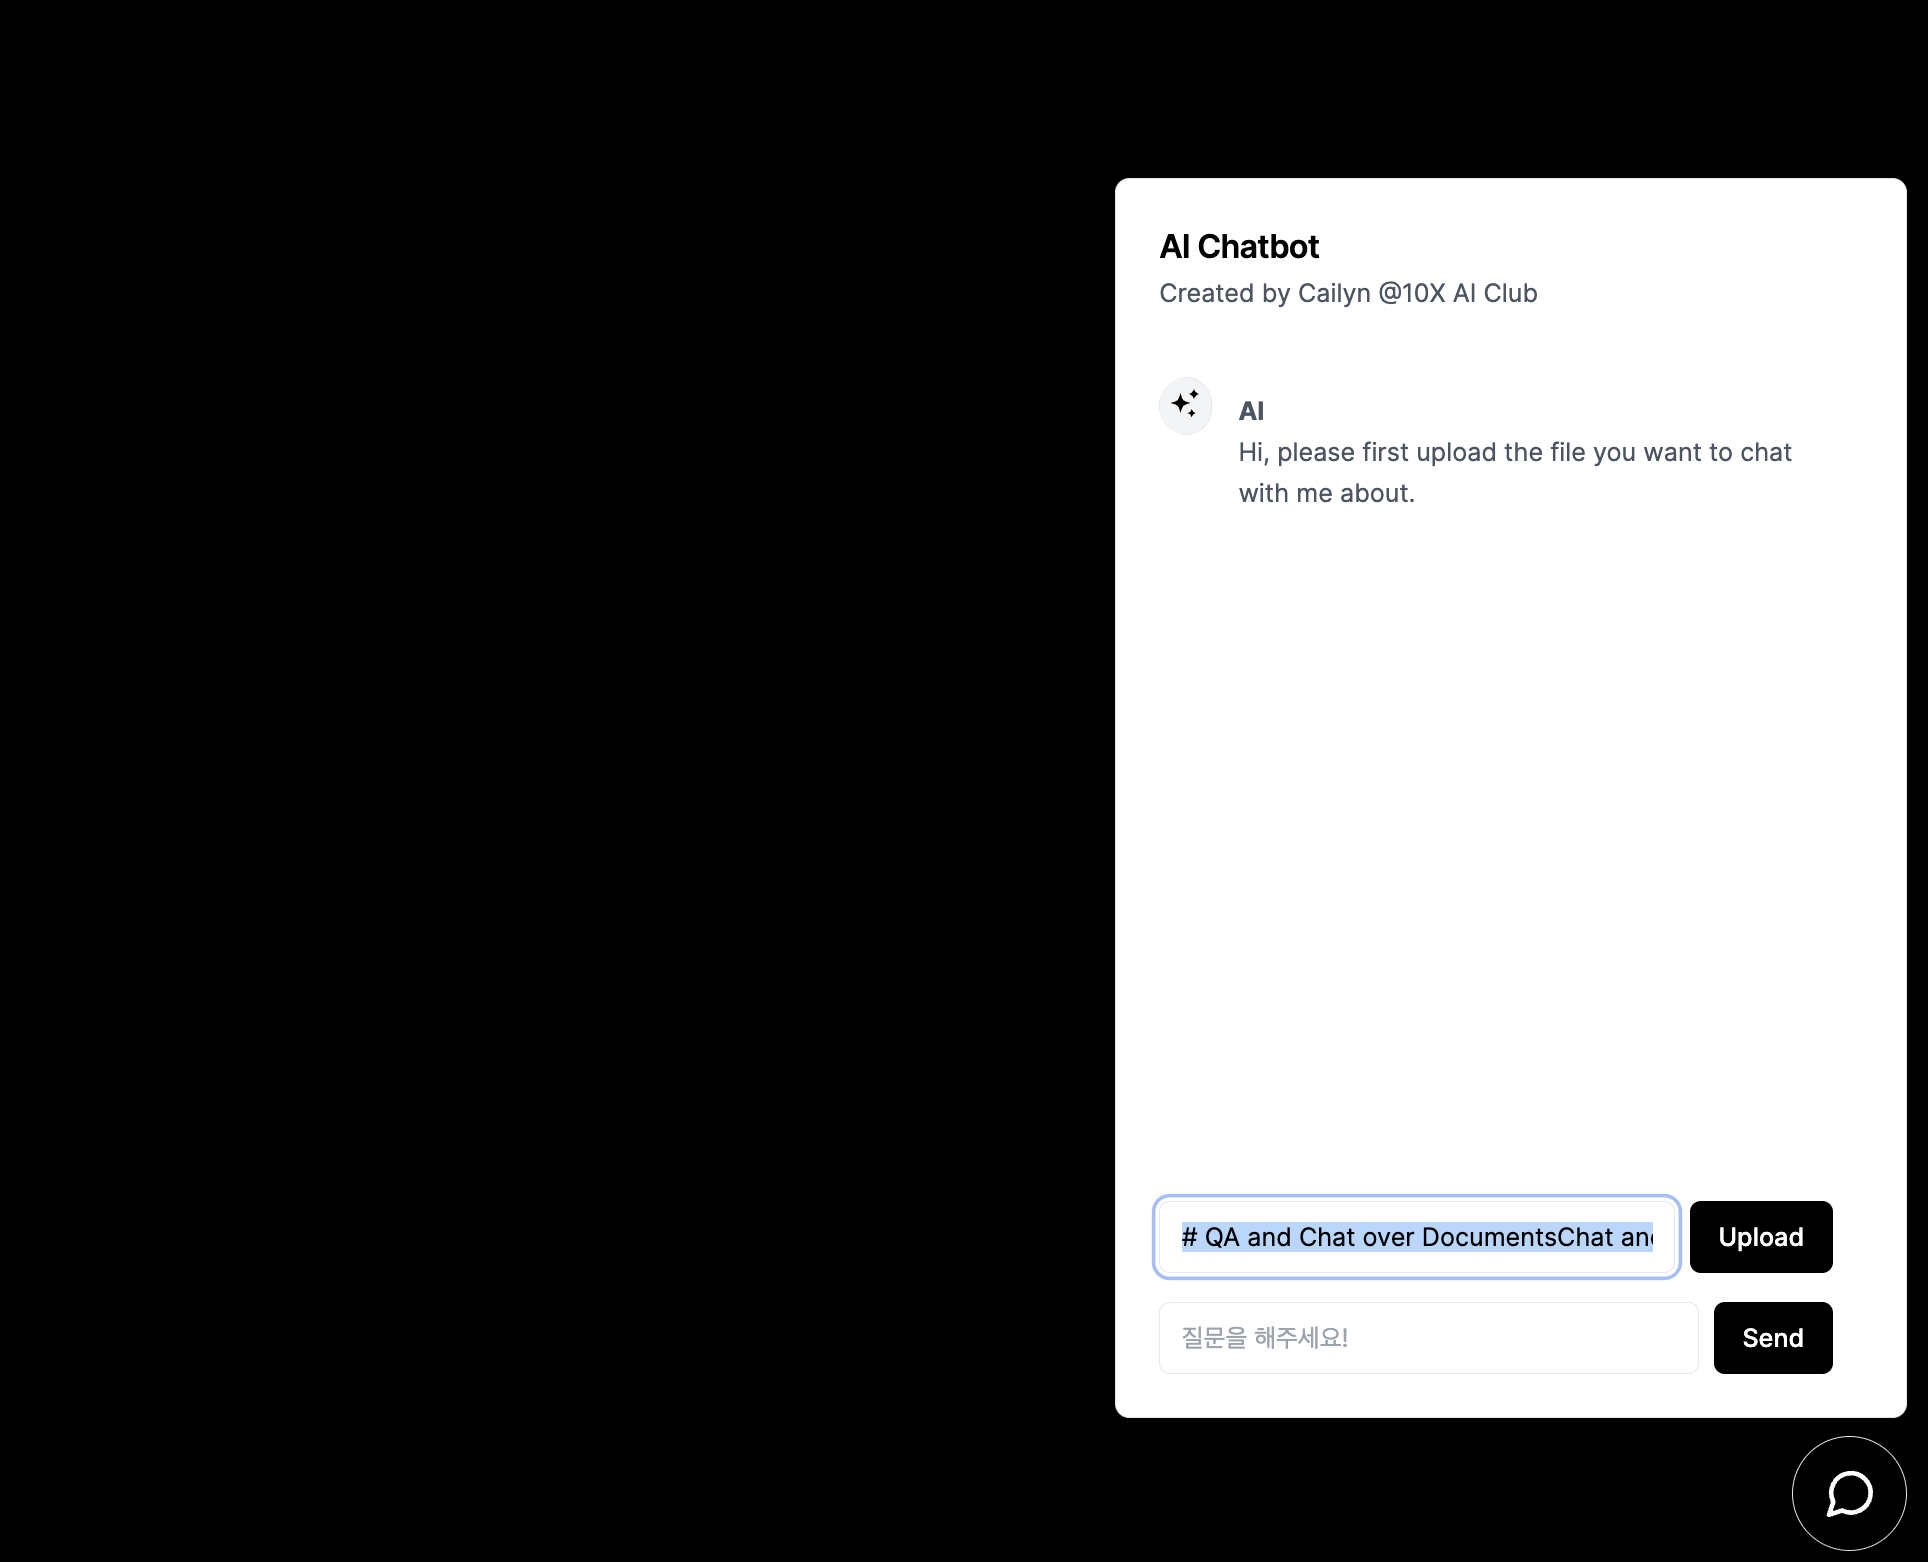
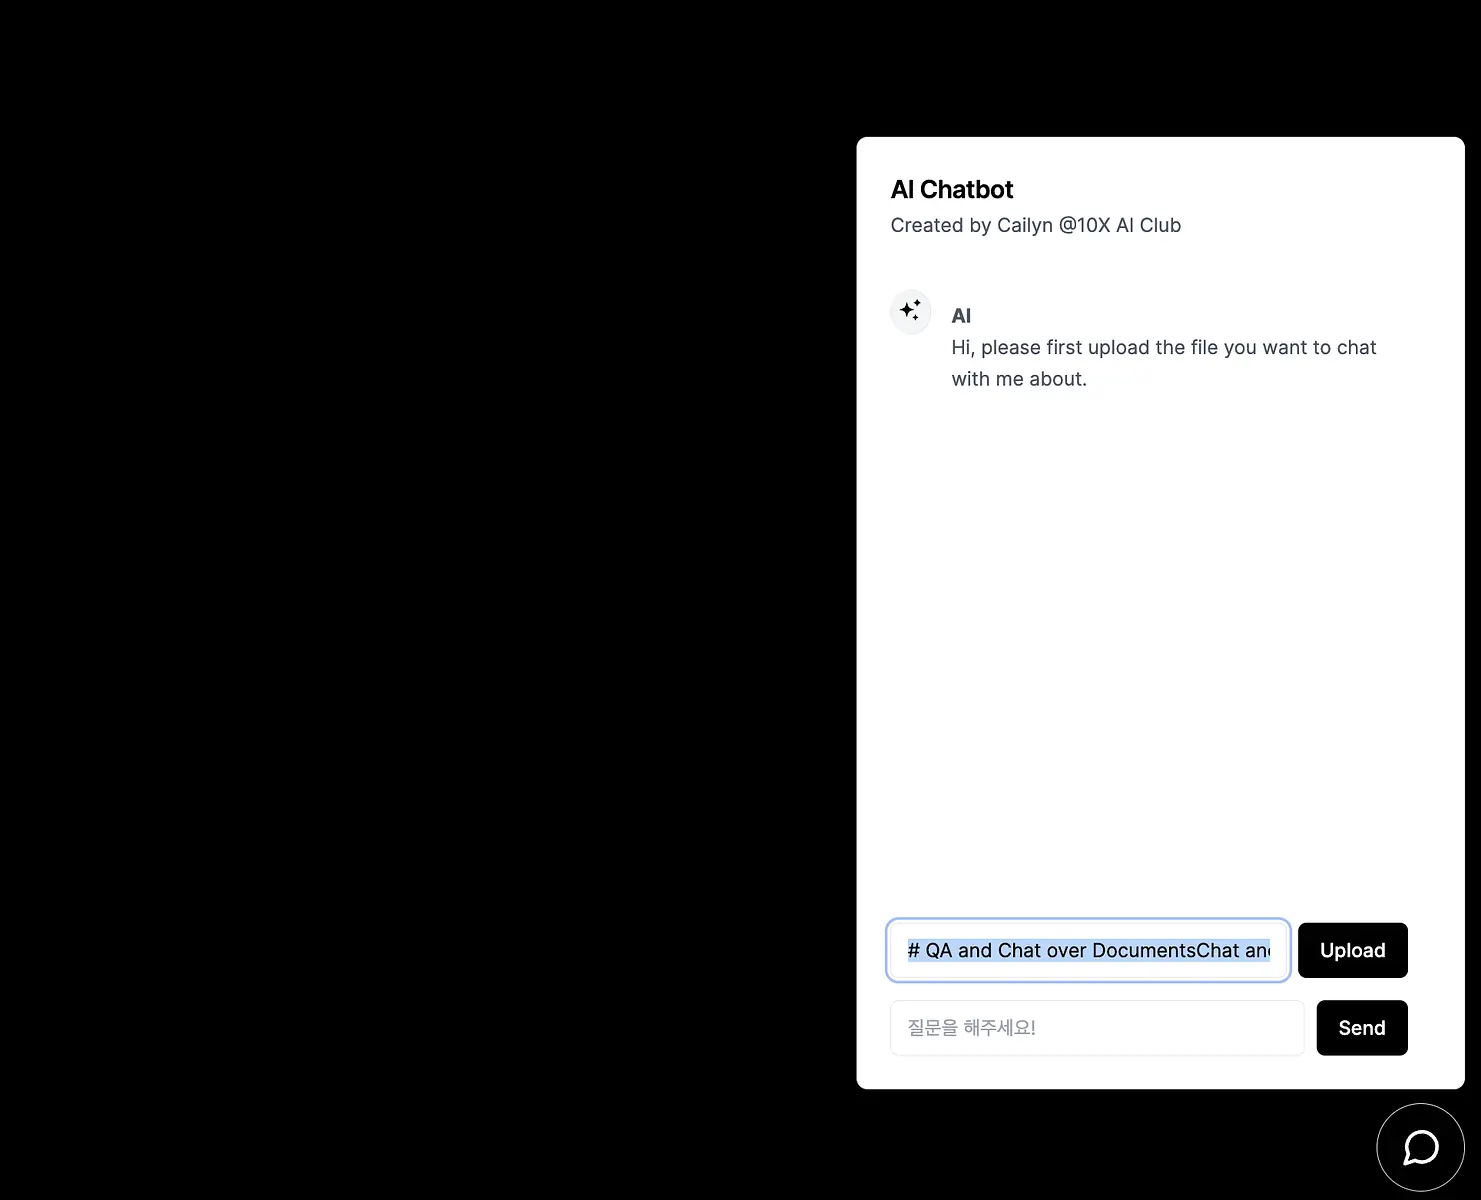
조금 더 예쁜 프론트엔드로 된 챗봇 코드를 받아보고 싶다면 위 링크에서 Week 3 챗봇만 따로 수강하실 수 있습니다! 프론트엔드가 더 잘 구현된 챗봇은 아래 이미지처럼 생겼습니다. 챗봇 아이콘을 누르면 대화 창이 팝업이 되고 다른 곳을 누르면 팝업이 사라지는 UX입니다. 원하는 다큐먼트 텍스트를 업로드하고 그와 관련된 Q&A를 할 수 있는 챗봇이에요!
마지막으로 따로 자신의 비즈니스에 이런 고객 서비스 챗봇을 연동시키고 싶으면 아래 Tally form에서 문의 받습니다.
오늘도 긴글 읽어주셔서 감사합니다!
댓글
로그인 후 댓글을 남길 수 있습니다.
꺄악 기다리고 있었어요. 잘 배워보겠습니다. 수고하셨고, 감사해요!
참, document는 chroma db에 permanently stored되는건지 궁금합니다.
흠 좋은 질문입니다. 저도 한번 알아봐야겠어요...
참고로 원본 코드 파일을 받고 싶으시다면 제 Github에서 확인하세용: https://github.com/cailynyongyong/chatgpt 여기서 customer-service.py 파일입니다 :)
이 강의는 무료입니까? 당장 지불해야 한다 내 지갑에서 돈을!
5000원 커피후원 감사하겠습니다
오 저희 Dalpha를 예시로 해주셨네요 ㅎㅎ 감사드립니다! 이렇게 간단하게 챗봇을 만드는 방법이 있다는 것도 매우 흥미롭네요 :) 좋은 글 잘 읽었습니다!
감사합니다!! :)
즉석 코딩 하시는 과정을 보여주시니 코린이가 쉽게 알 수 있네여 ^^ customer-service.py 파일 다운로드 해서 설치하고, 동작확인 하였습니다. => 약간 반응속도가 느린 점 있는데, time.sleep(0.05)을 수정해서 test해 보겠습니다. ^^
잘 이해하셨다니 다행입니다 ㅎㅎ 네 반응속도가 좀 느리더라구요 ㅠ