LLM 스터디 #4
LLM 스터디를 하면서 개괄적으로 파악한 내용
우선 CNN이나 RNN 기반일 때까지만 해도 메모리 문제로 인해 정확한 대용량 언어 처리가 불가능 했습니다. 입력 시퀀스를 하나의 벡터 표현으로 압축해서 사용했는데, 이로 인해 정보 손실이 발생했던 것으로 추측됩니다. 그러나 Transformer 모델이 등장하고 나서 실질적으로 LLM이 가능해진 것으로 생각됩니다.
또한 Transformer 모델은 Attention Mechanism만으로 기존의 CNN, RNN 의존도를 없애려고 했습니다. 따라서 RNN으로 파악했던 언어의 위치 정보를 Positional Encoding이 대신하게 된 것이죠. 그리고 기존의 Attention Mechanism과 동일하게 언어 사이의 관계 및 중요도를 Attention Value로 기술을 합니다. 토큰들의 위치 정보(via Positional Encoding)와 매 출력 마다 집중해서 참고해야 할 입력 토큰들(via Attention Mechanism)로부터 입력된 토큰들의 시퀀스 다음에 올 토큰이 무엇인지 예측을 하게 됩니다.
다시 정리해보자면.... (스킵하셔도 됩니다)
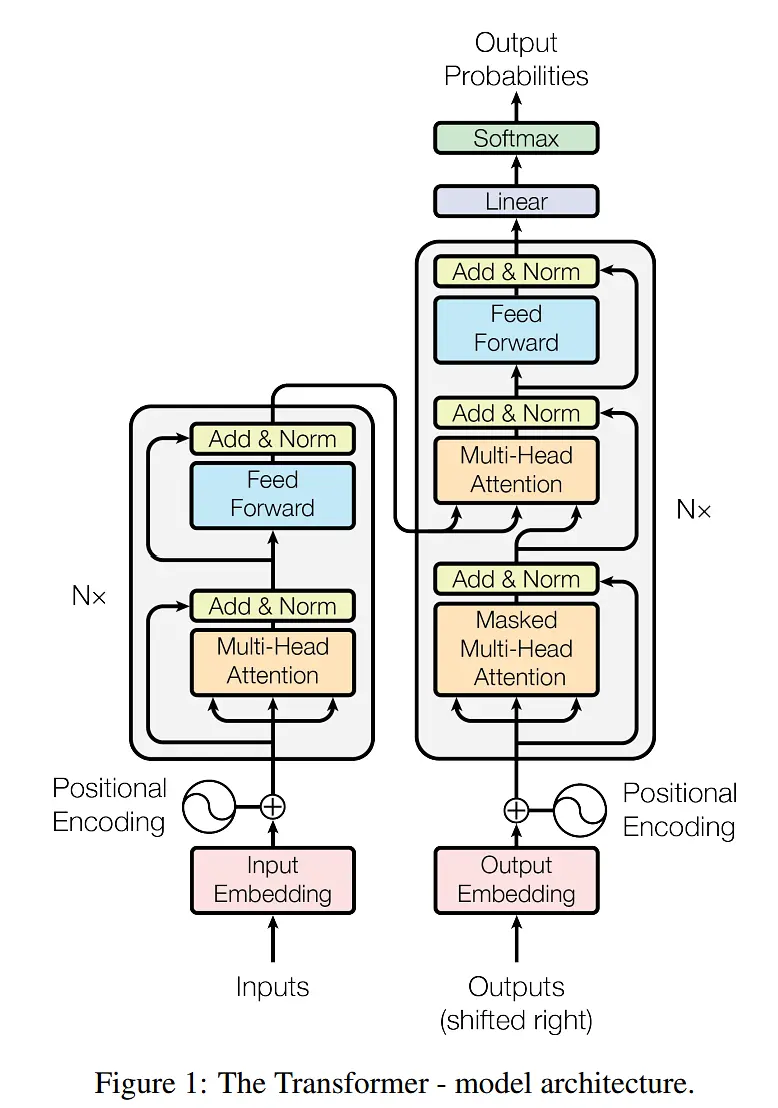
Transformer Model 모식도 입니다.
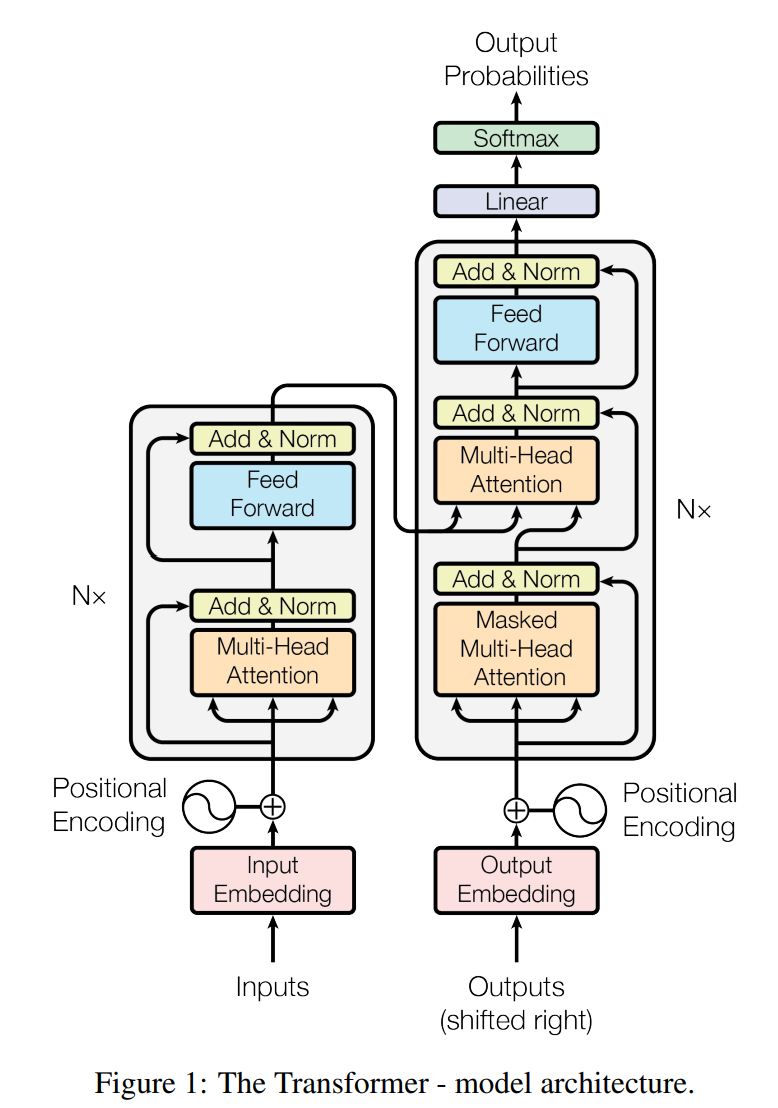
좌측이 Encoder, 우측이 Decoder입니다.
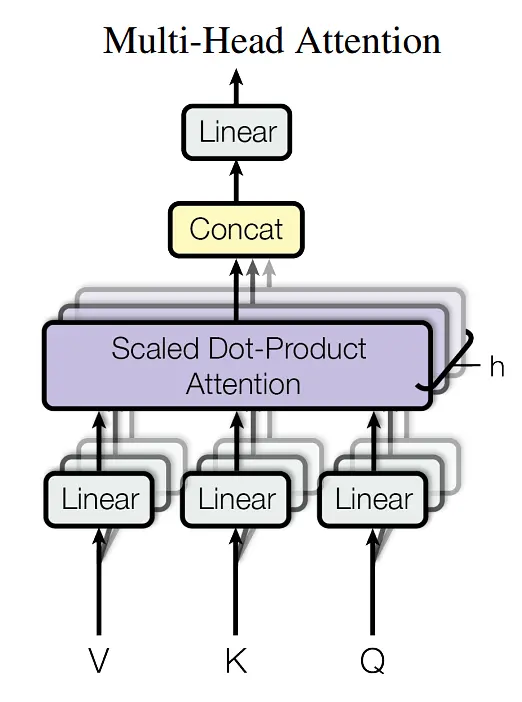
Multi-Head Attention 모식도입니다.
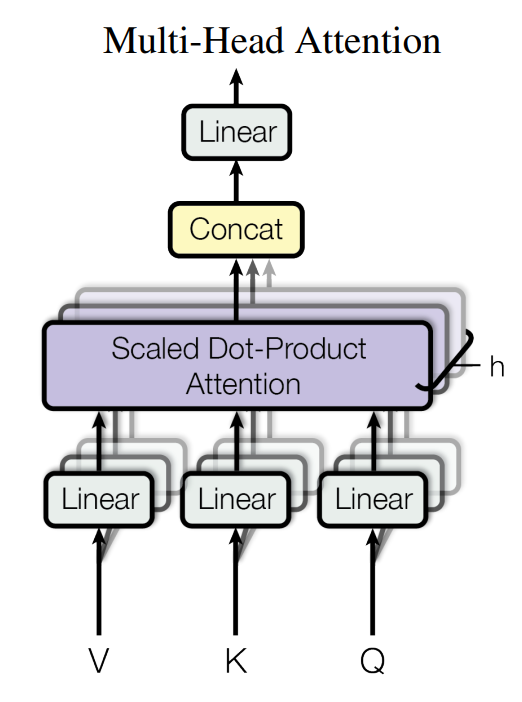
Encoder에서 Key, Value, Query 값은 각각 의미하는 바는 다음과 같습니다.
Key: 입력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)
Value: Key와 동일한 값
Query: Key와 동일한 값
Attention Value Matrix:
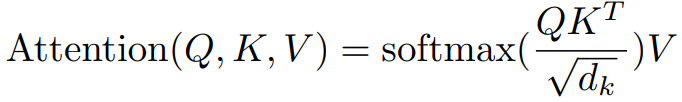
Decoder에서의 Masked Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.
Key: 출력 시퀀스의 tokenize된 수치 (입력된 문장의 단어들을 위치 벡터로 라벨링)를 64차원으로 변환 (d_model=512, num_head=8이기 때문)
Value: Key와 동일한 값
Query: Key와 동일한 값
Attention Value Matrix
Decoder에서의 Self Attention에서 Key, Value, Query 값의 의미는 다음과 같습니다.
Key: Encoder에서 Attention Value Matrix
Value: Encoder에서 Attention Value Matrix
Query: Decoder에서 Attention Value Matrix
이상... 크게 특별할 건 없었던 LLM 스터디를 일단락 지어보도록 하겠습니다..(꾸벅)
다양한 산업들에서 Transformer 모델을 활용하여 다양한 Task들이 비교적 손쉽게(?) 처리될 수 있으리라 기대됩니다.
< 참고 논문 >
Attention Is All You Need
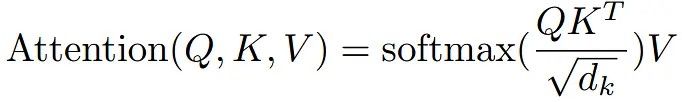
댓글
로그인 후 댓글을 남길 수 있습니다.
아~ 그 뜻이구나~