뒤로
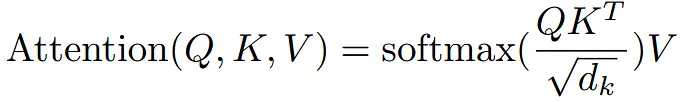
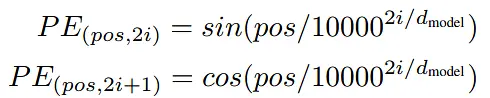
임세진
·
LLM 스터디 #3
트랜스포머 모델 아키텍쳐
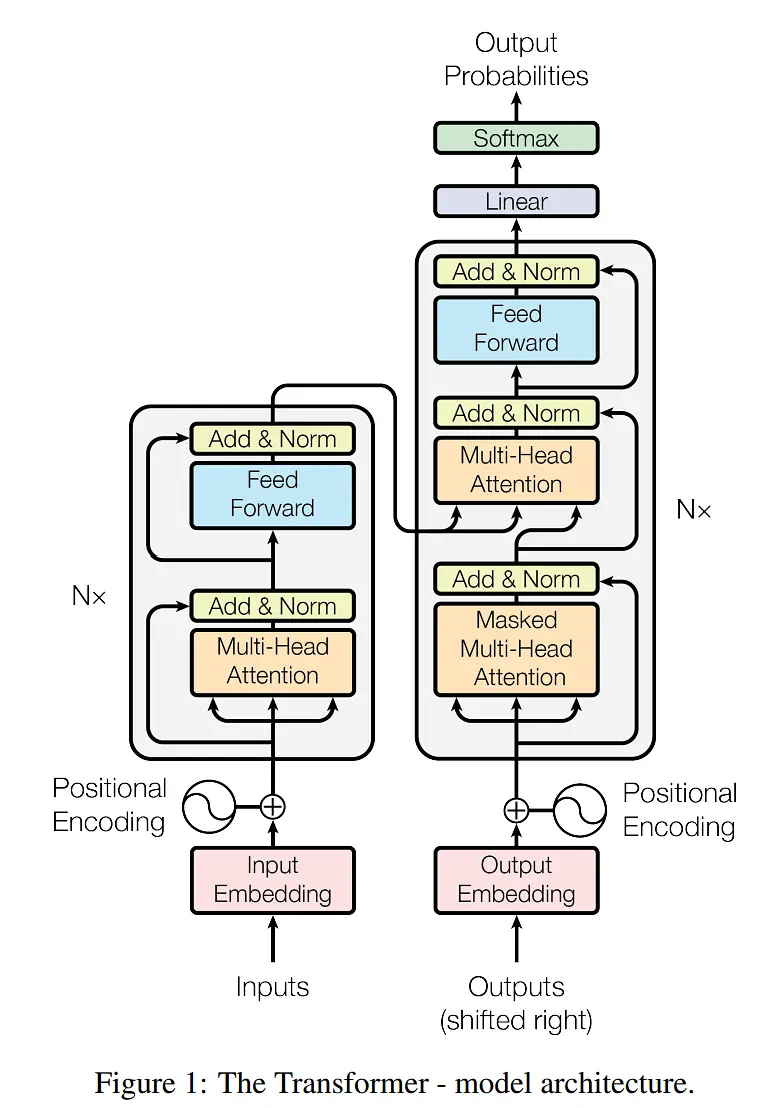
1. Inputs & Outputs
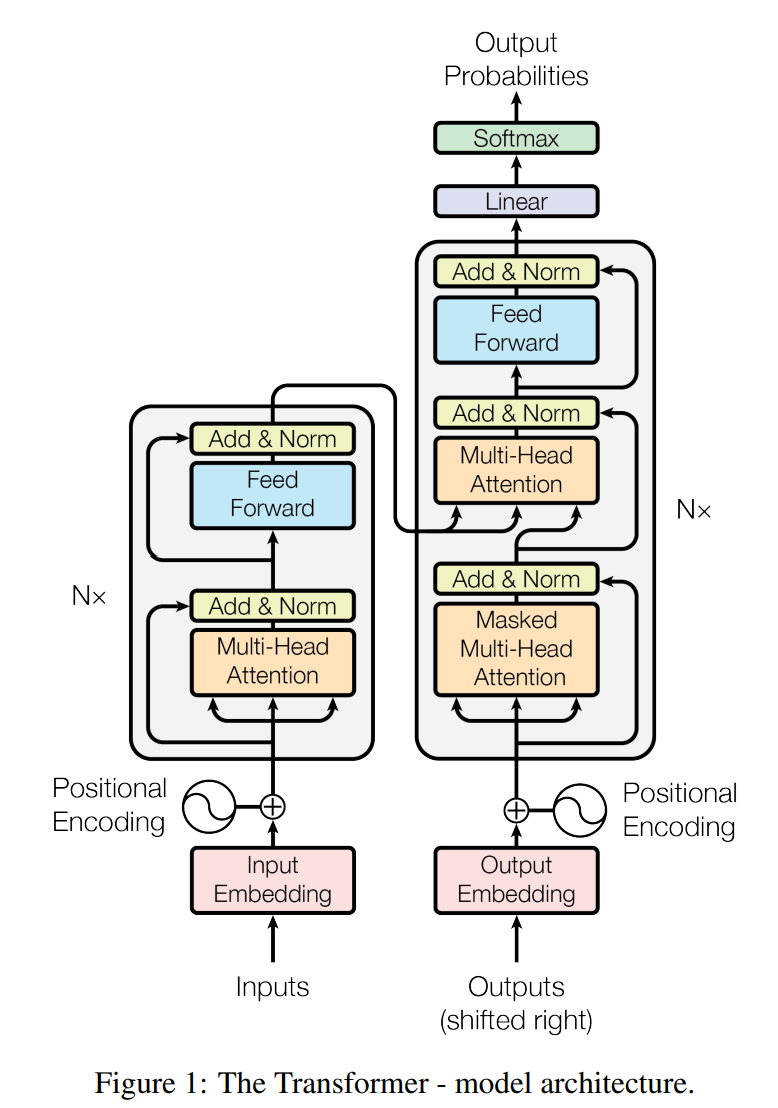
입력 시퀀스: (x_1, ..., x_n)
Encoder 결과물(hidden layer): (z_1, ..., z_n)
출력 시퀀스: (y_1, ..., y_m)
위의 트랜스포머 모델에서 좌측이 Encoder, 우측이 Decoder에 해당됨
2. Multi-Head Attention
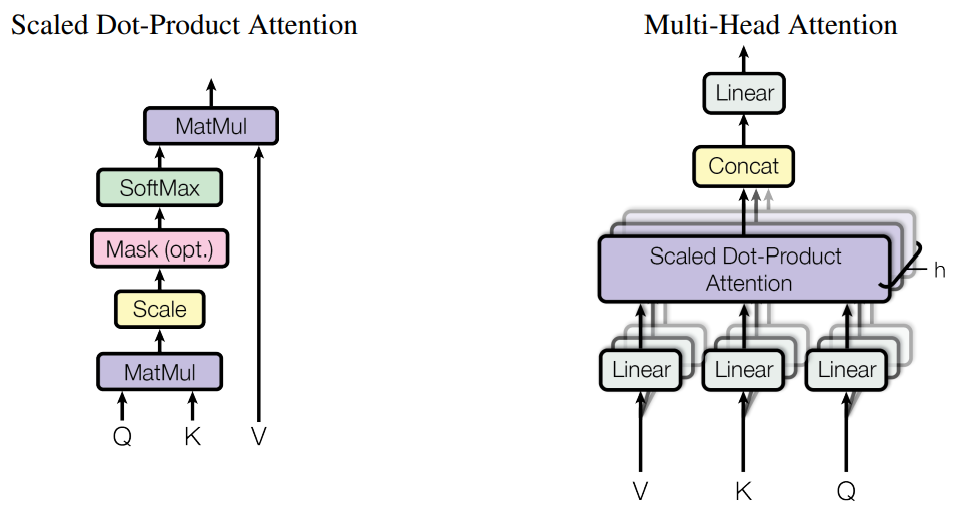
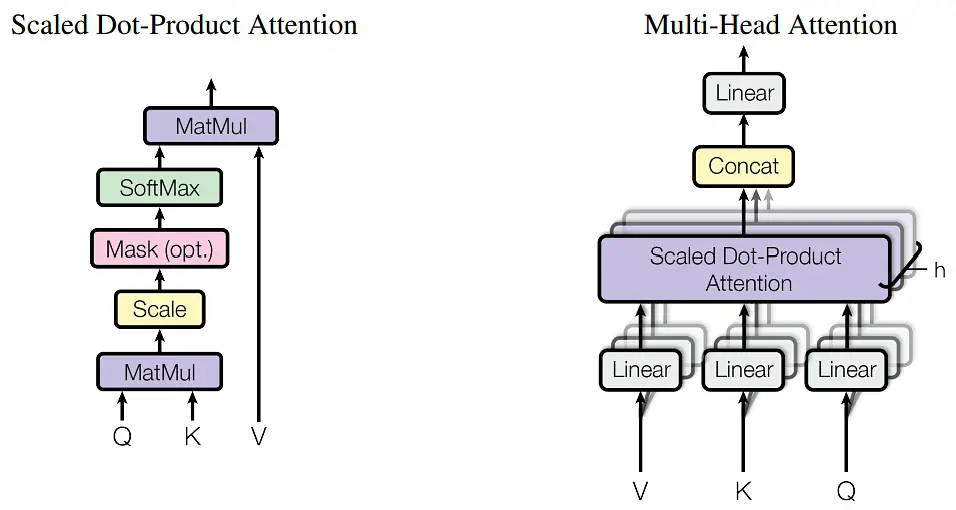
Scaled Dot-Product Attention
Q: 쿼리 값(문장 속 낱말들을 임베딩 한 결과), K: key 값(낱말들에 대한 정보를 제공하는 값) , V: value 값(key 값의 의미를 수치 값으로 갖고 있음)
keys의 차원: d_k
values의 차원: d_v
각 토큰을 임베딩하는 차원: d_model (d_model 차원의 vector로 문자들을 구분할 수 있다.)
h: 평행한 어텐션 레이어 개수
이 연구 논문에서는 d_k = d_v = d_model / h = 64, h = 8로 두었다. (d_model = 512)
Scaled Attention을 수식으로 간단하게 표기 :
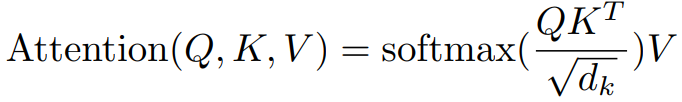
3. Positional Encoding
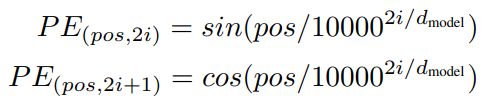
Positional Encoding을 통해 문자들의 위치를 d_model 차원의 좌표(위치 벡터)로 변환하여 표현할 수 있다.
그리고 해당 위치에 있는 문자가 바뀌어도 Positional Encoding의 결과물은 바뀌지 않는다. (위치에만 종속되어 있는 값이다)
pos: 시퀀스 내의 임의의 토큰의 위치
i: d_model 차원 이하의 차원
10X AI Club
그룹의 글
12
댓글
로그인 후 댓글을 남길 수 있습니다.
조..조금만 더 쉽..게......!
ㅠㅠ 알겠습니다~~
ㅋㅋㅋ 잘 읽었습니다
조금 정리가 안되어서 그런가봐요..ㅠㅠ