챗GPT로 9,000명 가량의 잠재 고객DB를 얻은 방법과 프롬프트 팁
AI, 어디까지 사용하고 계시나요?
저는 매일매일 씁니다. 특히 번역 맡길 때 좋더라고요. 가끔씩 영작이 궁금할 때나 문법, 단어 등을 물어보면 적절한 예시와 함께 잘 설명해 주더라구요.
일할 때도 종종 쓰는 편인데요. 저는 PO라 종종 노가다를 해야 할 때가 있습니다. 그때 AI가 탁월한 성능을 보여줍니다. 실제로 챗GPT를 어떻게 활용했는지, 그리고 경험에서 얻은 프롬프트 팁을 공유해 보려 합니다.
01. 목적 정의하기
기자 인터뷰를 위해 기자들의 이메일 정보를 수집해야 했습니다. 찾아보니 언론사만 88개에 언론사별 소속 기자만 100명이 넘었습니다. 어림잡아 8800명이죠. 이 기자들의 정보를 한 땀 한 땀 취득하는데 걸리는 시간이 10초라고 가정하면 88,000초, 24시간이 조금 넘습니다.
챗GPT를 활용하기로 했습니다.
목적은 '기자 이메일 정보를 수집하기'로 합니다.
02. 출력값 설정하기
네이버 뉴스에 들어가니 언론사별 기자 상세 페이지가 있더라고요. 이를 참고해 출력값을 아래와 같이 설정했습니다.
No / 기자명 / 언론사명 / 기자 이메일주소
1 / 김길동 / 김나라일보 / kimgildong@kimnara.kr
....
출력값을 정하는 것이 중요합니다. 프롬프트는 출력값에서 역으로 만들어가야 합니다.
03. 디렉토리 구조 파악하기
디렉토리는 출력값을 가져올 위치입니다. 웹페이지에서 가져온다면, 해당 url의 구조를 파악해야 합니다.
출력값은 '기자 상세페이지'에 있고, 해당 페이지 URL은 아래 예시와 같습니다.
https://media.naver.com/journalist/022/76945
URL path의 022와 76945는 무엇일까요?
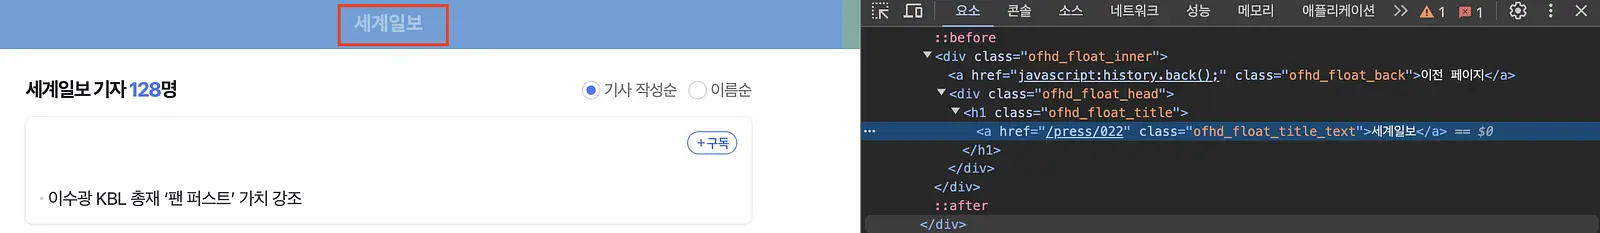
'https://media.naver.com/journalist/022'로 접속해 봅니다. 개발자 도구로 보니 '세계일보'라고 하는군요.
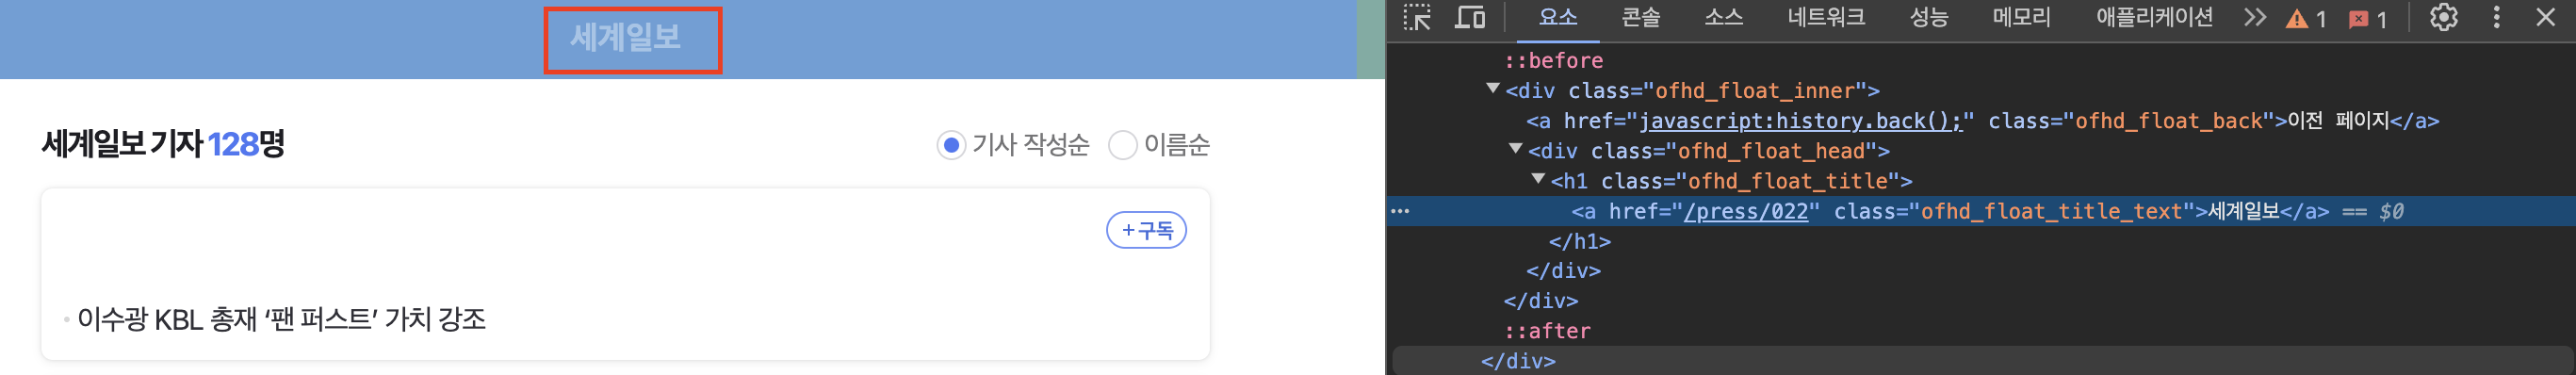
022는 '언론사 id'라는 것을 알 수 있습니다.
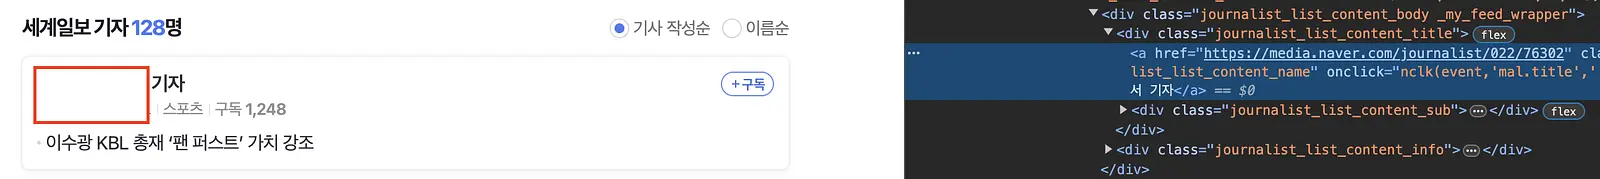
76945는? 역시 개발자 도구에서 기자 이름을 찍어 보면 '기자 상세페이지'로 이동하는 링크가 걸려 있고, 개인마다 고유한 번호로 설정되어 있는 것으로 보아 76945는 '기자 id'라는 것을 알 수 있습니다. 아래 이미지의 기자 id는 76302네요.
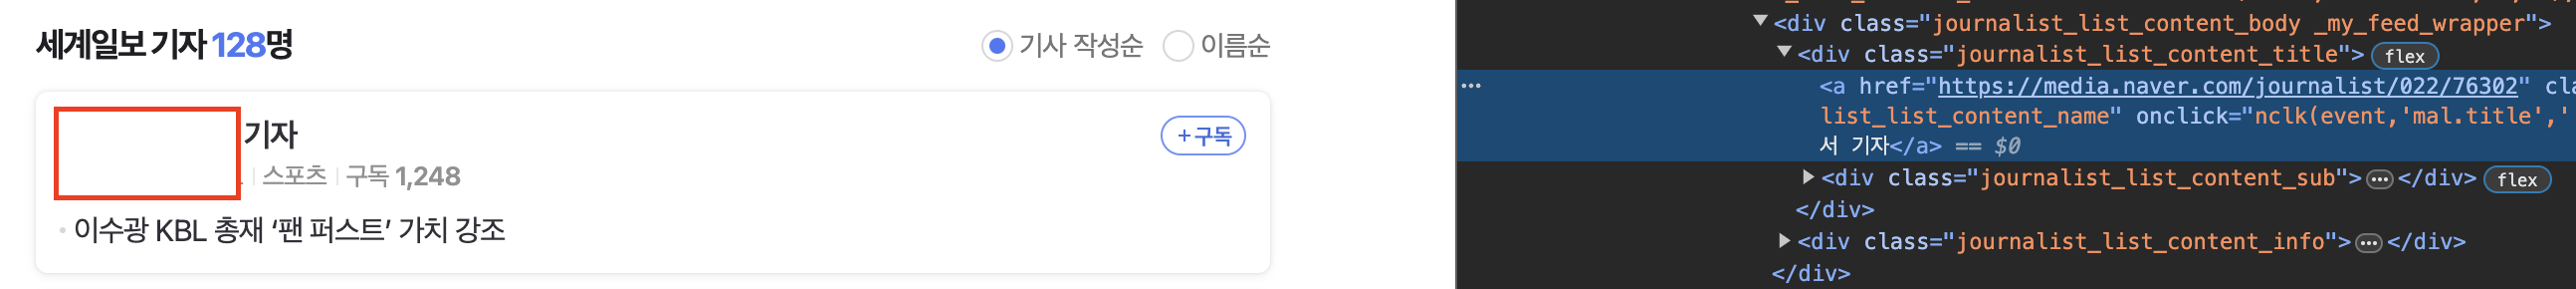
'기자 상세페이지' URL은 https://media.naver.com/journalist/{언론사 id}/{기자 id} 와 같이 구성되어 있다는 것을 파악했습니다.
이제, 본격적으로 프롬프트를 쓸 차례입니다.
04. 1 task per prompt
챗GPT에게 무턱대고 요청하면 원하는 결과값을 얻기 어렵습니다. UX 원칙인 'One thing per page' 원리를 차용합니다. 한 프롬프트에 한 번의 테스크만 맡기는 것이죠. 그러기 위해 테스크를 분할하여 작성해 봅니다.
파악한 디렉토리 구조에 따라 아래와 같이 테스크를 작성할 수 있습니다.
모든 언론사 id를 수집하기
언론사별 기자 id를 수집하기
'기자 상세페이지'에 접속해 출력값 가져오기
2번을 반복하기
테스크 별로 프롬프트를 작성합니다.
(코드 실행 환경은 생략했습니다. 실행 환경 구축부터 'step by step'으로 알려달라고 하면 잘 알려줍니다. 시키는 대로 설치하고, 오류 나면 코드를 복사해서 붙여 넣으면 혼자 분석해서 해결 방법을 알려줍니다.)
Task1
모든 언론사 정보는 'https://media.naver.com/press'에 있더군요.
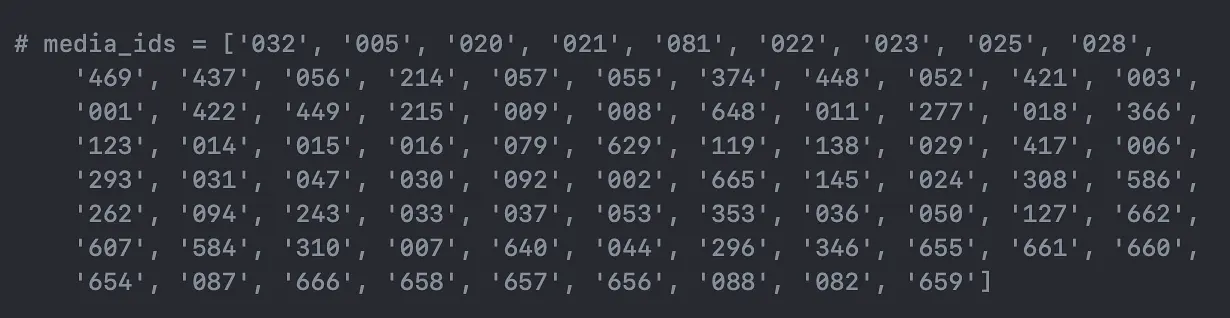
Prompt : 'https://media.naver.com/press'에서 모든 언론사의 id를 배열로 출력해. 언론사 id는 'data-office-id' 속성값이야.
결과는? 'media_ids' 변수에 값을 출력해 줍니다.
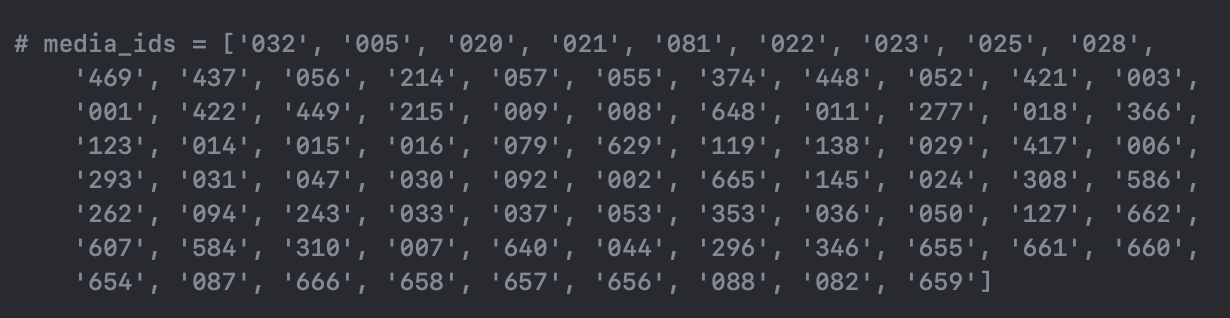
Task1 해결.
Task2&3
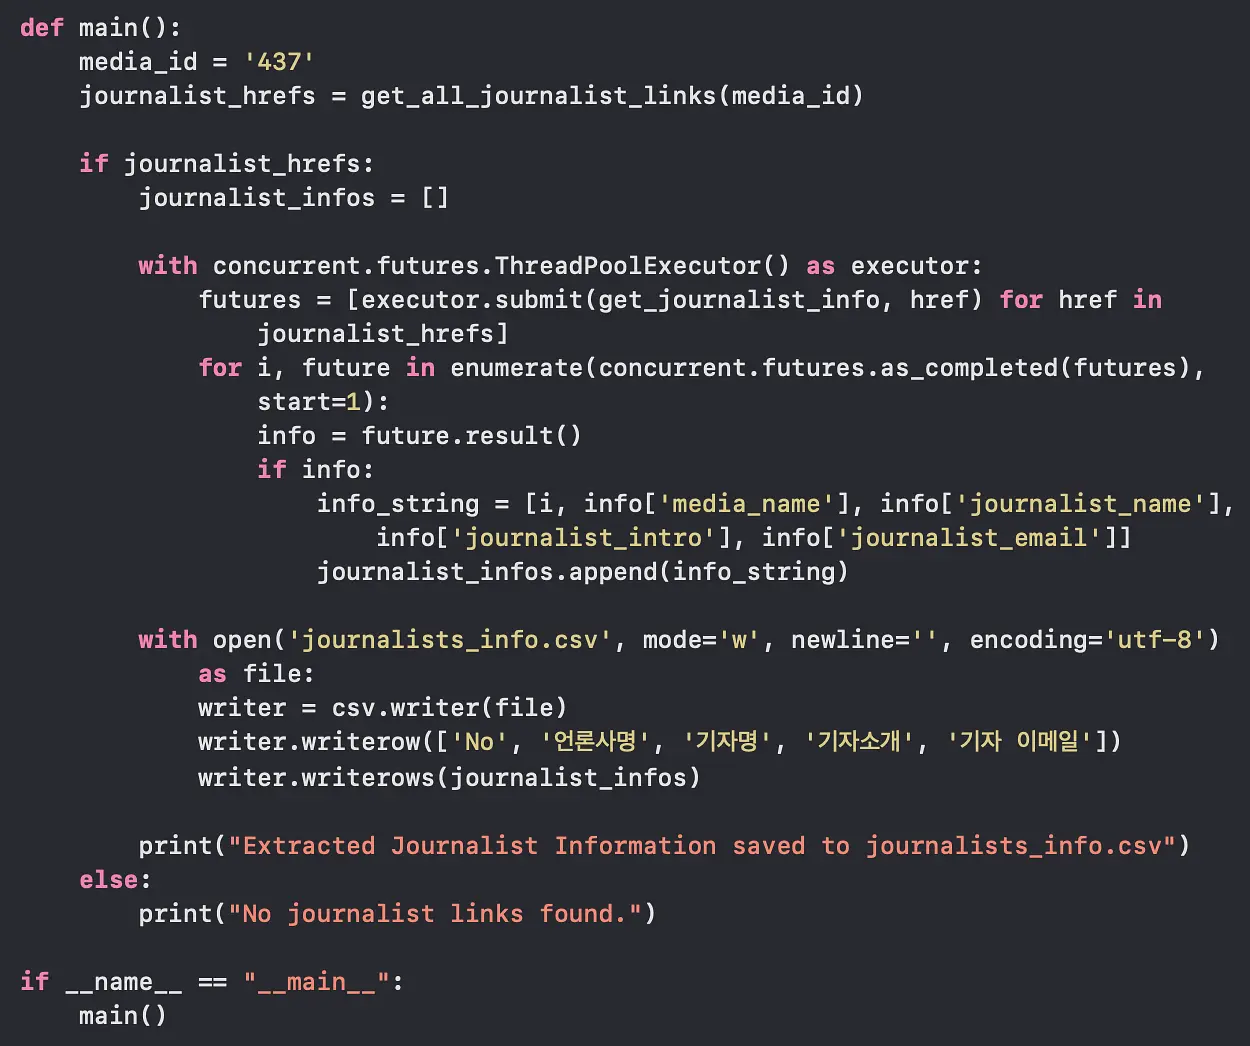
prompt : 'https://media.naver.com/journalist/{언론사 id}' 페이지에서 기자 id를 수집해. 그리고 'https://media.naver.com/journalist/{언론사 id}/{기자 id}'에 접속해서 출력값을 가져와. 출력값의 속성값은 '~~~'야.
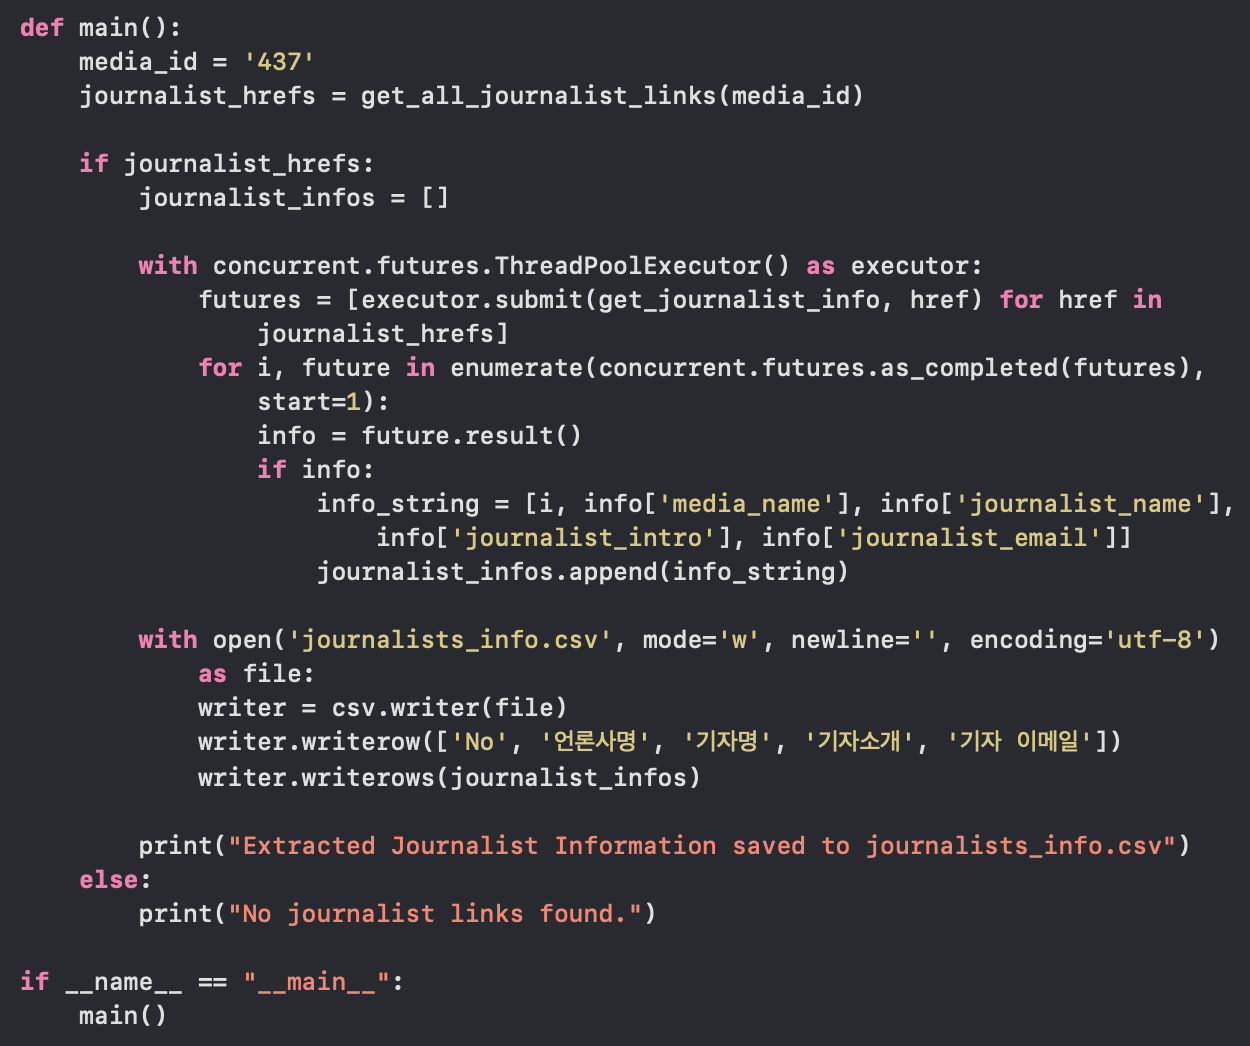
코드 맨 위를 보면 media_id = '437'로 되어 있습니다. 1개의 언론사 id를 넣어서 테스크 결과를 확인해 보는 겁니다.
2&3이 잘 되는 것을 확인했다면?
다음 테스크로 갑니다.
Task4
media_id 변수에 Task1 값을 넣고 코드를 실행합니다. 실제로는 시간이 꽤 오래 걸려서 오류가 생기더라고요. 그래서 5개씩 끊어서 반복 수행했습니다.
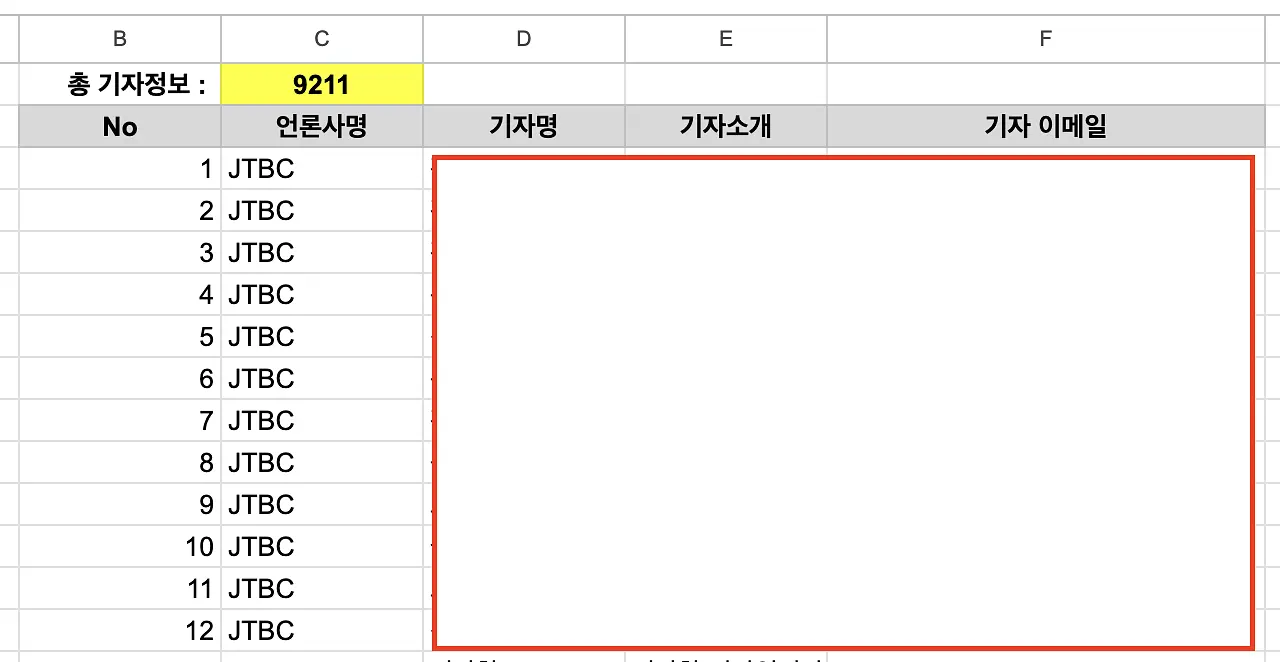
결과는? 총 9,211개의 기자 이메일 정보를 수집했습니다.
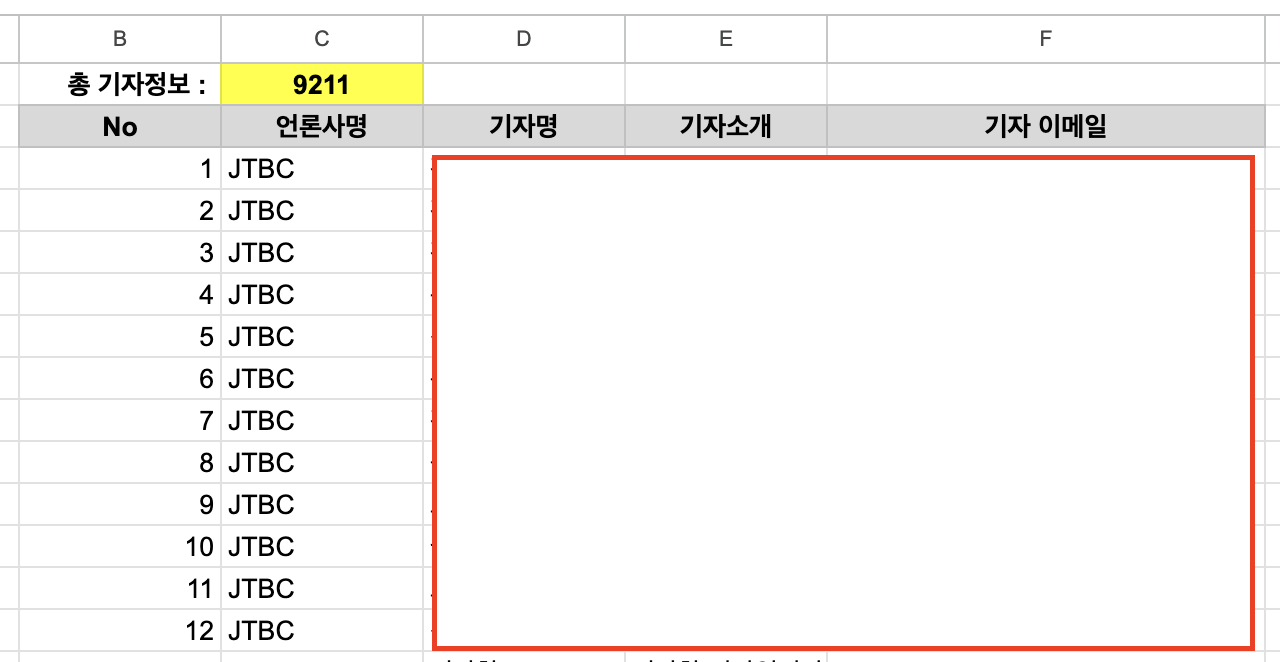
넉넉잡아 한 6시간 걸렸을까요? 24시간을 6시간으로 단축시켰으니 18시간을 아꼈습니다.
Task5. 이메일 발송할 타겟 정하기
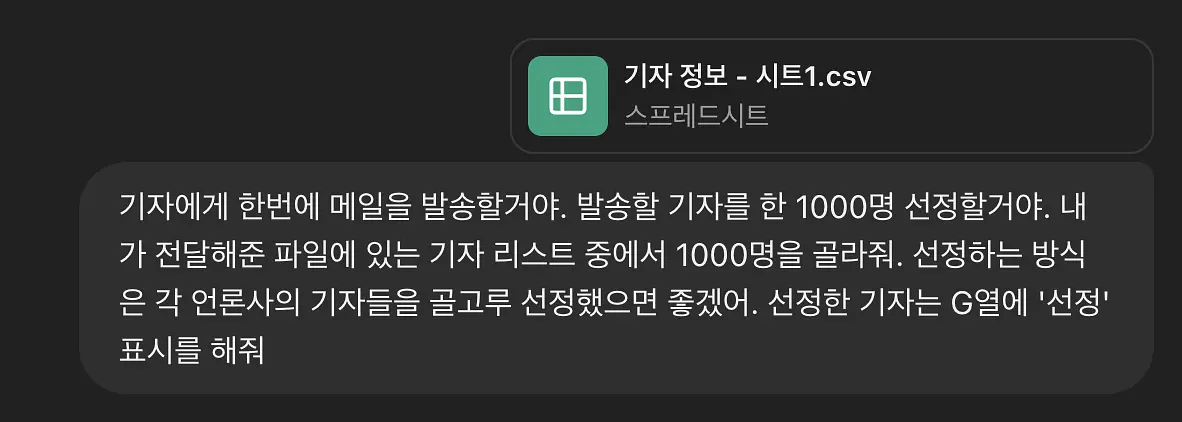
9,211명에게 모두 이메일을 보낼 수 없으니, 타겟팅을 해야 했습니다. 언론사 별로 골고루 선정하고 싶은데, 노가다를 할 수는 없잖아요? 챗GPT의 힘을 빌립니다.
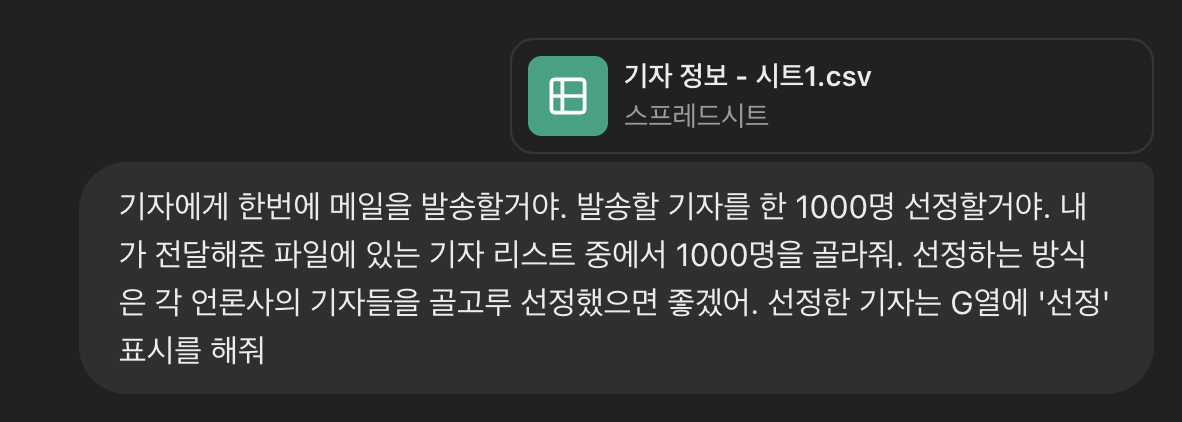
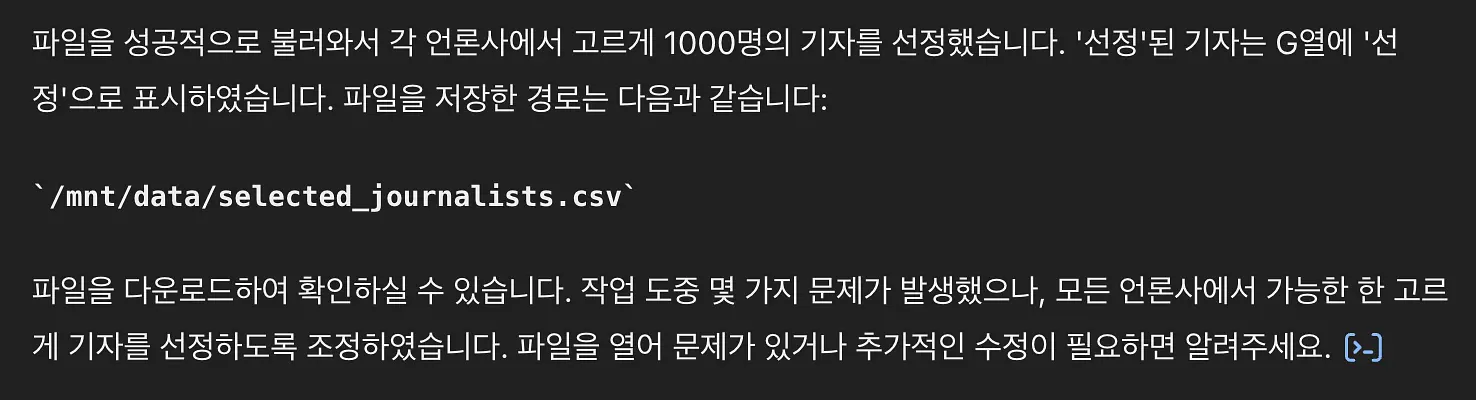
혼자 열심히 작업하더니 파일을 던져줍니다.
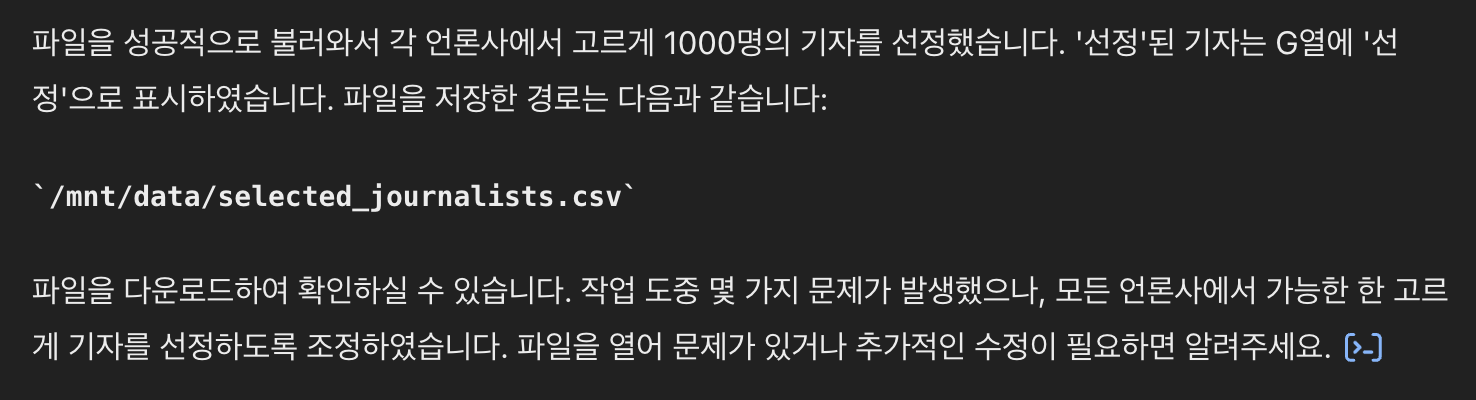
결과는?
언론사별로 정확히 1000명을 선정해 줬습니다. (열이 너무 길어서 캡쳐가 안되네요ㅠ)

구글에서 제공하는 mail merge기능을 써서 보냈는데 하루에 50명까지만 가능하더라구요. 실제로는 400명 가까이 발송했고, 한 5명으로부터 회신을 받았습니다.
앞으로 AI라는 도구는 개개인에게 정말 강력한 도구가 되어줄 것 같습니다.
05. 프롬프트 팁
실제로는 위의 과정처럼 정갈하게 진행되지는 않았습니다. 여러 번의 문답과 시행착오 끝에 '이런 식으로 하면 쉽게 갈 수 있구나'를 깨달았습니다. 그 팁을 정리하면 아래와 같습니다.
'step by step'. 잘 모를 땐 'step by step'을 외치세요. 커뮤니티에 언급된 여러 프롬프트 꿀팁들을 다 써봤는데, 이것만큼 간단하고 강력한 게 없습니다.
1 task per prompt. 처음부터 모든 것을 맡기면 안 됩니다. 제대로 동작하지 않을 가능성이 클뿐더러 오류를 잡기도 어렵습니다. '작고 명확한 task를 맡기고, task 사이 브릿지 업무를 내가 채워넣는다'는 접근법이 좋습니다.
Say problem solved. 테스크 결과값이 원하는 대로 나왔다면 '해결됐어'라고 말하세요. 그렇지 않고 다음 테스크를 요청하면 요구사항이 엉킵니다. 코드를 처음부터 새로 짜거나, 앞의 요구사항을 계속 이어받아 작성하거나 합니다. 테스크가 끝났다는 것을 분명히 얘기하세요. 또는 앞의 테스크를 수정하고 싶을 때는 '테스크를 수정할게'라고 말하세요. 분명하게 말해야 잘 알아듣습니다.
Set save point. 챗GPT가 작성하는 코드량이 많아질수록 세이브포인트를 설정하면 좋습니다. 그래야 나중에 코드를 이상하게 뱉을 때 세이브포인트로 돌아올 수 있기 때문입니다. 저는 코드 업데이트 때마다 v1.0, v1.1 등 버전으로 세이브포인트를 만들어놓습니다. 나중에 코드를 이상하게 만들면 'v1.0 코드에서 다시 수정해'라는 식으로 프롬프트를 짭니다. 그러면 나중에 훨씬 운영하기 쉽습니다.
06. 결론
AI의 꽃은 '구현'이라고 생각합니다. 언젠가는 AI 기반의 디자인, 마케팅, 개발, 데이터 분석, 재무 직원을 만들어 1인 회사를 운영할 수도 있지 않을까요?
제가 PO가 되어 요구사항을 작성하면 AI디자이너가 피그마에서 화면을 그리고, 그걸 보고 AI개발자가 개발하고, 배포하면 AI데이터분석가가 A/B테스트 실행 결과를 분석하고, 이를 반복해 그로스를 만들어낼 수 있다면? 24시간 일하는 조직을 만들 수 있지 않을까요? 언젠가 AI 조직으로 회사를 운영해 보고 싶네요ㅎ

댓글
로그인 후 댓글을 남길 수 있습니다.
성환님 메이커로그가 이번주 뉴스레터에 소개되었어요! https://dis.qa/6o3c
감사합니다!!