최동민

최동민님의 아티클

최동민

최동민

미국 신용평가회사 S&P가 바라본 AI 동향: 2023 Global Trends in AI Report

안녕하세요, ‘렛서’의 최동민입니다. 지난 아티클에서 스탠포드 연구소에서 발표한 <AI Index Report 2023>을 통해 AI의 동향을 한번 살펴보았었는데요, 이번 아티클에서는 세계적인 미국의 신용평가회사 S&P Global에서 2023년 8월에 공개한 <2023 Global Trends in AI Report>에 대해 다루도록 하겠습니다. AI의 현재와 미래를 S&P Global이라는 신용회사에서는 어떻게 바라보고 있는지 살펴보도록 하겠습니다.

해당 리포트에서는 아래의 7가지 키포인트를 이야기하고 있습니다.

  1. AI는 많은 분야와 기관에 걸쳐 가속화되고 있지만, 실제 엔터프라이즈 수준에 도달한 사례는 거의 없다.

  2. AI는 비용 감축을 위한 수단에서 수익을 창출하는 동력으로 변하고 있으며 이를 통해 기존의 시장을 재정의하고 있다.

  3. 데이터 관리는 AI의 활용을 억제하는 가장 주요한 요소이다.

  4. AI의 선구자들은 AI의 수요를 감당하기 위해 다양한 배포 환경과 방법을 사용한다.

  5. AI의 에너지 사용과 탄소 배출은 여러 기업에게 지속가능한 목표를 촉구하고 있지만, 이는 클라우드 서비스를 통해 더 나아질 수 있다.

  6. 노화된 데이터 인프라와 구조는 AI의 지속가능성에 직접적으로 영향을 미친다.

  7. 자체 데이터와 구조를 가지고 있는 기관은 미래에 AI를 이끌게 될 것이다.

몇가지 키포인트의 세부 내용을 들여다 보도록 하겠습니다. 해당 리포트는 약 1,500명의 AI 의사결정자와 프로젝트 리더를 대상의 설문에 기반하고 있습니다. 그중 AI를 실제로 활용하고 있는 응답자를 ‘AI 선구자(pioneer)’, AI 도입을 위해 PoC 단계를 거치고 있는 응답자를 ‘AI 탐험가(explorer)’라고 부르고 있습니다.

1. AI는 많은 분야와 기관에 걸쳐 가속화되고 있지만, 실제 엔터프라이즈 수준에 도달한 사례는 거의 없다.

  • AI는 이미 많은 기업들에서 활용되고 있으며, 설문자의 69%가 적어도 1개의 이상의 AI를  제품에서 활용해본 적이 있다고 응답했습니다. 즉, 약 70%의 응답자가 ‘AI 선구자'에 속하며 나머지 30%의 응답자가 파일럿 테스트나 PoC를 거치고 있는 ‘AI 탐험가'에 해당합니다.

  • AI 프로젝트의 규모에 대해서는 약 28%만이 그들의 비즈니스에서 널리 활용되어 엔터프라이즈 레벨에 도달했다고 답하였으며, 약 30%의 응답자는 아직은 작은 규모로만 AI가 적용되고 있지만 앞으로 더욱 중요해질 것으로 예상했습니다.

  • 위 결과를 통해서 이제는 AI의 활용이 더 이상 ‘IT나 데이터 전문가들만의 작은 분야가 아니라 여러 비즈니스 팀들도 도입할 수 있다'는 것을 확인할 수 있습니다. 

2. AI는 비용 감축을 위한 수단에서 수익을 창출하는 동력으로 변하고 있으며 이로 인해 시장을 재정의하고 있다.

  • 지금까지의 AI는 새로운 가치를 창출하기 보다는 비용 감축을 위해서 많이 활용되어 왔습니다. 하지만 대다수의 응답자들이 앞으로는 AI가 새로운 수익을 만들어내는 revenue driver로 작동할 것이라고 응답했습니다.

  • 위 결과는 “귀하의 회사에 있어 AI가 이끌어 낼 수 있는 주요 가치는 무엇입니까?”라는 질문에 대한 복수선택 결과입니다. 이중 새로운 가치를 창출해내는 내용은 초록색, 기존의 비용을 감축하는 내용은 빨간색으로 표시되어 있습니다. 많은 응답자들이 초록색에 해당하는 새로운 부가 가치 창출에 더욱 많은 의견을 실었으며, 그중 제품이나 서비스의 퀄리티 향상에 도움이 될 것이라는 응답이 가장 많았습니다.

3. 데이터 관리는 AI의 활용을 억제하는 가장 주요한 요소이다.

  • 기업의 IT와 데이터 구조는 한번도 겪어본 적 없는 AI의 수요에 의해 한계에 부딪히고 있습니다. 이는 GPU의 부족과 같은 하드웨어적인 측면이 아니라 데이터 관리 차원의 문제라고 대부분의 응답자가 말하고 있습니다.

  • 즉, 어떻게 데이터베이스를 저장 및 관리할지와 실시간 스트리밍 데이터를 어떻게 처리할지, 그리고 로그 파일과 AI 학습을 위한 데이터는 어떻게 저장할지에 대한 이슈가 AI 개발 및 활용에 있어 가장 큰 병목이라는 것입니다.

4. ‘AI 선구자’들은 AI의 수요를 감당하기 위해 다양한 배포 환경과 경로를 사용한다.

  • 대폭적으로 증가한 AI 수요를 감당하기 위해 ‘AI 선구자’들은 ‘AI 탐험가'에 비해 평균적으로 더 많은 경로를 활용합니다. 평균적으로 학습을 위해 3.2개의 환경과 추론을 위해 2.5개의 경로를 활용한다고 합니다.

  • 하지만 AWS나 Azure와 같은 클라우드 환경을 통해 더욱 쉽게 AI를 활용할 수 있게 되었으며, AI의 학습과 추론에 클라우드가 가장 주요한 환경으로 자리잡았습니다.

7. 자체 데이터와 구조를 가지고 있는 기관은 미래에 AI를 이끌게 될 것이다. 

  • 우선 위 표를 통해서 클라우드 환경이 AI의 학습과 추론 모두에 있어 가장 주요한 환경임을 다시 한번 확인할 수 있습니다.

  • 또한 배포 환경이 굉장히 다양한 것을 통해 자체 데이터 인프라나 환경이 충분히 확보되어 있는 기업에게 AI의 활용과 선점이 더욱 유리하다는 것을 알 수 있습니다.

해당 아티클에서는 S&P라는 신용평가회사가 AI의 현재와 미래를 어떻게 바라보고 있는지를 살펴보았습니다. 다소 뻔하거나 널리 알려진 내용도 많이 포함되어 있었는데 저는 첫번째 키포인트인 엔터프라이즈 레벨까지 도달한 기업의 비율이 생각보다 적다는 것이 인상적이었습니다. 그리고 PoC를 통해 AI 도입을 원하는 니즈는 많다는 것이 눈에 띄었습니다.

다들 AI의 현재와 미래에 대해 어떻게 생각하시나요? 댓글에 자유롭게 의견 달아주시면 감사드리겠습니다.

12
6
최동민

최동민

[콘텐츠 AI] AI가 대세라는데 우리 회사에 어떻게 활용할 수 있을까?

안녕하세요, ‘렛서’의 최동민입니다. 이번 아티클에서는 다들 한번씩 들어보셨을 'ChatGPT'와 '이미지 생성 AI'와 같은 콘텐츠 AI를 원하는 서비스에 어떻게 활용할 수 있을지를 예시와 함께 다뤄보도록 하겠습니다.

콘텐츠 AI를 직접 활용해보신 경험이 있으신가요? 예를 들어, 여러 은행사의 '챗봇' 서비스로 원하는 업무를 해결하거나, 'AI 프로필' 서비스로 매력적인 프로필 사진을 만들어 보신 적이 있으신가요? 아니면 'AI가 작성한 뉴스 기사'를 읽어보신 적이 있나요?

이처럼 AI가 만들어낸 창작물들을 일상생활에서 쉽게 접할 수 있을만큼 콘텐츠 AI는 대중화되어 여러 서비스에 녹아들어 있습니다. 그렇다면 이러한 “콘텐츠 AI를 우리 회사의 서비스에는 어떻게 활용”할 수 있을까요?

아래에서 콘텐츠 AI를 활용할 수 있는 서비스를 한번 살펴보도록 하겠습니다.

가상 피팅 서비스 만들기

  • 코로나 이후, 많은 사람들이 오프라인 매장보다는 온라인 쇼핑몰에서 옷을 구매하기 시작했습니다. 그러나 소비자 입장에서는 온라인 쇼핑으로 고른 '옷이 나에게 잘 어울릴까?'하는 걱정이 들기 마련입니다.

  • 최근 이미지 생성 AI 기술의 발전으로 'VITON (Virtual Try-On)' 기술을 통해 가상으로 옷을 입어볼 수 있게 되었습니다. 이로 인해 고객들은 실제로 옷을 입지 않고도 온라인상 가상 피팅을 거친 후에 구매 결정을 내릴 수 있게 되었습니다. 즉, AI를 통해 더욱 개인화된 서비스를 제공할 수 있게 되었습니다. 이러한 VITON 기술은 상하의 뿐만 아니라 모자, 가방, 시계와 같은 악세사리 가상 피팅에도 활용될 수 있으며, 또한 머리스타일이나 화장과 같은 가상 메이크업 서비스로 확장될 수 있습니다.

원하는 인물 이미지로 AI 아바타 만들기

  • 해당 서비스는 국내 여러 기업의 ‘AI 프로필’로 널리 알려져있습니다. 주어진 특정 인물의 한장 이상의 사진을 이용하여 해당 인물의 얼굴은 유지한 상태로 다양한 동작과 배경의 이미지를 생성하는 서비스입니다. 

  • 단순히 개인 프로필을 생성하는 것 뿐만 아니라 광고, 미디어, 유튜브 영상 등과 같이 다채로운 콘텐츠를 쉽게 제작할 수 있으며 이를 통해 차별화된 고객 경험을 제공할 수 있습니다. 예를 들어, 광고에 들어갈 인물이 어떤 구도나 배경에서 가장 잘 어울리며 홍보하고자 하는 메시지를 드러낼 수 있을지 직접 확인해보지 않고 단순히 많은 이미지를 생성하여 확인해볼 수 있습니다. 혹은 유튜브 썸네일도 이것저것 생성해보며 원하는 것을 손쉽게 고를 수 있습니다. 

다양한 질문에 자연스럽게 답변하는 맞춤형 챗봇 만들기

  • ChatGPT의 등장 이후로 챗봇의 성능이 급격히 향상되었으며 더욱 다양한 분야에서 널리 사용되고 있습니다. OpenAI의 API를 활용하여 원하는 챗봇 서비스에 AI를 연결하고 또한 주어진 서비스에 적합한 입력문을 작성(이를 프롬프트 엔지니어링이라고 합니다.)하여 특정 상황에 적합한 기능 위주로 활용할 수 있습니다. 

  • 적절한 프롬프트만 작성할줄 안다면 SQL을 몰라도, 직접 챗봇 규칙을 설계하지 않아도 원하는 정보를 제공하는 챗봇을 만들 수 있게 되었습니다. 예를 들어, “당신은 서울 역삼점 A 가게의 매출 내역에 대한 SQL 문을 작성합니다. 각 매출 내역은 날짜, 금액, 서비스 종류 등의 정보를 가지고 있습니다”와 같은 프롬프트를 미리 작성하여 사용자 질의를 응답하는 챗봇을 만들 수 있습니다.

맞춤 상품을 추천하기 위한 메타데이터 태깅하기

  • 인터넷 쇼핑에서 고객의 취향에 알맞는 상품을 개인화하여 추천하고 페이지에 노출하는 것은 굉장히 중요한 일입니다. 하지만 이를 위해 직접 모든 상품의 정보를 태깅하는 과정은 번거로운 과정입니다. 이때 AI를 활용하여 상품의 패턴, 디테일 등 상세 속성 정보를 분석하여 개인화 서비스를 고도화할 수 있습니다.

이외 콘텐츠 AI를 활용할 수 있는 서비스로 아래의 예시들이 있습니다. 본 아티클에서 소개드린 예시 이외에도 콘텐츠 AI를 활용할 수 있는 분야는 무궁무진합니다. 사례들을 통해 원하시는 서비스에 AI를 접목시켜 기능을 더욱 고도화할 수 있을지 고민해보실 수 있는 기회가 되기를 바랍니다.

  • 자연스러운 음성 생성하기

  • 대본 기반의 포스터 생성하기

  • 영화 시나리오 작성하기

  • 가사 생성하기

  • 카피라이트 생성하기

  • 브랜드 홍보물 생성하기

  • 캐릭터 스타일로 인물 이미지 변환하기

저희 렛서 또한 콘텐츠 AI를 여러 기업에서 활용해보실 수 있도록 서비스를 제공하고 있습니다. 자세한 내용은 아래 페이지에서 확인해보세요!

letsur.ai/content-ai/

9
0
최동민

최동민

AI에서 '멀티모달'이 무엇이고 왜 중요할까?

안녕하세요. 렛서의 최동민입니다.

이번 아티클에서는, 최근 AI 분야에서 많은 주목을 받고 있는 ‘멀티모달(multi modal)’에 대해 간략하게 정리하여 공유드리고자 합니다.

멀티모달이란?

‘멀티 모달’을 정리하기 앞서, 우선 ‘모달(modal)’이 무엇인지 한번 살펴보도록 하겠습니다. 여기서 ‘모달’이란 ‘모달리티(modality)’에 해당하며 ‘어떤 형태로 나타나는 현상이나 그것을 받아들이는 방식’라는 뜻을 가지고 있습니다. 

NLP VAK Modalities

출처: https://inlpcenter.org/nlp-submodalities-courtney/

예시를 통해 조금 더 쉽게 이해하면 어떤걸 눈으로 보고 인지하는 것은 시각(visual), 피부로 대상과 접촉하여 느끼는 것은 촉각(kinesthetic), 그리고 소리를 귀로 듣고 받아들이는 것은 청각(auditory) 모달리티에 해당합니다. 즉, 어떤 대상을 받아들이는 일종의 소통 형태 혹은 프로토콜이라고 이해할 수 있습니다.

AI에서 모달리티는 데이터의 종류 및 형태를 나타내며 일반적으로 이미지(computer vision), 자연어(NLP), 음성 등의 도메인으로 구분되어 일컬어집니다. 그렇다면 AI에서 특히 멀티모달이 중요한 이유가 무엇일까요?

AI 분야에서 멀티모달이 중요한 이유

불과 몇년 전까지만 해도 AI는 하나의 모탈리티만 입력으로 하는 ‘유니 모달(unimodal’)을 위주로 발전되어 왔습니다. 그 이유는 아직 하나의 모달리티만 고려하더라도 충분한 성능을 달성하지 못했으며 서로 다른 모달리티를 하나의 모델로 효과적으로 처리할 수 있는 기술이 부족했기 때문입니다.

그러나 많은 AI 연구 끝에 하나의 모달리티에 대해서는 딥러닝 기술이 일정 수준에 도달하여 괄목할 만한 성능을 보여주었으며, 자연스럽게 멀티모달 쪽으로 연구자들의 관심이 쏠리기 시작했습니다. 멀티모달이 중요한 이유는 기존 모델을 이용하여 여러 입력을 처리하기 위해서는 각 모달리티에 해당하는 개별 모델을 독립적으로 사용한 뒤에 최종 결과를 종합하는 식으로 판단을 내려야 했기에 데이터 간의 상호작용이나 상관성을 충분히 고려하지 못했기 때문입니다. 즉, 멀티모달 AI는 단순히 개별 모델로 여러 입력을 처리할 수 있다는 유용성 뿐만 아니라 모달리티 간의 정보를 교환하고 충분히 활용하여 시너지 효과를 낼 수 있다는 장점이 있습니다.

주목할 만한 멀티모달 AI 기술

  1. CLIP

CLIP: The Most Influential AI Model From OpenAI — And How To Use It | by  Nikos Kafritsas | Towards Data Science

출처: https://towardsdatascience.com/clip-the-most-influential-ai-model-from-openai-and-how-to-use-it-f8ee408958b1 

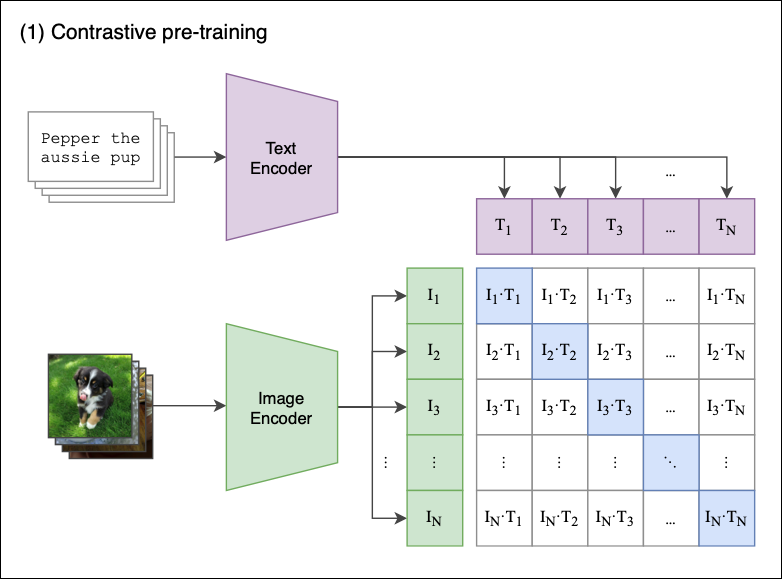
텍스트와 이미지 입력을 동시에 고려하여 멀티모달 AI의 본격적인 시작을 알린 CLIP은 현재까지도 핵심 기술로 손꼽힐 만큼 중요한 방법론입니다. 해당 방법론을 간단하게 정리하면, 서로 다른 모달리티인 이미지와 텍스트에서 얻어낸 정보가 하나의 특징 공간(feature space)에 존재하도록 학습하여, 결국 이미지에서 추출한 정보와 텍스트에서 추출한 정보가 유사해지도록 만드는 것을 목표로 합니다.

CLIP을 이용하면 텍스트 입력 만으로도 주어진 정보에 해당하는 이미지 정보를 얻어내어 활용할 수 있으며, 반대로 이미지 입력에서 원하는 텍스트 정보를 추출할 수 있습니다.

  1. ImageBind

ImageBind

출처: https://github.com/facebookresearch/ImageBind 

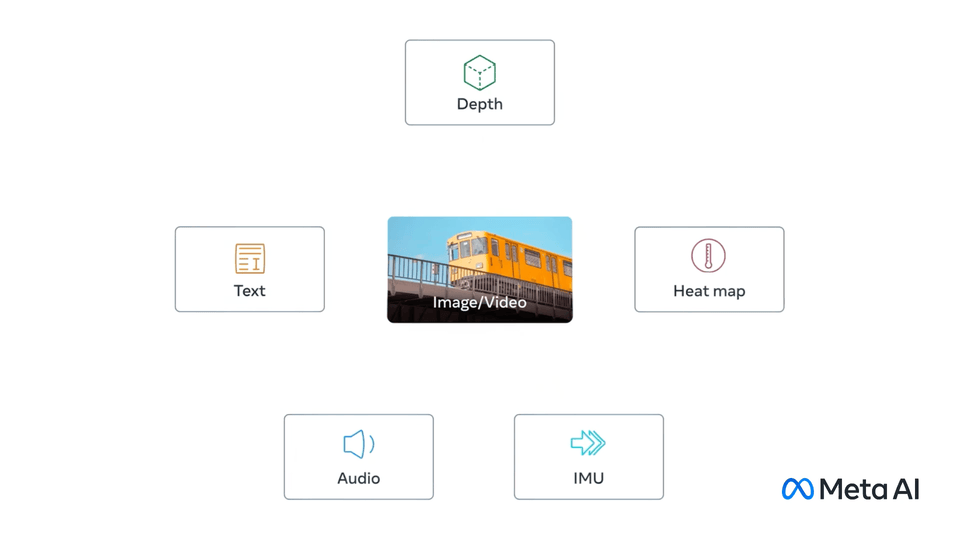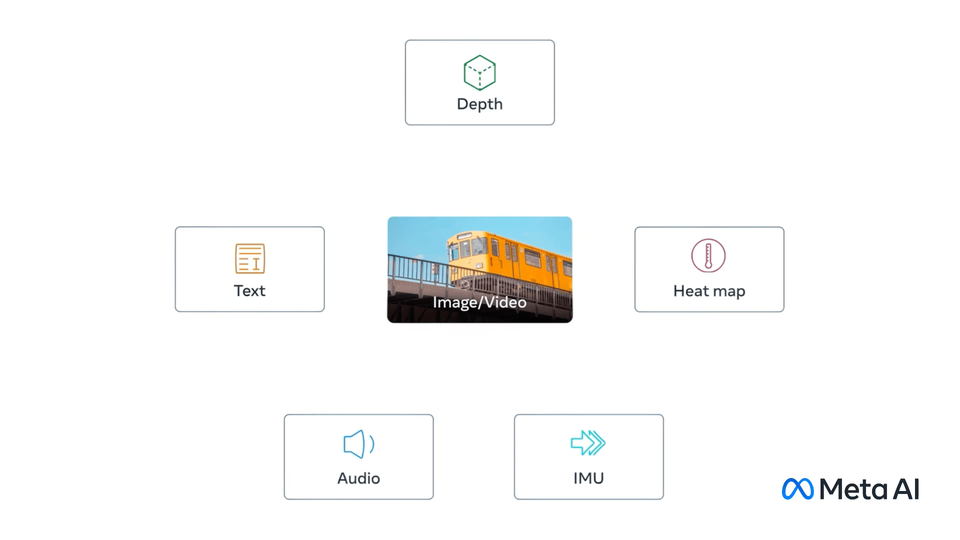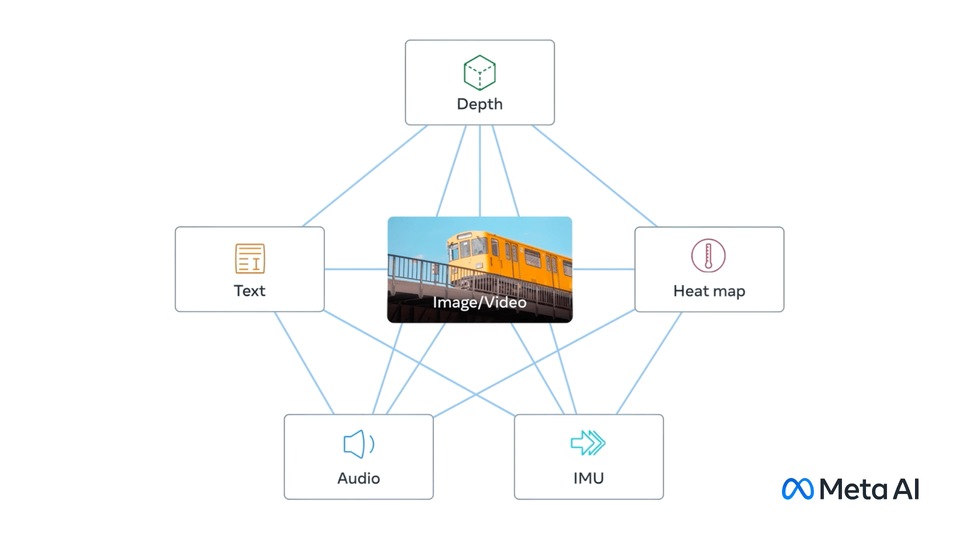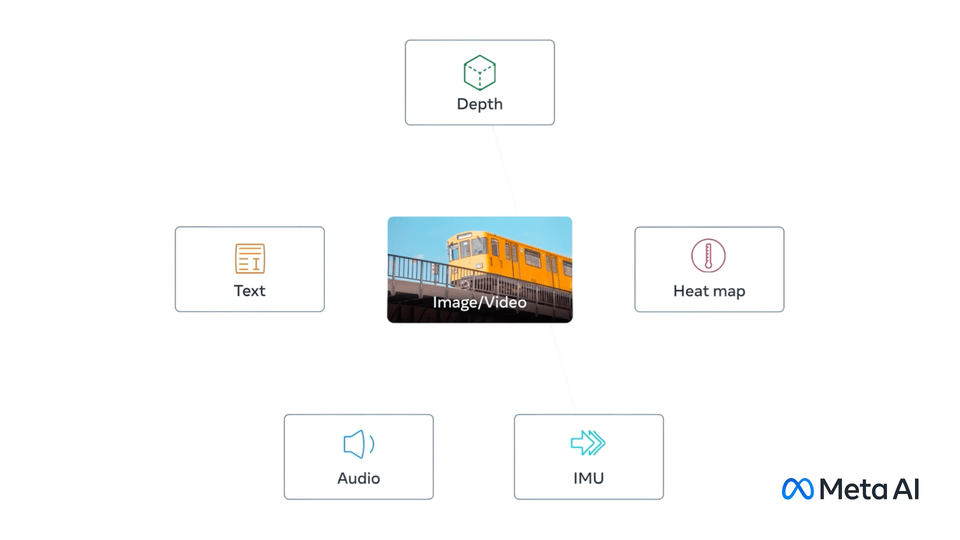
Meta에서 올해 발표하여 많은 주목을 받았던 ImageBind는 하나의 모델로 6개의 입력(이미지, 텍스트, 오디오, 깊이맵, thermal, IMU)을 처리할 수 있어서 많은 주목을 받았습니다. 해당 모델의 이름에서부터 알 수 있듯이 이미지를 핵심 모달리티로 설정하여 모달리티 간의 다리 역할로 활용하였습니다. 6개의 모달리티를 동시에 활용하는 것이 아니라, ‘이미지 - 텍스트’, ‘이미지 - 오디오’, ‘이미지 - IMU’와 같이 이미지와의 유사성을 높이는 방법으로 학습을 하다보면 결국 6개의 모달리티에서 얻은 특징이 하나의 공간에 모이게 된다는 것을 보여주었습니다.

  1. Meta Transformer

출처: https://kxgong.github.io/meta_transformer/

불과 한달 전(2023년 7월)에 공개된 Meta Transformer는 하나의 모델로 12개의 입력을 처리할 수 있으며 이렇게 얻어낸 정보를 무수히 많은 프로젝트에 적용할 수 있음을 보여주어 화제가 되었습니다. 해당 모델은 각 모달리티에 해당하는 데이터를  연속된 시퀀스 형태로 변환하는 Tokenizer (Data-to-sequence tokenizer)를 적절히 학습하면 하나의 모델로 처리할 수 있음을 보여주었습니다. 또한 ImageBind에 비해 훨씬 많은 수의 모달리티를 처리할 수 있음과 동시에 개별 modality에서 최고 성능(state-of-the-art)을 달성한 모델들과 비슷한 성능을 보여주었습니다.

이번 아티클에서는 AI에서 멀티모달이 무엇이며 왜 중요한지, 그리고 해당 분야를 선도하고 있는 기술들에 대해 간략하게 정리해보았습니다. 멀티모달 AI에 관심있으신 분들께 도움이 되었기를 바랍니다 :)


14
0
최동민

최동민

렛서에서 이번에는 이미지 생성모델 리포트를 발행해요🔥

렛서는 2차 리포트 ‘달리, 반 고흐, 피카소, 다음은 AI?’를 준비하고 있습니다.


아래 링크에서 신청 부탁드립니다 :)

url thumbnail

2차 리포트 배포 (디스콰이엇)

빠르고 쉬운 폼빌더, 왈라

https://walla.my/survey/p8w46xq72hfjUGSvnJEc


렛서의 지난 ChatGPT 리포트, 기억하시나요?

약 1,000명에 달하는 독자분들의 호평 속에 리포트 회고까지 잘 마무리 할 수 있었습니다.

최근의 GPT 리포트는 정말 걸작이었습니다ㅎㅎ 
차후 렛서의 리포트도 기대가 많이 되고, 이런 질적인 정보를 무료로 받는다니…
원문이 너무 좋아서 챗알못인 저도 이해가 쏙쏙 잘 되었습니다.


ChatGPT 같은 자연어 인공지능뿐만 아니라, 이미지 생성 인공지능도 굉장히 빠르게 발전하고 있습니다.

인공지능에 친숙하지 않은 기획자, 개발자 분들도 최신 이미지 생성 인공지능을 활용하여 서비스를 만드실 수 있도록, 해당 내용을 주제로 한 2차 리포트를 준비하고 있습니다. 


그리고 기다리시는 동안 AI 트렌드를 놓치지 않도록, 스탠포드의 AI 인덱스 2023의 핵심 내용에 렛서의 인사이트를 담은 글을 준비했습니다.

url thumbnail

스탠포드 연구소와 렛서가 바라본 AI 동향: AI Index Report 2023 | Disquiet*

안녕하세요, ‘렛서’의 AI 엔지니어 최동민입니다.이번 글에서는 스탠포드의 인간중심 인공지능연구소(Stanford Institute for Human-Centered Artificial Intelligence)에서 매년 발간하는 AI Index Report의 2023년 보고서를 정리하여 저의 생각과 함께 공유드리고자 합니...

https://disquiet.io/@dmchoi/makerlog/8257


기획자 분들이라면 놓치지 말아야 할 인공지능 트렌드, 렛서와 함께 알아보세요.

18
1
최동민

최동민

OpenAI의 상표권 문제, 너희 이제 진짜 CloseAI니?


안녕하세요, ‘렛서’의 AI 엔지니어 최동민입니다.

최근(2023.04.24)에 OpenAI에서 브랜딩 가이드라인을 공개하였으며, 가이드라인에 포함된 내용이 논란과 함께 화제가 되고 있습니다. 논란이 되는 핵심을 한줄로 요약하면, 앞으로는 ‘OpenAI 모델을 활용하였다고 명시해야 하며, GPT라는 이름도 함부로 사용하면 안된다'고 명시하였기 때문입니다.

본 아티클에서는 OpenAI의 창립 배경과 함께 이러한 태도가 논란이 되고 있는 이유와, 브랜딩 가이드를 바탕으로 앞으로 OpenAI의 기술을 활용하여 서비스를 제공할 때 어떤 부분을 주의해야 하는지 다루도록 하겠습니다.

url thumbnail

Brand guidelines

Language and assets for using the OpenAI brand in your marketing and communications.

https://openai.com/brand


출처: https://slate.com/technology/2022/12/chatgpt-openai-artificial-intelligence-chatbot-whoa.html 

OpenAI의 창립 배경과 변질된 현재의 모습

OpenAI는 인공지능을 이용하여 인류에게 이익을 주기 위한 목적으로 설립된 회사로, 설립 초기에는 AI의 오픈소스화(누구나 해당 모델을 이용할 수 있도록 코드를 공개하는 것)와 비영리를 추구하였습니다.

하지만 회사가 성장함에 따라 OpenAI는 점차 폐쇄적이며 영리적인 성격으로 변해갔으며, 이 과정에 발생한 이해충돌로 인해 설립자 중 한 명인 일론 머스크가 회사를 떠나기도 했습니다.

OpenAI의 이러한 태도는 ChatGPT가 폭발적인 인기를 얻기 시작한 이후로 본격적으로 드러나기 시작했습니다. 회사의 창립 이념과 달리, OpenAI는 ChatGPT를 포함한 모델들을 오픈소스로 공개하지 않았으며, 유료API 혹은 월 구독형 유료 서비스로만 모델을 사용할 수 있게 제안하였습니다. 그리고 가장 최근에 공개된 언어모델인 GPT-4는 자세한 모델의 구조나 적용된 기술에 대한 설명을 공개하지 않았습니다. (GPT-4의 기술 보고서는 모델의 성능에 대한 내용이 대부분입니다, https://cdn.openai.com/papers/gpt-4.pdf)


출처: https://youtu.be/0uI7SoMn0Es 

OpenAI의 변질된 모습을 보고 많은 사람들이 "더 이상 우리가 알던 OpenAI가 아니다.", "사명을 CloseAI로 변경해야 한다."와 같은 비판의 목소리를 내고 있습니다. 여담으로 OpenAI에 반하여 AI의 대중화를 외치며 최전선에서 오픈소스 진영을 이끌고 있는 회사로 Stability AI와 HuggingFace가 있습니다. 최근에 폐쇄적인 ChatGPT를 대체하기 위한 목적으로 StableLM(https://www.stablelm.com/) 와 HuggingChat(https://huggingface.co/chat/ )을 오픈소스로 공개하며 많은 주목을 받기도 했습니다. 이러한 오픈소스 진영의 흐름은 나중에 기회가 된다면 다음 글에서 다뤄보도록 하겠습니다.


출처: https://news.yahoo.com/gpt-may-trademarked-soon-openai-033353384.html

OpenAI의 GPT 상표권 등록 거부

OpenAI는 사실 이미 GPT의 독점 사용을 위해 상표권 등록을 시도한 적이 있습니다. 작년 12월, OpenAI는 미국 특허청인 USPTO에 GPT 상표권을 등록 시도하였으나 일련의 이유로 거절당하였습니다. (등록이 거부된 이유는 비용 미납과 서류 불충분입니다.) 

사실 GPT는 Generative Pre-trained Transformer의 줄임말으로, Transformer는 구글에서 제안한 딥러닝 모델의 이름입니다. 그리고 Generative와 Pre-trained는 Transformer를 대규모 데이터셋에 사전 학습(pre-trained)하였으며 텍스트 생성(generative)을 목적으로 발전시켰다는 의미를 담고 있습니다. 결국 이는 구글의 transformer에 기반을 두고 있으며 심지어 구글은 transformer를 두고 상표권 출원을 하고 있지 않기에, OpenAI가 GPT로 상표권을 등록하는 것이 어불성설이라는 의견도 있습니다.

그럼에도 불구하고 OpenAI는 지속적으로 GPT에 대한 독점을 확고히하려는 움직임을 보이고 있으며, 수개월 내에 다시 GPT 상표권 등록을 시도할 가능성이 있습니다. 이로 인해 앞으로 네이버와 카카오에서 사용 중인 GPT가 포함된 서비스명을 다른 이름들로 변경해야 할 가능성이 큽니다.

OpenAI의 변질된 모습은 4월 24일에 공개된 브랜딩 가이드라인에서 다시 한번 확인되었습니다. 본 아티클에서 해당 가이드라인이 OpenAI 기술 이용 시 어떤 주의사항을 언급하고 있는지 하나씩 살펴보도록 하겠습니다.


출처: https://openai.com/brand 


OpenAI의 브랜딩 가이드

브랜딩 가이드를 살펴보기에 앞서, OpenAI에서 각 사항을 API, 플러그인, 그리고 모델로 구분하고 있어 해당 개념에 익숙하지 않으신 분들을 위해 간단히 정리하고 시작하도록 하겠습니다.

  • API (Application Programming Interface): 다른 프로그램 혹은 환경에서 특정 모델을 사용할 수 있도록 해주는 인터페이스입니다. 주로 개발자 분들께서 API를 활용하여 특정 모델의 기능을 원하는 플랫폼에 붙이는 방식으로 개발을 진행합니다.
  • 플러그인 (Plug-in): 다른 프로그램 혹은 어플리케이션에서 특정 모델을 사용할 수 있도록 해주는 도구입니다. API와 다른 점은, 개발자가 아닌 일반 사용자도 플러그인 설치를 통해 쉽게 해당 모델을 사용할 수 있다는 편의성입니다. 구글 크롬 브라우저에서 확장 프로그램을 설치하여 크롬 환경에 다른 특정 서비스를 활용하는 것이 플러그인에 해당합니다. 예시로 Expedia, KAYAK, 그리고 스픽(Speak)이 있습니다.
  • 모델 (Model): API와 플러그인을 통해 활용하고자 하는 AI 모델 자체를 의미합니다. 예를 들어, ChatGPT와 DALLE-2는 모델에 해당합니다.


1) API 활용시

OpenAI는 ChatGPT를 포함해 GPT-4, DALLE-2, Whisper와 같은 자사의 AI 기술을 유료 API를 통해 제공합니다. 앞으로 OpenAI의 API를 사용한 서비스의 경우 아래와 같은 규칙을 준수해야 합니다. (주로 개발자 분들께서 OpenAI의 모델을 API를 통해 자사의 플랫폼에 붙이고자 하실 때 주의해야할 사항입니다.)

올바른 표기:

  • ‘서비스명’ powered by GPT-4
  • Powered by
  • Build on
  • Built with
  • Developed on
  • Developed with

잘못된 표기:

  • MeowlyticsGPT
  • Meowlytics with GPT-4
  • Meowlytics AI by OpenAI
  • ChatGPT-powered Meowlytics


예를 들어, 기획하고자 하는 서비스가 ChatGPT를 활용하였으며 서비스명이 ‘Meowlytics’인 경우에 해당 서비스는 ‘Meowlytics powered by ChatGPT’라고 표기해야 하며, ‘MeowlyticsGPT’ 혹은 ‘Meowlytics with ChatGPT’라고 표시해서는 안됩니다.

또한 심지어 ‘ChatGPT와 밀접하게 유사하지만 OpenAI의 제품이 아닌 경우’에 해당 서비스가 OpenAI와 무관하다는 것을 명시할 것을 요청하였습니다. (OpenAI 기술이 아닌데 비슷한 것처럼 보이는 서비스로 인해 괜히 이미지에 타격입는 것을 방지하는 목적으로 생각됩니다.)


2) 플러그인 활용시

OpenAI는 ChatGPT를 다양한 프로그램에 확장 기능으로 활용할 수 있도록 플러그인(https://openai.com/blog/chatgpt-plugins) 서비스를 운영하고 있습니다. 앞으로 OpenAI의 플러그인을 활용할 때에는, 회사의 이름 혹은 제품명이 먼저 오고 그 뒤에 OpenAI나 모델명으로 표기할 것을 제시합니다. (OpenAI의 모델을 플러그인을 통해 자사의 웹페이지 혹은 어플리케이션에 활용하고자 하실 때 주의해야할 사항입니다.)

올바른 표기:

  • BarkBytes plugin for ChatGPT
  • BarkBytes ChatGPT plugin

잘못된 표기:

  • BarkBytes plugin for OpenAI
  • BarkBytes plugin compatible with ChatGPT
  • BarkBytes plugin works with ChatGPT
  • BarkBytes plugin integrated with ChatGPT


3) 모델 활용시

ChatGPT나 DALLE와 같은 OpenAI의 모델을 사용할 때 정확한 모델명을 사용할 것을 권장합니다.

올바른 표기:

  • 정확한 모델 이름을 언급할 것: GPT-3, GPT-4, ChatGPT API, DALL•E API
  • 필요한 경우에 모델의 날짜 기준 버전을 언급할 것: GPT-4 3월 4일 버전 (Mar 14 version)
  • OpenAI의 모델을 일반적으로 언급할 때에는 OpenAI technologies 라는 용어를 사용할 것

잘못된 표기:

  • 잘못된 이름을 사용하지 말 것: Chat GPT (대신 ChatGPT), ChatGPT4 (ChatGPT는 GPT 시리즈 중 3.5 버전에 해당하는 모델이므로 GPT-4라고 하는 것이 정확), GPT Chat
  • 모델의 클래스를 사용하지 말 것: 예를 들어 GPT-3의 경우, 모델의 상대적인 기능과 비용에 따라 Ada, Babbage, Curie, Davinci로 나뉘어 있는데 개별 모델 클래스명을 사용하지 말고 GPT-3라고 일괄 사용할 것. 또한 ChatGPT의 경우에도 GPT-3.5-turbo와 같은 세부 클래명 대신ChatGPT로 명시할 것.
  • 구체적인 이름을 사용하지 말 것: text-davinci-003와 같은 세부 모델명을 사용하지 말 것.
  • 구체적인 모델 이름 대신에 OpenAI라는 용어를 사용하지 말 것 (OpenAI의 전반적인 기술을 언급하고자 할 때는 대신 OpenAI technologies 사용)


4) 파트너십이 아닌 경우

OpenAI는 공식적인 파트너십을 운영하고 있는데, OpenAI와 정식으로 체결된 파트너십이 아닌 경우에는 “협력하는(collaboared with, worked with, partnered with)”과 같은 용어를 사용하지 않고 아래의 가이드라인을 준수해야 합니다.

올바른 표기:

  • building with 혹은 developed with 사용: Pawtopia is building with OpenAI The Pawtopia product was developed with GPT-4

잘못된 표기:

  • 공식 파트너십으로 혼동을 야기할 수 있는 collaborated with, worked with, partnered with 용어 금지: Pawtopia collaborated with OpenAI, Pawtopia worked with OpenAI, Pawtopia partnered with OpenAI


5) 콘텐츠 제작에 활용하는 경우

ChatGPT가 널리 일반인에게도 널리 사용되며, 많은 사람들이 글이나 이미지와 같은 창작물 생성에 OpenAI 모델을 이용하고 있습니다. OpenAI는 해당 경우에 자사의 기술을 이용했음을 의무적으로 밝힐 필요는 없다고 명시하였으나, 혹여나 OpenAI의 기술을 이용했음을 나타내고 싶을 때에는 아래의 가이드라인을 준수해야 합니다. (문제가 될만한 상황을 피하기 위해, 해당 결과물이 전적으로 OpenAI 기술로 만들어졌음을 나타내는 표현을 꺼리는 것으로 생각됩니다.)

올바른 표기:

  • ChatGPT와 함께 작성된 (written with ChatGPT)
  • DALLE와 함께 만들어진 (created with DALLE)

잘못된 표기:

  • ChatGPT에 의해 작성된, ChatGPT로 작성된 (Written by ChatGPT)
  • DALLE에 의해 만들어진, DALLE로 만들어진 (Created by DALLE)


본 아티클에서는 OpenAI의 변화와 최근에 공개된 브랜딩 가이드라인에 대해 살펴보았습니다. 여러분들께서는 OpenAI의 이러한 태도와 변화에 대해 어떻게 생각하시나요?


해당 글의 검토를 도와주시고 인사이트를 제공해주신 @최혜린, @심규현님에게 감사드립니다.

18
5
최동민

최동민

렛서의 다음 인공지능 리포트 맛보기: '달리, 반 고흐, 피카소, 다음은 AI?'

안녕하세요, ‘렛서’의 AI 엔지니어 최동민입니다.

렛서의 지난 리포트, “NLP 연구자가 바라본 AI 동향" 모두 잘 읽어보셨나요? 리포트 발행 전부터 다들 뜨거운 반응을 보내주시고, 발행 이후에도 많은 분들께서 만족스럽다는 피드백을 주신 덕분에 저희 첫번째 리포트를 성공적으로 마무리 할 수 있었습니다.

이번 렛서 리포트는 '달리, 반 고흐, 피카소, 다음은 AI?'라는 제목으로, 비전 생성모델의 동향과 앞으로 시장에 미칠 영향에 대해 다룰 예정입니다. 이번 주 내에 리포트 신청이 시작될 예정이니 다들 기대해주세요! 


본격적인 리포트에 앞서, 해당 글에서는 다음 리포트의 일부인 <비전 모델 기반의 서비스 기획하기> 챕터의 내용을 맛보기로 공유드리고자 합니다. 


<비전 모델 기반의 서비스 기획하기>

1) 원하는 서비스의 입력과 출력 정의하기

  비전 생성모델을 이용하여 서비스를 기획하고자 하는 경우, 해당 서비스가 어떤 입력을 받아서 어떠한 출력을 제공할 지를 정의하는 과정이 우선적입니다. 예를 들어, ‘사용자가 업로드한 이미지에서 배경을 제거하는 서비스'는 입력과 출력이 모두 이미지인 경우에 해당합니다 (입력-사용자가 업로드 한 이미지, 출력-배경이 제거된 이미지). 

또 다른 예시로 ‘특정 영상에서 수정하고자 하는 사항을 문장으로 입력하는 방식 기반의 영상 편집'은 비디오와 텍스트를 입력으로 받아 비디오를 출력하는 서비스에 해당합니다 (입력- 사용자가 업로드한 비디오&텍스트, 출력- 사용자의 요구사항에 따라 생성된 비디오).


 아래는 비전 생성모델을 바탕으로 기획할 수 있는 서비스 사례들입니다. 여러 예시를 참고하여 원하는 서비스를 비전 모델로 구현할 수 있을지, 또한 해당 서비스의 입출력은 무엇일지 고민해보세요. 

[이미지 편집 서비스]

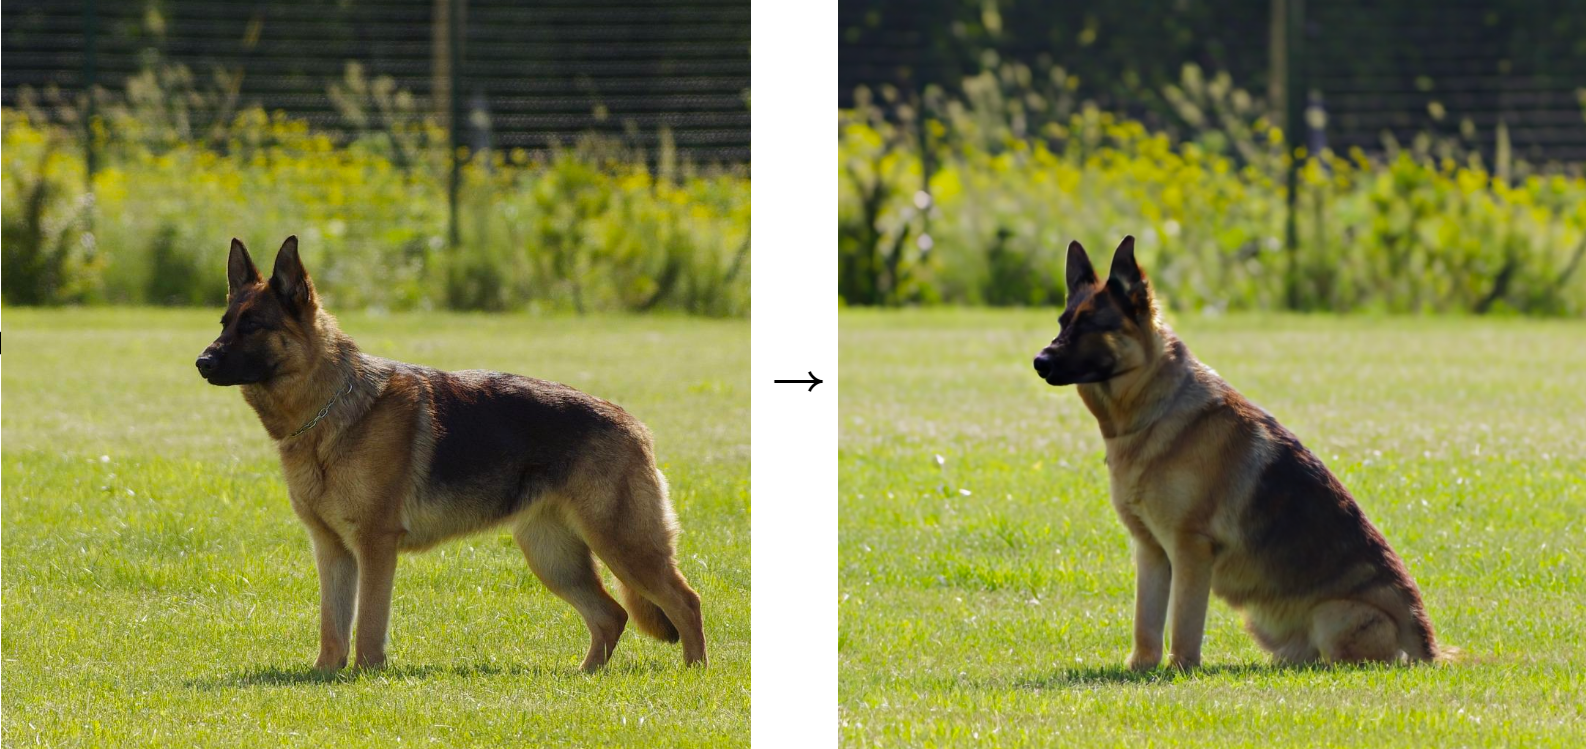
  • 텍스트 기반 이미지 편집 서비스 (입력: 이미지+텍스트 ⇨ 출력: 이미지): 이미지와 함께 수정하고자 하는 부분을 텍스트로 입력하면 해당 정보를 반영하여 이미지 수정 (예시: “해당 이미지에서 고양이를 강아지로 바꿔줘”, “해당 이미지가 밤에 찍은 사진인 것처럼 수정해줘”)
입력 이미지 (왼쪽)에 대해 “앉아있는 강아지 사진” (텍스트)으로 바꿔달라는 지시를 주었을 때의 결과 이미지 (오른쪽) - 출처: https://imagic-editing.github.io/#


  • 이미지 합성 서비스 (입력: 이미지+이미지 ⇨ 출력: 이미지): 두 개의 이미지를 업로드하면 이들을 조합하여 새로운 이미지로 합성 (예시: 인물 이미지와 특정 배경이 담긴 이미지를 함께 제공하여 이미지 속 인물의 배경을 바꾸는 서비스, 주어진 이미지에 원하는 화가의 화풍을 입히는 서비스)
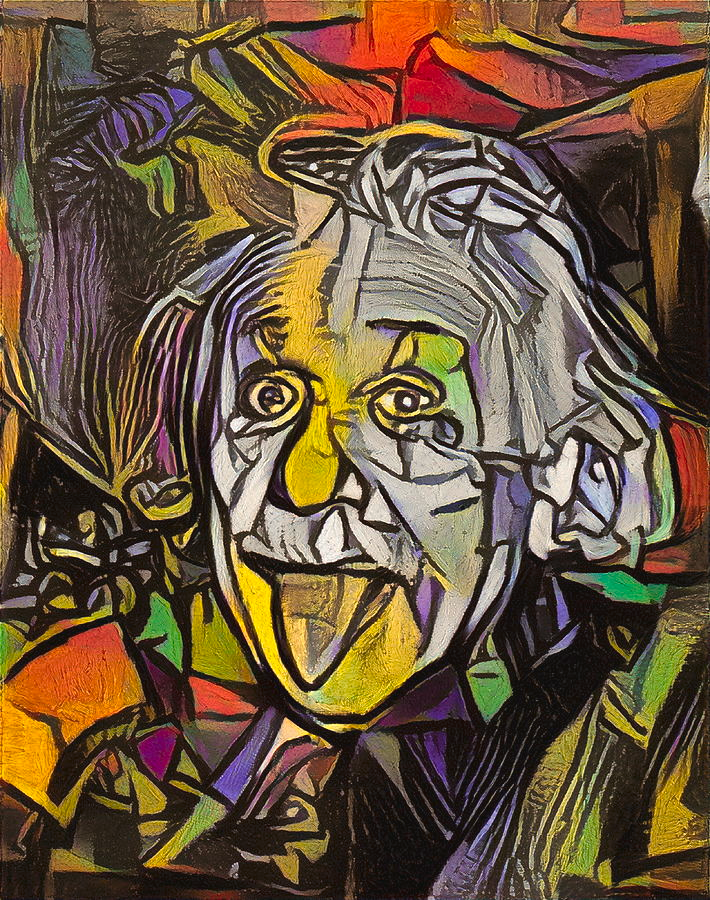
피카소의 ‘우는 여자’와 아인슈타인의 사진을 합성한 이미지 - 출처: https://pixels.com/featured/albert-einstein-meets-weeping-woman-ai-art-ai-artisan.html


[예술/디자인 서비스]

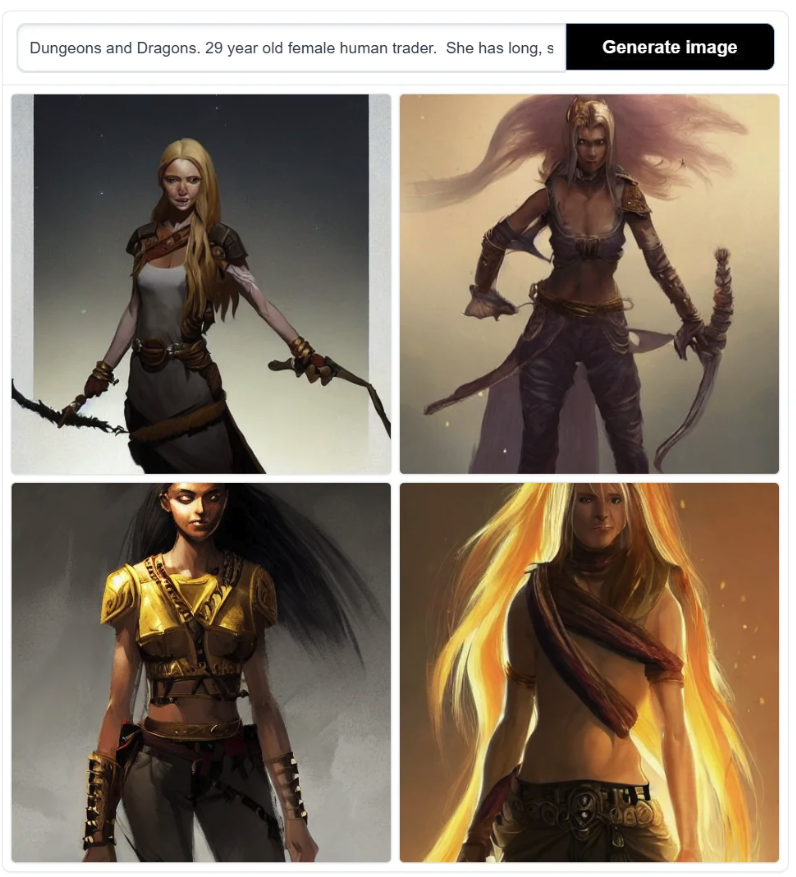
  • 캐릭터/NPC 생성 서비스 (입력: 텍스트 ⇨ 출력: 이미지): 원하는 특징을 반영하고 있지만 서로 다른 다양한 캐릭터 동시 생성 (예시: “귀가 뾰족하고 장발이며 발이 큰 캐릭터 50개를 만들어줘”)
Stable Diffusion을 활용해 “던전 앤 드래곤 스타일로 긴 금발의 생머리인 29세 여성”이라는 텍스트 입력으로 만든 이미지 - 출처: https://www.reddit.com/r/DnD/comments/y1xxnx/tip_characternpc_portrait_generator_with_stable/


[이미지 기반 번역 서비스]

  • 이미지 속 글자 번역 서비스 (입력: 이미지 ⇨ 출력: 텍스트): 이미지 속에 포함된 글자를 인식한 후 특정 언어로 번역된 텍스트 출력 (예시: 영어로 된 영수증 이미지로부터 각 메뉴의 한글 이름과 가격 정보 추출)
  • 이미지 속 글자 번역 및 표기 서비스 (입력: 이미지 ⇨ 출력: 이미지): 이미지 속에 포함된 글자를 인식한 후 특정 언어로 번역한 다음, 새로운 언어로 번역된 글자를 원본 이미지 상에 씌운 이미지 생성 (예시: 파파고 이미지 바로번역 서비스)

출처: https://www.aitimes.com/news/articleView.html?idxno=133541


2) 정의한 입출력에 해당하는 생성모델 선택 혹은 조합하기

  서비스의 입출력을 정의한 다음의 과정은 해당 입력을 바탕으로 적절한 출력을 생성할 수 있는 모델을 선택하는 것입니다. 이 과정에서 단일 생성모델로는 한번에 처리할 수 없는 서비스의 경우, 여러가지 AI 모델 간의 조합을 통해 서비스를 기획할 수 있습니다.

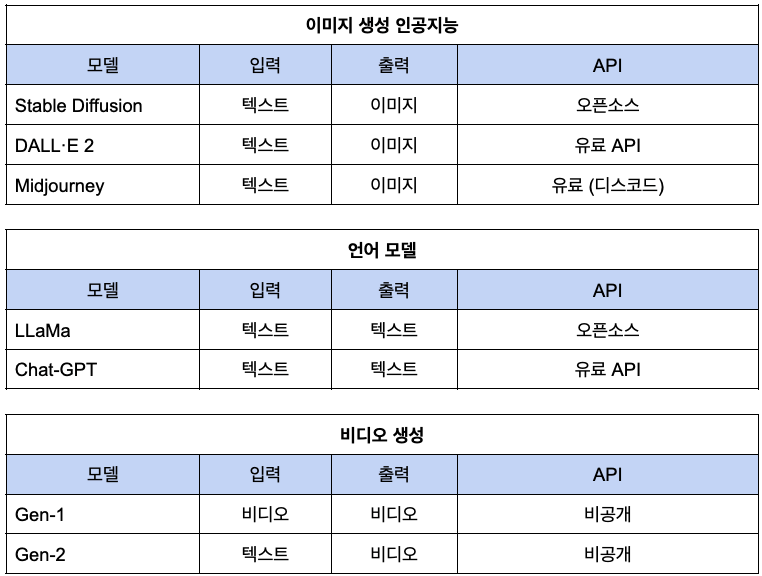
  각 생성모델의 입출력 형태와 API 공개 여부를 정리한 표입니다. 앞서 정의한 서비스의 입출력에 어떤 AI를 사용하는 것이 좋을지 해당 표를 바탕으로 결정해보세요.


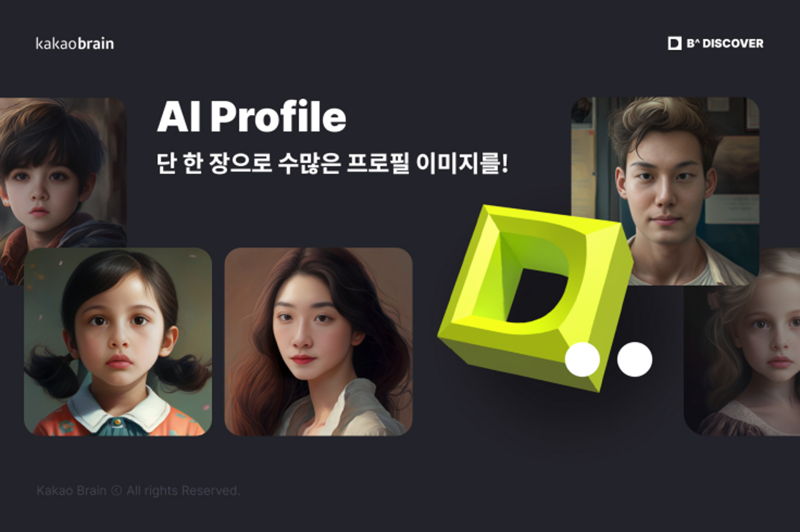
출처:https://bdiscover.kakaobrain.com/ai-profilee

 예를 들어, 카카오브레인의 B’ DISCOVER에서 제공하는 AI Profile과 같은 '사용자가 업로드한 셀카 이미지를 바탕으로 해당 사용자의 사진 여러장을 새로 생성해주는 서비스'의 경우, 입력과 출력이 모두 이미지에 해당하므로 Stable Diffusion을 활용할 수 있습니다. (B’ DISCOVER가 Stable Diffusion을 사용했다는 것은 아닙니다.) 또한 Stable Diffusion은 무료 오픈소스이므로 서비스를 구현하여 사용자에게 제공할 때, 클라우드 혹은 서버 비용 이외의 사용자 요청마다의 API 비용이 별도로 들지 않는다는 장점이 있습니다.


3) 직접 입출력을 정의하고 적절한 서비스를 찾기 어려워요

  앞선 예시와 표를 참고하더라도, 원하는 서비스 기획을 위해 직접 AI 모델을 조사하고 적절한 조합을 찾는 것은 여전히 어려운 과정입니다. 그렇다면 주어진 서비스 정의에 적합한 AI를 더욱 쉽게 찾을 수 있는 방법은 없을까요? 서비스 기획 시 필요한 AI를 선정하는 과정 또한 ChatGPT의 도움을 받을 수 있습니다. 보다 자세한 내용은 곧 출시될 렛서 리포트 전문을 참고해주세요 :)


해당 글의 검토를 도와주시고 인사이트를 제공해주신 @최혜린, @심규현님에게 감사드립니다.


혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)

url thumbnail

최동민

Welcome to my scheduling page. Please follow the instructions to add an event to my calendar.

https://calendly.com/dmchoi-letsur


14
2
최동민

최동민

스탠포드 연구소와 렛서가 바라본 AI 동향: AI Index Report 2023

안녕하세요, ‘렛서’의 AI 엔지니어 최동민입니다.


이번 글에서는 스탠포드의 인간중심 인공지능연구소(Stanford Institute for Human-Centered Artificial Intelligence)에서 매년 발간하는 AI Index Report의 2023년 보고서를 정리하여 저의 생각과 함께 공유드리고자 합니다.

url thumbnail

AI Index Report 2023 – Artificial Intelligence Index

https://aiindex.stanford.edu/report/


AI Index Report 2023은 총 386쪽의 분량에 달하기에 스탠포드 연구소에서 직접 선정한 핵심내용(Top takeaways) 10가지에 대해서만 간략히 소개드리도록 하겠습니다.  

[10가지 요약]

  • 1) AI 산업이 학계를 앞서나가고 있다.
  • 2) 기존 평가기법에 대한 AI 성능은 포화상태이다.
  • 3) AI는 환경을 살리면서 동시에 해치고 있다.
  • 4) 새로운 세계 최고의 과학자는 ... AI?
  • 5) AI 오용과 관련된 사건의 수가 급격히 증가하고 있다.
  • 6) AI 관련 전문 기술에 대한 수요는 거의 모든 미국 부문의 산업에서 증가하고 있다.
  • 7) 지난 10년 동안 처음으로 전년 대비 AI에 대한 개인 투자가 감소했다.
  • 8) 기업별 AI 도입 비율은 고점에 도달했지만, AI를 도입한 기업들은 여전히 앞서 나가고 있다.
  • 9) 정책 결정자들의 AI에 대한 관심이 증가하고 있다.
  • 10) 중국 시민들이 AI 제품과 서비스에 가장 긍정적인 인식을 가지고 있는 반면에 미국인들은… 별로 그렇지 않다.


1) 산업이 학계를 앞서나가고 있다. (Industry races ahead of academia.)

지금까지의 AI는 학계에서 제안된 임팩트 있는 모델들이 산업에 적용되는 흐름(학계 → 산업)이 일반적이었습니다. 하지만 2014년을 기점으로 학계가 아닌 산업이 AI 트렌드를 주도하기 시작하였습니다. 2022년에는 32개에 달하는 영향력 있는 AI 모델들(GPT, Stable Diffusion 등)이 산업에서 만들어진 반면, 학계에서 발표된 모델은 단 3개에 불과했습니다.

이는 고성능 AI를 만들기 위해서는 점점 더 많은 양의 데이터, 컴퓨팅 자원, 비용 등의 리소스가 중요해지고 있기 때문입니다. (연구실이나 대학 단위의 학계보다는 산업이 지출할 수 있는 비용이 압도적으로 많은 것이 현실입니다.)

2002년 이후로 각 분야에서 발표된 영향력 있는 AI 시스템 수의 변화

최근에 많은 주목을 받고 있는 ChatGPT 또한 Microsoft의 지원 하에 OpenAI가 만든 모델이며, 이외에도 DALLE-2, Stable Diffusion, LLaMA, GPT-4와 같은 압도적인 성능의 초거대 AI 대부분이 학계가 아닌 산업에서 만들어진 모델입니다.

#이처럼 각 환경이 가지고 있는 데이터의 양과 예산의 근본적인 차이로 인해 학계와 산업 간 격차는 점차 심화될 것이며, 더욱 양극화될 것으로 예상합니다.


2) 기존 평가기법에 대한 AI 성능은 포화상태이다. (Performance saturation on traditional benchmarks.)

지금까지 AI는 지속적으로 성능을 개선해왔지만 지난 해 대비 성능 향상 폭은 점점 줄어들고 있습니다. 이는 단순히 정답을 맞추는 것에 의존하는 평가지표에 대해서는 AI가 이미 충분한 성능에 수렴했음을 시사합니다. 즉, 단순한 비교 방법들로는 앞으로 더욱 고도화되어 복잡하고 어려운 문제에 대한 AI의 성능을 제대로 평가하지 못한다는 문제가 발생할 수 있습니다.

이와 같은 기존 평가지표의 한계를 극복하기 위하여 최근 연구들은 더욱 복잡하고 세밀한 평가지표들을 제안하고 있습니다. (예를 들어, 최근에 제안된 HELM이라는 지표는 단순히 예측 정확도 뿐만이 아니라 편향(bias), 공정성(fairness), 효율성(efficiency) 등의 총 7가지 요소를 동시에 고려하여 언어모델을 평가합니다.)

각 분야별 평가지표가 생긴 이후로 현재까지 달성한 성능 향상 폭(파란색)과 지난 1년 동안 달성한 성능 향상 폭(보라색)

위 그래프는 각 분야(이미지, 비디오, 언어, 음성인식, 강화학습)에서 주로 쓰이는 여러 데이터셋에 대한 성능 향상 폭을 나타낸 결과입니다. 이 중 파란색 막대(Overall Improvement)는 해당 지표가 처음 제안된 이후부터 지금까지 AI가 달성한 성능 향상 정도를 나타낸 것이고, 보라색 막대(YoY Improvement)는 지난 1년 동안 향상된 성능 폭을 의미합니다. 이를 통해 지난 1년간 달성한 성능 향상의 정도가 확연히 줄어든 것을 확인할 수 있습니다. 


3) AI는 환경을 살리면서 동시에 해치고 있다. (AI is both helping and harming the environment.)

최근에 발표된 연구들에 따르면, AI 모델들은 환경에 막대한 영향을 미치고 있습니다.

뉴욕에서 샌프란시스코로 가는 편도 비행 과정에서 배출되는 승객 한명당 탄소 양을 기준으로 하였을 때, GPT-3를 포함한 초거대 AI 학습 과정에서 배출된 탄소 양

위의 그래프에 나타난 결과처럼, ‘GPT-3’의 학습을 위해 배출된 탄소의 양이 뉴욕에서 샌프란시스코로 가는 편도 비행 과정에서 배출되는 승객 한명당 탄소량의 무려 502배, 한 사람이 1년 동안 배출하는 평균의 약 90배를 초과한다고 합니다. 

탄소 배출은 AI의 학습 과정에서만 배출되는 것이 아니라 실제로 활용할 때에도 지속적으로 발생하게 됩니다. ChatGPT와 GPT-4가 순식간에 대중의 많은 주목을 받으며 일간 사용량이 폭증한 점을 고려하면, 초거대 언어모델은 앞으로도 엄청난 수준의 탄소를 배출하며 환경에 악영향을 미치게 될 것입니다.


반면에 BCOOLER와 같은 강화학습 모델들은 AI를 활용하여 효과적으로 에너지 사용을 최적화할 수 있음을 보여주었습니다. 일례로 3개월에 걸친 BCOOLER 실험에서 강화학습 기반의 AI가 약 12.7%의 에너지 절감 효과를 보였습니다.


#전세계의 여러 기업에서 막대한 양의 데이터를 바탕으로 초거대 모델을 동시다발적으로 학습하고 있으며, 이 과정에서 엄청난 양의 탄소가 배출되고 있습니다. 위와 같은 결과들은 AI의 발전이 우리가 살아가고 있는 환경에도 지대한 영향을 미칠 수 있음을 보여주고 있습니다. 앞으로 AI가 환경을 살리는 방향으로 활용될지 반대로 환경을 해치는 결과를 초래할지는 AI를 만들고 사용하는 우리 모두에게 달렸습니다.


4) 새로운 세계 최고의 과학자는 ... AI? (The world’s best new scientist … AI?)

Deepmind에서 발표한 AlphaFold가 엄청난 성능으로 단백질 구조를 예측하여 화제가 되었던 적이 있습니다. 이후 AI는 급격한 속도로 과학적 진보를 가속화해왔으며, 2022년에는 수소 융합, 행렬 연산의 효율성 향상, 칩의 회로 성능 향상 그리고 새로운 항생제 개발에 AI가 사용되기도 했습니다.

AI를 이용해 특정 항원에 대한 항생제를 만드는 과정


5) AI 오용과 관련된 사건의 수가 급격히 증가하고 있다. (The number of incidents concerning the misuse of AI is rapidly rising.)

2012년 이후로 AI 관련 사건사고가 이전 대비 약 26배 가량 증가하였다고 합니다. 2022년에 발생한 충격적인 사례로 우크라이나 젤렌스키 대통령이 항복을 발표하는 내용의 딥페이크 영상이 온라인상에 퍼지기도 했습니다. 

(왼쪽) 실제 젤렌스키 대통령의 인터뷰 영상 / (오른쪽) 항복을 선언하는 딥페이크 영상


#오늘날 이미지 생성모델이 오픈소스로 공개되어 누구에게나 손쉽게 기술 활용이 가능해지자, 포르노와 같은 성적인 목적이나 사기 수법으로 AI를 활용하려는 어두운 움직임들이 수면 위로 드러나고 있습니다. 기술의 발전에 따라 야기될 수 있는 이와 같은 문제들을 사회적 그리고 제도적 차원에서 면밀하게 고민하고 논의해야 할 과도기임이 분명합니다.


6) AI 관련 전문 기술에 대한 수요는 거의 모든 미국 부문의 산업에서 증가하고 있다. (The demand for AI-related professional skills is increasing across virtually every American industrial sector.)

데이터가 존재하는 미국의 모든 산업(단, 농업이나 어업 등은 제외)에서 AI 관련 직무에 대한 구인 공고 비율이 2021년 기준 1.7%에서 2022년에 1.9%로 증가했습니다. 또한 미국의 많은 고용주들이 AI 기술을 확보한 근로자를 원하고 있습니다.

2014년 이후 각 국가별 AI 관련 구인공고 비율의 변화


우리나라 또한 AI 전문 인력에 대한 수요가 폭발적으로 증가하고 있습니다. 대표적인 채용 사이트인 ‘잡코리아'와 ‘사람인'에서 발표한 자료에 따르면, 2021년 상반기 AI 관련 직무 공고의 수가 전년 대비 각각 57.1%와 84.7%를 기록하며 놀라운 증가율을 보였습니다. 이는 많은 기업에서 AI 도입을 원하고 있으며, AI 인재의 수보다 기업에서 필요한 수요가 더욱 빠른 속도로 증가하고 있음을 보여줍니다.


우리나라의 2016년 이후 AI 고용 수치의 변화

위 그래프는 우리나라의 2016년 대비 상대적 AI 고용 수치(Relative AI Hiring Index)의 변화를 보여주고 있으며, 해당 수치는 링크드인 프로필을 바탕으로 계산되었습니다. 우리나라의 경우, 2017년 말과 2020년 말에 약 1.4에 달하는 높은 증가율을 보였으며, 이후 수치가 점차 감소하여 2022년 하반기 기준 1.05의 증가율을 보였습니다. (이는 2016년에 집계된 AI 고용 숫자에 비해 2022년 말에 수합된 양이 1.05배 증가했음을 의미합니다.) 


7) 지난 10년 동안 처음으로 전년 대비 AI에 대한 개인 투자가 감소했다. (For the first time in the last decade, year-over-year private investment in AI decreased.)

2022년에 집계된 AI에 대한 개인투자 금액은 총 919억 달러 (약 121조)로 2021년 대비 약 26.7% 감소하였습니다. 또한 AI와 관련 투자와 새롭게 설립된 AI 관련 회사의 수 모두 감소하는 경향을 보였습니다. 

하지만, 지난 10년 전체를 보았을 때에는 AI에 대한 투자가 확연히 증가하였습니다. 특히 2022년에 집계된 AI에 대한 개인 투자 금액은 2013년 수치에 비해 약 18배 증가하였습니다.

2013년 이후 여러 종류의 AI에 대한 투자 금액 변화


8) 기업별 AI 도입 비율은 고점에 도달했으며 AI를 도입한 기업들은 여전히 앞서 나가고 있다. (While the proportion of companies adopting AI has plateaued, the companies that have adopted AI continue to pull ahead.)

2022년을 기준으로 AI를 도입한 회사의 비율은 2017년 대비 2배 이상을 돌파했습니다. 하지만 McKinsey의 연간 연구 조사에 따르면, AI를 도입한 기업 비율은 50~60%을 고점으로 수렴하기 시작했습니다.

또한 AI를 도입한 회사들은 여러 분야에서 유의미한 비용 감소와 수익 증대를 달성했습니다.

각 산업군 별 AI 도입에 따른 비용 감소와 수익 증대 수준을 나타낸 결과. 예를 들어 ‘공급망 관리’의 경우, AI 도입을 통해 전체 기업의 52%가 비용 감소에 성공하였으며 이중 41%의 기업이 10% 미만 수준의 비용 절감을 달성했습니다.


9) 정책 결정자들의 AI에 대한 관심이 증가하고 있다. (Policymaker interest in AI is on the rise.)

약 2개월 전, 미국의 한 하원의원이 ChatGPT로 작성한 문장을 그대로 의회 연설문으로 낭독한 사례가 논란을 일으키며 정계에서 AI 규제를 본격적으로 다루기 시작하였습니다.

127개국의 법률 문서에 대한 분석에 따르면, "인공 지능"을 포함하고 있는 법안 중 실제 법률로 통과된 사례가 2016년 기준 불과 1개에서 2022년 기준 37개로 증가하였습니다. 또한 81개국의 AI에 대한 의회 기록을 분석한 결과, AI을 언급한 입법 절차의 수가 2016년 이후로 약 6.5배 증가하였다고 합니다.

각 나라별 AI 관련된 법안의 수를 나타낸 지도


10) 중국 시민들이 AI 제품과 서비스에 가장 긍정적인 인식을 가지고 있는 반면에 미국인들은… 별로 그렇지 않다. (Chinese citizens are among those who feel the most positively about AI products and services. Americans … not so much.)

2022년 IPSOS 조사에서 중국 응답자의 78%(조사 대상 국가 중 가장 높은 비율)가 AI를 활용한 제품과 서비스가 단점보다 장점이 더 많다는 의견에 동의했습니다. 그 다음으로, 사우디아라비아(76%)와 인도(71%) 국적의 응답자들이 긍정적인 의견을 보였습니다. 

한국인의 경우, 62%의 응답자들이 긍정적인 인식을 가지고 있으며 이는 전체 중 9번째에 해당합니다. 반면에 표본 조사된 미국인의 약 35%만이 AI 기반의 제품 및 서비스가 단점보다 더 많은 이점을 가지고 있다는 것에 동의했습니다. 이러한 결과는 나라별로 AI에 대해 가지고 있는 인식이 확연히 다르다는 것을 보여줍니다.


[글을 마무리하며]

이전부터 AI는 지속적으로 고도화되며 매년 놀라운 결과를 보여왔지만, 작년 말부터 올해 초까지 기술 발전은 이전과는 비교도 안될 정도의 빠른 속도로 달려온 것 같습니다. 한달 혹은 한주 단위가 아니라 매일매일 새로운 기술이 쏟아지는 것을 보며 놀라움과 동시에 걱정이 앞서기도 했습니다.

오늘 소개해드린 AI Index Report 2023은 제가 평소에 가지고 있던 생각들을 수치로 보며 정리하며 정리할 수 있는 유익한 자료였습니다. 여러분들은 오늘날의 AI와 앞으로 벌어질 미래에 대해 어떻게 생각하시나요?


해당 글의 검토를 도와주시고 인사이트를 제공해주신 @최혜린, @심규현 님에게 감사드립니다.


혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)
url thumbnail

최동민

Welcome to my scheduling page. Please follow the instructions to add an event to my calendar.

https://calendly.com/dmchoi-letsur

23
9
최동민

최동민

자연어에 이어 이미지도 이제 초거대 AI의 독점 시작?

별도의 학습 없이 SAM을 통해 얻은 Zero-shot Segmentation 결과


안녕하세요, ‘렛서’의 AI 연구원 & 엔지니어 최동민입니다.


ChatGPT의 등장 이후로 대규모 언어 모델(Large Language Model, LLM)은 뜨거운 감자가 되어 AI 트렌드를 독점하기 시작했습니다. ChatGPT, LLaMa 등의 초거대 AI는 기존 모델들을 압도적으로 뛰어넘는 성능을 보였으며, 거의 모든 분야에 접목되어 다양한 서비스에 활용되고 있습니다. 대규모 언어 모델이 가져온 충격은 AI 연구자와 엔지니어에게만 국한되지 않고, 순식간에 대중들에게도 번져나가 이제 어딜가도 ChatGPT에 대한 이야기는 빠지지 않게 된 것 같습니다. 


이와 달리 이미지와 비디오를 해석하고 영상 속 개별 물체를 분류하거나 인식하는 컴퓨터 비전 분야는 비교적 초거대 AI의 독점에서 자유로웠습니다. 이러한 상황에 대해 ‘렛서 3월 리포트’에서 저희 팀은 이미지 분석도 곧 대규모 비전 모델을 필두로 한 AI가 세부 분야에 활용되는 방식이 하나의 흐름으로 자리할 것이라 예상하였습니다. 그러던 중 이틀 전인 4월 5일, Meta AI에서 공개한 Segment Anything Model(SAM)을 보며 그 생각이 점차 현실로 다가오기 시작했다는 것을 깨달았습니다.


아래 링크를 통해 각종 데모를 직접 확인해보세요 :)

url thumbnail

Segment Anything

Meta AI Computer Vision Research

https://segment-anything.com/


[프롬프트 기반의 객체 분할]

프롬프트 엔지니어링은 대규모 언어 모델과 함께 많은 주목을 받고 있으며, 이로 인해 ‘프롬프트 엔지니어'라는 새로운 직업이 생겨나기까지 했습니다.

SAM은 대규모 언어 모델들이 사용자 프롬프트를 바탕으로 놀라운 자연어 처리 성능을 달성한 것에 영향을 받아, 이미지 인식 과정에서도 프롬프트를 적극적으로 활용하고자 시도한 AI입니다. (@심규현 님께서 이전 글에서 소개해주신 Interactive AI의 확장판 & 현 시점 끝판왕이라고 볼 수 있습니다.)

이와 같이 이미지와 함께 제공받은 사용자 입력을 추가로 활용하여 원하는 물체를 분할(segmentation)하는 작업을 promptable segmentation이라는 새로운 용어로 정의하였습니다.


[SAM은 어떤 종류의 사용자의 입력을 받을 수 있을까요?]

SAM은 무려 4종류(점, 박스, 대충 그린(rough) 마스크, 그리고 텍스트)의 사용자 입력을 받을 수 있으며, 이를 하나의 모델로 처리할 수 있다는 유연성이 있습니다. 위 그림 예시처럼, (1) 원하는 고양이 위에 점을 찍거나, (2) 주위를 둘러싸는 박스를 그리거나, (3) 해당 영역을 대충 간단히 그려주거나, (4) 특징을 나타내는 텍스트를 입력으로 제공하여 원하는 마스크를 얻을 수 있습니다. 


[SAM의 성능이 어느정도길래? 또 뭐가 다르길래?]

SAM의 등장 이후로 각종 AI 커뮤니티는 SAM의 놀라운 성능에 대한 이야기로 시끌시끌합니다. 기존에 AI 모델이 객체 분할 작업은 굉장히 잘 해왔는데, SAM은 왜 이렇게 주목을 받고 있는 것일까요?

그 이유는 새로운 이미지 분포와 물체 종류에도 높은 분할 성능을 보이는 zero-shot generalization 능력 때문입니다. 기존의 객체 분할 모델은 학습 데이터에 매우 의존적이기 때문에 학습 과정에서 접하지 못한 형태의 이미지가 주어지면 성능이 확연히 떨어지게 됩니다. 하지만 SAM은 이와 상황에 견고(robust)하여 다양한 형태의 이미지가 주어져도 비교적 정확하게 물체를 구분해낼 수 있다는 장점이 있습니다.

아래는 300개 이상의 물체가 존재하는 이미지에 대한 SAM의 분할 결과입니다. 특히 500개 이상의 물체가 존재하는 마지막 열에 주목해보면, 놀라울 만큼 많은 양의 물체를 잘 구분해내고 있다는 것을 확인할 수 있습니다. 만일 사람이 직접 모든 물체에 대한 마스크를 그린다면 굉장한 시간과 노력이 필요할 것입니다.

위와 같이 SAM이 높은 성능을 달성할 수 있었던 비결은 프롬프트의 활용도 있지만 엄청나게 큰 데이터셋을 바탕으로 학습된 점도 있습니다. Meta가 SAM 학습에 사용한 데이터셋인 ‘SA-1B’는 약 1,100만개의 이미지에 대한 10억개 가량의 물체 마스크로 구성되어 있습니다. 


[SAM이 미칠 영향은?]

그렇다면 SAM은 앞으로 우리에게 어떤 영향을 주게 될까요? SAM을 활용할 수 있는 분야는 무궁무진하겠지만, 저는 우선적으로 ‘학습 데이터 구축 과정의 간소화'가 떠오릅니다.

이미지 라벨링 중 특히 객체 분할(segmentation)을 위해 마스크를 그리는 과정은 개별 픽셀 마다의 물체 정보가 필요하기 때문에 굉장히 번거로우며 많은 시간을 요구합니다. 

앞으로 학습 데이터 구축 과정에서 SAM을 이용하면, 사용자가 물체 하나하나를 직접 그릴 필요 없이 SAM이 분할한 결과를 바탕으로 원하는 물체를 선택만 하거나, 물체에 대한 간단한 설명을 텍스트로 입력하는 방식의 효율적인 라벨링이 가능해집니다.

즉, SAM을 통해 얻은 마스크를 초기 결과로 이용하여 학습 데이터 구축의 전반적인 비용을 줄임으로써 더욱 빠르게 원하는 AI 모델을 학습하여 활용할 수 있습니다. 


또한 SAM은 텍스트 프롬프트도 처리할 수 있기 때문에 Stable Diffusion이나 ChatGPT와 같은 다양한 모델과 결합하여 활용될 가능성이 무궁무진합니다. 앞으로 어떤 창의적인 프로젝트들이 쏟아질지 기대되네요!


혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)


혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)

url thumbnail

최동민

Welcome to my scheduling page. Please follow the instructions to add an event to my calendar.

https://calendly.com/dmchoi-letsur


25
5
최동민

최동민

요즘 이슈인 초거대 AI를 데이터 보안 문제 없이 사용할 수 있을까?

안녕하세요, ‘렛서’의 AI 연구원 & 엔지니어 최동민입니다.


ChatGPT의 등장 이후로 많은 기업들이 LLaMA, Bard 등 다양한 초거대 AI를 앞다투어 공개하고 있습니다. 글로벌 빅테크 트렌드에 발맞추어 다양한 규모의 기업들에서 초거대 AI를 활용해보고자 하는 수요가 폭발적으로 증가하고 있습니다. 현재는 공개된 초거대 AI를 수요기업 자체 데이터로 최적화하여 맞춤형 AI를 구축하는 것이 보편적이나, 이러한 과정에서 ‘나의 소중한 데이터가 유출되지는 않을까?’, ‘너무 많은 비용이 들지는 않을까?’와 같은 걱정이 앞서는 것이 현실입니다.


실제로 @심규현 님이 세일즈 미팅을 다녀오신 다음에 한 말씀을 들어보면, 특히 대기업이나 대학병원에서 데이터 유출에 대한 우려의 목소리가 많았습니다. 이러한 데이터 보안 이슈는 실제로 기업이나 인공지능 프로젝트 규모에 상관없이 언제든지 발생할 수 있는데요, 실제로 최근 OpenAI CEO는 ChatGPT에서 일부 사용자가 타인의 대화 제목을 볼 수 있는 사생활 침해 이슈가 발생하였음을 인정한 사례도 있었습니다.

url thumbnail

OpenAI Confirms Leak of ChatGPT Conversation Histories

OpenAI CEO Sam Altman blames the exposure on 'a bug in an open source library.' A patch has been released, but the chat history sidebar remains inaccessible.

https://www.pcmag.com/news/openai-confirms-leak-of-chatgpt-conversation-histories


다시 본론으로 돌아가, 수요기업들은 ChatGPT와 같이 이미 압도적인 성능을 보유한 채로 공개된 초거대 AI를 자체 데이터에 추가로 학습하여 다양한 세부 작업에 최적화할 수 있습니다. 하지만, 모델의 추가 학습을 위해서는 공급기업-수요기업 간에 모델 전체 혹은 데이터를 공유해야 하며 이 과정에서 막대한 리소스가 필요할 수 있습니다. 이번 아티클에서는, 이러한 문제를 해결하기 위해 제안된 ‘Offsite-Tuning’이라는 방법을 공유드리고자 합니다. (해당 논문은 2023년 2월에 arXiv에 공개되었습니다.)

url thumbnail

[2302.04870] Offsite-Tuning: Transfer Learning without Full Model

https://arxiv.org/abs/2302.04870


해당 방법을 간단히 요약하면, ‘모델 소유자'는 전체 모델이 아닌 압축된 모델을 전달하여 모델 공개를 방지할 수 있으며, ‘데이터 소유자'는 압축된 모델 일부만 내부적으로 추가 학습하여 데이터 유출 방지와 동시에 학습 비용 절감 효과를 달성할 수 있습니다.


※ 아래의 내용은 방법론에 해당하는 부분이니 조금은 어려운 내용일 수 있습니다.

[Offsite-Tuning: 전체 모델 없이 추가 학습하기]

3줄 요약 (TL;DR)

  • Offsite-Tuning을 이용하여 AI 모델을 추가 학습하면, 전체 모델 공개를 방지함과 동시에 학습 데이터의 보안을 동시에 지킬 수 있다. (AI 개발 기업과 수요 기업이 모두 Win-Win!)
  • 모델 일부에 대해서만 추가 학습을 진행하기 때문에 학습 비용을 절감할 수 있다.
  • 기존의 방법대로 추가 학습용 데이터를 모두 공개하여 모델 전체를 학습하였을 때 대비, 성능 저하가 크지 않다.


해당 논문에서는 초거대 AI의 활용 과정을 크게 ‘모델 소유자’와 세부 태스크에 추가 학습 하고자 하는 ‘데이터 소유자'로 구분하여 접근합니다. 이 과정에서 발생할 수 있는 문제점을 각 관점에 따라 아래와 같은 2가지로 나누어 제시합니다.

  • (1) ‘데이터 소유자'가 추가 학습하고자 하는 데이터를 ‘모델 소유자’에게 전달하는 방법 (‘데이터 소유자' → ‘모델 소유자’): 데이터 프라이버시 유출의 위험
  • (2) ‘모델 소유자’가 ‘데이터 소유자’에게 모델을 전달하는 방법 (‘모델 소유자’ → ‘데이터 소유자'): 모델 소유권 침해의 위험

즉, AI 모델의 추가 학습을 위해서는 데이터 혹은 모델을 상대방에게 공개해야 하는데, 이 과정에서 상호간 보안 이슈가 생길 수 있다는 문제점이 있습니다. 이는 비단 초거대 AI에서만 발생할 수 있는 이슈가 아니라, AI를 개발하는 모든 기업과 해당 기업의 서비스를 활용하고자 하는 수요 기업 모두에게 흔히 발생할 수 있는 문제점입니다. 그렇다면 어떻게 양측의 소유권을 동시에 지켜주면서 특정 세부 작업에 추가 학습을 진행할 수 있을까요? 


해당 논문에서는 ‘Offsite-Tuning’이라는 기법을 도입하여 위와 같은 문제점들을 해결하고자 합니다. 위 방법을 다음과 같은 예시를 통해 이해해봅시다.

  • 인공지능 개발 기업인 ‘렛서'가 ‘A 병원’에게 특정 AI 모델을 제공하고자 합니다.
  • 이때 ‘렛서'의 입장에서, ‘A 병원’이 직접 모델을 추가 학습할 수 있도록 AI 모델과 가중치(weights)를 모두 제공하는 것(‘렛서' → ‘A’ 병원)은 회사의 자산 유출의 문제점이 있습니다.
  • 하지만 반대로 ‘A 병원’의 데이터를 ‘렛서'에게 전달하는 것(‘A’ 병원 → ‘렛서')은 프라이버시가 중요한 의료 데이터가 유출된다는 심각한 문제점이 있습니다. (해당 예시에서는 IRB 승인과 같은 상황은 고려하지 않았습니다.)


이러한 상황에서 ‘Offsite-Tuning’을 도입하면, ‘렛서'는 모델 전체에 대한 정보가 아니라 압축된 모델을 ‘A 병원’에게 전달해주게 됩니다. 또한 ‘A 병원’은 ‘렛서'에게 의료 데이터를 공개할 필요 없이 전달받은 압축 모델을 바탕으로 가벼운 추가 학습을 통해 원하는 모델을 완성할 수 있습니다. 따라서 궁극적으로 목표했던 ‘사전학습된 인공지능 모델을 세부 태스크에 추가 학습하기'를 달성함과 동시에 회사 자산과 소중한 병원 데이터를 지킬 수 있게 됩니다.


[아래의 내용은 ‘Offsite-Tuning’의 기술적인 내용입니다.]

‘Offsite-Tuning’의 핵심인 ‘모델 압축'과 ‘추가 학습'에 대해 간략히 정리하면 아래와 같습니다.

  • ‘모델 압축': 해당 논문에서는 데이터 소유자에게 전달하기 위해 압축한 모델을 ‘emulator’라고 부릅니다. 이러한 emulator를 만들기 위해서 layer drop-based 압축 기법을 활용합니다. 해당 방법은 특정 간격의 레이어를 제외한 나머지 레이어를 모두 제거하여 얻은 일부 모델을 활용하는 것입니다.
  • ‘추가 학습': 위와 같은 방법으로 얻은 emulator 전체를 다시 학습하는 것은 여전히 많은 비용을 요구할 뿐만 아니라 대규모 데이터셋를 바탕으로 사전 학습된 정보가 소실될 수 있는 문제가 있습니다. 이를 해결하기 위해서 입력과 출력에 ‘adapter’라는 학습 가능한 작은 레이어들을 구성하여 해당 ‘adapter’만 추가 학습하는 방법을 채택하였습니다.


[‘Offsite-tuning’의 성능]

위 테이블은 자연어 모델인 ‘GPT2’와 ‘OPT’에 Offsite-tuning을 적용하였을 때의 성능 비교입니다. 여기서 주목할 부분은 Full ZS, FT, 그리고 OT Plug-in 입니다. 

  • Full ZS: 추가 학습 없이 기존 모델을 바로 세부 태스크에 적용한 결과 (저성능-비용X)
  • FT: 모델 전체를 추가 학습한 결과 (고성능-고비용)
  • OT Plug-in: Offsite-tuning을 이용하여 추가 학습한 결과 (고성능-저비용)

학습 비용 절감 효과와 동시에 모델 및 데이터의 소유권을 모두 지킬 수 있는 Offsite-tuning (OT Plug-in)은 추가 학습을 거치지 않는 Full ZS 대비 높은 성능을 보여주었으며, 모델 전체를 추가 학습하는 FT와 비교하였을 때에도 크게 떨어지지 않는 결과를 보이고 있습니다. 해당 논문에 따르면 Offsite-tuning이 FT 대비 약 6.5배의 학습 속도 향상 및 약 5.6배의 메모리 절감 효과가 있었다고 합니다.

컴퓨터 비전 분류 태스크에서도 Offsite-tuning은 유의미한 성능 결과를 보여주었으니 관심 있으신 분들께서는 논문 실험 결과 파트를 읽어보시면 도움이 될 것 같습니다 :)


[Offsite-tuning이 인공지능 배포 및 도입에 미칠 수 있는 영향]

모델 학습 비용 절감과 동시에 모델 및 데이터 유출을 방지하는 것은 인공지능 개발 기업과 해당 서비스를 이용하고자 하는 수요 기업 모두에게 굉장히 중요한 요소입니다. 이와 같은 목표를 한번에 달성할 수 있는 ‘Offsite-tuning’이라는 기법을 소개드렸으며 AI 배포 및 도입을 고민하시는 모든 분들께 도움이 되시길 바랍니다 :)


혹시 커피챗을 원하시는 분들께서는 아래 링크에서 신청해주세요 :)

url thumbnail

최동민

Welcome to my scheduling page. Please follow the instructions to add an event to my calendar.

https://calendly.com/dmchoi-letsur


17
8