진용진

진용진님의 아티클

진용진

진용진

린스타트업(Lean Startup)은 스타트업 생태계에 혁신적인 변화를 가져온 개념으로, 저에게도 많은 영감을 준 책입니다. 이 방법론이 스타트업의 역사를 20년 앞당겼다고 표현할 정도로 그 가치를 높이 평가하지만, 한편으로는 많은 사람들이 이 책에서 제시하는 Build-Measure-Learn의 'Build'를 단순히 '개발'로 오해하며 적용하는 모습에 아쉬움을 느끼곤 했습니다. 특히 한국에서는 목적 없는 A/B 테스트나 실제 제품 개발이 필요 없는 가설까지 불필요하게 구현하는 사례를 자주 목격하며, MVP(Minimum Viable Product)라는 단어 자체를 사용하는 것을 개인적으로 선호하지 않았습니다.

사실 한동안 MVP의 정의에 대해 깊이 고민하지 않고 지내왔습니다. 그러던 중 멘토링 중 한 스타트업 대표님께서 "MVP는 어느 정도 구현해야 하나요?"라는 질문을 던지셨고, 그 순간 저도 모르게 자연스럽게 다음과 같이 답변을 드렸습니다: "팀이 알고 싶어하는 것을 확인할 수 있는 수준으로 만드시면 됩니다. 결국 위험한 것은 잘못된 방향으로 최적화를 하는 것이기 때문에, 이점을 조심하시면 됩니다."

린스타트업의 핵심은 불확실성을 줄이고 리스크를 최소화하면서, 사업의 성공 여부를 좌우할 핵심 가정을 빠르게 테스트하는 데 있습니다. MVP는 이를 위한 도구일 뿐, 반드시 정교한 제품 개발로 귀결되어야 하는 것은 아닙니다. 책 초반에 소개된 사례들을 떠올려보면, 드롭박스(Dropbox)는 실제 제품 대신 비디오 데모로 고객 반응을 확인했고, 그루폰(Groupon)은 피자를 직접 사서 블로그에 올리는 방식으로 가설을 검증했습니다. 이러한 사례들은 MVP가 꼭 '만들어진 제품'일 필요는 없으며, 팀이 확인하고자 하는 가정에 대한 답을 얻을 수 있는 최소한의 형태면 충분하다는 점을 보여줍니다.

그런데 2010년대 초반, A/B 테스트가 새로운 개념으로 주목받으면서 린스타트업이 마치 A/B 테스트 중심의 방법론으로 오해받는 경향이 생겼습니다. 이로 인해 고객의 핵심 문제나 기회를 탐색하는 본질적인 노력보다 '어떻게 측정할까'에만 치중하는 모습이 종종 나타났고, 이는 저에게 아쉬움으로 남았습니다. MVP는 단순히 측정 가능성을 확보하기 위한 도구가 아니라, 팀이 무엇을 배우고자 하는지 명확히 정의하고 그에 맞춰 최소한의 자원을 투입해 검증하는 과정이어야 합니다.

결국 MVP의 구현 정도는 '얼마나 정교해야 하느냐'가 아니라 '무엇을 알아내고자 하느냐'에 따라 결정됩니다. 잘못된 방향으로 최적화되는 것을 피하고, 팀이 가장 궁금해하는 질문에 답을 줄 수 있는 수준이면 충분합니다. 이런 관점에서 보면, MVP는 단순히 제품의 초기 버전이 아니라 학습을 위한 도구로서, 때로는 비디오, 블로그, 심지어 고객과 대화만으로도 구현될 수 있습니다. 중요한 것은 그 결과로 얻은 인사이트가 팀을 올바른 방향으로 이끌어주는가라고 생각합니다.

1
0
진용진

진용진

Vercel의 v0, Cursor AI 같은 AI 코드 제너레이터를 활용해 웹 프로토타입을 만든 경험을 뉴스레터로 작성했습니다.

간단한 자연어 프롬프트만으로 UI를 생성하고, API 연동까지 손쉽게 시도할 수 있었서 프로덕트 매니저(PM)도 프로그래밍 전문 지식 없이 프로토타입을 구현하고 배포할 수 있는 가능성을 만들어 주는 것 같습니다.

하지만 어려웠던 점은... 실제 프로덕션 환경 배포 과정과 환경 설정에서 여러 문제를 겪으며 “코딩이 단순히 코드를 작성하는 것이 아니구나”라는 점을 절실히 깨달았습니다 (저는 로컬 환경에서 테스트할 때 이상이 없는데 빌드를 생성하는 과정에서 에러가 꽤 많이 발생했습니다)

Cursor AI와 ChatGPT의 도움을 받아 문제를 해결했지만, 전체 작업 중 대략 30%에 해당하는 기술적인 부분에 90%의 시간을 쏟았던 것 같습니다.

그럼에도 불구하고, 이러한 도구들은 프로토타이핑 속도를 비약적으로 높이고, 가설 검증 주기를 단축시켜 제품 개발의 효율성을 크게 향상시킬 수 있는 잠재성이 보였습니다.

또는 사업적 관점에서 Figma AI나 Vercel의 v0 같은 도구가 프로타이핑 결과를 쉽게 제품에 integration할 수 있게 지원하면 제품 개발 생산성이 크게 높아질 수 있다고 느껴졌습니다.

마지막으로 기술 비전문가로서 코드 작성에 대해서 새롭게 생각을 해볼 수 있었습니다.

코딩은 단순히 코드를 작성하는 것을 넘어서... 문제, 목표, 성공을 정의하고, 여러 접근법의 트레이드 오프를 고민하고, 과거 레거시와 호환성/미래에 대한 확장/제약사항 고려, PM/프로덕트 디자이너 등과 협업을 통한 솔루션을 찾기, 설계/리뷰, 빌드/빌드 관련 문제 해결, 다양한 수준의 테스트를 통한 버그 수정, 배포/배포 후 모니터링 등의 다양한 영역을 포괄합니다.

이러한 과정은 순차적으로 진행되지 않으며, 병렬적이거나 반복적인 접근이 필요합니다. 이 모든 것을 AI가 대체하기에는 한계가 명확합니다.

결국 프로덕트 매니저를 비롯한 제품 개발팀은 AI가 제공하는 생산성 향상과 가설/솔루션 검증 속도 증가에 집중하며, 소모적 논쟁(예: AI로 소프트웨어 개발자를 몇명이나 줄일 수 있을까?)을 넘어 새로운 협업 모델을 찾을 수 있을 것 같습니다. 이를 통해 프로덕트 팀 전반의 역량과 가치 창출 속도를 한 단계 끌어올릴 수 있을리라 믿습니다.

PM Prompts

PM을 위한 AI 프롬프트 큐레이션

3
0
진용진

진용진

실리콘밸리 투자자와 커피챗

최근 한국 시장에 관심이 있는 실리콘밸리의 한 투자자와의 커피챗을 했습니다. 함께 관심을 가졌던 주제, 문제인식은 마켓플레이스에서 공급자 매칭과 콘텐츠 생성의 높은 비용이었습니다. 하지만 AI 기술로 고객 가치 사슬을 디커플링하여, 고객이 많은 시간을 들여야 했던 공급자 탐색 활동을 대신 처리해주는 것이 이 스타트업의 주요 가치 창출 방식이라는 점을 서로 공감했습니다. 이밖에 부수적으로 콘텐츠 생성 자동화도 Generative AI 상당히 효율화할 수 있는 점이 시장에서 관찰되고 있다는 점도 논의했습니다.

Product-Led Growth: 사용자 경험 중심의 성장
이번 대화에서 투자자는 매출보다 '리텐션'에 집중했습니다. 한국 사용자들이 해당 스타트업을 얼마나 자주 사용하고 있는지, 제품의 'stickiness'는 어느 정도인지. 브랜드 인지도와 충성도에 대한 논의도 자연스럽게 이어졌습니다. 다가올 해의 사용자 성장 예측에 대해 물었을 때, 저는 구체적인 숫자보다는 잠재 고객의 규모와 시장 성장 가능성을 중심으로 설명했습니다.

또한 해당 팀의 기술력과 제품 주도 성장을 지속할 수 있는 역량에 대해 이야기했습니다. 기술을 활용해 뭔가를 '시작'하는 것은 많은 팀이 할 수 있습니다. 하지만 그 기술을 스타트업의 고유한 가치로 만들어내는 것은 쉽지 않은 일입니다. 그리고 이 팀은 그 어려운 일을 해내고 있습니다.

디커플링과 Product-Led Growth의 교차점
결국 우리의 논의는 한 가지 주제로 정리되는 것 같았습니다. 고객 가치 사슬의 디커플링... 고객이 불필요한 활동을 줄임으로써 가치를 창출하는 것은 물론, 스타트업 입장에서도 특정 이해관계자와 가치 사슬에 대한 투자 부담을 줄일 수 있습니다. 이를 통해 자원을 더욱 집중할 수 있는 환경이 만들어지고, 제품 기반 성장을 더욱 강화할 수 있습니다. 이렇게 전략적으로 고객 경험과 스타트업의 비즈니스 집중도를 함께 개선하는 것이 투자자에게 매력적인 요소로 작용했음을 느꼈습니다.

한국 스타트업 생태계
이번 커피챗을 통해 한국 스타트업 생태계에 대한 글로벌 투자자들의 관심을 다시 한번 확인했습니다. 영어로 모든 내용을 명확하게 전달하지 못한 아쉬움도 있었지만, 이번 대화는 저에게 큰 동기부여가 되었습니다. 더 나은 제품 경험을 만들기 위해 무엇을 해야 할지, 앞으로의 방향성을 고민하게 만든 좋은 기회였습니다 :)

1
0
진용진

진용진

상품 소개서로 아이디어 근거(Evidence) 모으기

2015년에 개봉한 빅쇼트(The Big Short)는 2008년 글로벌 금융 위기를 배경으로, 주인공들이 서브프라임 모기지 시장의 붕괴를 예측하고, 이를 통해 거대한 수익을 얻는 이야기를 다룬다. 

영화 빅쇼트하면 많은 사람들이 떠오르는 인물은  대형 투자은행에서 제공하는 모기지 채권(MBS)을 분석하고, 이 채권들이 곧 가치가 하락할 것이라는 결론을 내린고, 이를 바탕으로 기존 금융 전문가들이 무시한 신용 부도 스와프(CDS)라는 새로운 금융 상품에 투자하기로 결정한 마이클 버리(크리스천 베일)이지만, 프로덕트 매니저 관점에서 영화 속에서 가장 인상적이었던 장면은 마크 바움(스티브 카렐)과 그의 팀이 직접 플로리다의 주택 시장을 조사하는 과정이다. 

그들은 현장에서 수많은 빈집과 파산한 주택 소유자들을 목격하며, 금융 시스템의 심각한 결함을 직접 확인하게 된다. 이 과정에서 그들은 기존에 알지 못했던 새로운 정보와 현실을 마주하게 되는데(사망자, 애완견, 스트립퍼 대상으로 묻지마 대출이 진행되는 현실), 이는 우리가 제품 개발에서 예측하지 못했던 기회를 탐구하고 새로운 인사이트를 발견하는 과정과 매우 유사하다. 

이렇게 시장의 상황을 빠르게 직접 눈으로 확인하여 근거(evidence)를 확보한 마크 바움 팀은 자신들의 가설에 대한 확신(confidence)의 수준을 높이고, 대량의 CDS를 매수한다. 그리고 그 결과 마크 바움 팀은 서브 프라임 모기지 이슈가 발생하면서 큰 돈을 벌게 된다. 

빠르게 고객 니즈를 파악하여 근거(Evidence)를 모아라

제품 개발은 크게 발견(product discovery)와 배포(delievery)로 구분된다. 다시 설명하면 제품팀이 잘 모르는 영역을 알아가는 과정과 이를 바탕으로 디자인, 엔지니어링을 통해 제품에 가치를 증분하는 작업 과정으로 구성된다.

많은 팀들이 경우 제품 발견(product discovery)을 생략하고 바로 기능을 개발하는 단계로 건너 뛰는 경우가 많다. 이렇게 제품을 만들면 3-4명의 제품팀 멤버(PM, 엔지니어, 디자이너)가 최소 2-3주 개발을 진행하게 된다. 

그렇게 배포된 기능은 대부분 성과가 바로 나타나지 않기 때문에 후속 개선 작업을 진행한다. 문제는 이 개선 작업이 프로젝트 시작부터 애초에 근거(evidence)가 빈약한 상태였기 때문에 계속해서 잘못된 최적화를 시도하게 된다. 그러면 이렇게 추가로 1-2주 더 시간이 지나간다. 여기서 제품 발견을 중요하게 생각하지 않는 조직이 좋아하는 단어 '리소스' 기준으로 계산하면 멤버 1명당 연봉이 7천만원이라고 가정하면 최소 3명 기준으로 2000만원의 비용이 소요되는 것이다. 단순한 인건비 손해 외 팀 전체적으로 단순히 기능 구현에 집중했기 때문에 팀이 모르고 있는 영역(unknown)에 대해 팀의 학습과 이해도를 높일 수 있는 기회를 잃게 된다.

제품 개발 비용 계산...

어떻게 하면 빠르게 모르는 것(unknown)을 파악할 수 있을까? 내가 자주 활용했던 방법은 바로 제품을 만들지 않고, 상품 소개서를 기반으로 바로 고객 및 시장의 이해관계자를 만나는 것이다. 

과거 카카오스타일에서 포스티(Posty)라는 신규 사업을 담당할 때 상품 소개서를 빠르게 제작하여 브랜드 패션 기업을 컨택했다. 아직 제품이 만들어지지 않은 상태였기 때문에 포스티가 풀려고 했던 문제점과 비전을 중심으로 상품 소개서를 제작했다. 상품 소개서가 구체적이지 않았지만, 당시 팀이 브랜드 패션 시장에 대한 이해도가 높지 않은 상태였기 때문에 빠르게 시장의 이해관계자를 만나서 니즈를 파악하는 것이 중요하다고 생각하여 바로 컨택을 진행했다.

당시에 우리 팀은 브랜드 패션에 있어 핵심 이해관계자가 벤더사(온라인 판매 대행사)일 것이라고 가정했다. 주요 브랜드 패션 커머스 플랫폼에서 상세 페이지 정보를 확인하면 주요 연락처에 스탁컴퍼니, 웹뜰과 같은 벤더사 정보가 있어서, 브랜드 패션에 있어 벤더사를 공략하면 패션 브랜드 입점 세일즈가 효율적일 것이라고 생각했다. 

하지만 몇 번의 미팅을 진행하니 우리의 가정이 틀렸다는 것을 파악했다. 다른 온라인 비즈니스(예: 광고)의 대행사와 달리 패션 커머스 시장에서 벤더가 가진 권한이 크지는 않았다. 커머스 플랫폼 입점은 벤더가 단독으로 진행할 수 없고, 패션 브랜드사의 승인을 받아야 진행이 가능했다. 주요 벤더사를 통해 우리 플랫폼 영업이 빠르게 확장하길 바랐던 바람은 그저 행복한 상상일 뿐이었다. 또 한편으로는 잘못된 가정으로 제품 개발을 시작했다면 1개의 벤더사가 여러 브랜드를 대행하여 관리하는 영역에 대해서 잘못된 엔지니어링 요구사항을 정의할 수도 있었다. 다행히 빠른 검증을 통해 잘못된 문제 정의를 하지 않게 되어서 마음의 안심을 얻기도 했다.

상품 소개서를 통해 계속 브랜드사 미팅을 진행하면서 피드백 기반으로 계속 상품 소개서의 콘텐츠를 업데이트하였고, 또한 제품 개발 관련해서 여러 근거들을 확보할 수 있었다. 팀이 이 과정을 통해 얻게 된 인사이트는 아래와 같다.

1. 패션브랜드 기업 내부의 중요한 조직간 이해관계가 존재한다. 오프라인 채널과 온라인 채널을 관리하는 조직이 분리되어 있으며, 주요 재고는 오프라인 매장 중심으로 우선순위 높게 유통이 된다. 만일 온라인 판매 가격이 오프라인 판매가 보다 낮은 경우 두 조직간의 이해관계 충돌이 발생한다. 이에 대한 대안으로 우회적으로 네이버 지식쇼핑에 가격이 노출되지 않는 온라인 판매 방식을 활용하거나 기업 내부적으로 합의를 통해 기획전이란 형태로 프로모션을 진행한다. 하지만 이 경우에도 조직간의 긴장감이 존재한다. 이밖에 오프라인 조직은 신상을 판매하고, 온라인 조직은 이월상품 중심으로 판촉 활동을 진행하는 경우도 존재했다. 따라서 패션 브랜드 온라인 MD 담당자가 오프라인 조직로부터 챌린지를 최소화할 수 있는 상품 노출/유통 구조가 필요했다.

2. 온라인 채널을 관리하는 MD 인력 대비 관리하는 플랫폼이 많다. 기본적으로 패션브랜드는 전통적인 리테일 비즈니스의 자산을 가지고 있다. 영업이익이 전반적으로 높지 않은 상황에서 이커머스 조직에 대한 투자를 적극적으로 하기 힘든 상황이다. 따라서 적은 수의 MD 멤버가 여러 온라인 채널(예: 하프클럽, 패션플러스 등)을 관리해야 한다. 여러 온라인 채널에 상품 정보(상품명, 옵션, 가격정보 등)와 주문 정보를 동시에 관리해야한다. 이를 위해서 브랜드 패션 MD는 셀링툴(예: EC모니터, 사방넷, 플레이오토, 샵링커)이란 솔루션을 통해 단일한 인터페이스로 온라인 채널의 상품, 주문 정보를 관리하고 있다. 사실 우리팀은 셀링툴이란 존재도 모르고 있던 상황이어서 빠르게 관련해서 상품정보 연동하는 API를 개발하고, 셀링툴 업체와 빠르게 계약을 맺어서 연동 개발을 진행했다. 외부 업체와 빠르게 계약하고 연동하는 과정은 사실 쉽지 않은데, 작업 중간에 다행히 상품 정보를 관리하는 유관부서가 지원을 해주어 적절한 시점에 필요한 bottleneck을 해결할 수 있었다. 이후 셀링툴 업체 연동 개발은 포스티 뿐만 아니라 지그재그의 브랜드 사업 확장에도 활용될 수 있었다.

https://www.perplexity.ai/search/ecmoniteo-sabangnes-peulreioto-7GeJCx5aSbijjGbxZbYoQQ

https://www.perplexity.ai/search/ecmoniteo-sabangnes-peulreioto-7GeJCx5aSbijjGbxZbYoQQ

3. 가격 할인 제약으로 인해 별도 장치가 필요하다. 패션 브랜드는 주로 기획전을 여러 플랫폼을 구분해서 일정을 나눠서 진행을 한다. 보통 패션브랜드 MD는 셀링툴을 통해 여러 온라인 채널의 가격을 관리하기 때문에 기획전 또는 어떤 형태의 할인에 대해서 특정 채널의 판매가격을 낮추는 것을 부담스러워 한다. 또한 브랜딩 또는 오프라인 매장과 가격 일관성 관점에서 판매가를 건드리기 보다는 별도 상품 쿠폰 형태의 할인을 선호한다. 결국 플랫폼을 운영하는 입장에선 수요를 만들기 위해서 가격을 낮추는 기재가 필요한데 이러한 요소에 대한 고려가 필요하다. 일반적인 형태는 쿠폰 플레이를 생각할 수 있고, 이밖에 컨셉 관점에서 접근하면 공동 구매와 같은 장치를 통하여 우리 플랫폼 만의 가격 체계를 설계할 수도 있다. 

4. 브랜딩에 대한 안심이 중요하다. 이 일을 하면서 "매출이 인격이다"라는 말을 많이 들었지만, 여전히 패션 브랜드사 담당자가 우려하는 것은 브랜딩이었다. 대부분 담당자 분들은 "입점한 브랜드가 어떻게 되나요?"라고 항상 질문을 하신다. 새로운 플랫폼이기 때문에 Selection이 어떤 전시 구조로 보여지는지 명확하지 않기 때문에 이 점을 잘 커뮤니케이션하는 것이 중요했다. 기본적으로 우리팀은 기술 기반으로 패션 시장의 문제점을 혁신하는 장점이었다. 관련해서 유저 데이터 기반으로 개인화된 상품 추천 방식으로 이에 대한 우려를 해소시키려 했다. 결국 초기 프로덕트에서 브랜딩과 관련해서 높은 퀄리티의 크리에이티브를 제공하는 쇼케이스 CMS 같은 플랫폼을 제공하는 것이 어려웠기 때문에 이 점은 숙제로 가져갔었고, 항상 신중하게 커뮤니케이션하려고 모두가 노력했다.

브랜드 패션에 대해서 낮았던 팀의 이해도는 빠르게 상품 소개서 기반으로 사업의 가치제안을 검증하면서 점점 개선이 되었고, 이러한 요구사항은 제품 개발에도 반영되었다. 당시 포스티팀은 풀타임 5명(PM, 디자이너, 사업개발, MD), 파트타임 1명(CTO)의 소규모 조직이었고 이렇게 2개월을 준비하여 포스티 서비스를 출시했다. 출시 후 사업 추진 과정에서 아쉬운 점이 많았지만 커머스 프로덕트를 2개월만에 출시하고, 이후 빠르게 월 거래액 10억원 대에 진입한 점은 팀 스스로 자부심을 가져도 좋다고 생각한다.

첫번째 버전의 포스티는 도전적인 UX로 시도를 했었다. 이후 몇번의 피벗을 거쳐 무료 쇼핑 분야 순위 2위에 오르기도 했다.마지막은 포스티 사례를 공유했던 사내 강의 포스터 이미지

알지 못하는 것을 인정하는 지혜

영화 빅 쇼트에서 마크 트웨인의 문장을 인용하여 다음과 같이 말한다

- "곤경에 빠지는 건 뭔가를 몰라서가 아니다. 뭔가를 확실하게 안다는 착각 때문이다." 

이 말은 우리가 직면한 불확실성과 위험을 통찰력 있게 요약한 표현이다. 그러나 나는 이 말을 조금 다르게 해석하고 싶다. 우리는 종종 근거(Evidence)가 없는 의견을 확신에 차서 주장하는 경우가 있다. 뭔가를 안다고 생각하지만, 사실 잘못된 근거와 정보를 기반으로 알고 있는 것이다. 이러한 착각은 열심히 일해도 성과(outcome)가 나타나지 않는 악순환을 만들어낸다. 결국, “내가 다 안다”는 착각은 우리가 뭘 모르는지조차 모르는 상황을 낳는다.

이런 상황은 제품 개발이나 비즈니스 전략에서도 자주 일어난다. 많은 기업들이 소비자가 무엇을 원하고 필요로 하는지 완벽히 이해하고 있다고 믿는다. 하지만 그들이 실제로 가지고 있는 데이터는 편향되거나 불완전할 수 있다. 또는 데이터도 없이 개인의 의견(opinion)과 오피니언 배틀로 주장을 관철시킨다. 그 결과, 잘못된 방향으로 나아가며 자원을 낭비하고 시장에서의 기회를 놓치는 경우가 발생한다.

결국, 중요한 것은 ‘모르는 것을 인정하는 것’이다. 이는 무능함을 의미하는 것이 아니라, 성장과 발전을 위한 첫걸음이다. 제품 개발에서 성공하기 위해서는 우리가 모르는 것을 모른다는 사실을 인정하고, 이를 해결하기 위해 끊임없이 탐구하고 학습해야 한다. 이것이 소위 말하는 제품 발견(Product discovery)이다.

우리가 알고 있다고 착각하는 것에서 벗어나, 진정한 학습과 발견의 과정을 통해 아웃풋이 아닌 성과(outcome)를 만들어내야 한다. 그렇게 할 때 우리는 비로소 고객 가치를 위한 유의미한 일을 실현하고 있는 것이다.

영화 빅쇼트의 장면

 ---

Product Moment 뉴스레터 내용을 기반으로 하고 있습니다.

4
0
진용진

진용진

Retros 커뮤니티 멤버 모집

안녕하세요. 회고를 통해 개인의 삶과 커리어의 성장을 지원하는 Retros에서 1기 커뮤니티 멤버를 모집합니다. Retros는 작은 회고의 습관을 통한 점진적인 성장을 추구합니다.

이번 1기 커뮤니티는 디자인 직군 종사자를 대상으로 모집합니다. 창립 멤버로서, 회고를 통해 일과 삶의 방식을 변화시키는 여정에 함께하시길 기대합니다.

운영은 카카오톡 오픈채팅을 기반으로 운영될 예정이며, 구체적인 운영 안내는 신청자 대상으로 별도 안내드리도록 하겠습니다.

https://forms.gle/azXdDhW4B62qKn438

3
0
진용진

진용진

고객 인터뷰 자동화 관련해서 참고할만한 팁인 것 같습니다.

미국에선 세일즈 콜 관련해서 인사이트를 도출할때 GONG, Chorus.ai, Otter.ai 같은 프로덕트를 활용하고 GONG은 기업가치도 매우 높은 것으로 알고 있습니다. 제가 예전에 리턴제로에서 Callabo.ai 개발할때도 이들 모델을 참고를 했습니다.

Lenny's Podcast에서 Kevin Yien이 Gong-Slack-Zapier-Calendly 통합해서 고객 인터뷰를 자동화하는 것을 소개했는데요. 그 플로우는 다음과 같습니다.

1. Gong에서 관심 토픽 키워드를 설정하면 슬랙으로 알림이 오는 기능이 있음 (고객 정보와 함께 세일즈콜 녹취된 문장과 슬랙으로 발송됨)

2.  Zapier와 같은 툴을 사용해 Slack에 새로운 알림이 올 때마다 자동으로 Calendly 템플릿이 포함된 이메일을 보내서 사용자 인터뷰 예약할 수 있도록 함

결국 세일즈, CX매니저가 가공한 정보 보다 프로덕트 팀이 원시 자료에 노출되어, 고객과 상호작용을 유지하는 것이 핵심입니다.

3
0
진용진

진용진

퍼플렉시티(Perplexity): AI 검색의 미래

최근에 렉스 프리드먼 유튜브에서 퍼플렉시티 CEO 아라빈드 스리니바스(Aravind Srinivas)와 인터뷰를 봤습니다. 제가 최근에 봤던 스타트업 창업자/CEO 중에서 가장 스마트한 사람처럼 느껴졌습니다. 고객에 대한 집착과 기술에 대한 높은 이해도로 매우 실용적으로 소위 말하는 제품 주도 성장을 이루어낸 경영자로 보였습니다. 이밖에 인터뷰를 보면 구글 검색광고 포함하여 온라인 비즈니스의 핵심을 잘 설명하여서 인상적이었습니다.

이번 기회로 Perplexity 제품에 대한 이해도를 높여보려고 서비스도 많이 이용해봤고, 내용을 정리해서 브런치에 '퍼플렉시티: AI 검색의 미래'라는 브런치북도 발행했습니다.


Perplexity 제품 소개

Perplexity는 기본적으로 Wrapper 역할을 하는 서비스입니다. 오픈 소스 기반(LaMA, Mistral Large) 자체 모델(Sonra) 최근에 운영하고 있지만, GPT-4o, Claude-3와 같은 외부 모델을 서비스에서 같이 제공하고 있습니다. 핵심은 사용자 입장에서 어떤 모델을 사용하더라도 높은 품질과 빠른 속도의 답변을 제공하는 것입니다.  

제품 관점에서 Perplexity AI의 핵심 컴포넌트는 검색엔진/인덱싱, LLMs, RAG로 나눠볼 수 있습니다. 제가 몇가지 글을 블로그에 작성해보고 다른 검색엔진과 비교를 했는데 Perplexity는 빠르게 인덱싱이 되어 서비스에 결과로 제공되는 것 같습니다. Perplexity 웹 검색은 오픈 소스 기반으로 구축된 Peprlexity LLM과 매끄럽게 통합되어 정확도 뿐만 아니라 맥락적으로 관련성이 높고 최신성 있는 답변을 제공하고 있습니다.

어쨌든 제가 느낀 차이점이 인덱싱의 차이인지 제가 쓴 글이 상대적으로 전문적인 편이라서 학술적 정보 탐색에 특화된 Perplexity AI 특성상 높은 가중치를 가지는지는 확실하지 않습니다. 어쨌든 구글과 같은 다른 검색엔진과 비교했을때 빠르게 색인되서 서비스 제공되는 점은 초기 스타트업이 갖추기 힘든 기술적 우위임은 확실한 것 같습니다. 

이밖에 Perplexity는 LLM의 지속적인 문제 중 하나인 정보의 최신성 부족과 잘못된 정보를 생성하는 환각(hallucinations)를 RAG(Retrieval-Augmented Generation ) 프레임워크를 시스템에 통합하여 해결하고 있습니다. RAG 시스템을 통해 Perplexity는  잘못된 정보나 오해를 불러일으킬 수 있는 정보를 생성할 가능성을 줄일 뿐만 아니라, 인용을 포함하여 생성된 콘텐츠의 투명성과 신뢰성을 높여줍니다.

궁금해서 국내 LLM 기반의 Wrapper 서비스을 찾아보니 대부분 UX가 Perplexity AI와 유사했습니다. 마치 검색 서비스가 비슷한 UX를 오랜 기간 여러 플랫폼에서 범용적으로 디자인된 것처럼 정보 탐색과 관련해서 Perplexity의 사용자 경험이 사실상 표준처럼 당분간 되지 않을까 싶습니다.


Perplexity의 시작

Perplexity의 공동 창업자인 Arvind Srinivas와 Denis Yarats는 Facebook AI 연구소에서 각각 연구를 진행하던 중, 우연히 같은 문제를 연구하게 되면서 서로 인연을 맺게 되었습니다. 2020년 COVID-19 팬데믹이 한창일 때, 두 사람은 각기 동일한 연구 결과를 담은 논문을 발표했는데 이로 인해 경쟁자가 될 수도 있었던 상황에서 오히려 서로 협력하게 되었습니다. 이후 Denis는 UC 버클리에서 Arvind와 협업을 이어갔고, 두 사람은 긴밀한 관계를 유지하며 각자의 커리어를 발전시켜 나갔습니다. 그리고 추가로 제품과 엔지니어링에 강한 Denis의 친구이자 2013년 Quora에서 함께 일했던 동료인 Johnny Ho를 공동 창업자로 맞이합니다.  Johnny는 세계적인 수준의 실력을 가진 인물로, 고등학생 때 IOI(국제정보올림피아드) 세계 챔피언이었던 경험이 있었습니다.

https://www.perplexity.ai/search/who-are-the-founders-of-perple-kI4nE8HZSLyNt5.X.bppkw#0

그들은 초기에 OpenAI의 DaVinci2 모델 기반으로 Text를 SQL로 변환하는 Text-to-SQL tool을 개발했습니다. 검색엔진을 개발하고 싶었지만 자금 조달이 쉽지 않을 것이라 이 아이디어를 실행하기로 했습니다. Text-to-SQL tool을 개발하면서 두 창업자는 사용자들이 이전에는 검색할 수 없었던 영역에 대한 검색 경험을 제공하는 것을 목표로 움직였습니다.

초기 Perplexity팀은 공공 데이터를 활용하고자 했습니다. 특히 그들은 트위터 데이터에 주목했습니다. 트위터의 API를 통해 데이터를 대량으로 수집하고, 이를 정리하여 데이터베이스에 저장한 후, 자연어 인터페이스를 구축해 데이터를 분석할 수 있도록 했습니다. 예를 들어, Twitter와 같은 소셜 미디어에서 특정 사용자가 팔로우하는 사람들 중에서 두 명이 공통으로 팔로우하는 사람을 찾는 질문을 던질 수 있도록 하는 것이었습니다. 이런 질문들은 AI가 의미를 이해하고 이를 SQL로 변환하여 데이터베이스에 실행한 후 결과를 반환하는 과정을 통해 가능해졌습니다. 

이 접근 방식은 GitHub Copilot에서 영감을 받아 개발된 코드 생성 모델들을 활용해 이루어졌습니다. Perplexity 팀은 사용자가 자연어로 입력한 질문을 AI가 이해하고, 이를 SQL 쿼리로 변환하여 데이터베이스에서 실행하도록 했습니다. 예를 들어, “Elon Musk와 Jeff Bezos가 공통으로 좋아요를 누른 최근 트윗은?“이라는 질문을 던지면, AI가 이 질문을 SQL로 변환하고, Twitter의 소셜 그래프 데이터베이스에서 해당 쿼리를 실행하여 결과를 반환하게 했습니다.

Perplexity 팀은 이러한 아이디어를 실현하기 위해 몇 가지 기술적 도전에 직면했습니다. 먼저, SQL 쿼리 생성의 복잡성을 처리하기 위해 RAG(Retrieval-Augmented Generation) 접근 방식을 사용했습니다. 이는 AI가 사용자 질문과 유사한 템플릿 쿼리를 검색하고, 이를 기반으로 새로운 쿼리를 작성하는 방식이었습니다. 하지만 초기에는 생성된 SQL 쿼리에 오류가 발생할 때도 많았고, 이러한 오류를 처리하고 재시도하는 메커니즘을 구축해야 했습니다.

또한, Perplexity 팀은 Twitter의 데이터를 학술 계정을 통해 스크래핑하는 방식으로 수집했습니다. 이 과정에서 일종의 그로스 해킹으로 여러 개의 가짜 학술 계정을 생성하고, GPT를 활용해 연구 제안서를 작성하여 데이터를 수집했습니다. 이 방법으로 수집된 방대한 소셜 그래프 데이터를 기반으로, Perplexity는 사용자들이 이전에는 불가능했던 수준의 검색 경험을 제공할 수 있었습니다.


초기 성과와 깨달음

Perplexity 팀은 이 과정을 통해 Twitter의 소셜 그래프를 활용한 검색 경험을 제공하는 데모를 만들었습니다. 이 데모는 얀 르쿤(Yann LeCun), 제프 딘(Jeff Dean), 안드레이 카르파시(Andrej Karpathy) 등에게 시연되었고, 모두 긍정적인 반응을 얻었습니다. 사람들은 자기 자신이나 관심 있는 사람들에 대해 검색하는 것을 좋아하기 때문에, 이러한 호기심을 자극하는 데모는 좋은 인상을 남겼습니다. 이를 통해 Perplexity 팀은 초기 사용자층을 확보할 수 있었고, AI를 기반으로 한 검색의 가능성을 확인할 수 있었습니다.

Perplexity의 초기 Twitter 검색 기능은 단순한 기술적 실험을 넘어, 투자자들과 업계의 주요 인물들의 관심을 끌어들이는 강력한 도구로 작용했습니다. Aravind Srinivas는 이 경험을 통해 “이전에 불가능했던 것을 가능하게 만드는 것이 강력한 힘을 가진다”는 교훈을 얻었다고 말합니다. 특히 그 기능이 실용적일 때, 사람들에게 더욱 강력한 인상을 남길 수 있습니다.

예를 들어, Perplexity가 Twitter의 데이터를 활용해 특정 사용자가 팔로우하는 사람들 중 두 명이 공통으로 팔로우하는 인물을 찾는 기능을 구현했을 때, 이 기능은 단순한 기술적 성과를 넘어 사람들의 호기심을 자극했습니다. 사람들은 자신이나 자신이 관심 있는 사람들에 대해 알고 싶어하며, 이러한 호기심은 강력한 동기가 됩니다.

이러한 호기심을 활용한 Perplexity의 초기 기능은 사용자가 자신의 소셜 미디어 프로필을 검색하는 행위를 통해 그들에게 관련 경험을 제공했습니다. Aravind Srinivas는 Instagram의 공동 창립자 Mike Kreiger와의 대화를 언급하며, “사람들은 자신의 프로필 아이콘을 클릭해서 자신을 볼 수 있음에도 불구하고, Instagram에서 가장 많이 검색하는 것은 자기 자신이라는 사실”을 발견했다고 전합니다. 이는 Perplexity의 초기 Twitter 검색 기능이 왜 그렇게 큰 반향을 일으켰는지를 잘 보여주는 사례입니다.

Mike Kreiger: 사람들은 자신의 프로필 아이콘을 클릭해서 자신을 볼 수 있음에도 불구하고, Instagram에서 가장 많이 검색하는 것은 자기 자신이다.


결국, Perplexity는 사용자가 자신의 소셜 미디어 핸들을 검색하여, AI가 제공하는 요약 결과를 통해 자신을 알아가는 과정을 경험하게 개발했습니다. 이 과정에서 사용자들은 AI가 자신에 대해 알고 있는 정보를 보고 놀라거나, 혹은 AI가 만들어낸 내용에 재미를 느끼며, 그 경험을 공유하게 되었습니다. 이러한 사용자 경험은 Perplexity가 초기부터 빠르게 주목받고 성장할 수 있었던 중요한 요소 중 하나였습니다.


전략적 Pivot, 그리고 Perplexity AI의 탄생

Perplexity의 초기 성공을 바탕으로, 퍼플렉시티 팀은 단순한 검색을 넘어 지식을 탐구하고 사람들을 새로운 발견으로 이끄는 것을 목표로 삼았습니다. 

이 과정에서 Perplexity 팀은 text-to-SQL tool 기반의 Twitter 검색이 한계가 있음을 깨닫고, 더 광범위한 웹 검색으로 확장하는 전략을 취했습니다. (추가로 Twitter를 Elon Musk가 인수하면서 주요 API의 접근을 제한하기도 함) 이를 통해 Perplexity는 단순한 소셜 미디어 검색을 넘어, 웹 상의 방대한 정보를 검색하고 요약해주는 도구로 발전하게 되었습니다. 

본래 Perplexity 팀이 목표로 했던 것은 검색 기능을 구현하는 것이었으며, 이를 좀 더 구조화된 데이터로 확장하는 방법을 모색하기 시작했습니다. 2022년 10월쯤, 그들은 내부적으로 Perplexity의 첫 번째 프로토타입을 사용하기 시작했습니다. 이 프로토타입은 직원들의 의료보험과 같은 정보를 질문할 수 있는 슬랙 봇 형태로 구현되었고, 이를 통해 이 기술의 잠재력을 처음으로 엿볼 수 있었습니다.

그러던 중, 2022년 11월 ChatGPT가 출시했습니다. 역사상 가장 성공적인 제품 출시 중 하나로 손꼽힐 만큼 폭발적인 반응을 이끌어낸 이 사건은 Perplexity 팀 내에서 큰 화제를 불러일으켰습니다. 팀원들 모두가 흥분했지만, 동시에 이 일이 Perplexity 팀에게 어떤 의미가 있을지 진지하게 고민하지 않을 수 없었습니다.

이처럼 Perplexity는 초기의 단순한 아이디어에서 시작해, 텍스트에서 SQL로의 도구(text-to-SQL tool) 개발, 그리고 검색 기능의 확장으로 발전해왔습니다. ChatGPT의 성공은 그들에게 많은 자극과 확신을 주었습니다. Perplexity는 이제 단순한 검색을 넘어, 구조화된 데이터와 일반적인 검색을 융합하여 AI 기술의 미래를 선도할 준비를 마친 상태입니다.

ChatGPT가 출시된 초기, 많은 사람들이 이 모델의 ‘환각(hallucinations)’ 문제와 출처가 불명확한 정보 제공에 대해 불만을 토로했습니다. 이 문제는 Perplexity팀이 이미 프로토타입에서 해결하려는 방향성과 정확히 일치했습니다. Perplexity 초기 프로토타입은 정보의 출처를 명확히 밝히고, 신뢰할 수 있는 데이터를 제공하는 기능을 가지고 있었기 때문입니다.

Perplexity 팀은ChatGPT가 큰 주목을 받고 있었고, 그들의 기술이 이를 보완할 수 있음을 깨닫고,  이 둘을 결합하기로 결정했습니다. 그렇게 해서 불과 이틀 만에 간단한 웹사이트를 프로토타입으로 제작해 트위터에 농담처럼 올렸습니다. 아무런 기대 없이 시작한 일이었지만, 놀랍게도 많은 관심을 받았습니다. 트위터에서 리트윗과 칭찬이 쏟아졌습니다. 비록 초기 구현은 매우 느리고 완성도가 낮았지만, 그럼에도 불구하고 사람들은 그것에 매력을 느꼈던 것입니다.

이 경험은 Perplexity 팀에게 중요한 시그널이었습니다. 초기 버전의 결함에도 불구하고 사람들이 이 도구에 반응했다는 것은, 그들이 더 나은 버전을 만들 수 있다면 더욱 큰 성공을 거둘 수 있다는 확신을 주었습니다. 그러나 그 당시 Perplexity는 이 성공이 일시적인 유행에 그칠지, 아니면 지속될지를 두고 고민했습니다. 크리스마스와 연말연시를 앞두고 있었기 때문에 우리는 잠시 기다려 보기로 결정했습니다.

2022년 12월 7일, Perplexity는 웹 검색 기능 출시 관련하여 Aravind Srinivas는 “이건 그저 일시적인 유행일 뿐이고, 사용량은 곧 줄어들 것이다”라고 생각했지만, 사용자들은 가족과 함께하는 크리스마스 휴가 기간에도 이 제품을 계속 사용했습니다. 보통 사람들이 휴가 기간 동안, 특히 잘 알려지지 않은 스타트업의 제품을 사용할 필요가 없음에도 불구하고, Perplexity를 사용한 것은 매우 긍정적인 신호였습니다.

이후 놀랍게도, 연말이 지나고 1월이 되었을 때, Perplexity의 트래픽은 줄어들지 않았습니다. 오히려 증가하고 있었습니다. 이는 평범한 일이 아니었고, Perplexity 팀은 큰 가능성을 보았습니다. 결국, Text-to-SQL 프로젝트를 완전히 중단하고, 수개월 간의 노력을 내려놓고, 일반 웹검색에 집중하기로 결정했습니다. 결과적으로 이 의사결정은 옳은 선택이었습니다.

Perplexity의 Text-to-SQL tool

초기 Perplexity는 단순한 질문에 답변을 제공하고 관련 링크와 요약을 보여주는 기능을 갖추고 있었을 뿐, 대화형 인터렉션 기반으로 동작하지는 않았습니다. 그러나 새해가 지난 후, 대화형 질문 제안 기능을 추가한 새로운 버전을 출시했으며, 그 후 사용량이 급격히 증가했습니다. 사용자는 답변에 만족할 뿐만 아니라, 관련된 질문을 계속 클릭하며 새로운 정보를 탐색하는 데 흥미를 느꼈습니다.

퍼플렉시티 공동 창업자들은 이러한 성장을 기반으로, 단순히 검색이나 질문에 답하는 것이 아니라, 사람들에게 새로운 지식을 발견하고 그들에게 올바른 방향으로 안내하는 것을 목표로 삼았습니다. 이들은 Amazon의 고객 중심 철학에서 영감을 받아, Perplexity를 “세상에서 가장 지식 중심적인 회사(We want to be the world’s most knowledge-centric company.)”로 만드는 것을 목표로 삼았습니다. Google의 초기 비전이 세계의 정보를 모두에게 접근 가능하게 만드는 것이었다면, Perplexity 팀은 사람들의 호기심을 자극하고 새로운 지식을 탐구하는 경험을 제공하고자 했습니다.

Perplexity의 Pivot(Text-to-SQL -> 웹검색 전환)은 단지 기술적 pivot이 아니라, 사용자 문제에 있어 팀의 자신감에서 비롯되었습니다. 초기 피드백에서 Perplexity 팀이 해결하고자 했던 문제들이 실제로 사람들에게 중요하다는 것을 확인할 수 있었습니다. 하지만 동시에 그들은 장기적인 경쟁 우위에 대해 깊이 고민하지 않을 수 없었습니다. 특히, 핵심적인 파운데이션 모델을 소유하지 않고 OpenAI와 같은 외부 제공자의 모델을 사용하는 상황에서, Perplexity 제품이 어떻게 더 나은 성과를 낼 수 있을지에 대한 논의가 필요했습니다.

이 질문은 매우 중요한 문제였습니다. Perplexity의 장기적 비전과 OpenAI와 같은 파운데이션 모델 제공자들보다 우월한 제품을 유지하기 위해 어떤 전략을 취해야 할지 고민했습니다. Perplexity 내부에서도 이와 관련된 회의적인 시각이 존재했지만, 이러한 질문들은 Perplexity 팀의 결속력을 강화하고, 더 나은 제품을 만들기 위한 동기부여가 되었습니다.결국, Perplexity는 단순히 ChatGPT를 보완하는 것을 넘어, 새로운 검색의 표준을 제시하기로 했습니다. AI 기술을 통해 신뢰할 수 있는 정보 제공과 사용자 경험의 혁신을 추구하며, 이 과정에서 얻은 통찰을 바탕으로 지속적인 성장을 이루어 나가는 것이었습니다.


인간답게 만드는 호기심

Perplexity는 기존의 검색 엔진과는 완전히 다른 접근 방식을 제시하며, 스스로를 “정답 엔진(answer engine)” 또는 지식 발견 엔진(”knowledge discovery engine”)이라고 정의합니다. Perplexity 공동 창업자 Aravind Srinivas는 호기심은 인간을 다른 존재들과 구분 짓는 중요한 요소 중 하나로 보고 있습니다. 우리는 새로운 것을 알고자 하는 열망으로 가득 차 있으며, 이러한 호기심은 우리를 끊임없이 탐구하고 질문하게 만드는 것입니다. 이는 Perplexity의 UI를 이용해보시면 답변 이후에 새로운 질문을 제안하면서 유저로 하여금 지식을 계속 탐구하게 만듭니다.

Perplexity의 공동 창업자 Aravind Srinivas는 “우리가 싸워야 할 가장 큰 적은 구글이 아니라, 사람들이 질문을 잘 못하는 것이다”라고 했습니다. 저도 개인적으로 공감이 많이 되었던 답변이었는데요. 좋은 질문을 하는 것도 기술이 필요한 것입니다. 질문의 순서도 중요하고요. 모든 사람에게 호기심은 있지만, 그 호기심을 잘 표현된 질문으로 바꾸는 능력은 모두가 가지지 못하고 있습니다. 호기심을 질문으로 정제하는 데 많은 사고가 필요하며, 그 질문을 AI에 잘 프롬프트할 수 있도록 만드는 것도 기술이 필요합니다. Aravind Srinivas는 구글에서 영감을 받아 Perplexity에 사용자가 첫 질문을 쉽게 할 수 있도록 돕고, 흥미로운 질문을 제안하는 기능을 반영했다고 밝혔습니다. 


우리는 여전히 인간의 호기심이 무엇에서 비롯되는지, 그 호기심이 어떻게 우리의 지능을 이끌어 가는지에 대해 명확하게 이해하지 못하고 있습니다. AI가 아무리 발전하더라도, 인간처럼 자연스럽게 호기심을 느끼고, 스스로 새로운 질문을 던지는 능력은 아직 갖추지 못했습니다. AGI(Artificial General Intelligence)의 세상에서 AI 과학자와 파인먼 수준의 대화를 나눌 수 있는 세상이 오더라도, 파인먼의 호기심을 모방할 수 있다는 증거는 아직 없습니다. 우리는 파인먼의 깊이 있는 연구 능력을 모방할 수 있을지는 모르지만, 그가 많은 다양한 것들에 대해 자연스럽게 호기심을 가지는 능력을 모방할 수 있을지는 아직 확실하지 않습니다. 그리고 올바른 질문을 이해하거나, 올바른 질문에 대한 설명을 찾기 위해 노력하는 것이 바로 우리가 가지고 있는 특별한 능력 중 하나입니다.

- Aravind Srinivas


그럼 여기서 마무리 하겠습니다 :) 브런치북에 더 많은 내용이 담겨 있으니 관심 있으신 분들께선 아래 링크를 통해 읽어주시면 감사하겠습니다.

https://brunch.co.kr/brunchbook/perplexity
4
0
진용진

진용진

'퍼플렉시티(Perplexity): AI 검색의 미래'란 제목으로 뉴스레터 글을 발행했습니다 :)
렉스 프리드만과 퍼플렉시티 CEO Aravind Srinivas 인터뷰를 봤는데요. 최근에 본 인터뷰 영상 중에서 가장 스마트하고, 기술에 대한 이해도가 높지만, 오히려 실용적으로 고객 중심으로 최고의 사용자 경험을 제공하려는 접근이 인상 깊었습니다.

Perplexity AI를 사용해보면 정확한 답변도 놀랍지만, 정보를 제공하는 방식에서 우아함도 느껴질 때가 있는 것 같습니다 :)

https://maily.so/7ish/posts/18ac40dc

6
0
진용진

진용진

Perplexity 창업자가 바라본 구글, 아마존, 메타, 엔비디아, 테슬라 창업자들

Perplexity 창업자 아라빈드 스리니바스(Aravind Srinivas)와 렉스 프리드만(Lex Fridman) 인터뷰에서 구글 창업자 래리 페이지, 세르게이 브린, 아마존 창업자 제프 베조스, Meta 창업자 마크 저커버그, 테슬라 창업자 일론 머스크에 대한 그의 생각을 밝혔습니다.

래리 페이지와 세르게이 브린에 대한 존경

Perplexity에 영감을 준 래리 페이지와 세르게이 브린

Aravind Srinivas는 래리 페이지와 세르게이 브린을 존경하며, 구글의 기업 문화를 잘 설명한 책 In The Plex와 How Google Works를 여러 번 읽었다고 밝혔습니다.

그는 구글이 초기 다른 검색 엔진들과 달리 동일한 방식으로 경쟁하지 않았다는 점에 주목했습니다. 다른 검색 엔진들이 텍스트 기반 유사성에 집중할 때, 구글은 링크 구조에서 랭킹 신호를 추출하는 방법을 고안해냈습니다. 이것이 바로 PageRank의 핵심 아이디어였습니다. Google Scholar 검색의 학술 인용 그래프는 Perplexity 제품 개발에 영감을 주었으며, Perplexity는 인용 빈도가 높은 도메인에 랭킹 신호가 있다고 판단하고, 이를 기반으로 새로운 인터넷 랭킹 모델을 구축하여 구글의 클릭 기반 랭킹 모델과 차별화를 이루었습니다. Aravind Srinivas는 이러한 점에서 구글 창업자들을 존경한다고 밝혔습니다. 래리 페이지와 세르게이 브린은 깊이 있는 학문적 배경을 가지고 있었고, 다른 창업자들처럼 대학 중퇴 후 회사를 창업한 것이 아닌, 스탠포드에서 박사 과정을 밟으며 학문적 뿌리를 바탕으로 많은 사람들이 사용하는 제품을 만들었습니다. 이는 Srinivas에게 큰 영감을 주었다고 합니다.

박사급 인재 중심의 팀 빌딩

구글 창업자들은 제품이 사용자들 사이에서 인기를 얻기 시작하자, 전통적인 인터넷 비즈니스 방식대로 비즈니스 팀이나 마케팅 팀을 구성하는 대신, “검색이 실제로 중요할 것이니 가능한 한 많은 박사들을 고용하겠다”는 역발상의 통찰력을 가졌습니다. 당시 인터넷 버블이 터지면서 많은 박사급 인재를 비교적 저렴한 비용으로 채용할 수 있었고, 이를 통해 Jeff Dean과 같은 뛰어난 인재를 영입하여 핵심 인프라와 깊이 있는 연구에 집중할 수 있었습니다.

사용자는 결코 틀리지 않는다

‘사용자는 결코 틀리지 않는다’는 단순하지만 심오한 구글 창업자들의 철학은 Perplexity가 작은 세부 사항을 중요하게 다루게 만든 주요 원동력이었습니다. 예를 들어, 검색창에 커서를 미리 표시해 사용자가 바로 쿼리를 입력할 수 있게 하고, 답변이 맨 아래까지 자동으로 스크롤되며, 모바일 앱에서 검색창을 클릭할 때 키패드가 빠르게 나타나도록 하는 것 등이 있습니다. Aravind Srinivas는 또한, 래리 페이지가 크롬을 초기 출시할 때 오래된 윈도우 버전과 구형 노트북에서 테스트한 사례를 들어 속도(latency)의 중요성을 강조했습니다. 그는 비행기 와이파이가 보통 형편없기 때문에 그 상황에서도 Perplexity 앱이 빠르게 작동하는지 확인하며, ChatGPT나 Gemini 같은 다른 앱과 비교해 지연 시간을 점검한다고 합니다. 렉스 프리드먼 역시 인터뷰에서 지연 시간을 집요하게 줄이면 사용자가 느끼는 경험이 급격히 개선되며 불만족이 줄어든다고 언급했습니다.

LLM 기반의 제품을 개발하는 팀은 사용자가 프롬프트 엔지니어링을 잘못했다고 비난할 수 있습니다. 그러나 구글의 ‘사용자는 결코 틀리지 않는다’는 철학을 기억한다면, 사용자가 입력한 것이 무엇이든 항상 높은 품질의 답변을 제공해야 한다고 그는 밝힙니다. 이렇게 하면, 사용자가 게으르거나 오타를 내거나 음성 전사가 잘못되었더라도 원하는 답을 얻고 제품에 만족하게 됩니다. 이것이 바로 사용자 중심의 제품을 만들어야 하는 이유입니다.

추가로 Aravind Srinivas는 프롬프트 엔지니어링이 장기적으로 중요한 일이 되지 않을 것이라고 생각하며, 사용자가 요청하지 않아도 그들이 원하는 결과를 제공할 수 있는 제품을 만드는 것이 중요하다고 밝혔습니다.

사람들은 게으르다

Aravind Srinivas는 제품이 사용자가 정교한 쿼리를 입력하지 않더라도 몇 가지 단어만으로 충분히 작동하도록 설계되어야 한다고 설명합니다. 그는 사람들이 본질적으로 게으르기 때문에, 더 나은 제품은 사용자가 더 쉽게, 더 게으르게 사용할 수 있도록 만들어야 한다고 주장합니다. 물론 사용자가 명확한 문장을 입력하여 사고를 깊게 하는 것도 중요하지만, 궁극적으로 제품에는 일종의 ‘마법’이 필요하며, 그 마법은 사용자가 더욱 편리하게 사용할 수 있게 만드는 데 기여해야 한다고 강조합니다.

우리가 싸워야 할 가장 큰 적은 구글이 아니다. 사람들은 질문을 잘 못한다

Perplexity의 공동 창업자와 디자이너는 UX에 대해 논의하면서 “우리가 싸워야 할 가장 큰 적은 구글이 아니라, 사람들이 질문을 잘 못하는 것이다”라고 말했습니다. Aravind Srinivas는 왜 사람들이 렉스 프리드먼처럼 팟캐스트를 잘할 수 없는지에 대해 언급하며, 좋은 질문을 하는 데에는 기술이 필요하다고 설명합니다. 모든 사람에게 호기심은 있지만, 그 호기심을 잘 표현된 질문으로 바꾸는 능력은 모든 이가 갖추지 못한 것입니다. 호기심을 질문으로 정제하는 데는 깊은 사고가 필요하며, 그 질문을 AI에 잘 전달할 수 있도록 만드는 것 또한 기술이 요구됩니다. 

렉스 프리드먼은 질문의 순서가 중요하다고 강조했으며, Aravind Srinivas는 구글에서 영감을 받아 Perplexity에 사용자가 첫 질문을 쉽게 할 수 있도록 돕고, 흥미로운 질문을 제안하는 기능을 반영했다고 밝혔습니다. 구글은 사용자가 자주 묻는 질문이나 추천 질문을 자동 완성 바에서 제시하여 질문 시간을 최소화하고 사용자 의도를 정확하게 예측하려고 합니다.

제품이 너무 단순하면, 이게 다일까?

신규 사용자를 늘리면서 기존 사용자를 유지하는 것은 매우 어려운 과제입니다. 한 노트 앱은 파워 유저를 위한 기능을 계속 추가하다가, 결국 새로운 사용자들이 제품을 이해하지 못하게 되는 상황에 직면했습니다. 페이스북의 초기 데이터 과학자 중 한 명은 새로운 사용자들을 위한 기능 출시가 기존 사용자보다 더 중요하다고 언급한 바 있습니다. 이는 하루 종일 논의할 수 있는 주제이며, 이 때문에 제품 디자인과 성장은 결코 쉬운 일이 아닙니다.

제품 개발자에게 가장 큰 도전 중 하나는 제품에 대해 혼란을 느끼는 사용자들입니다. 이들은 좌절하지만 그 신호는 미약하거나 없으며, 몇 가지 시도만 해보고 제품을 떠나기 때문에 무슨 일이 일어났는지 파악하기 어렵습니다. 모든 제품은 이러한 침묵하는 사용자가 다시 제품으로 돌아올 가능성을 높이는 지표를 찾아야 합니다. 예를 들어, 페이스북은 가입 시 친구가 많을수록 페이스북에 머무를 가능성이 높다는 점을 발견했고, 우버는 성공적으로 탑승한 횟수를 중요한 지표로 삼았습니다.

Aravind Srinivas는 Perplexity의 경우, 사용자를 만족시킨 쿼리의 수가 중요한 지표라고 말했습니다. 이는 제품이 빠르고 정확하며, 답변이 쉽게 읽혀야 한다는 것을 의미합니다.

Jeff Bezos가 제공한 영감

명확한 사고의 중요성

Aravind Srinivas는 Jeff Bezos를 통해 명확한 사고의 중요성을 이해했다고 밝혔습니다. 그는 스타트업에서는 문서를 많이 작성하지 않으려고 하지만, 본인이 명확한 사고를 가지기 위해 가끔 전략 문서를 작성하는 것은 중요하다고 언급했습니다. (다음 6개월 동안 우리가 무엇을 할지, 왜 그것을 하는지, 그리고 우리의 포지셔닝은 무엇인지). 또한 회의가 더 효율적이 될 수 있는 이유는 내가 회의에서 무엇을 얻고자 하는지 명확히 알고 있을 때 잘 진행될 수 있다고 했습니다.

사용자에 대한 집착

“당신은 인터넷 회사인가요?” Jeff Bezos는 “인터넷이든 아니든 중요하지 않습니다. 중요한 것은 고객입니다.”

Aravind Srinivas는 “perplexity는 래퍼(wrapper)인가요, 아니면 독자적인 모델을 구축하나요?“라는 질문을 받을 때 Jeff Bezos와 유사하게 답변을 한다고 합니다. “네, 우리는 둘 다 합니다. 하지만 중요한 것은 그것이 아닙니다. 중요한 것은 답변이 효과적이고, 빠르고, 정확하며, 읽기 쉽고, 제품이 잘 작동하는 것입니다. AI가 부모님 세대까지 사용하게 되는 그런 널리 퍼진 기술이 되려면, 사람들은 그 제품이 어떤 모델을 사용하고 있는지조차 신경 쓰지 않게 될 때 가능하다고 생각합니다.”

Elon Musk가 제공한 영감

Aravind Srinivas는 모든 비즈니스에서 가장 어려운 것은 유통이라 밝히며, 일론 머스크가 이를 테슬라를 통해 이뤘다고 밝혔습니다.

일론 머스크는 그의 첫 번째 회사인 Zip2에서 그는 구글 맵과 같은 것을 만들려고 했습니다. 하지만 결국 그 회사는 자사의 기술을 다른 사람들의 사이트에 제공하는 방식으로 계약을 체결했고, 그 결과 사용자와의 직접적인 관계를 잃어버렸습니다. 비즈니스 관점에서는 이익을 내야 하고, 사람들이 돈을 지불하지만, Tesla에서는 그렇게 하지 않았습니다. 그는 실제로 딜러나 다른 경로를 거치지 않았습니다. 대신 사용자와의 직접적인 관계를 형성했습니다. 이는 대중과 접점이 줄어준다는 리스크도 있지만 일론 머스크는 놀랍게도 직접 판매를 해냈습니다. 

이밖에 일론 머스크가 강력한 의지, 원칙적 사고, 주인의식을 바탕으로 매우 디테일한 업무(오토바일럿의 annotation 작업 실무)까지 직접 함으로써  어려운 병목 현상을 어떻게 돌파할지 그리고 시스템을 어떻게 단순화할지를 파악할 수 있게 된다고 했습니다.

젠슨 황의 리더십과 혁신에 대한 통찰

나는 1대 1 회의를 거의 하지 않습니다. 시스템 전반적으로 정보를 얻고 싶기 때문에 60명의 직접 보고자들과 함께 모여서 모든 지식을 한 번에 얻고 점들을 연결합니다. 이렇게 하면 훨씬 효율적입니다.

젠슨 황의 리더십 스타일은 세부 사항에 대한 철저한 이해와 시스템의 지속적인 개선에 대한 집착에서 두드러집니다. 그는 모든 정보를 한 번에 얻기 위해 1대 1 회의 대신 60명의 직접 보고자들과 함께 모여 회의를 진행하며, 이를 통해 더 효율적으로 결정을 내릴 수 있는 방법을 찾습니다. 이러한 방식은 기존의 지혜를 의심하고, 새로운 방법으로 일을 수행하려는 그의 독창성을 반영합니다.

젠슨 황은 차세대 기술을 끊임없이 제공하며, B-100 칩셋이 H-100에 비해 30배 더 효율적일 것이라는 점을 강조합니다. 이는 단순한 성능 향상을 넘어선, 혁신적 변화를 예고하는 것입니다. 젠슨 황은 단기적인 계획을 넘어서 10년, 20년, 심지어 30년 후를 내다보며 기술 개발에 임하고 있습니다. 그는 이러한 장기적 비전 덕분에 NVIDIA의 성공을 이끌고 있으며, AI와 컴퓨팅의 미래를 주도할 준비를 하고 있습니다.

어떻게 성공을 유지하면서도 열심히 일하십니까?

Aravind Srinivas는 젠슨 황을 만날 기회가 있었고, “어떻게 성공을 유지하면서도 열심히 일하십니까?“라고 질문을 했습니다. 이에 대해 젠슨 황은 “사실 나는 사업이 망할까 봐 매우 두렵습니다. 매일 아침 땀을 흘리며 일어나서 무슨 일이 잘못될지를 고민합니다.“라고 답했습니다. 하드웨어은 최소한 2년 전에 계획을 세워야 하는데, 한 세대의 아키텍처에서 실수를 하면 큰 손실로 이어질 수 있는 분야이기 때문에, 젠슨 황은 항상 세심한 주의를 기울이고 있다고 밝혔습니다(추진력, 두려움, 세부 사항에 대한 집착).

마크 저커버그와 오픈 소스에 대한 리더십

빠르게 움직이고 기존 질서를 파괴하라.

마크 저커버그는 빠르게 움직여 혁신을 이루려는 집착으로 잘 알려져 있으며, 오픈 소스 AI 모델을 선도하는 역할을 하고 있습니다. 저커버그는 Llama-3-70B와 같은 AI 모델(GPT-4와 거의 유사한 수준의 모델)을 오픈 소스로 공개함으로써 AI의 발전을 독점하려는 몇몇 기업에 대한 대안적 접근을 제공합니다. 이러한 움직임은 AI 연구의 투명성을 높이고, 더 많은 플레이어가 AI 모델을 개발할 수 있는 기회를 제공합니다.

저커버그의 리더십은 단순히 기업의 이익을 넘어선, AI 기술의 민주화에 기여하고 있습니다. 그는 AI 기술이 몇몇 대기업에 의해 독점되는 대신, 더 많은 사람들이 접근할 수 있도록 함으로써 혁신을 촉진하고 있습니다.

얀 르쿤의 통찰과 자가 지도 학습의 중요성

얀 르쿤은 자가 지도 학습과 에너지 기반 모델을 통해 AI 연구에 큰 기여를 해왔으며, 많은 후학들에게도 영향을 미쳤습니다(DeepMind의 CTO인 Koray, OpenAI에서 DALL-E를 발명한 Aditya Ramesh, OpenAI의 공동 창립자 Wojciech Zaremba). 

강화 학습은 단지 케이크 위의 체리일 뿐이다(RL is just the cherry on the cake.)

그는 2016년에 강화 학습(RL)이 AI의 미래가 될 것이라는 대중의 생각에 반대하며, 대부분의 지능은 자가 지도 학습에 기반해야 한다고 주장했습니다. 그의 이러한 통찰은 현재의 AI 모델 개발에 큰 영향을 미쳤습니다.

자기 회귀 모델은 한계에 다다를 수 있다(autoregressive models might be a dead end)

얀 르쿤은 현재 자기 회귀 모델의 한계에 대해 논의하며, AI 시스템이 원시 입력 공간이 아닌 더 추상적인 표현에서 추론을 수행해야 한다고 주장합니다. 이는 AI 시스템이 더 효율적이고 강력하게 작동할 수 있는 가능성을 열어줍니다. Aravind Srinivas는 얀 르쿤이 주장하는 것이 아마 맞을 것이라고 힘을 실어주며 추상적인 표현(abstract representation)에서 추론을 한다면 훨씬 더 효율적일 수 있다고 의견을 밝혓습니다.

만약 어떤 것이 위험하다고 주장한다면, 더 많은 사람들이 그것을 살펴보는 것이 좋지 않겠습니까?

얀 르쿤은 또한 AI 안전성을 유지하는 방법으로 오픈 소스를 강조합니다. 오픈 소스를 통해 더 많은 사람들이 AI 시스템을 검토하고, 그 사용 가능성과 잠재적 위험을 평가할 수 있기 때문에, AI 기술의 안전성을 높일 수 있다는 것입니다. 그는 AI 기술의 투명성과 협력적 발전이 AI 안전성을 확보하는 데 필수적이라고 믿고 있습니다. Aravind Srinivas 역시 오픈 소스를 통해 시스템이 어떻게 오용될 수 있는지 더 빠르게 파악하고, 그것에 대한 적절한 보호 장치를 마련할 수 있다고 말했습니다.

8
1
진용진

진용진

생성형 AI와 창의성: 단편 소설 쓰기에서의 대규모 실증 연구 분석

최근 몇 년간 AI 기술의 발전은 창의적인 작업에 큰 변화를 가져오고 있습니다. 특히 생성형 AI는 창작 과정에서 인간의 역할을 보완하고 지원할 수 있는 중요한 도구로 부상하고 있습니다. 이러한 변화 속에서, 생성형 AI가 실제로 창의성에 어떤 영향을 미치는지를 탐구하는 연구들이 점차 증가하고 있으며, 그 중 하나가 최근 발표된 대규모 실증 연구 Generative AI enhances individual creativity but reduces the collective diversity of novel content(https://www.science.org/doi/10.1126/sciadv.adn5290)입니다.

이번 연구는 단편 소설 쓰기에서 생성형 AI가 작가들의 창의성에 미치는 영향을 실험적으로 분석한 첫 번째 시도 중 하나입니다. 이 글에서는 연구의 주요 결과와 이에 따른 인사이트를 살펴보고자 합니다.

연구 개요

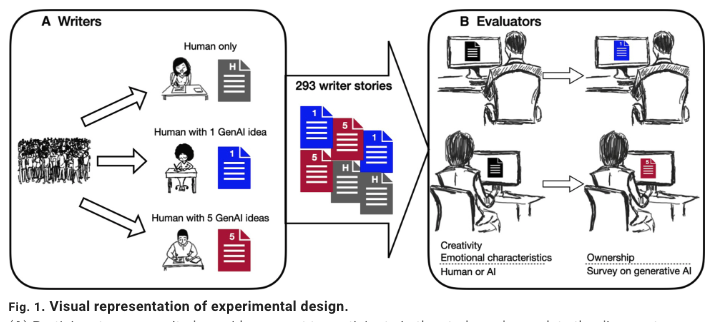
연구진은 총 293명의 참가자를 모집하여 “청소년과 젊은 성인 관객에게 적합한” 8문장으로 된 단편 소설을 작성하도록 요청했습니다. 이들은 다음과 같이 세 그룹으로 나뉘었습니다:

1. 생성형 AI 미사용 그룹: AI의 도움 없이 독립적으로 이야기를 작성한 그룹.

2. GPT-4 아이디어 제공 그룹: GPT-4를 사용하여 이야기 시작을 위한 세 문장 아이디어를 제공받은 그룹.

3. GPT-4 다중 아이디어 제공 그룹: GPT-4를 통해 최대 다섯 가지의 다양한 아이디어를 제공받아 그 중에서 영감을 얻어 이야기를 작성한 그룹.

이후, 600명의 평가자들이 각 그룹의 이야기를 평가했으며, 연구진은 이야기들 간의 유사성을 분석하기 위해 OpenAI의 임베딩 API를 활용했습니다.

image.png

주요 발견

연구 결과, 생성형 AI의 사용이 작가들의 창의성에 다양한 방식으로 영향을 미친다는 점이 밝혀졌습니다.

1. 개별 창의성의 향상: 생성형 AI를 사용한 그룹의 이야기들은 참신성과 유용성에서 높은 평가를 받았습니다. 특히 덜 창의적인 작가들에게 더 큰 도움이 되었으며, 이는 AI가 제공하는 아이디어가 개인의 창작 과정을 촉진하는 역할을 한다는 것을 보여줍니다.

2. 평가의 균등화: 생성형 AI를 사용함으로써 작가들의 타고난 창의성에 따른 불균형이 해소되었습니다. 이는 AI가 작가들에게 일정 수준 이상의 창의적 출발점을 제공함으로써, 더 공정한 평가를 받을 수 있도록 도와준다는 것을 의미합니다.

3. 집단적 참신성의 위험: 비록 AI가 개별 창의성을 높이지만, 모든 이야기가 AI에 의해 영감을 받을 경우, 결과물들 간의 참신성이 줄어들 가능성이 있습니다. 이는 창작 과정에서 AI의 사용이 집단적 차원에서의 창의적 다양성을 감소시킬 수 있다는 우려를 제기합니다.

연구는 이러한 현상을 “사회적 딜레마”로 비유합니다. 개별 작가들은 AI를 통해 창의성을 향상시킬 수 있지만, 그 결과 집단적으로는 새로운 콘텐츠의 다양성이 줄어들 수 있다는 것입니다. 생성형 AI는 작가들에게 영감을 제공해 개별적으로는 더 나은 결과물을 만들어낼 수 있지만, 이로 인해 집단적으로는 더 좁은 범위의 결과물이 만들어질 수 있다는 우려가 있습니다.

인사이트

연구는 생성형 AI가 창의적인 작업에 미치는 영향을 이해하는 기초를 마련했습니다. 특히 덜 숙련된 작가들에게는 AI가 강력한 창작 도구로 작용할 수 있으며, 이들이 더 창의적인 결과물을 만들 수 있도록 도와줄 수 있습니다. 이는 AI가 단순히 도구 이상의 역할을 하여, 창작 과정에서 공정성을 높이고 개인의 잠재력을 최대한 발휘할 수 있는 환경을 조성할 수 있음을 시사합니다.

그러나, 개별적인 창의성 향상에 비해 집단적인 창의적 다양성이 감소할 수 있다는 점도 시사했습니다.

AI가 창의성에 미치는 영향에 대한 탐구는 이제 막 시작된 것 같습니다. 생성형 AI의 역할, 그리고 AI의 장점과 잠재적 한계에 대한 고민이 앞으로 더욱 깊어질 것 같습니다.

7
1
진용진

진용진

Perplexity가 Google과 경쟁에서 이길 수 있을까?

퍼플렉시티 창업자 Aravind Srinivas <> Lex Fridman 인터뷰에서 구글과 관련 이야기가 있어 정리해봤습니다.

Perplexity가 Google과 경쟁에서 이길 수 있을까?

• Google과 맞붙을 필요 없음.

• Perplexity는 Google이 만든 게임에서 이기려고 하지 않음.

• Google은 20년 동안 검색 엔진 게임을 완벽하게 해왔음.

• 진정한 혁신은 UI를 재고하는 것에서 나옴.

• Perplexity는 답변이 충분하지 않거나 잘못된 경우에도 링크를 보여주지 않기로 결정.

• 시간이 지나면서 Perplexity가 더 좋아질 것이라고 믿음.

• 모델은 점점 더 좋아지고, 더 스마트해지고, 더 저렴해지고, 더 효율적이 될 것.

• Perplexity 데이터베이스는 최신 정보와 더 자세한 내용을 담게 될 것임.

• 환각(잘못된 정보 제공)은 점점 줄어들 것.

Google의 AdWords 같은 검색광고 모델을 Perplexity에 적용하지 않는 이유

• Google AdWords는 경매 시스템 기반으로 가격이 결정되어 마진이 높음.

• AdWords는 지난 50년 동안 최고의 비즈니스 모델 중 하나.

• Google은 다른 플레이어(오버츄어)의 훌륭한 아이디어를 파악하고 성장하는 검색 플랫폼에 잘 매핑.

• 다른 플랫폼에서 브랜드 인지도가 생성되더라도 실제 구매는 Google 검색광고를 통해 이루어짐.

• Perplexity는 사이트의 주요 특성은 링크가 아닌 답변을 만듦.

• 새로운 회사를 시작할 때 최고의 마진을 보장하는 비즈니스를 만들 필요는 없음.

• Google처럼 수익성 있는 회사가 되지 않아도 괜찮음.

• 대부분의 회사는 평생 동안 수익을 내지 못함 (예: Uber).

• 중요한 점은 Google의 약점을 Perplexity의 강점으로 만드는 것.

• Google은 링크 클릭을 억제하는 광고를 선호하지 않음.

• Amazon은 기존 비즈니스 마진이 낮아서 클라우드 비즈니스를 Google보다 먼저 시작함 (클라우드는 광고보다 마진이 낮음).

• Perplexity에는 구독 모델이 있음. 광고 수익 모델을 만드는 데 절박하지 않음.

• Netflix는 구독과 광고의 하이브리드 모델을 통해 이를 해결.

• 구독 모델을 통해 사용자 경험과 정확한 답변을 손상시키지 않고 지속 가능한 비즈니스를 구축할 수 있음.

• 장기적인 미래는 불확실하지만 매우 재미있는 상황임.

Perplexity의 사용자 경험을 해치지 않고 광고 비즈니스 모델이 가능할까?

• 사용자가 제품에 대한 신뢰를 잃지 않도록 하면서 올바른 정보 출처와 연결할 수 있는 무언가를 구축하는 것이 중요.

• Instagram의 광고 방식이 좋은 예시.

• 잘 타겟팅되어 있어 광고를 보는 것 같지 않게 느껴짐.

• Elon Musk도 광고가 정말 잘 만들어지면 유용할 수 있다고 언급.

• 광고를 볼 때 광고를 보고 있는 것 같지 않게 느껴져야 함.

• Perplexity도 링크를 클릭하는 데 방해가 되지 않으면서도 효과적으로 광고를 노출시키는 방법을 찾는 것이 중요할 것임.

1
0
진용진

진용진

프로덕트 매니저 분들을 대상으로 뉴스레터를 운영하고 있습니다. 이번 주는 아래 주제로 콘텐츠를 담았습니다. 관심 있으신 분들께선 구독 부탁드리겠습니다 :)

- 미국 여성 럭비팀, 영화 같은 결말
- AI 업계의 폭풍 같은 한 주
- Meta의 Llama 3.1 다운로드
- 공채 면접의 어려움
- Read Write Own - 읽고, 쓰고, 소유하다
- 그저 그런 일에 50%의 시간을 쓰고 있다면
- 앤드류 응이 제안하는 AI 제품 개발 방식
- 우리가 일하는 방식이 마음에 들지 않지만 내가 그것을 바꿀 수는 없을거야
- 제품 개발 프레임워크 참고

4
0
진용진

진용진

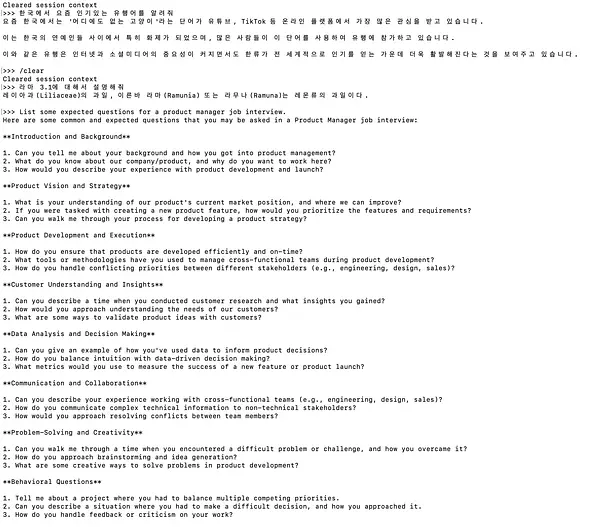
Llama 3.1 맥북에 다운로드하여 프로덕트 매니저 인터뷰 질문 요청

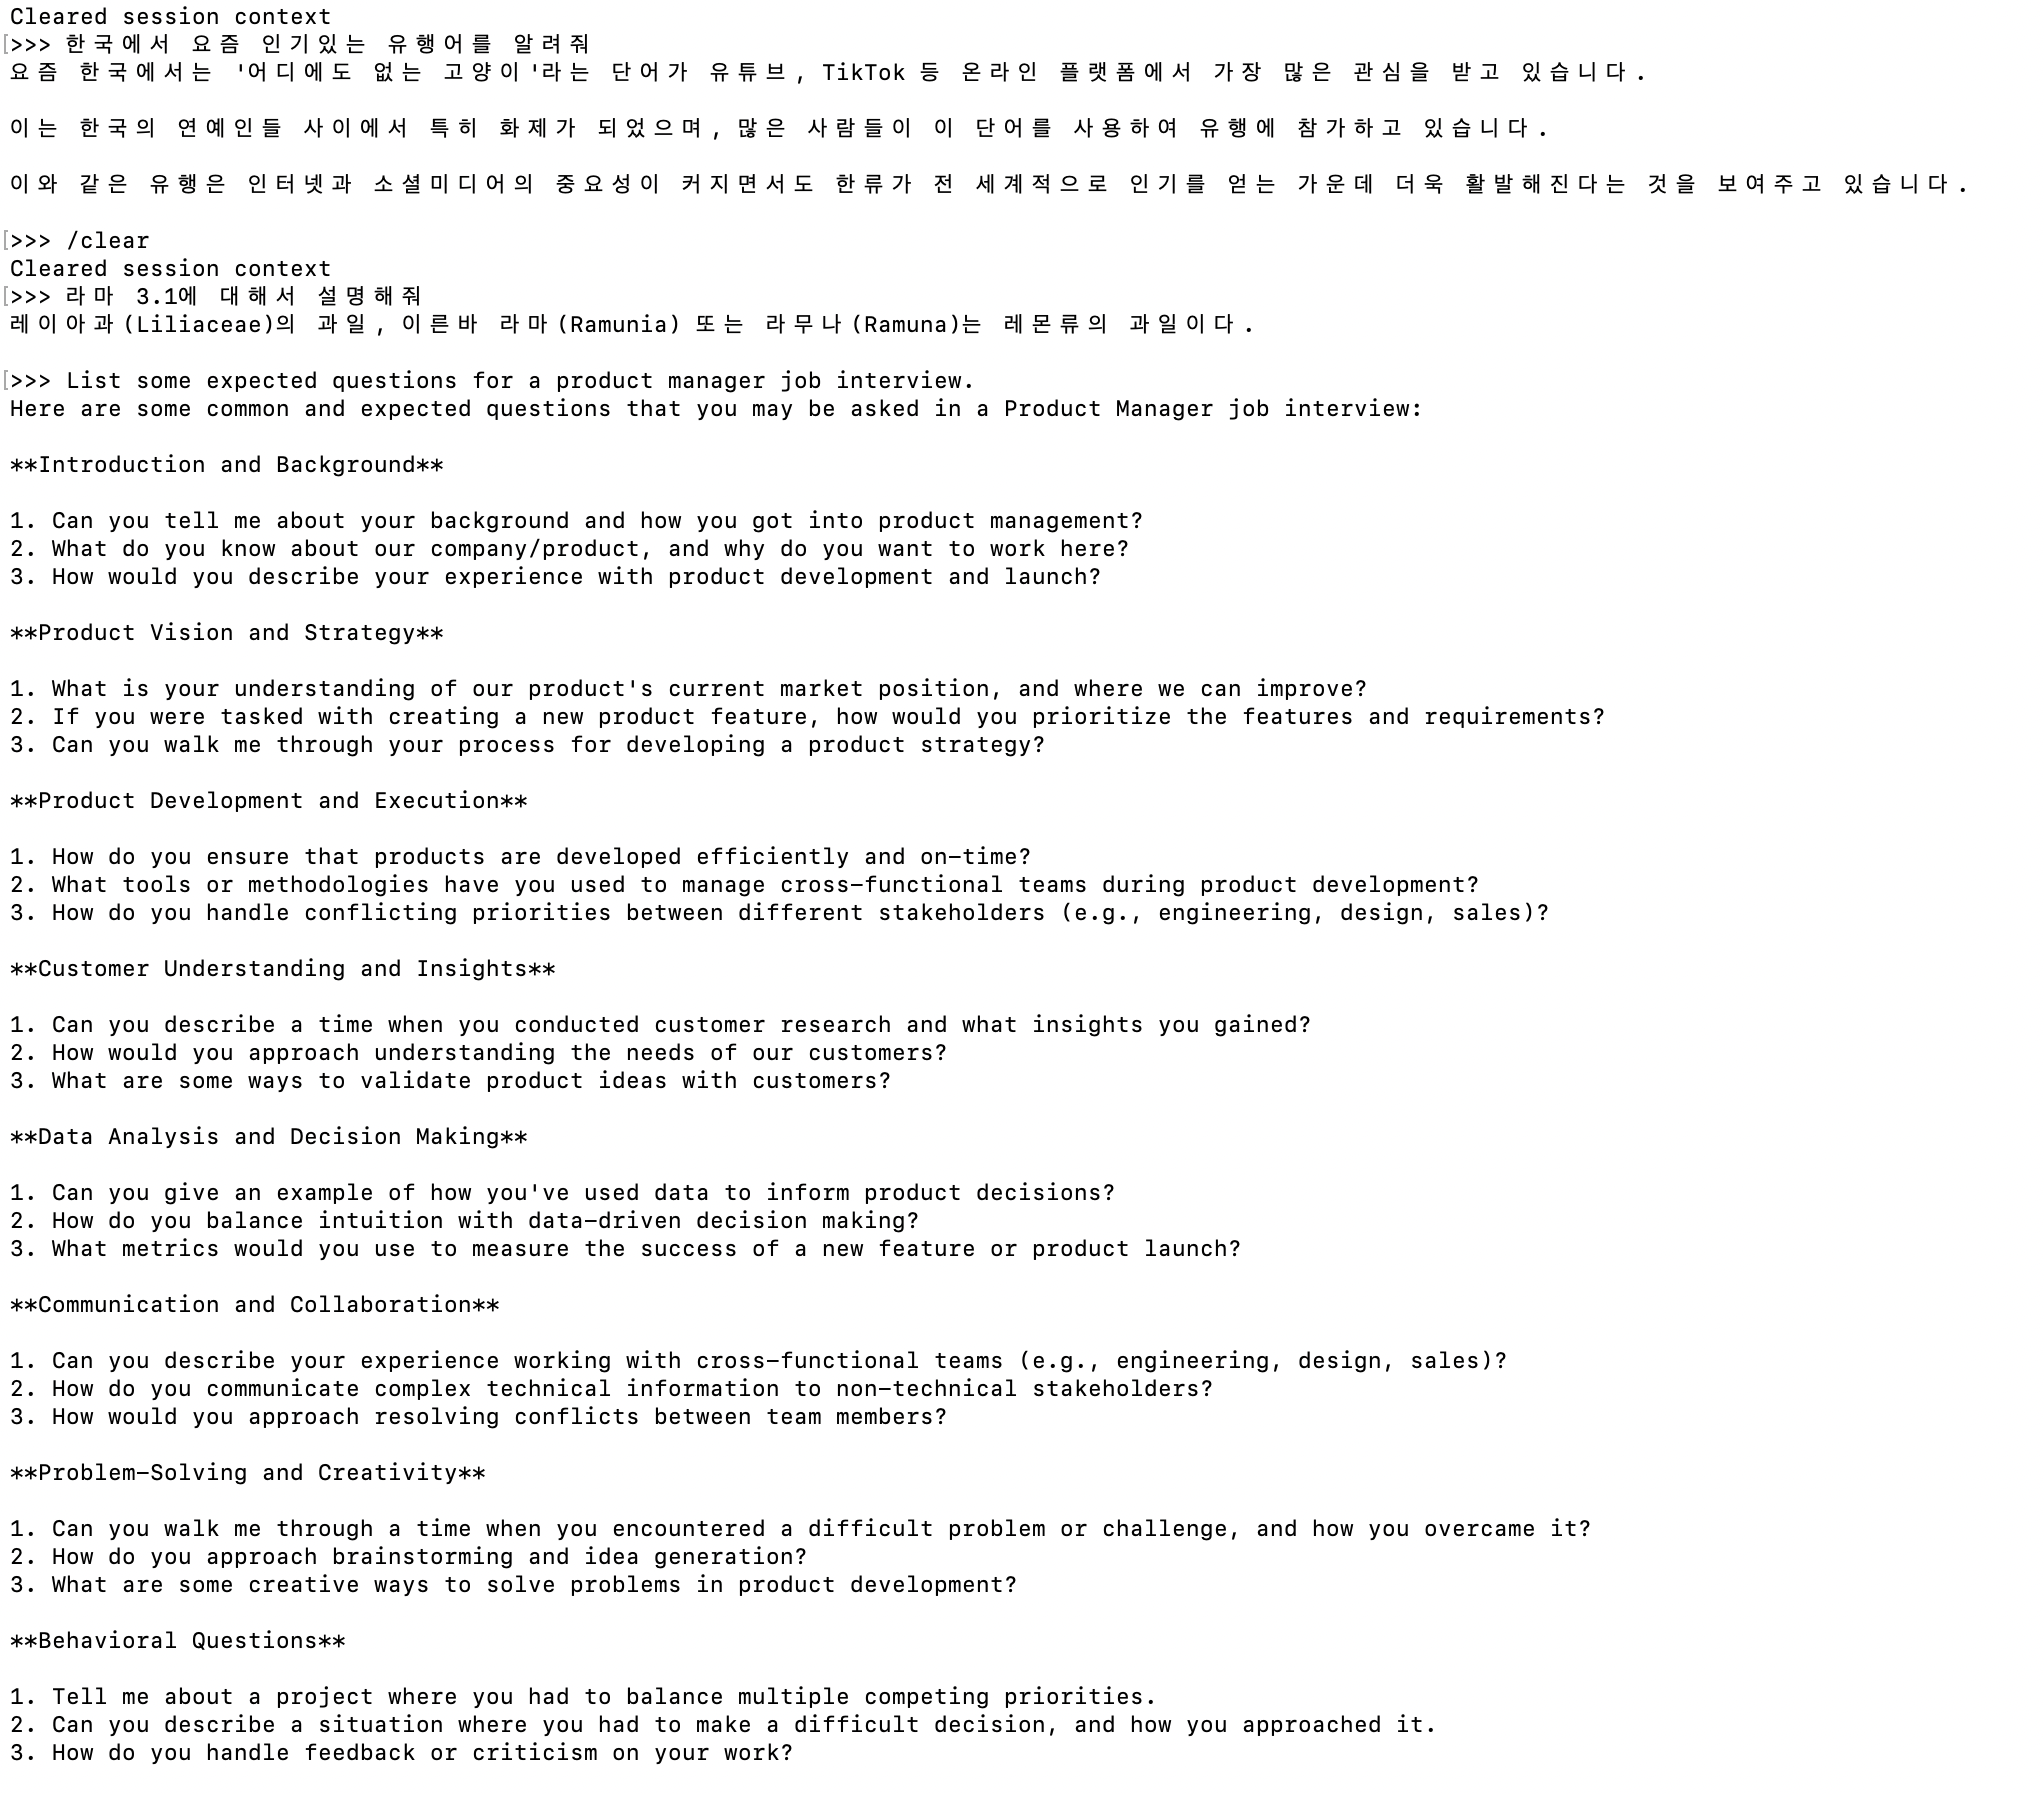
Llama 3.1 소형모델을 맥북에 다운로드하였습니다. Ollma 통해서 다운로드하면 매우 간단한데요. 4기가 바이트 정도 용량입니다.

몇가지 질문을 했는데 한글로 라마 3.1에 대해 설명해달라고 하니 엉뚱한 답변을 하네요.

영어로 프로덕트 매니저 인터뷰 관련 예상 질문을 뽑아 달라("List some expected questions for a product manager job interview.")고 하니, 꽤 자세하게 답변을 응답해줍니다.

Llama 3.1에 대해서 프로덕트 매니저들도 전반적인 동작을 이해하기 위해서 모델을 다운로드해서 테스트해보시길 추천드립니다 :)

Llama 3.1 응답

Here are some common and expected questions that you may be asked in a Product Manager job interview:

Introduction and Background

1. Can you tell me about your background and how you got into product management?

2. What do you know about our company/product, and why do you want to work here?

3. How would you describe your experience with product development and launch?

Product Vision and Strategy

1. What is your understanding of our product's current market position, and where we can improve?

2. If you were tasked with creating a new product feature, how would you prioritize the features and requirements?

3. Can you walk me through your process for developing a product strategy?

Product Development and Execution

1. How do you ensure that products are developed efficiently and on-time?

2. What tools or methodologies have you used to manage cross-functional teams during product development?

3. How do you handle conflicting priorities between different stakeholders (e.g., engineering, design, sales)?

Customer Understanding and Insights

1. Can you describe a time when you conducted customer research and what insights you gained?

2. How would you approach understanding the needs of our customers?

3. What are some ways to validate product ideas with customers?

Data Analysis and Decision Making

1. Can you give an example of how you've used data to inform product decisions?

2. How do you balance intuition with data-driven decision making?

3. What metrics would you use to measure the success of a new feature or product launch?

Communication and Collaboration

1. Can you describe your experience working with cross-functional teams (e.g., engineering, design, sales)?

2. How do you communicate complex technical information to non-technical stakeholders?

3. How would you approach resolving conflicts between team members?

Problem-Solving and Creativity

1. Can you walk me through a time when you encountered a difficult problem or challenge, and how you overcame it?

2. How do you approach brainstorming and idea generation?

3. What are some creative ways to solve problems in product development?

Behavioral Questions

1. Tell me about a project where you had to balance multiple competing priorities.

2. Can you describe a situation where you had to make a difficult decision, and how you approached it.

3. How do you handle feedback or criticism on your work?

image.png

3
5
진용진

진용진

마크 저커버그가 Meta Newsroom에서 Open Source AI Is the Path Forward 제목의 오픈 레터를 썼습니다. 이 글에서 그는 Meta의 Llama 3.1 출시와 전략적 방향성에 대해 시장에 전달하고, 오픈 소스 AI에 대한 자신의 견해를 명확히 밝혔습니다. 이는 단순한 의견 제시에 그치지 않고, 시장이 나아갈 방향성에 대해 강력한 메시지를 전달하고 있습니다.

https://about.fb.com/news/2024/07/open-source-ai-is-the-path-forward/

저커버그의 메시지는 매우 직설적입니다. 그는 애플의 폐쇄적인 생태계가 Meta의 AI 및 AR/VR 혁신을 제약하고 있다고 비판했습니다. 특히 그는 “애플이 개발자에게 세금을 부과하고, 임의의 정책을 적용하며, 모든 제품의 혁신을 출시하지 못하게 막는 방식은 Meta와 많은 다른 회사들이 더 나은 제품을 구축하는 것을 제한하고 있다”라고 지적했습니다. 그의 표현의 강도를 비춰 봤을 때 앞으로 Meta가 애플 인텔리전스 파트너로 함께 할 일은 없을 것 같습니다..

저커버그는 오픈 소스 AI의 장점을 개발자 관점, Meta 고객의 효용 관점, 그리고 사회적 가치 관점에서 설명합니다. 그는 규제 기관에 AI 관련 Meta의 행보를 지켜달라고 메시지를 전달하는 것으로 보였습니다. Llama를 안전성 관점에서 구글 검색엔진과 다르게 취급하지 말아 달라고 요청하며, 중국을 향해서는 단호하게 표현하면서 국가 안보 관점에서 설득력 있게 AI 오픈소스의 메시지를 전달하고 있습니다.

저도 이 부분 맥락을 잘 모르는데, Andrew Ng도 링크드인 메시지를 통해 Meta의 오픈 소스 행보를 지지하며, 캘리포니아의 SB1047 법안이 혁신을 방해하는 어리석은 규제라고 언급했습니다. 이는 규제 기관이 AI 관련 통제를 시도하는 움직임이 있음을 시사합니다.

https://www.linkedin.com/feed/update/urn:li:activity:7221557961112834048/

저커버그는 Rundown AI와 독점 Q&A를 진행했으며, Emily Chang과의 인터뷰도 있었습니다.

Rundown AI 인터뷰(https://www.youtube.com/watch?v=Vy3OkbtUa5k)에서는 오픈 레터의 내용을 대부분 다루었지만, AI 및 AGI에 대한 장기 비전에 대해서도 논의했습니다. 저커버그는 “하나의 단일 AI가 아닌 다양한 AI와 AI 서비스가 존재해야 한다”라고 주장하며 AI의 민주화 필요성을 강조했습니다. 그는 이러한 접근 방식이 광범위한 혁신을 촉진할 수 있다고 말하며, 모든 사람에게 AI의 혜택이 주어지지 않으면 결국 반발을 초래할 것이라고 경고했습니다.

Emily Chang과 인터뷰(https://www.youtube.com/watch?v=YuIc4mq7zMU&t=629s)에선 AI 오픈 소스 외 다양한 주제로 이야기를 나눴습니다. Meta AI에 대해서 마크 저커버그 인스타그램(https://www.instagram.com/p/C9xxBFYyF2X/)에도 포스팅했 듯이 타이핑으로 쿼리를 입력하면 바로 이미지를 생성하는 기능을 소개했습니다. Meta AI 출시의 목표가 올해 말까지 세계에서 가장 많이 사용되는 AI 어시스턴트가 되는 것이고 현재 수억 명이 사용 중이고, 연말까지 목표에 도달할 것이라 밝혔습니다.

또한, 저커버그는 Meta AI의 흥미로운 사용 사례로 사람들이 어려운 사회적 상호작용을 롤플레이하는 것을 소개했습니다. 예를 들어, 직장에서 매니저에게 급여 인상을 요청하거나, 여자친구나 친구와 어려운 대화를 연습하는 데 Meta AI를 사용하는 경우가 있다고 합니다.

이외에도 저커버그는 자녀 교육과 인재상에 대한 자신의 관점을 공유했습니다. 그는 다양한 경험과 유연성, 그리고 가치를 강조하며 이러한 특성이 중요하다고 언급했습니다.

1
0
진용진

진용진

Pre-mortem으로 비즈니스 가설을 사전에 검증한다

얼마전 PM 멤버들이 모여서 PRD(Product requirement document) 작성에 대해서 서로 피드백을 가지는 시간을 가졌다. 프로젝트의 진행, 완료 여부 관계 없이 관련 PRD를 리뷰하면서 의미있는 피드백을 나누었다. 멤버들끼리 문제점 정의, 문서를 읽은 대상자 고려한 도메인 지식의 상세한 정도, 시각화, current state와 desired state를 어떻게 문서화하면 좋을지 의견을 주고 받았다.

그 중에서 내와 유사하게 공통된 문제인식을 가지셨던 멤버가 있었다. 과거에 진행되었던 특정 프로젝트를 같이 돌아보면서 프로젝트 초기 시점에 놓쳤던 중요한 business feasibilty를 어떻게 그 시점에 체크할 수 있을지 이야기했다. 미팅에선 관련해서 구체적인 액션 아이템은 나오지 못했다.

그 뒤 오늘 Lenny's Podcast의 링크드인 글에서 과거 포커 플레이어였고 현재 decision making 관련 코칭을 하는 Annie Duke 인터뷰 글을 읽었다.

Annie Duke는 pre-mortem이라는 기법을 소개했다. pre-mortem은 프로젝트 시작 전에 팀이 모여서 프로젝트가 실패하는 상황을 가정하고, 관련 원인과 assumption을 찾아내는 기법이다. 의사결정 관점에서 위험 징후를 사전에 가정해봄으로써 실제 상황에서 방향성을 선회하는 것이 유연해지고, 소위 말하는 매몰비용과 확증 편향이 커지기 전에 포기하기 쉬워진다는 것이다.

"Use pre-mortems to set kill criteria. Before starting a project, imagine failure and what early warning signs might have predicted it. Commit in advance to reassess or pivot if you notice those red flags later on. This makes it easier to walk away when sunk costs and overconfidence bias loom large." - Annie Duke

  1. 최근에 읽었던 Continuous Discovery Habits에서도 비슷한 개념이 언급이 되었고, 그 내용은 아래와 같다. 아이디어를 중심으로 일을 하는 것은 리스크가 크다. 많은 사람들이 제품 개발 의사결정 과정에서 고객의 요구사항을 듣고, 떠오르는 첫번째 아이디어에 바로 뛰어든다.

  2. 몰입 상승 효과(escalation of commitment)에 빠지게 된다. 이 아이디어를 개발해야하나? 좋은 아이디어인가? 결국 해당 아이디어 틀에서 일을 하다보니 소위 몰입 상승 효과(escalation of commitment)라 불리는 인지적 편향에 빠지기 쉽다. 즉, 우리가 아이디어에 더 많이 투자할수록 그 아이디어와 자신을 동일시하게 된다(‘아이디어에 반했다’라고 표현하는 상황).

  3. 우리가 아이디어에 반하게 되면, 두 번째로 확증 편향(confirmation bias)에 빠지게 된다. 우리가 사랑한 아이디어가 좋다는 증거를 더 쉽게 받아들이고, 아이디어에 결함이 있음을 제안하는 증거를 놓치게 된다.

보통 일하다보면 특정 아이디어와 솔루션 중심으로 product feasiblity만 체크하고 프로젝트를 진행하는 경우가 많다. 앞서 소개한 pre-mortem을 통해 프로젝트가 실패했다고 가정하고 product feasibilty 외 business 관점에서 여러 assumption을 생성해보고, 나열된 assumption을 비교 및 대조해보는 것만으로 많은 인사이트를 발견할 수 있다.

6
0
진용진

진용진

문제 해결과 문제점 정의 구분이 그리 명확하지 않은 것을 강조한 글입니다.

모든 문제점들은 독립적으로 존재하지 않으며, 한 문제를 해결하는 것이 때때로 더 큰 범위의 문제를 다루는 방법이 될 수 있다고 합니다. 또한 조직 내에서 문제를 정의하는 과정은 문제를 이해하는 것 이상으로, 협상과 정치적 요소가 포함될 수 있다는 것을 강조하고 있습니다.

저자는 문제와 해결책 사이의 이분법적 사고를 피하고, '기회(opportunity)'의 관점을 채택하여 문제를 더 폭넓게 이해하고 접근할 것을 권장합니다. 문제점 인식을 넘어서서, 이것이 해결할 가치가 있는지, 그리고 실현 가능한 경로가 있는지를 고려하는 것이 중요하다고 강조합니다.

https://cutlefish.substack.com/p/tbm-1752-the-problem-with-problems

5
0
진용진

진용진

링글 프로덕트에 '내 달성 과제'라는 서비스가 릴리즈 되었습니다. 내부적으로 Achievement라는 명칭으로 챌린지 서비스의 후속으로 진행되었습니다.

내 달성 과제를 리딩하신 박지원 PM께서 정리하신 goal은 '영어 실력이 한번에 오르지 않는 상황에서 노력에 대한 progress를 시각화해 매 수업마다 만족감을 주고 꾸준히 학습하도록 독려하는 것'이라고 밝히셨습니다.

앞으로 '내 달성 과제' 서비스가 유저가 원하는 영어 학습 목표 달성을 위한 작은 단위의 액티비티로 동기 부여와 성취감을 제공하고, 꾸준한 영어 수업을 통해 언어 학습을 습관화할 수 있을 수 있는 좋은 장치가 될 것으로 기대합니다.

릴리즈 시점의 달성 과제 종류는 아래와 같고, 앞으로 계속 확대할 예정입니다. 달성 과제 별로 디자인 메타포도 잘 정의되어서 관심 가지고 살펴 주시면 감사하겠습니다.

1. 열정적인 영어 갓생러/English Enthusiast (수업 듣기)
2. 끈기있는 영어 마라토너/Streak Scholar (매주 연속 수업 듣기)
3. 호기심 많은 튜터 탐험가/Tutor Trailblazer (링글 튜터 만나기)
4. 성실한 영어 개근왕/Attendance Ace (매주 일주일 학습 완료하기)

https://www.ringleplus.com/ko/portal/my-ringle/achievements

4
0
진용진

진용진

Evidence Guided라는 책으로 주목받는 Itamar Gilad의 블로그 내용의 일부입니다. Evidence Guided는 Lenny's Podcast 출연 뒤에 아마존의 Product management 분야에서 2위로 올라와서 실리콘 밸리 PM들 사이에서 좋은 반응을 얻고 있는 것 같습니다. 완전히 새로운 개념의 책은 아니고, 기존 제품 개발 프레임웍을 다시 정리한 일종의 메타 프레임웍인 GIST(Goals-Ideas-Steps-Tests)라는 것을 기반으로 하고 있습니다. 프로덕트 매니저 뿐만 아니라 테크 산업에 종사하시는 분들께 추천드립니다.

---


제품 개발에서 가장 중요한 것은 우선순위 관리입니다. 어떤 아이디어를 선택하느냐에 따라 발생하는 비용은 상당할 수 있습니다.


- 개발 비용 + 배포 비용 + 유지 보수 비용 + 기회 비용 + 기타 잔여 비용


우리는 weak signals, 다수결, 상위 지위자의 의견(Hippo), 산업 트렌드 등을 기반으로 아이디어 실행에 대한 결정을 내립니다. 하지만 이러한 방식은 종종 동전을 룰렛 테이블에 놓는 것과 다를바 없어요. 여기서 Big Bet이란 용어가 나오게 된 이유입니다.

그래서 ICE 스코어링을 활용합니다. 이것은 잘 알려진 프레임워크로, Impact(영향), Confidence(신뢰도), Ease(용이성)를 고려합니다. Impact와 Ease만으로는 우선순위를 지정하기에 한계가 있고, 우리를 무감각하게 만들 수 있습니다. 그래서 Confidence가 이에 대한 솔루션입니다.

결국, bad product ideas에 투자하지 않기 위한 것인데요. 링크에서 소개하는 예시는 어떤 아이디어를 선택하느냐에 따라 발생하는 비용과 위험이 얼마나 큰지를 보여줍니다. 직관, 의견, 테마, 시장 트렌드에 의존하기보다는 검증하고 불확실성을 줄이는 것이 중요합니다.


제품 개발에서 테스트와 검증하는 것이 느려 보이지만 실제로는 리스크와 임팩트 측면에서 효율적입니다.

링크의 예시는 아래와 같은 방식으로 두 가지의 아이디어(챗봇, 대시보드 개발)를 검증합니다. 대부분 bad product idea는 챗봇과 같이 비용이 많이 들어가는 아이디어라는 점입니다. 앞서 언급드린 것처럼 제품 개발은 개발 비용, 배포 비용, 유지 보수 비용, 기회 비용 그리고 기타 잔여 비용이 모두 고려돼야 합니다. �


[ICE를 통한 우선순위 관리 예시]


1. Prioritization round 1: First ICE

- Impact, Ease, Confidence를 1차로 스코어링

- 자기확신(Self conviction), Thematic support(업계가 좋다는 아이디어), 타인의 의견(관리자, 동료가 좋다는 아이디어)는 모두 Confidence 값이 10점 만점의 0.1점으로 0에 가까움. 이러한 의견(Opinion)은 아이디어를 테스트/제품 개발하는데 있어 신뢰할 시그널로 고려하지 않음


2. Prioritization round 2: Estimations and feasibility checks

- Engineering, UX 멤버와 같이 좀 더 정교하게 ease를 계산하여 ICE 스코어를 정교화함


3. Prioritization round 3: Market Data

- 서베이 통해 신규 아이디어 반응 확인

- Market data를 통해 confidenc score는 조금 상승하지만, 여전히 '매우' 낮은 지수임


4. Prioritization round 4: Customer Evidence

- 소수 고객(10명) 대상으로 프로토타입 활용한 user study 진행

- 전화 인터뷰도 병행(20명 대상)

- 기능이 유용한지? 열정적인지? 얼마나 자주 사용할지? 의도한 목표를 잘 이해하는지?

- 이 단계에서 좋은 반응이 나오면 confidence score가 올라가지만 10점 만점의 3점 수준.

- 여전히 high-risk/high-reward project


5. Final Prioritization Round And a Winner!

- MVP 개발 통한 검증하여 최종 출시할 기능 결정

- 예시는 챗봇 6주 개발, 대시보드 5주 개발하여 MVP 출시

- 활성 사용자수, 전화인터뷰를 통한 유저 인터뷰, 그리고 최종적으로 MVP가 아닌 프로덕션 버전 출시 위한 ease를 고려하여 대시보드를 상용 버전으로 개발하기로 결정함

https://itamargilad.com/the-tool-that-will-help-you-choose-better-product-ideas/

6
0
진용진

진용진

우선순위의 미로: 버킷 리스트를 해석하는 사람들

원문: Why do most lists of top-level priorities read like bucket lists? - John Cutler

---

기업의 주요 우선순위가 버킷 리스트처럼 보이는 이유?

1. 문제는 리더들이 하나의 우선순위가 다른 우선순위 보다 더 중요하다고 말하기를 꺼림 "모두 중요하다. 그래서 모두가 우선순위이다"

2. 이와 같은 접근법은 틀린 것은 아님. 특정한 상황에서 동작할 수 있음.

- 충분한 자금을 보유한 경우

- 우선순위가 상호 독립적인 경우. 리소스 / 내부 또는 외부 정치 / 이해관계자의 기대가 충돌하지 않는 경우

- 우선순위가 모두 미션이나 수익에 동등하게 기여하는 경우. 이보다 더 긴급하거나 영향력이 있는 것이 없는 경우

- 이해관계자 모두가 “everything is important” 접근법에 동의하는 경우

3. 리더들은 종종 이러한 조건이 존재한다고 희망함. 여기에 다른 감정적이고 정치적인 요인이 작용함

4. 특정 우선순위가 다른 우선순위 보다 덜 중요하다는 것을 팀에게 말하길 원치 않음. 특히 몇 개월을 들여 팀을 얼라인시키고, 다양한 아젠다로 혼란을 겪은 후에 더욱 그렇게 됨

5. 또한 종종 어떤 우선순위가 다른 우선순위 보다 암묵적으로 더 긴급하거나, 중요하다는 동의가 있음. 리더들은 이러한 차이를 명시적으로 설명하는 것이 비생산적이라고 느낄 수 있음(오히려 역효과가 날 수 있다고 믿음). 리더들은 암묵적인 이해를 통해 일하는 것이 우선순위를 엄격히 하는 것보다 유연하고, 팀의 적응력을 유지할 수 있다고 생각함. "We should be able to walk and chew gum at the same time!"

6. sandbagging paranoia라는 것이 있음. 리더들은 중요한 무언가를 '가장 중요하지' 않다고 표현하면 팀에게 그 일을 하지 않을 구실을 줄 것이라는 두려움이 있음

7. 이러한 모든 요소는 "버킷 리스트" 형태의 우선순위 목록을 만들어 냄

8. 시니어 리더들이 만들어 내는 "버킷 리스트" 형태의 우선순위(항상 모든 것을 원하고, 너무 많은 것을 원하며, 어떤 것이 더 긴급하거나 더 중요하다는 것에 어려움을 겪음) 리스트는 변화지 않을 것이고, 그러한 리스트를 만들어 내는 것이 그들의 임무인 것 같음

9. 이러한 버킷 리스트를 가져와서 실제로 가능하게 만들고 비대칭성과 갈들을 해결하기 위해 노력하는 것은 다른 누구가의 임무임 (Product manager의 일?;;)

10. 버킷 리스트 형태의 우선순위에 대한 인식이 뿌리 깊게 자리 잡혀 있고, 사라지지 않을 것이라는 사실을 인정하면(실제로 긍정적인 측면도 있음), challenge와 opportunity를 명확히 하는데 도움이 됨

6
0
진용진

진용진

PM 역할과 관련한 세 가지 안티 패턴

원문: Three Common PM Role Antipatterns - Itamar Gilad

1. Product Managers reporting to a non-PM Manager

이 안티패턴엔 여러가지 변형이 있음

  • PM이 CTO/VP 엔지니어링에게 보고함

  • PM이 COO/CIO에게 보고함

  • PM이 마케팅/세일즈 헤드에게 보고함

PM을 긴밀하게 협업하는 사람들과 같은 조직에 배치하는 것은 매력적으로 보일 수 있지만 관련해서 문제점이 존재함

  • 프로덕트 매니저는 특별한 종류의 직무임. 엔지니어링/비즈니스/디자인에 소속되지 않음. 프로덕트 매니저는 자신의 어려움을 이해하는 시니어 PM에게 보고하고, 코칭 받고, 업무를 진행하는데 자유를 부여받을 때 가장 성과가 나옴. non-PM에게 보고하는 것은 가능하지만 흔하지 않으며 PM의 경력 성장과 성과에 제약을 줄 수 있음

  • 일반적인 권장 사항은 CPO에게 리포팅한는 프로덕트 조직을 구성하는 것임. CPO가 공석이라면, CEO 또는 비즈니스 유닛의 general manager에게 보고하는 head of product가 PM 조직을 맡도록 함

  • 프로덕트 매니저가 엔지니어링 매니저, 마케팅/영업 매니저에게 보고하는 것은 좋지 않은 아이디엄. 두 경우 목표가 맞지 않음. PM은 올바른 제품을 찾는데 집중해야 하는데, 딜을 성사하거나 엔지너이의 업무 효율성을 담당하는 것은 PM에게 재미없고, 조직에게 도움이 되지도 않음

2. Splitting the PM Role

프로덕트 매니저의 역할은 다양하고 다양한 접점과 일함 - 고객, 엔지니어링, 디자인, 마케팅, 영업, 경영 지원 부서. 관련해서 몇 년동안 PM의 역할을 다양한 방식으로 분리하려는 여러 시도가 있었음:

  • 외부 고객 담당 PM vs 내부 업무 담당하는 PM

  • 비즈니스 PM vs 테크니컬 PM

  • 전략을 맡는 시니어 PM vs 전술을 맡는 주니어 PM

Agile Dev의 도입과 함께 Product Managers 대 Product Owners의 등장함..

  • 프로덕트 매니지먼트 초창기엔 프로덕트 오너가 아닌 프로덕트 매니저만 존재함. 몇년 뒤 스크럼이 도입되면서 프로덕트 오너(PO) 용어 소개됨. 스크럼 내에서 가장 중요한 역할 맡으며, 엔지니어링 팀과 가까운 위치에서 고객/사용자, 이해관계자의 요구사항을 기반으로 우선순위가 정해진 제품 백로그를 관리하는 역할

  • 이는 PM이 하는 일의 일부분에 불과함. 오늘날 PM은 market research 기반으로 요구사항을 결정하지 않음. PM은 팀과 긴밀히 협력하여 목표 달성을 위한 제품 '발견'에 관여함(discover the product that best addresses the goals). 이는 전통적인 프로덕트 오너와 상반되는 개념임

  • 오늘날 기업들은 주로 두가지 이유에서 프로덕트 오너를 채용함. (1) 최근 스크럼 추세는 PO에게 상세한 에픽과 유저 스토리르 작성하고, 계획 세션, 회고, 데일리 스탠드업에 참석하는 등 PO에게 상당한 부담을 주고 있음. 이것은 쉽게 전문 직무가 될 수 있음. (2) 대체로 관리자들은 업무를 나누는 개념을 좋아함. strategic, outbound-facing product work은 시니어가 다루고, 프로덕트 매니저가 직접 처리하기 어려운 전술적인 업무는 PO에게 위임됨. 이는 처음 시도된 것은 아니지만, 제대로 동작한 적이 없음

  • 전략 및 전술적 책임에 따라 프로덕트 관리 업무를 완저히 분리하는 방법은 없음. 그리고 이렇게 일을 나누는 것이 프로덕트 오너에게 좋은 작업 경험은 아님. 이에 대한 해결은 프로덕트 오너의 전술적 업무 부담을 줄이고, 전반적으로 팀 멤버에게 위임하여 프로세스 오버헤드를 줄여서 PM의 다른 중요한 기능을 맡도록 하는 것임

3. Siloing PM, Engineering, and UX

일부 기업에선 엔지니어링 또는 UX 책임자가 에이전시 모델을 활용하여 팀의 리소스를 최적화하려 함. 고정된 fixed cross-functional team은 없고, 대신 각 분기마다 goal과 로드맵에 따라 새로운 ad-hoc 팀이 구성됨.

엔지니어, 디자이너는 필요할 때마다 영역과 프로젝트를 옮겨가며 전문가가 아닌 일반 인력처럼 다뤄짐. 어떤 엔지니어링 책임자는 이러한 방식이 엔지니어가 계속해서 새로운 것을 배우면서 더 많이 참여하게 만든다고 주장함. 어떤 UX 리더는 디자이너가 cross-functional team이 아닌 디자이너와 같은 조직에서 일해야 효과적이라고 생각해서 에이전시 모델의 조직구조 선호함.

이러한 조직구조는 아래와 같은 문제를 일으킴

  • Misalignment - 프로덕트 매니저, UX, 엔지니어는 자신의 전문적인 목표(예: 더 많은 기능 제공, 적절한 디자인 원칙 사용, 높은 코드 품질 유지)에 더 많이 헌신할 가능성이 있음. 타협을 찾기가 더 어려움. 제품의 성공은 프로덕트 매니저의 문제가 되며, PM은 어떤 의미에서 고객으로 인식되기도 함

  • Lack of area expertise - 특정 제품 영역(예: 검색 또는 결제)에서 지속적으로 작업하는 엔지니어와 디자이너는 기술, 코드베이스 및 사용자 경험에 대한 전문 지식을 쌓임. 에이전시 모델에서는 많은 지식이 분산되거나 사라져서 팀의 효율성이 크게 낮아짐

  • Lack of team spirit - 제품 팀은 여러 주기의 제품 개발과 론칭을 통해 합이 맞춰지는데 이에 시간이 필요합니다. 이러한 팀 스프릿은  ad-hoc 팀에서는 나타나지 않습니다.

  • Handoffs - 이러한 작업 방식은 PM이 요구 사항을 전달하고 디자이너가 목업을 전달하고 엔지니어가 코드를 개발하는 미니-워터폴을 장려합니다. 이로 인해 지나친 계획의 오버헤드와 민첩성 부족(planning overhead and lack of agility)과 같은 워터폴의 모든 단점이 나타납니다.

  • Decisions don’t stay in the team - 에이전시 모델에서 엔지니어, 특히 디자이너는 자신의 디자인 동료의 리뷰와 이를 통한 결정을 내릴 것을 장려받음. 따라서 PM은 관련 역할을 가질 수 없다고 말할 수도 있음. 왜냐하면 PM이 초대되지 않은 디자인 위원회가 잘못된 접근 방식이라고 판단했기 때문임. 이는 PM, UX 및 엔지니어가 제품을 정의하고 필요하면 리뷰로 가져가는 프로세스와 매우 다른 접근 방식임

How to fix: 

  • 명확한 정체성과 미션을 가진 cross-functional team을 만듭니다.

  • 리더십 트리오를 만듭니다(Create leadership trios) - 팀 리더부터 PM/UX/ENG 리더가 트리오(구글에선 트라이어드 triads라고 부름)를 구성하고 긴밀하게 협력함. 직군 간의 벽을 허물고 cross-disciplinary collaboration 촉진하기 위해 노력함. 리더십 트리오는 각 cross-functional team에 권한을 위임하고 자체적으로 결정을 내릴 수 있도록 필요한 모든 컨텍스트를 제공하려고 노력해야함.

9
0