ChatGPT로 5분만에 블로그 쓰고 느낀 인간의 일
글로 쓰면 좋을만한 내용을 아웃라인을 먼저 잡아 보았다.
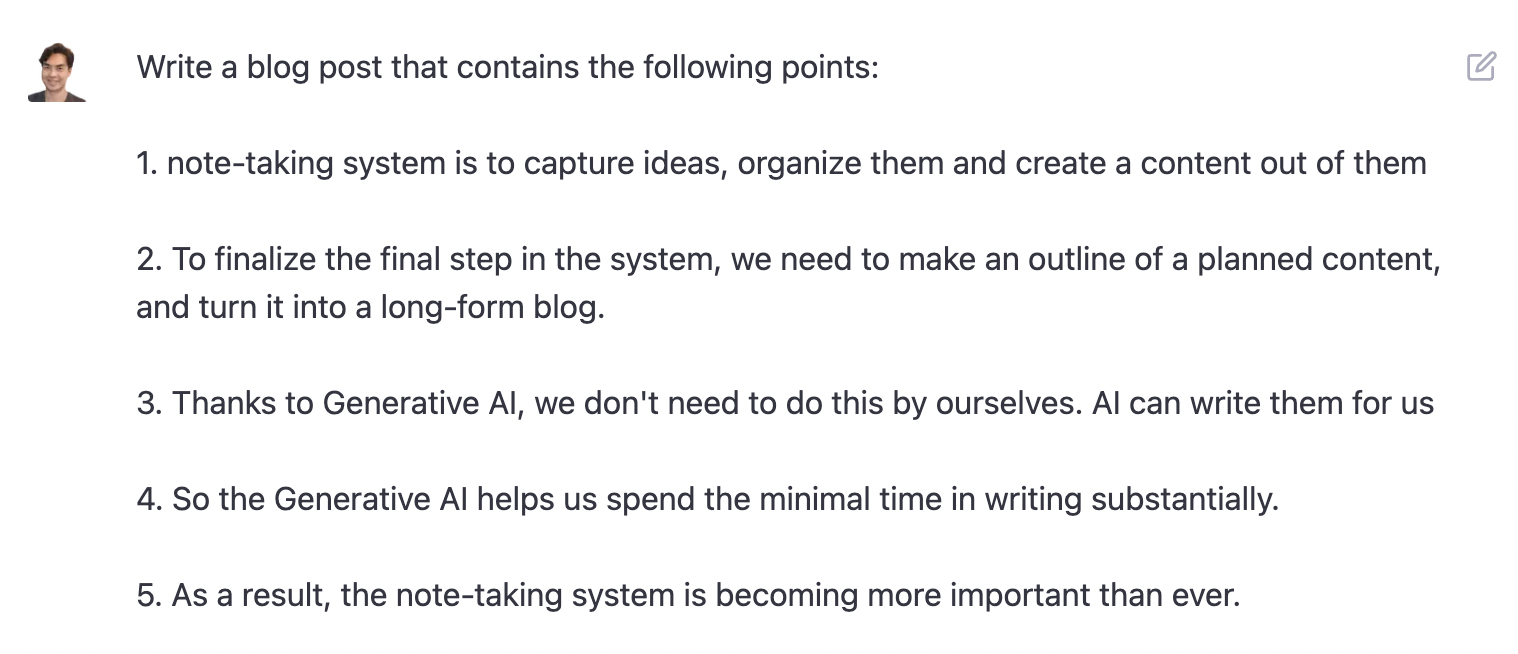
위의 내용은 대충 ...
모든 기획은 핵심 포인트를 가지고 시작한다. 슬라이드 덱을 만들때도 유튜브 영상을 만들 때도 보고서를 쓸 때도 블로그 글을 쓸 때도 마찬가지이다. 그러면 Generative AI가 콘텐츠를 생성해내는 것을 정말 잘하니까 결국 인간에게 남는 것은 그 기획물의 핵심 포인트를 만들어 내는 것이다. 그리고 그걸 가장 잘하는 방법이 세컨드 브레인을 만들고 사용하는 것이다.
참고: 세컨드 브레인, 제텔카스텐, 개인 지식 관리는 도대체 무엇인가
hhttps://tkim.co/2022/07/16/what-is-second-brain/
그러므로 Generative AI가 엄청나게 활용될 2023년부터는 세컨드 브레인이 메인 스트림의 생산성 도구가 될 것이고, 인간이 하는 가장 중요한 일을 하는 방법이 될 것이다.
라는 내용이다.
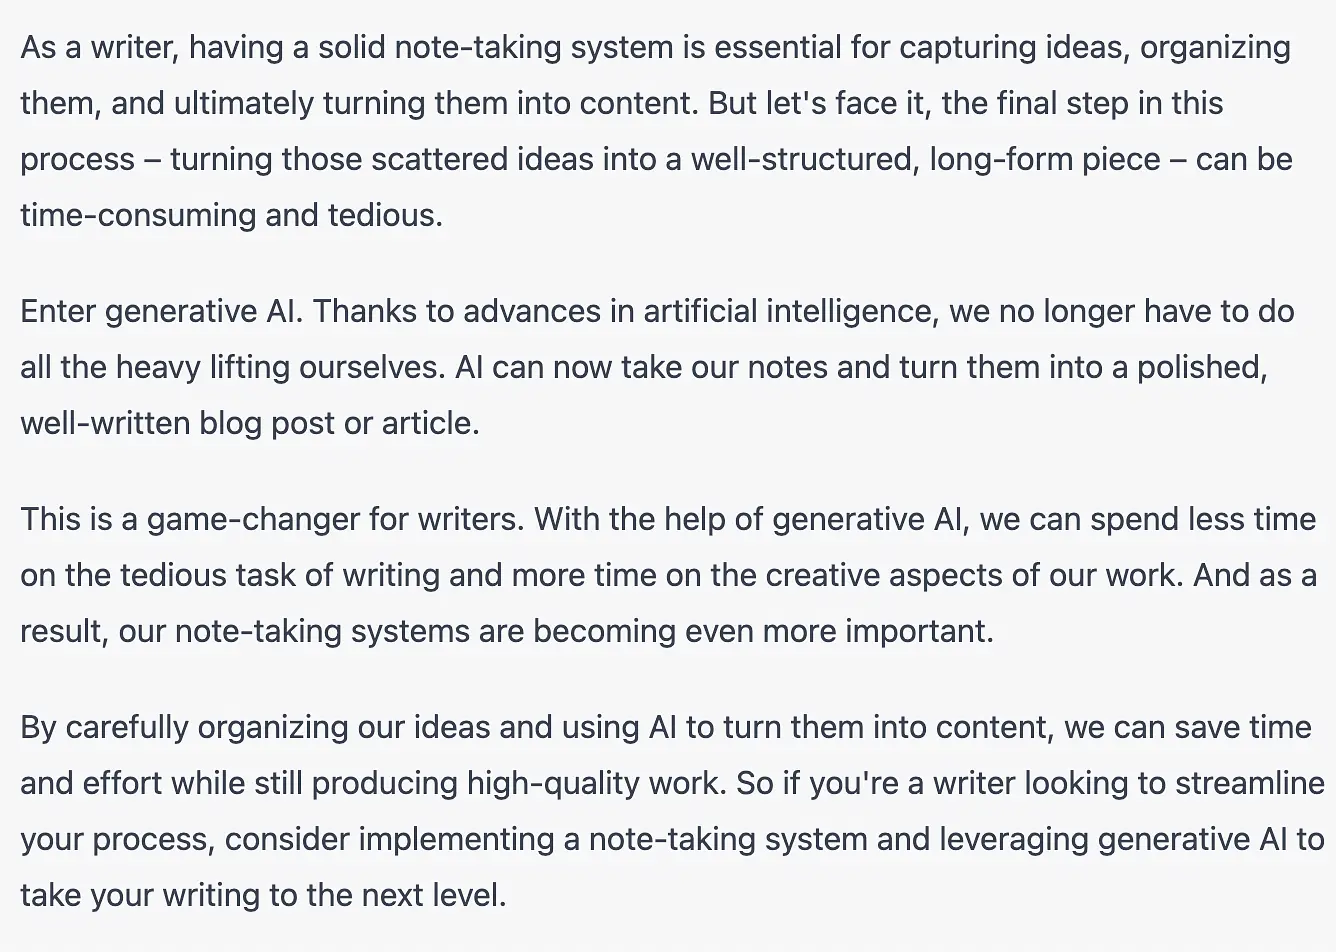
위의 불렛 포인트를 ChatGPT에 넣었더니 아래와 같이 글이 나왔다.
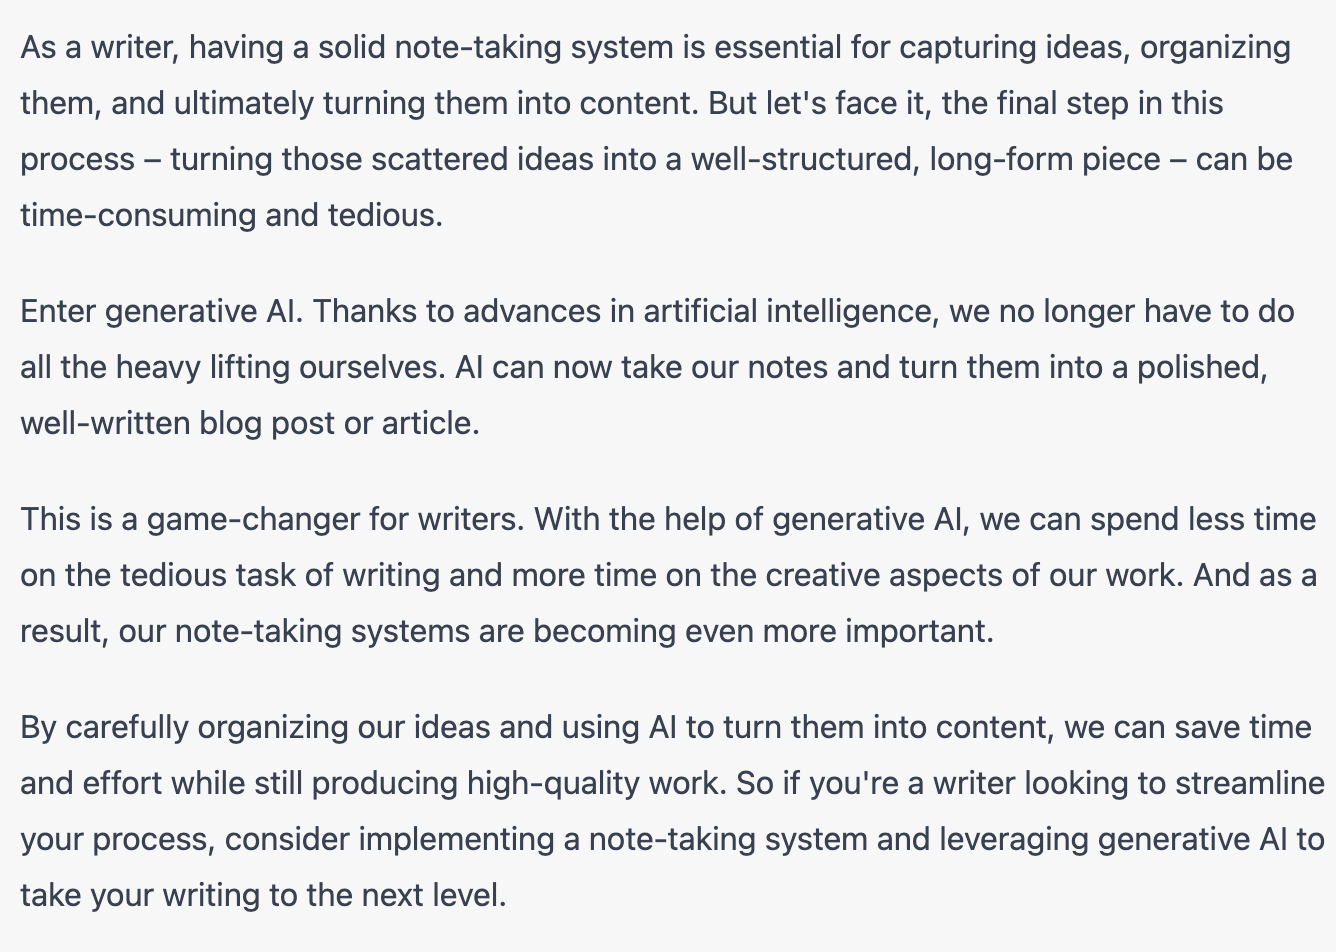
정말 인상깊다. 위의 내 말이 헛소리가 아니라는 확신이 든다.
더 무서운 것은 GPT라는 거대 언어 모델의 성능이 한계에 다다르지 않았다는 것이다. 데이터를 더 많이 먹으면 그에 비례해서 성능이 향상되고 있다.
결국 미래에 사람이 할 일은 평소에 떠오른 아이디어, 얻은 영감, 인사이트, 흥미로운 사례를 잘 정리해 두고, 그 과정에서 새로운 아이디어를 떠올리는 일 밖에 남지 않을 것이다.
ps. Generative AI에 대해 같이 얘기를 나눠요
오픈 채팅방 - https://open.kakao.com/o/gkoIRmSe
(암호: gpt3)
댓글
로그인 후 댓글을 남길 수 있습니다.
살면서 이렇게 무언가를 신기하게 느낀 적이 처음입니다. GPT3가 제공하는 기회들을 상상할수록 즐겁고 더 공부하게 되네요. 현제 클로즈 베타로 오픈된 노션AI도 정말 기대됩니다.
저도 그렇습니다 그리고 직관적인 사용 케이스 외에 어떤게 더 있을지 탐색해 보고 싶습니다. 생각지 못한 활용 방법이 또 있을 것 같아요.
지식 관리, 특히나 연결의 부분이 더 중요해질 거라는 생각이 드네요. 연결로 파생된 아이디어의 확장과 실행에 대한 인사이트는 chat gpt가 알려주기도 할 것 같아요.
네 저도 그렇게 생각합니다.
"거대 언어모델의 성능이 한계에 다다르지 않았다" 에 대한 근거로 "데이터를 더 많이 먹으면 그에 비례해서 성능이 향상되거 있다."는 별로 좋지 않은 근거입니다. gpt3는 현존하는 데이터중 거의 대부분의 데이터를 학습시킨거거든요
저는 그렇게 생각하지 않습니다. https://arxiv.org/abs/2211.04325
언어모델 관련해선 "하이퀄리티 언어 데이터는 2026년정도면 한계에 도달할거다" 라는 논지의 아카이브 자료이고, 아직 데이터가 한계에 다다르지 않았기 때문에, 그리고 아직 데이터를 넣을 여지가 있다. 라는 말씀을 하고싶으신것 같은데, 제가 이해한게 맞을까요? 하지만 저 자료에서 말하는 "하이퀄리티 랭귀지 데이터"라는게 꼭 gpt에 넣을만한 텍스트 데이터만을 의미하는게 아니라, 스피치 데이터같은것도 포함이라서요. 앞서 말했듯, gpt3에는 웹사이트에 존재하는 대부분의 텍스트, 위키, 수많은 책들을 크롤링 하고, 이를 필터링 해서 괜찮은 부분만 추린것입니다.(낮은 퀄리티의 데이터까지 넣어버리면 결과가 오히려 안좋아지거든요) 이러한 상황에서 더 텍스트 데이터를 구해다가 우겨넣는건 생각보다 성능향상폭이 크지 않습니다. 현재 영어자료만 들어가 있으니 타언어 자료도 넣을 수 있는 방식이 개발된다면 모를까.... 뭔가 계속 반기만 들고있는것 같은데, 저도 언어모델의 성능이 지금이 한계라고는 생각하지 않습니다. 하지만 데이터적인 측면보다는 말 그대로 모델의 구조적 개선이 이루어져서 성능이나, 효율이 더 증가할것같다는게 제 생각입니다. 실제로 지금까지 모델의 발전은 "아무튼 큰 데이터"와 "아무튼 큰 파라미터를 가지는 모델"을 가지고 "아무튼 좋은 성능만 내는것"이 미덕이였는데, 서서히 효율을 바라보고(메타에서 최근에 개발한 OTB-175B의 경우, GPT3와 비슷한 성능을 내면서도 모델을 학습시킬때 탄소발자국을 1/7만 소모했다고 주장합니다.) 모델구조의 개선으로 성능을 높이려는 시도가 시작되고 있거든요
긴글 감사합니다! 많은 인사이트가 있네요. 제가 말한 건 데이터를 더 넣었을 때 성능이 더 선형적으로 증가할 여지가 충분하다 - 라는 의미였어요. 그런데 말씀하신건 데이터를 거의다 넣었다 -- 였구요. 그래서 제가 말씀드리고 싶은 것은 아직 데이터 더 넣을게 있는것 같다 -- 였습니다. 지훈님이 생각하시는 하이 퀄리티 데이터가 적어 보여도 저는 아직 넣을 게 더 있다 - 라는 의견을 드리고 싶어서 페이퍼를 인용했구요. 데이터를 더 늘리기 위한 방법도 개선될 것이고, 지훈님 얘기대로 모델 자체에 혁신도 계속 있을거라 봅니다. 그리고, 아직 우리가 사용 방법을 몰라서 full potential을 다 쓰고 있지도 못하는 것 같구요.
맞아요 의외로 사용방법을 몰라서 full potential 을 다 못쓰는 경우가 생각보다 많이 큰것같더라구요. 가끔보면 "이녀석들은 지가 만들고도 어떻게 써야할지 잘 모르는것 같다" 라는생각이 들때도..... ㅋㅋㅋㅋㅋㅋ 더 빨리 많이 발전했음 좋겠고, 그 발전에 저도 기여할 수 있다면 정말 영광일것같습니다 덕분에 많은 인사이트 얻고갑니다. 감사합니다.