🐋 가설 검정을 위한 (간단) 통계학 수업
서비스를 운영하며 어떠한 변화를 주는 것에 굉장히 조심스럽다. (특히, 이미 유저가 잘 사용하고 있는 기능은 더욱 그렇다) 하지만 모든 것은 100%가 아닌 이상 개선의 여지가 있기 마련이다. 그래서 우리 팀은 항상 AB 테스트를 한다. 대체적으로 A는 기존의 기능/화면/카피이고 B는 새로운 가설을 기반으로 만들어진 (더 좋은 방향으로 가기 위한) 시도이다.
이렇게 항상 AB 테스트를 진행하는데 (정식 스프린트는 이미 40차가 넘었다) 결과 분석을 내가 하고 있다 보니, 우리 팀원들에게 내가 어떠한 과정을 거쳐 그러한 결론을 내는지 통계학적 관점에서 한 번 설명해 주고 싶었다. 그래서 이 글을 작성하게 되었다.
우선 나는 전문 통계학을 전공한 사람은 아니고 아래에서 다룬 통계학적 내용은 큰 흐름일 뿐! 각 흐름 안에서의 가정과 계산 방법, 결론 도출 방식은 아래에서 설명한 것과 다르게 매우 매우 복잡하다는 것을 미리 말한다. (+ 인터넷 세상엔 정말 친절한 통계학 박사님들도 많이 계시다. 개인적으로 정말 쉽게 잘 설명해 주셔서 이분 글을 많이 참고했다)
📌 가설 검정 단계
1. 가설 설정하기
귀무가설은 A와 B의 차이가 없다는 것이다.
대립가설은 A와 B가 차이가 있다는 것이다. (편의를 위래 앞으로 모든 가설은 대립가설을 칭한다) 3가지 방법으로 차이를 볼 수 있다:
온보딩에서 영상을 본 유저와 보지 않은 유저의 전환율은 다를 것이다. (two-tail)
온보딩에서 영상을 본 유저는 보지 않은 유저보다 전환율이 높을 것이다. (right one-tail)
온보딩에서 영상을 본 유저는 보지 않는 유저보다 전환율이 낮을 것이다. (left one-tail)
이번 예시에서는 온보딩에서 영상을 본 유저는 보지 않은 유저보다 전환율이 높다는 right one-tail로 가설을 세워보겠다.
2. 신뢰구간 (Confidence level) 정하기
우리가 신규 유저를 대상으로 같은 실험을 100번 했을 때 95번은 같은 결과가 나온다고 하면 신뢰도는 95%이다. 보통 신뢰도는 95%나 99%를 사용한다.
3. 알파 (Alpha level) 계산하기
우리가 내리는 결론이 통계적으로 유의미한지 판단할 수 있는 기준이 되는 숫자이다. 알파는 1 – 신뢰구간이다. 따라서 보통 알파는 5%나 1%이다.
만약 one-tail 테스트를 한다면 알파는 선택한 숫자 그대로 사용한다. 하지만 만약 two-tail 테스트를 한다면 알파 값을 1/2 해야 한다. 즉 2.5%이거나 0.5%가 된다.
이번 예시에서는 one-tail이니 5%를 그대로 사용하겠다.
4. 통계 기법 정하고 검정 통계량 계산하기
이제 우리에게 가장 잘 맞는 실험 방법론을 선택하고 숫자를 입력하여 우리의 가설이 맞았는지 확인해봐야 한다. 유형별 방법론은 아래 다시 정리했다.
간단히 예시를 이어가자면 영상을 본 유저의 평균 전환율과 영상 보지 않은 유저의 평균 전환율을 비교해볼 수 있다. 두 표본의 평균을 비교할 때는 Z-test라는 테스트를 사용할 수 있다. Test를 통해 Z값을 구하게 된다.
5. P값 (P-value) 계산하기
P값(유의확률)은 어떤 사건이 우연히 발생할 확률이다. P값이 우리가 기준으로 세운 알파(5%)보다 적으면 가설을 통과했다고 보면 된다. 왜냐하면 이것은 우연히 일어난 일이 아니고 뭔가 의미가 있다는 것이기 때문이다.
아까 구한 Z값으로 P값을 구할 수 있다. 예를 들어 P값이 0.03이 나왔다고 해보자.
6. 결론 내리기
P값이 알파 0.05(5%)보다 낮기 때문에 우연이 아니라 확실히 영상 온보딩 유저의 전환율이 더 높다. 따라서 우리의 가설이 맞았다: 온보딩에서 영상을 본 유저들의 전환율이 더 높다.
📌 어떤 통계 기법을 선택해야 하는가?
우리가 하는 테스트의 형태 및 샘플의 성질에 따라 어떤 기법을 사용할 지 선택할 수 있다.
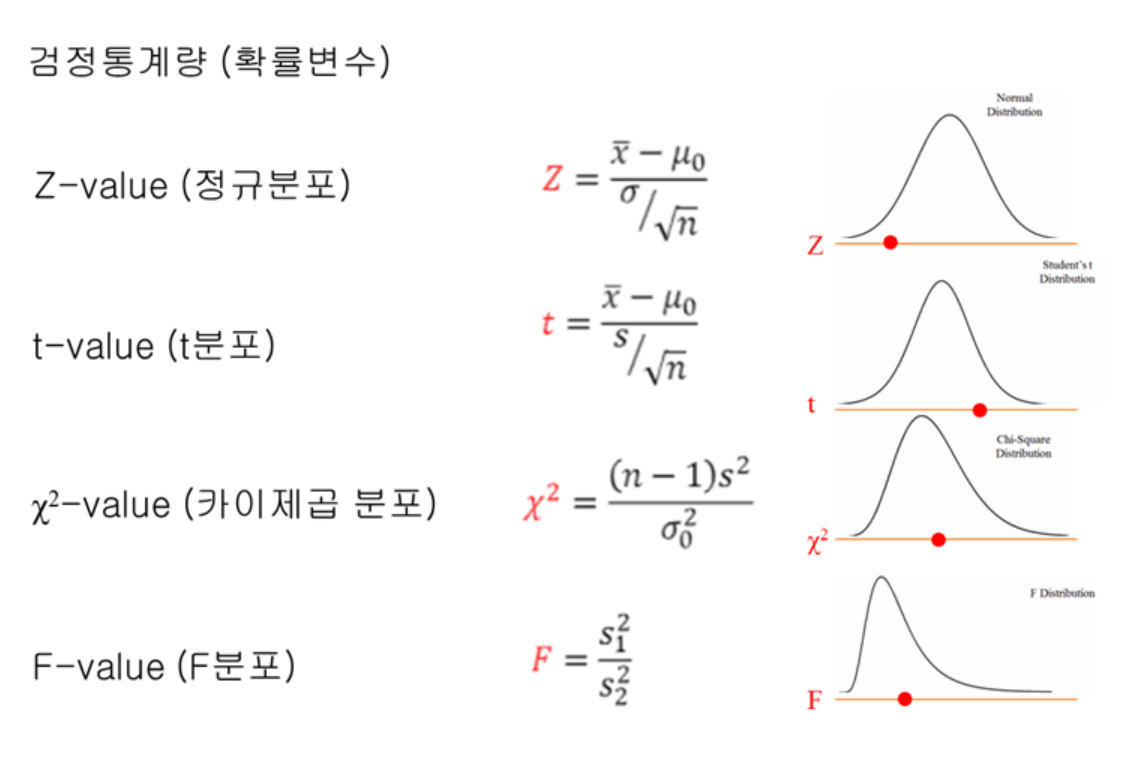
출처: https://drhongdatanote.tistory.com/80
이중 AB테스트를 할 때 내가 가장 많이 사용하는 2가지 기법과 사용 방법을 소개하겠다.
1. AB 비율 차이 👉 Z-test for 2 Population Proportions
A와 B 고객군의 비율 차이가 있는지 확인하는 테스트 기법이다. 여기서 비율은 각 고객군에서 우리가 정의하는 “성공” 이벤트를 한 고객의 비율이다.
실제 내가 적용했던 사례를 공유한다. 이번엔 신규 기능에 대한 AB 테스트가 아닌 특정 행동을 한 고객군 AB에 대한 차이를 보는 테스트이다.
결제한 유저(A)와 결제하지 않은 고객(B)의 회원가입한 시간대의 비율을 확인했다.
귀무가설 = A와 B는 같은 시간대의 같은 비율로 회원가입 했다.
대립가설 = A와 B의 같은 시간대의 다른 비율로 회원가입 했다. (two-tail)
계산 방법 (정말 다양한 가정(ex.모집단의 표준편차를 아는지)과 데이터(ex.허용 오차) 등을 제외하고 가장 간단하게 계산할 수 있는 방법인 것):
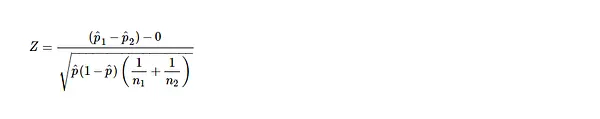
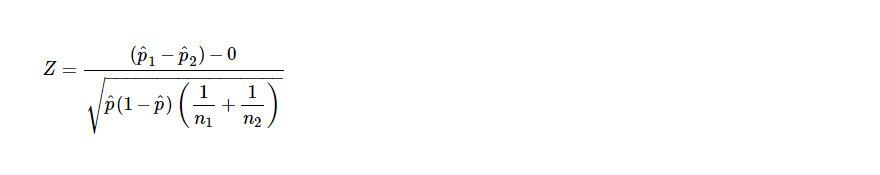
Z 구하기
P-value 테이블에서 구하기 (각 알파값 별로 테이블이 있다. 우리의 z값을 특정하면 p값를 찾을 수 있다)
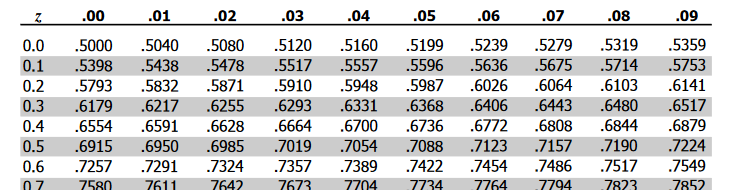
사실 이렇게 복잡하게 할 필요 없이 계산해주는 사이트를 활용하면 된다: https://www.socscistatistics.com/tests/ztest/default2.aspx
간단 예시로 새벽 2시 ~ 2시 30분에 유입된 고객군의 비율을 본다고 해보자.
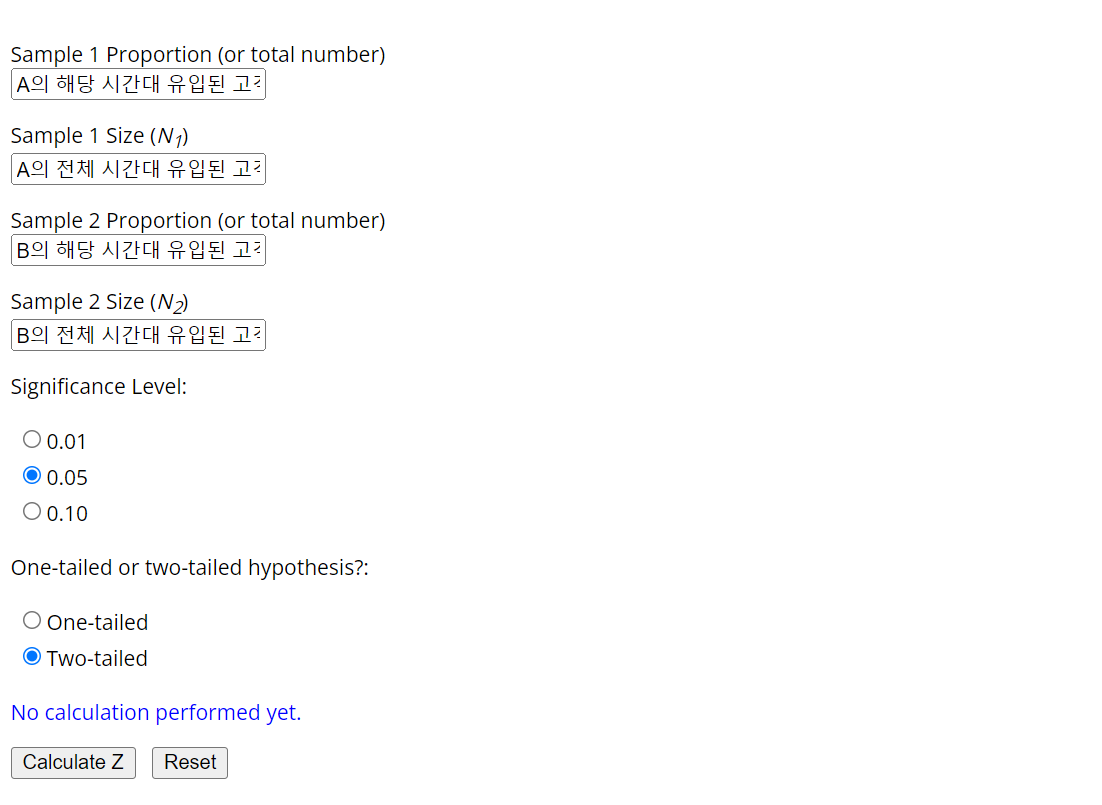
Sample 1 Proportion (or total number) = A의 해당 시간대 유입된 고객 수
Sample 1 Size = A의 전체 시간대 유입된 고객 수
Sample 2 Proportion (or total number) = B의 해당 시간대 유입된 고객 수
Sample 2 Size = B의 전체 시간대 유입된 고객 수
Significance level = 알파 = 0.05
Two-tailed
그럼 이런 결과가 나온다. The value of z is -2.7259. The value of p is .00634. The result is significant at p < .05.
우선 P값이 우리가 정한 알파값보다 더 낮다. 따라서 이는 우연히 일어난 일이 아니고 A와 B군 중 하나는 이 시간대에 더 많이 혹은 적게 들어왔다는 뜻이다.
따라서 결과를 이렇게 도출할 수 있다: A와 B군의 새벽 2시에 유입된 비율은 통계적으로 유의미하게 다르다.
2. AB 평균 차이 👉 T-test for 2 Population Means
A와 B 고객군의 평균 차이가 있는지 확인하는 테스트 기법이다.
실제 내가 적용했던 사례를 또 공유한다. 현재 우리 서비스에서 코어 액션까지 가는데 약 6가지 단계가 필요하다. 이것을 단축시키는 홈 화면 버튼과 기존의 홈 화면 버튼 AB 테스트를 했었다. 단계가 단축되었으니 B 고객군의 1주일 평균 수면 횟수가 올라가는지 궁금했다.
무작위로 표본에 들어갈 신규 고객을 선정했다. 그리고 기존 플로우대로 사용한 고객은(A)과 단축된 플로우를 사용한 고객(B)의 평균 수면 횟수를 비교했다.
귀무가설 = A와 B는 같은 평균 수면 횟수를 가진다. 대립가설 = B는 더 많은 평균 수면 횟수를 가질 것이다.
계산 방법 복잡하니 바로 웹사이트 추천으로 넘어가겠다: https://www.evanmiller.org/ab-testing/t-test.html
우리의 데이터를 입력해보자
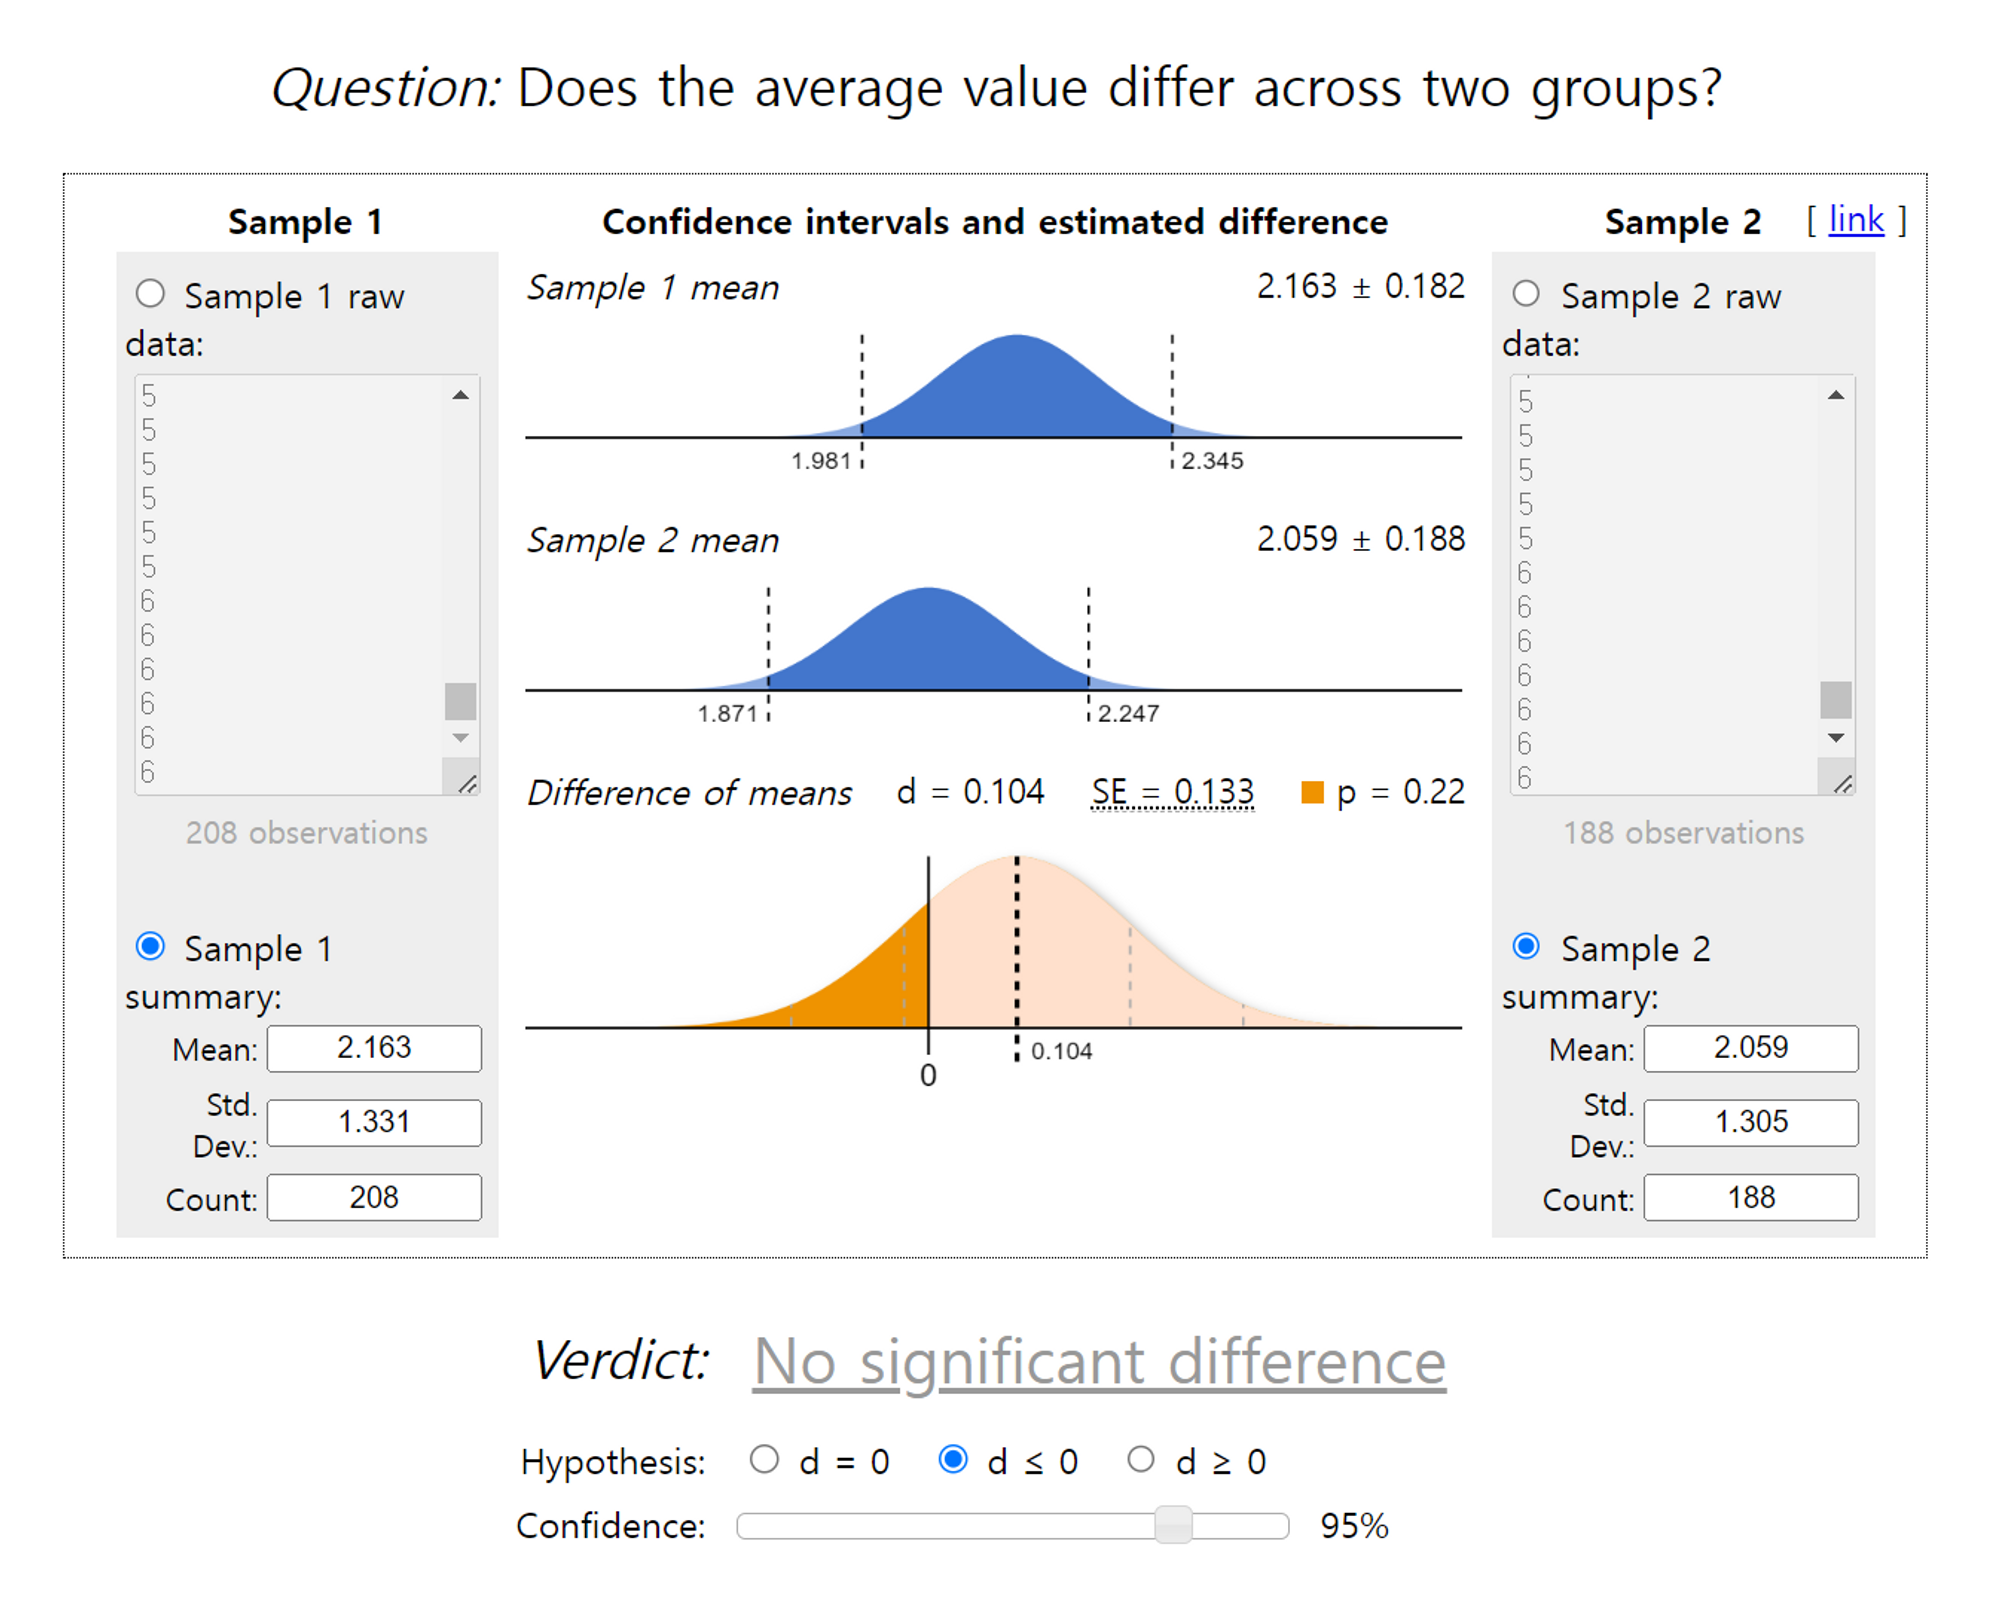
Sample 1 = A 고객군의 1주일 전체 수면 횟수
Sample 2 = B 고객군의 1주일 전체 수면 횟수
Hypothesis = d <= 0 👉 가설에서 B의 수면 횟수가 더 많아질 것이라고 했다. 따라서 A 고객의 평균 횟수에서 B 고객의 평균 횟수를 빼면 d(=difference)가 0보다 작을 것이기 때문에 d <= 0을 선택했다.
Confidence = 95%
그럼 이런 결과가 나온다.
결과를 이렇게 도출할 수 있다: A와 B군의 1주일 평균 수면 횟수는 통계적으로 유의미하게 다르지 않다. 따라서 코어 액션까지 가는 단계는 수면 횟수에 영향을 미치지 않는다.
이러한 가설 검정을 할 때 꼭 주의해야 하는 것이 있다면 바로 “표본수”이다. 각 기법마다 얼마의 표본수가 필요한지 도출하는 계산법이 있지만 이론적으로는 표본에서 최소 30개의 데이터가 있으면 통계적으로 유의미하다고 볼 수 있다. 하지만 실제 서비스에 적용할 때는 유의미한 결과를 내기 위해 훨씬 (훨~씬) 많은 모수가 필요할 것이다.
데이터 분석이 초기 스타트업에 왜 필요할까? 데이터를 기반으로 결정하고 발전하는 것이 가장 합리적이기 때문이다. 그렇기에 서비스를 만드는 모두가 데이터를 이해해야 한다. 코인베이스 PM분께서 하신 이야기 중 기억에 남는 것이 좋은 PM은 데이터 사이언티스트의 일을 없애는 사람이라고 했다. 실제 이 PM분과 함께 일하던 데이터 사이언티스트 분께서는 팀원들을 교육하고 분석 업무를 자동화하여 그 팀을 떠나는 것이 KPI라고 이야기했다고 한다.
나의 데이터 분석 역할이 없어질 때까지, 그리고 팀의 데이터 분석 및 인사이트 도출 능력이 나를 뛰어 넘을 때까지 더욱 열심히 공부하고 노력하겠다! 😊
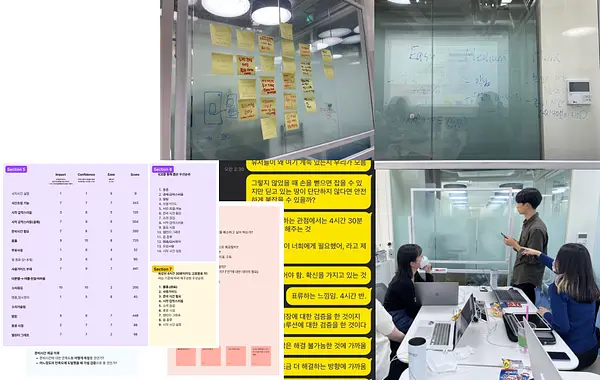
 그렇게 우리는 우리만의 원칙을 세웠다.
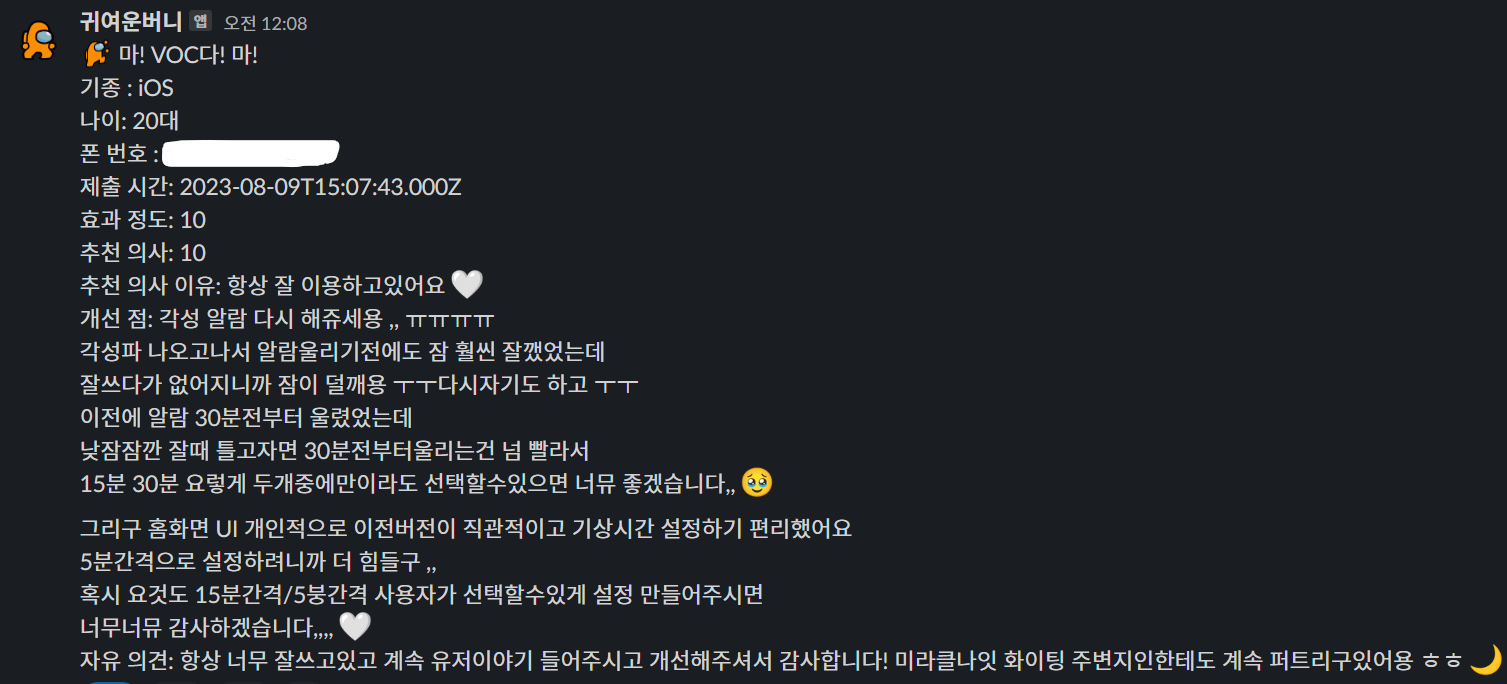 하지만 우리를 놀라게 한 것은 그들의 솔직한 피드백이었다. 서비스 경험이 만족스럽지 못하다고 이야기하는 사람들이 열정적으로 우리의 서비스를 비판했다. 미라클나잇을 친구 누구에게도 추천할 의사가 전혀 없다고 한다. 그렇지만 엄청나게 상세한 이유들을 적어주신다. 한 번은 인터뷰에서 그런 고객에게 질문을 했다. 그럼에도 불구하고 왜 인터뷰를 해주시나요? 그의 대답이 아직도 기억난다. 본인의 수면 문제를 해결해 줄 수 있는 곳이 여기 밖에 없을 것 같고, 이 서비스는 본인이 이야기하면 바뀔 것 같아서 한다고. 우리는 누군가에게 대체 불가능한 서비스로 자리 잡고 있었다.
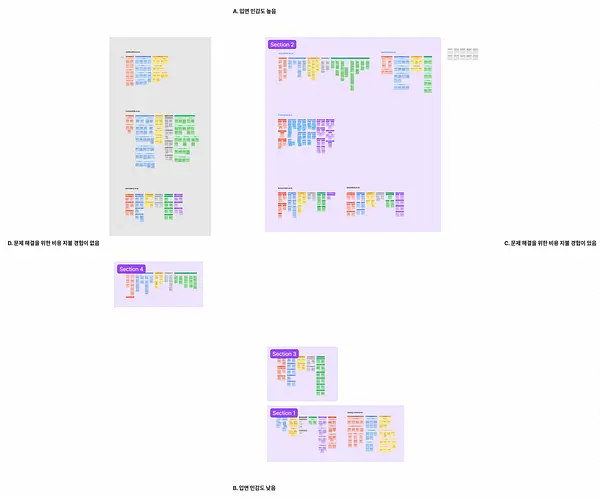
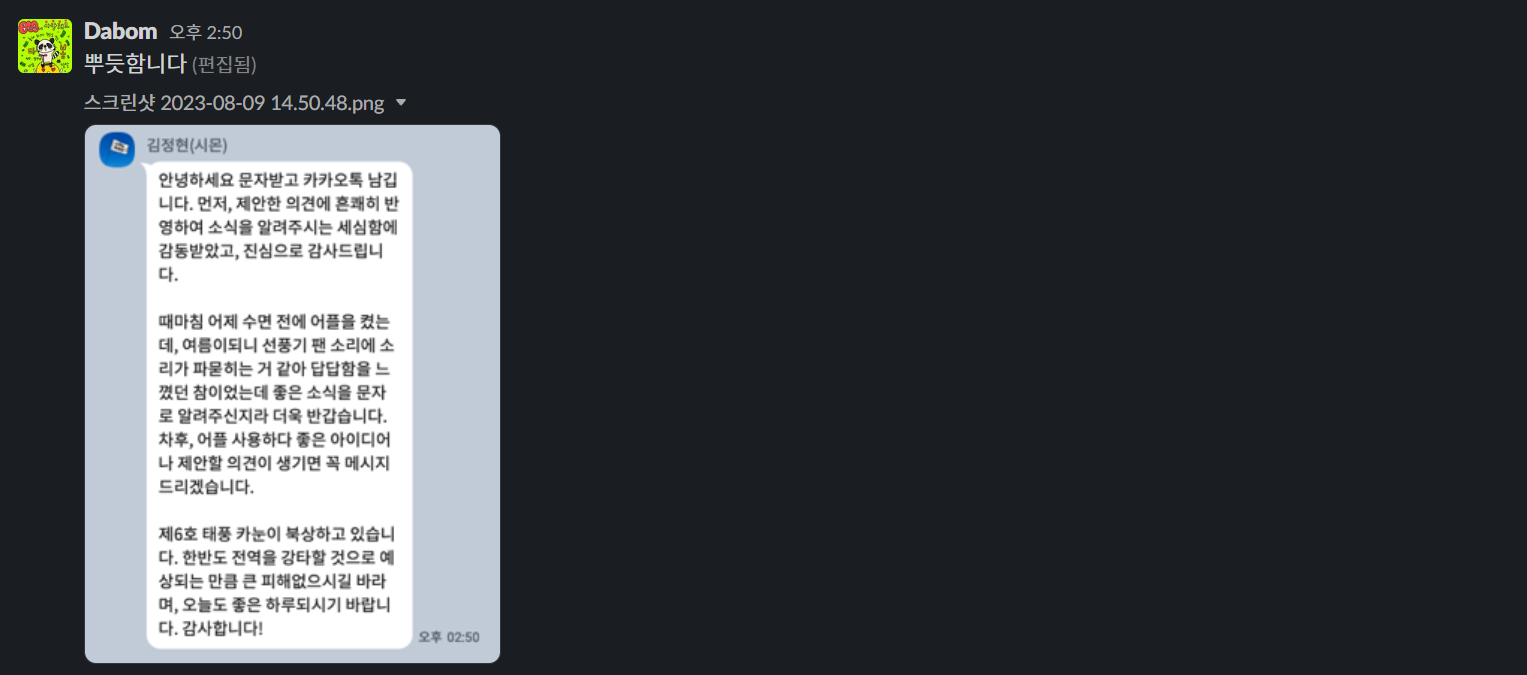
 뿐만 아니라, 각자의 자리에서 각자가 한 액션에 따라 고객의 목소리가 어떻게 바뀌는지 바로바로 확인할 수 있다는 것도 엄청난 장점이다. (고객이 제시한 문제를 빠르게 해결하여 드리니 감사하다고 장편의 문자를 받은 오퍼레이터 다봄의 행복한 순간)
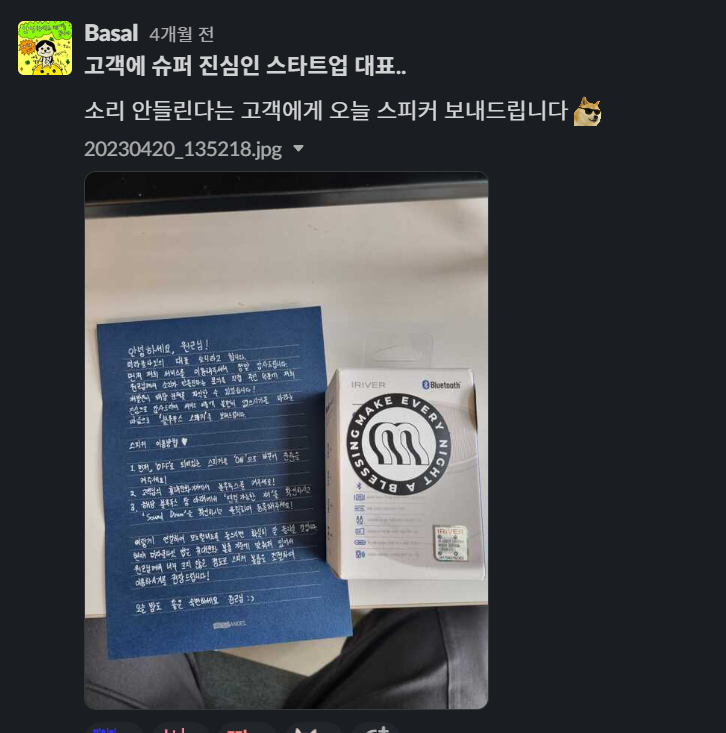
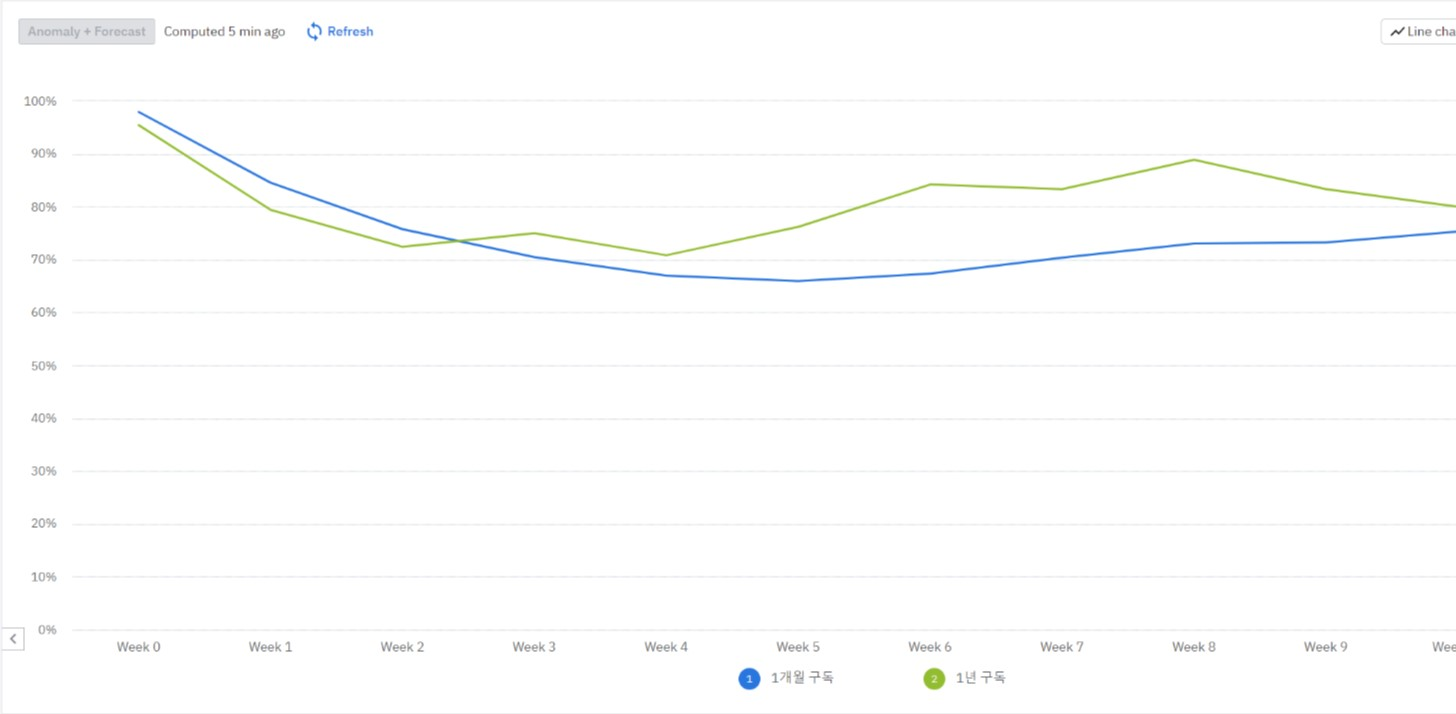
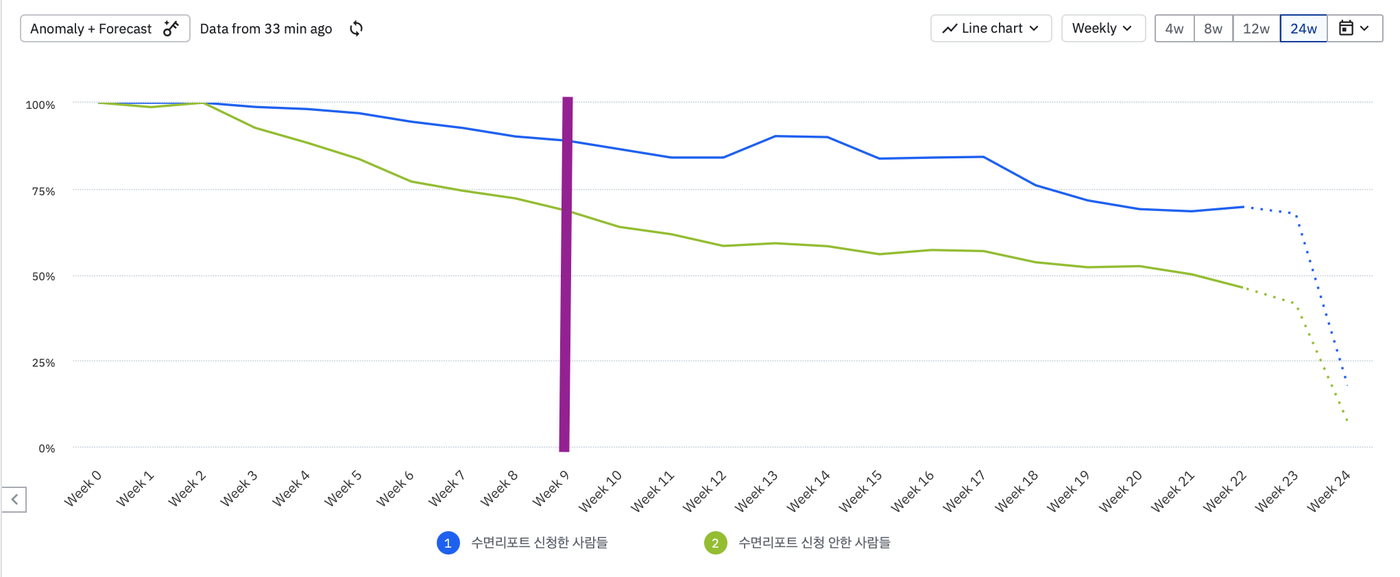
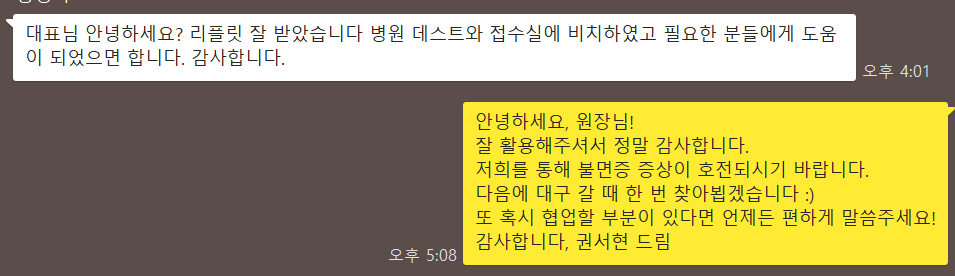 그 결과 우리 고객은 엄청난 리텐션을 보인다. 우리와 진정으로 소통하고 이야기하며 우리의 본질을 이해해 주시는 분들은 계속 앱에 남는다. 떠난 사람도 돌아온다.