싱클리에 적용된 AI 기술 (1) Embedding에 대하여
안녕하세요, 싱클리 팀의 Spring입니다. 🦄
메이커로그에 올린 글을 클럽에도 공유드리면 좋을 것 같아, 같이 올려요 ;)
저희 팀은 AI 기술 기반으로 고객 피드백을 분석하는 제품 싱클리를 만들고 있는데요, 이번에 Podium이라는 미국 회사의 AI 해커톤(Hack-AI-thon)에서 저희 연구팀이 Advisor로 참여하여 자문한 AI 관련 내용을 공유드리고자 합니다.
<Podium의 Hack-AI-thon에 참여해 AI 관련 자문을 진행했습니다.>
Podium에 제공한 설명 자료 등 싱클리에도 적용되는 AI / NLP 기술 관련해서 더 많은 분들께 공유드리면 좋을 것 같아, 시간 날 때마다 차근차근 풀어내보려고 합니다.
이번에 첫 편으로 풀어낼 이야기는 Embedding이라는 개념인데요, Semantic Search(의미 기반 검색), Recommendation(추천), Clustering(군집화) 등을 비롯하여, LLM(Large Language Models: 대형 언어 모델)에게 방대한 사전 지식을 주입하여 이를 바탕으로 원하는 결과물을 만들어내도록 하는 데 필수적인 요소입니다.
현재 싱클리에서도 고객 피드백을 자동분류 하거나, 긍정/부정 감정 분석 결과를 제공하는 등 다양한 기능에 embedding이 활용되고 있습니다.
Embedding이란?
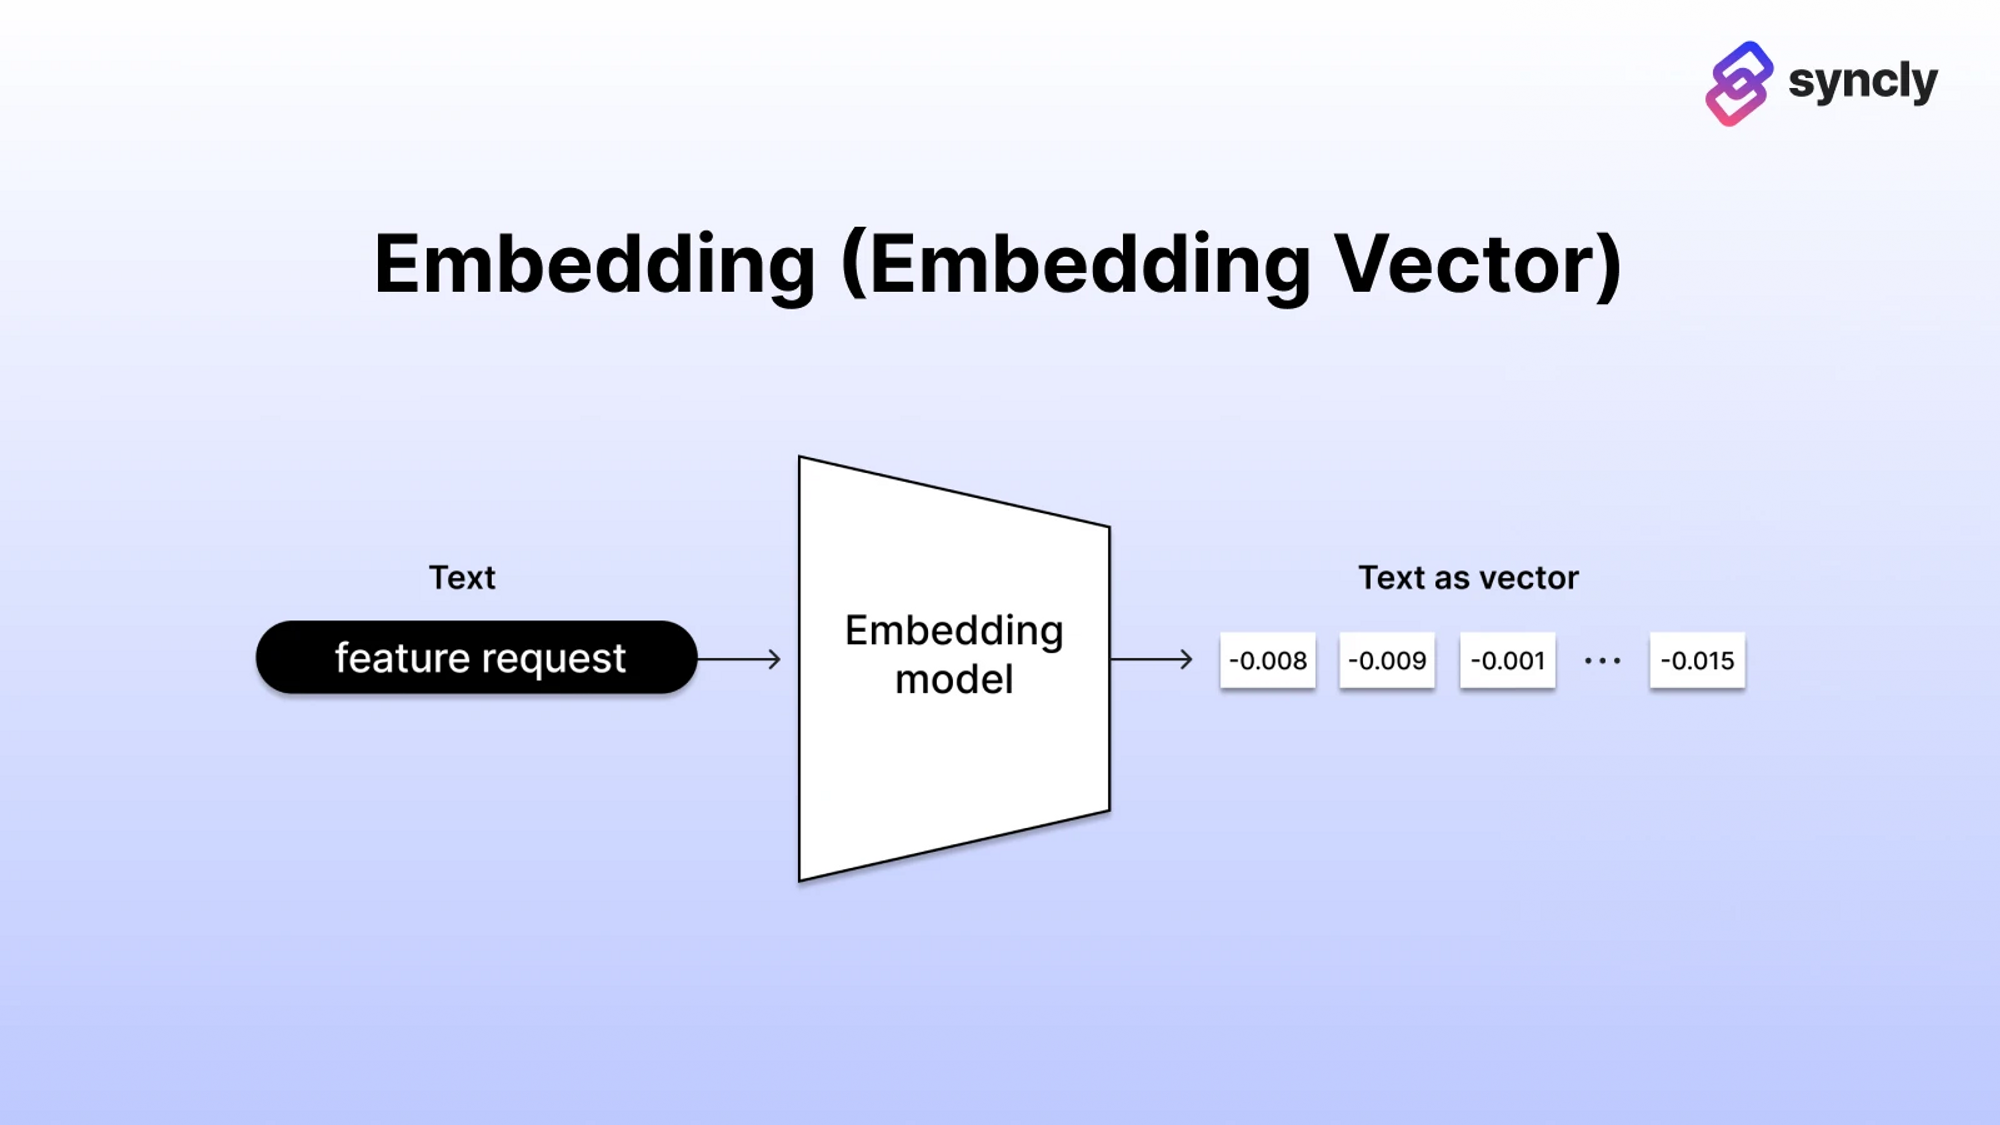
Embedding을 도식화하면 위 그림과 같은데요, Embedding(또는 embedding vector)이란, 텍스트를 실수 벡터 형태(i.e. floating point 숫자들로 구성된 고정된 크기의 배열)로 표현한 결과물을 의미합니다. 특정한 단어, 문장 혹은 문서를 embedding 생성 모델에 입력하게 되면, 일정한 수의 실수들로 구성된 벡터가 출력됩니다.
Embedding을 언제 사용해야 하는가?
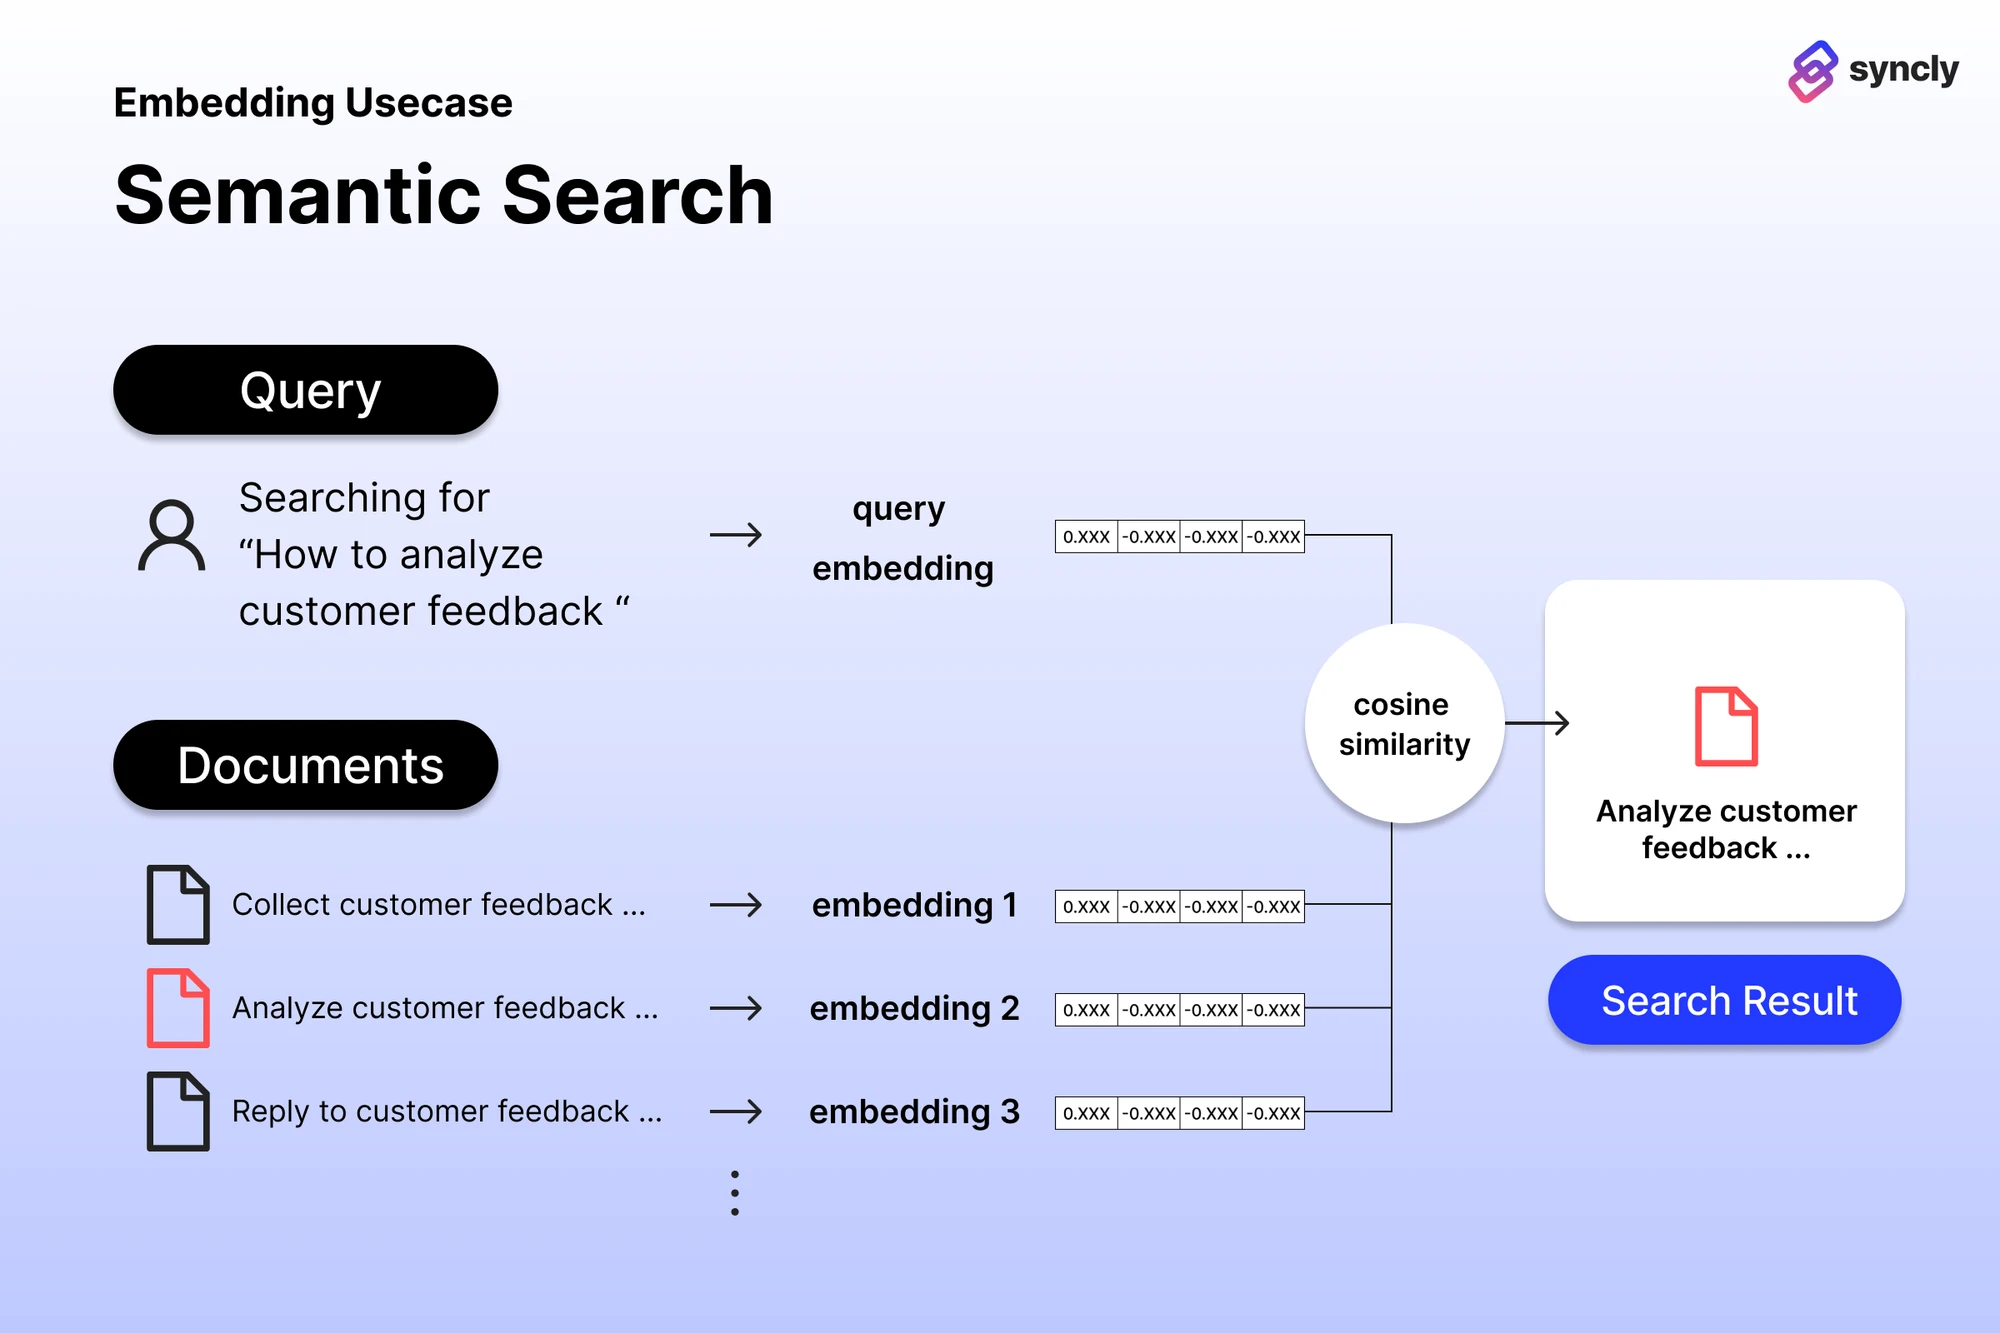
Embedding을 활용한 예시로, Semantic Search(의미 기반 검색)을 도식화하면 위와 같습니다. 사용자가 제시한 텍스트 형태의 query(검색어)와 의미적으로 연관성이 높은 문서들을 찾아서 제시해 주는 기능입니다. Embeddings를 활용한 Semantic Search 프로세스를 간략하게 정리하면 아래와 같습니다.
- 문서 모음집에 포함되어 있는 각각의 문서에 대한 embedding을 계산하여 별도의 저장소(e.g. local drive, vector database 등)에 저장해 놓음.
- Query 텍스트에 대한 embedding을 계산함.
- Query embedding과 각 문서 embedding 간의 cosine similarity(코사인 유사도)를 계산하고, 그 값을 기준으로 전체 문서들을 내림차순 정렬함.
- 정렬 결과 중 상위 k개에 해당하는 문서들의 텍스트를 불러온 뒤 이를 반환함.
Embedding을 활용한 다른 예시들은 블로그에서 더 자세하게 풀어냈습니다.

링크 : https://www.syncly.app/ko/blog/what-is-embedding-and-how-to-use
🪄 또 궁금하신 AI 관련 이야기들이 있다면, 댓글로 남겨주세요.
다음 편에서 반영해서 적어보도록 하겠습니다!
감사합니다.
AI 기반 고객 커뮤니케이션 분석 솔루션
댓글
로그인 후 댓글을 남길 수 있습니다.
덕분에 임베딩에 대해 알아가요!!
감사합니다.! 저희도 파인콘 벡터데이터 눈여겨 보고 있었는데 너무 좋은 자료 같습니다 감사합니다.!
너무 재밌게 읽고 갑니다!!
Spring님 메이커로그가 Must Reads 182에 선정 되었어요 :) https://stib.ee/19l7