초개인화 추천 AI, 7일 만에 구현하기
저는 약 7일간 검색 결과도 개인에 따라 추천되는 시스템을 구현하는 데에 시간을 썼습니다.
제작 중인 콘텐츠 큐레이션 서비스 '다이비'가 초개인화로 거듭나기 위함입니다.
당연히 저렴해야 하고 배포 가능한 형태로 AI가 활용되어야 했을 겁니다.
과연 저는 제작에 성공했을까요?
일주일의 노력 결과물을 공유합니다.
AI 추천 시스템에 이제 막 관심을 가지기 시작했다면 유용한 글이 될 것입니다.
이 글을 통해서 AI가 세상에 어떤 영향을 주고 있는지, 작동 원리, 작업 결과를 얻어가실 수 있습니다.
초개인화의 사례와 문제점
이런 주제에 관심이 있다면 아마 아실 겁니다.
요즘 AI 추천 시스템은 우리의 모든 것에 관여하고 있습니다.
디스커버리 앱에서 홈 피드 추천은 거의 기본기죠.
유튜브, 핀터레스트는 검색 결과도 취향에 맞춰 보여줍니다.
더 나아가서 넷플릭스는 영화 포스터도 취향에 맞춰 보여줍니다.
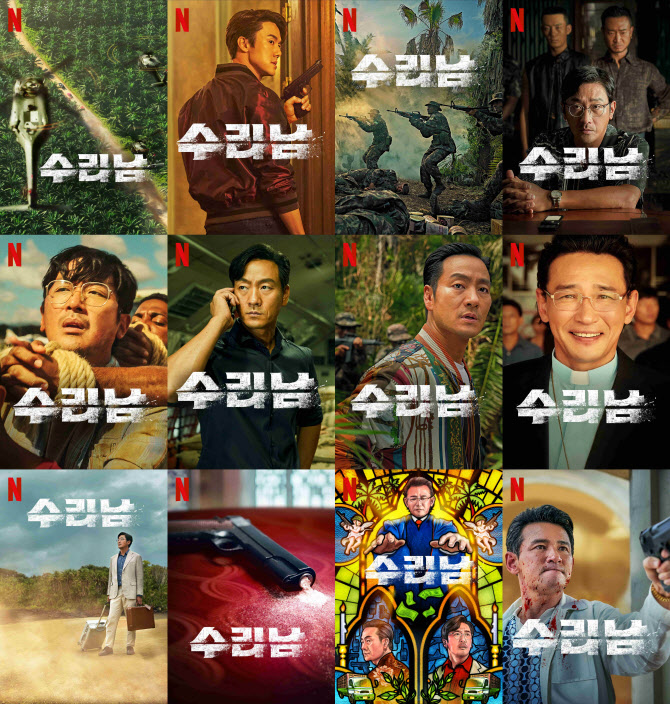
개인이 관심이 있는 정보에 더 빠르게 접근할 수 있습니다.
때로는 이런 알고리즘에 의해 시야가 좁아지기도 합니다.
그래서 추천 시스템 디톡스를 하시는 분들도 있습니다.
하지만 저희 삶에 유용한 것도 사실입니다.
이렇게 많은 개인화 기반 추천을 받아도, 여전히 저희는 스스로가 뭘 좋아하는지 잘 모릅니다.
본인이 관심이 있는 것에 대한 탐구를 더 심도 있게 해볼 필요가 있습니다.
또한, 보고 싶은 것만 보려고 하는 것은 모두의 본능 아닐까 싶습니다.
이 글도 흥미가 있는 분들만 남아서 여기까지 보셨겠죠.
이 사실은 통계로도 확인할 수 있었습니다.
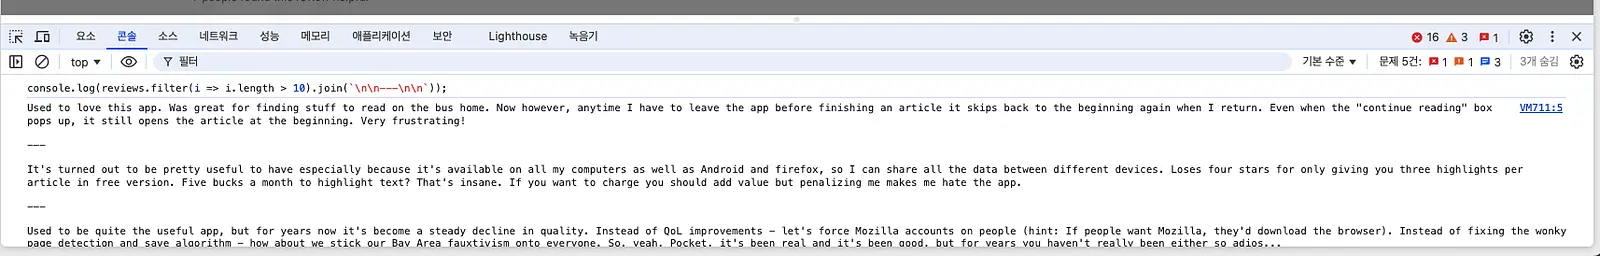
콘텐츠 큐레이션 서비스를 잘 만들기 위해 기성 큐레이션 서비스들의 앱 리뷰를 취합하여 AI에게 분석을 요청했습니다. (Google Discover, Microsoft Start, Flipboard, Pocket 등)
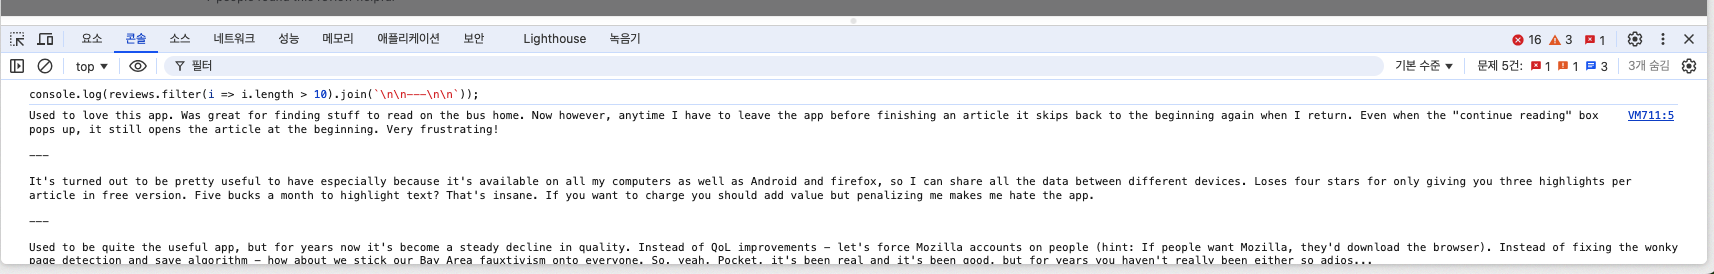
간단하게 브라우저(개발자 도구)에서 리뷰를 긁어와서 AI로 분석했습니다.
기존 큐레이션 앱들의 언급된 피드백 순위입니다.
출처가 다양해서 만족스럽다
세밀하지 못한 개인화가 불만스럽다
광고가 많아서 불만스럽다
세밀한 북마크 기능이 만족스럽다
소식이 빨라서 만족스럽다
이미 충분히 개인화 시스템이 잘 되어 있다고 느낄 수 있지만
여전히 더 높은 수준의 개인화를 원하는 피드백이 2위로 우수했습니다.
포괄적인 의미의 개인화 피드백이었습니다.
"내 정치색에 맞는 것만 보고 싶다",
"글씨 크기 / 테마 / 뷰어 바꾸고 싶다",
"관심사 관리하고 싶다",
"차단 기능 더 잘 만들어라"
이런 리뷰들을 보고 확실히 느꼈습니다.
개인화 시스템을 싫다고 하는 사람들이 많아졌지만,
일시적인 현상이 확률이 높고
초개인화의 시대가 오는 걸 막을 수 없다는 것입니다.
‘좋은 것이란 무엇인가?’에 대한 질문도 개인에 따라 다르게 적용됩니다.
물론, 어른이 없는 놀이터와 무관심한 어른만 있는 놀이터는 난장판이 되기 마련입니다.
초개인화의 시대를 올바른 방향으로 나아가야 합니다.
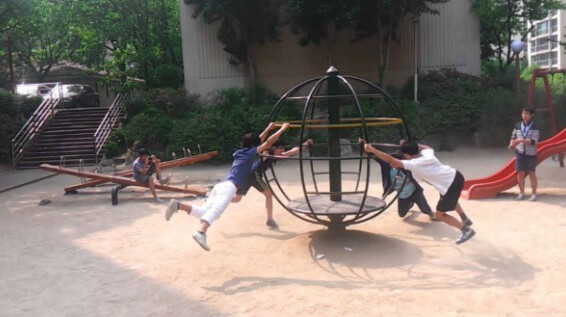
사실 AI 추천 시스템씬은 이미 난장판이기도 합니다.
우리의 관심사 탐구 활동이 조작되고 있다면 어떠신가요?
넷플릭스는 넷플릭스 오리지널을 더 우선적으로 보여줍니다.
그러면 우리는 넷플릭스 오리지널을 보게 됩니다.

내가 넷플릭스 오리지널을 좋아해서 추천을 받은 게 아니라,
넷플릭스 오리지널을 추천받았기 때문에 넷플릭스 오리지널을 좋아하게 됩니다.
무섭지 않나요?
우리는 좀 더 추천 시스템에 관심을 가지고, 올바르게 통제할 필요가 있습니다.
저도 추천 시스템을 만드는 메이커로서 의무감을 가지고 어떻게 만들 것인지와 원리를 공유합니다.
AI 추천 시스템 원리
요즘은 임베딩 기술을 많이 사용하는 편입니다. (뭔지 쉽게 알려드립니다)
저도 이번에 임베딩을 사용했고, LLM의 근본이 되는 기술입니다.
Voyage AI의 voyage-multilingual-2를 API로 사용했습니다.
클로드를 만든 걸로 유명한 앤트로픽의 파트너 회사이기도 하고, 나름 리더보드 순위도 높았습니다.
심지어 50만 토큰까지 무료입니다.
ChatGPT를 만든 OpenAI에서도 임베딩 API를 제공하지만, 훨씬 비쌉니다.
임베딩이란?
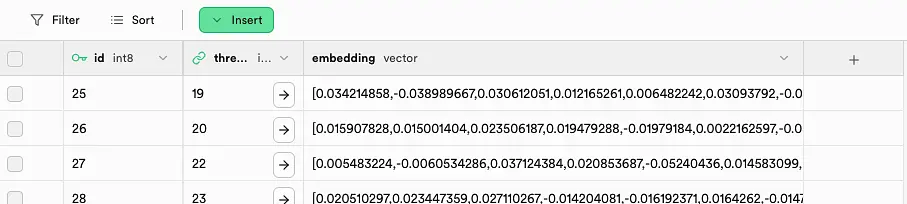
글을 숫자로 치환해서 얼마나 비슷한 숫자인지를 보는 겁니다.
누구나 이해할 수 있게 설명해 보겠습니다.
(치환 전) => (치환 후)
사과 => [1, 2, 3]
망고 => [2, 2, 3]
사과와 망고는 기본적으로 둘 다 과일이기 때문에 비슷한 숫자들이 배열로 치환됩니다.
그러나 차이는 분명 존재합니다. 예를 들어서 색이 다르기 때문에 첫 번째 배열이 다른 숫자가 됩니다.
배열을 순서대로 뜯어보면 [색, 크기, 종류] 이런 식으로 치환되는 겁니다.
반면에 '코끼리'를 치환했다면 [7, 8, 9] 이런 식으로 차이가 명확하게 발생했을 겁니다.
단어들을 전부 임베딩하여 숫자로 치환하고 가까운 숫자를 가진 것을 우선 보여주는 것이 임베딩 추천입니다.
개인이 관심을 가졌던 문장의 임베딩 평균값을 저장하여 콘텐츠 임베딩과 유사도를 분석해서 추천하면 됩니다.
우리가 흔히 아는 ChatGPT, 클로드도 대량의 텍스트를 임베딩 후 관련 문장을 답으로 출력합니다.
물론, 실제로는 엄청 디테일한 수준의 소수점으로 구분되며, 배열의 크기도 큽니다.
제가 추천드린 voyage-multilingual-2의 경우 소수점 15자리까지 표현하며, 1024개의 배열 크기로 치환해 줍니다.
비슷한 콘텐츠를 넘어서
단순히 비슷함의 여부로만 추천을 한다면, 뭔가 부족합니다.
가령 우리는 인기 있는 새것을 선호하기도 합니다.
혹은, 중독을 피해 의도적으로 덜 자극적인 걸 보려고도 합니다.
이런 것을 고려한 랭킹 알고리즘은 이미 공개된 것들이 좀 있습니다.
대표적으로 레딧, 해커뉴스 사례를 공유해 드리겠습니다.
레딧
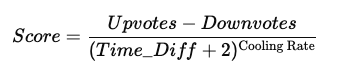
Upvotes: 좋아요 수
Downvotes: 싫어요 수
Time_Diff: 게시물이 올라온 후 경과한 시간(시간 단위)
Cooling Rate: 인기 하락 속도
많은 사람들이 선호하며 신선한 글을 보여주며, 시간의 흐름에 따라 랭킹이 급격하게 줄어듭니다.
해커뉴스
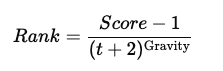
Score: 게시물에 부여된 점수(Upvotes 등으로 결정)
t: 게시물이 게시된 후 경과 시간(시간 단위)
Gravity: 시간에 따른 점수 감소를 조정하는 가중치
초기에는 점수 높으면서 신선한 걸 위주로 보여주지만, 시간이 오래된 것들끼리는 점수만 위주로 비교하여 높은 걸 보여줍니다.
추가 고려 사항
저도 두 알고리즘을 참고하여 인기도, 신선도에 대한 변수를 마련하고 감소 기준을 마련했습니다.
하지만, 제 프로덕트가 고만고만하면 쓸 이유가 없겠죠?
더 나아가 추가적으로 개인의 선호 필터와 학습된 선호도도 함께 고려했습니다.
스푼 차이 만들기
지금까지 인기도, 신선도, 개인 선호도, 학습된 선호도가 언급되었습니다.
각각 원하는 비율로 가중치를 줘서 점수를 내고 비교하면 알고리즘이 완성됩니다.
저도 비율은 경험을 더 해봐야 할 텐데 우선은 이런 비율로 짰습니다.
개인 선호도 = 학습된 선호도 > 인기도(조회, 댓글, 좋아요) > 최신도
결과물
이런 수준의 결과를 도출했습니다.
홈 피드
수동 선호 반영
방문 게시물 학습
댓글 남긴 게시물 학습 (구현 예정)
좋아한 게시물 학습
인기도 반영
신선도 반영
검색 결과
유사도 반영
개인화 반영
인기도 반영
신선도 반영
아직 댓글 기능이 없어서, 댓글 남긴 게시물을 학습하는 것 빼고 완료했습니다.
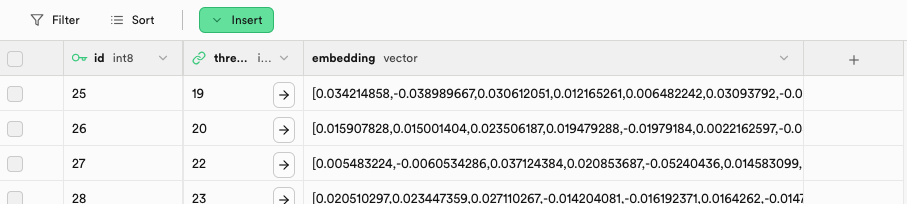
데이터베이스에 값들을 차곡차곡 쌓고 있습니다.
아직 API 수준으로만 작업이 되어 있어서 나중에 프론트엔드랑 잘 결합되면 또 공유하겠습니다!
콜드 스타트 문제
사용자가 뭘 좋아하는지 처음부터 알까요?
데이터가 없기 때문에 알 수 없습니다.
처음 1번, 2번 상호작용한 것만으로는 관심사를 추정하기에 시기상조입니다.
이것이 추천 시스템이 가진 콜드 스타트 문제입니다.
다이비는 그래서 회원만 사용이 가능합니다.
회원가입 후 관심사를 물어볼 예정입니다.
그걸 시작으로 잦은 상호작용이 발생한 주제의 콘텐츠도 함께 추천할 것입니다.
중독보다는 유용한 도구로 사용되길 바랍니다.
언제든 계정의 관심사는 직접 편집 가능하게 열어둘 것입니다.
개인이 알고리즘을 시스템과 함께 통제할 수 있도록 하는 것이 핵심입니다.
관심 있는 것에 대해 더 푹 빠져서 탐구하실 수 있는 프로덕트로 만들고 싶습니다.
과장하자면 같은 프로덕트를 쓰는 게 맞나 싶을 정도의 초개인화를 꿈꿉니다.
그래서 Dive(빠지다 + e)로 '(좋아하는) 무언가에 빠진 사람'이란 의미를 가지게 서비스명을 지었습니다.
많은 관심 부탁드립니다!
중독적이기도 하지만 잘 사용한다면, 깊은 탐구가 가능해지는 추천 알고리즘에 대해 다뤘습니다.
여러분은 어떻게 사용해야 한다고 생각하시나요?
읽어주셔서 감사합니다.
스타트업 창업, 직무 콘텐츠 모음 사이트 (곧 서비스 사라질 예정)
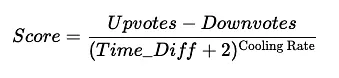
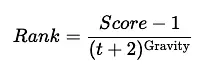
댓글
로그인 후 댓글을 남길 수 있습니다.
이런 엄청나게 유용한 글에 댓글이 없다니! >.<
좋은 글 감사히 읽었습니다!
덕분에 무플은 피했군요 ㅋㅋㅋ 읽어주셔서 감사합니다 :)
다음 글을 위해 댓글을 또 하나 달아봅니다. >.<
잘 읽었습니다. 문외한으로써 질문드려보자면, 개인화 추천이나 랭킹 알고리즘에 있어서 AI 기술의 발전이 비전공자들의 접근성을 높여주었나요? 추천 알고리즘이라는게 (품질이 좋으려면) 많은 투자와 기술보유가 선행되어야 하는줄 알고 잇었는데, 성호님 글 보니 생각이 달라져서 여쭤봅니다! :)
읽어주셔서 감사합니다 :) AI의 기술이 발전하면서 예전에는 불가능했던 다양한 것들이 가능해지고 있습니다. 특히나 오픈소스로도 다뤄지고 있고, 가격 경쟁이 심화되면서 더 좋은 AI를 더 저렴하게 누릴 수 있게 되었습니다. 이 글에 작성된 것처럼 AI를 추천 시스템으로 응용하는 것이 가능합니다. 더 저렴하게 더 높은 수준의 추천 시스템이 가능해진 거죠. (AI를 통한 추천 시스템은 AI의 성능을 따라갑니다) '예전에는 어떤 방식의 추천 시스템을 어떻게 구현할 것인가?'가 주된 질문이었고 이는 전문가만 답을 내릴 수 있었습니다. 요즘은 'AI가 제공하는 데이터를 어디에 사용할 것인가?'의 질문으로 바뀌고 있는 듯합니다. 계산기의 보급화 전후랑 비슷한 양상이지 않을까 싶습니다. 모두에게 계산할 능력이라는 게 생기니까 '무엇을 계산할 것인가?'라는 질문이 더 중요해진 것이죠. 물론 데이터베이스를 쓰거나, API 접근 등의 기초적 기술이 필요하기 때문에 아직은 전공자여야 합니다. 그러나, 전문가만 쓸 수 있던 것들이 초심자도 쓸 수 있게 되면서 간접적인 수혜를 볼 것이며, 수년 이내로 비전공자도 쓸 수 있지 않을까 기대해봅니다 :)