프로덕트

아티클

전체 보기
김준호

김준호

퍼블리 박소령 대표님 "실패를 통과하는 일" 독후감 (1)

TL;DR

  • 10년 동안 정말 고생 많으셨습니다. 특히 도망치지 않고 스스로 끝을 맺으신 점에 깊은 존경을 표합니다.

  • 또 공개하기 쉽지 않은 이야기를 나눠주셔서 감사합니다. 큰 도움이 됐습니다.

  • 많은 부분에서 배우고 공감하였지만 생각이 좀 다른 부분도 있었습니다.

  • 책에서는 리드 호프먼의 “블리츠스케일링”이 생존자 편향(Survivorship Bias)의 오류에 해당한다는 지적을 언급합니다. 저도 공감합니다. 그런데 반대로 이 책의 일부 내용은 결과 편향(Outcome Bias)적 측면, 즉 실제로는 어떤 요소가 실패에 기여한 정도가 없거나 적음에도 불구하고 실패한 결과를 설명하기 위해 그 요소를 과대하게 해석한 측면이 없지 않나 생각했습니다.

  • 대표님은 책임감이 강한 분이어서 실패를 되돌아보며 조금이라도 반성할 거리가 있는 부분은 샅샅이 뒤져 반성하신 것 같았습니다. 예를 들어 비용 통제에 소흘했던 점이나 커뮤니케이션이 원활하지 못했던 부분들을 회고하며 반성하셨습니다.

  • 하지만 스타트업은 멱의 법칙(Power Law)이 지배하는 게임이고 창업자의 시간과 에너지는 한정된 자원입니다. 스타트업 업무 중 약 20%에 해당하는 부분이 전체 성과의 80%를 만들어 낸다고 생각합니다. 일부 영역에서 실수가 있더라도 성과를 드라이브하는 영역에서 좋은 퍼포먼스를 낼 수 있다면 실수는 상쇄됩니다. 비용이나 커뮤니케이션 등도 물론 중요한 일이지만 그것들이 스타트업에서 가장 중요한 20%에 해당하는지는 의문이 있습니다. 창업자는 일부 영역이 sub-optimal한 상태란걸 인지하더라도 자신의 한정된 시간과 에너지를 핵심 20%에 집중하는 것이 맞지 않나 생각합니다.

  • 핵심이 되는 20%는 스타트업의 큰 방향성과 관련된 일들, 무엇을 어떻게 할 것인가, 어떤걸 그만하고 정리할 것인가 등에 관한 일들이라고 생각합니다. 그런 점에서 이 책에서 가장 기대됐던 부분은 PMF를 찾아 가는 과정에 대한 회고였습니다. 계몽주의 사업의 한계를 이야기하신 부분, 성공한 서비스가 건드리는 인간의 본성과 7대 죄악을 연결시키는 부분은 무척 흥미로웠습니다.

  • 하지만 이 부분에 대한 분석이 한 걸음 더 깊이 들어갔었으면 어땠을까 하는 아쉬움이 남습니다. 예를 들어 7대 죄악 중 색욕 부분에서는 온리팬즈(OnlyFans) 같은 서비스를 다루며 좀 더 깊이 분석해 보았으면 좋았을 것 같습니다. 온리팬즈의 매출액, 사용자 수, 성장률 등을 보고 있으면 머리가 어질어질해집니다. 사업이란 게 결국 사람들이 필요로 하는 것을 공급해주고 그 대가를 받는 일이라고 했을 때, ‘과연 사람들이 필요로 하는 것은 무엇인가’라는 근원적인 물음을 갖게 합니다. 이런 물음은 정답이 없는 어려운 문제지만 실제 몸으로 부딪치며 밀도 높은 경험을 하신 대표님의 이 문제에 대한 생각을 더 듣고 싶었는데 아쉬웠습니다.

  • 또 스타트업은 그 본질에 있어서 운이 차지하는 비중이 매우 큰 게임이라고 생각합니다. 가장 큰 성공을 거둔 스타트업들도 되돌아보면 큰 행운이 따랐기에 성공할 수 있었습니다. 우버는 유례를 찾기 힘든 초저금리 시대 속에서 엄청난 양의 자본을 조달할 수 있는 행운이 있었고, 퍼블리가 안타까운 결말을 맺은 데에도 갑작스런 코로나 사태와 그로 인한 벤처 자본 시장의 자금 경색이 영향을 끼쳤습니다. 만약 우버도 시장 지배력이 충분하지 않았던 상태에서 코로나 사태를 맞았다면 결과가 어떻게 됐을지 알 수 없습니다.

  • 그래서 스타트업은 될 때까지 계속해서 영리한 베팅을 해나가는 것이 중요하지 않나 생각합니다. 그리고 여러번 반복해서 베팅할 수 있으려면 창업자는 스스로를 지킬 수 있어야 합니다. 

  • 대표님은 퍼블리에서의 마지막 1년을 매우 고통스럽게 보내셨습니다. 안타까웠습니다. 물론 어려움을 겪는 스타트업의 창업자가 행복할리 만무하겠습니다만, 그래도 스스로를 지키기 위해 조금 더 이기적이셨어도 좋지 않았을까 생각했습니다. 선배 창업가에 대한 인간적인 연민 차원에서가 아니라 우리가 플레이하고 있는 이 게임의 본질 차원에서의 생각이었습니다.

  • 성공한 스타트업 중에는 한 번에 잘 된 경우도 있지만, 한 번 망했다가 두 번째에 성공한 회사들도 적지 않습니다. 그와 반대로 한참 잘 나가다가 한 번 실패한 후 영영 재기에 성공하지 못한 경우는 매우 많습니다. 이건 창업이 개인의 능력, 노력도 중요하지만 그보다도 운이 작용하는 요소가 더 크기 때문입니다. 아무리 똑똑하고 성실한 창업가라도 폭군 같은 불운 앞에선 한없이 무력한 존재일 뿐입니다. 

  • 그때 만약 창업가에게 목숨이 하나 더 있다면, 그래서 실패한 후에 한 번 더 도전할 수 있다면 성공 확률은 비약적으로 높아질 수 있습니다. 두 번째 도전을 할 수 있었던 창업자들을 보면 집이 부잣집이었던 경우가 많습니다. 그 창업가 가족의 현금과 기타 유무형의 자산이 그 분들을 보호해 주었고 두 번째 기회를 마련해준 것입니다. 

  • 두 번째 기회를 가질 수 있는 것이 창업가에게는 매우 중요하기 때문에 창업자는 스스로를 보호해야 합니다. 스스로를 보호한다는 것은 창업자의 현금과, 시간, 건강을 지키는 것을 말합니다. 퍼블리에서 마지막 1년 동안 있었던 일들, 그때 하신 작업들이 이 틀에 딱 맞는 것인지는 모르겠습니다. 그냥 일반론적으로 말했을 때 실패를 정리함에 있어서는 설사 업계에서의 평판을 좀 잃더라도 창업가는 두 번째 기회를 확보하기 위해 분투해야 된다고 생각합니다. 물론 이 모든 것의 전제는 창업자가 다시 창업을 하겠다는 의지가 있을 때의 이야기이긴 합니다.

  • 어쨌든 다시 처음으로 돌아가면, 이 모든 단상은 일이 다 끝나고 난 뒤에 현장에 없었던 참견꾼으로서의 짧은 생각일 뿐입니다. 악전고투의 치열한 현장 속에서 고뇌하며 결정을 내려오신 대표님의 그것과 무게가 같을 수 없습니다. 누구나 링 위에 올라가기 전에는 그럴싸한 계획을 갖고 있지만 일단 링에 올라가 흠씬 두들겨 맞은 다음부터가 본게임의 시작일텐데, 만약 제가 당시 현장에 있었다면 대표님이 하신 것의 절반이라도 할 수 있을까 싶습니다. 다시 한 번 진심으로 존경과 감사의 마음을 전합니다. 고생 많으셨습니다.

0. 퍼블리를 창업한 박소령 대표님의 “실패를 통과하는 일”이라는 책을 읽음. 살면서 책을 읽고 주변에 선물한 적이 3번 있는데, 토니 셰이의 “딜리버링 해피니스”, 토스 팀의 “유난한 도전” 그리고 이번이 세 번째였음. 매우 재밌고 유익했음.


1. 스타트업과 멱의 법칙

  • 레이 달리오는 “원칙”에서 효율적으로 결정하는 방법과 관련해 “80/20의 규칙을 기억하고, 핵심이 되는 20%가 무엇인지 파악하라”라고 말함(레이 달리오, “원칙”, 한빛비즈, 2018, 330쪽). 처음 이 말을 들었을 때는 잘 와닿지 않았는데 시간이 지날 수록 더 공감하게 됨. 레이 달리오가 말한 80/20 규칙은 약 80%의 결과가 약 20%의 원인으로부터 발생한다는 파레토 법칙을 말함.

  • Veritasium 유튜브 채널에서도 최근 이 주제를 다뤘는데 매우 공감함. 영상의 요지는 다음과 같음.

  • “세상에는 정규분포를 따르는 종류의 일들이 있고 반대로 멱의 법칙(Power Law)를 따르는 일들도 있음. 예를 들어 2012년 Y Combinator의 전체 수익 중 75%는 1% 미만(280개 중 2개)의 회사로부터 나옴. 반면 레스토랑 같은 사업에서는 아무리 운이 좋고 열심히 일했다고 해도 어느 하루의 매출이 1년 매출의 75%를 차지할 수는 없음. 정규분포의 법칙이 적용되는 세계에서는 일관성, 즉 꾸준히 좋은 성과를 내는 것이 중요한 반면, 멱의 법칙이 적용되는 세계에서는 결과를 예측하는 게 매우 어려운 반면 극소수의 사건이 나머지를 압도하기 때문에 영리한 베팅을 반복하는 것이(Intelligent Repeated Bet) 필요하고, 일관성보다 끈기(Persistence over Consistency)가 더 중요함.”

  • 스타트업에 투자하는 일은 80/20 규칙을 따르는게 직관적으로 이해되지만 스타트업 자체의 업무도 80/20 규칙을 따를까?

  • 스타트업의 일은 크게 1) 무엇을 어떻게 할지 고민하는 단계와 2) 결정된 사항을 실행하는 단계로 나눌 수 있음. 이미 결정된 내용을 실행하는 단계에서의 일은 정규분포를 따름. 그게 영업이 됐든 코딩이 됐든 간에 어느 정도 결과를 예측할 수 있음.

  • 그런데 무엇을 어떻게 할지 고민하는 단계에서의 일은 멱의 법칙을 따른다고 볼 수 있음. 그 단계에서의 일은 결과를 예측하는게 매우 어려운데 잘 내린 결정은 나중에 결과를 설명할 때 다른 요소들을 압도함. 성공한 스타트업들은 결국 이 결정을 탁월하게 잘 한 회사들로서 Right Time에 Right Decision을 잘 내린 회사들임.

  • 예를 들어 Windsurf는 원래 GPU 가상화 서비스를 제공하는 회사였음. 그런데 OpenAI의 Text-Davinci 같은 모델이 인기를 끌자 자신들이 제공하는 서비스가 차별점을 잃게 될 것이라고 판단했고 48시간 만에 피봇을 해 코딩 에이전트 서비스를 만들기 시작함. 지금이야 다 지나고 나니까 저 판단이 당연해 보일 수 있지만, 그 당시로서는 정보는 혼재돼 있었을 것이고 많은 것들이 불확실했을 것임. 게다가 그 피봇은 창업자 혼자 있을 때 한게 아니고 이미 직원이 8명에, 2800만 달러를 투자 받은 상태에서 내린 결정이었음. 이런 종류의 결정은 그 당시 시점에서 결과를 예측하는 것이 사실상 불가능함.

  • 그런데 Right Time에 Right Decision을 잘 내릴 수 있기 위해서는 창업자의 머릿 속이 그 의사 결정과 관련된 정보와 맥락으로 가득차 있어야 함. 맥락을 바꿔가면서 생각하는 것은 사람에게나 컴퓨터에게나 매우 부하가 큰 일이고 성능이 크게 저하됨. 그래서 나는 스타트업의 업무에도 80/20 규칙이 적용된다고 생각하고(특히 창업자의 관점에서), 창업자는 그 20%의 업무를 잘하는데 본인 자원의 80%를 쏟아야 한다고 생각함.

  • 그리고 그 20%의 일을 잘 할 수 있으면 나머지 80%에서의 부족과 실수는 상쇄될 수 있음. 우버는 한때 Toxic한 문화 때문에 큰 내홍을 겪었고, 위워크의 비용 관리는 헛웃음이 나오는 수준이었음.

  • 물론 스타트업에서 비용을 잘 통제하는 일도 중요한 업무임. 정도와 우선순위의 문제인데 너무 작은 부분까지 창업자가 관여할 필요는 없다고 생각함. 예를 들어 개발팀의 생산성은 그대로 유지하면서, 또는 생산성 감소분을 최소화하면서 최대한으로 비용을 절감하는 일은 창업자의 20% 영역이라고 보기는 어려움. 개발팀과 재무팀의 의견이 다를 것이며 개발팀 안에서도 의견이 갈릴 것임. 누구는 M1 맥북이면 충분하다고 할 것이고 누구는 최소 M3는 돼야 한다고 할 수 있음. 이런 일들에 하나씩 개입해서 판단을 내리는 것은 상당한 시간과 에너지가 드는 일인데 그 작업들로 높아지는 성공 가능성은 제한됨. 비용 문제에 있어서는 어떤 사람을 채용할 것인가 말 것인가, 해고를 할 것인가 말 것인가 정도가 20%에 포함된다고 봄.


2. 스타트업과 운

  • 우버는 오랫동안 만성적인 적자와 큰 규모의 적자폭 때문에 현금을 불태우는 기계라는 조롱을 들었음.

  • 예를 들어 뉴욕대 스턴 경영대학원의 Aswath Damodaran는 우버의 기업가치 평가 방식은 소설같은 이야기(“good tale”)이며 우버는 완전히 내러티브에 의해 움직이는 회사(“company that’s driven almost entirely by narrative”)라고 비판함. 우버를 폰지 사기라고 비판한 사람들도 많았음.

  • 한때는 이런 사람들을 현실은 모르면서 오래전 이야기나 떠들어대는 헛똑똑이들이라고 생각함.

  • 그런데 시간이 좀 더 지나고 다시 돌이켜보니 그 비판들도 충분히 일리가 있었음. 우버가 사업을 확장한 시기는 역사상 유례가 없을 정도로 VC 시장에 자금이 풍부했던 시기임. 실리콘밸리에서도 그 전까지는 그렇게 큰 자본을 조달해 막대한 적자를 보면서 사업을 영위하는 것이 애초에 불가능한 일이었음. 지금 시점에서 앞으로 30년 내에 그때같은 초저금리 시대가 다시 올까 생각해보면 회의적임.

  • 물론 그 시대였다고 해서 누구나 다 자본을 쉽게 조달한 것은 아님. 우버 창업자 TK의 탁월한 능력이 빛을 발휘한 것이었지만 아무리 TK였어도 시장 상황이 받쳐 주지 않았다면 그렇게 큰 자본을 조달할 수 없었을 것이고 우버의 성공은 지금보다 훨씬 작아지거나 실패했을 수도 있음. 

  • 빌 그로스는 테드 강연에서 스타트업이 성공하거나 실패하는데 가장 큰 영향을 끼치는 요소를 타이밍이라고 주장함. 그러면서 그 근거로 에어비엔비와 우버의 사례를 듦. 특히 에어비엔비는 경기 침체가 가장 절정이었 때 사업을 시작했고, 추가적인 소득이 절실했던 집 주인들이 여러 걱정에도 불구하고 호스팅을 시작했다고 분석함.

  • 이 분석도 상당히 공감됨. 그런데 타이밍이라는 것은 일을 시작하기 전에는 맞는 타이밍인지를 알 수가 없고 일이 끝나고 나서야 비로소 판단할 수 있기 때문에 운으로 바꿔 말해도 크게 틀리지 않음.

  • 다시 강조하지만 창업자의 역량도 매우 중요함. 위대한 창업자가 행운을 만나면 역사적인 성공을 만듦. 하지만 위대한 창업자도 운이 나쁘면 성공의 크기가 작아지거나 심지어 실패할 수도 있음. 반면 보통의 창업자도 운이 좋으면 약간의 성공을 거두기도 함. 우리가 하는 이 스타트업은 본질적으로 우연적 요소가 결과에 매우 큰 영향을 줌. 


3. 스타트업과 인간의 본성

  • 아나운서 이혜성 씨가 운영하는 유튜브 채널에 박 대표님이 나와 인간의 본성과 사업의 관계에 대해 이야기를 나누신 적이 있음. 성경에 나오는 7대 죄악과 성공한 서비스를 매칭해볼 수 있다는 이야기였는데 두 분 모두 색욕을 틴더와 연결하심. 내가 이해하는 세상과 차이가 커서 놀랐음. 내 기준에서 틴더는 그냥 건전한 교제 앱임.

  • SemRush 데이터에 따르면 2025년 한국에서 가장 많이 방문된 사이트 40개 중 12개가 포르노 사이트임.

  • OnlyFans에는 2024년 기준 약 3억 8천만명의 사용자, 460만명의 “크리에이터”가 있고, 약 10조원의 총수익과(72억 달러) 2조원의(14억 달러) 매출이 남. 크리에이터는 총수익의 80%를 가져가기 때문에 460만명의 크리에이터가 총 8조원의 매출을 올린 것임. 3억 8천만명의 사용자는 2021년 1억 9천만명에서 3년 만에 2배 성장한 것인데 이 회사는 새로 투자할 것도 별로 없기 때문에 이익의 대부분을 배당함. 소유주 Leonid Radvinsky는 2018년 이 사이트를 인수한 이래로 이미 1조 4천억원이(10억 달러) 넘는 돈을 배당으로 받아감. 놀라운 것은 이 회사의 직원 수가 단 46명임.

  • 포르노 사업을 할 것도 아닌데 포르노 서비스들에 대해 뭘 그렇게 자세히 이야기하느냐고 반문할 수 있음. 하지만 다른 분야의 사업을 하더라도 창업자가 우리의 현실을 어떻게 이해하느냐에 따라 의사 결정이 달라짐. 

  • 색욕을 건드리는 것은 노골적인 형태의 포르노만 있는 것이 아니고 다양한 방식으로 여러 서비스에 녹아 있음. 틱톡에서 인기 있는 챌린지들은 은은하게 섹스를 어필하는 것들이 많고 조회수가 가장 높은 영상 카테고리 중 하나도 소프트 포르노라고 볼 수 있는 것임. 아이돌들은 남녀를 불문하고 섹시한 옷을 많이 입으며 팬들에게 유사 연애 경험을 제공함. 일론 머스크의 xAI는 “AI companion” 서비스 “와이푸(waifu)”를 출시함.

  • 사업을 할 때 ‘세상은 어떻게 돌아가고 있고 인간은 어떤 존재인가’에 대한 창업자의 세계관이 의사 결정에 많은 영향을 끼침. 숏폼 플랫폼을 운영할 때 콘텐츠 정책은 어떻게 가져갈 것인가, 모더레이션은 어떻게 할 것이며 어떤 콘텐츠에 대해 어느 정도로 패널티를 줄 것인가 같은 의사 결정들을 내려야 함. xAI는 AI companion 같은걸 만들려고 시작한 회사가 아님. 본인들 말에 따르면 인간의 과학 발전을 가속화시키는 인공 지능을 만드는 회사라고 함(“xAI is a company working on building artificial intelligence to accelerate human scientific discovery.”). 자금도 이미 수십조원 이상 유치해서 돈도 많음. 그래도 추가로 현금을 벌어들이기 위해 와이푸 서비스를 출시함.

  • 성욕이 인간의 전부다, 돈 버는데는 포르노가 짱이다 같은 말을 하는 게 아님. 내가 하려는 말은, 현실과 밀접하게 상호작용하는 일을 하는 창업자는 ‘세상은 어떻게 돌아가며 인간은 어떤 존재인가’라는 주제에 대한 자신만의 이론을 가지고 있어야 함. 그리고 그 이론은 데이터에 기반하고 현실의 큰 부분들을 정합성 있게 설명할 수 있어야 함. 그런 점에서 창업자는 색욕 뿐 아니라 성경의 7대 죄악과 연결되는 비즈니스들에 대해 숫자와 함께 현실을 있는 그대로 보고 세상이 어떻게 돌아가는지 알고 있어야 함. 세상에 대한 이해가 현실과 데이터에 기반하지 않으면 사람들이 필요로 하는 걸 만드는게 아니고 내가 옳다고 믿는 걸 만들게됨. 박 대표님을 꼬집는게 아님. 나 자신의 실패에 대한 뼈저린 반성임.

(다음 편에서 계속)
2
0
김준호

김준호

내가 “Cursor for 로톡 변호사”를 만들며 배운 것들

1. 무엇을 만들었나

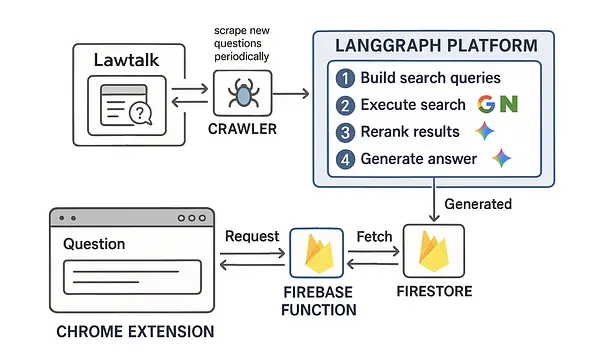
Cursor가 코드를 자동완성해 주듯이 로톡에서 변호사님들이 답변을 쓰실 때 ai가 자동으로 답변 초안을 작성해주는 크롬 익스텐션을 만들었습니다. 

크롬 익스텐션으로 만든 이유는 변호사님들이 원래 작업하던 방식 그대로 작업하시면서 동시에 ai 자동완성 기능을 통합할 수 있는 방법이 익스텐션 방식 뿐이기 때문입니다.

2. 시스템 아키텍쳐
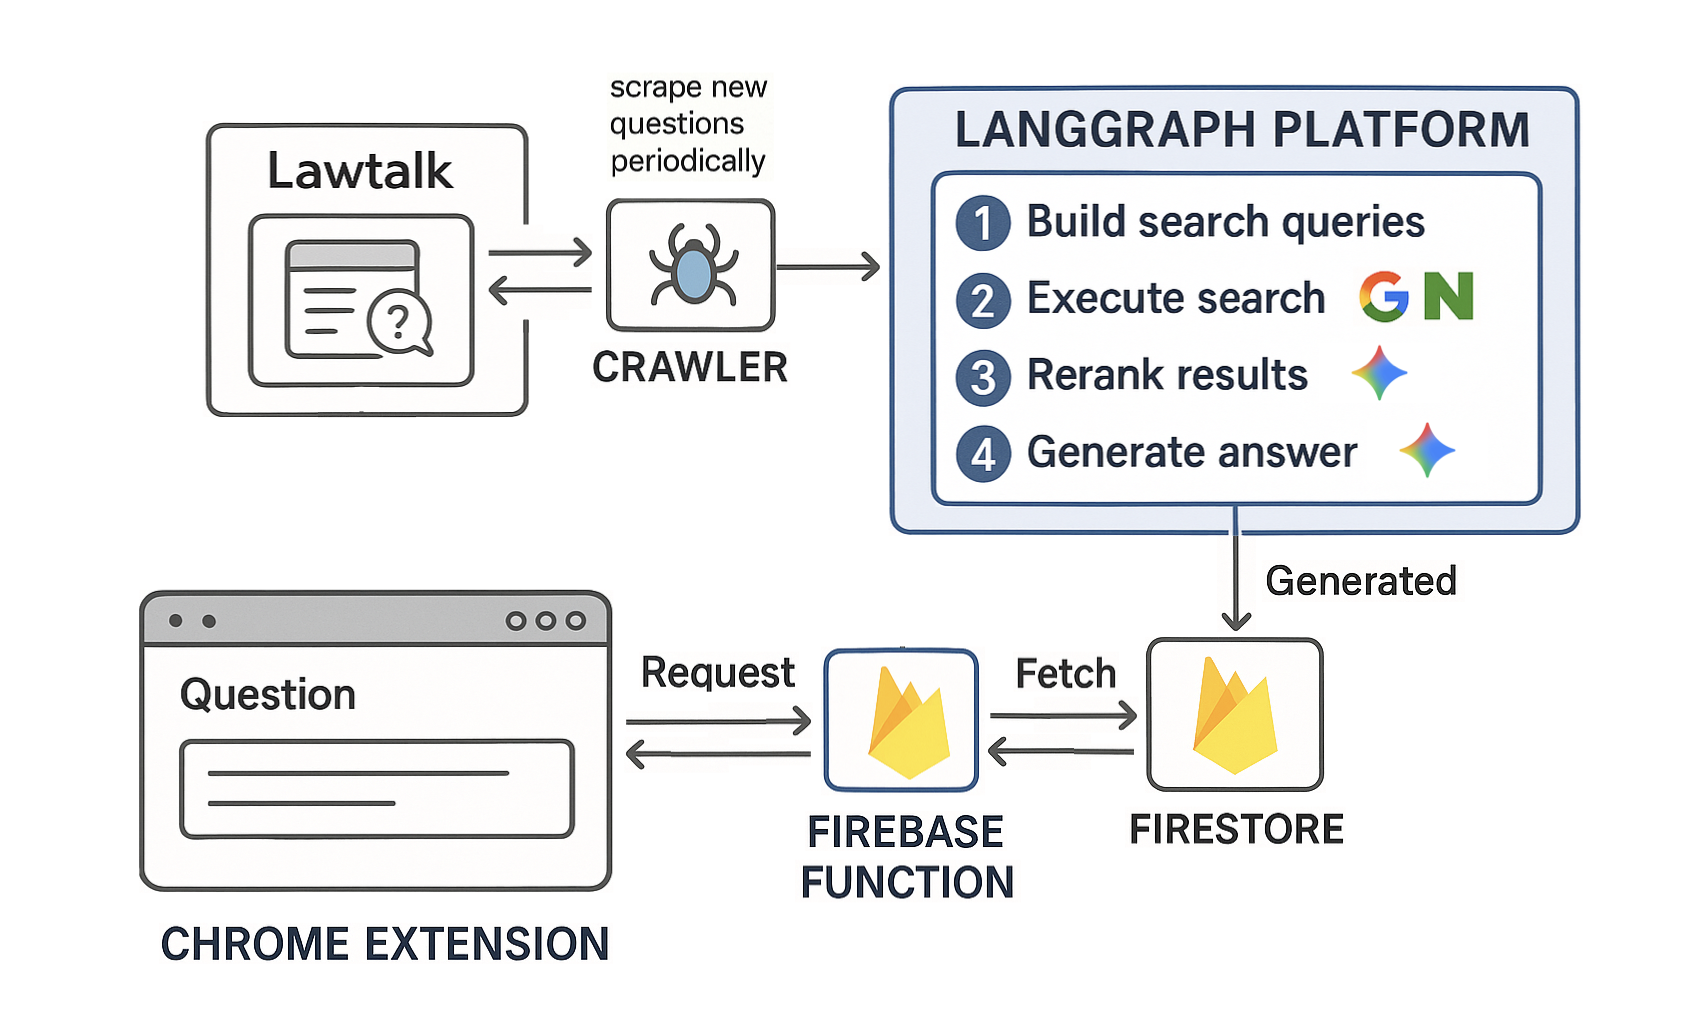
system_design.png

  • 저희 시스템을 개괄하면, 1) 로톡 질문이 주어지면 웹 검색을 하기 위한 검색어를 추출합니다. 2) 추출된 검색어로 구글, 네이버에서 검색하고 3) 검색 결과를 질문 원문과의 관련성을 기준으로 다시 한 번 정렬합니다. 4) 검색 결과중 가장 관련성이 높은 문서를 이용해 답변을 생성합니다.

  • 그래서 큰 틀에서 보면 웹 검색을 기반으로 답변을 생성하는 퍼플렉시티 등과 비슷하게 동작합니다.

  • 차이점은 1) 저희는 법률 분야에서 검색어를 더 잘 추출하기 위한 특화된 설계를 가지고 있고 2) 사용자 입력을 미리 알 수 없고 그때그때 실시간으로 답변을 생성해야 되는 퍼플렉시티 등과 달리, 로톡에서는 질문이 등록되는 시점과 변호사님이 답변을 다는 시점 사이에 시간 간격이 있고 그래서 저희는 로톡에 질문이 등록될 때 충분한 시간을 갖고 미리 질문을 분석해 놓습니다. 그래서 예를 들면 웹 검색 결과를 가지고 바로 답변을 생성하는 것이 아니라 질문과의 관련성을 기준으로 한 번 더 정렬해서 좀 더 관련성이 높은 문서로 답변을 생성합니다.

  • 법률 분야에서 검색어를 더 잘 추출하기 위해 특화된 설계는, 로톡에 올라오는 모든 질문을 커버할 수 있는 상세한 분류체계도(택소노미)를 만들고 이것을 이용해 검색어를 추출하는 것입니다. 제가 이렇게 접근한 이유는 이 문제(일반인의 법률 질의에 답변하는 것)의 본질이 질문의 법적 쟁점을 정확한 법률 개념과 용어로 정리하는 것이라고 판단하였기 때문입니다.

  • 법률 질문의 절대 다수는 이미 전에도 질문되고 답변된 것들로서 대부분 학계와 실무에서 이미 다 논의되고 정리된 이슈들입니다. 이미 다 정리가 되었기 때문에 그 정리된 자료를 찾을 수만 있으면 되는 것인데 여기서 핵심은 그렇게 정리된 문서들이 법률 용어들로 작성된 것이어서 높은 품질의 관련 문서를 찾으려면 그 용어들을 이용해 검색해야 된다는 점입니다.

  • 그리고 언어 모델은, 적어도 아직까지는, 법률 질문에서 법적 쟁점을 정확한 법률 용어로 정리하는 작업을 잘 하지 못합니다. 그 작업을 더 정확히 수행하도록 도와주기 위해서 모든 법 분야의(민법, 형법, 행정법 등) 거의 모든 주제, 쟁점을 정확한 법률 용어로 망라하는 거대한 분류체계도를 만들고 언어모델로 하여금 그 분류체계도를 참고하여 단계별로(step-by-step) 쟁점을 정리하도록 하면 훨씬 결과가 좋아진다는 것을 확인하였고 그렇게 구현하였습니다. 

  • 이렇게 어떤 문제에 특화된 장치를 만들어 문제에 접근하는 방식과 관련해서는 이것이 과연 올바른 방법인가, 여기 또 한 명의 어리석은 자가 the bitter lesson을 잊은 것인가 하는 고민이 되기도 했습니다. 이 이야기는 긴 이야기니 뒤에 따로 하겠습니다.


3. 기술 스택

  • 랭그래프: 질문을 분석하고 웹 검색을 수행하는 전체 워크플로우는 랭그래프 프레임워크를 이용해 구현하였고 랭그래프 플랫폼으로 호스팅하고 있습니다. 랭체인 모듈들을 많이 쓰고 있고 랭스미스도 이용하고 있는데 문서화가 좀 부실한 것만 빼면 꽤 만족스럽습니다. 

  • 언어모델: 구글 제미나이 2.5 플래시와 2.0 플래시를 섞어서 사용하고 있습니다. 한국어 능력에 있어서는 OpenAI 모델들보다 훨씬 성능이 좋은 듯합니다.

  • 서퍼(Serper API) & 파이어크롤(FireCrawl): 추출된 검색어로 구글 검색을 수행할 때 사용합니다. 검색 결과가 PDF 파일일 때 잘 처리를 못하는 경우가 있는등 약간 아쉬운 점이 있지만 대체로 만족스럽습니다. 네이버 검색은 네이버 검색 API를 이용하고 있습니다.

  • 구글 클라우드 스케쥴러, 클라우드 빌드: 로톡에 등록되는 질문들을 주기적으로 수집해오는데 구글 클라우드 스케쥴러와 클라우드 빌드를 이용하고 있습니다. 클라우드 빌드는 깃헙 액션 등 다른 경쟁 서비스보다 가격이 가장 저렴해서 선택했고 만족스럽게 쓰고 있습니다.

  • 파이어스토어, 파이어베이스 함수: 질문을 분석한 결과는 파이어스토어에 저장하고 파이어베이스 함수를 통해 클라이언트에 데이터를 제공합니다.

  • 프론트엔드: 크롬 익스텐션이 파이어베이스 함수에 데이터를 요청하고 파이어베이스 함수는 파이어스토어에 저장된 질문 분석 결과를 응답으로 보내줍니다.


4. 몇 가지 배운 점들

  • 개인적으로 이번 프로젝트를 통해 가장 크게 배운 점은 텍스트 데이터를 바라보는 새로운 눈을 갖게 된 점입니다. 

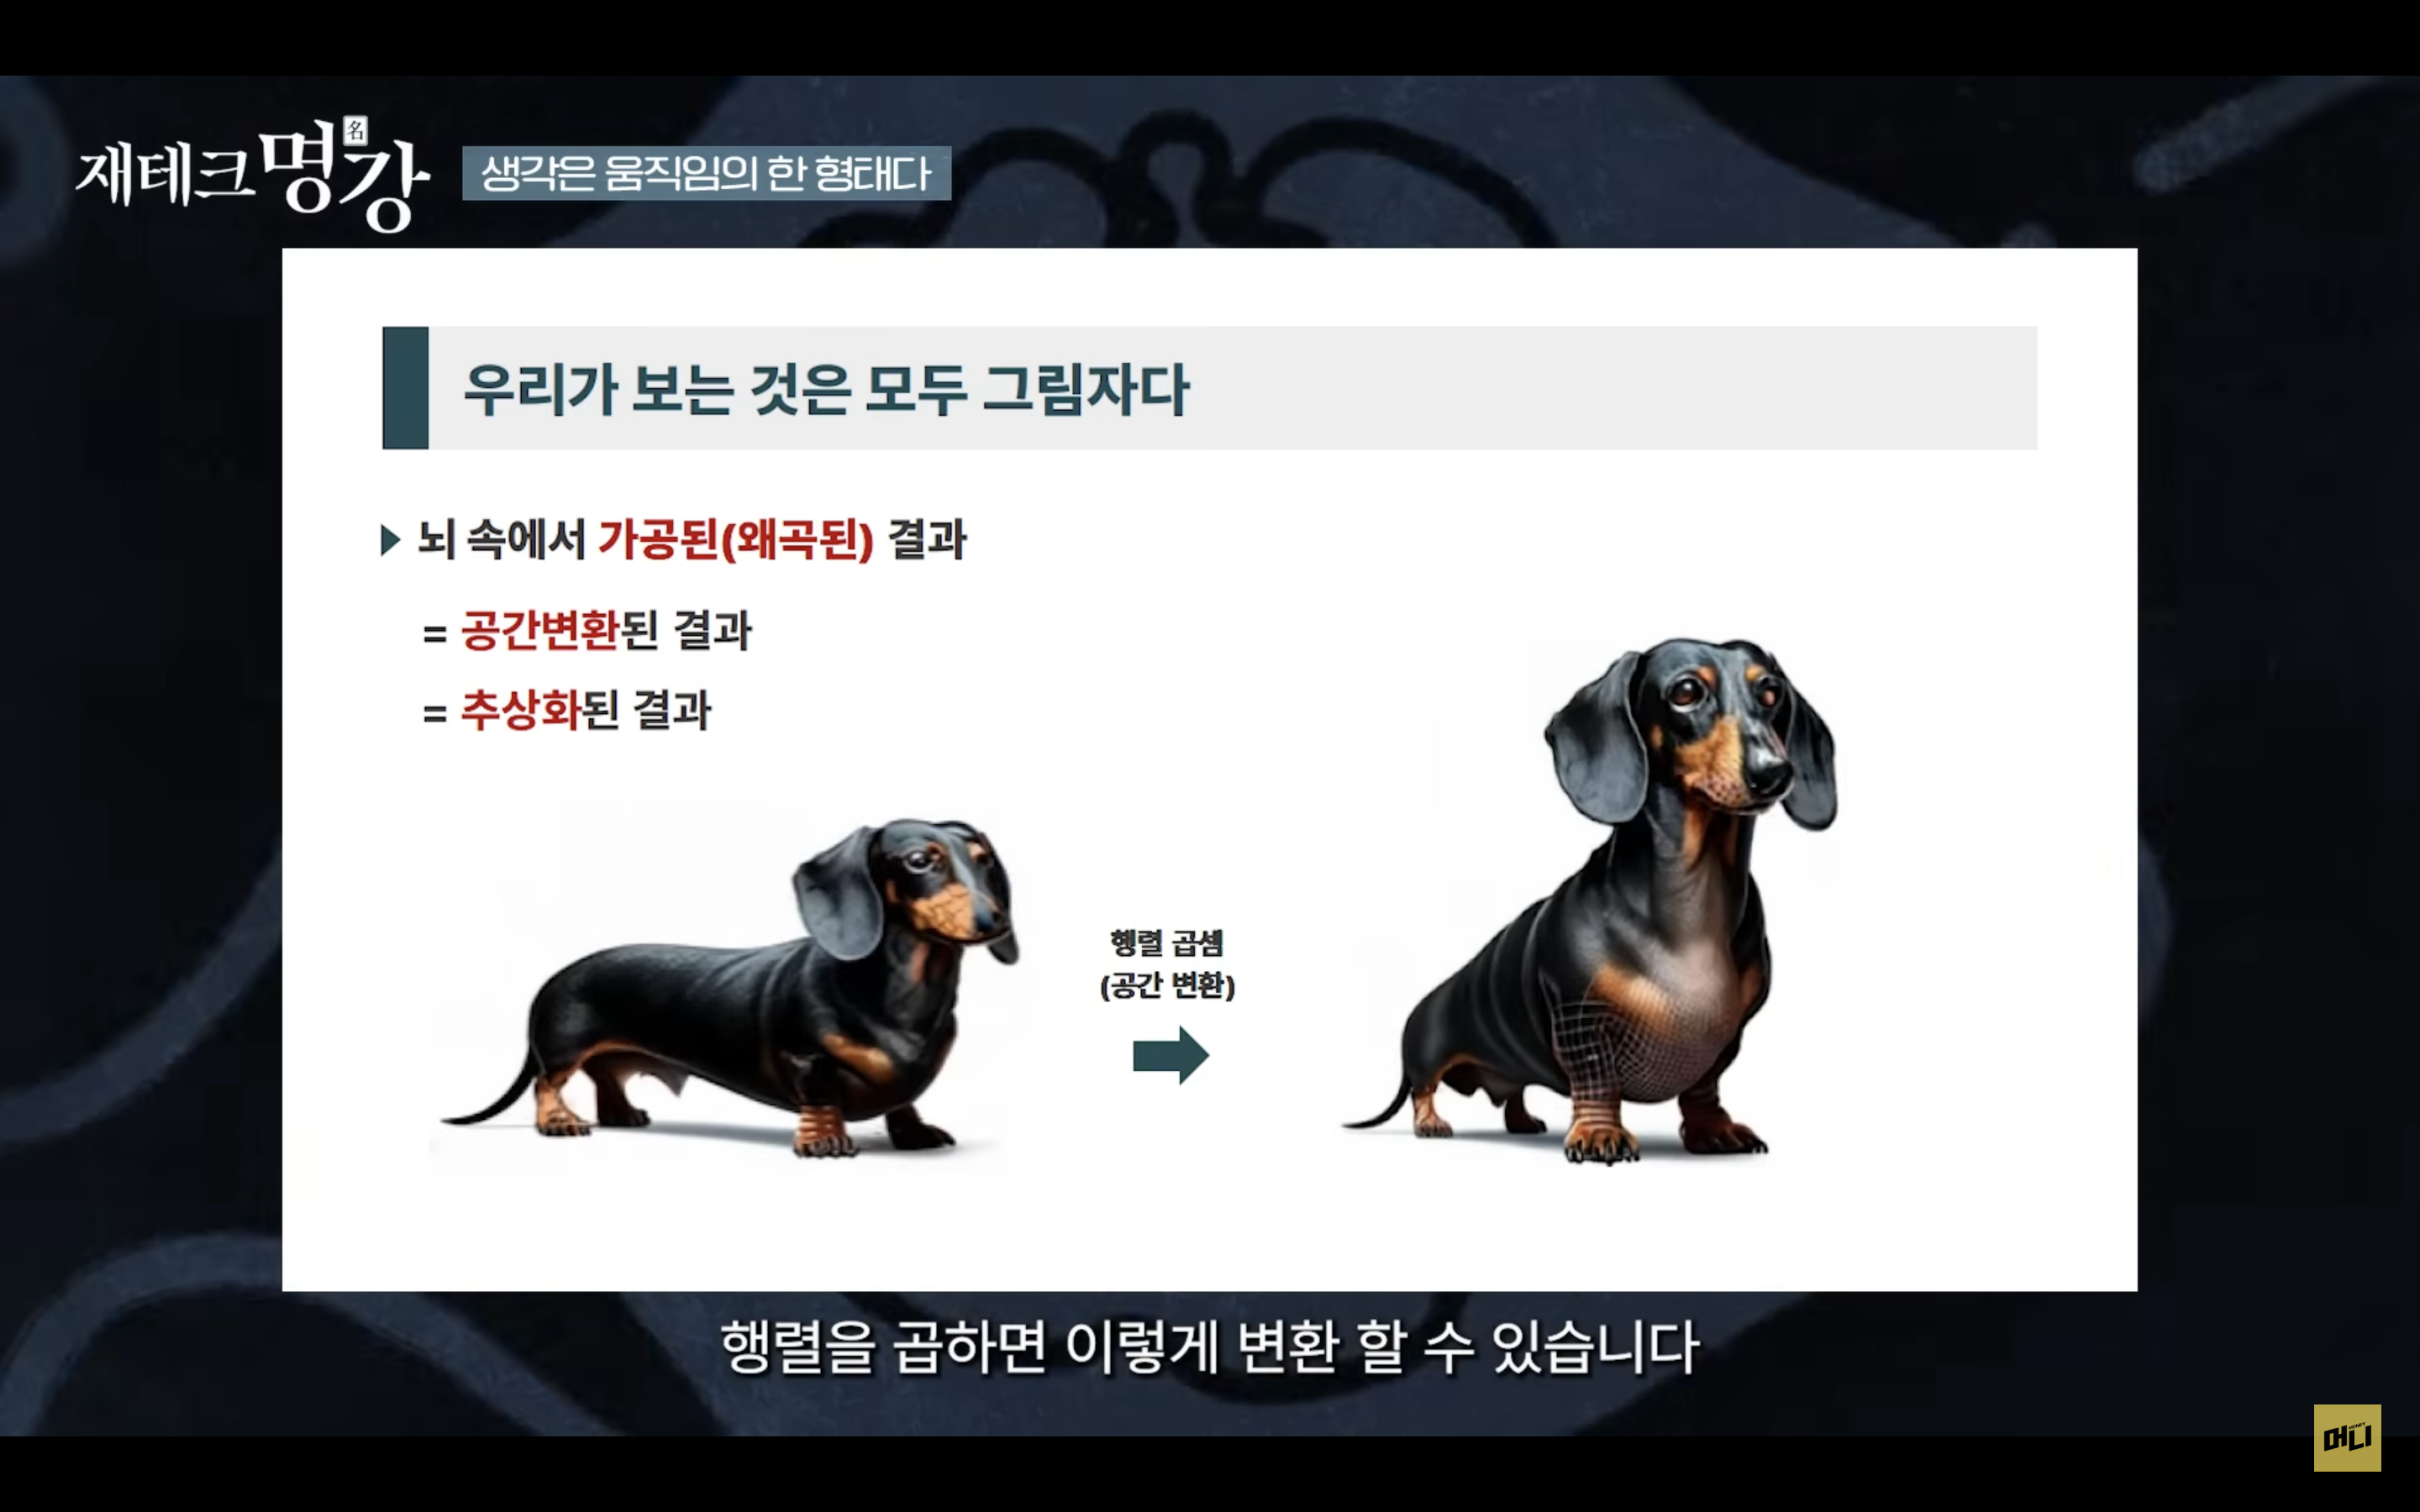
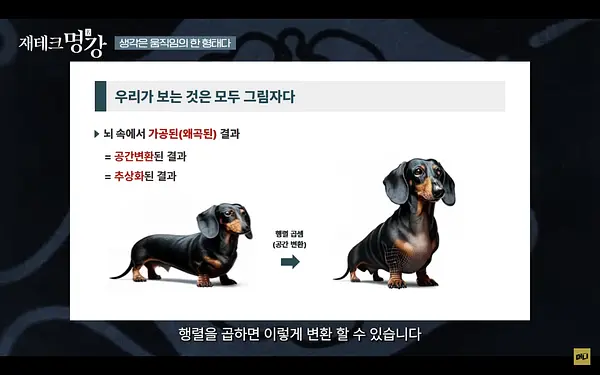
  • 아래 이미지는 문병로 교수님의 강의 중 한 장면인데요, 우리가 이미지에 행렬을 곱해서 이미지를 변형하는 것은 자연스럽게 생각합니다. 우리는 이미지를 늘릴 수도 있고, 추상화시킬 수도 있고, 캐리커쳐화 할 수도 있고, 생각할 수 있는 어떤 변형이든 자유자재로 가할 수 있습니다. 이미지에 적당한 행렬을 곱함으로써요.

    스크린샷 2025-07-12 오전 11.01.38.png

  • 그런데 가만히 생각해보면 텍스트 데이터라고 해서 다를 것이 없습니다. 텍스트 데이터도 임베딩 모델을 통해 임베딩 벡터로 변환할 수 있고, 그 임베딩 벡터에 어떤 행렬을 곱해 다른 벡터로 공간 변환을 할 수 있습니다. 벡터 공간 상의 한 점에서 다른 한 점으로 이동하는 것인데 어떤 행렬을 곱하느냐에 따라 그 변환은 텍스트를 요약하는 작업이 될 수도 있고, 질문에 답변하는 것이 될 수도 있는, 우리가 원하는 어떤 텍스트 처리 작업도 모두 수행할 수 있습니다.

  • 즉, 텍스트를 입력 받아 텍스트를 출력하는 모든 텍스트 처리 작업들이 본질적으로는 이미지에 행렬을 곱해 원하는 형태로 이미지를 변형하는 것과 같다는 사실을 알게 되었습니다.

  • 물론 아직까지 텍스트를 임베딩 벡터로 변환할 수는 있어도 임베딩 벡터를 다시 텍스트로 변환할 수는 없습니다. 하지만 텍스트를 다루는 것이 본질적으로는 하나의 공간 변환이라고 바라보게 되면서 two-tower 모델을 약간 변형한 mini two-tower 모델을 시도해볼 수 있었습니다.

  • Extreme classification과 mini two-tower 모델:

  • Q&A 데이터에서 질문에 가장 관련성이 높은 답변을 찾아내는 작업은 Extreme (multi label) classification 문제로 다루어지기도 합니다. 만약 이 작업을 사람이 수동으로 처리한다면 어떻게 할 수 있을까요? 아마도 태그를 이용하는 방식이 가장 효과적일 겁니다. 학습 데이터의 여러 특징들을 표현할 수 있는 태그 목록을 만든 다음 학습 데이터의 질문에도 태그를 붙이고 답변에도 태그를 붙입니다. 그다음 학습되지 않은 새로운 질문이 들어오면 그 질문에도 동일한 방식으로 태그를 붙이고나서 답변들 중 같은 태그가 붙은 데이터를 찾는 것입니다.

  • 그런데 이렇게 질문에 태그를 붙이는(즉, 질문을 태그로 변환하는) 것이나 답변에서 태그를 붙이는 것 모두 행렬곱, 즉 공간 변환이기 때문에 우리는 이 작업을 벡터 공간에서 수행할 수도 있고 곱할 행렬 값 역시 딥러닝 학습을 통해 찾아낼 수 있습니다.

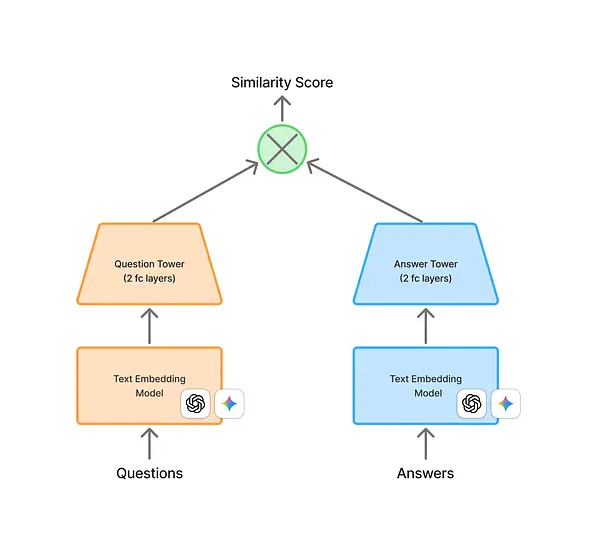
  • Two-tower 모델은 개인화된 추천 영역에서 가장 널리 사용되는 아키텍쳐입니다. Two tower는 user 타워와 candidate 타워를 말하는데 둘 다 딥러닝 방식의 임베딩 모델입니다. user 타워는 유저와 관련된 여러 정보들, 예컨대 프로필 정보, 과거 구매 이력, 시청 이력 등의 정보를 입력으로 받아 그 유저를 나타내는 임베딩 벡터를 출력하는 모델이고, candidate 타워는 그 유저와 매칭하려는 대상(예를 들어 유튜브에서는 비디오 영상이 되고 우버 이츠에서는 음식점이나 메뉴가 되는)의 여러 정보들을 입력으로 받아 마찬가지로 그 대상을 잘 표현하는 임베딩 벡터를 출력하는 모델입니다. 그리고 user 모델의 임베딩 값과 candidate 모델의 임베딩 값이 유사도가 높으면 그 대상을 해당 유저에게 추천해주는 방식입니다.

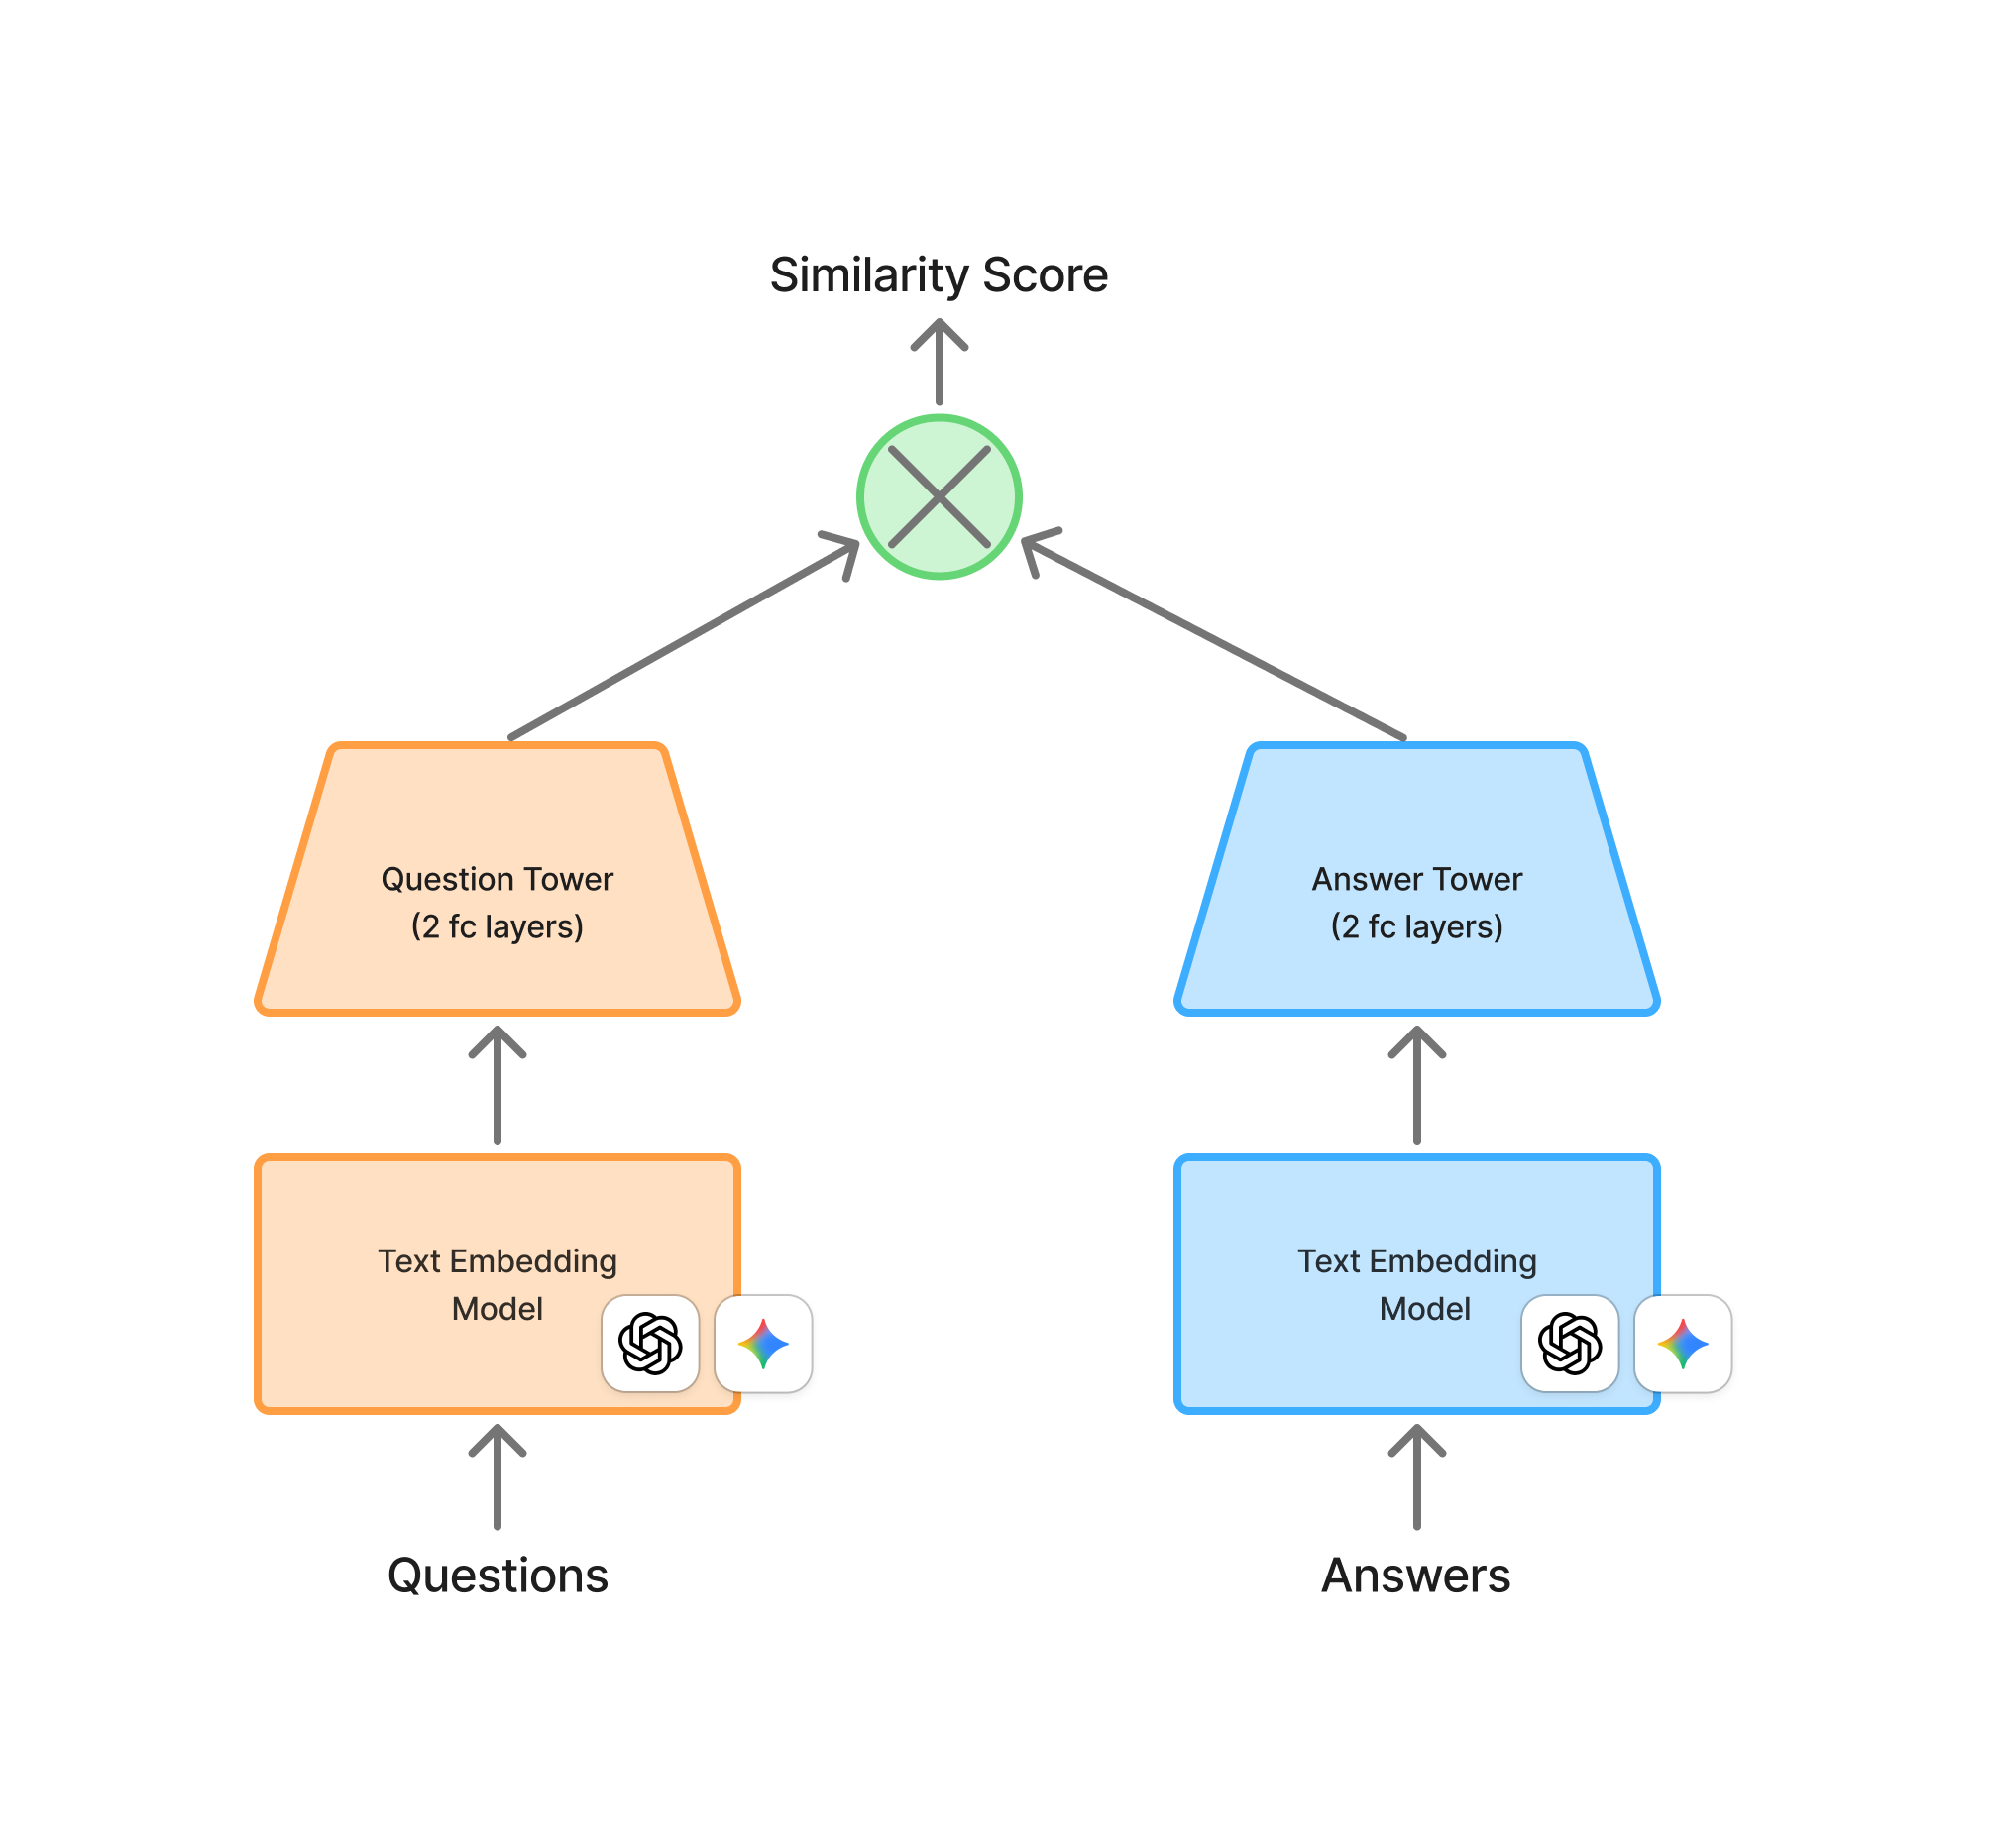
  • 제가 생각한 mini two-tower 모델은 user 모델과 candidate 모델을 바닥부터 새로 학습시키는게 아니라 OpenAI나 Gemini의 텍스트 임베딩 모델을 이용해 질문과 답변을 임베딩한 다음, 이 값을 다시 공간 변환하는 작은 모델만 새로 학습시키는 방식입니다. 텍스트 임베딩된 벡터는 이미 그 텍스트의 의미와 뉘앙스 등을 정확히 담고 있을 것이기 때문에 남은 작업은 그 텍스트를 태그로 변환하는 것 뿐이라서 그 태그 변환에 해당하는 공간 변환을 담당하는 작은 모델만을 학습시키는 접근입니다.

    Untitled.png

  • 그래서 공개된 Q&A 데이터셋을 하나 찾아서 아주 단순한 모델을 학습시켜 보았습니다. Two tower 모델을 Q&A 데이터에 적용할 때는 질문을 user로, 답변을 candidate로 보고 새로운 질문이 들어왔을 때 답변 데이터 중 그 질문과 가장 관련성이 높은 답변을 찾는 문제로 적용합니다. 저의 mini two-tower 모델에서는 질문 타워와 답변 타워 모두 임베딩을 입력으로 받아서 임베딩을 출력하는 모델들로서, 유효한 질-답 쌍(즉, 실제 질문과 답변 쌍)에 대해서는 두 모델의 임베딩 출력값들의 유사도가 높도록 하고, 유효하지 않은 질-답 쌍에(즉, 질문과 엉뚱한 답변 쌍) 대해서는 두 임베딩 출력값의 유사도가 낮도록 학습 목표를 설정하였습니다. 모델의 내부 구조는 아주 단순하게 두 개의 fully-connected layer로 구성하여 학습시켜 보았습니다. 

  • 하지만 아쉽게도 학습 결과는 좋지 못했습니다. 5 epoch 정도가 되면 overfitting이 계속 발생했고 그래서 모델 구조를 바꿔보거나 학습률을 조정해보았는데 결과는 달라지지 않았습니다. 제가 내린 잠정적인 결론은 텍스트 임베딩 모델의 성능이 충분히 좋지 못해서, 그래서 제가 학습시키는 모델들의 입장에서는 입력 데이터들이 충분히 깨끗하지 않아서 잘 학습되지 않는다고 정리했습니다.

  • 그래서 결국 저는 질문을 태그로 변환하는 작업, 다른 말로 하면 질문에서 법적 쟁점을 추출하여 정확한 법률 용어로 정리하는 작업을 벡터 공간에서 수행하는게 아니라 언어 모델과 분류체계도를 이용해 (토큰 공간에서) 수행하는 것으로 방향을 바꿨습니다.

  • 노면 유도선과 생각의 길:

    스크린샷 2025-07-21 오전 11.50.03.png 이미지 출처

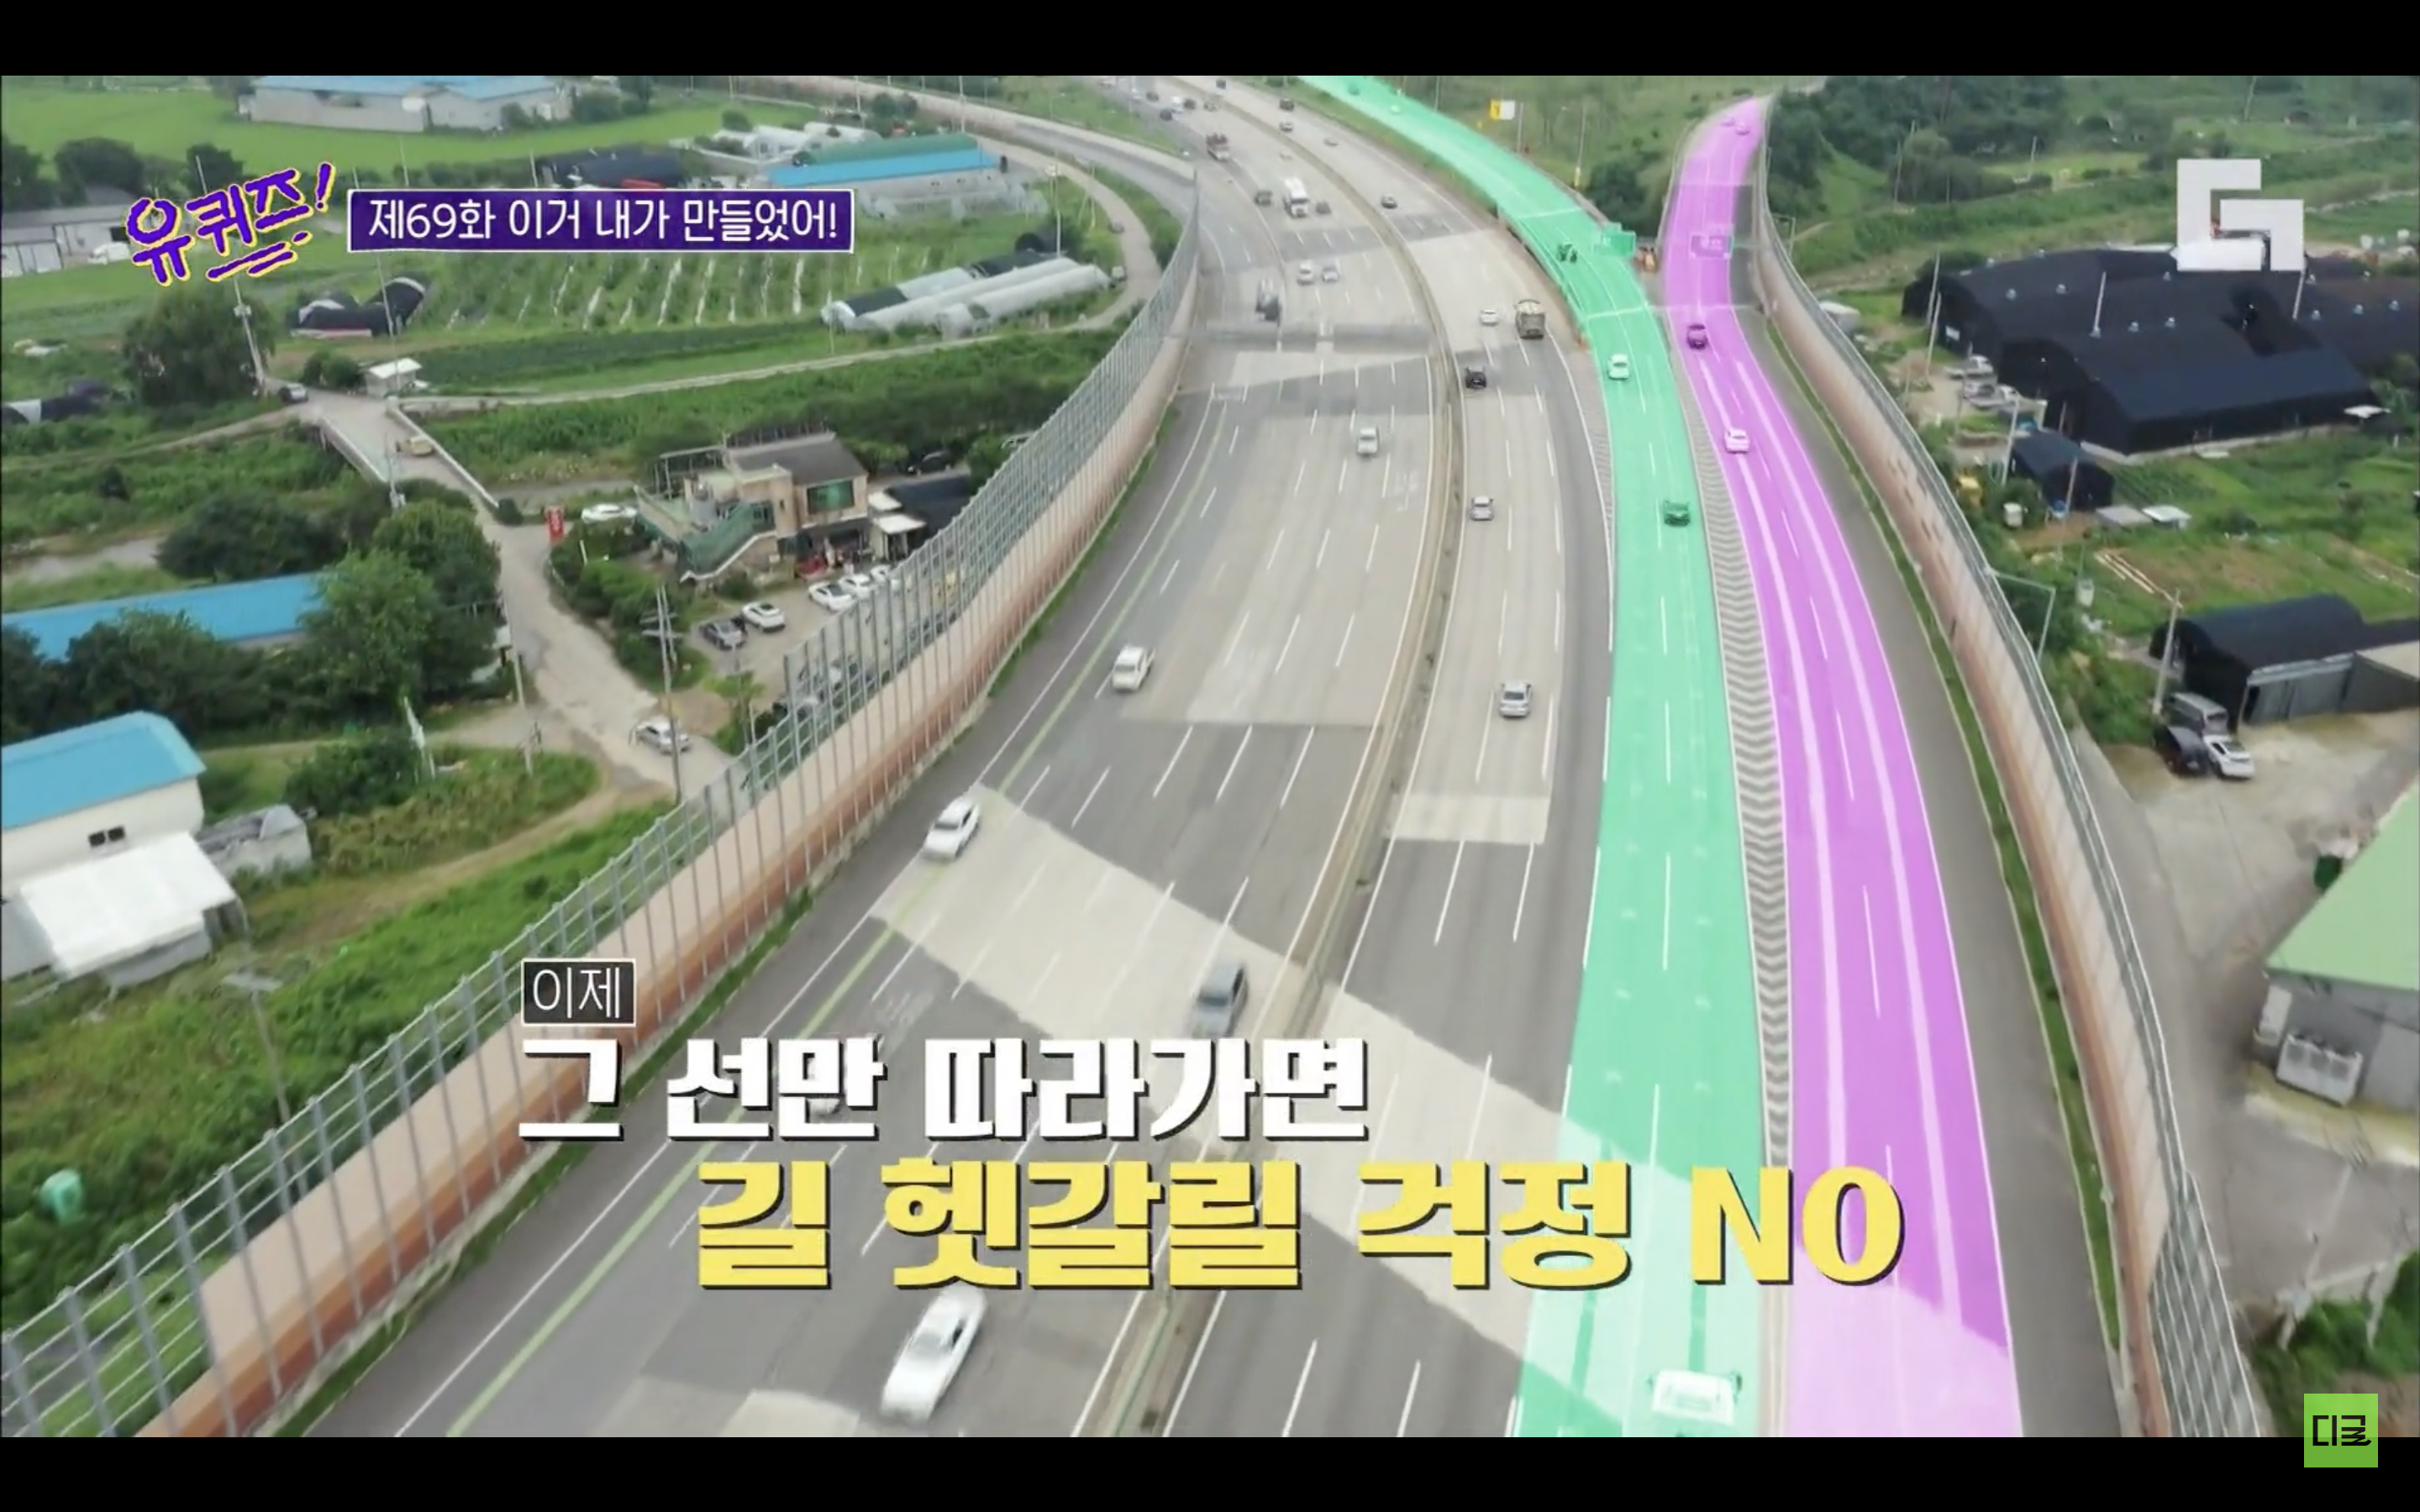
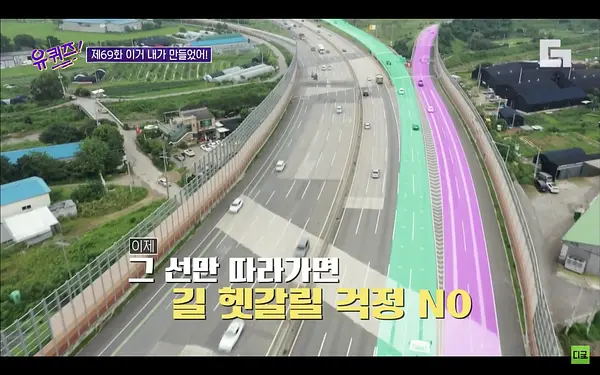
  • 이제는 언어 모델들의 성능이 매우 좋아져서, 특히 작년 말부터 등장한 추론(reasoning) 모델들의 성능은 정말 뛰어나서 웬만한 법률 질문에도 꽤 그럴싸한 답변을 만들어냅니다. 그리고 잘 대답하지 못하는 문제에 대해서도 정말 그 내용을 몰라서 답변을 못한것인지, 아니면 정답의 내용은 알고 있지만 제시된 문제를 풀어나가는 방향을 잘못 선택해서 그런 것인지를 확인해보면 후자인 경우가 대부분입니다. 즉, 최신 언어 모델들은 방대한 사전 학습 과정을 거치면서 웬만한 내용에 대해서는 전부 다 학습을 하였고 그 내용들을 이미 알고는 있습니다. 언어 모델이 약한 부분, 아직까지 잘 하지 못해서 도움이 필요한 부분은 어떤 문제를 풀어갈 때 방대한 탐색 공간 중에서 문제 해결을 위한 올바른 방향을 잘 선택해나가야 하는 부분입니다. 지금 언어 모델이 종종 잘못된 답을 내놓는 것은 너무 많은 그럴 듯한 길 속에서 쉽게 잘못된 길을 택하기 때문입니다.

  • 그런 측면에서 분류체계도를 만들고 언어 모델로 하여금 그것을 참고하여 추론하게 하는 것은 마치 우리가 운전을 할 때 노면 유도선을 따라 길을 헷갈리지 않고 목적지로 갈 수 있듯이, 언어 모델로 하여금 방대한 탐색 공간을 모두 탐색하지 않고 생각의 길이 나아갈 방향을 인도해 주는 것과 같습니다. 언어 모델은 방대한 지식과 함께 논리적인 사고 능력도 갖추고 있기 때문에 생각을 전개해나갈 방향만 잘 잡아준다면 꽤 괜찮은 어시스턴트의 역할을 수행해낼 수 있습니다. 그리고 일반인들의 법률 상담 문제는 정답이 없는 열린 문제가 아닌 닫힌 문제이기 때문에 이런 접근이 유효할 수 있습니다.

  • The Bitter Lesson에 관하여: 

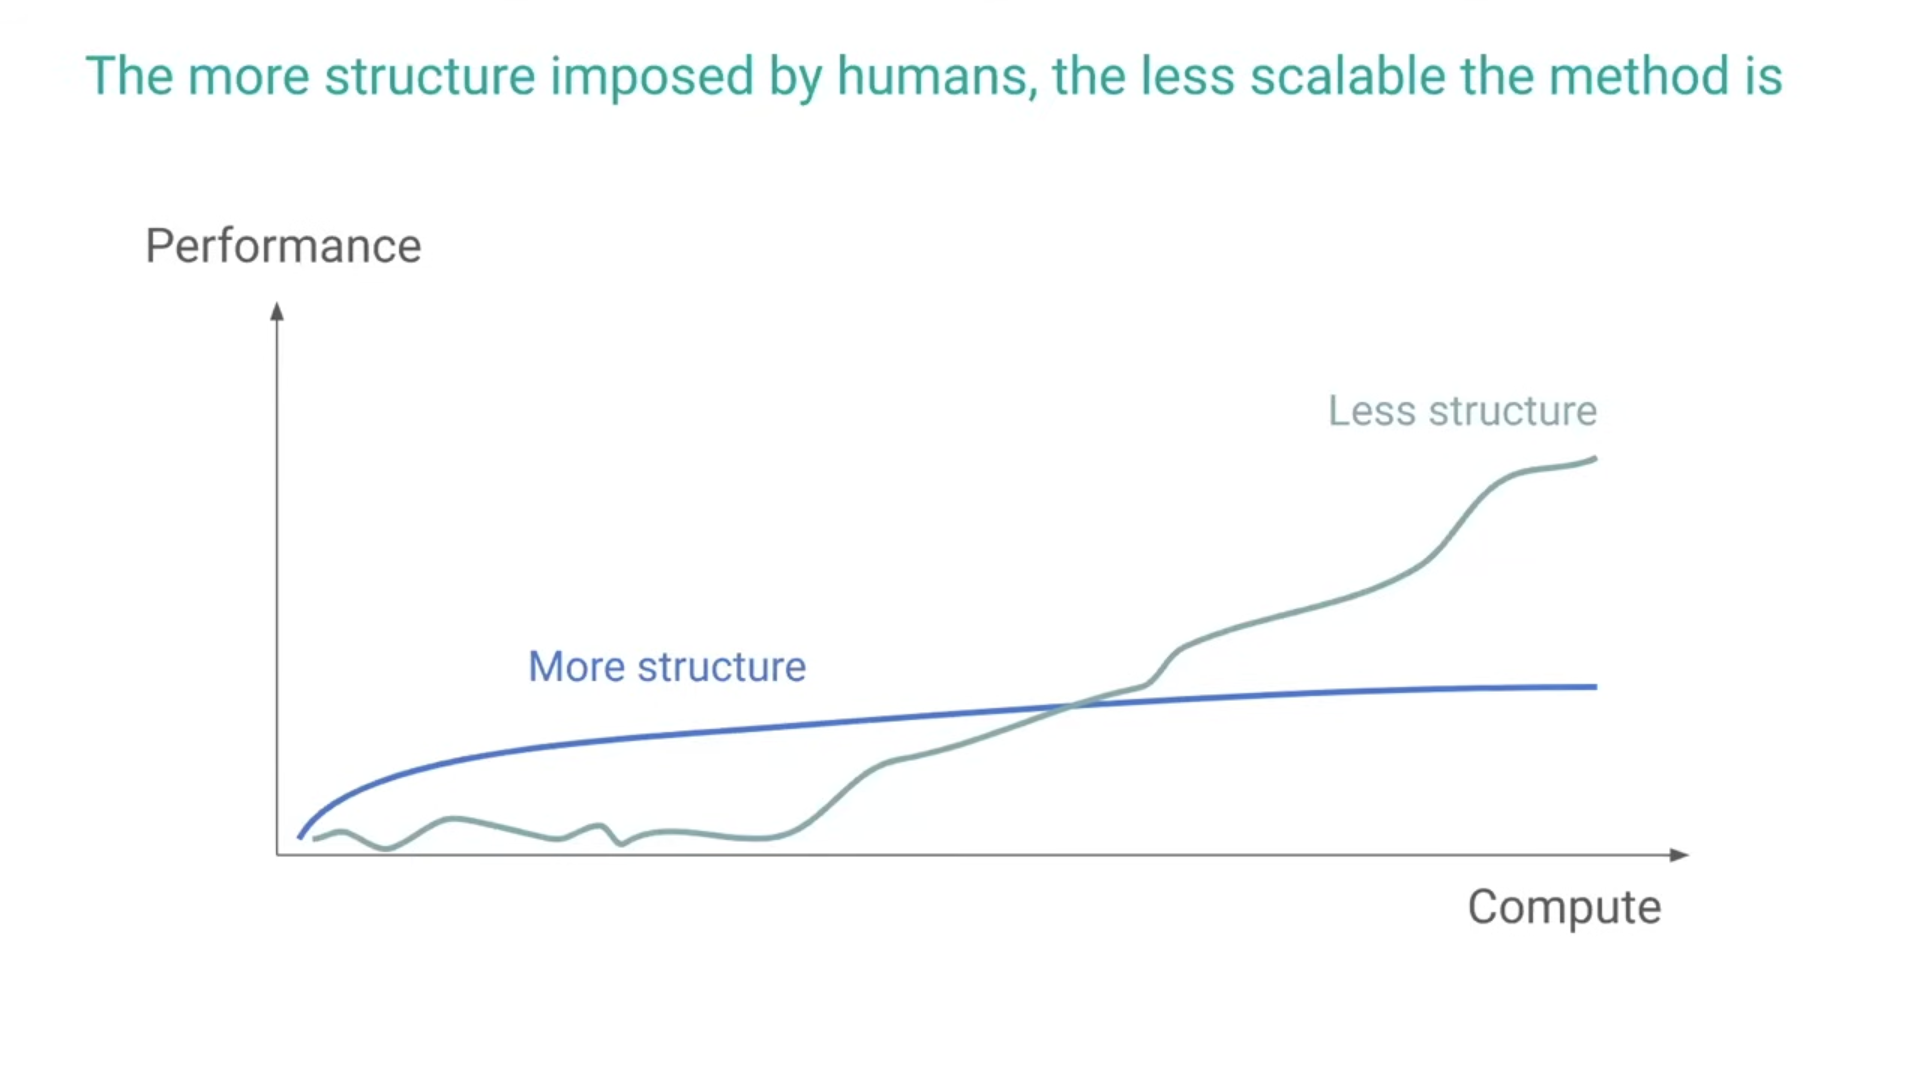
  • 그런데 이렇게 사람의 지식을 이용해 문제에 접근하는 방법은 단기적으로는 좋은 성과를 낼 수 있어도 장기적으로는 좋은 결과를 만들기 어렵다는 Richard S. Sutton 교수님의 “the bitter lesson”을 접하게 되면서 이 방법에 대해 다시 고민하게 되었습니다(아래 이미지는 OpenAIMeta 정형원 박사님 강의 중 한 슬라이드입니다).

    스크린샷 2025-07-16 오후 7.03.35.png

  • 이와 관련하여 여러 고민들을 했지만 저의 결론은 1) 연구의 영역과 비즈니스의 영역은 다르다. 2) 인간의 지식을 활용하여 성능을 향상시키는 것과 연산량을 때려 박아 일반적인 방법으로(특정 문제에 특화된 방법이 아닌 방법으로) 문제를 해결하는 것이 반드시 상충되는 것은 아니다 라고 정리하였습니다. 

  • 검증 가능한 정답이 있는 수학이나 코딩 같은 분야에서는 test time computation을 늘리는 추론 모델들이 등장하여 모델의 성능을 상당히 향상시켰지만, 그렇지 않은 분야에서는 여전히 늘어난 computation을 어떻게 활용할 수 있을지 아직까지 확실하지 않습니다. 법률 분야는 수학이나 코딩과 달리 검증 가능한 정답이 있는 분야라고 보기 어렵습니다.

  • 혹자는 변호사시험의 객관식 문제들은 정답이 있으니 그 데이터를 이용해 법률 분야에 특화된 추론 모델을 학습시킬 수 있지 않을까 생각할 수 있지만 커스텀한 추론 모델을 학습시키는데 적당한 학습 데이터는 수학 문제나 스도쿠처럼 더 오래 생각하는 것이 문제를 푸는데 실제로 도움이 되는 성질의 문제들이어야 합니다. Noam Brown이 예시로 들었던 것처럼 부탄의 수도가 어디인지 같은 문제에 있어서는 더 오래 생각한다고 해서 문제를 푸는데 별 도움이 되지 않습니다. 제가 생각하기에 변호사시험의 객관식 문제들은 그것과 마찬가지로 10초 안에 정답이 생각나지 않으면 10분을 생각해도 정답을 찾아내기 어려운 문제들입니다.

  • 이건 연구의 영역이긴 합니다만 만약 법률 분야에서 커스텀한 추론 모델을 학습시킨다면 어떤 데이터로 학습시켜볼 수 있을까 고민해보았습니다. 한 가지 아이디어는 법률 서적에서 문장들을 추출해낸 다음 언어 모델에게 추출한 문장과 책의 목차를 주면서 이 문장이 목차 중 어느 섹션에서 가져온 문장인지를 추론하게 하는 방식을 시도해볼 수 있지 않을까 생각합니다. 이렇게 학습 목표를 설정하면 1) 명확한 정답이 있는 문제가 되고 2) 충분히 많은 학습 데이터, 책 한권에서도 수천, 수만개의 학습 데이터를 확보할 수 있습니다. 이렇게 학습된 모델을 모든 법률 관련된 문제를 푸는데 바로 쓸 수는 없겠지만, 어떤 텍스트가 우리 법체계 중 어느 영역에 관련된 텍스트인지를 판단하는 일은 꽤 정확히 해낼 수 있을 것이고, 그 정보는 정확한 답변을 생성하는데 상당히 유용하게 사용될 수 있을 것입니다.

5. 트러블 슈팅

  • 이번 프로젝트를 하면서 겪었던 가장 큰 트러블은 랭체인의 ChatGoogleGenerativeAI 클래스를 이용해 structured output을 생성할 때 자꾸 오류가 발생한 일입니다. 더 구체적으로는 출력 구조에 배열이 포함돼있을 때 문제가 발생했는데 랭체인 깃헙에도 관련된 이슈들이 좀 등록이 돼있었습니다.

  • 디버깅해본 결과 정확한 문제의 원인은 응답 청크를 스트리밍으로 받을 때, 문제가 발생하는 경우들에서는 구글이 마지막에 빈 청크를 한 번 더 보내고 있었고 랭체인 ChatGoogleGenerativeAI 클래스는 그런 경우를 제대로 처리하지 못하게 설계되어 있었습니다. 마지막에 빈 청크를 더 보내는 구글이 잘못한 것인지, 빈 청크가 오면 제대로 처리를 못하는 랭체인의 오류인지 까지는 확인하지 못했습니다.

  • 저는 랭체인 BaseChatModel을 상속하는 커스텀한 ChatModel 클래스를 만들어서 마지막에 빈 청크가 오는 경우에도 잘 처리되도록 구현하여 문제를 해결하였습니다.


6. 크게 도움된 자료들

  • 이번 프로젝트를 진행하면서 개인적으로는 머신 러닝을 많이 공부했는데 저에게 특히 도움이 많이 되었던 자료들을 몇 가지 공유합니다.

  • 서울대 데이터 사이언스 대학원 이준석 교수님 유튜브 채널: 실제 수업에서 사용하신 강의 자료와 실제 강의를 유튜브로 공유해주시는데, L1, L2 정규화 같은 머신 러닝의 기초적인 내용부터 트랜스포머의 구조에 대한 상세한 설명까지 여러 영상에서 큰 도움을 받았습니다.

  • Algorithmic Simplicity: 특히 CNN에 대해 다룬 영상이 크게 도움됐는데 CNN이 왜 그렇게 잘 동작했는지, 나아가 트랜스포머가 등장하기 전에는 왜 사람들이 RNN으로 텍스트 데이터를 처리하려고 했는지 이해할 수 있게 되었고 덕분에 트랜스포머에 대해서도 더 깊이 있게 이해할 수 있게 되었습니다.

  • Welch Labs: 이 채널에도 재밌고 유익한 영상들이 많은데 개인적으로는 Mechanistic Interpretability를 다룬 영상에서 특히 많이 배웠습니다.

5
0
김준호

김준호

아이디어 피드백 요청: 유튜브에 나온 (여행) 장소 검색 서비스

안녕하세요,

제가 사이드 프로젝트로 시작해보려는 아이디어가 하나 생겼는데 한 번 읽어보시고 피드백을 주신다면 대단히 감사하겠습니다. 피드백도 받고 아이디어를 몇 주 숙성시켰다가 현재 작업 중인 메인 프로젝트가 끝나면 한 번 작업해볼 계획입니다.

  • 한 줄 정의

    • 유튜브에 나온 (여행) 장소들을 검색하고, 목록을 만들고, 공유할 수 있는 서비스

  • 어떤 문제를 해결하나?

    • 일본 여행할 때 풀어봤어X 님이(일본의 유명 건축물들을 스토리텔링 방식으로 소개해주는 채널) 소개한 장소들을 가보고 싶은데 그러려면 영상을 다시 돌려보면서 장소들을 직접 정리해야 됨.

    • 장소들을 일정 조건으로, 예를 들어 지역 별로(도쿄, 나고야 등) 건축가 별로, 건물 용도 별로(대학교 건물인지, 미술관인지 등) 필터링해서 보고 싶은데 쉽게 할 수 있는 방법이 없음.

  • (이 서비스가 없는) 지금은 사람들이 이 문제를 어떻게 풀고 있나

    • 각자가 유튜브 영상을 다시 보면서 구글맵 등에 일일이 등록하거나 수기로 정리하고 있을 것

  • 배경 및 동기

    • 내가 좋아하는 풀어봤어X 님이나 그 구독자들에게 내가 어떤 가치를 더해줄 수 있을까 고민

    • 댓글들을 봤더니 일본 여행 갔을 때 영상에서 소개된 장소들을 쭉 둘러보고 싶다, 실제로 방문해 봤다는 댓글들이 좀 있었음.

    • 또 개인적으로는 이 채널에서 다뤄진 장소뿐 아니라 채널에서 언급된 유명 건축가들의 일본 내 다른 건축물들도 구경해보고 싶음. 근데 이때는 그냥 위치 좌표만 찍어주는 걸로는 부족하고 그 장소에 대한 스토리텔링이 추가되면 좋겠음. => 이 부분은 이제 인공지능으로 아주 쉽고 빠르게 가능할듯

    • 풀봤X도 앞으로 구독자 50만, 100만 채널로 성장할 듯한데(현재는 6만) 이 분이 성장할 때 필요한 부분을 채워주면서 같이 성장하고 싶다.

  • 아이디어 초안

    • nomads.com에서처럼 영상에 등장한 장소들을 하나의 아이템으로 해서 1) free text 검색, 필터링 등을 할 수 있고, 2) 특정 아이템들을 모아 콜렉션을 만들 수 있는 사이트

  • 구글맵 리스트에 비해서는 어떤 가치를 더 주는가

    • 고민되는 부분. 굳이 별도의 서비스를 따로 만들지 않아도 구글맵의 리스트 기능을 이용해 장소들을 담고 공유할 수 있음.

    • 리스트 안에서의 필터링 등은 구글맵으로 어렵겠지만 핵심적인 차별점이 될 수 있을지 고민

  • 확장성에 대한 고민

    • 어떤 유튜브 채널에서 다룬 장소들을 한 곳에서 쉽게 찾아볼 수 있고, 목록을 만들 수 있고, 공유할 수 있고 하는 것들은 풀봤X 채널에만 한정되는 것은 아님. 예를 들면 아융그 채널도 그런 니즈가 있을 수 있고 더 넓게 보면 빠니보틀, 곽튜브 등도 마찬가지.

    • 실제로 아융그 채널을 검색하면 연관 검색어로 지역명들이 뜸. 사람들이 여행 준비할 때, 또는 여행 가서 많이 검색을 하는듯.

    • 그런데 이런 장소들을 매번 관리자가 등록하는 것은 확장성이 떨어짐.

  • 서비스가 주는 가치의 성격에 대한 고민

    • 유틸리티적 성격만 있는 것 보다는 팬심과 덕질의 요소가 가미되면 좋겠음. 예를 들어 이 사이트에 등록돼 있는 장소들을 가지고 여행기를(또는 여행 계획) 만들고 공유할 수 있다면(e.g. Wanderlog 같은), 각 유튜브 채널의 팬들은 자기가 좋아하는 채널의 영상들을 이 서비스 내의 여행기로 재구성해볼 수 있고(방문한 곳들, 이동편 등 정리) 본인이 여행 갈 때 참고할 수도 있음.

4
6
김준호

김준호

나홀로소송 서비스 개발기 (3) - proof of concept 개발

TL;DR

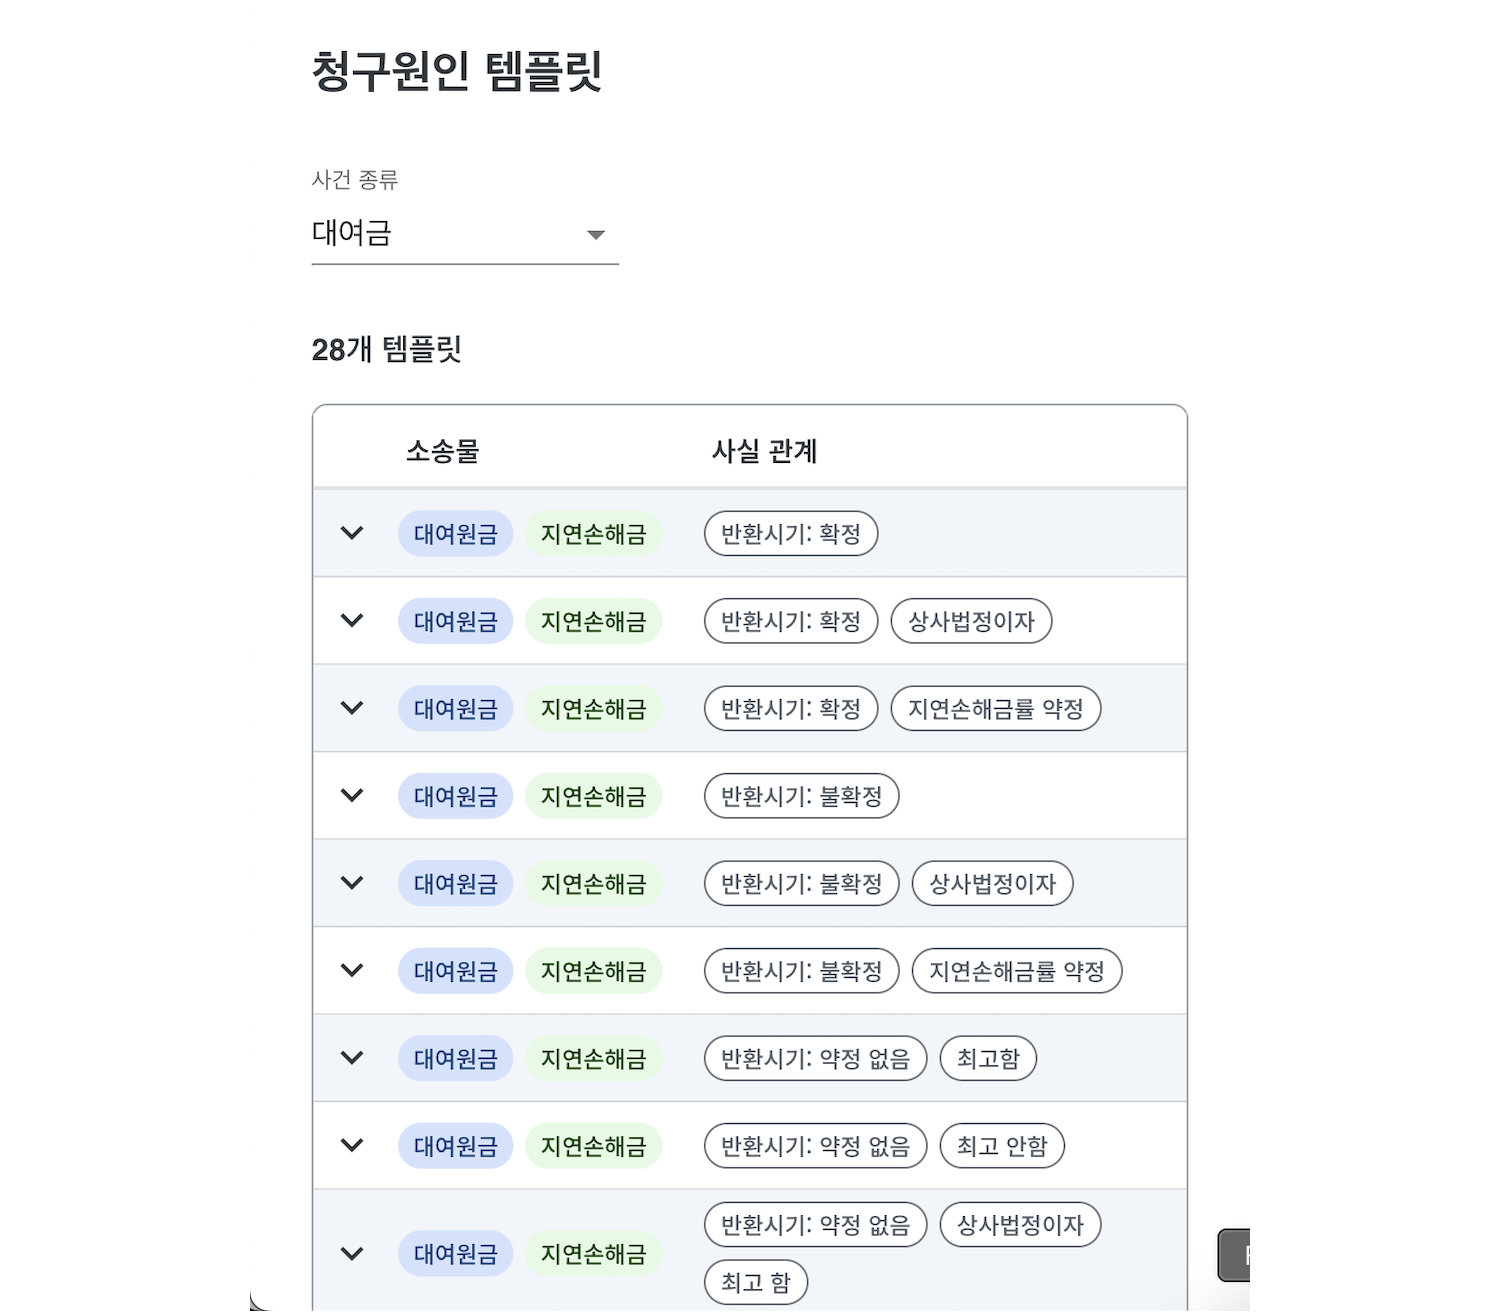
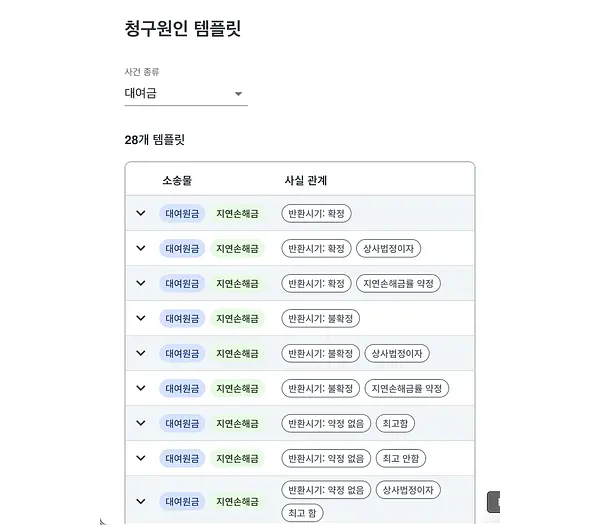
앞의 글에서 제시한 아이디어를 구체적으로 구현해 보았습니다. 처음부터 모든 종류의 사건을 다룰 수는 없어서 우선 대여금 사건에 대해 사용자 UI를 개발하였고 요건사실론에 따라 청구원인 템플릿을 28개로 구분하였습니다. 사용자가 UI를 통해 정보를 입력하면 그에 맞는 청구취지가 자동으로 완성되고 청구원인은 템플릿과 언어모델로 작성되는 proof of concept를 개발하였습니다. botoai.co/compose 에서 직접 사용해보실 수 있고 28개 템플릿은 botoai.co/admin 에서 확인하실 수 있습니다. 이제 본격적으로 변호사님을 찾아나설 계획입니다.

(이 글은 제가 나홀로소송의 문제를 다룬 시리즈 중 네번째 글입니다. 첫번째 글은 여기서 보실 수 있습니다.)

0. Proof of Concept 개발

이전 글에서 제시한 아이디어를 구체적으로 어떻게 구현할 것인지에 대해 POC(Proof of Concept)를 개발하였습니다. POC를 통해 검증한 내용들은 아래와 같습니다.

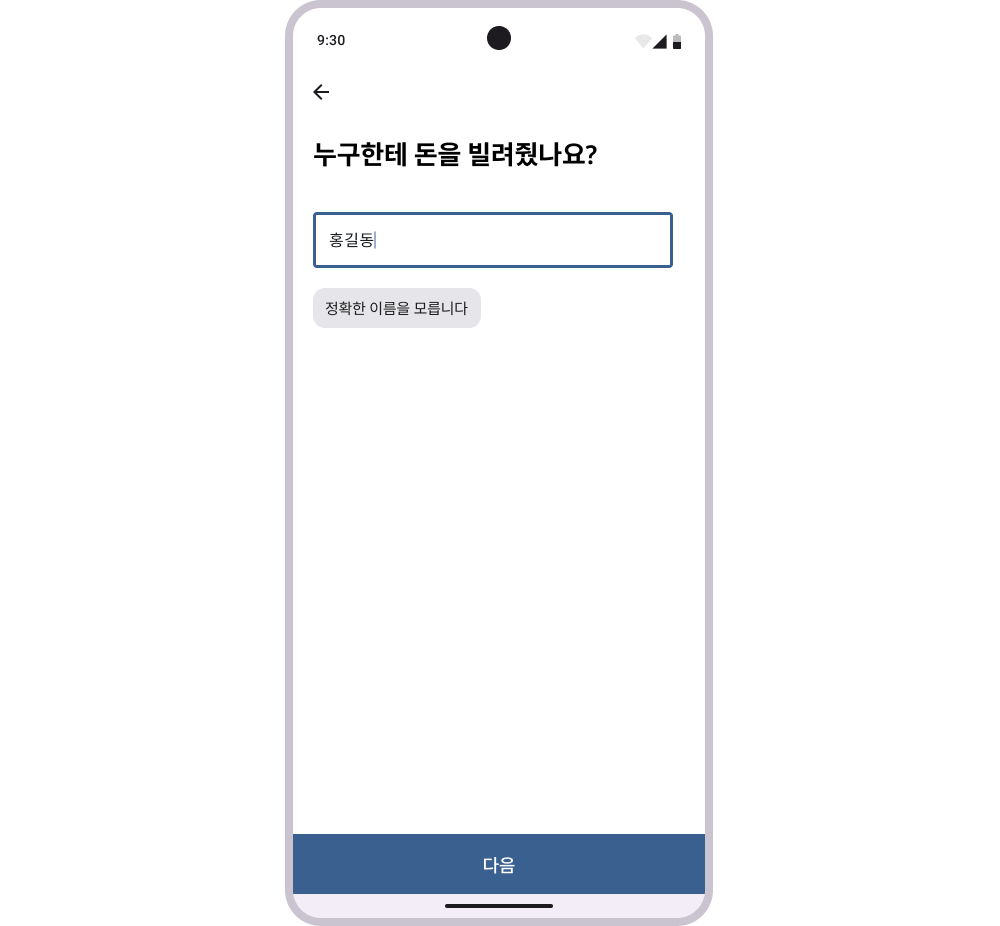
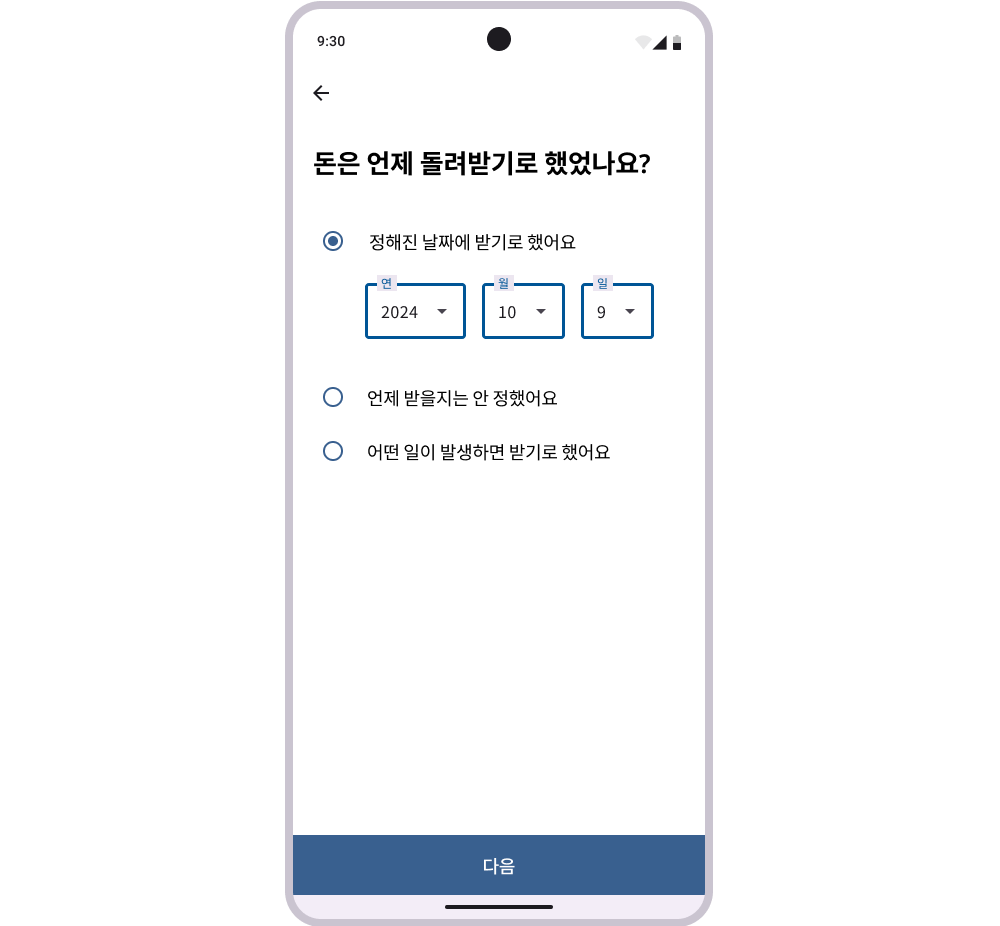
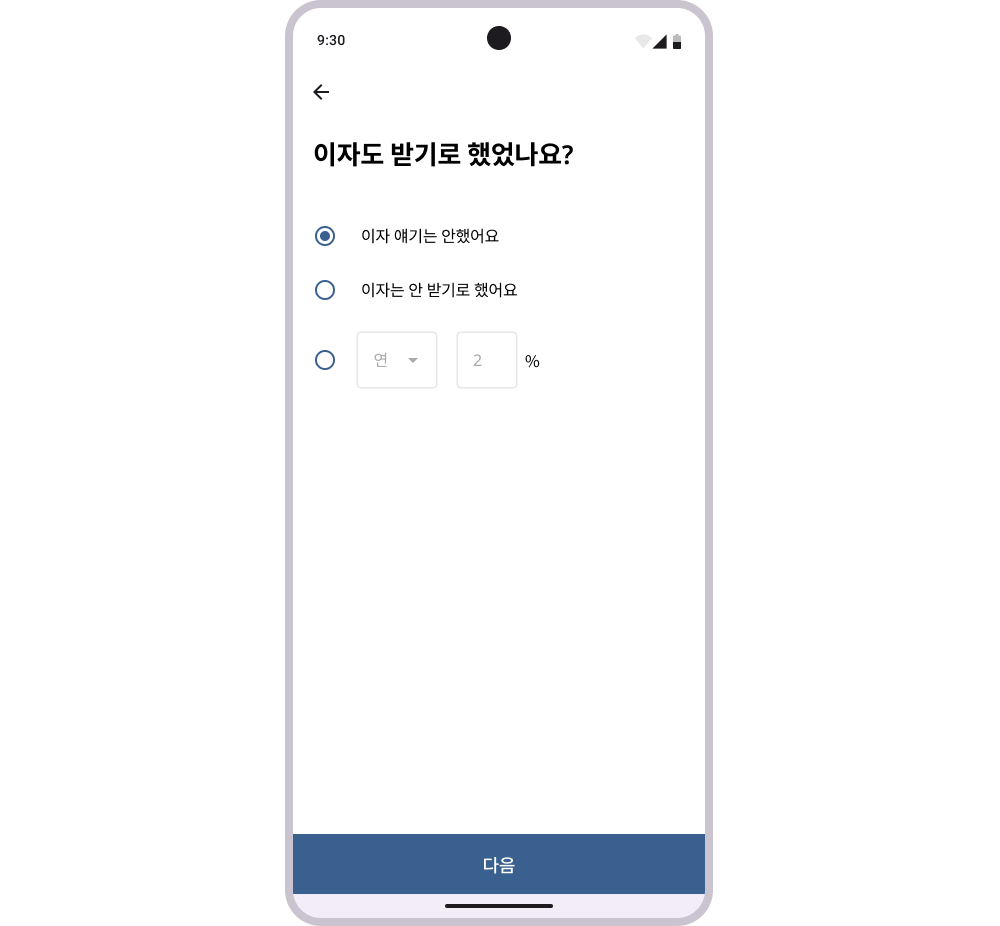
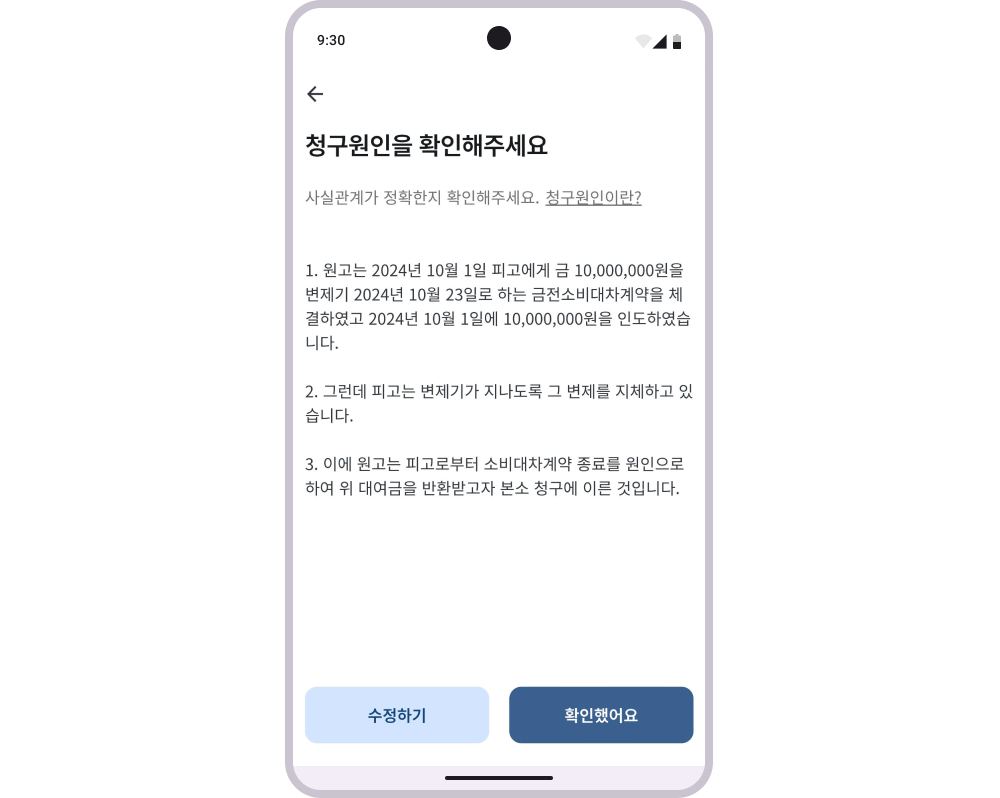
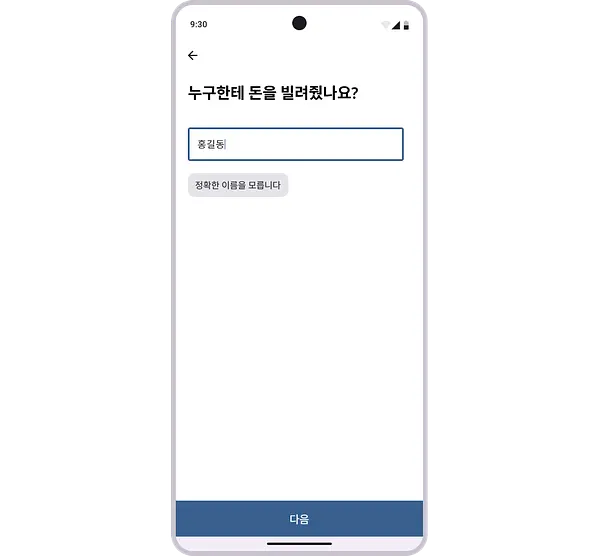
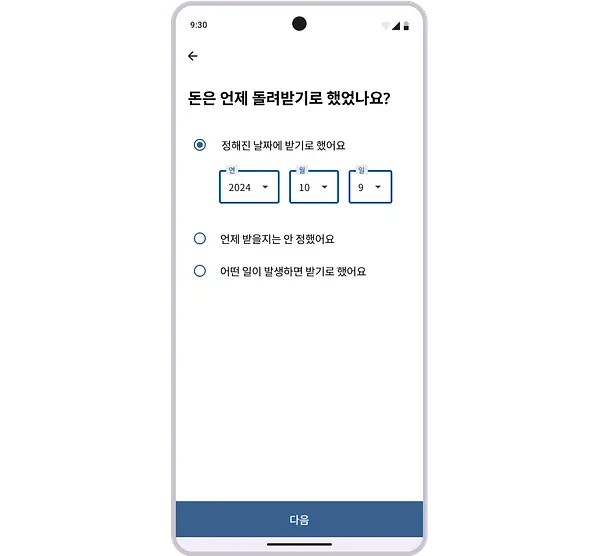
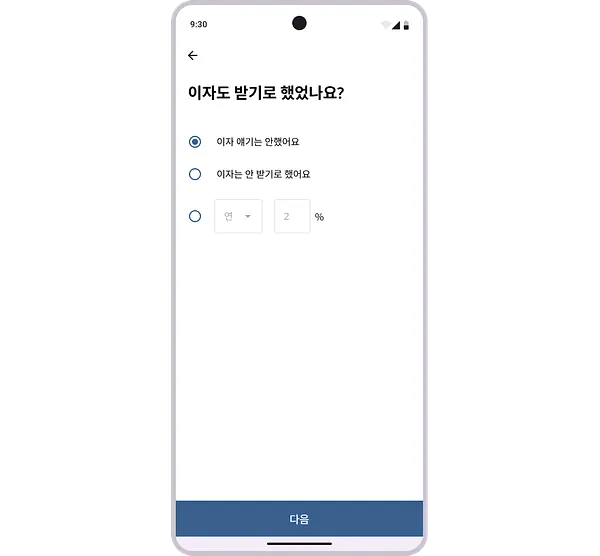
  • 사용자는 4지선다 선택지에서 연속해서 선택을 한다고 했는데 구체적으로 어떤 선택지들을 어떤 순서로 배치할 것인지

    • 대여금 사건의 소장 작성을 위해 필요한 정보들은 요건사실론에 따라 정리하였고 논리적인 선후관계에 따라 순서를 배치하였습니다. 위 데모 링크에서 직접 사용해보실 수 있고 이 피그마에서 전체 플로우를 확인해보실 수도 있습니다.

    누구한테 돈을 빌려줬나요_ (1).png돈은 언제 돌려받기로 했었나요_ (1).png이자도 받기로 했었나요_ (1).png

  • 같은 종류의 사건 안에서도 다양한 상황이 있고 각 상황 별로 소장에 들어갈 내용이 달라지는데 그런 다양한 상황을 어떤 기준으로 구분하고 어떻게 각 상황에 맞는 소장을 작성할 것인가

    • 먼저 청구취지는 형식이 정해져있고 논리적인 규칙에 따라 그 내용을 구성할 수 있기 때문에 사용자가 입력한 정보를 청구취지 형식에 맞게 구성되도록 만들었습니다. 그리고 각각의 경우에 정확한 청구취지가 완성되는지를 80여개의 시나리오에서 테스트하였습니다. 이 부분은 변호사님을 찾고 나면 변호사님께 다시 검토받을 예정입니다.

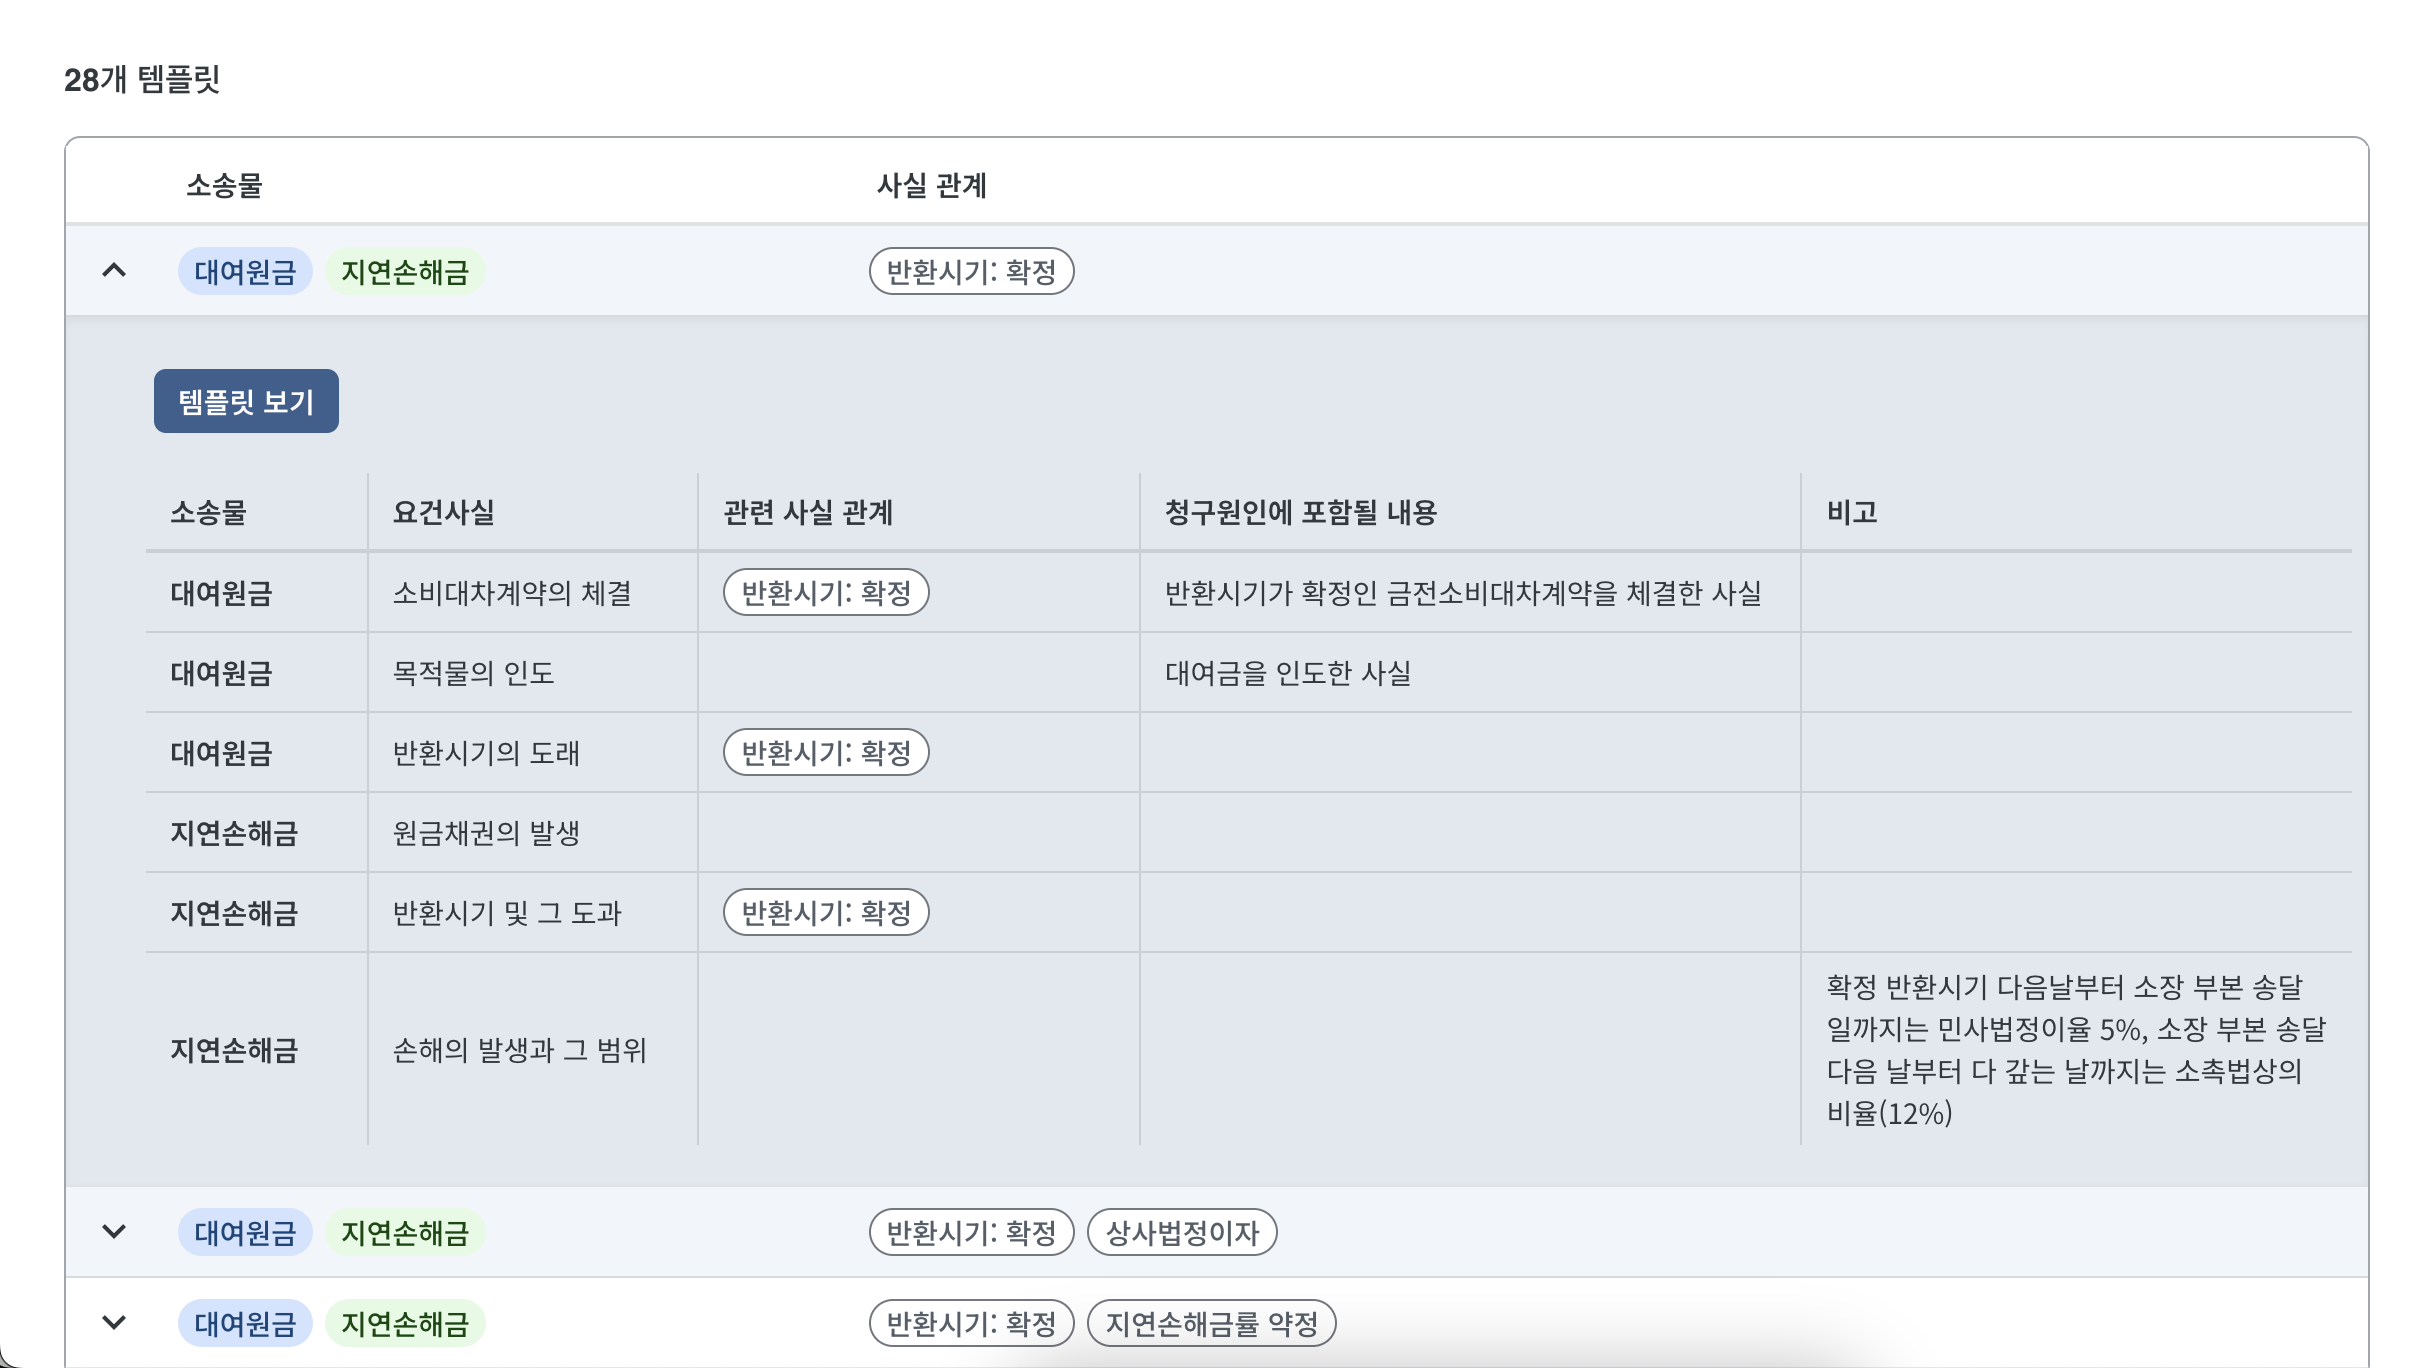
    • 청구원인은 소송물에 따라 전체를 대별한 뒤(대여금 사건에서는 대여원금, 이자, 지연손해금 3개의 소송물이 있습니다) 각 요건사실 사실관계에 따라 세분하였습니다. 구체적으로는 전체 경우를 1) 대여원금 및 지연손해금을 청구하는 경우와 2) 대여원금, 이자 그리고 지연손해금을 청구하는 경우로 대별하였고, 그 안에서는 각 요건사실의 사실관계에 따라, 예를 들어 소비대차계약의 반환시기가 확정인지 불확정인지 등에 따라 세분하였습니다. 그렇게해서 대여금 사건을 28가지 경우로 구분하였고 구분된 각각의 경우 안에서는 요건사실론에 따라 청구원인에 반드시 포함될 내용을 정리하고 그 내용을 바탕으로 청구원인 템플릿을 구성하였습니다. 

    • 다만 이 분류는 비전문가인 제가 한 것이기 때문에 부정확할 수 있고 변호사님을 찾고 나면 이 부분도 변호사님께 다시 검토를 받을 예정입니다. 같은 맥락에서 현재 28개의 청구원인 템플릿도 일일이 내용을 구성해 놓지는 않고 임시로 동일한 내용들로 채워놓았습니다. 어차피 28개 분류 자체를 수정하게 될 수도 있기 때문입니다. 

    • 이 POC를 통해서는 28개의 구체적인 분류보다는 1) 전체 경우를 논리적인 기준(요건사실론)에 따라 구분할 수 있다는 점 2) 그렇게 구분된 각각의 경우마다 적절한 청구원인 템플릿을 마련할 수 있다는 점 3) 사용자가 입력한 정보와 그에 해당하는 템플릿을 언어모델에 넣어 각 상황에 맞는 청구원인을 작성할 수 있다는 가설을 검증하였습니다.

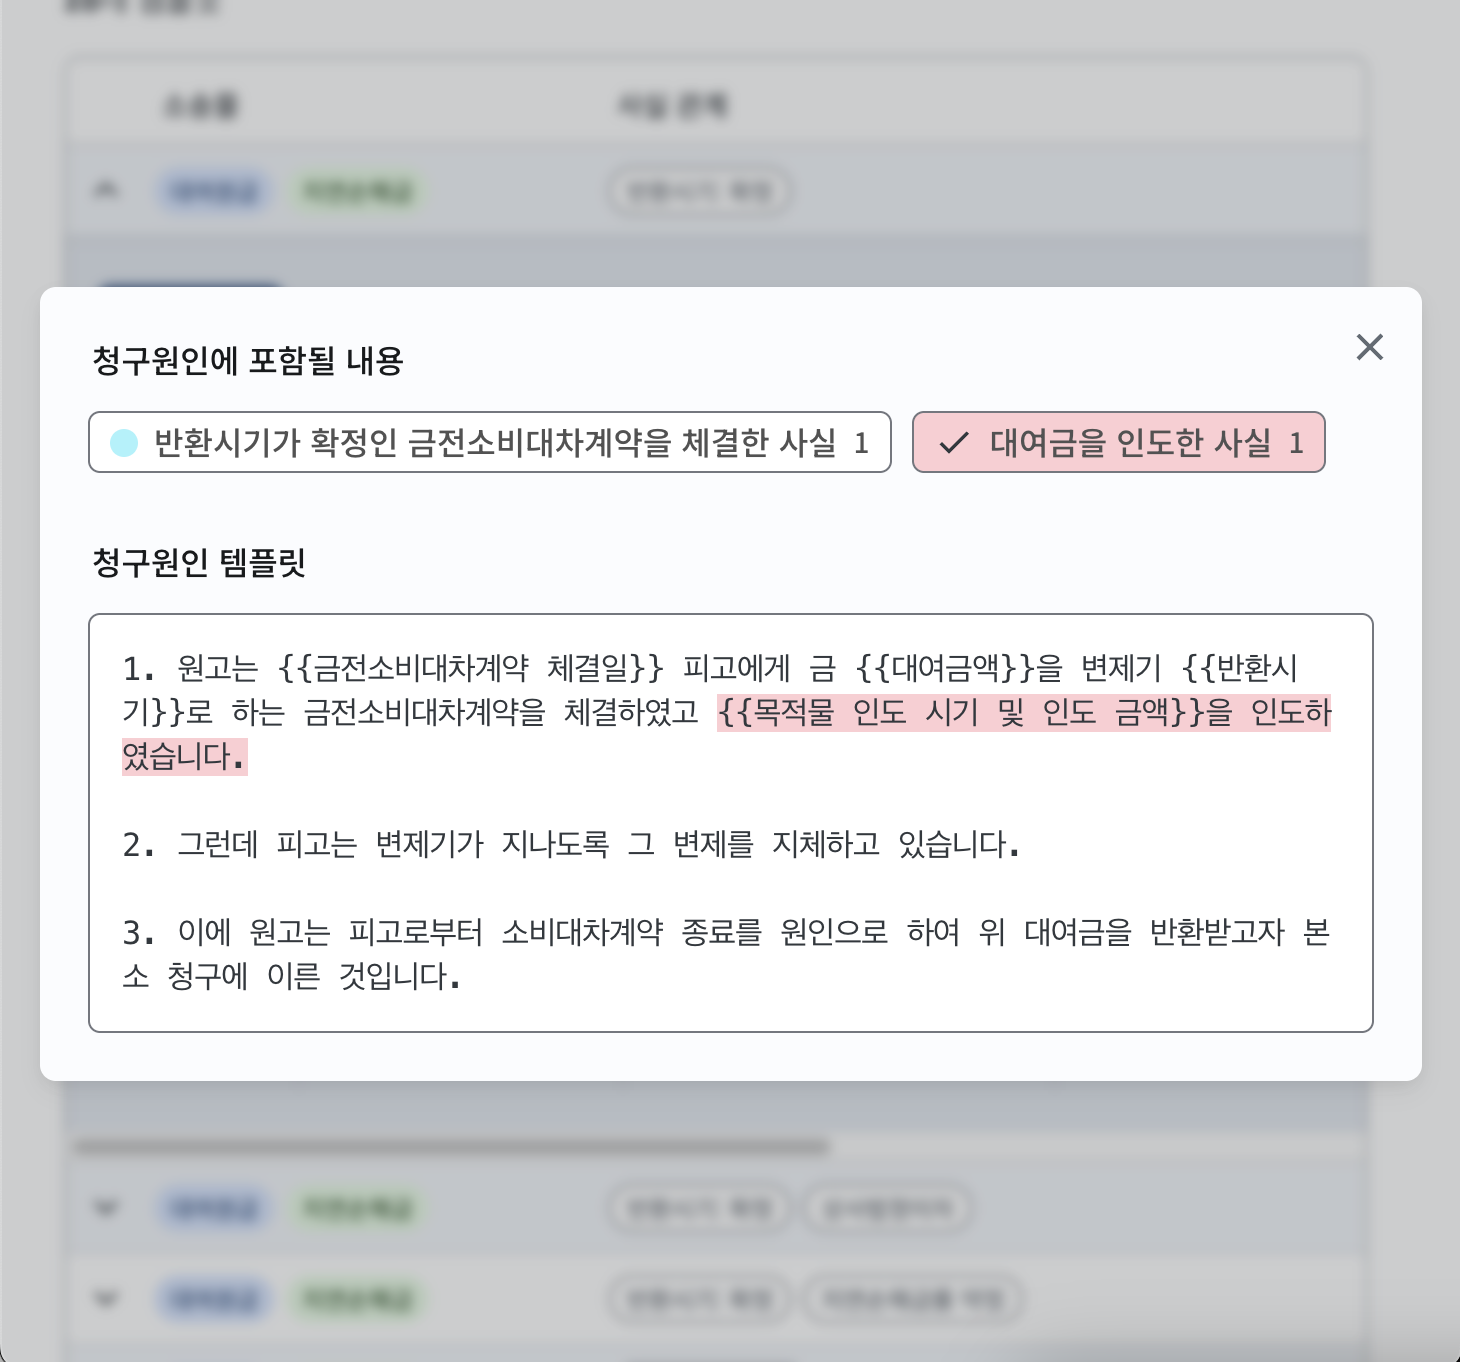
    • 그리고 앞으로 수백, 수천개의 템플릿을 관리해야 되는데 이 템플릿들을 효과적으로 관리할 수 있는 방법에 대해서도 고민하였습니다. 먼저 각각의 템플릿은 요건사실론에 따라 해당 청구원인 템플릿에 반드시 포함돼야 하는 내용들로 구성돼야 합니다. 이런 작업이 템플릿 수가 많지 않을 때는 수작업으로 관리해도 충분하지만, 전체 템플릿 개수가 많아지면 보다 효과적으로 그 정확성을 담보할 수 있는 장치가 필요합니다. 그래서 각각의 청구원인 템플릿에는 그 템플릿에 반드시 포함돼야할 사실 목록이 있고 템플릿 문구 중 구체적으로 어느 부분이 각각의 사실에 해당하는지를 라벨링 할 수 있도록 만들었습니다. 예를 들어 어느 청구원인 템플릿에 “소비대차 계약의 목적물을 차주에게 인도한 사실”이 반드시 포함돼야 한다고 하면, 템플릿 중 정확히 몇 번째 줄 몇번째 글자부터 몇번째 글자까지가 이 사실에 해당하는지를 라벨링 할 수 있도록 하였습니다. 이 라벨링 작업은 각각의 청구원인 템플릿이 그 템플릿에 포함될 내용을 빠트리지 않고 전부 포함하고 있다는 점을 효과적으로 검토할 수 있게 해줄 뿐만 아니라, 추후에 이런 라벨링 데이터가 충분히 쌓이고 나면 역으로 a, b, c라는 사실을 포함하고 있는 청구원인 템플릿을 생성하라고 하는 작업에도 활용할 수 있게 됩니다.

      스크린샷 2025-01-10 오후 3.56.36.png스크린샷 2025-01-10 오후 3.57.36.png스크린샷 2025-01-10 오후 3.58.19.png

  • 그래서 실제로 법원에 제출할 수 있는 소장을 완성할 수 있는지

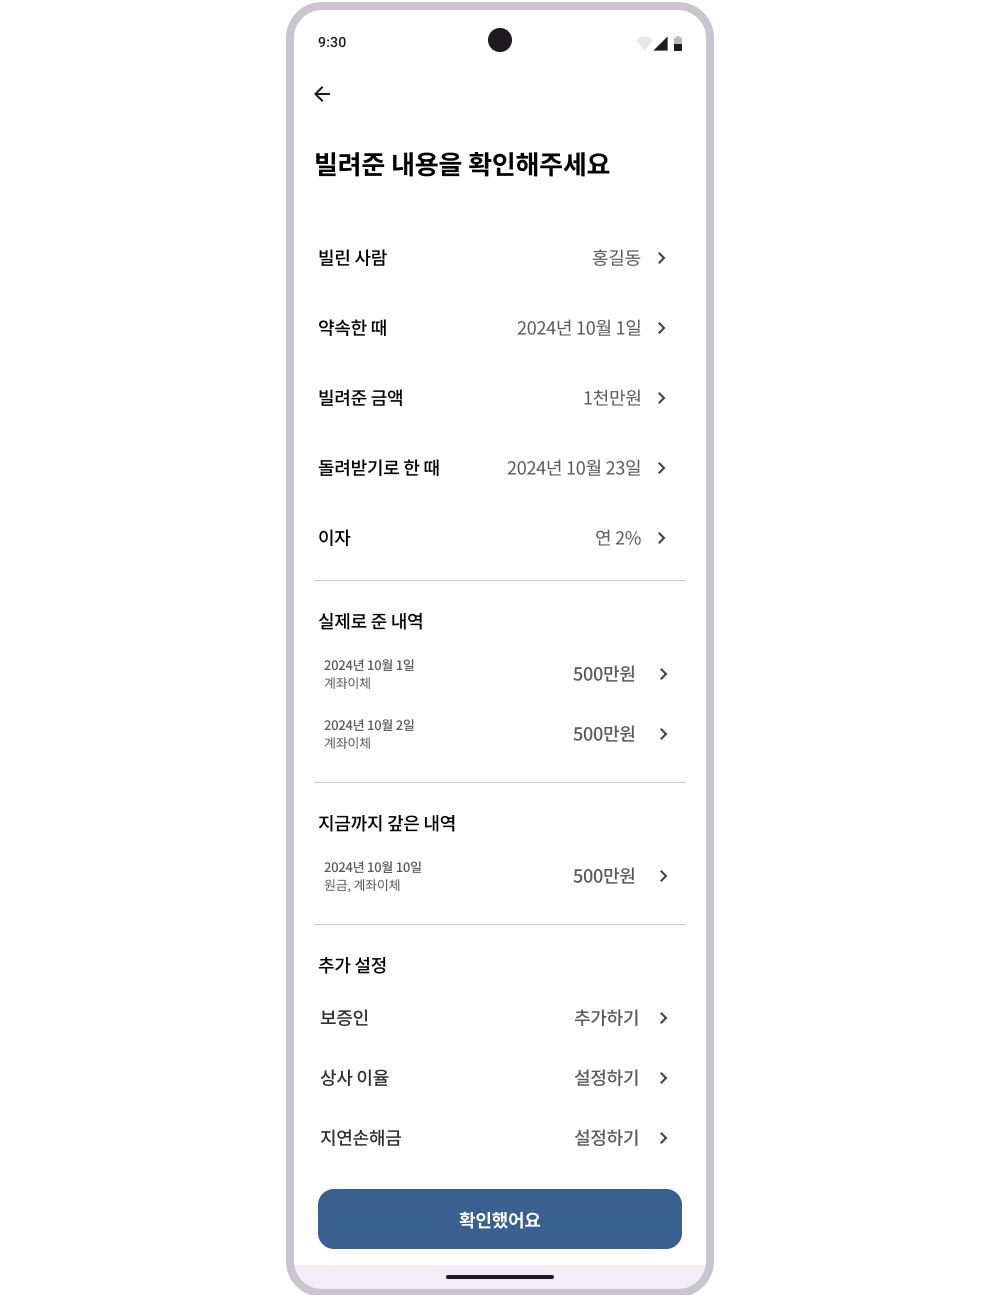
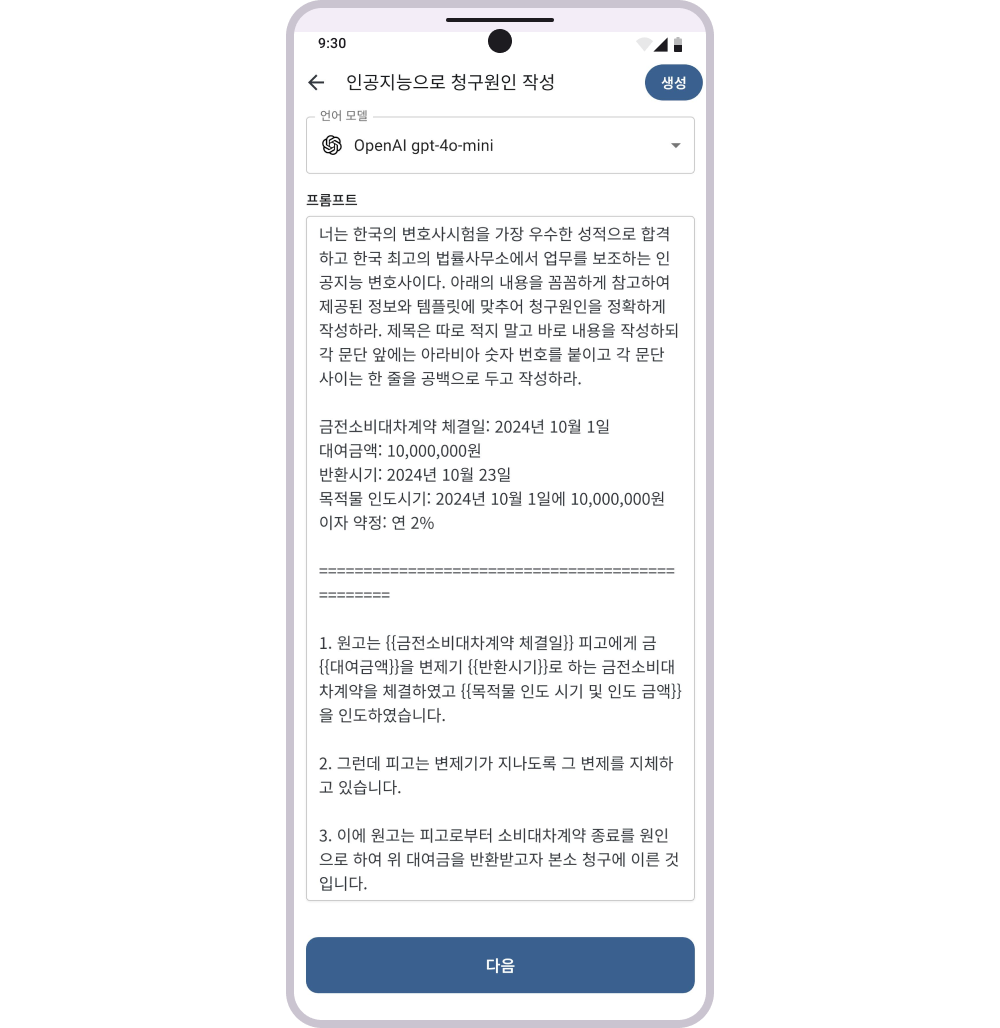
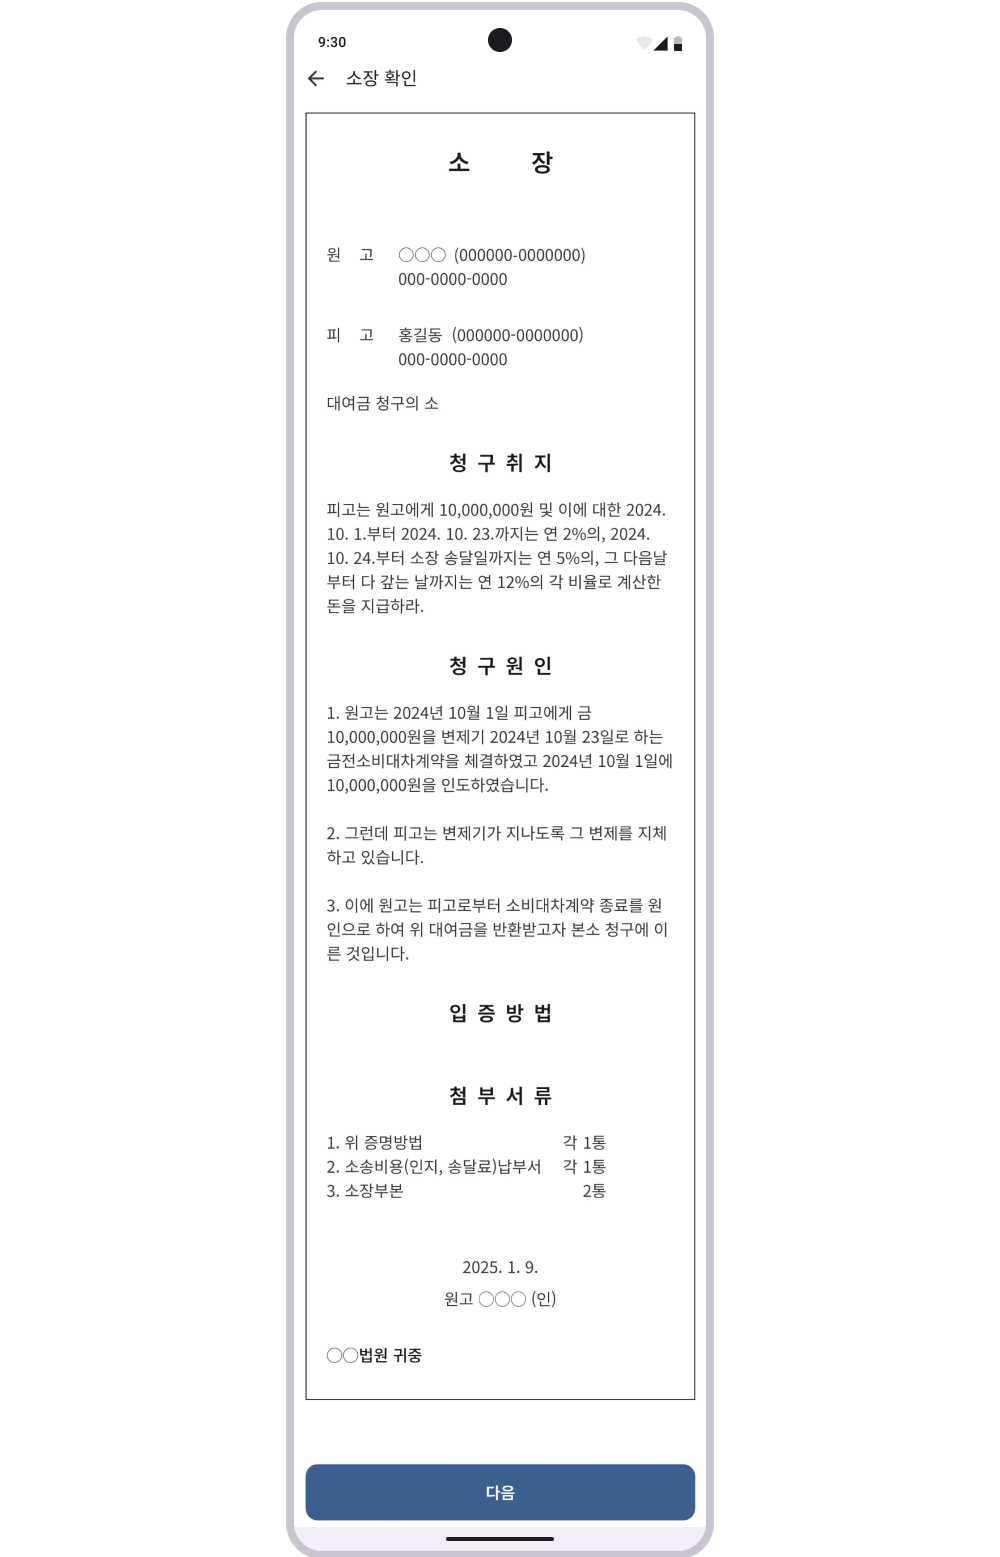
    • 네, 됩니다. 아직 당사자 정보를 입력하는 부분이나 증거를 첨부하는 부분 등이 다 완성되지 않았지만 1) 사용자 입력 정보로부터 정확하게 청구취지를 구성하는 것 2) 같은 정보로 청구원인 템플릿을 활용해 청구원인을 작성하는 부분은 완성하였습니다. botoai.co/compose 에서 직접 확인해보실 수 있습니다.

      빌려준 내용을 확인해주세요.png인공지능으로 청구원인 작성 (1).png청구원인을 확인해주세요 (3).png소장 확인 (1).png

1. 다음 작업 안내

  • 변호사님 찾기

    • 이 POC를 가지고 본격적으로 변호사님을 찾아 나설 계획입니다. 변호사님이 법률사무소를 세우시면 제가 사무직원으로 들어가서 같이 나홀로소송 서비스를 개발, 운영하는 것을 생각하고 있습니다. 그러다 현재 법사위에서 심사 중인 리걸테크법이 통과되면 법률사무소는 정리하고 주식회사를 새로 세워 사업을 이어나가고, 만약 법이 통과되지 않는다면 리스크를 감수하면서 주식회사로 전환해서 사업을 계속하거나 한국 시장은 보류하고 외국으로 진출하는 방안 등을 고민해볼 생각입니다.

    • 이 도전이 얼마든지 실패할 수 있다는 사실을 분명히 이해하고 있습니다. 중요한 것은 우리가 하는 일의 의미를 정확히 이해한 상태에서 실패를 두려워하지 않고 도전하는 것이라고 믿습니다. 앞으로는 간단한 소장은 인공지능이 작성하고, 인간 전문가는 인공지능이 작업한 부분중 중요한 부분을 검토하는 방식으로 법률가들의 업무 방식이 바뀔 것입니다. 그리고 그렇게 됨으로써 전에는 비싼 비용과 낮은 편리성 때문에 자신의 권리를 침해받고도 구제받지 못했던 많은 사람들이 더 두텁게 자신의 권익을 보장받게 될 것입니다. 이 도전은 그런 새 시대를 현재로 당겨오는 일입니다.

    • 관심 있으신 변호사님은 joonhok@botoai.co로 연락 바랍니다.

  • 내용 검토 및 남아 있는 부분들 완성

    • 아직 이 POC에는 실제 제품으로 출시하기까지(그래서 사용자가 실제로 소장을 작성하고 법원에 제출할 수 있을 정도까지) 완성되지 않은 부분이 많이 있습니다. 당사자 정보를 입력하는 부분이나 증거를 첨부하는 부분, 인지대나 송달료 같은 비용을 납부하는 부분 등이 그것입니다. 또 멀티모달리티 모델을 이용해 사용자가 첨부한 증거들의 증명력, 정합성 등을 검토하고 문제가 있을시 수정을 제안하는 부분 등도 추가로 개발할 계획입니다. 변호사님을 찾는 시간 동안 이런 작업들을 병행할 계획입니다.

3
1
김준호

김준호

나홀로소송 서비스 개발기 (2) - 귀하신 변호사님을 찾습니다

TL;DR

모바일에서 탭과 스크롤만으로 소장을 완성하고 전자소송 사이트를 거치지 않고 제출까지 가능한 나홀로소송 서비스를 만들고 있습니다. 저랑 같이 이 일을 해보실 변호사님을 찾습니다. 변호사님이 법률사무소를 설립하시면 제가 거기 사무직원으로 들어가겠습니다. 사용자들은 저희 웹사이트에서 소송 대리 계약을 맺는데 비용은 무료인 대신 소장은 본인이 알아서 작성해야 되고 기일에도 본인이 출석해야 됩니다. 사용자가 소장을 완성하면 저희가 전자소송 사이트를 이용해 대신 제출합니다. 사용자는 4지선다 선택지에서 몇 번 선택을 하면 청구취지는 자동으로 완성되고 청구원인은 거대언어모델을 통해 완성합니다. 수임료가 무료기 때문에 돈은 전혀 못 법니다. 빠르게 핵심 가설만 검증해 보는데 만약 지표가 나쁘지 않으면 1년 동안 딱 10만건만 대리해봅시다.

(이 글은 제가 나홀로소송의 문제를 다룬 세번째 글입니다. 첫 번째 글은 여기서 보실 수 있습니다.)

0. 무엇을 할 것인가

나홀로소송을 더 간편하게 할 수 있는 웹사이트를 만들어 보려고 합니다. 구체적으로 어떤 문제를 어떻게 해결할지에 대해서는 다음 글에서 자세히 살펴볼 예정이니 여기서는 간단히만 다루겠습니다.

잘 알려져있다시피 현재 민사본안사건의 대부분은 나홀로소송입니다¹. 그런데 당연히도 전문 지식이 부족하고 법률가로서의 훈련을 받지 않은 일반인들에게 있어서 혼자서 소송을 하는건 매우 고된 일입니다. 그런데 이제 인공지능 기술이 크게 발전하면서 이 문제를 해결해볼 수 있는 실마리가 보이고 있습니다. 나홀로소송은 소장을 작성하는 단계랑 작성된 소장을 제출하는 단계로 나눌 수 있는데, 소장을 작성하는 단계에서는 거대언어모델을 활용하면 전보다 더 편리하게 소장을 작성할 수 있습니다. 그리고 저는 나홀로소송 문제를 제대로 해결하기 위해서는 소장을 작성하는 단계뿐 아니라 소장을 제출하는 단계의 경험도 혁신되어야 한다고 생각합니다. 지금은 전자소송 사이트를 통해서 소장을 제출해야 되는데 이 사이트를 이용하는 것이 정말 불편합니다. 윈도우 PC가 아니면 사용하기 어렵고, 번거로운 공동인증서를 이용해 접속해야 하며, 반복적으로 수행해야 되는 작업 등을 처리하기가 어렵습니다.

우선 소장을 작성하는 단계에서는 사용자가 직접 청구원인을 작성하지 않아도 언어 모델이 대신 작성해줄 수 있습니다. 청구 취지도 직접 작성할 필요가 없습니다. 사용자가 이것들을 직접 작성하도록 하는 것이 아니라 몇 개의 보기 안에서 본인에게 맞는 보기를 계속 선택하도록만 해도 나홀로소송 같이 간단한 사건에 대해서는 소장 작성에 필요한 정보를 충분히 수집할 수 있습니다. 4지 선다 선택지에서 10번만 연달아 선택해도 100만 가지가 넘는 경우를 커버할 수 있습니다(4^10 = ​​1,048,576). 모든 선택지를 4지선다로 할 필요도 없고 반드시 10번 선택을 할 필요도 없는데 요지는 사용자가 이미 정리돼있는 선택지에서 자신에 맞는 보기들을 계속해서 선택하기만 하면 청구취지는 자동으로 완성해줄 수가 있는 것입니다(물론 금액이나 날짜 같은 정보들은 단답 형태로 입력 받을 수 있습니다). 그리고 이렇게 확인된 정보를 바탕으로 언어 모델을 이용해서 청구원인의 초안을 작성해줄 수 있습니다. 사람은 원래도 자유 양식의 글을 쓰는 것보다 여러 보기 중 하나를 선택하는 일을 더 쉽게 할 수 있는데², 소장이라는 낯설고 어려운 양식의 문서를 작성하는 것이라면 더 말할 것도 없습니다. 이렇게 인공지능 기술을 적절히 활용하면 일반인들의 소장 작성 경험을 크게 개선할 수 있습니다. 

그리고 나홀로소송 경험을 근본적으로 혁신하기 위해서는 사용자가 대한민국법원 앱이나 전자소송 사이트를 통해 소송을 수행하게 해서는 안됩니다. 대한민국법원앱(안드로이드, iOS)의 iOS 평점은 5점 만점에 1.3점이고(42개 평가), 안드로이드의 최근 3년 평점은 1.7점입니다(전화 버전, 223개 평가). 이 앱들의 리뷰를 읽어보면 사실 어디서부터 이야기를 해야될지 모를 정도로 총체적으로 문제입니다. 그리고 전자소송사이트를 이용하는 경험도 크게 다르지 않습니다. 맥에서는 이용할 수가 없어서 윈도우PC를 구해야 되고 공동인증서(구 공인인증서)로 로그인을 해야됩니다. 그런데 이 문제가 심각한 것은 이것이 단순히 불편한 경험인 것을 넘어 소송 결과에까지 영향을 주기 때문입니다. 대표적인 사례 한 가지만 이야기하자면, 보통 소송을 시작할 때 상대방의 이름이나 주소는 모른채 전화번호만 알고 있는 경우가 꽤 있습니다. 이때는 통신사에 사실조회신청을 해서 상대방의 이름과 주소를 알아내게 되는데, 문제는 이렇게 사실조회를 신청해야할 통신사 수가 너무 많다는 점입니다. 과거 대부분의 무선통신가입자가 통신 3사를 이용했을 때는 그 3개 회사에 대해서만 사실조회신청을 해도 높은 확률로 상대방을 확인할 수 있었지만, 2024년 6월말 기준 알뜰폰 가입자 수는 약 929만명으로 전체 가입자 수의 16.5% 정도를 차지하고 있으며 그 수는 계속해서 늘어나고 있습니다. 알뜰폰 통신사는 2023년 5월 기준 55개에 이르는데 이 많은 회사들에 대해 전자소송 사이트에서 일일이 사실조회신청서를 작성하는건 매우 번거로운 일일 뿐 아니라 회사명이 비슷한 엉뚱한 회사로 신청서를 보내는 실수를 하기도 쉽습니다. 그래서 나홀로소송에 대한 정보를 공유하는 글 등에서도 보통 전화번호를 이용한 사실조회신청은 통신 3사 정도에 대해서만 안내를 해주고 있습니다. 그런데 큰 마음을 먹고 소송을 결심해서 소장도 작성하고 인지대, 송달료도 납부했는데 이 단계에서 막혀버린다면 여간 허망한 것이 아닐 것입니다. 그냥 분함을 꾹꾹 누르고 없던 일로 하든지 아니면 알뜰폰 사업자 55개 회사에 대하여 하나씩 사실조회신청을 보내야 합니다.

그런데 사용자가 전자소송 사이트를 쓰지 않고 우리 웹사이트를 통해 소장을 제출하도록 하면 이런 문제를 한 번에 해결할 수 있습니다. 우리 사이트에서는 클릭 1번으로 통신 3사를 포함한 모든 알뜰폰 사업자에 대해 사실조회신청을 보내도록 만들 수 있습니다. 그리고 이렇게 원고가 전자소송 사이트를 거치지 않고도 소장(및 각종 서류들)을 제출할 수 있는 (사실상) 유일한 방법은 변호사님이 소송을 대리하는 것입니다³. 사용자는 쓰기 편한 우리 웹사이트를 통해 소장을 완성하고 네이버, 카카오 같은 간편인증이나 휴대폰 본인인증 등의 방법으로 본인을 인증합니다. 그러면 저희가 사용자가 완성한 소장을 전자소송 사이트를 통해 대신 제출합니다. 이 부분도 저희가 수동으로 하나씩 제출하는 것이 아니라 스크립트 코드를 통해 자동으로 처리할 수 있습니다. 

주식회사가 아닌 법률사무소를 세우는 이유는 불특정 다수의 사람들로부터 사건을 수임하기 위해서입니다. 그래서 변호사님께서 법률사무소를 세우시고 제가 그 사무소에 직원으로 근무하면(저는 변호사법 제22조 제2항에 정한 사무직원으로 채용되는데 있어서의 어떠한 결격사유도 가지고 있지 않습니다) 적법하게 이 서비스를 개발, 운영할 수 있을 것입니다. 하지만 주식회사가 아닌 법률사무소이기 때문에 외부 투자를 받을 수도 없고 저 역시도 사무소의 자산에 대해 아무런 권리를 인정받을 수 없습니다. 저는 상관없습니다. 어떻게 되었든 나홀로소송의 문제를 끝까지 밀어붙여서 해결해보고 싶습니다.

그리고 앞에서 적었듯이 이 서비스는 전부 무료입니다. 아무리 우리 서비스가 편리하다고 해도 돈을 내야 쓸 수 있다면 그 사용 경험은 크게 떨어질 것이고 우리는 나홀로소송의 문제를 근본적으로 혁신할 수 없습니다(우리 삶을 바꾼 여러 서비스들, 예를 들어 네이버 검색을, 카카오톡을, 유튜브를 돈을 내야 쓸 수 있다고 한다면 쓰는 사람이 얼마나 되겠습니까?). 우리는 외부 투자를 받을 수 없기 때문에 사실 생계를 꾸려나가는 부분에 있어서 문제가 생깁니다. 제 생계는 제가 알아서 해결하겠습니다. 변호사님 생계는 변호사님께서 해결해 주십시오. 물론 이런 구조로 무한정 일을 할 수는 없습니다. 적당한 기간을 정해 놓고 핵심 가설만 빠르게 검증해봅시다. 검증해보려는 핵심 가설들을 정리하면 다음과 같습니다.

  1. 나홀로소송을 준비 중인 사람에게 소장을 작성하는 일은 매우 큰 문제일 것이고 인공지능 기술을 이용해 소장을 작성하는 해결법은 만족스러운 해결법일 것이다. 왜냐하면 현재는 소장을 작성하는 법을 배우기 위해 유튜브나 네이버를 찾아보면서 스스로 공부를 해야되는데 이 방법은 시간도 오래 걸리고(최소 몇일) 어려운 내용을 공부해야 되는 반면 인공지능 기술을 이용해 (적어도 초안을) 작성하는 방법은 그것보다 훨씬 빠르고(약 10분) 편리하게 소장을 작성할 수 있기 때문이다.

    • 이 가설이 틀리게 될 경우:

    • 소장을 작성하는 일이 생각보다 별 문제가 아니다.

    • 인공지능을 이용해도 좋은 품질의 소장을 만들어내지 못한다.

    • 인공지능을 이용해 소장을 만들어내는 방법에 불법적 요소가 존재한다. 즉, 불법적 요소를 포함하지 않고서는 좋은 품질의 소장을 만들어내지 못한다.

    • 인공지능을 이용해 품질 높은 소장을 만들수도 있고 불법적 요소도 없지만 사용자가 결과물을 신뢰하지 못하여 사용하지 않는다.

  2. 나홀로소송을 시작하기 위해 소장을 작성한 사람들에게 전자소송 사이트를 이용해 서류를 제출하는 것은 큰 문제일 것이고 별도 사이트에서 간편인증을 통해 서류를 제출하는 방법은 만족스러운 해결법일 것이다. 왜냐하면 1) 핸드폰만 갖고 있는 사용자⁴나 맥 사용자⁵는 PC방을 찾아가거나 해서 처리해야되고 2) 윈도우PC 사용자도 핸드폰에서 공동인증서를 발급받아서 PC로 옮기고 하는 등의 번거로운 절차를 거쳐야 하는 것에 비해 훨씬 빠르고 편리하기 때문이다.

    • 이 가설이 틀리게 될 경우:

    • 법원 공식 사이트를 통해 제출하는 것이 아니기 때문에 신뢰가 가지 않아서 사용하지 않는다.

  3. 소장을 작성하는 것과 작성된 소장을 제출하는 것까지를 묶어서 한번에 해결해주어야만 회사를 세울 수 있을 정도의 큰 가치를 줄 수 있을 것이다.

제품 개발에 필요한 기술적인 부분은 제가 담당하겠습니다. 변호사님은 서비스 안에 들어갈 내용 부분을 맡아주십시오. 그래서 적당한 기간을 정해놓고 그 기간 동안 우리가 해결하려는 문제가 진짜 문제가 맞는지, 우리의 접근 방법이 충분히 혁신적인 것인지를 검증해봅시다. 그리고 마치 토스가 송금의 문제를 해결하는데서 시작했지만 지금은 은행과 증권, 전자 결제까지 금융 산업 전 영역에 걸쳐서 사업을 운영하고 있는 것처럼, 우리도 만약 이 시도가 성공한다면 법률 서비스 시장의 다른 여러 문제들을 해결하면서 사업성을 키워가봅시다. 

1. 마일스톤들

이 시도는 (적어도 지금 단계에서는) 돈도 못 벌고 법적인 리스크도 있으며 성공하기 위해서는 여러 난관을 헤쳐나가야 하는 그런 일입니다. 그래서 얼마든지 실패할 수 있고 사실 실패하는 것이 기본값인 그런 일입니다. 그렇기 때문에 우리는 더 마음 편하게, 자유롭게 도전해볼 수 있습니다. 실패하는 것을 두려워하지 말고 어차피 안될테니까 핵심 가설만 빠르게 검증해봅시다. 어차피 안될거라는 사실을 우리가 잠시라도 잊을 수 있으니 앞으로 이 단락의 모든 문단은 어차피 안될거라는 말로 시작하겠습니다.

어차피 안되긴 할텐데 우선 6개월 동안 해보고 그 기간 동안의 평균 주간 성장률이 40% 미만이거나, Net Promoter Score가 70이 안되면 깨끗하게 실패를 인정합시다(주간 성장률은 그 주에 대리한 소송 건수로 계산합니다). 더 이상 새로운 사건은 수임하지 말고 이미 수임한 사건들만 잘 처리합니다. 그 다음 변호사 님은 원래 변호사님이 계셨던 곳으로 돌아가시고 저도 제 갈길을 가겠습니다. 

어차피 안되겠지만 만약 6개월 평균 주간 성장률도 괜찮고 NPS도 70을 넘으면 1년 동안 10만 건을 소송 대리하는 것을 목표로 조금 더 진행해봅시다.

어차피 안되겠지만 만에 하나 우리가 10만건을 대리하는데 성공한다면 변호사법을 바꾸기 위해 움직여봅시다. 이 사업을 계속하기 위해서는 외부 투자도 필수적이고 많은 인재들이 위험을 감수하고 이 일에 같이 도전할 수 있도록 그들의 기여에 정당한 보상을 해줄 수 있어야 합니다. 그런데 변호사법은 변호사와 비변호사가 동업하는 것을 금지하고 있습니다(변호사법 제34조 제4항 및 제5항). 이 이슈는 이미 오래된 이슈이고 2018, 2019년에 비슷한 취지의 개정안이 발의 시도된 적이 있고, 현재도 허가 받은 리걸테크서비스는 일반인을 대상으로 자동화된 법률 자문, 자동화된 법률 문서 작성수단의 제공 등을 할 수 있다는 내용의 법안이 접수되어있지만(리걸테크 산업진흥 및 이용촉진에 관한 법률안), 여전히 많은 변호사님들이 우려하시는 이슈입니다. 만약 이 법안이 통과되지 못한다면, 한국에 계신 변호사님들을 한 분씩 만나 우리의 취지를 전해봅시다. 만나서 설득한다고 생각하지말고 그냥 우리의 노력이(그리고 우리를 뒤이을 다른 팀들의 노력이) 어떻게 대한민국의 사법 접근성을 제고할 것인지, 그래서 우리나라의 법치주의를 얼마나 더 발전시킬 수 있을 것인지를 말씀드려 봅시다. 우리가 법률 서비스 시장의 탐색과 구매 과정을 얼마나 편리하게 만들 것인지, 그래서 법률 서비스 공급자와 소비자 사이의 거래를 얼마나 촉진할 수 있는지를 전달 드리고, 그로 인해 우리나라 전체 법률 서비스 시장이 얼마나 더  커질 수 있는지 등을 낮은 마음으로 말씀드립시다. 한국에 변호사님이 3만 5천분 정도 계신데 이미 우리 입장에 찬동하시는 분들도 계시고 절대로 안 만나주시는 분들도 있을테니 1년 정도면 다 만나뵐 수 있을 겁니다. 그리고 입법 청원 5만명 동의를 만들어 봅시다. 우리 서비스를 이용한 사용자들께도 부탁드리고 유튜브에도 닥치는대로 나가서 어떻게든 5만명을 채워 봅시다. 설사 법을 바꾸는데까지는 실패하더라도 법사위 청문회까지는 만들어봅시다.

만약 그래도 변호사법을 바꿀 수 없어서 계속 사업을 진행하기 어려우면 외국으로 갑시다. 일본, 독일, 미국(50개 주) 중에 잘 찾아보면 우리 모델로 사업을 할 수 있는 곳이 분명히 있을 겁니다. 우리의 성공 레코드를 가지고 투자를 받아서 그곳에 가서 사업을 합시다. 주간 성장률 40%는 유니콘을 꿈꾸게 하는 숫자입니다. 만약 우리가 일본으로 가게 된다면 코드를 몇 줄 바꾸지 않고도 사업을 할 수 있을지 모릅니다. 또 우연히도 제가 일본과 독일에서 일한 경험이 있습니다. 일본에서는 Indeed라는 회사의 도쿄 오피스에서 일했고 독일에서는 Amazon 베를린 오피스에서 일했습니다. 쉬운 일은 아니겠지만 못할 이유도 없습니다. 

어차피 안되겠지만 만약 우리가 변호사법을 바꿀 수 있어서 계속 사업을 할 수 있게 된다면 한국 법률 서비스 시장의 크기를 2배로 키워 봅시다. NYU Stern MBA의 Aswath Damodaran 교수는 2014년에 전세계 택시 시장의 크기를 130조(1000억불), 우버의 향후 예상 시장 점유율을 10%로 추정해 우버의 기업 가치를 8조원 정도로(59억불) 평가하였습니다. 그런데 우버는 2023년 총 거래액 180조(1,379억불), 매출액 48조(373억불)를 기록하면서 현재 약 200조원(약 1,500억불) 가까운 기업 가치를 인정받고 있습니다. 이에 대해 링크드인의 창업자 Reid Hoffman은 그의 저서 “블리츠스케일링”에서 “이러한 시장 규모를 얻을 수 있었던 것은 우버와 경쟁업체들이 제공한 사용의 편의성과 낮은 가격이 '서비스로서의 운송(transportation-as-a-service)' 시장을 확장했기 때문”⁶이라고 지적하였습니다.

지금은 나홀로소송 과정이 번거롭기 때문에 소수의 사람만 그 제도를 이용하지만 과정이 좀 편리해지면 지금보다 더 많은 사람들이 이용하게 될 것입니다. 그리고 나홀로소송을 하는 분들도 소송을 하다보면 법률 전문가의 도움을 받아야 하는 상황이 반드시 옵니다. 지금은 법률 서비스의 가격이 비싸고 서비스를 구매하는 과정이 불편하기 때문에 전문가의 도움이 가장 필요한 순간에도 도움을 받지 못하는 경우가 많습니다. 예를 들어 소송을 하면 최소 한 번은 법정에 출석해야 되는데 사실 이때가 일반인들에게는 가장 변호사의 도움이 필요한 순간입니다. 그런데 지금은 몇 백만원을 주고 소송 전체를 위임하든지 아니면 본인이 전부 다 직접 하든지 양자택일을 할 수 밖에 없어서, 가장 떨리고 두렵기까지한 법정 출석의 순간에도 변호사님의 도움을 받는게 쉽지 않습니다. 또 유료 전화 상담 같은 것을 이용한다고 해도 지금은 내가 무슨 소송을 하고 있는지, 이 다툼의 사실관계가 어떠한지, 지금까지 내가 어떤 서류들을 제출했고 상대방은 어떤 답변을 해왔는지 등을 상담하는 변호사님께 처음부터 다 다시 이야기해야 합니다. 이런 과정은 말하는 사람에게도 힘든 일이지만 무엇보다 변호사님의 시간을 효율적으로 쓰는 방법이 아닙니다. 요컨대 우리가 법률 서비스를 더 모듈화해서 서비스 구매의 최소 단위 가격을 낮추되 거래 과정에서 발생하는 마찰들을 줄이고 꼭 변호사님의 시간을 쓰지 않아도 되는 작업들을 중간에서 효율적으로 처리해주면 법률 소비자들이 더 저렴한 비용으로 더 많은 도움을 받을 수 있고 결과적으로 법률 서비스 시장 전체의 크기를 키울 수 있습니다. 

그리고 꼭 소송으로 한정해서 생각할 필요도 없습니다. 사용자가 원하는 것은 내 침해된 권리를 구제받고 문제를 해결하는 것이지 반드시 “소송”이라는 행위를 하겠다는 것이 아니기 때문입니다. 소송까지 가지 않더라도 그 전단계에서 법률 전문가들이 개입하여 문제를 원만히 해결할 수 있는 방법들은 얼마든지 있습니다. 지금은 이 역시 높은 가격과 거래를 맺는데까지의 여러 마찰들 때문에 활발히 거래되고 있진 않지만 가격이 더 낮아지고 이용이 편리해진다면 상황은 달라질 수 있습니다. 말하자면 우리는 분쟁해결로서의 서비스(conflict-resolution-as-a-service)로 진화해갈 수도 있을 것입니다. 법률 서비스 시장은 거대한 잠재 수요가 대기하고 있는 시장입니다. 이 문제를 하나씩 해결해나가면 전체 법률 시장 크기를 2배로 키우는 것도 불가능한 것만은 아닙니다.

2. 그 일을 왜 하는가, 왜 지금 하는가, 왜 저와 하는가

로마의 클라우디우스 황제가(재위기간 서기 41년부터 54년) 변호사를 전문적인 직업으로 제도화한 이래 지난 2000년동안 법률 소송은 오직 전문가만이 할 수 있는 어렵고 돈이 많이 드는 일이었습니다. 지금도 나홀로소송이 제도적으로 지원은 되고 있지만 많은 경우 일반인이 혼자서 소송을 하는건 “머릿 속이 새하얘지고 멘탈은 와르르 다 무너지고 (중략) 너무 억울하고 그냥 눈물만 나”는 일입니다(중략은 인용자가 가한 것임). 복잡하고 어려운 사건이야 전문가의 도움을 받아야겠지만 간단한 사건들, 예를 들어 친구한테 돈을 빌려줬는데 갚지를 않는다든지, 헬스장 회원권을 끊었는데 폐업하고 도망가버린다든지 하는 일 따위를 해결하는 건 그렇게 복잡할 필요도 없고 비용이 많이들 이유도 없습니다. 우리가 서로 약속한 내용을 당신이 지키지 않았으니 내 돈을 돌려달라는 것입니다. 이 2000년짜리 문제가 지금까지는 도저히 해결할 방법이 없었는데 이제 막 꽃을 피우기 시작한 새로운 기술 덕분에 해결될 가능성이 조금씩 열리고 있습니다.

오픈AI가 작년 3월에 발표한 GPT-4 모델은 미국 변호사시험을 상위 10% 성적으로 합격할 수 있었는데, 이는 그보다 4개월 전에 발표된 GPT-3.5 버전이 하위 10%의 성적으로 합격할 수 있었던 것에 비해 크게 발전된 것이었습니다. 현재 이 모델은 토큰당 0.00001 달러에(1백만 토큰당 $10) 이용할 수 있는데⁷, 어쩌면 우리는 변호사님들이 일하는 방식이 완전히 바뀌는 새로운 시대의 시작점에 서있는지도 모릅니다. 이 거대언어모델은 멀티모달리티가 지원되기 전부터 보지 않았지만 볼 수 있었고⁸, 현재는 국제수학올림피아드에서 (금메달에 1점 모자란) 은메달을 딸 수 있는 수준까지 발전하였습니다. 사실 GPT 모델이 아직 정복하지 못한 테스트들을 보면 그것들은 언어에 대한 이해가 부족해서 생긴 “능력”의 문제라기보다는 바로 답하기 어려운 질문들에 대해서 아직 한 번에는 잘 대답하지 못하는 “운용”의 문제라고 보는 것이 맞습니다. 언어모델에 있어서 이 문제들은 이미 다 해결된 문제들이고, 비유하자면 수학 문제를 풀긴 했는데 연습장에 지저분하게 풀어서 답안지에 깨끗하게 옮겨적는 일 정도만 남은 것들입니다. 그리고 현재 이 분야에 투자되고 있는 자본의 크기를 감안하면 1-3년 안에 지금보다 성능은 10배 더 좋아지고 가격은 10배 더 싸질 것입니다. 

이렇게 빠르게 변화하는 시기에 가장 현명하게 대처하는 방법은 그 변화의 흐름에 적극적으로 올라타서 미래를 직접 만들어 가는 것입니다. 저는 앞으로 10년 이내에 법원에 제출되는 서류의 절반 이상은 인공지능이 (적어도 초안을) 작성한 것일 거라고 생각합니다. 인공지능이 훨씬 더 저렴한 비용에(최소 몇 만배에서 몇 억배) 거의 실시간으로 충분히 괜찮은 문서를 생산해낼 수 있는데 그렇게 안될래야 안될 수가 없습니다. 전에는 소수의 리걸테크 회사를 규제하고 제재하는 방식으로 변화에 저항할 수 있었지만 지금 방식의 기술은 그렇게 막기도 어렵습니다. 그래서 저는 앞으로 10여년 동안 전세계 모든 나라, 모든 법률 시장이 이 방향으로 변해갈 것이라고 생각합니다. 남은 문제는 글로벌 플레이어가 시장을 독차지하느냐 아니면 로컬 플레이어가 시장을 지켜내느냐 정도의 문제만 남았다고 생각합니다. 인터넷 시대가 온 다음에는 전세계 모든 사람들이 인터넷 검색을 하게 되었습니다. 대부분의 시장은 구글이 차지하였고 아주 일부 시장에서는 네이버 같은 로컬 플레이어가 승리하였습니다. 모바일 시대가 온 다음에는 전세계 모든 사람들이 메시징 앱을 사용하게 되었습니다. 상당수의 시장은 왓츠앱 같은 글로벌 플레이어가 차지하였지만 일부 시장은 카톡 같은 로컬 플레이어가 차지하고 있습니다. 저는 똑같은 일이 법률 시장에도 일어날 것이라고 생각합니다. 지금으로서는 상상도 하기 힘들지만 불과 40여년 전에는 소장을 손으로 작성했습니다. 지난 40여년 동안의 변화보다 지금부터 앞으로 10년 동안의 변화가 더 클것입니다. 

저는 검사가 되고 싶어서 서울대학교 법학부에 입학했습니다. 그런데 학교를 다니면서 법조인이 되기 보다는 사업을 더 하고 싶어져서 코딩을 배워 개발자가 되었습니다. 대학교를 졸업하고 10년 정도 코딩을 해왔는데 작은 스타트업의 3번째 멤버로 참여해보기도 했고, 네이버나 아마존 같이 큰 조직에서도 일해보았습니다(보다 자세한 제 이력은 링크드인 프로필을 참조해주세요). 창업을 하기로 한 것은 어떻게 살 것인가라는 물음에 대한 저의 답이었습니다. 비록 부족한 재능이지만 전 저의 재능을 남기지 않고 전부 다 쏟아서 살아내는 그런 삶을 살고 싶었습니다. 또 아주 어렵긴해도 해결만 할 수 있다면 정말 멋진 어떤 일에 제 생애에 걸쳐서 도전해보고 싶었습니다. 나홀로소송은 제가 찾은 그런 문제입니다. 지금처럼 법적 구제 수단이 불편한 상황에서는 결과적으로 먹고 튀는 놈들한테 상을 주는 결과가 돼버립니다. 헬스장이 환불 처리를 하지 않고 폐업해버린다든가, 상품권을 팔아놓고 환불해주지 않는다든가, 부동산을 잔뜩 소유하고 전세보증금을 돌려주지 않는다든가 하는 일들이 계속 반복되는 것은 그렇게 했을 때의 경제적 이득이 압도적으로 크기 때문입니다. 저는 이 문제에 꼭 도전해보고 싶습니다. 한국에 뛰어난 개발자분들도 많고 훌륭한 법조인분들도 많이 계시지만, 그래서 감히 제가 제일 잘 낫다고 말할수는 없지만, 그래도 한국에서 인공지능 기술을 이용해서 법적인 문제를 해결하는 일에 있어서만큼은 누구에게도 지지 않을 자신이 있습니다. 앞으로 10년간은 기술이 계속해서 빠르게 발전할 것이고 이 시장은 기술이 주도해가는 시장이 될 것입니다. 기술이 주도하는 시장에서는 기술을 깊이 이해하고 잘 다룰 수 있는 팀이 이깁니다. 이기는 팀에 합류하십시오. 

3. 결어

저랑 같이 나홀로소송을 조금 더 편리하게 만들어보실 귀하신 변호사님을 찾습니다. 간단한 소송들은 동사무소에 가서 등본을 떼듯이 간편하게 할 수 있어야 합니다. 하지만 동시에 이 시도는 특별한 일이 없다면 실패할 시도입니다. 그래서 우리는 마음 편하게, 미련 없이 도전해볼 수 있습니다. 만약 우리의 도전이 빛을 보게 된다면 한국의(어쩌면 전세계의) 많은 사람들이 지금보다 더 두텁게 자신의 권익을 보장받게 될 것이고, 판사님들은 보정 명령을 발령할 일이 줄고 소송 지휘가 수월해져서 지금보다 더 일찍 퇴근하실 수 있게 될겁니다. 우리가 꿈꾸는 변화들이 하나씩 이루어진다면 정의가 물처럼 흐르는 세상이라고까진 할 수 없어도 적어도 지금보다는 한 걸음 더 정의로운 세상, 더 좋은 세상으로 바뀌었다고 말할 수 있을지 모릅니다. 

그리고 사실 전자소송 사이트가 지금 기준에서 보면 많이 불편한 것이 맞지만 지금 이만큼의 시스템을 갖춘 것도 한편으로는 대단한 성과라고 생각합니다. 이만큼의 시스템도 갖추지 못한 사회도 많습니다. 이만큼의 시스템을 만들고 우리에게 물려주신 우리 사회 선배님들을 진심으로 존경하고 감사하게 생각합니다. 이제는 우리가 그 바통을 이어받아서 그 다음 단계로 밀어올리는 일을 하면 됩니다. 저랑 같이 해봅시다. 관심 있으신 분은 아래 이메일 주소로 연락 바랍니다.

joonhok@botoai.co


각주

---------------------------------------------------------------------------------------

  1. 2023 사법연감 720쪽

  2. 특히 이 점과 관련해서는 Andrej Karpathy가 MS Build 2023 컨퍼런스에서 제시한 다음 분석을 참고할만합니다. “But you might ask why, why does it(RLHF model) work better? (중략) It has to do with the assymmetry between how easy computationally it is to compare versus generate”.

  3. 이 부분도 자세히 들어가면 보통의 변호사 선임처럼 포괄적 소송대리권을 받는 것으로 계약 내용을 구성할 수도 있고 서류 제출과 송달 영수 2개의 개별 소송 행위에 대한 대리권만을 위임받는 것으로 구성할 수도 있습니다. 두 가지 방법 모두 가능할듯하나 각각의 방법마다 장단점이 있어 최종적으로는 실제 제품을 만들면서 결정하면 되지 않을까 생각합니다.

  4. 2023년 기준 전체 가구 중 50.8%만 데스크톱 PC를 보유하고 있고, 노트북은 35.9% 가구만 보유중.정보통신정책연구원, 「한국미디어패널조사」

  5. 2023년 4월 기준 PC 운영체제 점유율 약 14%

  6. 리드 호프만, 크리스 예, 『블리츠스케일링』, 이영래 옮김, 쌤앤파커스(2020), 94p

  7. “gpt-4o-2024-08-06” 모델 기준. https://openai.com/api/pricing/

  8. GPT-4 모델은 TikZ 코드로 뿔이 달린 유니콘을 그릴 수도 있고 뿔이 빠진 유니콘에 다시 뿔을 붙여줄 수도 있습니다. “We gave to GPT-4 a transformed version of the TikZ code it produced for Figure 1.1, with the part drawing the horn removed. We asked for code to add back the horn, and display the result. This demonstrates that GPT-4 can “see” despite being a pure language model”. “Sparks of artificial general intelligence: Early experiments with GPT-4”.

6
0

포스트

전체 보기
김준호

김준호

로톡 변호사님들을 위한 Cursor를 만들었습니다. 🙂

이 크롬 확장 프로그램을 설치하시면 답변을 쓰실 때 ai가 자동으로 질문을 분석해서 답변 초안을 작성해 줍니다. 변호사님은 초안에서 필요한 부분만 고쳐 답변을 완성하실 수 있습니다.

챗GPT나 퍼플렉시티보다 월등히 답변 품질이 좋고, 변호사님이 이전에 로톡에서 작성하신 답변이 있으면 그 답변 스타일을 참고하여 초안을 작성합니다.

설치 외에 추가로 하실 건 아무 것도 없습니다. 설치만 하시면 원래 하시던 데로 하셨을때 자동으로 초안이 작성됩니다.

변호사님은 검토만 해주세요. 초안은 AI가 쓸게요. 😉

https://www.botoai.co/

Cursor for 로톡 변호사님

로톡에서 변호사님이 답변을 쓰실 때 ai가 자동으로 답변 초안을 작성해주는 크롬 확장 프로그램

1
0